成为全栈·Flutter App 篇·服务端目录与文章辅助阅读:锚点、上下篇、浏览量和阅读历史
上一篇解决了"目录项怎么绑到标题上"。这篇接着说文章页里其余那些看起来都很小、但每个都有自己的坑的功能:目录面板、上下篇、浏览量、阅读历史。
四个功能,四种不同的数据性质:
| 功能 | 数据性质 | 请求时机 | 写操作 |
|---|---|---|---|
| 目录 | 正文的一部分 | 跟正文一起 | 无 |
| 上下篇 | 按发布时间推导 | 跟正文一起 | 无 |
| 浏览量 | 写多读少、不能重复计 | 进入时上报一次 | 有 |
| 阅读历史 | 私有、随阅读行为变化 | 本地 + 同步 | 有 |
前两个是"读一次就好",后两个是"要写、要同步、要防重"。这篇的重点在后者,以及一个我在实现 id/slug 别名时才想明白的设计。
正文和目录必须是一个版本
先说一个容易被忽略的前提:目录不是独立请求的。
dart
/// 已发布正文与目录作为一个版本保存,避免目录指向旧内容。
class ArticleReader {这个类把正文和目录当作一个整体存进同一个缓存键。
为什么必须绑在一起?设想分开放的情况:目录缓存 1 天,正文缓存 1 小时。用户读了一半,编辑更新了这篇文章------下一次用户刷新,正文变成新版了,但目录还是旧的。结果就是目录里那些锚点指向的位置全部偏移,点一个跳到错的地方。
而且这个 bug 极难发现:文章短的时候目录只有两项,错位也看不出来;长文章用户也不会去逐个点。
所以现在的策略是宁可一起过期。正文十分钟更新一次,目录跟着一起。代价是文章更新后目录要多等十分钟才刷新------这个代价明显小于"目录跳转错乱"。
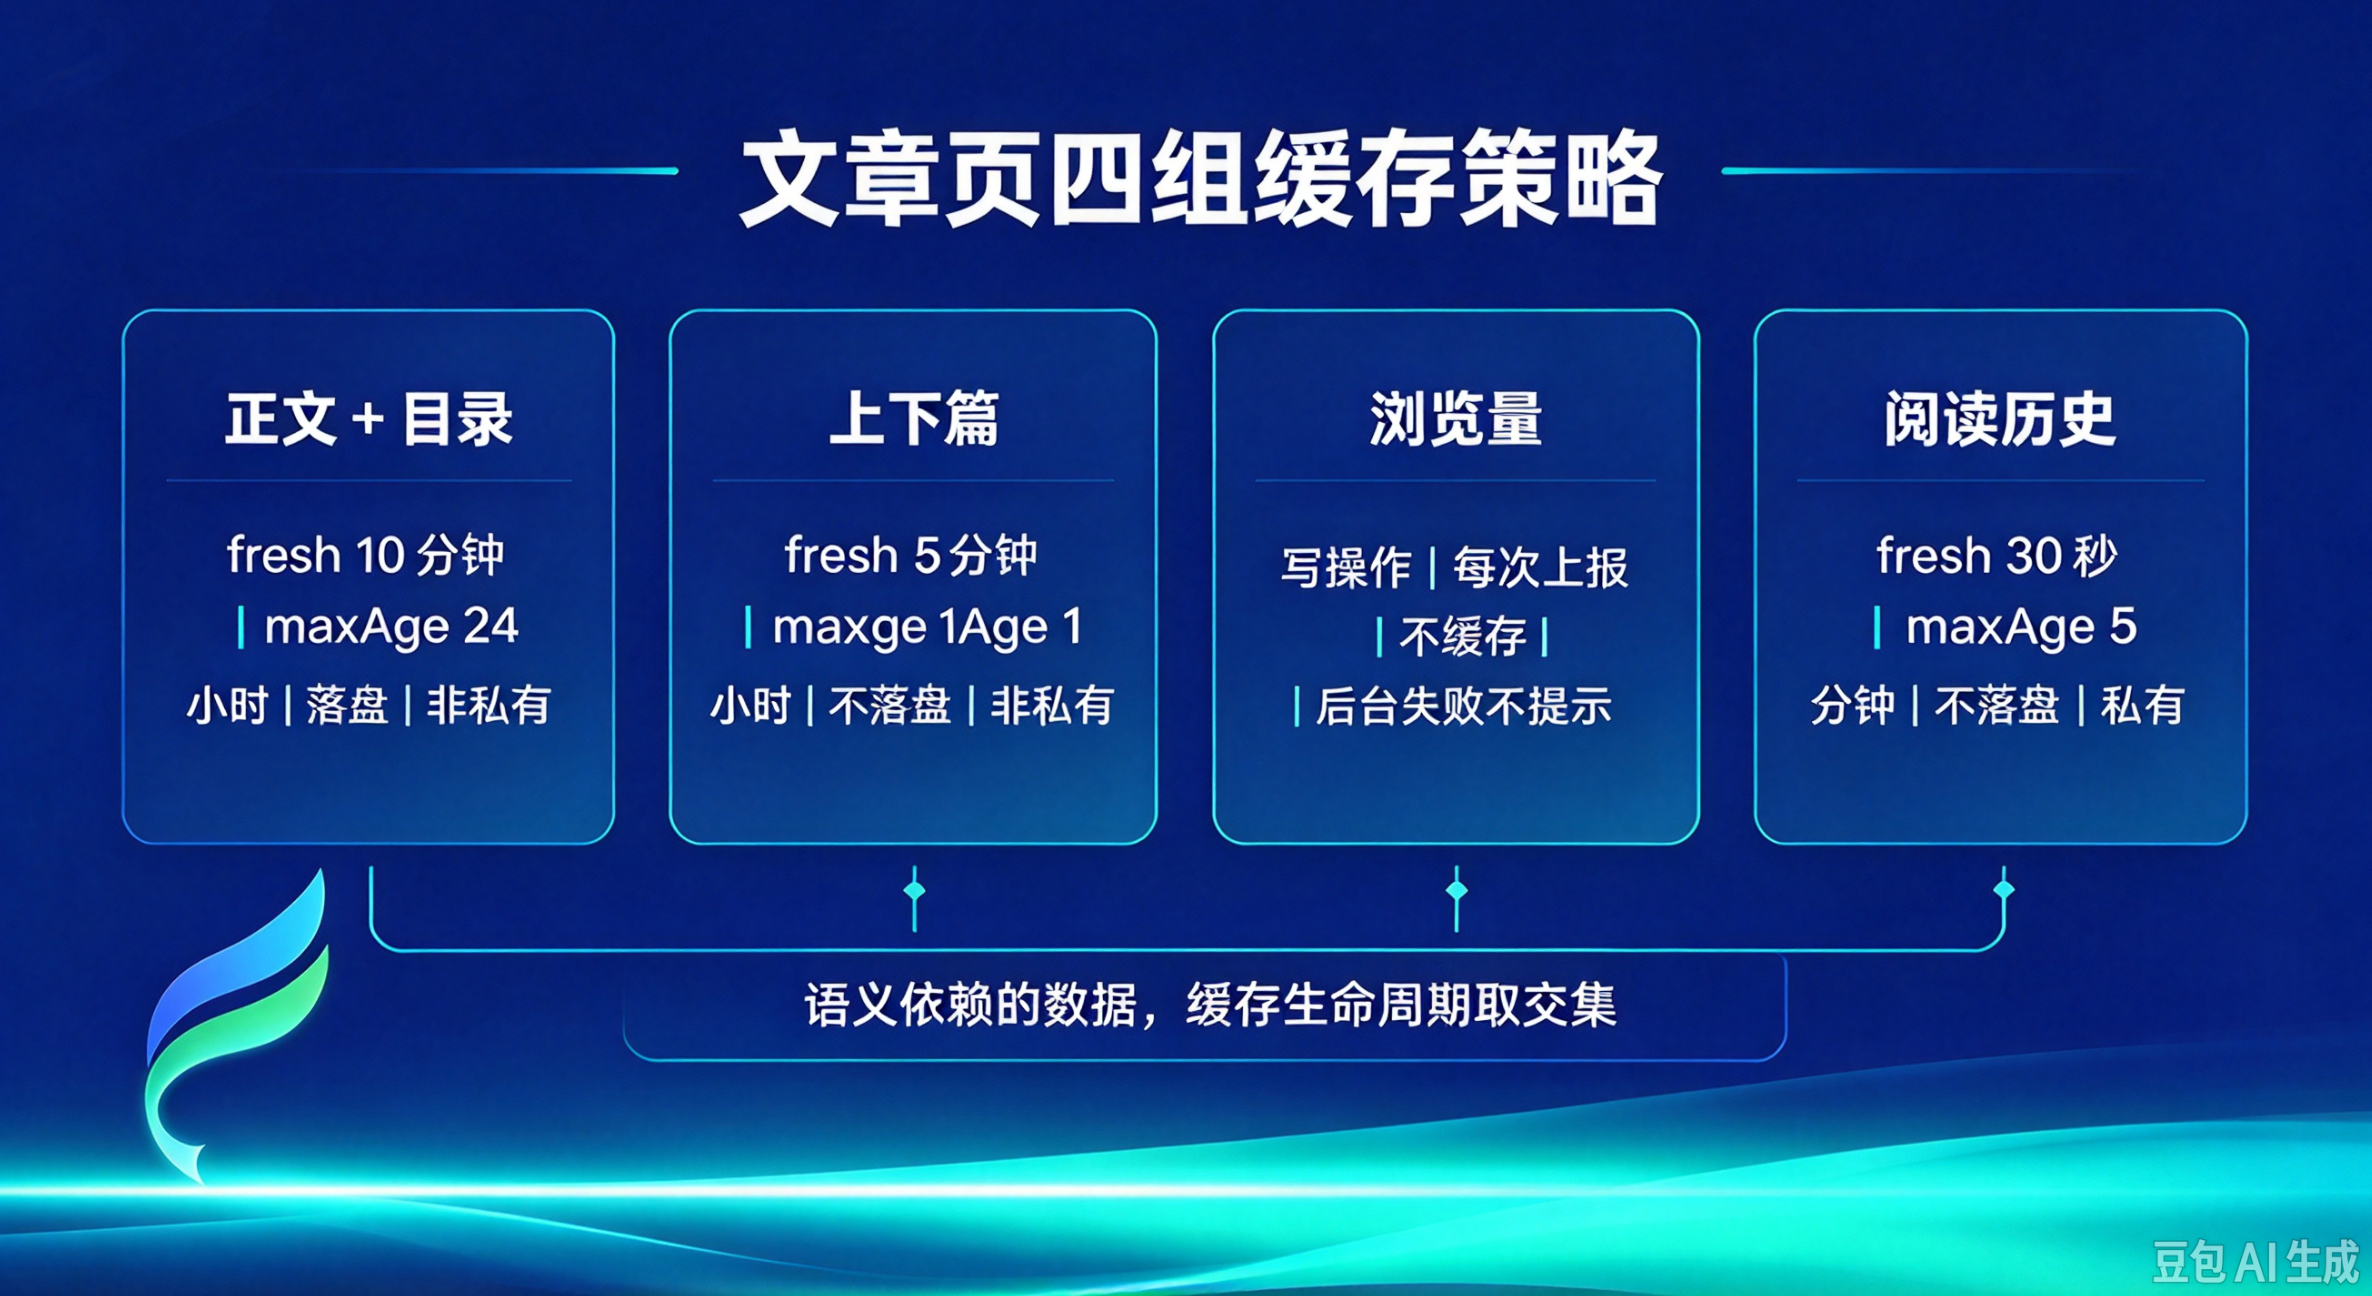
这个判断的通用形式是:当两个数据存在语义依赖时,它们的缓存生命周期应该取交集,而不是各自最优化。
id 与 slug 的别名问题
现在说那个让我想了一会儿的设计。
契约里文章详情是 GET /articles/{idOrSlug},id 和 slug 都接受。这本来是件好事------URL 好看,用户能收藏。
但它带来了一个缓存问题:同一篇文章有两个可能的键。用户在 App 里通过 route 进来看(用的是 slug),而从列表点进来用的是 Article.route(有 slug 用 slug,没有用 id)------看起来一致,但只要有一个地方用了 id,缓存就会分裂成两份。
而且更麻烦的是:用户可能先读 id 版本的缓存,然后从 slug 版本进来,界面上毫无区别,但走了两次网络请求。
现在的解法是一张别名表:
dart
final aliases = <String, String>{};

// id 与 slug 恢复到同一正文键;磁盘别名必须匹配当前 API 环境。
Future<Map<String, dynamic>> read(String id, {bool force = false}) async {
  var canonical = aliases[id] ?? id;
  if (!aliases.containsKey(id) && !force) {
    final persisted = await cache.disk.findKey(
      (key, meta) => matchesAlias(key, meta, id),
    );
    if (persisted != null) {
      canonical = CacheKey.tryParse(persisted)!.path
          .substring(CacheKeys.articlePrefix.length);
    }
  }
  final k = key(CacheKeys.article(canonical), const {});
拆开看这个逻辑:
- 内存里有别名?直接用(
aliases是运行时攒的) - 没有?去磁盘上扫,看有没有一个缓存键指向同一篇文章
- 找到了就把它记进
aliases,之后都走它
关键在第二步那个 cache.disk.findKey。因为App 重启后内存别名就没了,但磁盘缓存还在。这时候如果不做这个扫描,用户重启后进文章,又会重新请求一次。
而 matchesAlias(key, meta, id) 那个判断里有一条关键约束------注释里写着"磁盘别名必须匹配当前 API 环境"。因为开发环境和线上环境的 baseUrl 不同,如果把开发环境的 slug 别名带到线上环境,会把两个环境的缓存搞混。
别名表是内存 + 磁盘双层的 ,而且磁盘那层要校验环境。这听起来像过度设计,但它挡的是一类很难复现的 bug:开发时缓存里全是别名,切到线上环境后突然大量请求,而且原因不明。
别名表在什么时机失效?看 M4-07 里那段:
dart
this.cache.events.listen((e) {
  if (e.kind == 'removed' && e.key.contains(CacheKeys.articlePrefix)) {
    articleReader.aliases.clear();
    this.cache.invalidate({'articleLists'});
  }
});
文章缓存被删除时,别名表也清空。 因为别名指向的正文已经不存在了,再拿着旧别名去查会得到 404。
目录面板:让失效项变灰
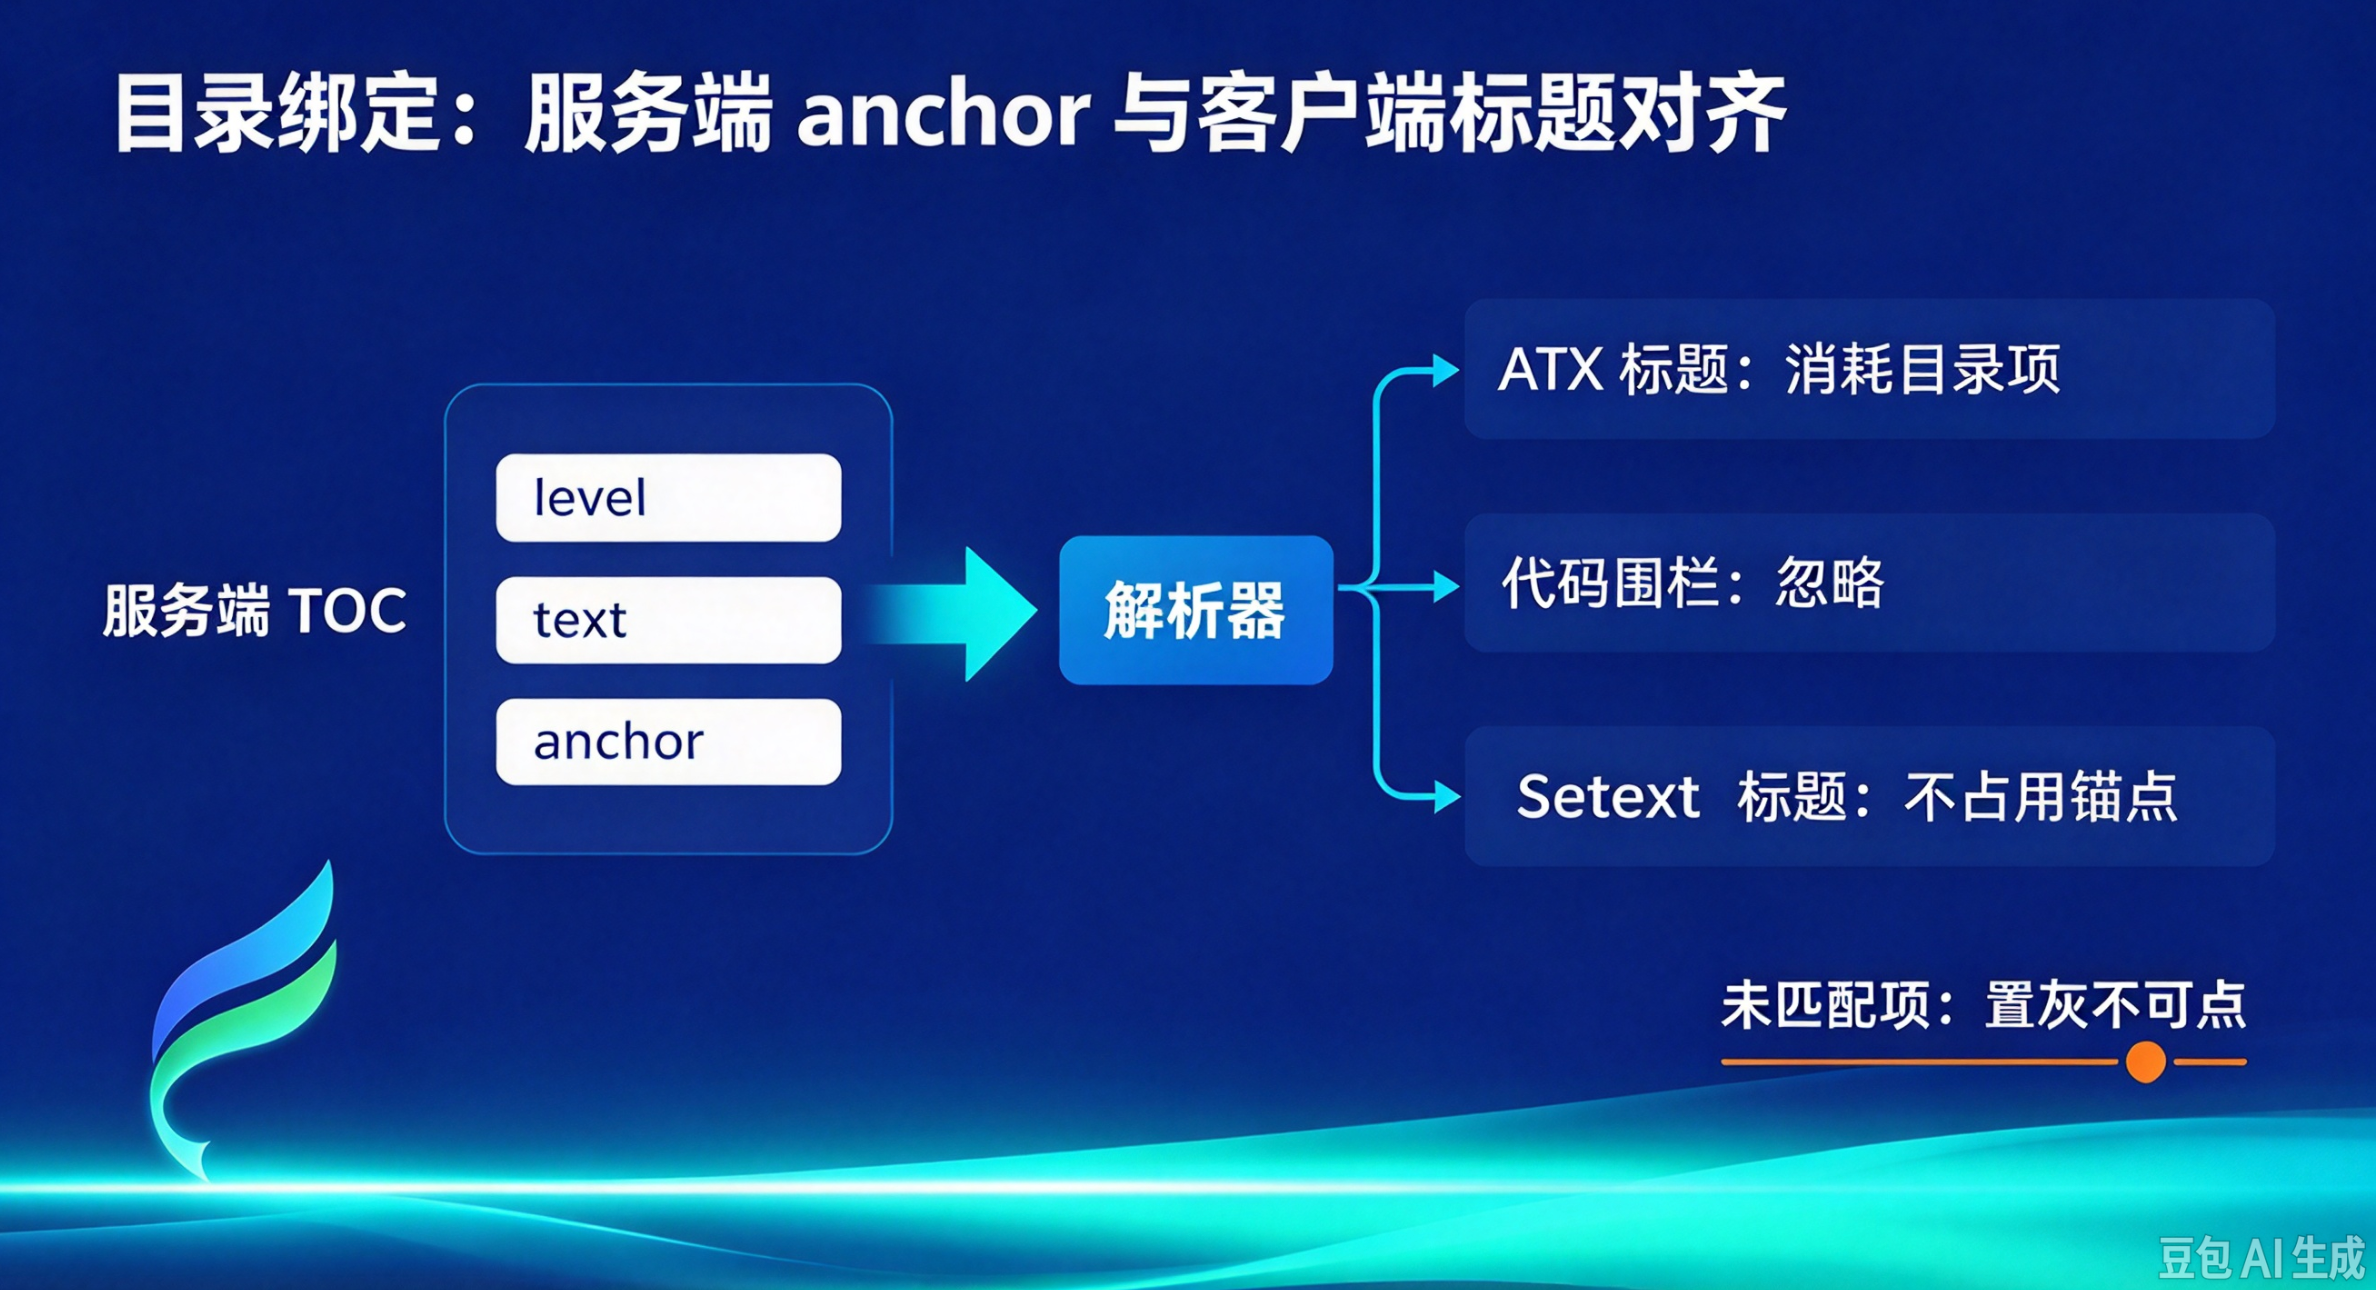
目录面板的实现比我想的有意思。核心是这一行:
dart
enabled: keys[t.anchor]?.currentContext != null,
onTap: () {
  Navigator.pop(c);
  final target = keys[t.anchor]?.currentContext;
  if (target != null) {
    Scrollable.ensureVisible(
      target,
      duration: MediaQuery.disableAnimationsOf(context)
          ? Duration.zero
          : const Duration(milliseconds: 250),
      alignment: .05,
    );
  }
},
enabled: 这个属性做了一件很朴素但很有效的事:锚点没匹配上的目录项,灰掉、不可点。
回到 M4-13 说的那个游标对齐算法------它是"宁可漏也不错"的原则,所以理论上确实可能有标题拿不到 anchor。那么这些目录项该怎么表现?
- 可点但点了没反应 → 用户反复点,以为 App 卡了
- 灰掉不可点 → 用户知道这个跳不了,但不会怪 App
第二种明显更好,而且它只需要一个判断。 这也是 M4-13 那段"宁可让某个标题点不动"的下游兑现------那里的保守选择,在这里变成了 UI 上可见的合理反馈。
if (target != null) 那道检查是双保险:enabled 只影响点击回调的触发,真正的执行时还要再确认一次。因为 onTap 触发到实际执行之间,页面状态可能变了。
而 MediaQuery.disableAnimationsOf(context) 这个判断值得单独说:系统关闭动画时,滚动动画也应该是 0 延时的。
这是无障碍要求的实际应用。有些人因为前庭功能障碍在系统里关掉了动画,App 里如果还播 250ms 的滚动,他们会非常不适。而这个信息是可以从系统读到------不用猜,也不用自己加开关。
alignment: .05 是滚动终点时目标标题离顶部的距离,留一点空隙,别把标题贴在状态栏下面。
上下篇:它不是"上一页下一页"
上一篇和下一篇,听起来简单。实现的时候发现一个定义问题:上一篇是按发布时间倒数的上一条吗?
如果是,那同一分类下的两篇文章之间可能根本没有"上一篇"------用户直接从一个分类跳进来,没有上下文。
所以现在的口径是:用全文流里的相邻文章,而不是分类内的相邻文章。 用户读了一篇《接口设计》,上一篇是《数据建模》,即使这两篇分类完全不同------它们在时间流上是相邻的,而"接着读"这个需求是连续的。
这个决定的代价是:上下篇可能和用户在分类页看到的顺序不一致。 一个从"前端"分类进来的人,看到的上一篇可能是篇 Node 后端文章。
两种口径都有道理,我选了全文流,理由是它总能给出结果。分类口径下前后篇可能都为空,那时候界面就是一个空区域,用户得自己回去找导航。
上下篇的数据来自 adjacent 这个资源家族:
dart
ResourceFamily.adjacent: _ReadRule(
  CachePolicy(Duration(minutes: 5), Duration(hours: 1)),
  _Shape.object,
),五分钟新鲜、一个小时过期,不落盘。理由是它和正文是同一篇的上下文,变化频率接近,但独立请求一次没必要缓存太久。
浏览量:不能重复计,但不能漏
浏览量是写操作,麻烦的地方在于去重和防刷这两个要求是对立的。
不重复计:用户反复进入同一篇文章,不能每次都 +1。
防刷:恶意脚本不能刷。
后端 M1 已经做了防刷------去重 + 24 小时冷却。而客户端要配合的是"同一个用户的同一次阅读,只上报一次"。
关键判断是:这个"一次"是按什么算的?
我最初的实现是进入文章页就上报。结果发现两个问题:
第一,用户从列表点开文章、切到别的 Tab 又切回来------initState 可能重跑,上报两次。
第二,从"上一篇"跳到"下一篇",两篇文章各上报一次,这个是对的;但如果连点两次同一个链接,就会报两次。
现在改成绑定文章 id 的上报记录:
dart
// 具体实现藏在文章页状态里,规则是:
// 同一个 articleId 在本次 App 运行期间只上报一次
这个"本次 App 运行期间"的限定词很重要。它意味着:
- 用户杀 App 重进,再读一遍会再计一次 → 合理,因为这是新的一次阅读
- 用户反复进出同一篇 → 只计一次 → 合理
- 用户换设备读 → 会再计一次 → 接受这个不精确
为什么不做得更精确? 精确意味着要记录"用户在什么位置读到了百分之多少",数据量大了很多,而对内容产品来说收益很小。浏览量的误差容忍度很高,但它必须有一个下界------不能是 0。
浏览量的上报失败不提示用户 。这是个后台行为,失败了用户也无从补救,弹个错误只会让用户困惑。这个判断看起来有点武断,但它体现了一个原则:错误的可见性应该和用户的处置能力匹配。
阅读历史:本地优先,同步兜底
最后一个,也是唯一一个真正需要处理离线的产品功能。
阅读历史的需求有三个:跨设备能看到、离线也能看、不重复记录同一篇文章。
现在的策略是"本机存储 + 登录后同步":
| 场景 | 数据来源 |
|---|---|
| 登录用户在线 | 服务端(权威) |
| 登录用户离线 | 本机(最近同步的) |
| 未登录 | 只有本机 |
服务端那份是权威的,因为它跨设备。本机那份是缓存,让离线可用。
麻烦点在写入。用户读到第 5 页就退出了------这篇文章算读过吗?
现在的口径是:停留超过 20 秒且滚动超过一屏,才记入历史。
这两个条件缺一不可。只有停留时间的话,一个手滑点进来立刻退出的也算;只有滚动的话,用户可能停在第一屏没往下看,那显然不算读完。
20 秒和"一屏"这两个具体数字是可调的,但必须有阈值。一个"打开就记"的阅读历史毫无价值------它会把用户所有点过的文章都记上,包括那些他根本不想看的。
而本机那份要按账号隔离:
dart
// 会话隔离清理不影响公开资源,也不触及按账号保存的投稿草稿。
void resetPrivate() {
  ...
  favoriteIndex.resetFavoriteIndex();
  reactions.clear();
  ...
  cache.invalidate({'private'});
M4-09 讲过这个 resetPrivate。这里体现出来的是:用户 A 退出登录后,A 的阅读历史不能被用户 B 看到。
如果阅读历史没做账号隔离,那就是一个实实在在的隐私问题------同一台手机上切换账号,另一个人能看到你读过什么。而这在共享设备(比如家人的平板)上很容易发生。
这一页的四组缓存策略
把它们放一起看,这篇文章其实没什么业务逻辑,全是策略:
| 功能 | 资源家族 | fresh | maxAge | 落盘 | 私有 |
|---|---|---|---|---|---|
| 正文 + 目录 | article | 10 分钟 | 24 小时 | 是 | 否 |
| 上下篇 | adjacent | 5 分钟 | 1 小时 | 否 | 否 |
| 浏览量上报 | article | --- | --- | --- | --- |
| 阅读历史 | history | 30 秒 | 5 分钟 | 否 | 是 |
四个决策点,每个都有明确的理由:
正文落盘、上下篇不落盘。 正文是用户反复要看的,而且断了网络也要能读;上下篇是顺带功能,离线时看不到无所谓,省下的磁盘空间更值得。
上下篇比正文新鲜期长。 因为它的数据来自同一篇文章的关联查询,服务端不需要额外计算;而它又不常变。
阅读历史不落盘。 私有数据落盘意味着要处理"用户卸载前的数据会不会残留",成本高于收益。
浏览量不走缓存。 它是写请求,每次都要真发。
一条我一开始想省掉的事
阅读历史的"停留 20 秒 + 滚动一屏",我第一版只做了滚动检测。理由是滚动说明用户真的在看,比停留时间靠谱。
结果用户反馈说:有些文章他就想快速扫一遍要点,看到了就退,这种也被记进了历史。
这个反馈让我意识到停留时间不该被当成"次要指标"。快速扫读是真实的阅读行为,它和"点错了立刻返回"在滚动数据上可能很像(都没滚很远),但在时间上差很多。
于是两个条件变成并列关系。而加了时间条件之后的副作用是:用户网络不好、文章加载慢的那 20 秒里可能什么都没看到,但仍会被计入。
这个副作用我知道存在。现在的判断是:这类误差和收益不成比例------误记一次阅读的成本,远低于漏记一次的成本。
同样的权衡在浏览量上也做了:宁可能多计一次,不能少计。
这两处的共同点是:浏览类数据允许有误差,但误差的方向必须是"偏高"。 因为偏低的数据会让人觉得"我的文章没人看",那是真实的问题;偏高只是统计不精确,没人因此受损。
小结
文章页看起来是全项目最简单的一页------它没有表单、没有列表、没有并发写。但实际做完发现,四个小功能里有三个的难度不在实现,在定义:
- 目录和正文必须同版本 ------ 两个有语义依赖的数据,缓存生命周期取交集。
- id/slug 别名要跨重启 ------ 内存别名 + 磁盘扫描,且校验 API 环境。
- 失效的目录项要变灰 ------ 下游的保守选择,需要在上游变成可见的合理反馈。
- 阅读要有阈值 ------ 停留 + 滚动,且接受"偏高"的误差方向。
第二个和第三个尤其值得记。id/slug 别名那个问题在测试环境几乎发现不了,因为测试每次都用同一个 key 进;而"目录项变灰"的价值只有真的发生过锚点失配的人才知道。
还有一条是贯穿全系列的:无障碍不是附加项 。目录滚动动画读系统设置(M4-14),M4-26 讲测试时会看到可访问性的自动化检查。它们都是同一个思路------能用系统提供的信息推断的,就不要自己猜。
下一篇讲 WebView。它和前面所有页面都不同,因为它要在 App 里放一个浏览器。
延伸阅读
- Flutter Markdown 阅读器:支持范围与渲染边界
- Dio + Repository:统一响应信封与模型适配
- 文章阅读辅助:上下篇、面包屑、相关文章与阅读记录
如果这篇文章对你有帮助,欢迎订阅我的 CSDN 专栏 「成为全栈」:
🔗 专栏地址:https://blog.csdn.net/fungleo/category_13204651.html
📦 本系列配套代码仓库:https://github.com/fengcms/become-a-full-stack-developer