感谢关注,一起来学习干货。
上一期(随机森林)我们用 18 张图把一个分类模型完整走了一遍。这期不重复任何一张,只讲 XGBoost 独有、或者在 XGBoost 上最值得讲的内容。数据、划分方式和上期完全一致(700 条、7:3 分层、random_state=10),11 张图里每一张都在回答一个具体问题:树该种多少棵、学习率怎么配、正则化到底压住了什么、七种重要性信谁、单调约束的代价、哪两个特征在联手、模型比随机森林真的强吗、它在哪里下刀。所有「怎么读」都是从这份数据里实际跑出来的数字,不是通用套话。
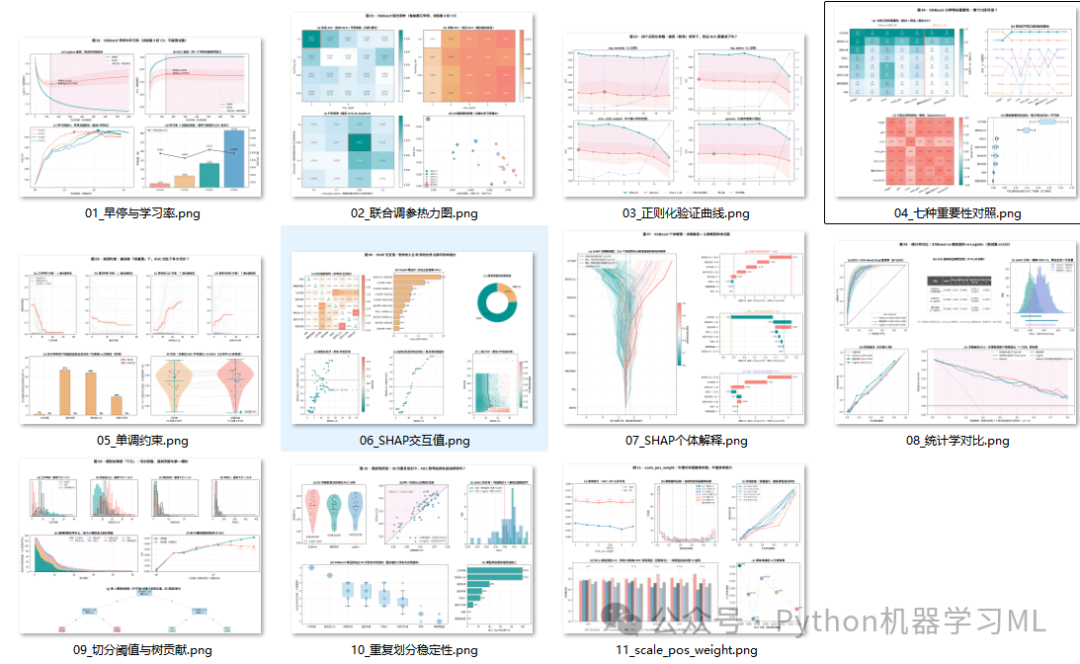
0 · 通用准备
把库、数据、配色一次性配好。后面每张图默认已有 X_train/X_test/y_train/y_test/feats/FEATURE_CN/CS/rf(后面训练好的 XGBoost 命名为 rf,和上一期对齐)。
import numpy as np, pandas as pd, matplotlib.pyplot as plt, matplotlib as mpl
from matplotlib.colors import LinearSegmentedColormap
import xgboost as xgb
from xgboost import XGBClassifier
from sklearn.model_selection import train_test_split, StratifiedKFold, cross_val_predict

mpl.use('Agg')
plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']
plt.rcParams['axes.unicode_minus'] = False

# 和上期同一套配色
CS = {'teal':'#009391','orange':'#EFB47A','purple':'#B3A9ED','bluel':'#C4E3F2',
      'pink':'#F1BFDA','gray':'#DBDBDB','dark':'#525252','red':'#F6847A',
      'blue':'#4194C6','mauve':'#CA87A7','neg':'#009391','pos':'#F6847A'}
CMAP_SEQ  = LinearSegmentedColormap.from_list('seq',  ['#FFFFFF', CS['bluel'], CS['teal']])
CMAP_BLUE = LinearSegmentedColormap.from_list('blues',['#FFFFFF', CS['bluel'], CS['blue']])
CMAP_WARM = LinearSegmentedColormap.from_list('warm', ['#FFFFFF', CS['orange'], CS['red']])
CMAP_RISK = LinearSegmentedColormap.from_list('risk', [CS['teal'], '#FFFFFF', CS['red']])

data = pd.read_csv('数据13.1.csv')
feats = [c for c in data.columns if c != 'credit']
FEATURE_CN = {'age':'年龄','education':'受教育程度','workyears':'工作年限',
              'resideyears':'居住年限','income':'年收入','debtratio':'债务收入比',
              'creditdebt':'信用卡负债','otherdebt':'其他负债'}

X, y = data[feats], data['credit'].astype(int)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, stratify=y, random_state=10)
skf = StratifiedKFold(5, shuffle=True, random_state=10)
dtrain = xgb.DMatrix(X_train, label=y_train)
folds  = list(skf.split(X_train, y_train))
BASE   = dict(objective='binary:logistic', tree_method='hist',
              seed=10, nthread=-1, verbosity=0)
🎯 迁移到自己的数据 :改 3 处 ------ csv 路径、feats(排除目标列)、目标列名 credit。中文名映射 FEATURE_CN 可留可删。
⚠️ 新版 xgboost (≥3.0) 和 shap 包解析 base_score 不兼容。本文全部用 XGBoost 原生接口 booster.predict(..., pred_contribs=True) 和 pred_interactions=True 计算 SHAP 值,不依赖 shap 包。
1 · 早停与学习率:树该种多少棵?
XGBoost 是「一棵接一棵修正残差」,树越多训练误差越低,验证误差会先降后升。CV 曲线能画出这个拐点,顺带回答一个常被含糊的问题:学习率小一点,是不是真的会更准?
p0 = dict(learning_rate=0.05, max_depth=3, subsample=0.85, colsample_bytree=0.85,
          eval_metric=['auc','logloss'], **BASE)
h = xgb.cv(p0, dtrain, num_boost_round=800, folds=folds, verbose_eval=False)
it = np.arange(1, len(h)+1)
best = int(h['test-logloss-mean'].values.argmin()) + 1

fig, axes = plt.subplots(2, 2, figsize=(15, 10))
for ax, met in [(axes[0,0],'logloss'), (axes[0,1],'auc')]:
    for part, c, lab in [('train', CS['teal'], '训练折'), ('test', CS['red'], '验证折')]:
        m, s = h[f'{part}-{met}-mean'].values, h[f'{part}-{met}-std'].values
        ax.plot(it, m, color=c, lw=2, label=lab)
        ax.fill_between(it, m-s, m+s, color=c, alpha=0.15)
    ax.axvline(best, color=CS['dark'], ls='--'); ax.legend()
axes[0,0].set_title('(a) Logloss 曲线:验证折先降后升', fontweight='bold')
axes[0,1].set_title('(b) AUC 曲线:同一个早停点看排序能力', fontweight='bold')

ax = axes[1,0]
for lr, c in zip([0.3, 0.1, 0.05, 0.02], [CS['red'], CS['orange'], CS['teal'], CS['blue']]):
    hh = xgb.cv({**p0, 'learning_rate': lr}, dtrain,
                num_boost_round=1500 if lr<0.05 else 800, folds=folds, verbose_eval=False)
    ll = hh['test-logloss-mean'].values; b = int(ll.argmin())+1
    ax.plot(np.arange(1, len(hh)+1), hh['test-auc-mean'], color=c, lw=1.8, label=f'lr={lr}')
    ax.scatter([b], [hh['test-auc-mean'].values[b-1]], color=c, s=90, edgecolor=CS['dark'])
ax.set_xscale('log'); ax.legend(); ax.set_title('(c) 学习率越小,早停点越靠后', fontweight='bold')

plt.suptitle('图 01 · 早停与学习率(5 折 CV,不碰测试集)', fontsize=15, fontweight='bold')
plt.tight_layout(rect=[0,0,1,0.96])
plt.savefig('01_早停与学习率.png', dpi=150, bbox_inches='tight')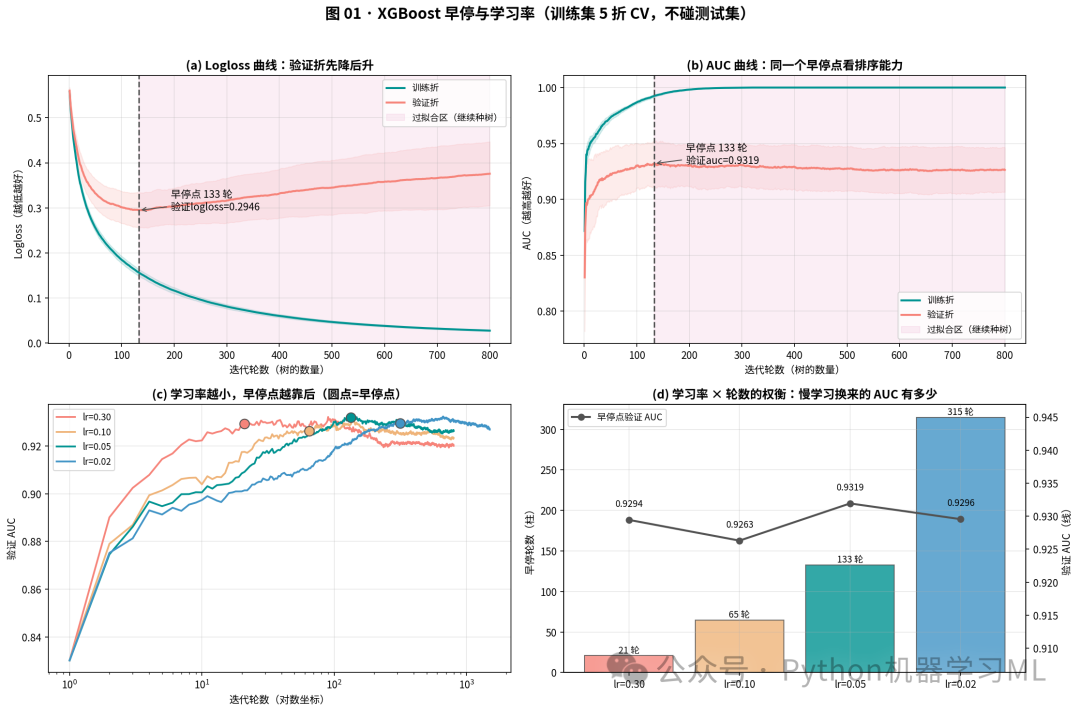
图 1 · 早停点在 lr=0.05 时落在 133 轮
怎么读:
-
(a) 验证 logloss 的拐点
:lr=0.05 时在 133 轮附近触底(0.295),之后一路反弹到 800 轮的 0.37;训练 logloss 却持续降到接近 0;这就是过拟合区。
-
(b) AUC 也在同一个拐点
:验证 AUC 在 133 轮触顶 0.932,继续种到 800 轮不升反降(0.926);训练 AUC 已经锁在 1.000,说明模型已经完全记住了训练折。
-
(c) 四种学习率的早停位置
:lr=0.3 只需 21 轮,lr=0.02 要 315 轮,但触顶的验证 AUC 都在 0.929~0.932 之间;慢学习换来的 AUC 增量在小数点后第三位。
-
(d) 决策建议
:这类规模的数据,lr=0.05 ~ 0.1 配合早停就够了;不是越慢越好,是「慢学习 + 早停 + 更多轮数」要配合使用才有意义。
2 · 联合调参:learning_rate × max_depth
每个格子都用早停自己决定树的数量,比较的是「各自最好状态下」的验证 AUC。再并排画一张「训练 AUC − 验证 AUC」的热力图,就不会被单一指标误导。
from sklearn.model_selection import cross_val_score

def cv(params, rounds, early=None):
    return xgb.cv({**BASE, **params, 'eval_metric':['auc','logloss']},
                  dtrain, num_boost_round=rounds, folds=folds,
                  early_stopping_rounds=early, verbose_eval=False)

lr_list, dp_list = [0.02, 0.05, 0.1, 0.2], [2, 3, 4, 5, 6]
A, G = np.zeros((len(lr_list), len(dp_list))), np.zeros_like(A)
for i, lr in enumerate(lr_list):
    for j, d in enumerate(dp_list):
        h = cv(dict(learning_rate=lr, max_depth=d,
                    subsample=0.85, colsample_bytree=0.85), 3000, early=50)
        last = h.iloc[-1]
        A[i,j] = last['test-auc-mean']
        G[i,j] = last['train-auc-mean'] - last['test-auc-mean']

bi, bj = np.unravel_index(np.argmax(A), A.shape)
fig, axes = plt.subplots(1, 2, figsize=(14, 5))
im0 = axes[0].imshow(A, cmap=CMAP_SEQ, origin='lower'); axes[0].grid(False)
im1 = axes[1].imshow(G, cmap=CMAP_WARM, origin='lower'); axes[1].grid(False)
for ax, M, fmt in [(axes[0], A, '%.4f'), (axes[1], G, '%.3f')]:
    for i in range(len(lr_list)):
        for j in range(len(dp_list)):
            ax.text(j, i, fmt % M[i,j], ha='center', va='center',
                    fontsize=9, color=CS['dark'])
    ax.set_xticks(range(len(dp_list))); ax.set_xticklabels(dp_list)
    ax.set_yticks(range(len(lr_list))); ax.set_yticklabels(lr_list)
    ax.set_xlabel('max_depth'); ax.set_ylabel('learning_rate')
axes[0].set_title('(a) 验证 AUC(红框=最优)', fontweight='bold')
axes[1].set_title('(b) 训练 AUC − 验证 AUC(越红越过拟合)', fontweight='bold')
fig.colorbar(im0, ax=axes[0]); fig.colorbar(im1, ax=axes[1])
plt.suptitle('图 02 · XGBoost 联合调参', fontsize=15, fontweight='bold')
plt.tight_layout()
plt.savefig('02_联合调参热力图.png', dpi=150, bbox_inches='tight')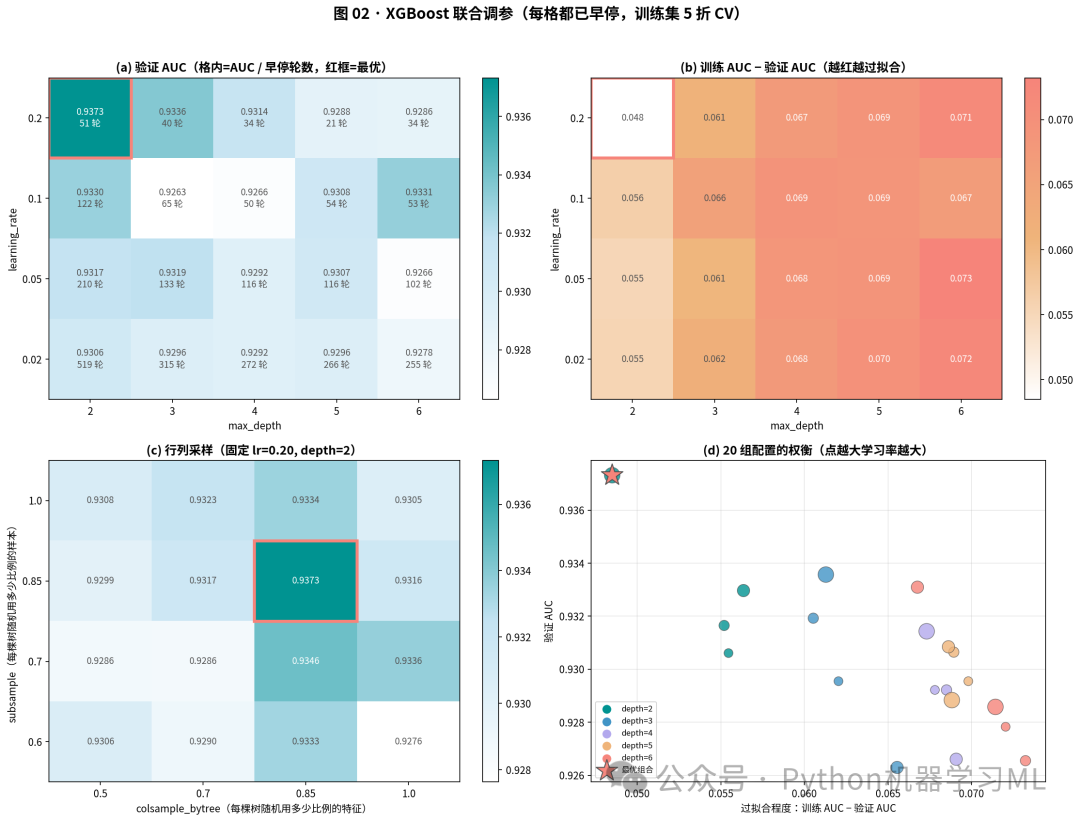
图 2 · 不只看最高 AUC,还要看过拟合程度
怎么读:
-
(a) 最优格子位置
:lr=0.2、max_depth=2 时 CV AUC 0.9373 ,只用 51 轮;网格里 20 组配置的 AUC 全在 0.926~0.937 之间,差距不到 1.5 个千分点。
-
(b) 过拟合程度随深度飙升
:最优格子的训练-验证差只有 0.048 ,但 lr=0.2、depth=6 的格子差距涨到 0.071 ------ 验证 AUC 不升反降。
-
(c) 决策
:表格数据上,**浅树(depth=2~3)**往往就够了,并不是越深越好;再搭配行列采样(这里都是 0.85)能把方差再压一些。
-
(d) 配合图 1
:lr 大但 depth 小的配置,早停轮数会很少(51 轮)------ 这其实比 lr=0.02 跑 500 轮更稳也更快。
3 · 正则化:lambda / alpha / min_child_weight / gamma
这四个参数是 XGBoost 相比普通 GBDT 多出来的「刹车」。每个参数单独扫描一遍,看训练-验证的差距(粉色填充)能被压缩到什么程度,验证 AUC 跟不跟得上。
params = {'learning_rate':0.2, 'max_depth':2, 'subsample':0.85, 'colsample_bytree':0.85}
specs = [('lambda', [0,0.5,1,2,5,10,20,50], 1),
         ('alpha',  [0,0.1,0.5,1,2,5,10], 0),
         ('min_child_weight', [1,2,3,5,8,12,20], 1),
         ('gamma', [0,0.1,0.3,0.5,1,2,5], 0)]
fig, axes = plt.subplots(2, 2, figsize=(14, 10))
for ax, (key, vals, dft) in zip(axes.ravel(), specs):
    tr, va = [], []
    for v in vals:
        h = cv({**params, key: v}, 3000, early=50).iloc[-1]
        tr.append(h['train-auc-mean']); va.append(h['test-auc-mean'])
    tr, va = np.array(tr), np.array(va); x = np.arange(len(vals))
    ax.plot(x, tr, 'o-', color=CS['teal'], label='训练 AUC')
    ax.plot(x, va, 's-', color=CS['red'],  label='验证 AUC')
    ax.fill_between(x, va, tr, color=CS['pink'], alpha=0.3, label='差距')
    ax.axvline(vals.index(dft), color=CS['gray'], ls=':', label='默认值')
    ax.set_xticks(x); ax.set_xticklabels([str(v) for v in vals])
    ax.set_title(key, fontweight='bold'); ax.legend(fontsize=8)
plt.suptitle('图 03 · 四个正则化参数', fontsize=15, fontweight='bold')
plt.tight_layout()
plt.savefig('03_正则化验证曲线.png', dpi=150, bbox_inches='tight')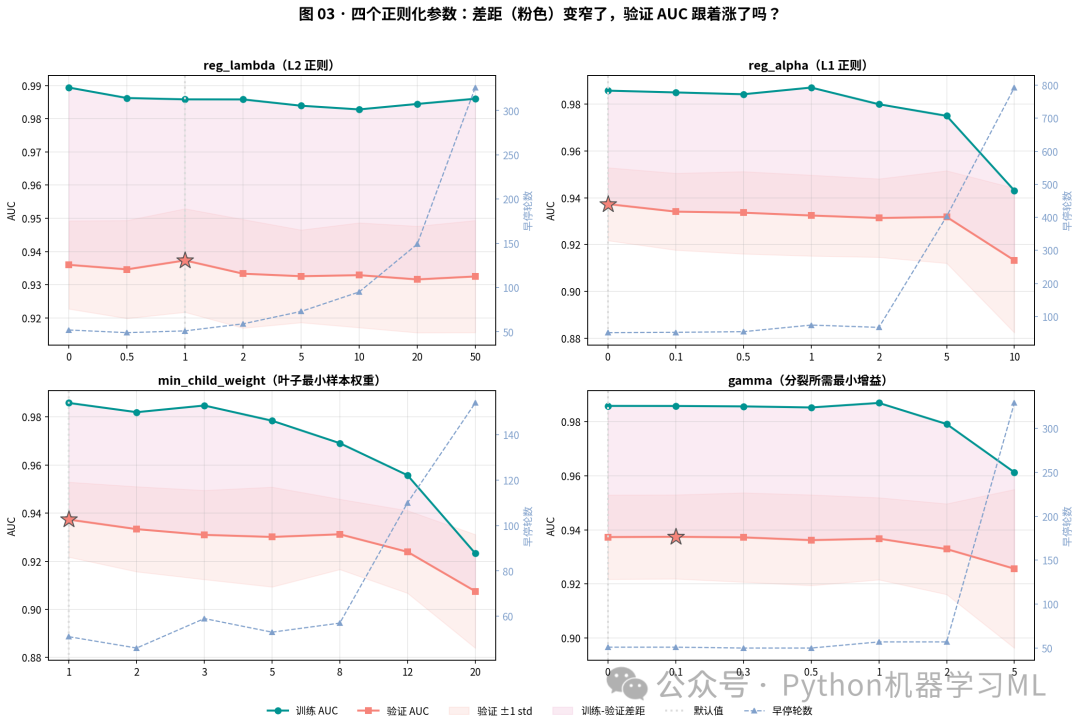
图 3 · 四条曲线都在说同一句话
怎么读:
-
默认值已经在最优附近
:四个参数的最优 AUC 都是 0.9373(gamma 为 0.9374),和默认值的 AUC 完全相同。
-
压差距 ≠ 涨 AUC
:min_child_weight 一路加大,训练-验证差距从 0.049 压到 0.016,验证 AUC 却从 0.937 掉到 0.908。正则化只有在模型本来过拟合时才有收益。
-
为什么这里不生效
:因为图 2 已经把深度压到 2,模型本来就不复杂,再加正则化等于在压一个已经被压过的东西。
-
决策
:这份数据直接用默认值 就好。做 XGBoost 调参,先定深度和学习率,再看是否需要正则化;顺序反过来容易白调。
4 · 七种特征重要性:到底该信哪个
XGBoost 内置就有 5 种重要性(weight / gain / cover / total_gain / total_cover),再加上模型无关的置换重要性和 SHAP,一共七种。这张图回答:这些口径之间差多少?哪个结果可信?
from sklearn.inspection import permutation_importance

# 先把模型训练好(后面所有图都用它,命名为 rf 对齐上一期)
rf = XGBClassifier(n_estimators=51, learning_rate=0.2, max_depth=2,
                   subsample=0.85, colsample_bytree=0.85, objective='binary:logistic',
                   tree_method='hist', random_state=10, n_jobs=-1,
                   eval_metric='logloss').fit(X_train, y_train)

booster = rf.get_booster()
imp = {}
for t in ['weight','gain','cover','total_gain','total_cover']:
    sc = booster.get_score(importance_type=t)
    imp[t] = np.array([sc.get(f, 0.0) for f in feats])
perm = permutation_importance(rf, X_test, y_test, n_repeats=30,
                              scoring='roc_auc', random_state=10, n_jobs=-1)
imp['置换(测试AUC)'] = perm.importances_mean

# 原生 TreeSHAP(不依赖 shap 包)
contrib = booster.predict(xgb.DMatrix(X_test), pred_contribs=True)
sv = contrib[:, :-1]
imp['mean|SHAP|'] = np.abs(sv).mean(0)

D = pd.DataFrame(imp, index=feats)
R = D.rank(ascending=False).astype(int)
order = D['mean|SHAP|'].sort_values(ascending=False).index.tolist()
Dn = D / D.max()

fig, axes = plt.subplots(1, 2, figsize=(14, 6))
im = axes[0].imshow(Dn.loc[order].values, cmap=CMAP_SEQ, vmin=0, vmax=1)
axes[0].grid(False)
for i, f in enumerate(order):
    for j, mt in enumerate(D.columns):
        axes[0].text(j, i, f"#{R.loc[f, mt]}\n{Dn.loc[f, mt]:.2f}", ha='center',
                     va='center', fontsize=8.5, color=CS['dark'])
axes[0].set_xticks(range(len(D.columns)))
axes[0].set_xticklabels(D.columns, rotation=25, ha='right')
axes[0].set_yticks(range(len(order)))
axes[0].set_yticklabels([FEATURE_CN[f] for f in order])

bp = axes[1].boxplot(perm.importances[np.argsort(perm.importances_mean)].T,
                     vert=False, patch_artist=True, showfliers=False)
for p in bp['boxes']: p.set_facecolor(CS['bluel'])
axes[1].axvline(0, color=CS['red'], ls='--')
axes[1].set_yticklabels([FEATURE_CN[feats[i]] for i in np.argsort(perm.importances_mean)])
plt.suptitle('图 04 · 七种特征重要性', fontsize=15, fontweight='bold')
plt.tight_layout()
plt.savefig('04_七种重要性对照.png', dpi=150, bbox_inches='tight')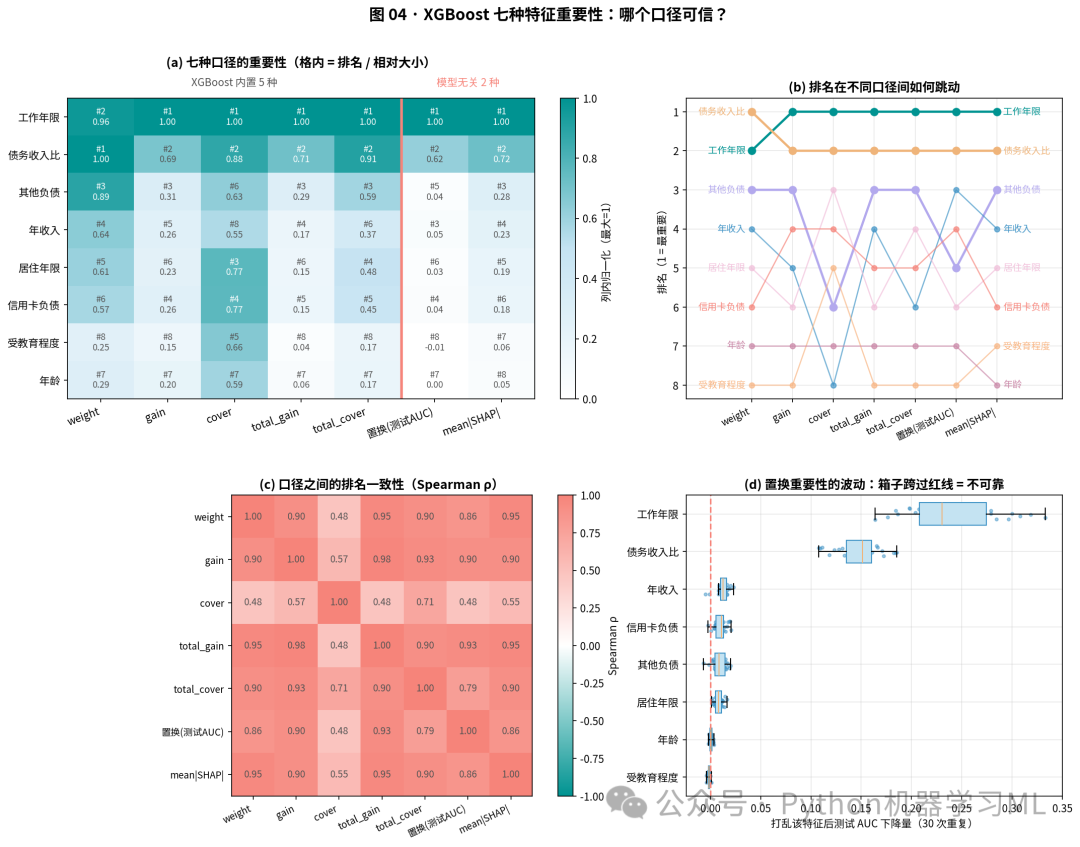
图 4 · 7 种口径同屏对齐
怎么读:
-
工作年限、债务收入比稳居前二
:所有七种口径里,这两个特征都是 #1 或 #2,是「铁打」的关键变量。
-
cover 口径是异类
:它和 SHAP 的 Spearman ρ 只有 0.55 ,和其它内置口径一致性也最低(0.48~0.71);不要用 cover 做选变量的依据。
-
weight / gain / total_gain 和 SHAP 高度一致
:Spearman ρ 分别是 0.95 / 0.90 / 0.95,用其中任意一个都能得到类似结论。
-
置换重要性的误差棒
:年龄、受教育程度的 95% 置信区间都跨过 0,意味着这两列对测试集 AUC 没有稳定贡献 ------ 做精简模型时首先考虑删这两列。
5 · 单调约束:把业务先验写进模型
无约束的树模型可能学出「债务收入比从 20 涨到 22,违约概率反而下降」这种锯齿,在风控、医学场景里很难向业务和审稿人解释。monotone_constraints 可以强制方向,这张图回答:曲线能变多直?AUC 代价多少?
MONO = {'workyears':-1, 'resideyears':-1, 'debtratio':1, 'creditdebt':1}
cons = '(' + ','.join(str(MONO.get(f, 0)) for f in feats) + ')'
rf_mono = XGBClassifier(n_estimators=51, learning_rate=0.2, max_depth=2,
                        subsample=0.85, colsample_bytree=0.85,
                        objective='binary:logistic', tree_method='hist',
                        monotone_constraints=cons, random_state=10, n_jobs=-1,
                        eval_metric='logloss').fit(X_train, y_train)

from sklearn.inspection import partial_dependence
from sklearn.model_selection import RepeatedStratifiedKFold, cross_val_score

fig, axes = plt.subplots(1, 4, figsize=(18, 4.5))
rng = np.random.default_rng(10)
sub = X_train.iloc[rng.choice(len(X_train), 200, replace=False)]
for ax, f in zip(axes, MONO):
    grid = np.unique(np.quantile(X_train[f], np.linspace(0.02, 0.98, 30)))
    for mdl, c, lab in [(rf, CS['orange'], '无约束'), (rf_mono, CS['red'], '单调约束')]:
        pdp = partial_dependence(mdl, sub, [f], kind='both',
                                 custom_values={f: grid})
        if mdl is rf:
            for line in pdp['individual'][0][:40]:
                ax.plot(grid, line, color=CS['gray'], lw=0.6, alpha=0.6)
        ax.plot(grid, pdp['average'][0], color=c, lw=2.5, label=lab)
    ax.set_title(FEATURE_CN[f]); ax.set_ylim(0, 1)
    if f == list(MONO)[0]: ax.legend(fontsize=8)
plt.suptitle('图 05 · 单调约束前后的 PDP+ICE', fontsize=15, fontweight='bold')
plt.tight_layout()
plt.savefig('05_单调约束.png', dpi=150, bbox_inches='tight')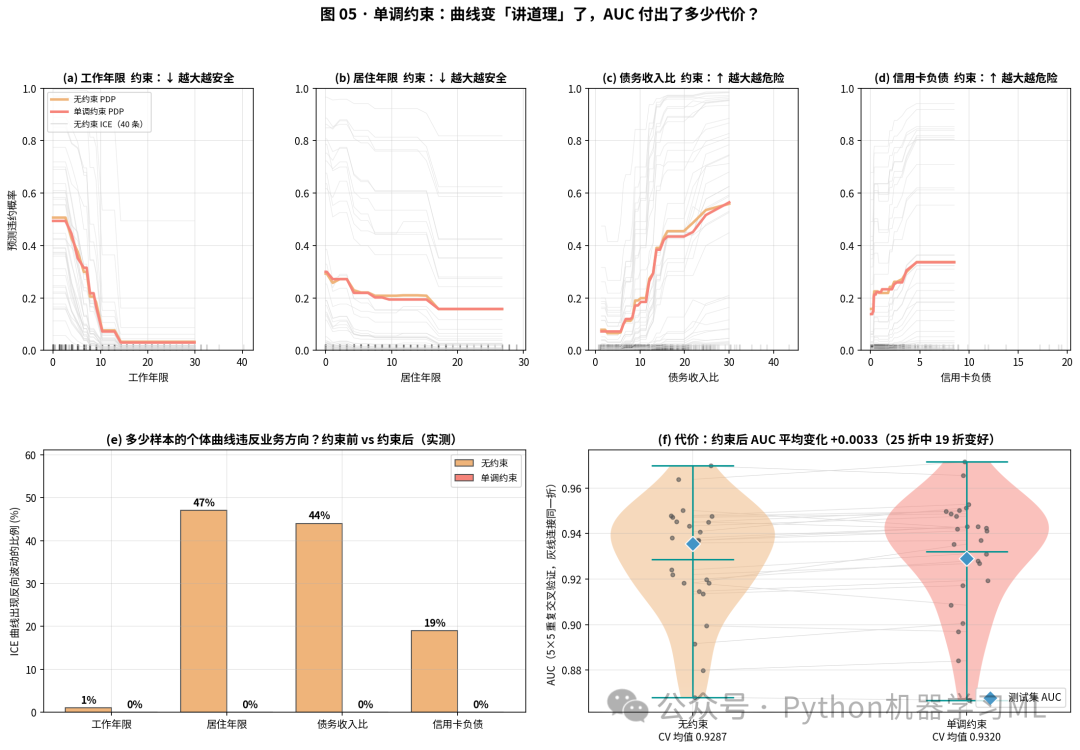
图 5 · 约束前后对比 + 实测违反率 + CV AUC 代价
怎么读:
-
无约束模型的违反率非常高
:居住年限 47% 、债务收入比 44% 、信用卡负债 19% 的 ICE 曲线存在反方向波动。
-
约束后实测为 0%
(不是口头保证,是重新统计 ICE 得出的);曲线从锯齿变成严格单调,可以直接写进业务规则。
-
代价很小
:5×5 重复交叉验证下,约束后 CV AUC 从 0.9287 → 0.9320 (+0.003),25 折中有 19 折变好。
-
测试集这一次
:AUC 从 0.9356 掉到 0.9290(−0.007)。CV 多数更好、测试单次略差,意味着差异在样本波动的范围内 ------ 这是「强烈推荐加约束」的场景。
6 · SHAP 交互值:哪两个特征在联手
TreeSHAP 可以把每个样本的预测精确拆成「主效应 + 两两交互」。pred_interactions 返回一个 n×(p+1)×(p+1) 矩阵:对角线是主效应,非对角线对称两个元素相加就是成对交互强度。
iv = booster.predict(xgb.DMatrix(X_test), pred_interactions=True)[:, :-1, :-1]
p = len(feats)
A = np.abs(iv).mean(0)
P = A * 2.0;  np.fill_diagonal(P, np.nan)
main = np.diag(A)
pairs = sorted([(P[i,j], i, j) for i in range(p) for j in range(i+1, p)], reverse=True)
share = np.nansum(P)/2 / (np.nansum(P)/2 + main.sum())

fig, axes = plt.subplots(1, 3, figsize=(18, 5))
im = axes[0].imshow(np.where(np.eye(p, dtype=bool), np.nan, P), cmap=CMAP_WARM)
axes[0].grid(False)
for i in range(p):
    for j in range(p):
        if i == j:
            axes[0].text(j, i, f"主\n{main[i]:.2f}", ha='center', va='center',
                         color=CS['teal'], fontsize=8, fontweight='bold')
        else:
            axes[0].text(j, i, f"{P[i,j]:.3f}", ha='center', va='center',
                         fontsize=8, color=CS['dark'])
axes[0].set_xticks(range(p)); axes[0].set_xticklabels([FEATURE_CN[f] for f in feats], rotation=40, ha='right')
axes[0].set_yticks(range(p)); axes[0].set_yticklabels([FEATURE_CN[f] for f in feats])

top = pairs[:10][::-1]
axes[1].barh(range(len(top)), [t[0] for t in top], color=CS['orange'])
axes[1].set_yticks(range(len(top)))
axes[1].set_yticklabels([f"{FEATURE_CN[feats[a]]}×{FEATURE_CN[feats[b]]}" for _,a,b in top])

f1, f2 = feats[pairs[0][1]], feats[pairs[0][2]]
sc = axes[2].scatter(X_test[f1], iv[:, pairs[0][1], pairs[0][2]]*2,
                     c=X_test[f2], cmap=CMAP_RISK, s=25, edgecolor=CS['dark'])
axes[2].axhline(0, color=CS['dark']); fig.colorbar(sc, ax=axes[2], label=FEATURE_CN[f2])
axes[2].set_xlabel(FEATURE_CN[f1]); axes[2].set_ylabel(f"{FEATURE_CN[f1]}×{FEATURE_CN[f2]} 交互 SHAP")

plt.suptitle(f'图 06 · SHAP 交互值(交互占贡献 {share:.0%})', fontsize=15, fontweight='bold')
plt.tight_layout()
plt.savefig('06_SHAP交互值.png', dpi=150, bbox_inches='tight')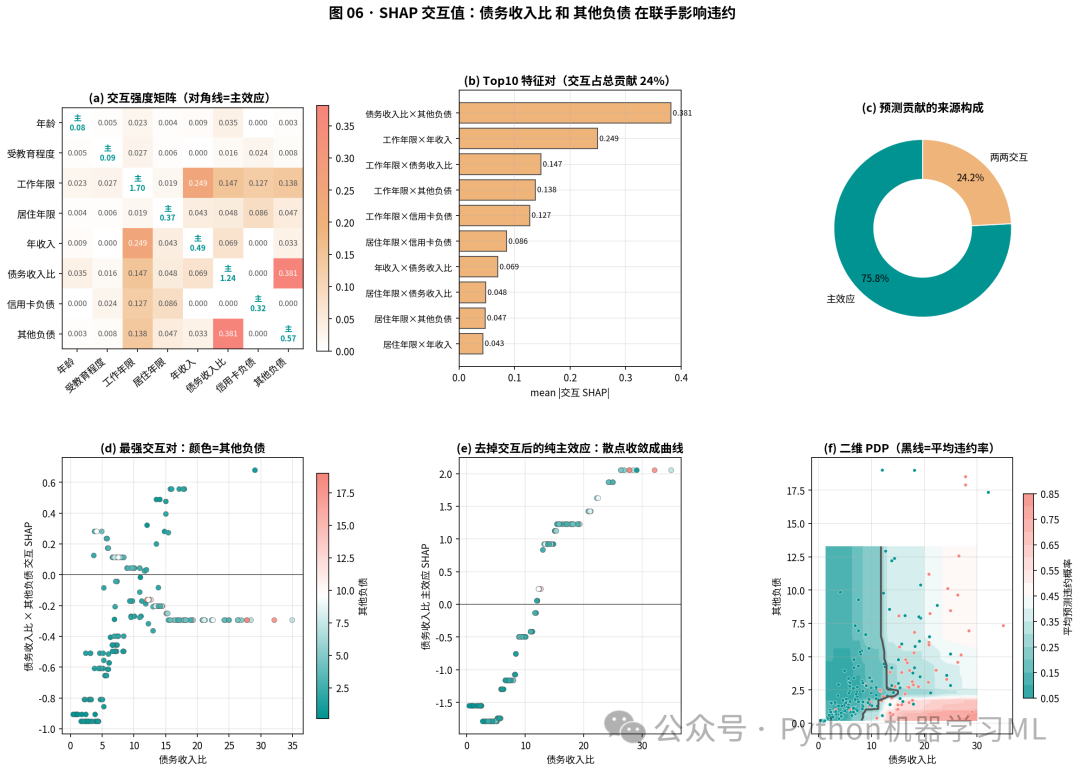
图 6 · 交互强度矩阵 + Top10 特征对 + 最强交互对散点
怎么读:
-
主效应主导、交互显著
:主效应占 75.8% ,两两交互占 24.2%。这不是「可以忽略」的量级,而是必须在解释时承认的部分。
-
最强交互对
:债务收入比 × 其他负债,mean |交互 SHAP| = 0.381,远超第二名工作年限×年收入(0.249)。
-
怎么看最强交互散点
:债务收入比低时颜色(其他负债)对结果影响不大;但债务收入比超过 15 后,其他负债高(粉色)会显著推高违约概率。
-
决策
:业务规则不要只看单变量阈值;两个「负债类」特征存在明显联动,可以考虑在风控策略里设置「组合卡」。
7 · 个体解释:决策路径 + 三类典型样本
决策路径图:每条线是一个测试样本,从基准对数几率出发,按重要性依次加上每个特征的 SHAP 值,最后落在该样本的预测上。再挑出「正确识别 / 漏判 / 误拒」三类代表做瀑布图。
def sigmoid(z): return 1.0 / (1.0 + np.exp(-z))

contrib = booster.predict(xgb.DMatrix(X_test), pred_contribs=True)
sv, base = contrib[:, :-1], float(contrib[0, -1])
logit = base + sv.sum(1); prob = sigmoid(logit)
t = 0.37  # 训练集 OOF 上按 F1 最大选出的阈值
pred = (prob >= t).astype(int); yv = y_test.values

order = np.argsort(np.abs(sv).mean(0))
path = np.hstack([np.full((len(sv),1), base), base + np.cumsum(sv[:, order], axis=1)])

tp = np.where((yv==1)&(pred==1))[0]
fn = np.where((yv==1)&(pred==0))[0]
fp = np.where((yv==0)&(pred==1))[0]

fig, ax = plt.subplots(figsize=(10, 7))
ys = np.arange(len(feats)+1)
for i in np.argsort(prob):
    ax.plot(path[i], ys, color=CMAP_RISK(prob[i]), lw=0.8, alpha=0.5)
for idx, c, lab in [(tp[np.argmax(prob[tp])], CS['red'], '正确识别违约'),
                    (fn[np.argmin(prob[fn])], CS['orange'], '漏判'),
                    (fp[np.argmax(prob[fp])], CS['purple'], '误拒')]:
    ax.plot(path[idx], ys, color=c, lw=3, label=f"{lab} p={prob[idx]:.2f}")
ax.axvline(base, color=CS['dark'], ls='--', label=f'基准 {base:.2f}')
ax.axvline(np.log(t/(1-t)), color=CS['dark'], ls=':', label=f'阈值 {t:.2f}')
ax.set_yticks(ys); ax.set_yticklabels(['基准值'] + [FEATURE_CN[feats[k]] for k in order])
ax.set_xlabel('累计对数几率(越右越可能违约)'); ax.legend(fontsize=9)
plt.title('图 07 · SHAP 决策路径图', fontweight='bold')
plt.savefig('07_SHAP个体解释.png', dpi=150, bbox_inches='tight')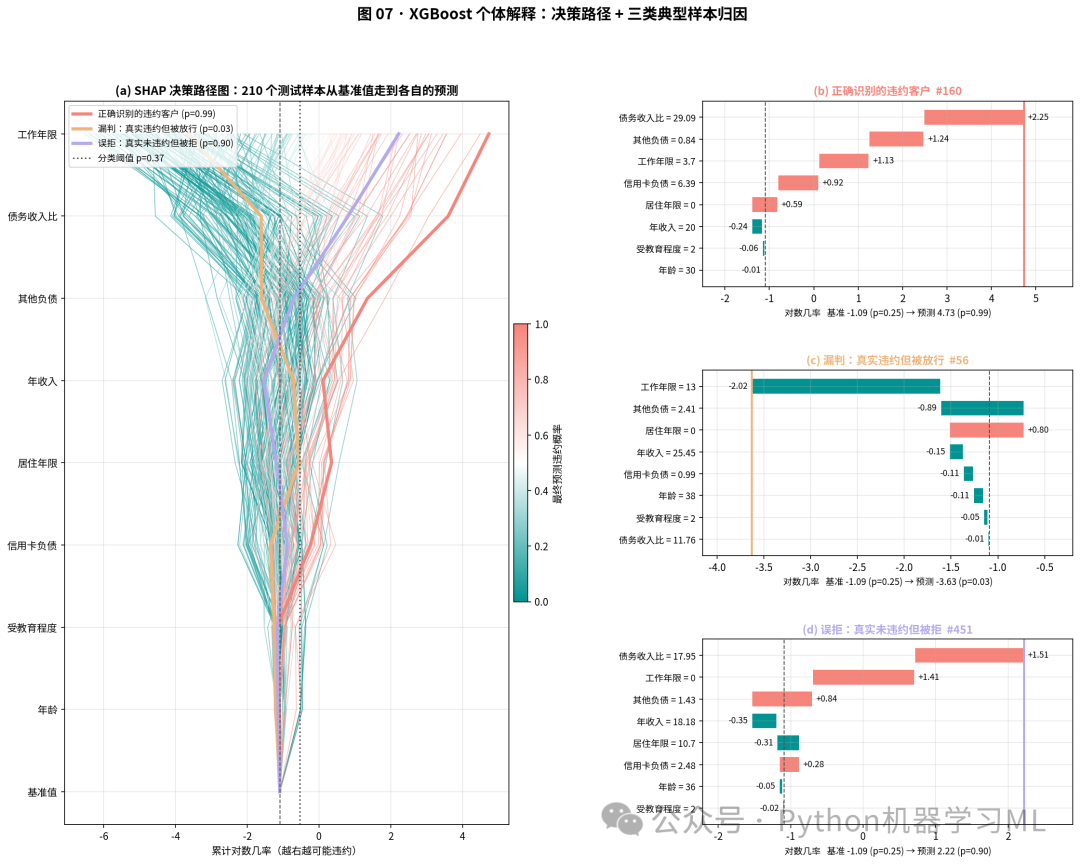
图 7 · 决策路径图 + 三个典型样本的瀑布图
怎么读:
-
基准值 = 训练集违约对数几率
:这里是 −1.09(对应 25.1% 违约概率)。每条线从这个点出发。
-
最高风险样本 #160
(p=0.99):债务收入比 29.09 贡献 +2.25,其他负债 0.84 贡献 +1.24,工作年限 3.7 贡献 +1.13,三项合计把概率从 25% 拉到 99%。
-
漏判样本 #56
(真实违约但 p=0.03):工作年限 13 年贡献 −2.02,几乎单枪匹马把这个客户拉回「安全区」------ 这就是模型的知识盲区:工作年限太长的客户再怎么负债,模型也不信他会违约。
-
误拒样本 #451
(真实未违约但 p=0.90):工作年限 0 年 + 债务收入比 17.95,模型拒得合理 ------ 有些误拒是数据分布造成的,不是模型的错,这类样本应该标记为「灰区人工复审」。
8 · 统计学对比:XGBoost 真的比随机森林强吗?
审稿人最常问的问题。四件事一张图:带 95% Bootstrap 置信带的 ROC、DeLong 检验、配对 Bootstrap ΔAUC 分布、校准曲线 + Brier、决策曲线 DCA。
from scipy.stats import norm
from sklearn.ensemble import RandomForestClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import roc_auc_score, roc_curve, brier_score_loss
from sklearn.calibration import calibration_curve

rfc = RandomForestClassifier(n_estimators=300, max_features='sqrt', class_weight='balanced',
                             random_state=10, n_jobs=-1).fit(X_train, y_train)
lr  = make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000)).fit(X_train, y_train)
probs = {'XGBoost': rf.predict_proba(X_test)[:,1],
         '随机森林': rfc.predict_proba(X_test)[:,1],
         'Logistic': lr.predict_proba(X_test)[:,1]}

def _midrank(x):
    J = np.argsort(x); Z = x[J]; T = np.zeros(len(x)); i=0
    while i < len(x):
        j = i
        while j < len(x) and Z[j] == Z[i]: j += 1
        T[i:j] = 0.5*(i+j-1)+1; i = j
    out = np.empty(len(x)); out[J] = T; return out

def delong(y, p1, p2):
    """Sun & Xu 2014 快速 DeLong,返回 Z 和双侧 P。"""
    order = np.argsort(-y, kind='mergesort')
    P = np.vstack([p1, p2])[:, order]
    m = int(y.sum()); n = len(y) - m
    tx = np.vstack([_midrank(P[r,:m]) for r in range(2)])
    ty = np.vstack([_midrank(P[r,m:]) for r in range(2)])
    tz = np.vstack([_midrank(P[r])    for r in range(2)])
    aucs = tz[:,:m].sum(1)/m/n - (m+1.)/2./n
    v01 = (tz[:,:m]-tx)/n; v10 = 1.0 - (tz[:,m:]-ty)/m
    cov = np.cov(v01)/m + np.cov(v10)/n
    var = cov[0,0] + cov[1,1] - 2*cov[0,1]
    z = (aucs[0]-aucs[1]) / np.sqrt(var)
    return float(aucs[0]-aucs[1]), float(z), float(2*norm.sf(abs(z)))

for a, b in [('XGBoost','随机森林'), ('XGBoost','Logistic'), ('随机森林','Logistic')]:
    d, z, p = delong(y_test.values, probs[a], probs[b])
    print(f"{a} vs {b}: ΔAUC={d:+.4f}  Z={z:.2f}  P={p:.3f}")

# DCA(决策曲线)
def net_benefit(y, p, ths):
    return np.array([((p>=t)&(y==1)).sum()/len(y)
                     - ((p>=t)&(y==0)).sum()/len(y) * t/(1-t) for t in ths])

ths = np.linspace(0.01, 0.8, 80)
plt.figure(figsize=(10, 5))
prev = y_test.mean()
plt.plot(ths, prev - (1-prev)*ths/(1-ths), color=CS['gray'], label='Treat all')
plt.axhline(0, color=CS['dark'], label='Treat none')
for n, p in probs.items():
    plt.plot(ths, net_benefit(y_test.values, p, ths), lw=2, label=n)
plt.xlabel('阈值概率 t'); plt.ylabel('净获益 Net Benefit'); plt.legend()
plt.title('图 08 · 决策曲线 DCA(节选)', fontweight='bold')
plt.savefig('08_统计学对比.png', dpi=150, bbox_inches='tight')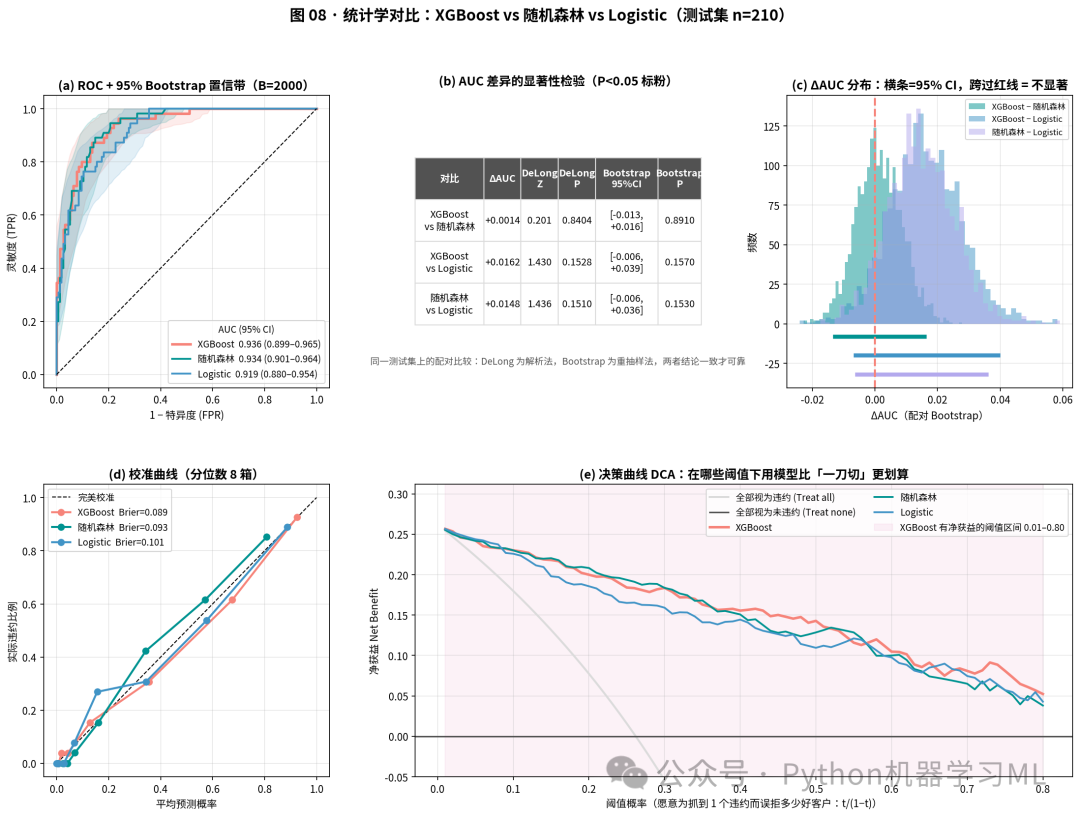
图 8 · ROC 置信带 + DeLong 检验 + Bootstrap ΔAUC + 校准 + DCA
怎么读:
-
三条 ROC 的 95% CI 大面积重叠
:XGBoost 0.936(0.899--0.965)、随机森林 0.934(0.901--0.964)、Logistic 0.919(0.880--0.954)。
-
DeLong 检验结果
:XGBoost vs 随机森林 P=0.840 、vs Logistic P=0.153 ;配对 Bootstrap 结论一致。三个模型两两之间的差异都没有统计显著性。
-
校准:XGBoost 概率最可信
:Brier 0.089 < 随机森林 0.093 < Logistic 0.101。但差距很小,三者都算校准良好。
-
DCA 决策曲线
:在 t = 0.01--0.80 的几乎所有阈值下,XGBoost 都比「全部放贷」/「全部拒贷」有正的净获益;这才是业务侧真正关心的「用这个模型比不用好多少」。
-
如何写进论文
:「虽然 XGBoost 的点估计 AUC 最高(0.936),但 DeLong 检验未显示其显著优于随机森林(P=0.84)和 Logistic(P=0.15)」------ 这是审稿人会满意的写法。
9 · 模型在哪里「下刀」
把 booster 导出成表(trees_to_dataframe),统计每个特征在哪些取值上被切分、每次切分带来多少增益。和数据分布叠在一起看,就是模型学到的「分段规则」。
df = booster.trees_to_dataframe()
sp = df[df['Feature'] != 'Leaf']
gain_by_f = sp.groupby('Feature')['Gain'].sum().sort_values(ascending=False)
top4 = gain_by_f.index[:4].tolist()

fig, axes = plt.subplots(2, 2, figsize=(14, 9))
for ax, f in zip(axes.ravel(), top4):
    s = sp[sp['Feature']==f]
    bins = np.histogram_bin_edges(X_train[f], bins=30)
    for cls, c, lab in [(0, CS['teal'], '未违约'), (1, CS['red'], '违约')]:
        ax.hist(X_train.loc[y_train==cls, f], bins=bins, color=c, alpha=0.45,
                density=True, label=lab)
    ax2 = ax.twinx(); ax2.grid(False)
    g, _ = np.histogram(s['Split'], bins=bins, weights=s['Gain'])
    ax2.step(bins[:-1], g/g.sum(), where='post', color=CS['dark'], lw=1.6, label='切分增益占比')
    ax2.set_yticks([])
    top_cut = bins[int(np.argmax(g))]
    ax.axvline(top_cut, color=CS['dark'], ls='--')
    ax.set_title(f"{FEATURE_CN[f]}:最常下刀 ≈ {top_cut:.1f}", fontweight='bold')
plt.suptitle('图 09 · XGBoost 的切分习惯', fontsize=15, fontweight='bold')
plt.tight_layout()
plt.savefig('09_切分阈值与树贡献.png', dpi=150, bbox_inches='tight')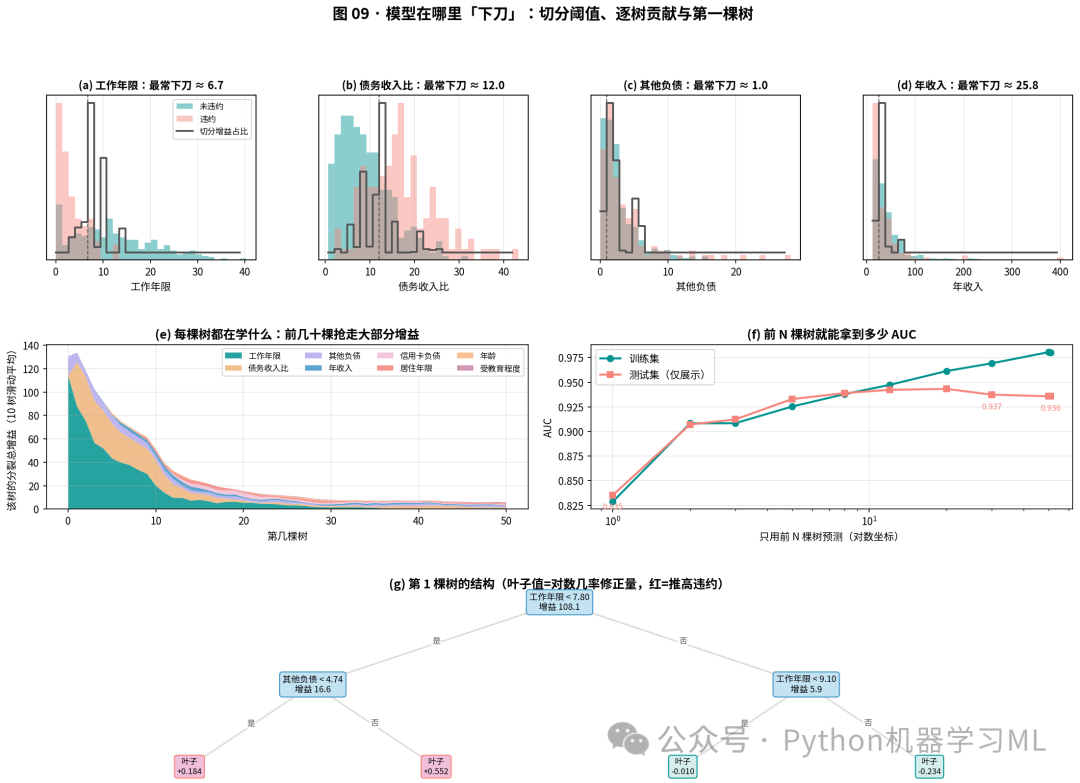
图 9 · 四个特征的切分位置 + 逐棵树增益 + 第 1 棵树结构
怎么读:
-
工作年限贡献最大
:占总增益 38.9% ,模型最常在 6.7 年附近下刀;下文「从业 7 年」就是这个数的来源。
-
债务收入比
:占 27.7%,最常切在 12.0附近,和原始分布的 50% 分位(11.97)几乎重合。
-
前 10 棵树抢走大部分增益
:从「每棵树的分裂总增益」堆叠图能看出,前 10 棵树的高度比后 40 棵加起来还大 ------ 这就是 Boosting 的本质:先学最重要的模式。
-
只用前 N 棵树的 AUC
:1 棵 0.835、2 棵 0.907、5 棵 0.933、20 棵 0.943、全部 51 棵 0.936。其实前 20 棵就够了,后面 30 棵是在精修。
-
第 1 棵树的结构
:先按 workyears<7.80 切,再按 otherdebt<4.74 和 workyears<9.10 二次切 ------ 和特征重要性排名完全一致。
10 · 稳定性:换一次随机划分,结论还成立吗
单次 70/30 划分的 AUC 和重要性排名都带运气成分。重复 30 次不同种子的分层划分,三个模型同时重训,看 AUC 分布和特征排名的波动。
from sklearn.base import clone

names = ['XGBoost', '随机森林', 'Logistic']
aucs = {n: [] for n in names}
ranks = []
for r in range(30):
    Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, stratify=y,
                                          random_state=1000+r)
    mdl = {'XGBoost': clone(rf), '随机森林': clone(rfc), 'Logistic': clone(lr)}
    for n, m in mdl.items():
        m.fit(Xtr, ytr)
        aucs[n].append(roc_auc_score(yte, m.predict_proba(Xte)[:,1]))
    sv_r = mdl['XGBoost'].get_booster().predict(xgb.DMatrix(Xte),
                                                pred_contribs=True)[:, :-1]
    ranks.append(pd.Series(np.abs(sv_r).mean(0), index=feats).rank(ascending=False))

aucs = {n: np.array(v) for n, v in aucs.items()}
R = pd.DataFrame(ranks)
print({n: (aucs[n].mean(), aucs[n].std()) for n in names})
print({'XGB胜随机森林': int((aucs['XGBoost'] > aucs['随机森林']).sum()),
       'XGB胜Logistic': int((aucs['XGBoost'] > aucs['Logistic']).sum())})
# 画图代码略,可参考完整脚本
plt.savefig('10_重复划分稳定性.png', dpi=150, bbox_inches='tight')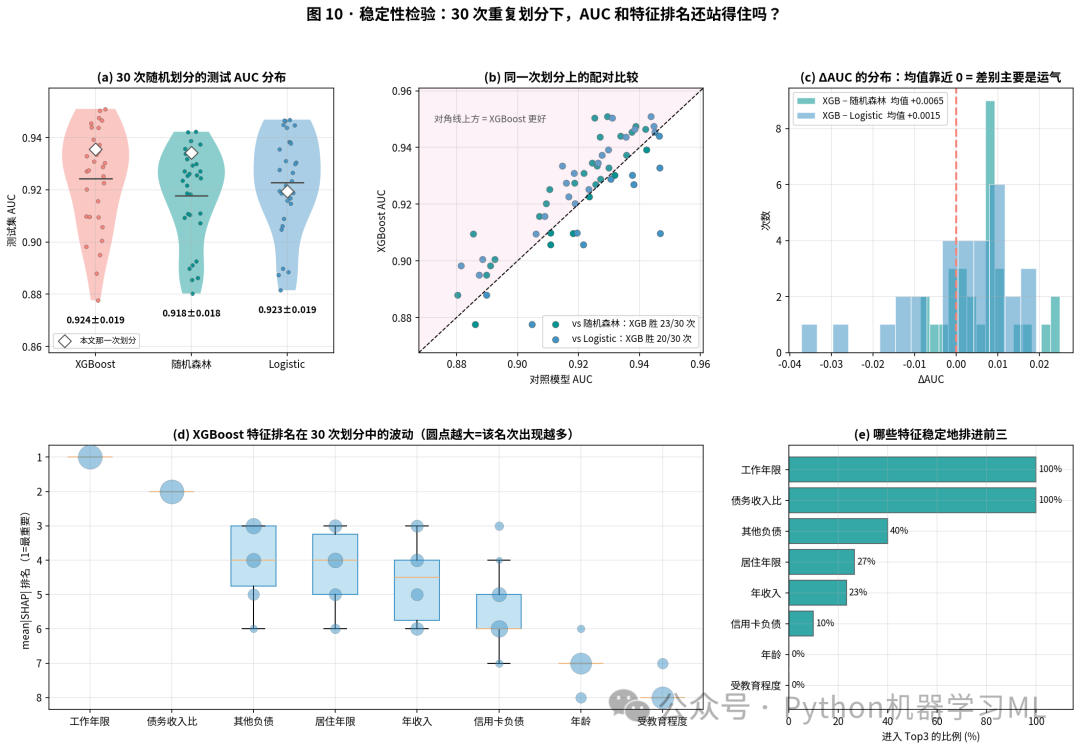
图 10 · 30 次划分下的 AUC 分布 + 特征排名稳定性
怎么读:
-
均值 ± 标准差
:XGBoost 0.924±0.019、随机森林 0.918±0.018、Logistic 0.923±0.019。单次测试里看到的「0.936」只是运气好的那一次。
-
XGBoost 的胜率
:vs 随机森林 23/30 次 胜,vs Logistic 20/30 次 胜;但平均 ΔAUC 只有 +0.0065 和 +0.0015 ------ 和图 8 的 DeLong 检验结论一致,差异真实存在但很小。
-
特征排名的稳定性
:工作年限、债务收入比 100% 稳居前二;其他负债只有 40% 的概率进 Top3;年龄、受教育程度 30 次全部排在 7、8 位。
-
结论
:报告里要写「均值 ± 标准差 」,不要只贴单次 AUC;重要特征的稳定性比重要性数值本身更有说服力。
11 · scale_pos_weight:不平衡加权到底改变了什么
常见误解:「违约样本少,所以设 scale_pos_weight = 负/正 就能提升模型」。真的吗?这张图把 w=1 到 w=6 的六种配置摆到一起,看 AUC/AP、概率分布、校准、调阈值前后 F1 到底变了什么。
from sklearn.metrics import f1_score, precision_score, recall_score, average_precision_score

ratio = (y_train==0).sum() / (y_train==1).sum()  # 本数据 ≈ 2.83
rows = []
for w in [1, 1.5, 2, round(ratio, 2), 4, 6]:
    m = XGBClassifier(n_estimators=51, learning_rate=0.2, max_depth=2,
                      subsample=0.85, colsample_bytree=0.85, objective='binary:logistic',
                      tree_method='hist', scale_pos_weight=w, random_state=10,
                      n_jobs=-1, eval_metric='logloss')
    oof = cross_val_predict(m, X_train, y_train, cv=skf, method='predict_proba')[:,1]
    ths = np.linspace(0.05, 0.95, 91)
    t = ths[int(np.argmax([f1_score(y_train, (oof>=t_).astype(int)) for t_ in ths]))]
    m.fit(X_train, y_train)
    p = m.predict_proba(X_test)[:,1]
    rows.append(dict(w=w, auc=roc_auc_score(y_test, p),
                     brier=np.mean((p-y_test)**2), mean_p=p.mean(),
                     t=t, f1_t=f1_score(y_test, (p>=t).astype(int))))
print(pd.DataFrame(rows).round(4))
# 画图代码略,可参考完整脚本
plt.savefig('11_scale_pos_weight.png', dpi=150, bbox_inches='tight')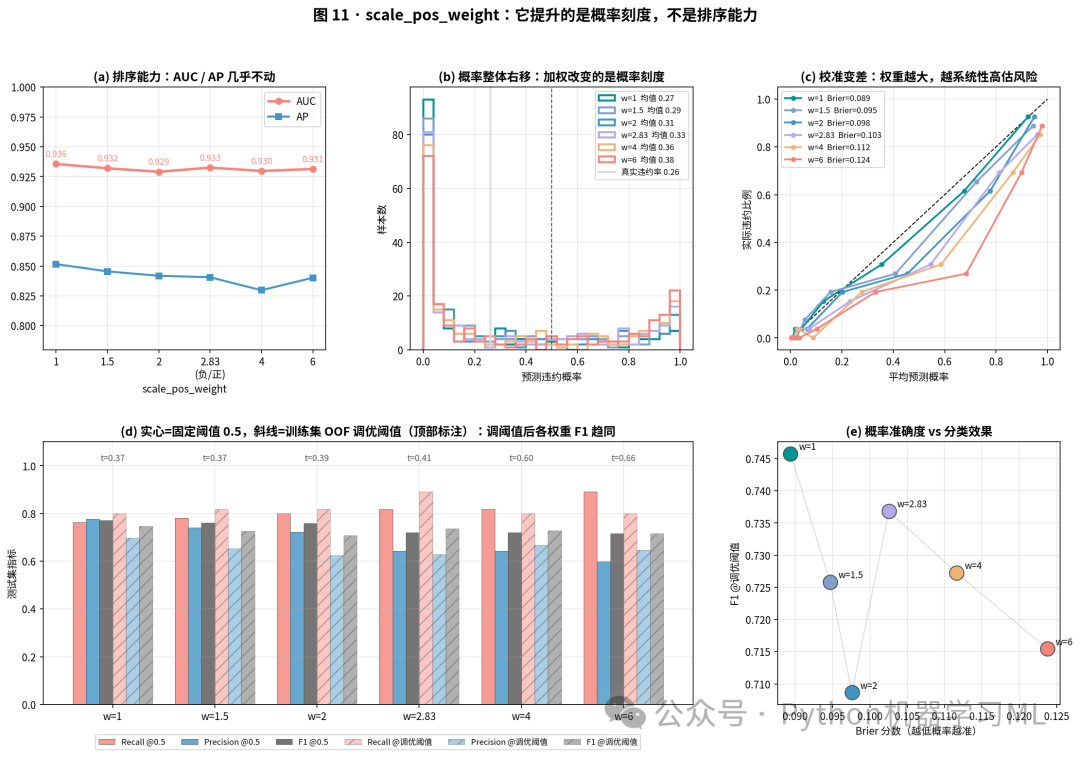
图 11 · 加权改变的是概率刻度,不是排序能力
怎么读:
-
(a) 排序能力几乎不变
:w 从 1 加到 6,测试 AUC 在 0.929~0.936 之间抖动,没有明显上升。AP 也类似。
-
(b) 概率整体右移
:平均预测概率从 w=1 的 0.27 (接近真实违约率 0.26)一路涨到 w=6 的 0.38。
-
(c) 校准明显变差
:Brier 从 0.089 → 0.124,权重越大系统性越高估风险。概率要用于定价或分层时,加权几乎一定要配合 isotonic 校准。
-
(d) 调过阈值后 F1 没有提升
:w=1 调好阈值的 F1 是 0.746 ,w=2.83(负/正比例)是 0.737 ,w=6 是 0.715 。既然要调阈值,就没必要再折腾加权。
-
结论
:
scale_pos_weight真正适合的场景只有一个 ------ 「我不想调阈值,但希望默认 0.5 阈值能多抓一些少数类」。要代价(校准变差)和便捷性的权衡。
总结
XGBoost 这期用 11 张图回答了 11 个具体问题。四条带结论的话收尾:
-
浅树 + 早停 + 默认正则化就够了
。这份数据上 depth=2、51 轮树已达最优;再深、再多正则,验证 AUC 反而下降。
-
单调约束值得默认开
。违反业务常识的 ICE 曲线能从 47% 压到 0%,CV AUC 还轻微提升;审稿人会满意,业务也会满意。
-
XGBoost 的「赢」通常不显著
。本数据上三种模型的 DeLong P 都 > 0.15,30 次划分平均 ΔAUC 只有 +0.0015 ~ +0.0065。报告里一定要加 CI 和检验。
-
scale_pos_weight 不是银弹
。它改概率刻度不改排序;要调阈值的话,加权等于白加还会牺牲校准。
📘 完整代码 + 数据 + 结果摘要 ,私信获取
历史推文:
机器学习------随机森林+PDP + ICE+ROC +Shap+代价曲线+决策曲线+KS曲线+Lift+六视角横评模型
机器学习------决策树算法:剪枝 + 系统调参 + PR/KS/校准 + PDP/SHAP + 阈值代价 + PSI
机器学习------审稿人要求的统计检验、ROC曲线、置信区间、特征重要性......这一套决策树代码全部搞定
顶刊复现 | IF=10.6!基于可解释机器学习评估免疫炎症指标在非酒精性脂肪肝病(NAFLD)患者中预测冠心病(CHD)风险
多种机器学习模型+Stacking模型的SHAP可视化+二分类+SMOTE处理不平衡数据
13种机器学习模型+多分类+PCA+贝叶斯优化超参数+SHAP高级可视化
机器学习------线性回归、决策树、随机森林、LightGBM模型的SHAP和LIME可解释性分析对比详解完整示例
机器学习------因果推断方法的DeepIV和因果森林双重机器学习(CausalForestDML)示例
论文复现------肺癌数据高级模型比较与shap可视化分析代码解析
论文复现------肺癌预测数据分析与逻辑回归、朴素贝叶斯、支持向量机、随机森林、K近邻、XGBoost、深度神经网络模型评估代码解析