我用全新 TRAE 给耳机工厂从零写了套 MES:26 天、217 次提交、574 个测试全绿
💡 本文参与「全新 TRAE 实战体验」活动 参赛赛道:从零开始的独立产品(真实工厂项目实战) 话题:#全新 TRAE 实战体验
前言:一个真实的工厂痛点
先交代背景:我司是一家做耳机的制造企业(尼尔耳机,nier),生产执行环节------工单传达、领料、报工、库存核对------长期依赖纸质单据 + 人工汇总。传达滞后、算料易错、财务补录滞后,这三件事车间几乎每天都在发生。
而公司用的畅捷通 T+ 云 ERP 里,其实躺着一份完整的生产与库存家底:981 个 BOM、551 行生产工单明细、5424 条库存现存量。缺的不是数据,是一个面向车间的执行层工具。
市面上的 MES 对小工厂来说太重、太贵,二次开发周期也扛不住。于是我决定:用 TRAE 从零写一套。 ERP 侧数据一分不能动(财务红线),MES 严格只读;车间侧要真正好用,纸单怎么流转系统就怎么建模。
这个决定最终变成了一个 1.2.0 版本、约 3.5 万行代码、574 个自动化测试全绿的完整系统。下面是全程复盘。
一、技术选型:刻意「不高级」
给工厂用的系统,我的选型原则是部署足够傻、依赖足够少:
| 层 | 选型 | 理由 |
|---|---|---|
| 后端 | Python 3.12 + Flask 3 + waitress | 生态稳,单人可维护 |
| 数据库 | SQLite(WAL 模式) | 单文件、零运维,30 人并发实测扛得住(后文有数据) |
| 前端 | 原生 JS 单页应用 + ECharts | 不引框架,内网老机器也能秒开 |
| 集成 | 畅捷通开放平台 OpenAPI | 与 T+ Cloud ERP 双向集成 |
| 部署 | 便携版 Python 打包 + Windows 计划任务自愈 | IT 专员整包落地 1~2 小时 |
整个系统最终长这样:
text
┌─ T+ 云网关 ────────────┐
│  (只读白名单实时查询)    │
└──────────┬─────────────┘
           │ token(跨进程文件锁) / 消息推送
┌──────────┴──────────────────────────┐
│ mes_api.py  → :8080  14 个蓝图        │
│   app/api        切面 + 335 条路由    │
│   app/services   17 个业务服务        │
│   app/data       74 张表(SQLite WAL)  │
│   app/integration TPlusClient         │
│ scheduler.py     定时同步/巡检/自愈     │
│ message_server.py :8000 消息+OAuth回调 │
└──────────┬──────────────────────────┘
           │ web/ 单页应用(原生 JS + ECharts)
四条核心数据链路全部经真实环境验证:
- 生产工单同步(T+ → MES):每 5 分钟自动同步,551 行明细聚合为 40 张工单落库;
- 领料(MES → T+ 通道):按 BOM 自动算料(需用量 × 工单量 ÷ 成品率)+ 库存校验;
- 完工回传:报工即时生成产成品入库单,工单满量自动关闭;
- 库存共享:每 15 分钟同步 6 仓 5424 条现存量,员工自助查询。
二、第一条红线:T+ 严格只读
ERP 是财务系统,任何误写都是事故。所以这个项目第一条不是功能,而是数据保护的三重落地:
python
# 简化示意:写动词在客户端入口直接拦截,连网络请求都不发
def call(self, api_path, http_method, ...):
    if http_method in ("POST", "PUT", "DELETE"):
        raise ReadOnlyViolation(...)   # 审计记 BLOCKED,留痕
...- 客户端硬拦截:所有写动词在调用入口拒绝,不发网络请求;
- 业务验证走本地:领料等需要「写」语义的功能在 MES 本地完成登记;
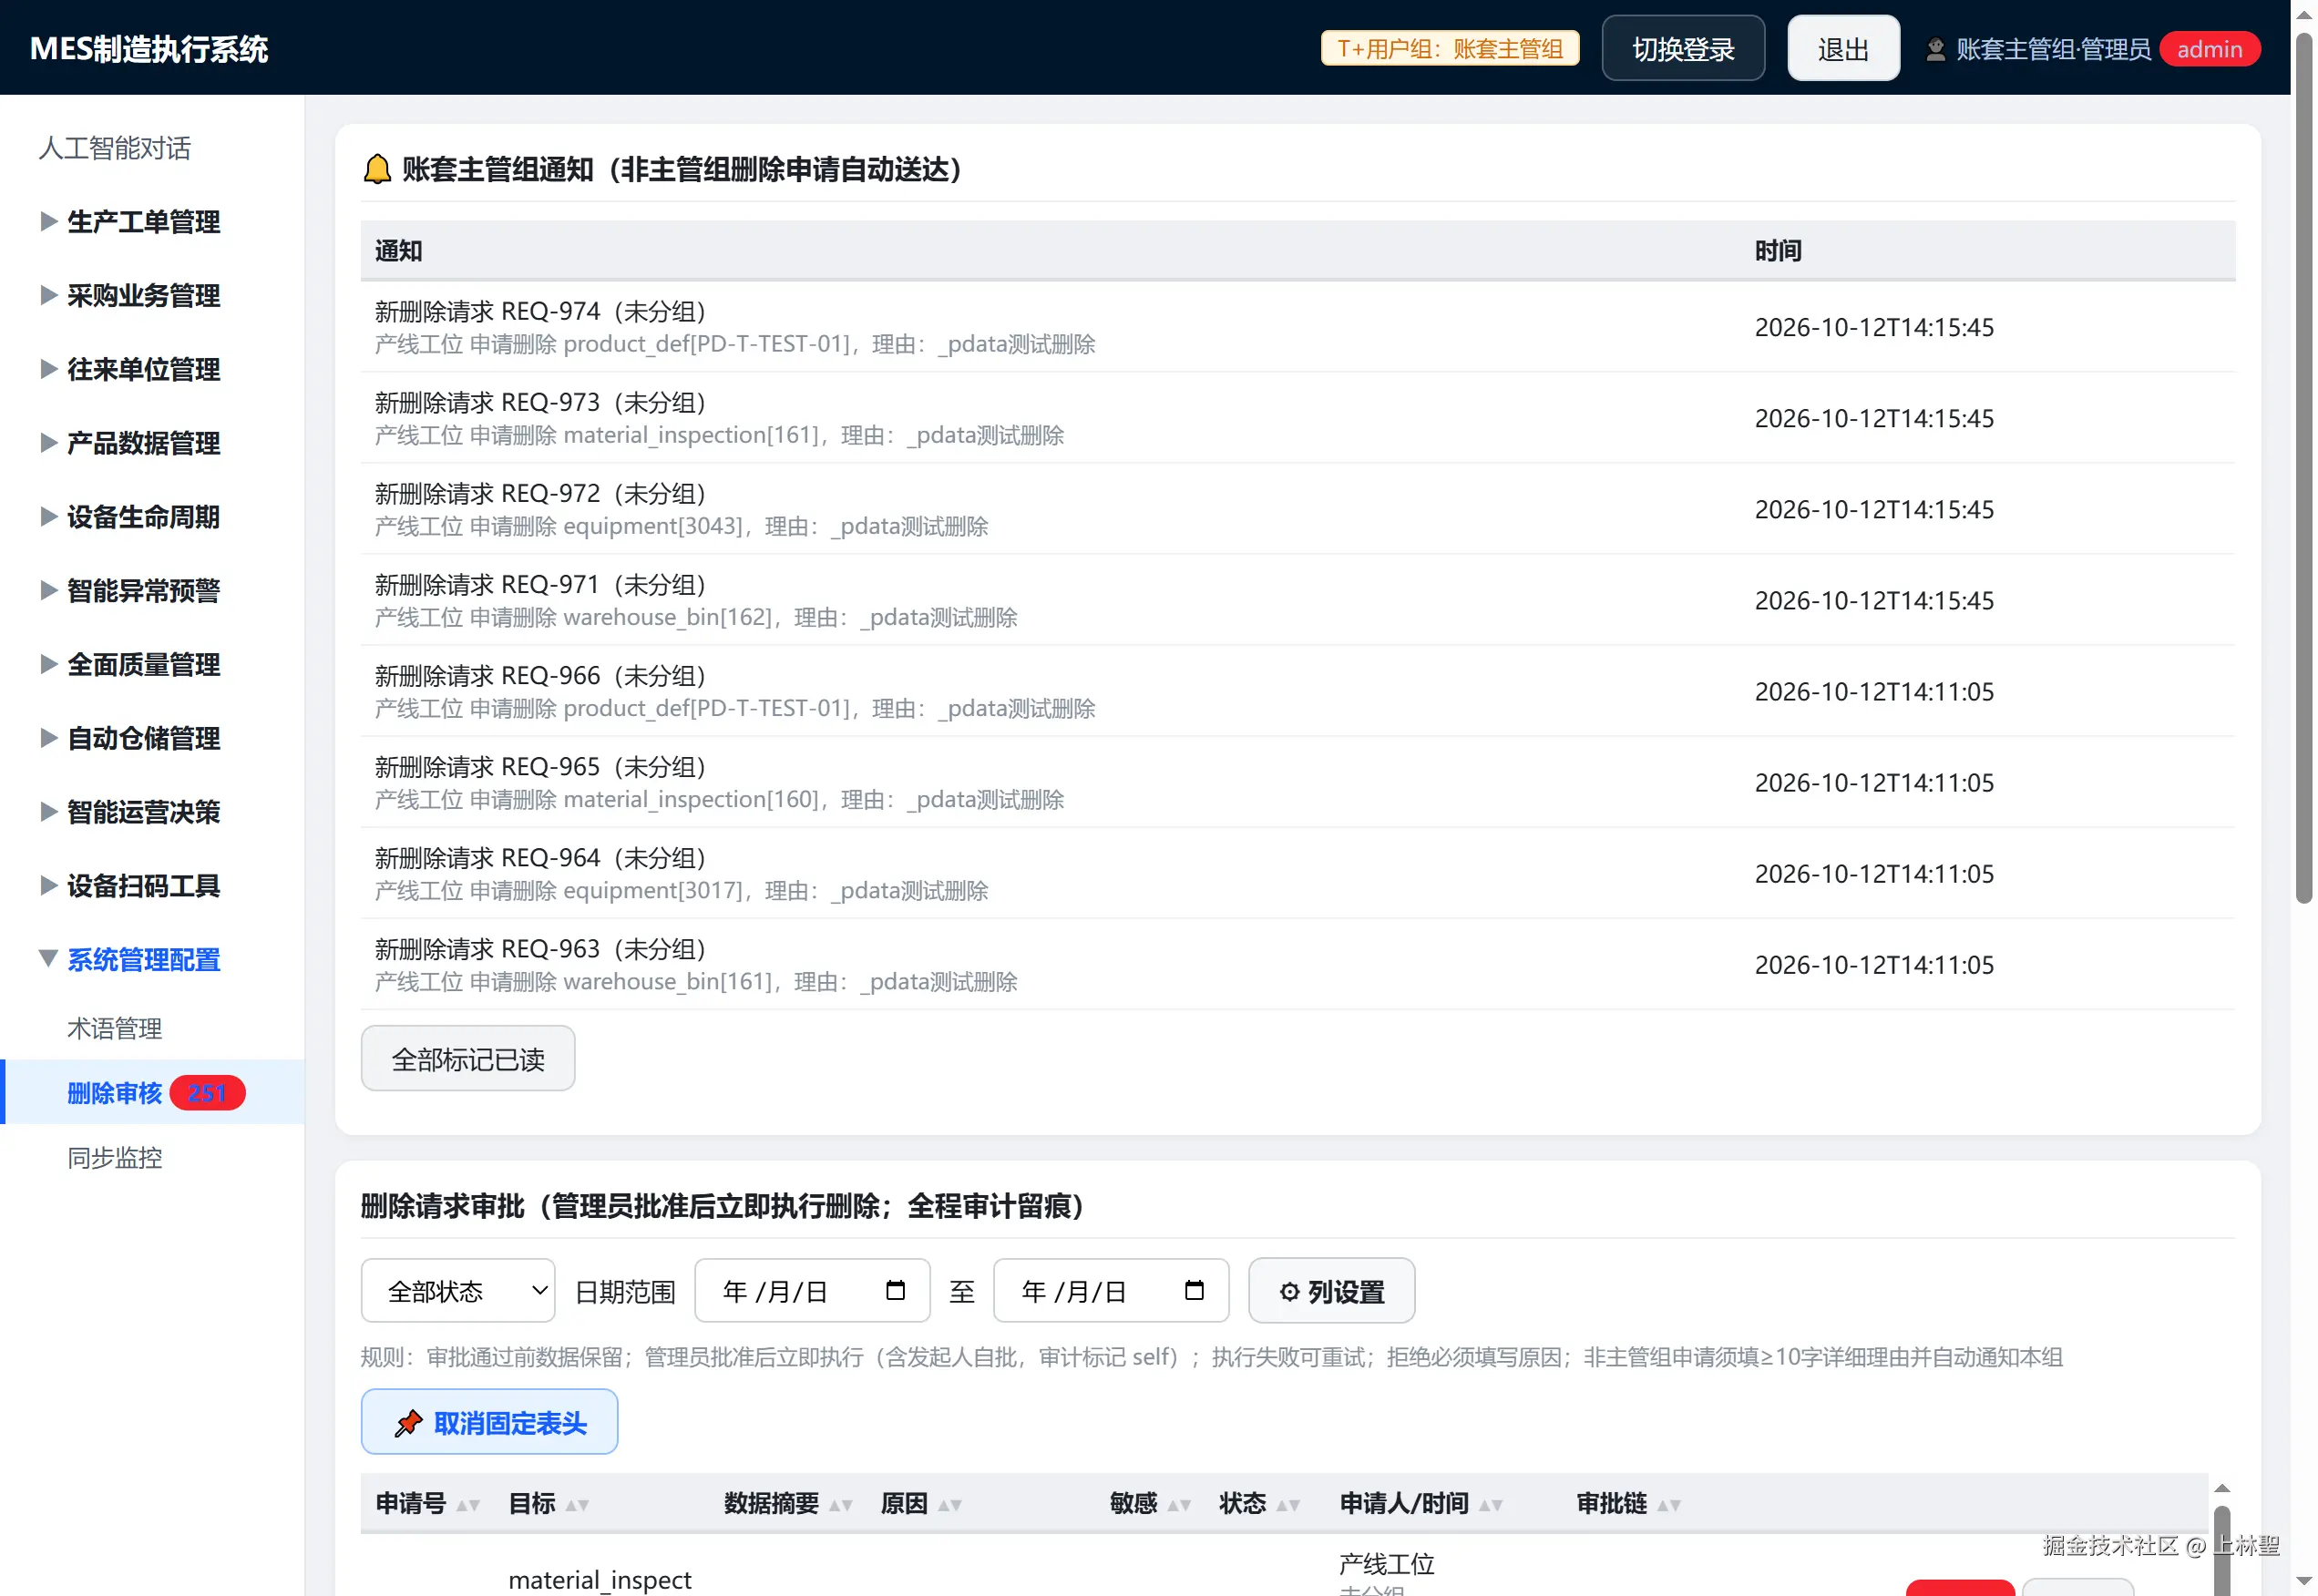
- 删除 100% 进审核队列:任何删除操作一律返回 202 进入删除审核,由账套主管审批后才会执行,且支持级联补偿。
配合三级角色 API Key(查询员/操作员/管理员)+ 全量审计留痕(读/写/拦截尝试双写 SQLite + JSONL),这套防线后来经受住了 30 用户并发压测和两轮全面审校的考验。
删除审核队列:申请 202 进入队列,账套主管审批闭环、全程留痕
三、TRAE 在这个项目里到底干了什么
接下来说说主角。这个项目从第一行代码到 v1.2.0,全程只在全新 TRAE 里开发。26 天里它给我留下的体验,我总结成四个「真的有用」:
3.1 计划先行,大改不跑偏
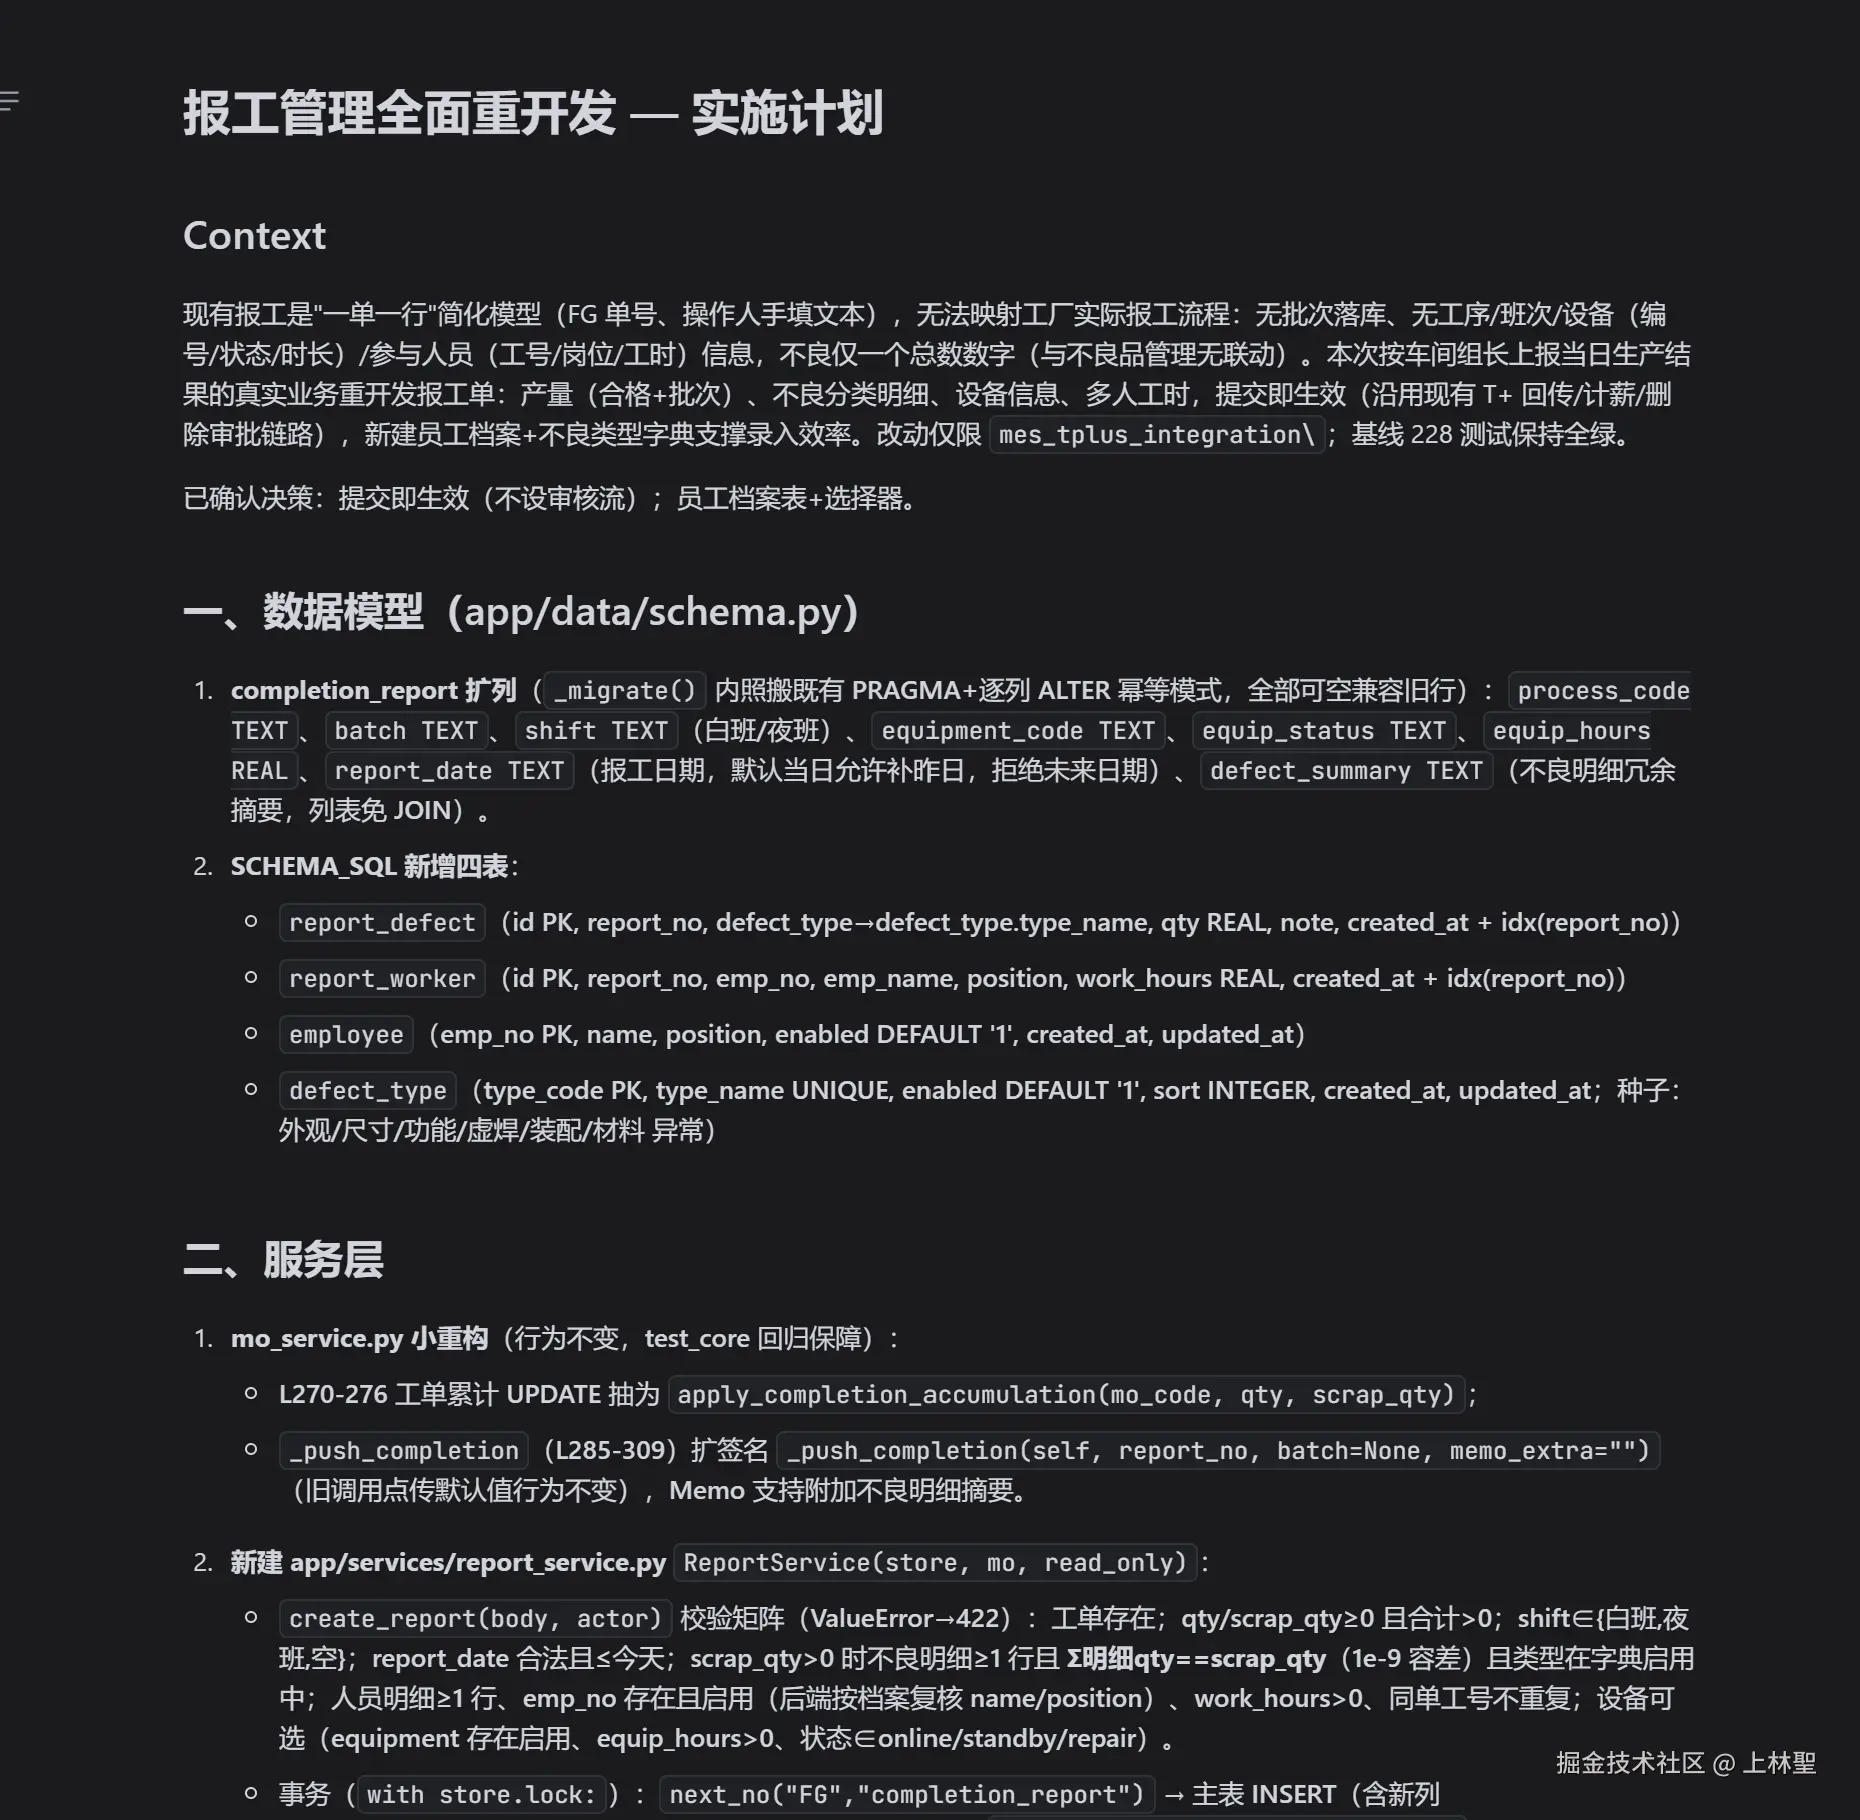
报工模块 v2.1 重构是个典型例子:旧模型是「一单一行」的简化版,无法映射车间真实流程(无批次、无工序/班次/设备、不良只有一个总数)。这种横跨数据层 → 服务层 → API → 前端 → 测试五层的大改,最容易翻车。
我的做法是先用 TRAE 的计划模式出实施计划:新表怎么建(report_defect / report_worker / employee / defect_type 四张表)、旧端点如何兼容保留、校验矩阵长什么样(如 Σ不良明细 == scrap_qty,1e-9 容差)、级联删除补偿钩子改哪里------一整页计划确认后才动手。结果整个重构一次通过回归,没有出现「改 A 坏 B」的返工。
报工重构前先由 TRAE 计划模式产出的实施计划文档(沉淀在 .trae/documents 目录)
3.2 大上下文跨模块改动
项目到后期已经 300+ 路由、74 张表。做「AI 历史会话」功能时,一个需求牵扯:建两张新表、接入既有删除审核三件套(DELETABLE_TABLES 白名单 + 级联补偿钩子 + 主键映射)、三个新端点走通用分页协议、前端弹层、测试 7 用例。这种「要把项目规矩都摸清」的活,正是上下文理解的用武之地------项目铁律(删除必须走审核、表格排序是全站默认能力、前端文本中文化门禁)都被稳定遵守,7 个新用例写完直接全绿。
3.3 测试即门禁的闭环
项目有一条铁规矩:全量 pytest 全绿才能提交合并 。测试规模从第一天的 13 个用例涨到如今的 574 passed / 1 skipped,前端还有一套门禁五件套(JS 语法 / 运行时冒烟 / 页面渲染 / 删除弹层 / URL 快照逐条回归)。TRAE 内置终端让「改完 → 跑测试 → 修 → 再跑」的循环快到几乎没有摩擦,这也是敢在压测前反复动手术的底气。
3.4 踩坑时的「结对」价值
举一个真实的坑:Windows 上用 Start-Process -Verb RunAs 提权拉起 PowerShell 脚本,一行都不执行且无任何报错 。人机一起排查:先在脚本首行落 marker 文件证明「确实没执行」,再定位到机器 ExecutionPolicy(Restricted)拦截,最终固化了 -NoProfile -ExecutionPolicy Bypass -File 的启动范式,含中文注释的 .ps1 必须带 BOM 也一并写进项目经验。这类环境级暗坑,单靠搜索引擎很难这么快闭环。
四、硬骨头两根:压测惊群与性能手术
4.1 30 用户压测,揪出「界面卡死」真凶
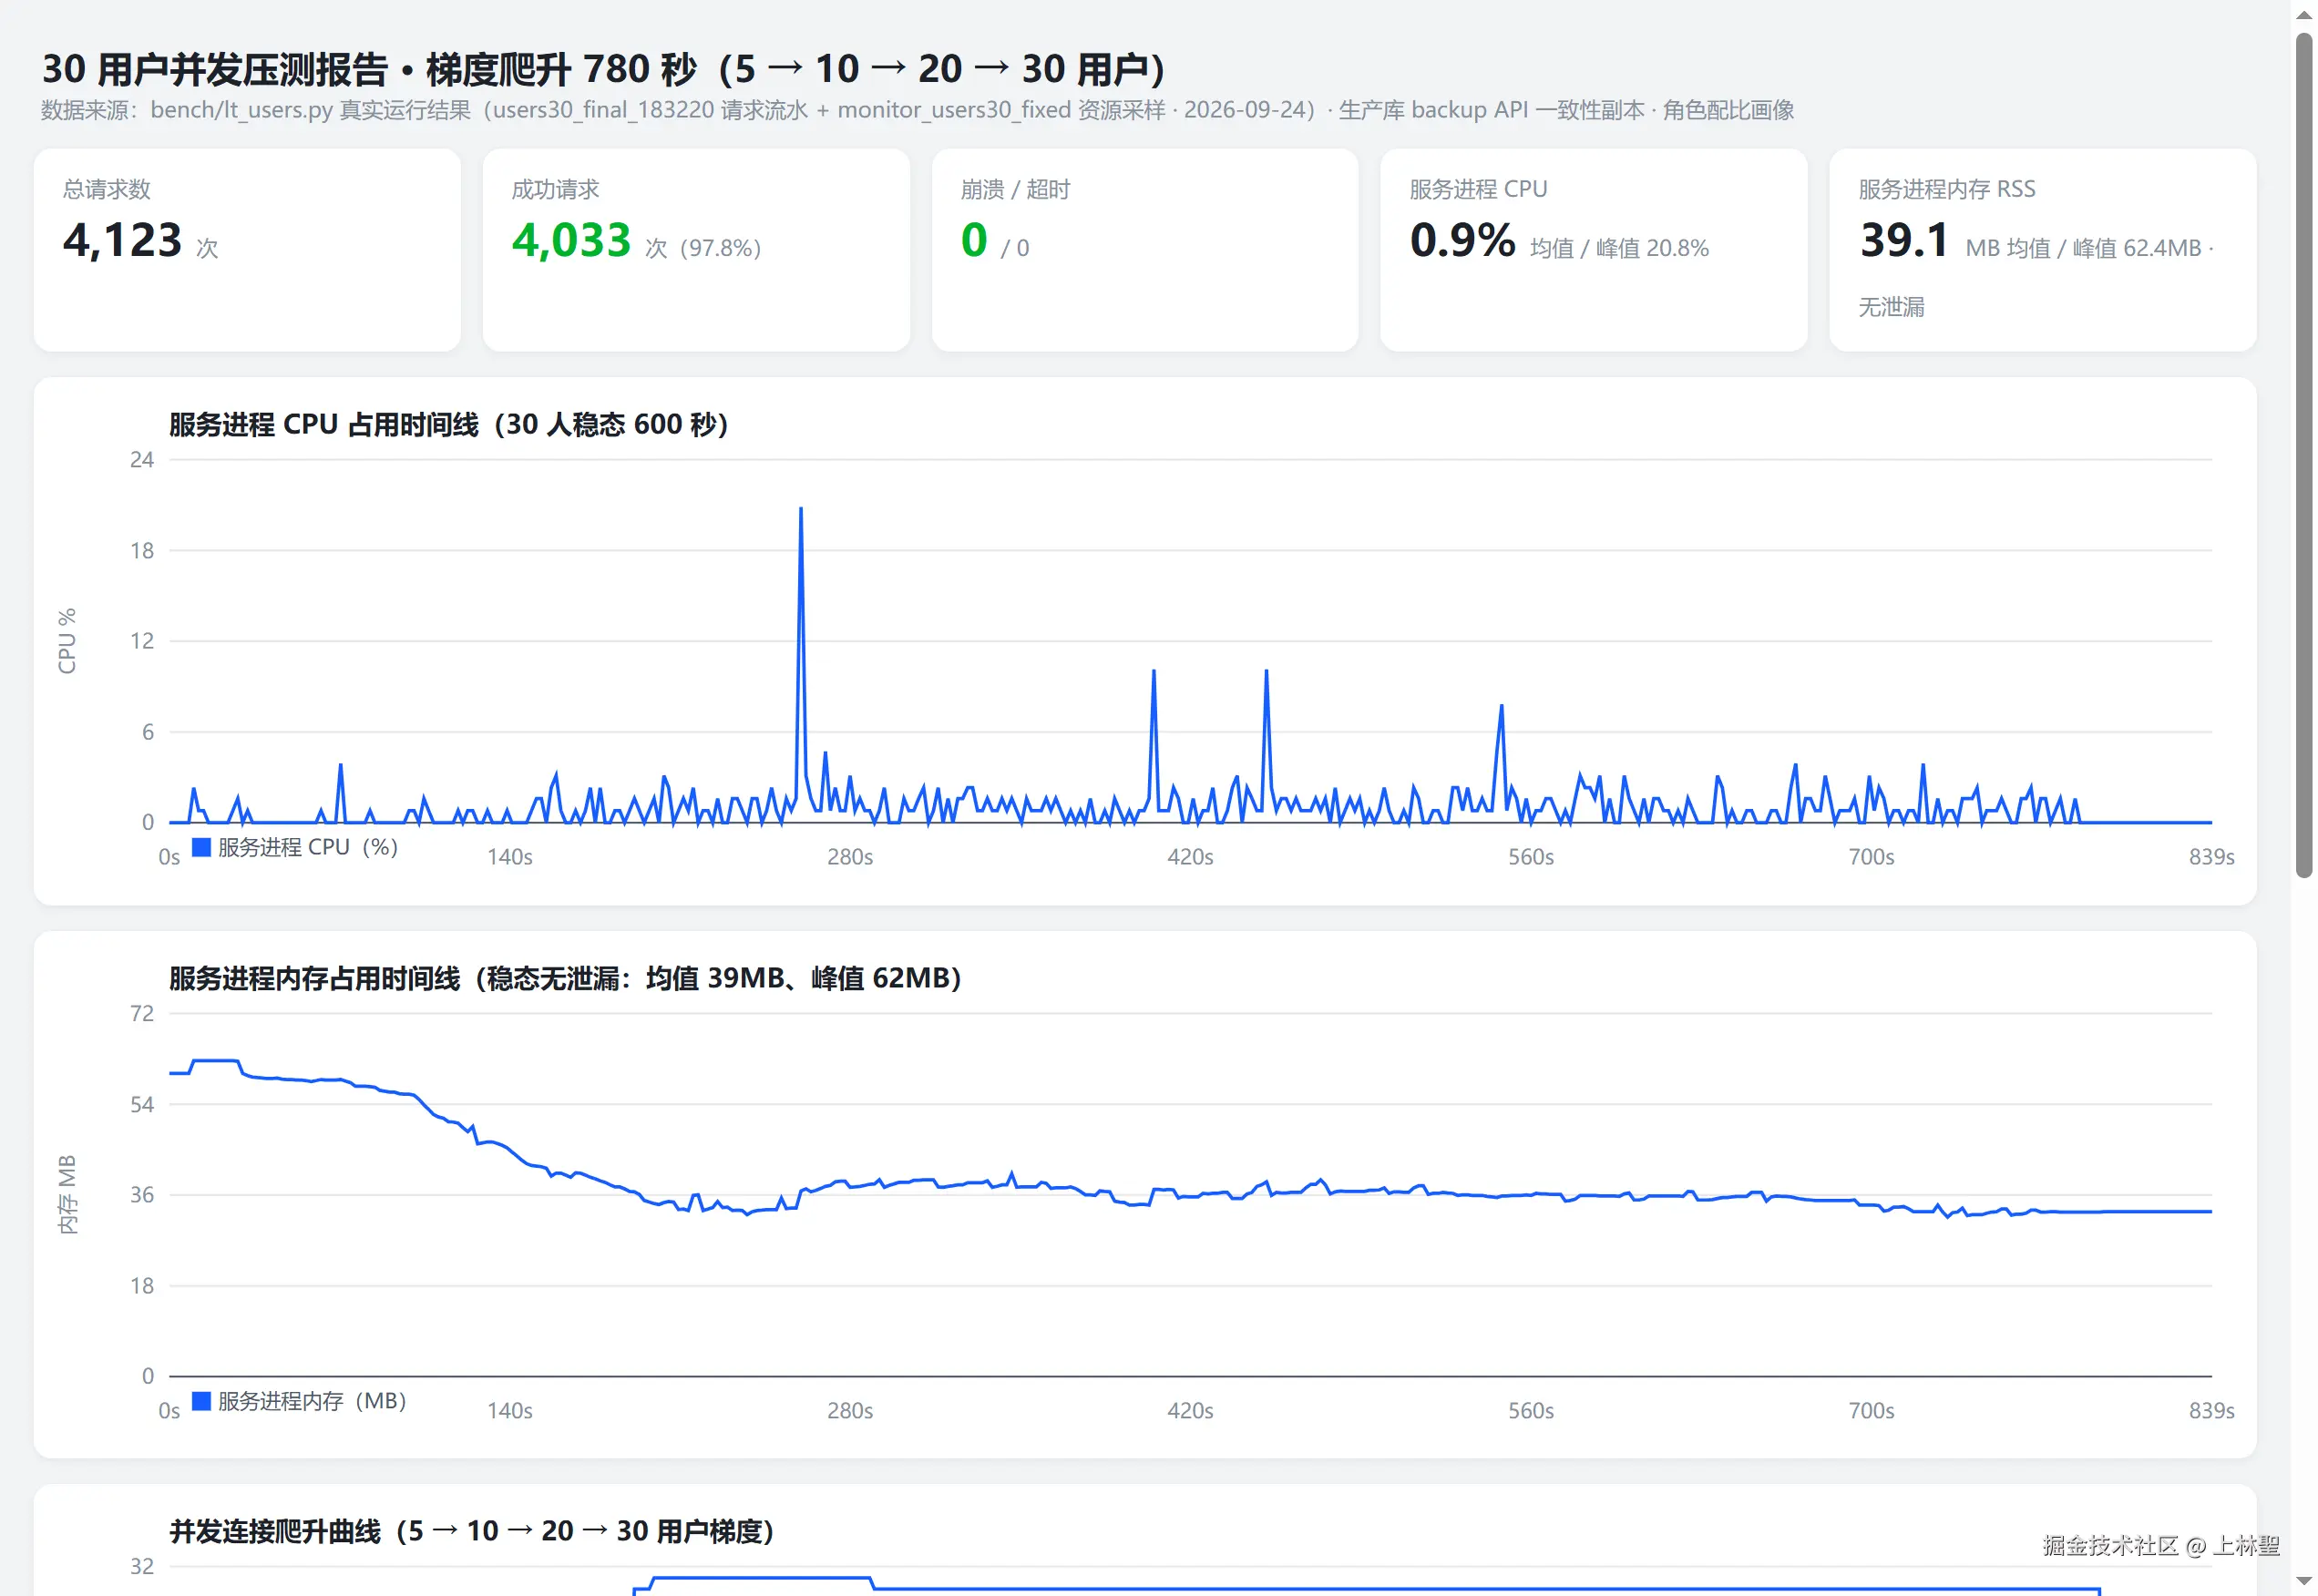
系统上线前,我搭了一套完整的压测工具链(生产库 backup API 一致性副本 + 角色配比画像 + 梯度爬升),按真实岗位权限模拟 30 人并发:5 → 10 → 20 → 30 用户梯度爬升,30 人稳态 600 秒,全程 780 秒。
第一轮就抓到两个生产级缺陷:
- 缓存惊群 :WMS 缓存 TTL 过期瞬间,所有并发用户排队等回源,单请求最长 39.7 秒------这就是车间用户抱怨的「界面卡死」;
- 共享 SQLite 连接的读写竞争:无锁读与并发写 commit 撞车,偶发 500,生产环境已实际复现。
修复方案:缓存加锁 + 读连接线程本地化(query_only=ON)+ waitress 线程数 16 → 32。修复后回归:
| 验证项 | 结果 |
|---|---|
| 30 人并发 780s | 4123 请求,零崩溃、零超时、零数据异常 |
| 单用户高频 | ~575 rps,12 万请求无劣化;60 连发写入全成功 |
| 资源占用 | 服务进程 CPU 平均 0.9%,内存 39~62MB 无泄漏 |
30 用户并发压测报告:梯度爬升曲线 + 服务进程 CPU/内存时间线(bench 真实结果渲染)
4.2 两台「性能手术」:99.7% 和 99.9%
压测之后又是一轮针对性优化,两项都拿到了量化数据:
- O-1 BI 报表 :T+ 报表通道按会话串行翻页(2841 行 ÷ 200/页 ≈ 15 次串行往返),冷回源 7.1s,过期后 10 并发全阻塞 9480ms 。方案:stale-while-revalidate(过期立即回旧值、后台单飞刷新)+ 每 30 分钟定时预热 10 张报表。改后过期并发 9480ms → 32ms(-99.7%)。
- O-2 工单 BOM :工程主数据变更低频却零缓存,每次请求实时打 T+。加 300s 短 TTL 缓存(只缓存成功结果),重复访问 2757ms → 3.0ms(-99.9%)。
值得记录的是:O-1 上线后首轮基准测试发现 SWR 并发场景 median 高达 824ms(预期 ~8ms),根因是退避节流标记在成功回源路径也误生效。修正后复测达标------基准测试不只用来证明优化有效,还能抓住你新引入的缺陷。
五、进阶:给 MES 装上本地大模型
系统稳定后,我做了一次更大的尝试------把本地部署的 Qwen3-8B(llama-server GPU 推理,全内网加载、零遥测)集成成 MES 的「人工智能对话」模块:
text
浏览器(MES 对话页)
   │ MES SSO 登录态
   ▼
MES 后端代理 /api/ai/*(8 端点)──▶ AI 服务 :7861 ──▶ 推理底座 :18080
   ▲                                 │
   └── /adapter/* 适配网关(17 契约端点)◀─┘ 工具调用(读查询/写提案)
三个设计决策值得一提:
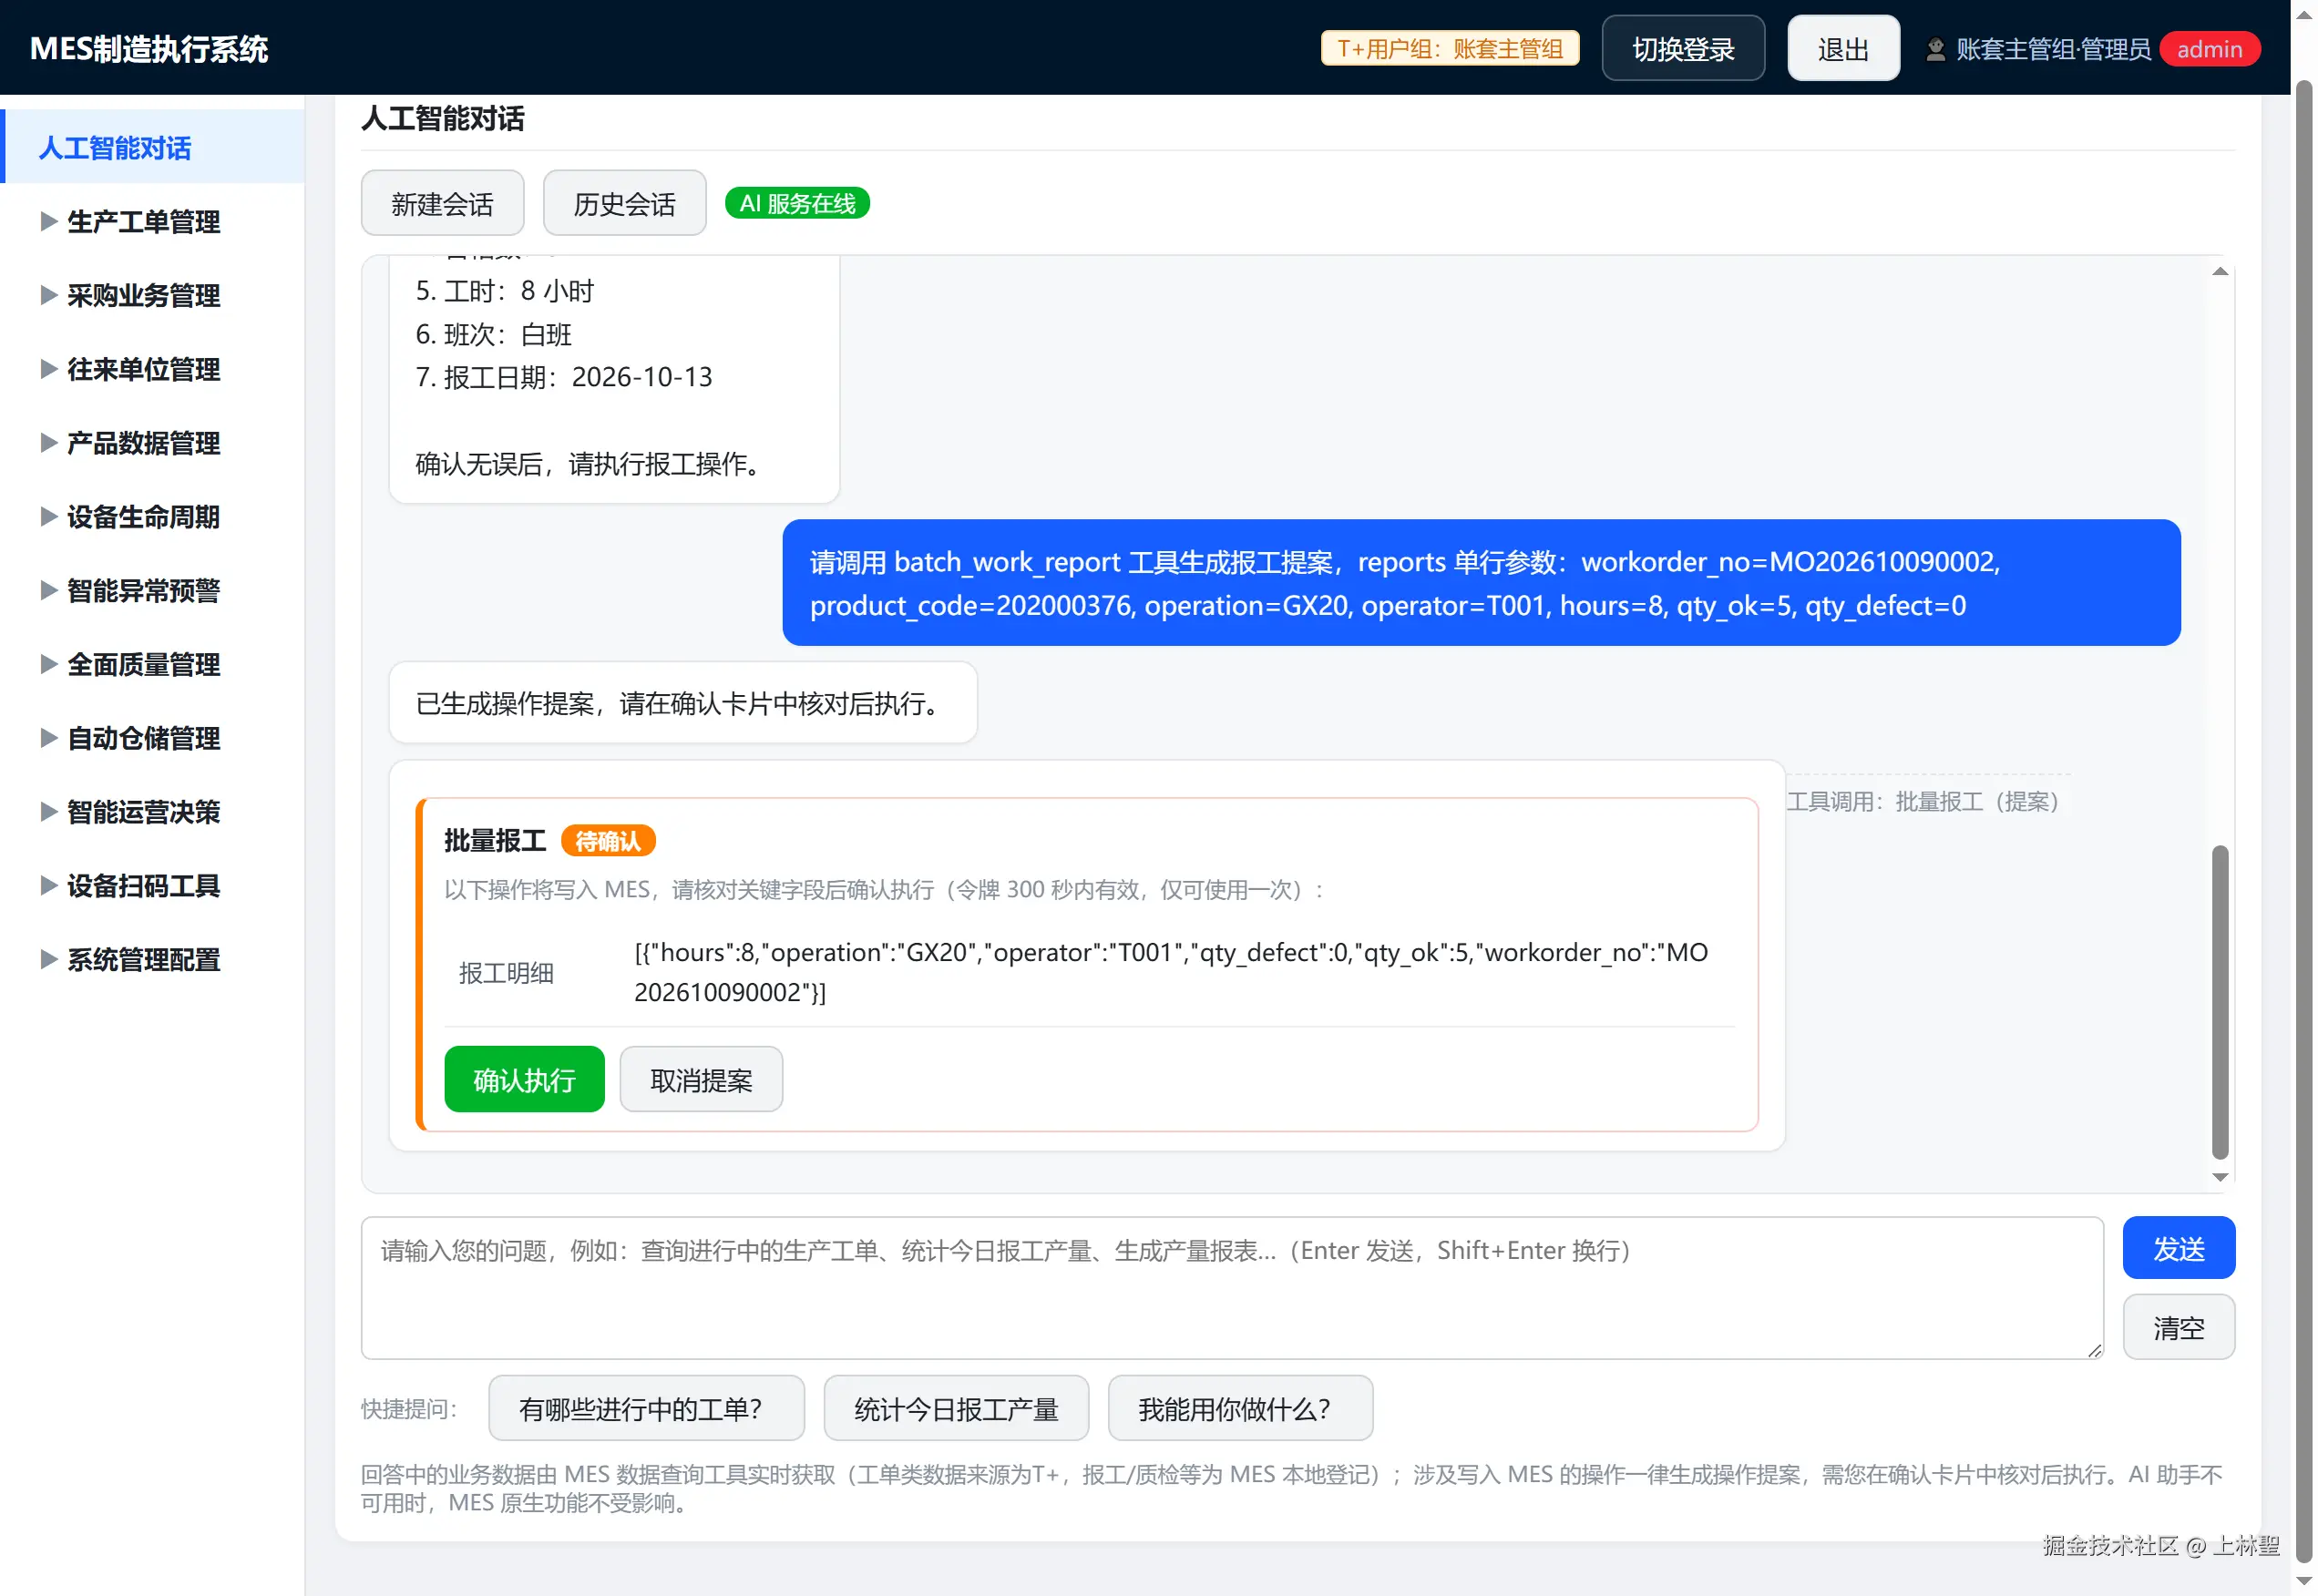
- 写操作三段式:AI 只生成「提案 + 确认令牌」(5 分钟有效、一次性),人工确认后才落库。工单状态流转类操作直接业务拒绝------MES 是报工即执行语义,不做假流转,数据零污染;
- 故障隔离做到 import 层面:MES 侧代理零 import AI 服务代码,AI 宕机仅对话降级提示,MES 原生功能零影响;
- QLoRA 微调对齐业务 :从
schema.py(74 张表)、URL 快照(335 条路由)、术语表(75 条)、开发文档(1097 段切片)自动构建语料,产出 119 条 SFT 样本;质量门禁复用运行时解析器做闭环校验,首轮就拦下一例参数名错误。41 用例评测集显示未微调基线总通过率 68.3%(工具调用仅 42.9%),微调靶点非常明确。
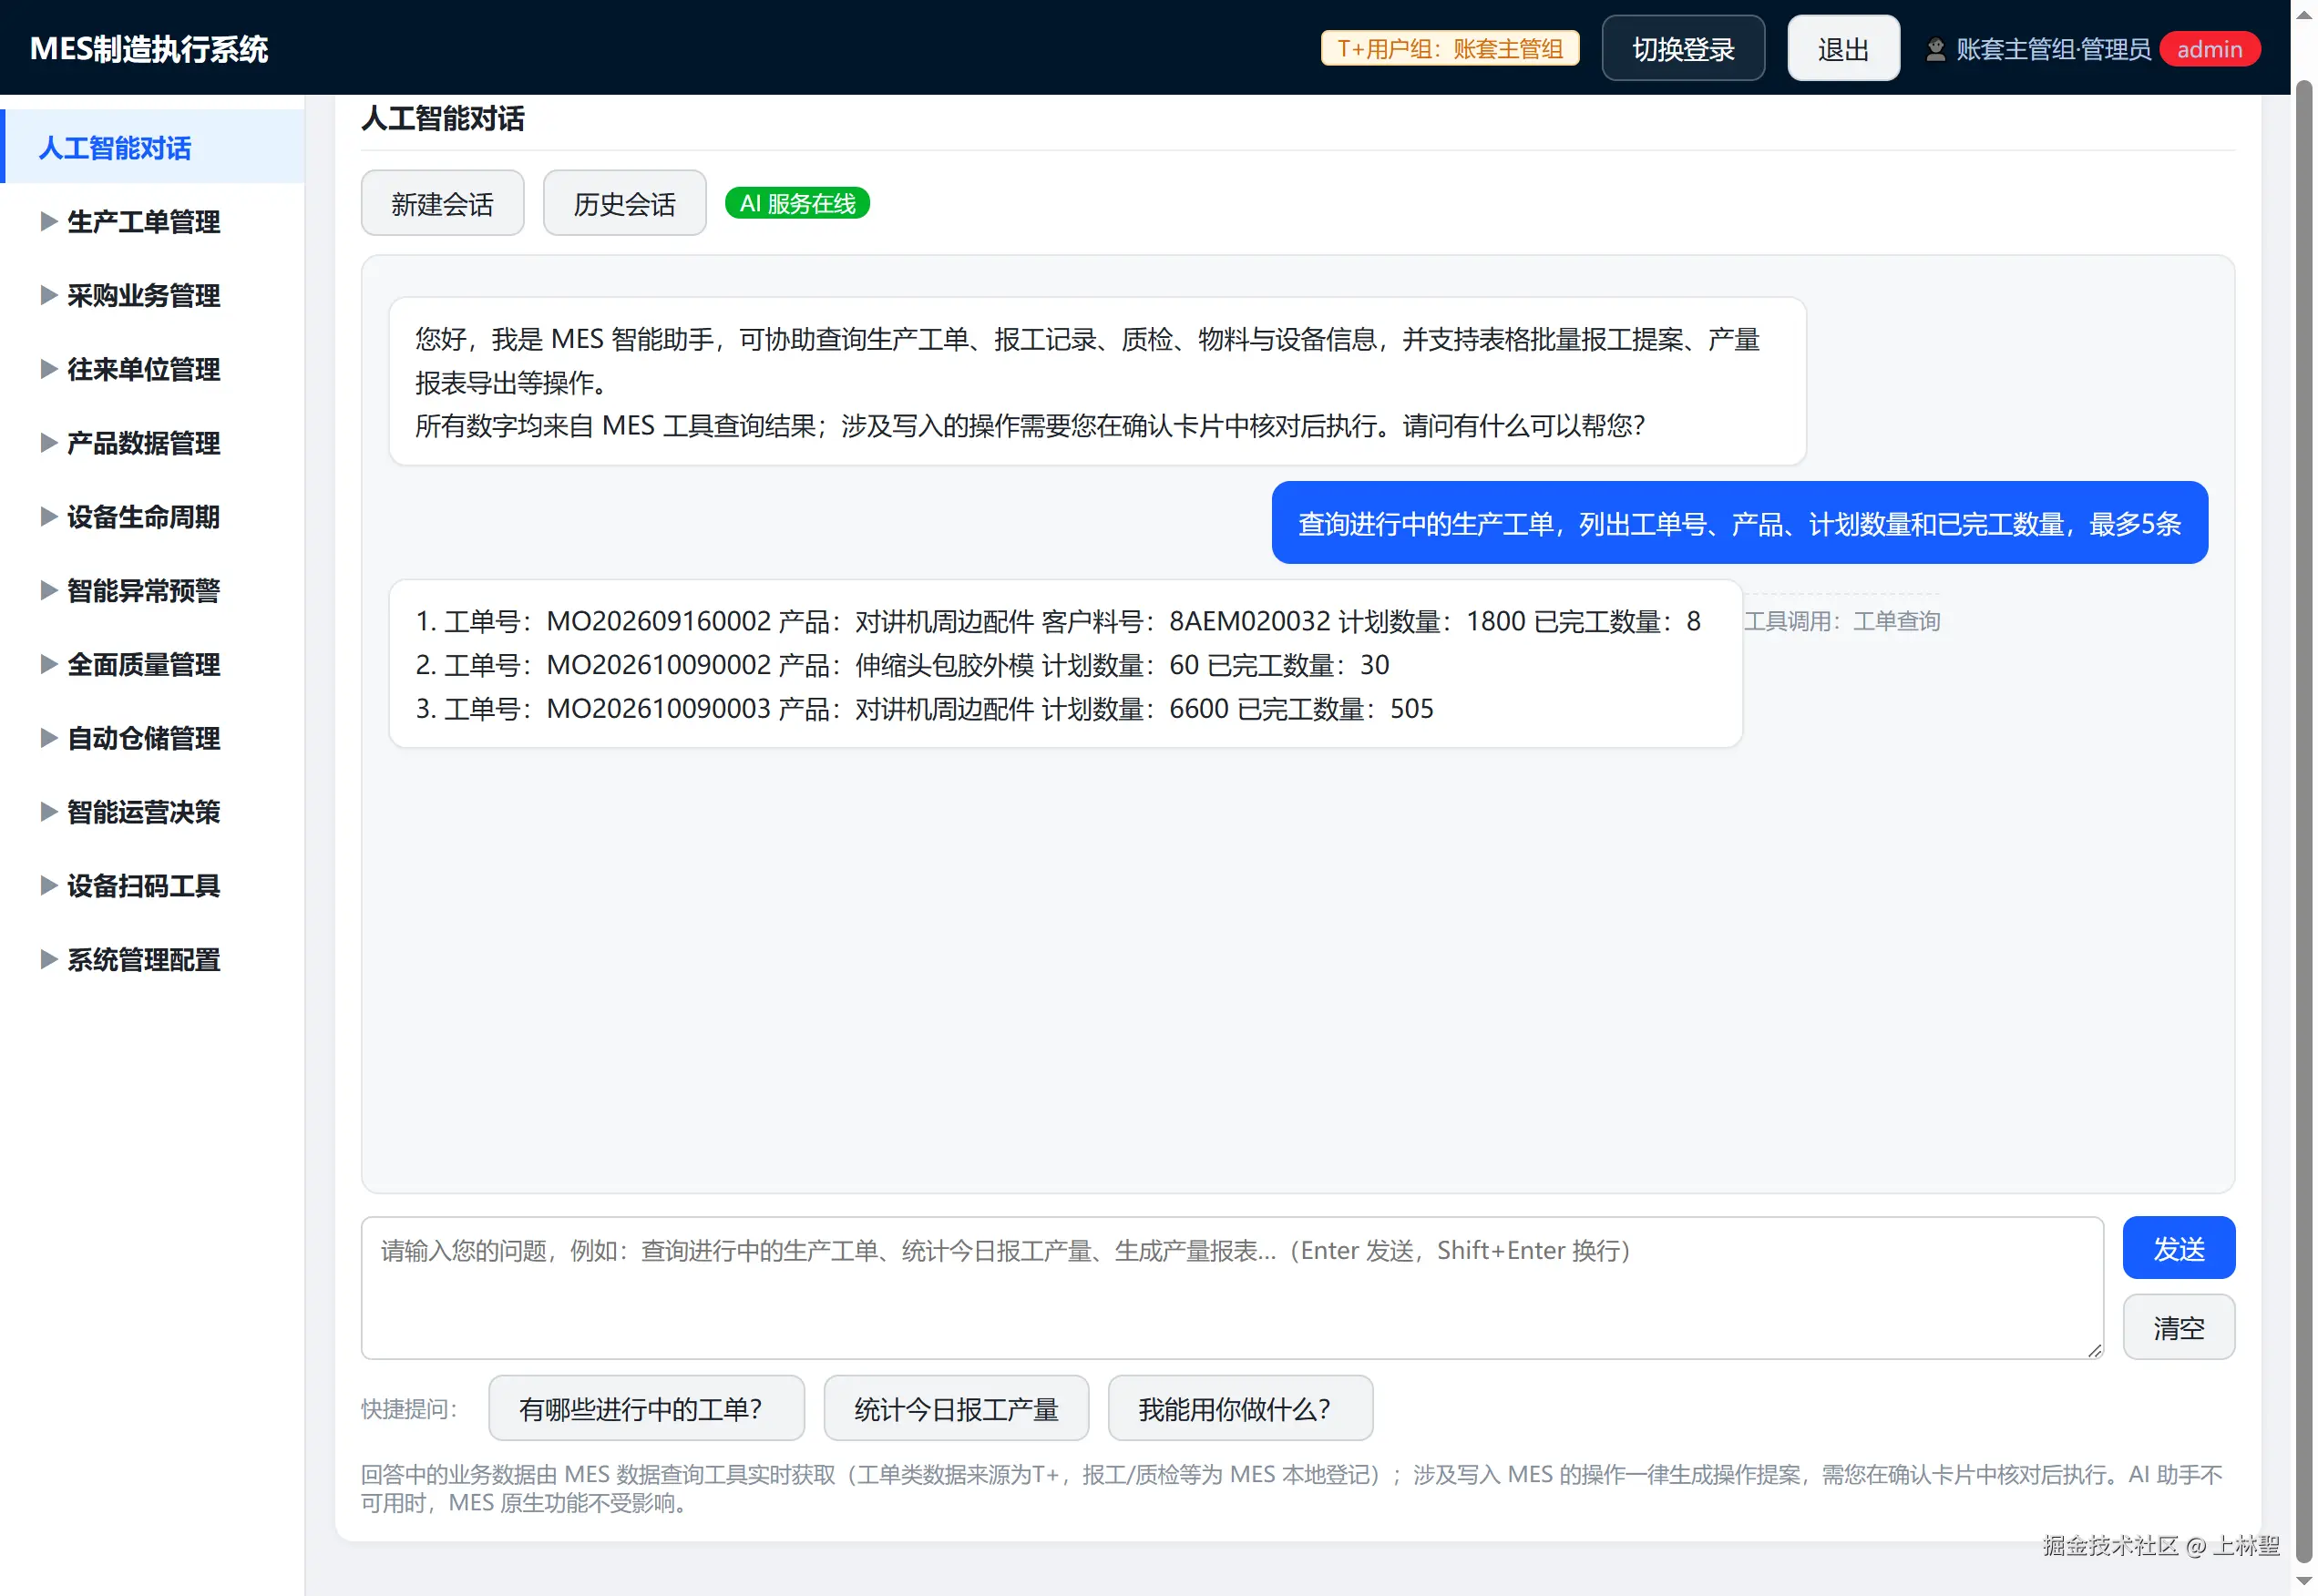
AI 查询真实工单数据(回答中的数字全部来自 MES 工具查询,标注数据来源):
写操作一律生成提案,人工核对确认卡片后才落库(令牌 5 分钟、一次性):
集成当天的浏览器真机验证还抓到三个小问题:本地 8B 模型爱传「今日/进行中」这类口语参数被 schema 枚举拒绝(加别名归一层解决)、快捷提问只填框不发送、推理降级时状态标签不变色------当天全部闭环复测通过。
六、成果清单
| 指标 | 数值 |
|---|---|
| 项目周期 | 2026-09-17 立项 → 10-12 迭代至 v1.2.0(26 天) |
| Git 提交 | 217 次(Conventional Commits 规范 + pre-commit 门禁) |
| 代码规模 | 127 个源文件,约 3.5 万行(不含三方库) |
| 自动化测试 | 574 通过 / 1 跳过(全程保持全绿才合并) |
| API 路由 / 数据表 | 335 条 / 74 张表 |
| 并发压测 | 30 用户 780s,4123 请求零崩溃零超时 |
| 性能优化 | BI 过期并发 9480ms → 32ms;BOM 重复访问 2757ms → 3.0ms |
| AI 模块 | 本地 Qwen3-8B + 18 个业务工具,写操作 100% 人工确认 |
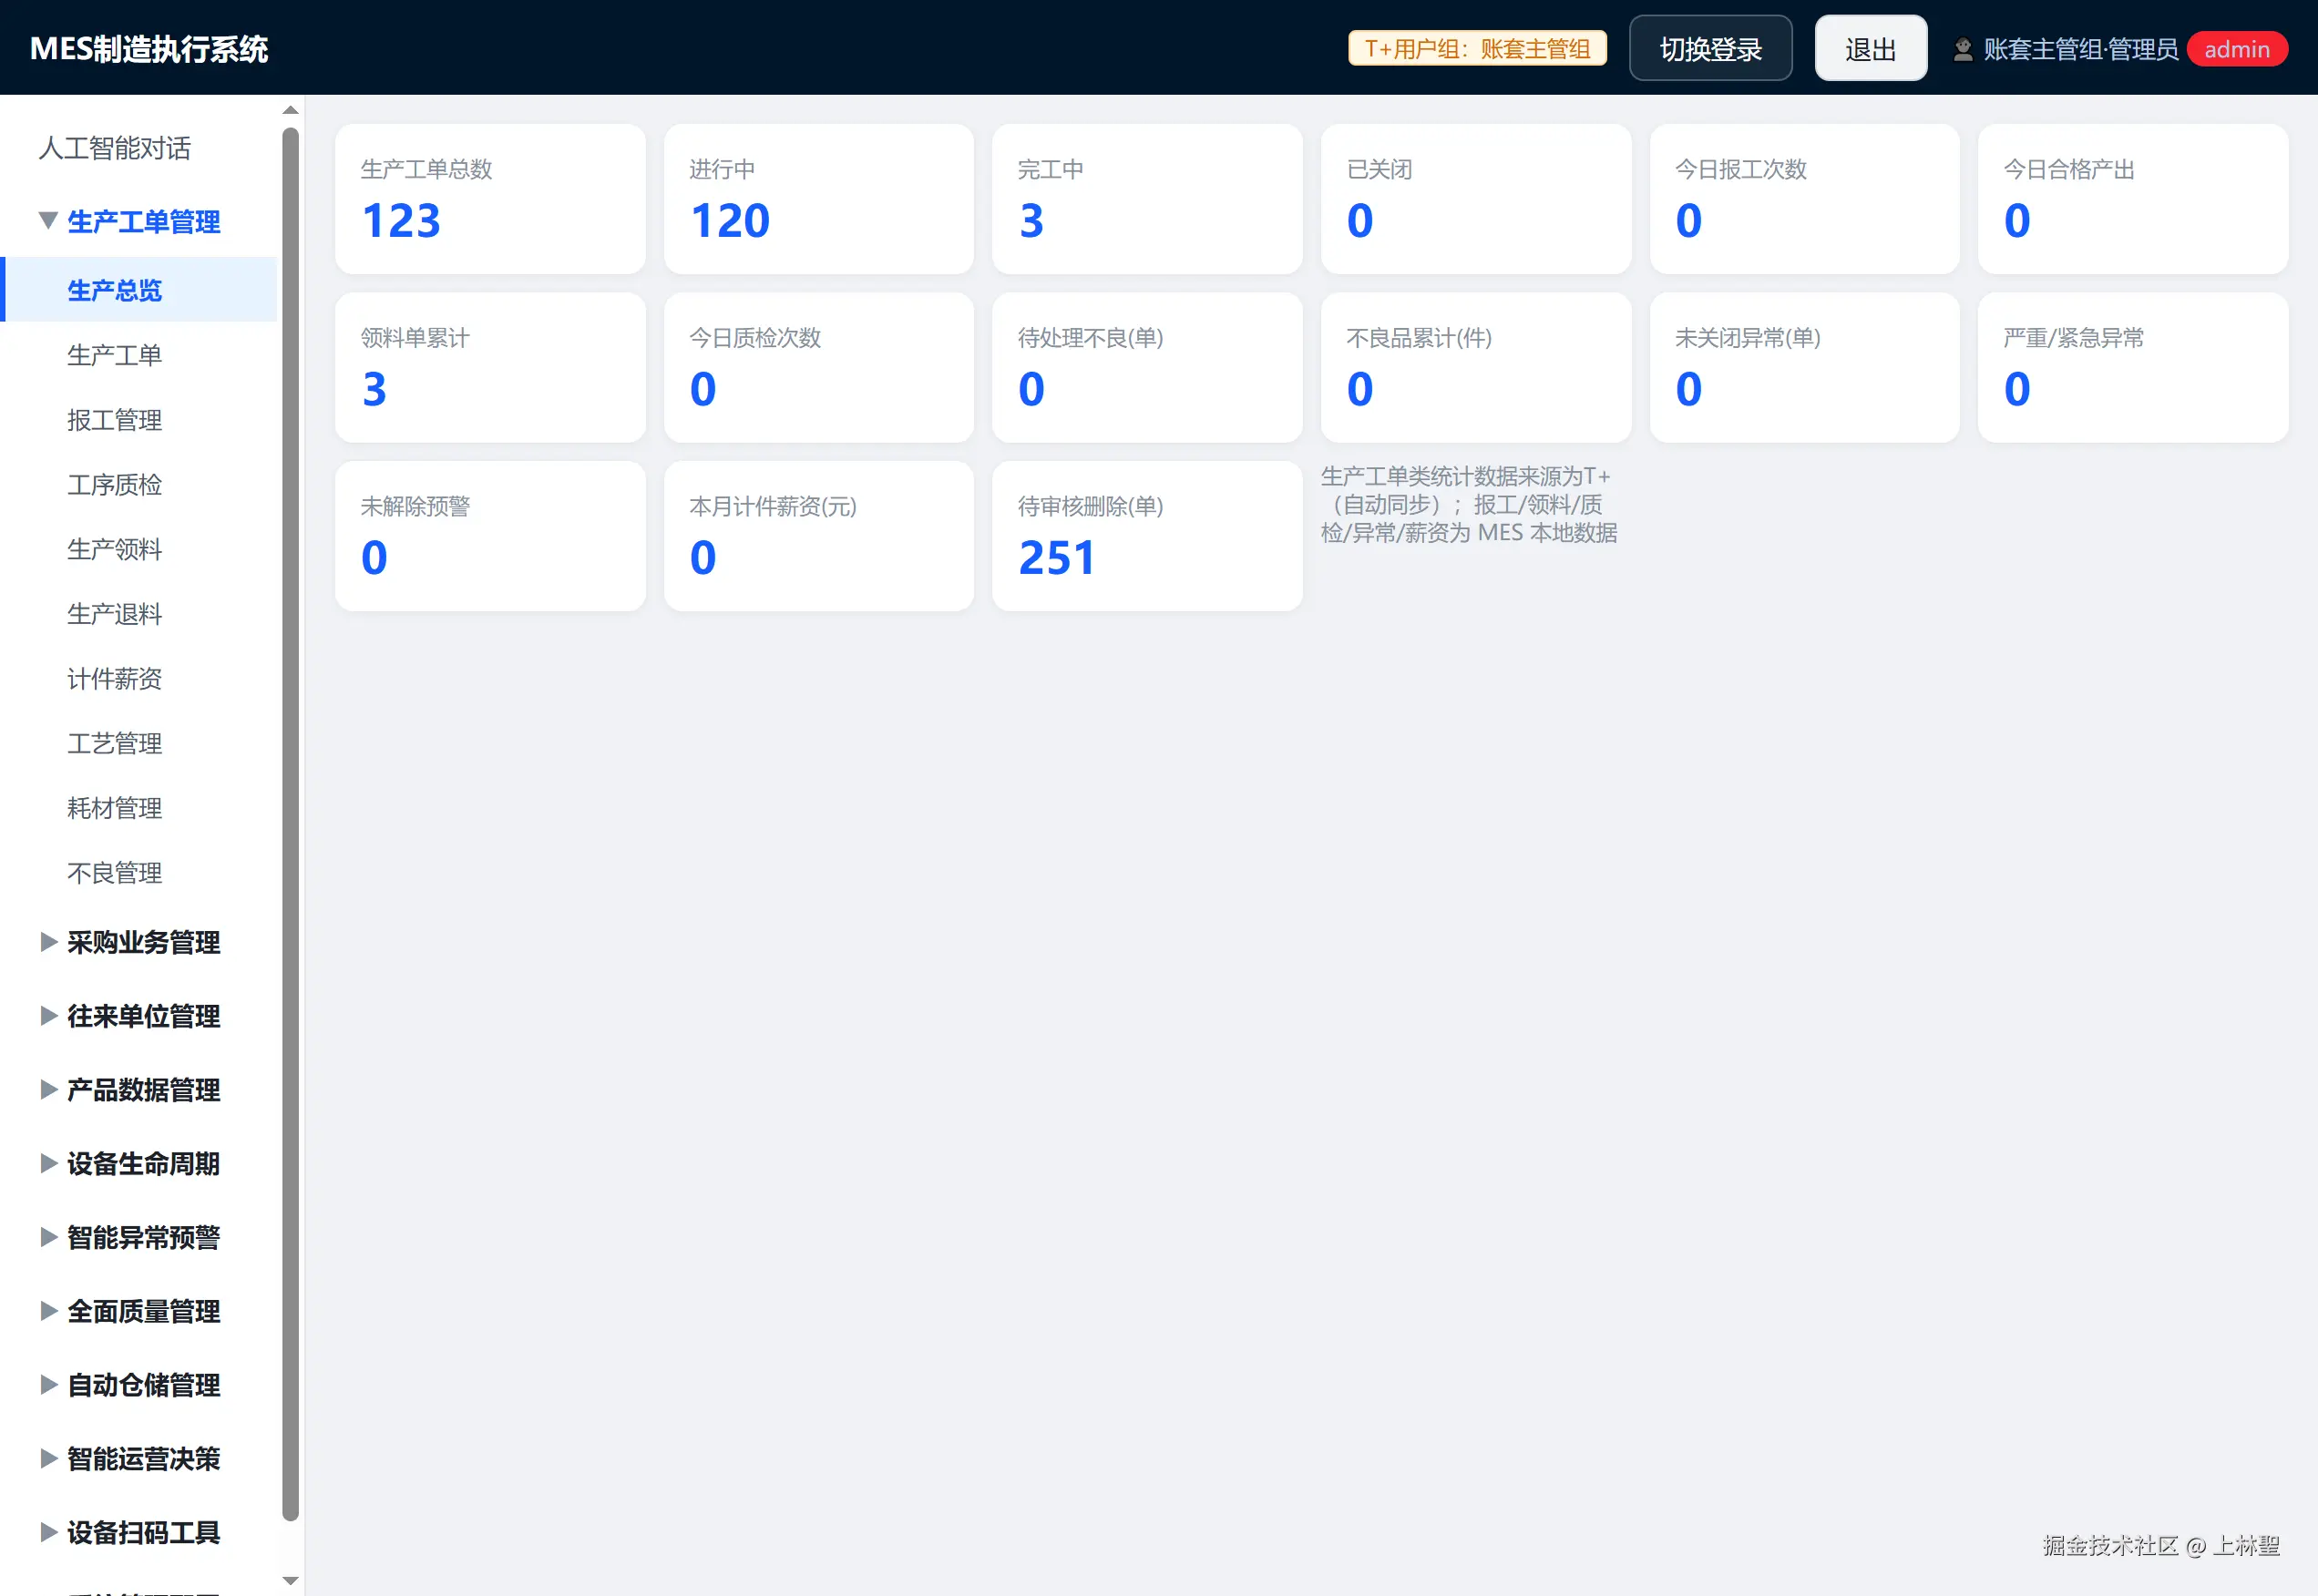
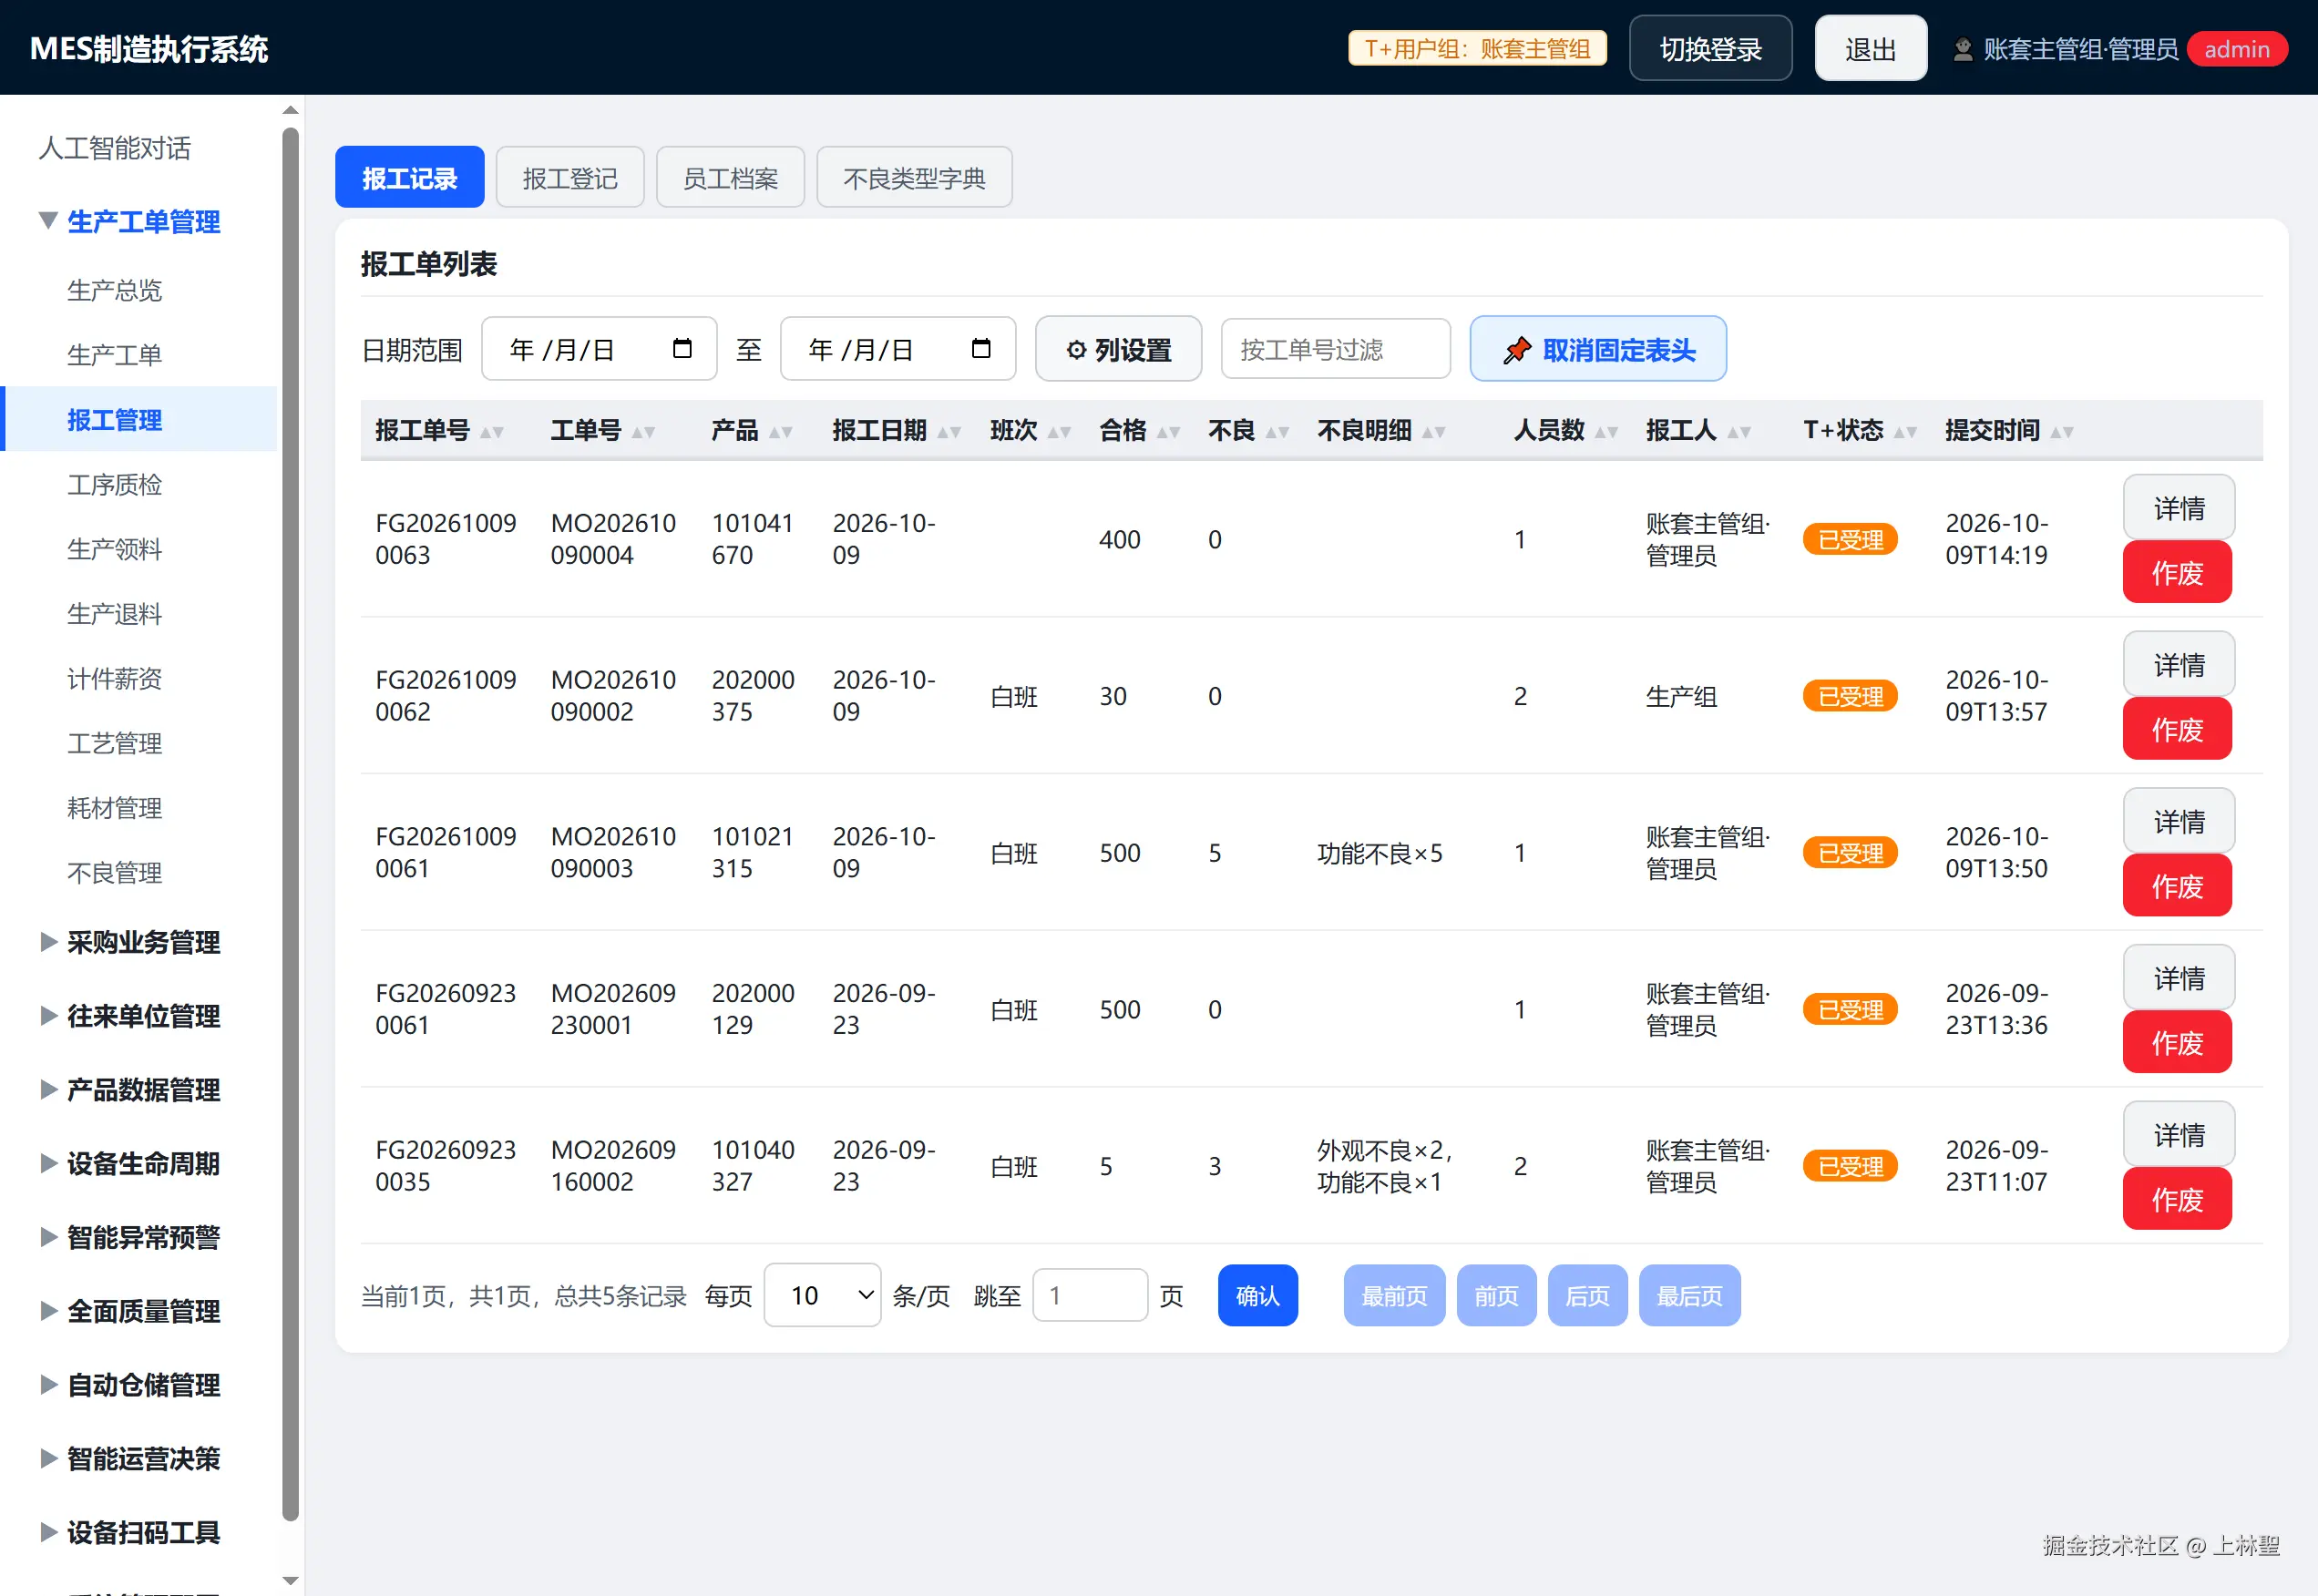
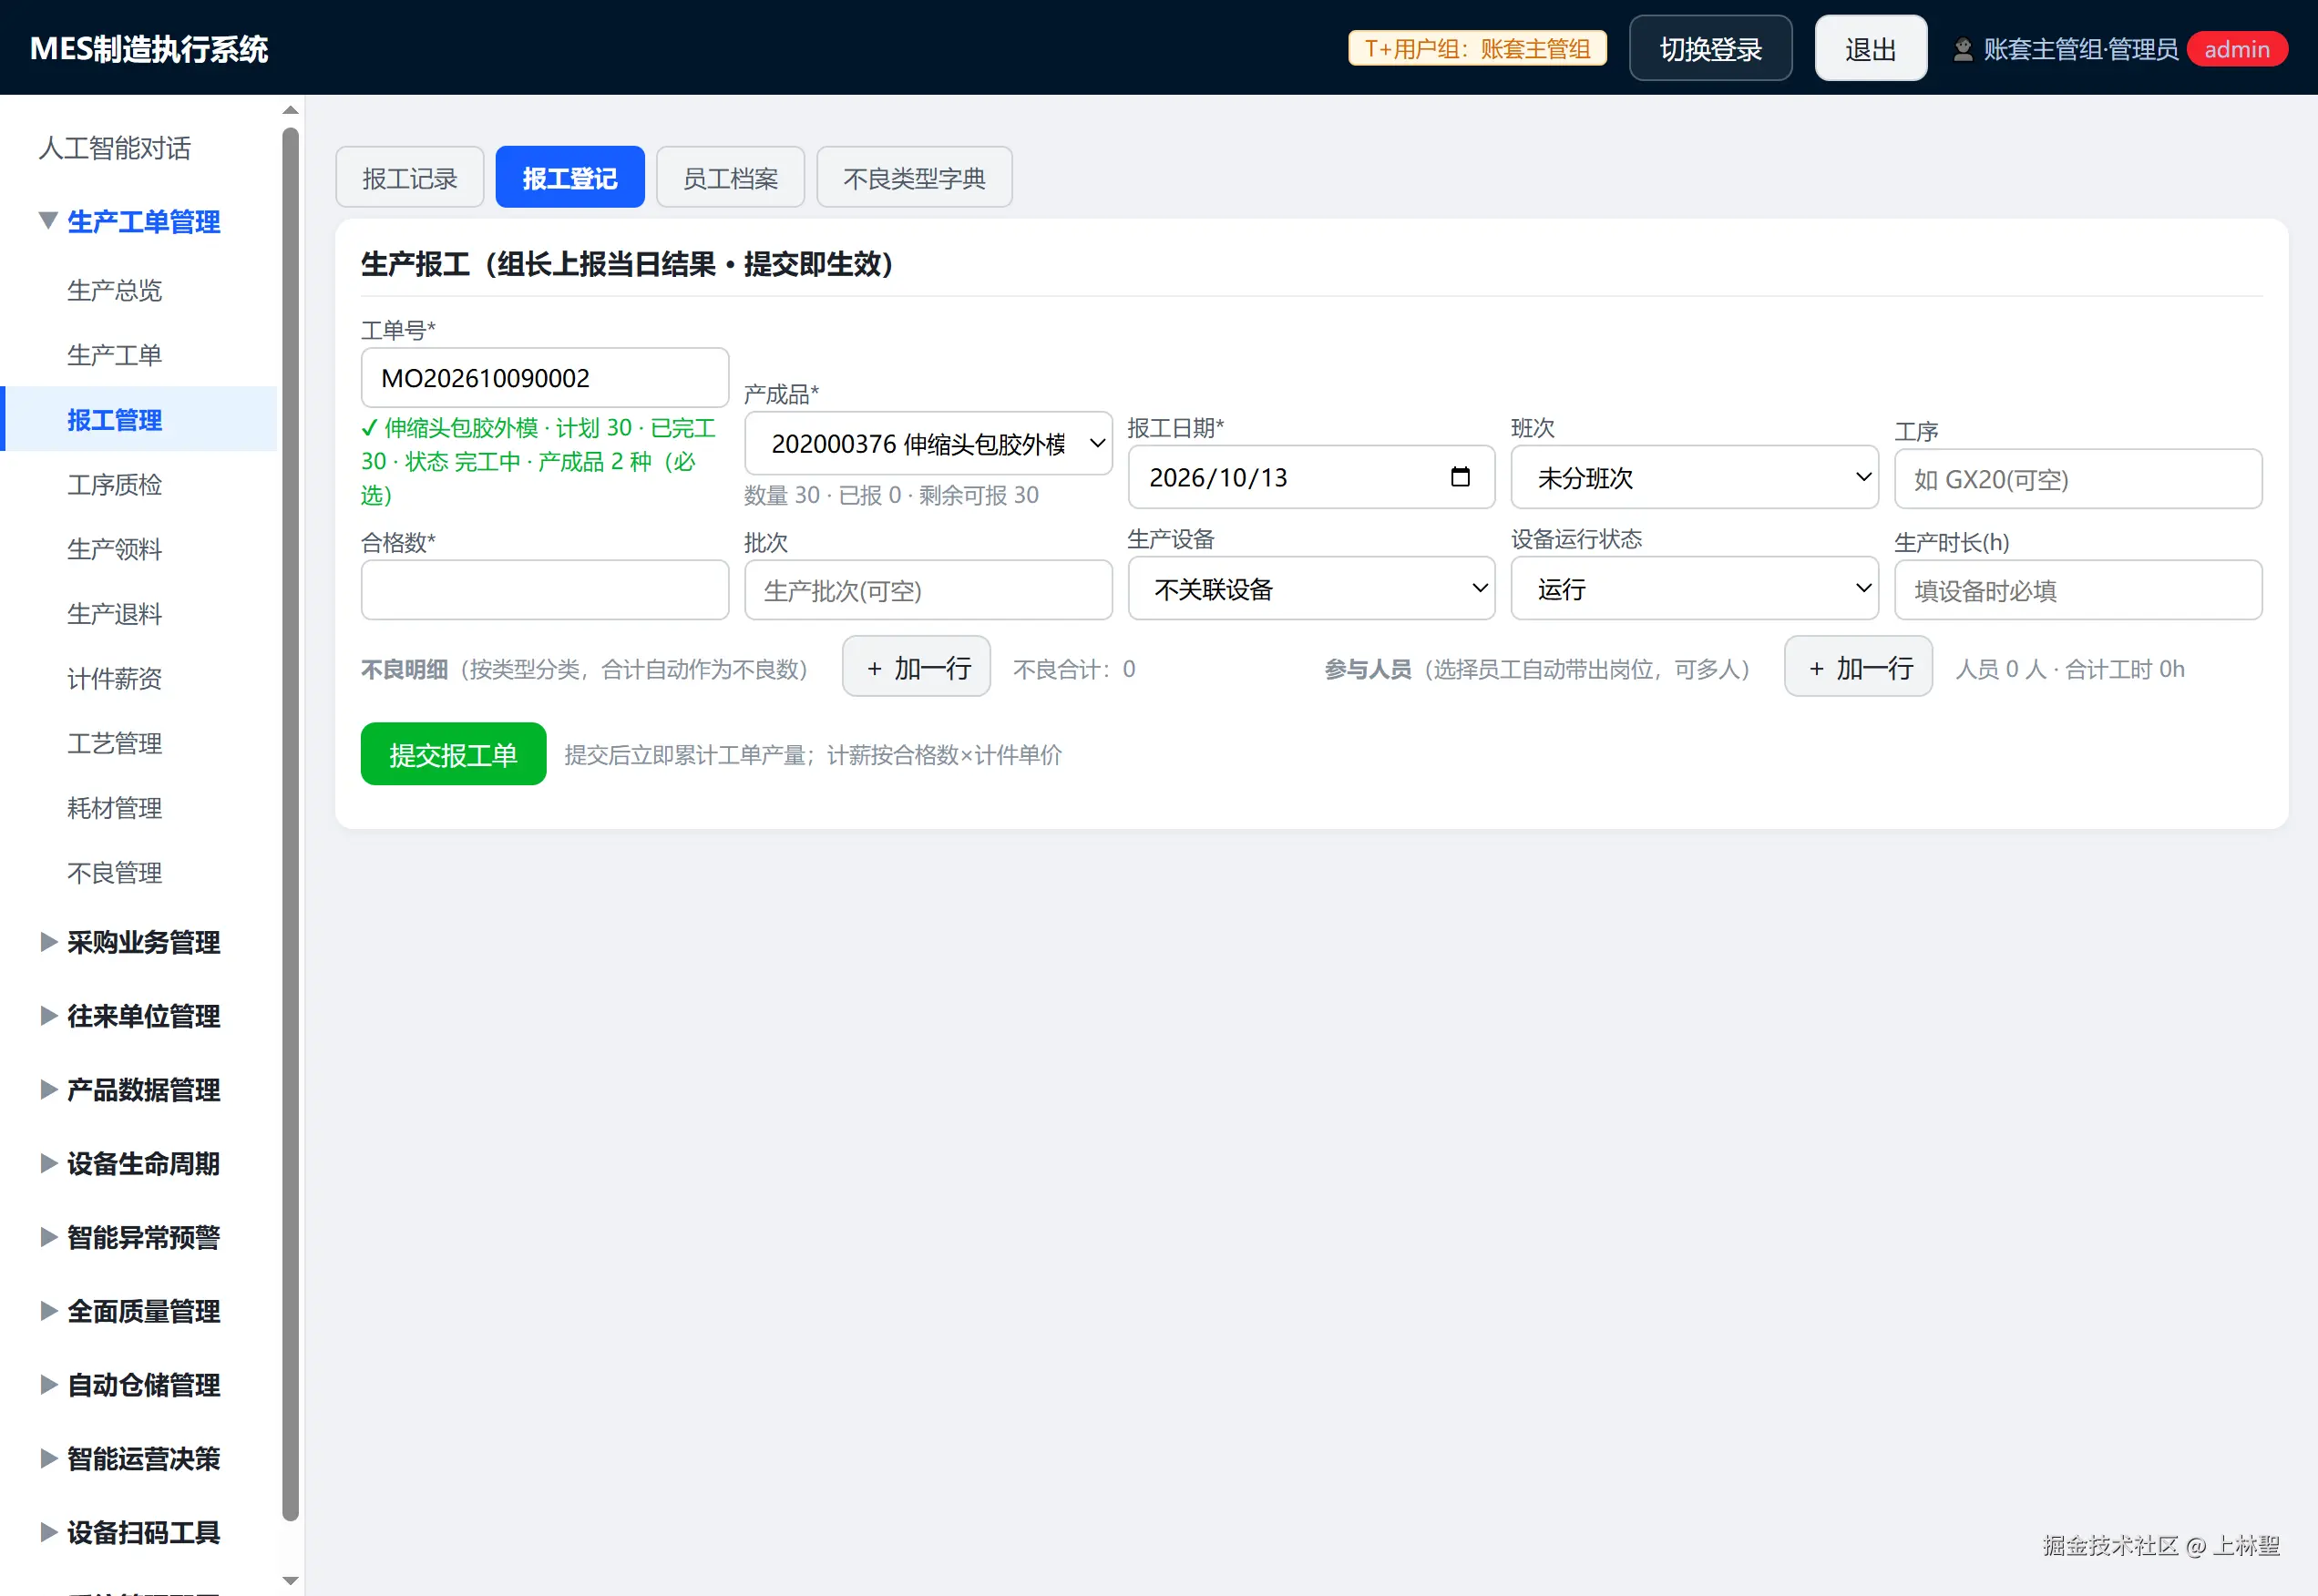
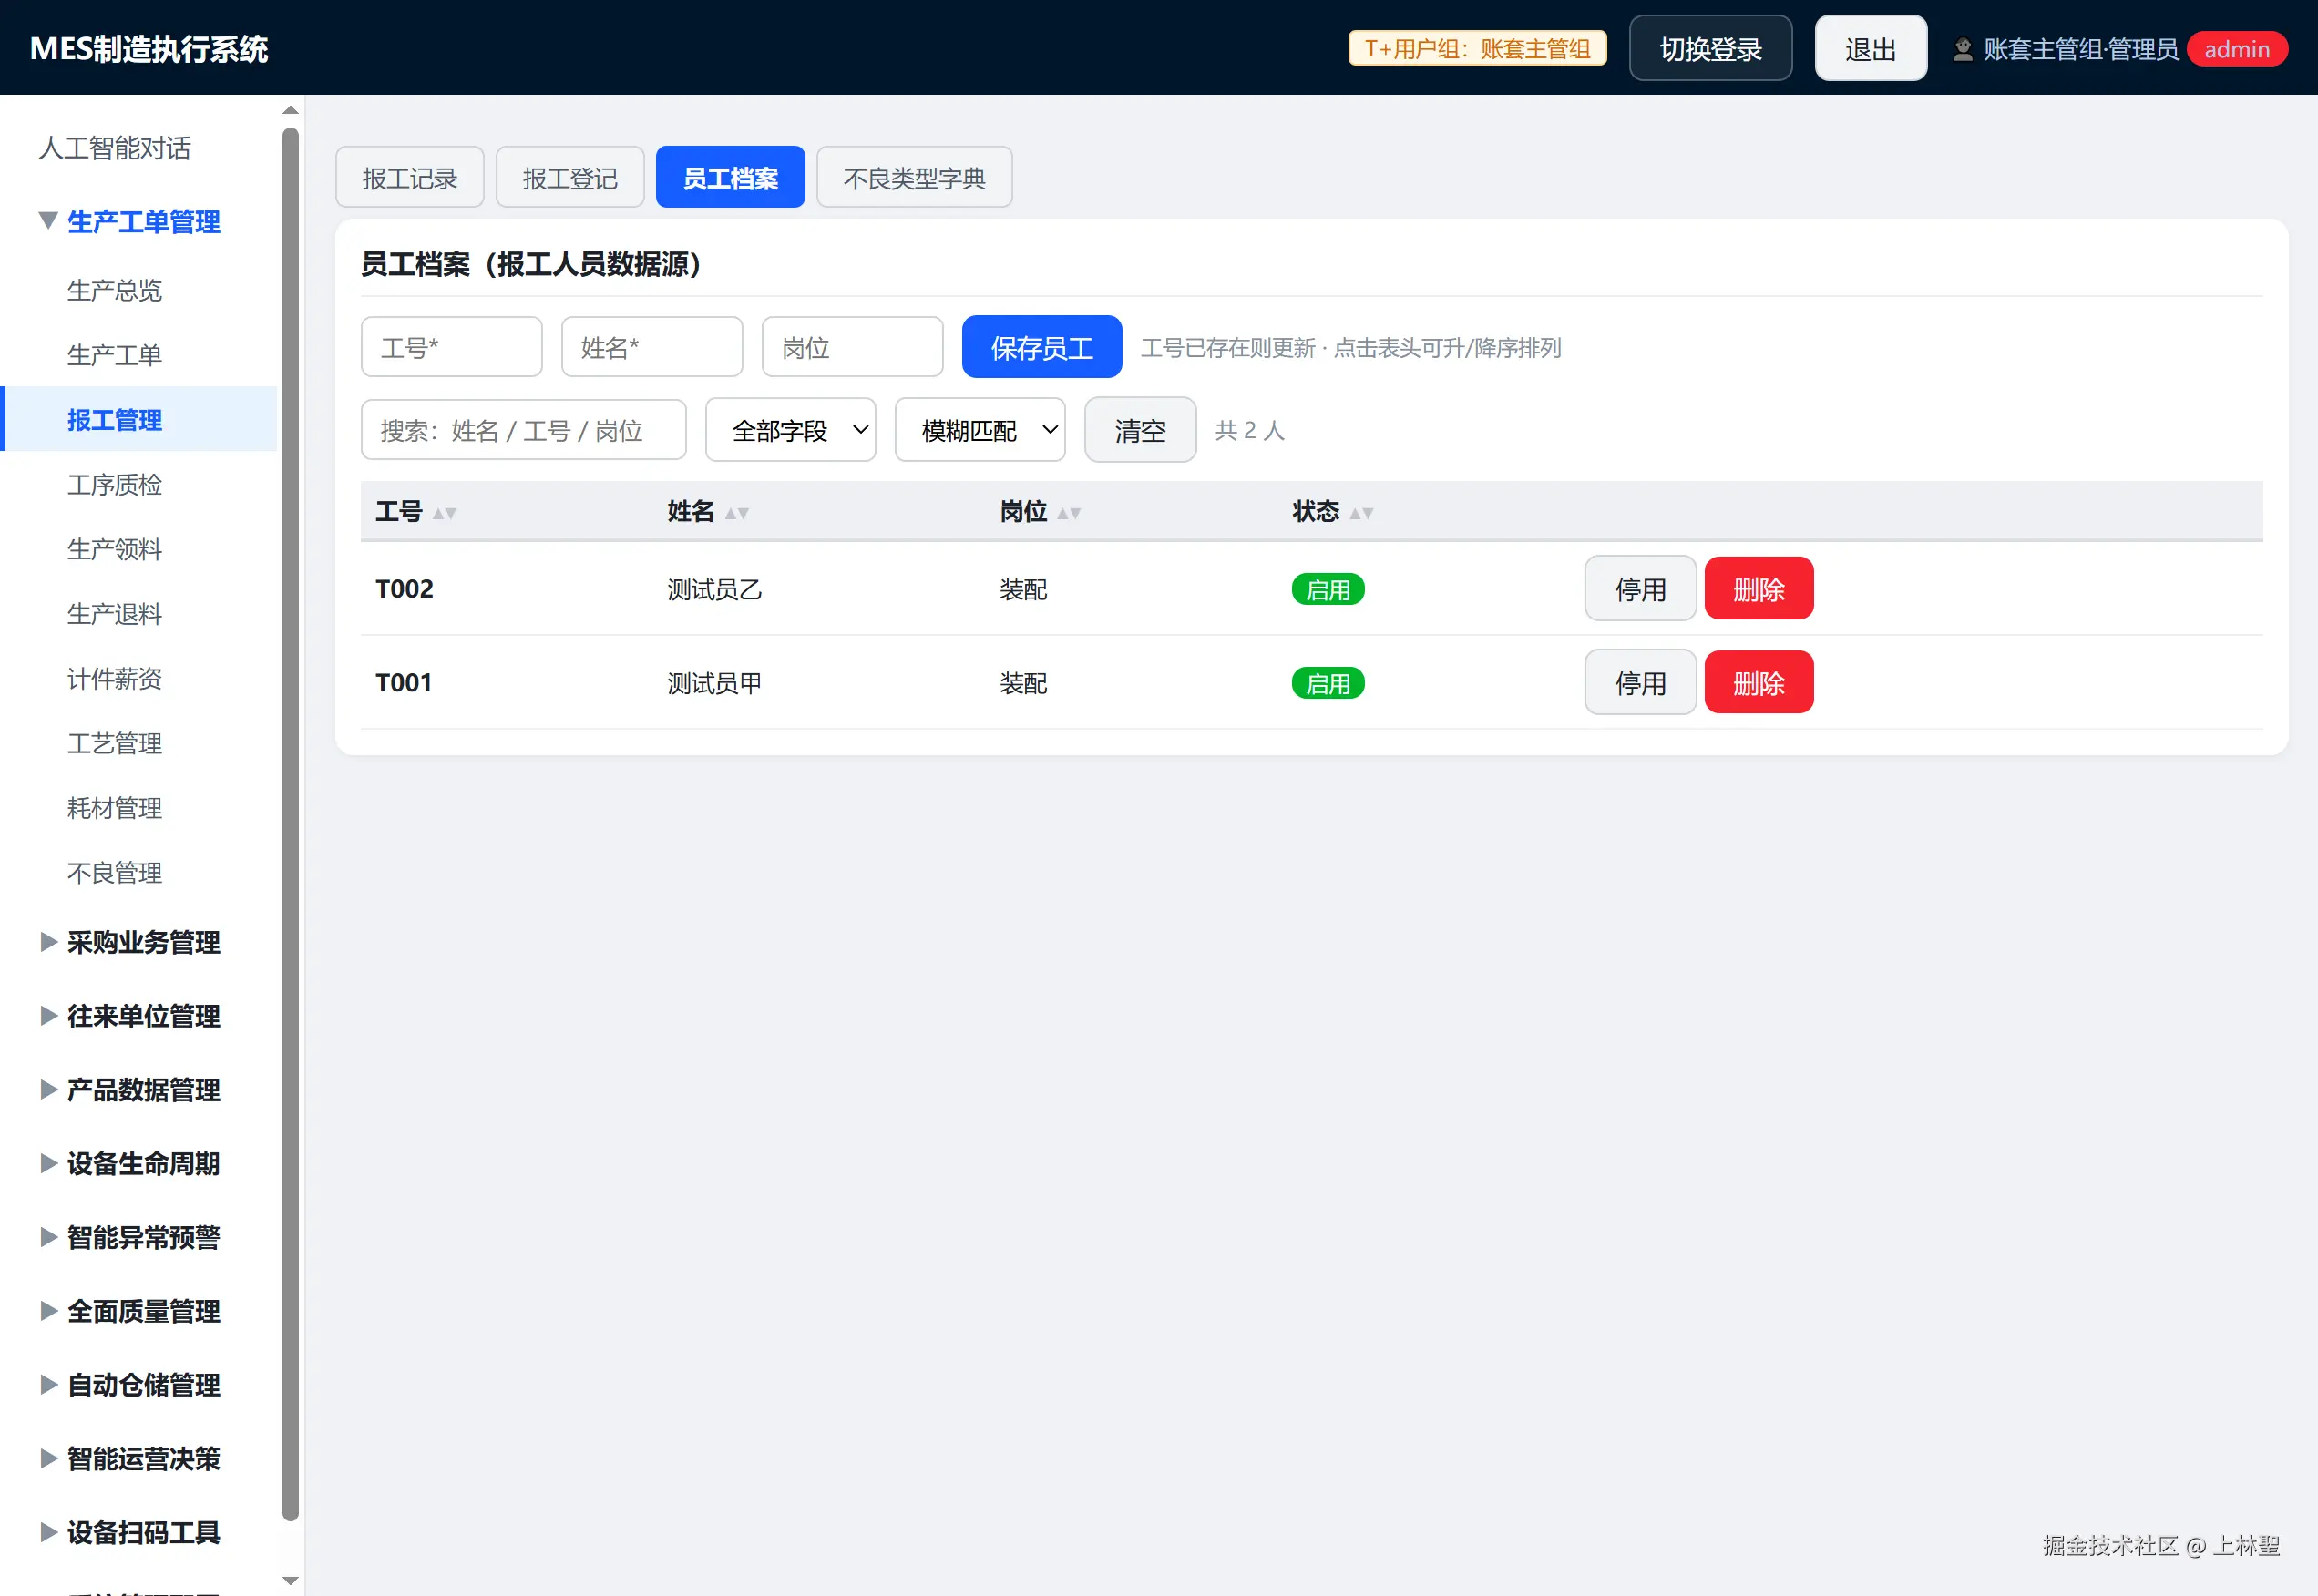
功能上,系统覆盖 人工智能对话、生产工单、报工管理(产品×工序双维)、工序质检、生产领退料、计件薪资、工艺管理、自动化仓储、采购、往来单位、异常预警、数据删除审核 等模块,界面全量中文化,表格排序、分页、导出都是全站通用能力。
生产总览看板(15 张统计卡,T+ 来源与 MES 本地数据分开标注):
报工管理四页签:报工记录 / 报工登记 / 员工档案 / 不良类型字典
七、写在最后
回顾这 26 天,最大的感受有两点:
第一,AI 编程工具的价值不在「替你写代码」,而在「替你守住规矩」。 这个项目能保持 574 个测试持续全绿、每次改动都走完计划 → 实现 → 回归的闭环,靠的是把工程约定沉淀成项目规则,让 TRAE 在每个环节自动对齐------人只负责做决策和验收。
第二,真实项目是最好的试炼场。 缓存惊群的 39.7 秒、提权脚本的静默失败、HTTP 头的 latin-1 编码坑、本地 8B 模型的口语参数------这些坑没有一个出现在教程里,全部来自真实生产环境。而 TRAE 让「发现 → 定位 → 修复 → 回归」的循环压缩到了小时级。
接下来系统会按「IT 部署上线 → 单产线试点 → 全员培训切换正式模式」三步推行,AI 报工提案灰度观察两周后全量放开。后续我打算再写一篇部署推行篇,聊聊小工厂如何用「便携化 + 计划任务自愈」实现零运维落地。
如果你也在用 TRAE 做真实项目,欢迎评论区交流。
话题:#全新 TRAE 实战体验