一、痛点场景:快运系统的数据库"慢性病"
快运系统和快递系统最大的区别在于货量大、流程长、对账重。
本文作者:深圳+Eyf•半字节科技▪技术产品团队
物流、快递、快运作业管理系统,让每一票,都清晰可控。从任务分配到签收回传,一站式管理每个作业环节。
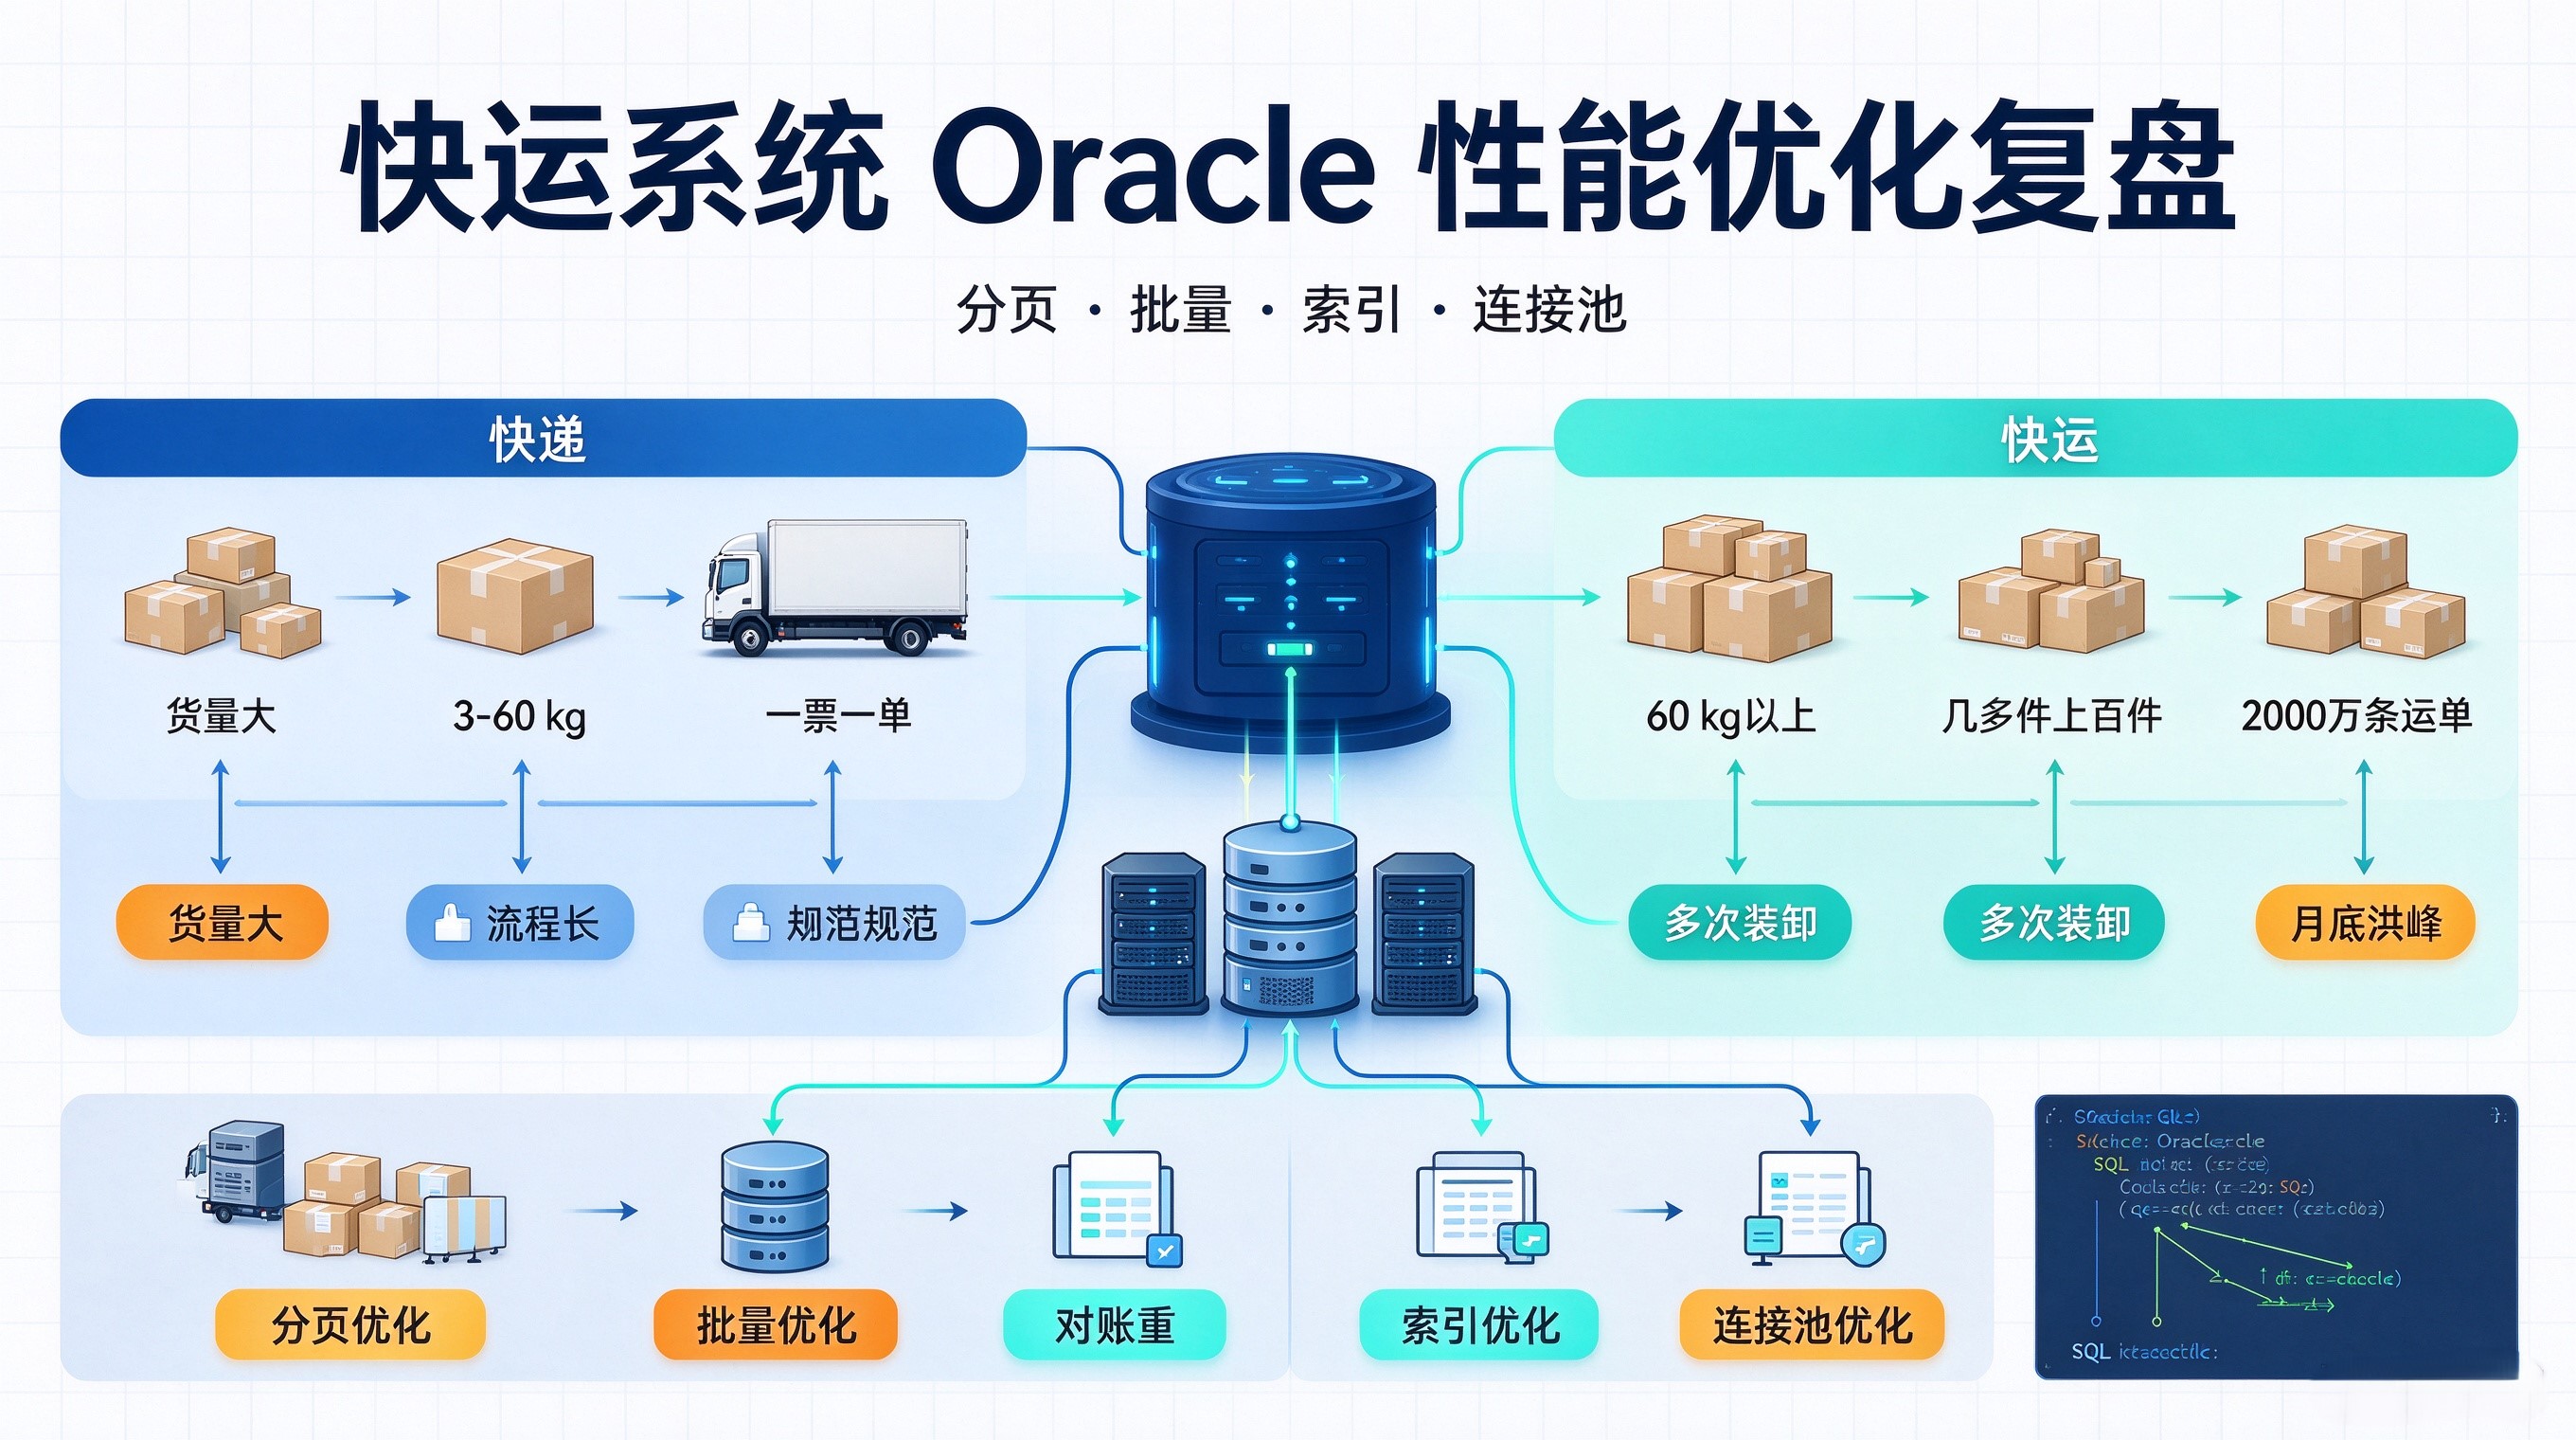
快递主打 3-60 公斤段的小件,一票一单,流程相对标准。而快运主打 60 公斤以上的大票货,一单可能对应几十件、上百件货物,装卸车次数多,中转环节长。到了月底对账,财务要跑几百个网点的营收结算,数据量瞬间从"日常"跳到"洪峰"。
我们的快运系统基于 Java + Spring Boot + Oracle 构建。日常运行还算平稳,但一到大促或者月底,问题就集中爆发:
运单查询越来越慢:系统跑了一年,运单表积累了 2000 多万条记录,一个简单的"按手机号查运单"要等 3-5 秒
批量操作超时:月底营收结算,一次要处理几万条计费记录,Oracle 的批量插入走的是"逐条提交",跑几个小时都跑不完
分页查询"翻到后面就崩":运营人员翻到第 50 页之后,页面直接卡死,后台日志显示全表扫描
数据量涨了,系统没涨:业务量翻了一倍,数据库硬件没变,系统越来越"重"
这些问题不是一夜之间出现的,是数据量增长 + 代码写法不当长期积累的结果。
这篇文章完整复盘我们的 Oracle 性能优化过程------分页、批量、索引、连接池四个维度的实战调整,包含可直接运行的代码和踩坑记录。
二、分页优化:Oracle 的"分页陷阱"
2.1 为什么 Oracle 分页容易踩坑
Java 开发者习惯了 MySQL 的 LIMIT offset, size,迁移到 Oracle 后,很多人还是"翻译"着写 SQL。但 Oracle 的分页语法和 MySQL 完全不同,写不好就是全表扫描 + 排序 + 再截取。
Oracle 12c 之前只有 ROWNUM 伪列,而且 ROWNUM > n 永远返回空结果。正确的嵌套写法是:
sql
SELECT * FROM (
SELECT t.*, ROWNUM rn FROM your_table t
WHERE ROWNUM <= 30
) WHERE rn > 10;
这个写法本身没问题,但问题在于:内层查询先扫描了前 30 行,外层再过滤掉前 10 行。如果表很大,内层的 ROWNUM <= 30 并没有减少实际的扫描量,因为 Oracle 需要先产生前 30 行才能判断。
2.2 快运系统的实际分页场景
快运系统的分页场景和快递不一样。快递的运单列表通常是"按时间倒序",翻到后面意义不大。但快运的对账查询需要翻到很深------财务要按网点、按客户、按日期范围逐页核对。
原来的写法是 MyBatis 的 RowBounds,底层走的是 Oracle 的 ROWNUM 嵌套。数据量到千万级后,翻到第 100 页时,SQL 变成了:
sql
SELECT * FROM (
SELECT t.*, ROWNUM rn FROM waybill t
WHERE create_time >= ? AND create_time < ?
) WHERE rn BETWEEN 990 AND 1010;
内层查询先扫描满足条件的所有行,给它们编上 ROWNUM,外层再截取第 990-1010 行。内层扫描量 = 第 1010 行之前的所有数据。
优化后的做法是两阶段查询:先用覆盖索引查出主键,再回表取明细。
sql
-- 第一阶段:只查主键,利用索引
SELECT waybill_id FROM (
SELECT waybill_id, ROWNUM rn FROM (
SELECT waybill_id FROM waybill
WHERE create_time >= ? AND create_time < ?
ORDER BY create_time DESC
) WHERE ROWNUM <= 1010
) WHERE rn > 990;
-- 第二阶段:根据主键批量回表
SELECT * FROM waybill WHERE waybill_id IN (?, ?, ...);
关键差异在于:第一阶段只扫描索引,不扫表。如果 create_time 上有索引,Oracle 可以直接从索引取前 1010 条主键,不需要扫描全表。
2.3 Oracle 12c+ 的 OFFSET FETCH
如果数据库版本是 12c 及以上,可以用更标准的 OFFSET ... FETCH 语法:
sql
SELECT * FROM waybill
WHERE create_time >= ?
ORDER BY create_time DESC
OFFSET 990 ROWS FETCH NEXT 20 ROWS ONLY;
这个语法比 ROWNUM 嵌套更简洁,但性能陷阱是一样的------Oracle 仍然需要先排序并跳过前 990 行才能返回结果。如果 ORDER BY 的列没有索引,性能会非常差。
结论:分页性能的关键不在语法,在于能否用索引直接定位到目标范围。翻得越深,对索引的要求越高。
三、批量操作:从"逐条提交"到"批量绑定"
3.1 快运系统里最慢的操作
快运系统的批量操作比快递多。一次装车可能涉及几百件货,一次对账可能涉及几万条计费记录。原来的代码用的是 MyBatis 的 foreach 标签拼接 INSERT ALL,或者循环调用 insert 方法:
java
// 旧写法:循环单条插入
for (BillingRecord record : records) {
billingMapper.insert(record);
}
在 Oracle 上,这种写法的性能灾难在于:每一次 insert 都是一次网络往返 + 一次 SQL 解析 + 一次事务提交。1 万条记录就是 1 万次网络往返。如果客户端和数据库之间的延迟是 1ms,光网络往返就浪费了 10 秒,加上 SQL 解析和日志写入,几分钟都跑不完。
3.2 批量绑定的正确写法
MyBatis 在 Oracle 上做批量插入,推荐使用 ExecutorType.BATCH:
java
@Configuration
public class MyBatisBatchConfig {
@Bean
public SqlSessionTemplate batchSqlSessionTemplate(
        SqlSessionFactory sqlSessionFactory) {
    return new SqlSessionTemplate(sqlSessionFactory,
        ExecutorType.BATCH);
}
}
然后在 Service 中注入这个批量模板:
java
@Service
public class BillingService {
@Autowired
@Qualifier("batchSqlSessionTemplate")
private SqlSessionTemplate batchSqlSession;

public void batchInsertBilling(List<BillingRecord> records) {
    BillingMapper mapper = batchSqlSession.getMapper(
        BillingMapper.class);

    for (int i = 0; i < records.size(); i++) {
        mapper.insert(records.get(i));
        // 每1000条flush一次,避免内存积压
        if ((i + 1) % 1000 == 0) {
            batchSqlSession.flushStatements();
        }
    }
    batchSqlSession.flushStatements();
}
}
ExecutorType.BATCH 的原理是:MyBatis 把多条 INSERT 攒在 JDBC 的 PreparedStatement 里,达到 batch size 后一次性发给 Oracle。网络往返从 N 次降到 N/batchSize 次。
3.3 快运场景的"批次大小"调优
批次大小不是越大越好。我们测试了不同 batchSize 在快运计费场景下的表现:
batchSize 1万条耗时 内存占用 适用场景
100 约 8 秒 低 日常小批量
500 约 3 秒 中 常规对账
1000 约 2.5 秒 中高 月底结算
5000 约 2.3 秒 高 不推荐(OOM风险)
结论 :batchSize 设置为 500-1000 是最佳平衡点。超过 1000 后性能提升不明显,但内存风险显著增加。
四、索引策略:快运查询的"精准打击"
4.1 快运系统的查询特征
快运系统的查询和快递有个本质区别:多条件组合查询多。
快递的运单查询通常是"单号精确查询"或者"手机号查询",条件简单。快运的查询场景复杂得多:
"查这个网点今天发出的所有货"
"查这个客户本月所有未结算的运单"
"查这辆车今天装了多少票货,总体积和总重量是多少"
这些查询涉及网点 ID、时间范围、客户 ID、车辆 ID、状态的组合过滤。如果索引设计不当,Oracle 很容易走全表扫描。
4.2 组合索引的"最左前缀"原则
快运系统最常见的查询模式是:网点 + 时间范围 + 状态。
sql
SELECT * FROM waybill
WHERE origin_station_id = ?
AND create_time >= ?
AND create_time < ?
AND status IN ('PENDING', 'LOADED');
这个查询的索引设计应该是:
sql
CREATE INDEX idx_waybill_station_time
ON waybill (origin_station_id, create_time, status);
顺序很重要:等值条件在前,范围条件在后。origin_station_id 是等值查询,放在最前面;create_time 是范围查询,放在后面;status 是 IN 查询,放在最后。
如果顺序写反,比如 (create_time, origin_station_id, status),Oracle 可能仍然走索引,但扫描的索引范围会大很多,因为时间范围先限定了,然后再过滤站点,效率低。
4.3 覆盖索引减少回表
快运系统的"列表页查询"通常只需要展示摘要信息,不需要全字段。这时候可以用覆盖索引:
sql
-- 列表页查询:只查摘要字段
SELECT waybill_no, origin_station, dest_station,
create_time, total_weight, status
FROM waybill
WHERE origin_station_id = ?
AND create_time >= ?
ORDER BY create_time DESC;
如果索引包含所有查询字段:
sql
CREATE INDEX idx_waybill_list
ON waybill (origin_station_id, create_time DESC,
waybill_no, dest_station, total_weight, status);
Oracle 可以直接从索引返回结果,不需要回表。对于列表页这种高频查询,性能提升非常明显。
五、连接池配置:Oracle 的"隐性瓶颈"
5.1 HikariCP 在 Oracle 上的关键配置
Spring Boot 默认用 HikariCP,但针对 Oracle 需要调整几个参数:
yaml
spring:
datasource:
hikari:
Oracle 的验证查询必须用 FROM DUAL
connection-test-query: SELECT 1 FROM DUAL
Oracle 连接建立较慢,validation 超时适当放宽
validation-timeout: 3000
连接泄漏检测:快运系统批量操作多,容易忘记关闭
leak-detection-threshold: 60000
最大连接数:根据 Oracle 的 PROCESSES 参数调整
maximum-pool-size: 20
最小空闲连接:保持连接池"热"状态
minimum-idle: 5
5.2 Oracle 的 NLS_LANG 陷阱
快运系统涉及大量中文地址和客户名称。如果 NLS_LANG 设置不当,会出现中文乱码 或者查询不走索引的问题。
yaml
spring:
datasource:
url: jdbc:oracle:thin:@//host:1521/ORCL
明确指定字符集
hikari:
connection-init-sql: "ALTER SESSION SET NLS_LANG='AMERICAN_AMERICA.AL32UTF8'"
更稳妥的做法是在 JDBC URL 上指定:
yaml
url: jdbc:oracle:thin:@//host:1521/ORCL?useUnicode=true&characterEncoding=UTF-8
六、避坑指南
坑1:MyBatis-Plus 的 Oracle 分页插件"看起来正常,实际很慢"
现象:用 MyBatis-Plus 的 Page 对象分页,日常查询正常,但翻到后面就卡死。
原因:MyBatis-Plus 的 PaginationInnerInterceptor 在 Oracle 上默认用 ROWNUM 嵌套,而且它生成的 SQL 是先排序再分页。如果排序字段没有索引,Oracle 会先做一次全表排序。
解决 :确保 ORDER BY 的字段上有索引,或者改用游标分页(基于 create_time < 上一页最后一条的时间),避免深层翻页。
坑2:批量插入时 Oracle 的 ORA-12838 错误
现象:用 APPEND 提示做直接路径插入后,马上查询这批数据,报 ORA-12838: cannot read/modify an object after modifying it in parallel。
原因 :直接路径插入(INSERT /*+ APPEND */)会绕过 buffer cache,数据直接写入高水位线以上。插入完成后必须 COMMIT,否则数据不可见。
解决 :如果只是普通批量插入,不要用 APPEND。用 MyBatis 的 ExecutorType.BATCH 就够了。APPEND 适合百万级的数据导入,而且必须在 COMMIT 后才能查询。
坑3:Oracle 的 ROWNUM 和 ORDER BY 的"执行顺序陷阱"
现象:分页查询返回的结果顺序不对。
原因:Oracle 的 ROWNUM 是在 ORDER BY 之前分配的。如果写成:
sql
SELECT * FROM waybill WHERE ROWNUM <= 10 ORDER BY create_time DESC;
Oracle 先取前 10 行(不管顺序),再对这 10 行排序。结果就错了。
解决:必须先排序,再分配 ROWNUM。正确写法是嵌套两层:
sql
SELECT * FROM (
SELECT t.*, ROWNUM rn FROM (
SELECT * FROM waybill ORDER BY create_time DESC
) t WHERE ROWNUM <= 10
);
七、效果验证
优化上线后的关键指标对比:
指标 优化前 优化后
运单列表首页查询 3-5 秒 <200ms
运单列表第 50 页查询 超时(>30 秒) <800ms
月底结算批量插入(5万条) 约 45 分钟 约 90 秒
日常批量装车(500条) 约 15 秒 约 2 秒
数据库 CPU 峰值 85% 45%
核心改善来自三个方面:分页优化 把深层翻页从全表扫描改成索引定位;批量绑定 把网络往返从 N 次降到 N/1000 次;组合索引让高频查询从全表扫描变成索引覆盖。
八、总结
这次 Oracle 性能优化的核心经验可以用三句话概括:
分页的瓶颈不在语法,在索引:Oracle 的 ROWNUM、OFFSET FETCH 都只是"截取"语法,真正决定性能的是能否用索引直接定位到目标范围。深层翻页一定要用覆盖索引先查主键,再回表。
批量操作要减少网络往返:Oracle 的批量机制叫 Update Batching,底层是 PreparedStatement 的批量绑定。MyBatis 的 ExecutorType.BATCH 是正确姿势,batchSize 控制在 500-1000。
连接池配置要针对 Oracle 调整:connection-test-query 必须用 FROM DUAL,NLS_LANG 要显式设置避免中文乱码,leak-detection-threshold 要开启防止连接泄漏。
如果你也在做 Java + Spring Boot + Oracle 的快运系统,建议先从分页优化 和批量绑定入手。这两个是效果最直接、改动成本最低的优化点。索引策略需要结合具体的查询模式分析,连接池配置在项目初始化时就应该配好。
你在 Oracle 上遇到过哪些"玄学"性能问题?欢迎在评论区分享,一起避坑。