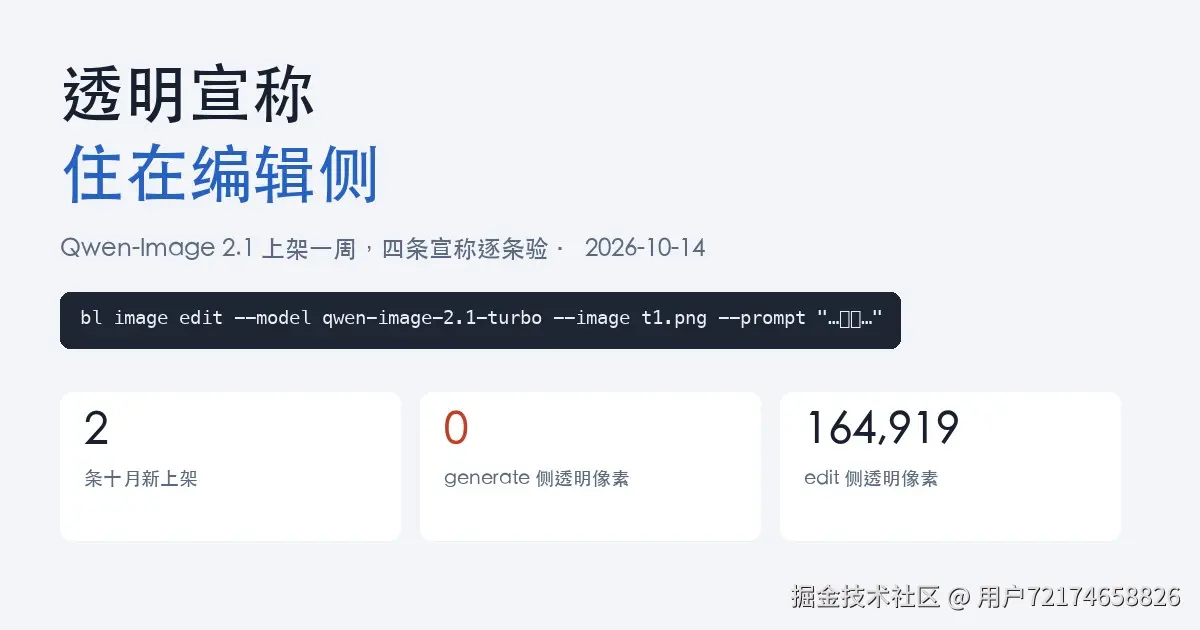
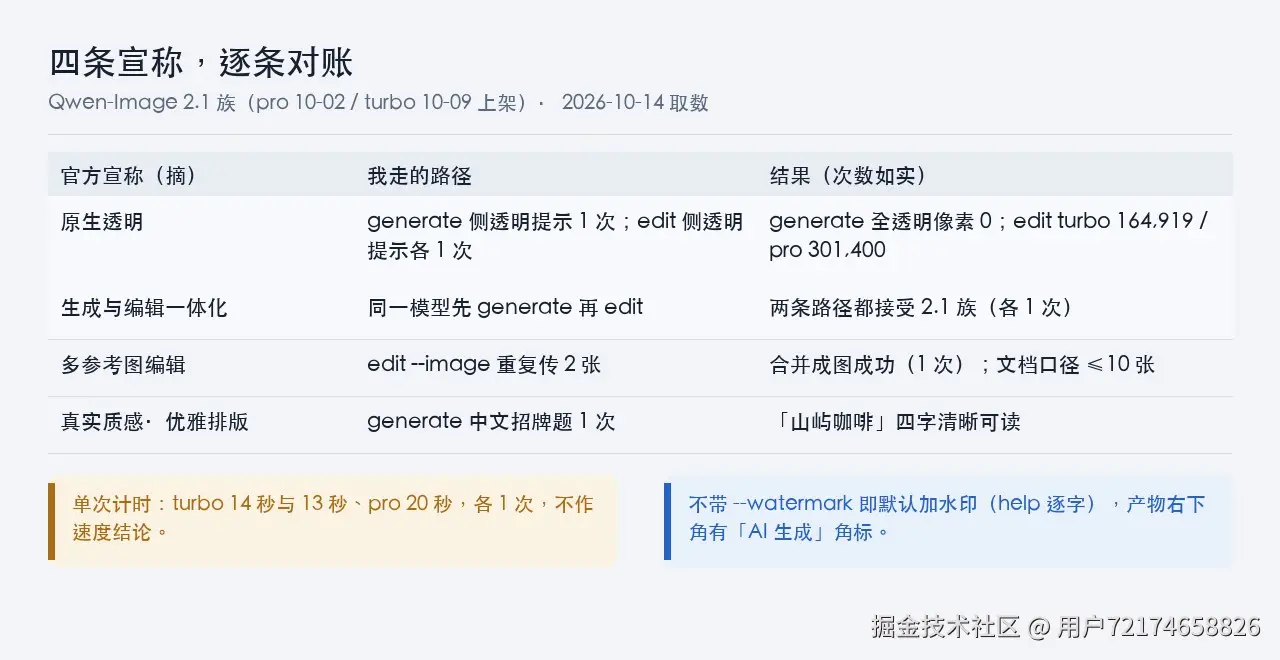
模型优势列表是写给决策看的,落到代码里得翻译成另一套东西:哪条子命令、哪个参数、什么读数、跑了几次。Qwen-Image 2.1 族上架之后,我把官方给这两个模型写的四条宣称(原生透明、生成与编辑一体化、多参考图编辑、排版与人像)按这个标准拆了一遍,拆出一条会影响实现方案的信息:透明通道不在生成命令这一侧。
计时与像素读数都是单次,后面每条都标了次数,不做稳定性结论。花费与额度不进这篇,这类数字有有效期,看控制台当天读数。
一、前置:在架核验与两个默认值
模型 ID 是第一个坑。2.1-pro、2.1-turbo 与 bl image generate 的默认模型 qwen-image-3.0 长得像,差一个字符就是另一个模型,而且不报错,图照样出。装好阿里云百炼 CLI(CLI 安装页,一条 npm 命令)之后先核在架:
bash
bl model search --keyword qwen-image-2.1返回 total 2,两个模型的 capabilities 都是 IG,modalities 输入 Text 与 Image、输出 Image,docUrl 指向同一个 API 参考页。这条命令不需要 Key,所以它可以放在 CI 的最前面当一道前置闸:模型名不在返回里,后面的调用不必发起。
我核在架时看的不是"有没有这个名字",是 capabilities 与 modalities 两个字段。它们决定了这个模型能吃图像输入,也就是 edit 路径可用;docUrl 一致则说明两个模型共用一份 API 参考,参数口径不用分开查。刚上架的模型,这些字段比宣称列表更靠得住。
第二个默认值在鉴权与产物上:image generate 与 image edit 都要 API Key(API Key 签发页);--watermark 省略时按帮助文本走 Profile 设置或 CLI 默认值 true,产物右下角带"AI 生成"角标。批量出图的脚本里,这个默认值要么显式关掉,要么在下游留一道裁切。
二、透明通道:两条路径的读数对照
官方给 turbo 写的四大优势里第二条是"原生透明,生成与编辑一体化",给 pro 写的是"可从文本生成普通或透明(RGBA)图像,编辑透明图层"。我按字面理解,先在生成侧要透明:
bash
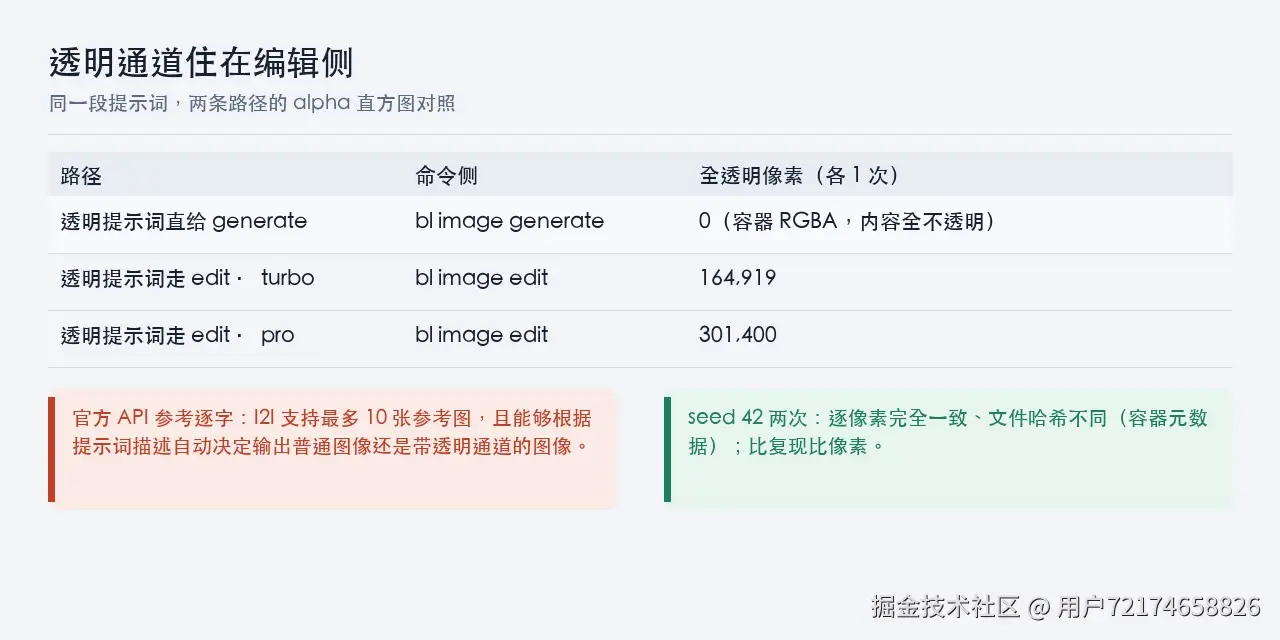
bl image generate --model qwen-image-2.1-turbo --prompt "一枚圆形徽章贴纸:蓝色山峰剪影,背景完全透明(alpha 通道透明,不要任何底色)" --size 1:1 --out-dir ./img21 --out-prefix t2出图 13 秒(单次),PNG 1328×1328,容器是 RGBA。alpha 通道直方图:全透明像素 0 个,全不透明 1,759,201 个。容器带 alpha 通道与图像内容有透明像素是两件事,这次只有前者成立。
alpha 读数不用肉眼判断,几行就能核。把第四通道拉出来数 0 值即可:
python
from PIL import Image
im = Image.open("./img21/t2.png").convert("RGBA")
a = im.getchannel("A")
print("全透明像素", a.histogram()[0], "全不透明像素", a.histogram()[255])
这段脚本是我这一轮所有透明读数的来源,生成侧与编辑侧用的是同一段,口径一致才好对照。
生成侧没有透明参数可填,帮助文本里也没有相关开关,所以我只报现象,不替它推机制。
官方 API 参考对两个 2.1 模型写的是同一句:图生图/图像编辑(I2I)支持传入最多 10 张参考图,且能够根据提示词描述自动决定输出普通图像还是带有透明通道的图像。整篇没有 transparent 或 RGBA 这样的参数名。也就是说,透明是编辑侧由提示词触发的输出形态,生成侧没有对应的 flag。
换成编辑命令,把先前那张柠檬贴纸的背景抠透明:
bash
bl image edit --model qwen-image-2.1-turbo --image ./img21/t1.png --prompt "保留柠檬切片主体,把背景改成完全透明的 alpha 通道" --size 1:1 --out-dir ./img21 --out-prefix t3| 路径 | 模型 | 命令 | 全透明像素 | 全不透明像素 | 次数 |
|---|---|---|---|---|---|
| generate | turbo | 提示词写"背景完全透明" | 0 | 1,759,201 | 1 |
| edit | turbo | 提示词写"背景改成完全透明的 alpha 通道" | 164,919 | 1,006,430 | 1 |
| edit | pro | 同上提示词 | 301,400 | 1,001,576 | 1 |
两个模型在编辑侧的读数差将近一倍。单次数据不支持"谁抠得更干净"的结论,但支持一条工程判断:需要透明资产的管线,调用点放在 image edit,把透明写进提示词,而不是在 image generate 上加重试。
三、多参考图:--image 重复传参与 10 张上限
宣称里的"支持多参考图"在 CLI 上的实现是 --image 可重复。我传两张源图让它合并:
bash
bl image edit --model qwen-image-2.1-turbo --image ./img21/t1.png --image ./img21/p1.png --prompt "把两张贴纸合并成一张组合贴纸,左右并排,白色底" --size 1:1 --out-dir ./img21 --out-prefix t4成图里两枚柠檬贴纸左右并排,两个源主体都在,布局符合提示词(1 次,目视核验)。文档口径的上限是 10 张,这一轮我只验到 2 张,10 张的行为没测。
实现上有两点值得写进代码评审清单:多参考是编辑命令的能力,生成命令没有 --image;参考图数量上去之后,布局指令要跟着写细,"合并成一张"这种粗描述在 2 张时可用,更多张时能不能保持主体完整,得自己那批素材上验。
四、seed 复现:像素一致,文件哈希不同
帮助文本里 --seed 的用途是可复现生成。同提示词同 seed 连跑两次:
bash
bl image generate --model qwen-image-2.1-turbo --prompt "一枚圆形徽章:蓝色山峰剪影" --size 1:1 --seed 42 --prompt-extend false --out-dir ./img21 --out-prefix s1逐像素比对完全一致,差异图 bbox 为空;两个文件的 sha256 却不相同,差在 PNG 容器的元数据上(2 次)。
复现判据同样可以脚本化,比哈希稳:
python
from PIL import Image, ImageChops
d = ImageChops.difference(Image.open("s1.png").convert("RGB"), Image.open("s2.png").convert("RGB"))
print("差异区域", d.getbbox()) # None 表示逐像素一致这条对自动化脚本有直接影响:拿文件哈希当复现判据会误报失败,因为哈希把容器元数据也算进去了。判据要用像素级比对,把两张图转成同一色彩模式后做差、检查差异区域是否为空。附带一条,--prompt-extend 我显式关掉了,提示词扩写开着的话,同 seed 的输入本身就不稳定。
五、资源纪律与调用对账
每条结论在正文里都标了跑的次数,重跑时对得上号。
产物侧的纪律有两条。生成的图都落在新建的输出目录里,用 --out-dir 加 --out-prefix 控制文件名,不覆盖已有资产;云端资源净增 0,这一轮只往本地落图,没有上传对象,也没有创建需要事后清理的云端资源,验收清单里不用留删除步骤。
需要提醒的是本地目录:一轮对照实验下来,生成侧与编辑侧的中间产物会混在一起,哪个前缀对应哪条结论,隔两天就记不清了。跑之前把输出目录和前缀约定好,跑完按结论归档,别让中间产物混进交付目录。
六、参数面速查
| 参数 | 口径 | 来源 |
|---|---|---|
--model |
必填才能命中 2.1 族,generate 默认是 qwen-image-3.0 | 帮助文本 |
--image |
仅 edit;可重复,文档上限 10 张 | 帮助文本与 API 参考 |
--watermark |
省略即用 Profile 设置或 CLI 默认值 true | 帮助文本逐字 |
--size |
收比例(1:1、3:4)与像素(2048*2048)两种写法,像素写法中间是星号 | 帮助文本 |
--seed |
可复现生成;复现判据用像素不用文件哈希 | 帮助文本加 2 次实测 |
--prompt-extend |
提示词扩写开关,做复现实验时显式关掉 | 帮助文本 |
--function |
只服务 wanx 系编辑模型,2.1 族不要套 | 帮助文本 |
七、pro 与 turbo:官方定位与选型判据
官方定位逐字抄。turbo:"目前 Qwen-Image 系列中综合表现与性价比最优的开源图像生成模型",四大优势为模型轻量、性能强劲、性价比卓越,原生透明、生成与编辑一体化,灵活编辑(多参考图、局部控制、高保真还原与全面编辑能力),真实质感、优雅排版、精美人像。pro:"统一的文本到图像生成与图像编辑模型,视觉生成组件仅包含 70 亿参数(32 层单流 DiT)",另写了"从照片中提取主体"。
我这一轮的读数:同一句提示词,turbo 落盘 14 秒、pro 20 秒(各 1 次);编辑侧透明像素 turbo 164,919、pro 301,400(各 1 次)。四个数都是单次,用来估量级可以,用来定选型不行。
能定的是路径判据:要透明资产走 edit;要多参考图合并走 edit 且 --image 重复;只要文生图,两个模型都在 generate 上,--model 写谁就跑谁。排版这条我给的是一道招牌题,turbo 出图 952×1269,招牌「山屿咖啡」四字清晰可读,门口立牌上的「今日特调」也没写错(1 次)。更长的中文段落、更小的字号,这一轮没覆盖。
八、可以抄进脚本的六条
- 调用前用
bl model search --keyword qwen-image-2.1核在架,别把模型 ID 写死在配置里 image generate必须显式传--model,默认值是 qwen-image-3.0- 透明资产的调用点放在
image edit,透明写进提示词;生成侧我那一次的全透明像素是 0 个 --watermark显式传值,别依赖默认(默认 true,产物带角标)- 复现判据用像素比对,不用文件哈希;同时关掉
--prompt-extend --function只给 wanx 系编辑模型用,2.1 族别套
九、这次没覆盖的
10 张参考图的上限行为、局部控制与"从照片中提取主体"这两条宣称、多字号长文本排版、并发与限流表现,都不在这一轮里。所有读数是单次结果,模型换版之后要重跑。
你在编辑侧要透明时,提示词是怎么写的?我这轮用的是"把背景改成完全透明的 alpha 通道",两个模型都出了透明像素,但读数差将近一倍。评论区交换一下写法和你的像素数,我下一篇把局部控制和主体提取补上。