MATLAB 清洗 CSV 采样日志:重复时间戳、无效行、分组统计与自动出图
同一时刻出现两条记录,数值分别为 10 和 14,该保留哪条?缺失值要删掉、补零,还是插值?这些决定会改变统计结果。先把处理规则写清楚,比先把曲线画出来更重要。
本文用 12 行合成 CSV 跑通一个小流程:显式导入字符串,过滤无效记录,按时间排序,对重复时间戳取均值,同时保存每组观测次数。数据规模小,可以逐行核对,也能直接看到错误去重策略会怎样改变输出。
1. 运行方式与实际结果
将第 3 节的代码保存为 example02_csv.m,在 MATLAB 中切换到该目录后执行:
matlab
example02_csv终端已配置 MATLAB 命令行路径时,也可以执行:
text
matlab -batch "example02_csv"本例只用基础 MATLAB。数据由函数自己生成,不读取真实设备、学生或公司日志;没有随机输入和外部下载。实际测试版本为 25.2.0.2998904 (R2025b)。
正常运行会在 output02 中生成:
synthetic_raw.csv:带表头的 12 行原始合成观测cleaned.csv:清洗、排序、聚合后的 5 行结果csv_cleaning.png:原始有效观测与聚合结果、分组计数
默认在后台导出 PNG,不弹出图窗。同一目录重跑会覆盖这些示例输出;需要保留结果时,改用 example02_csv('output02_run2',false)。
2026 年 10 月 14 日正向 batch 退出码为 0,5 项断言通过。实际行数变化为:
12 行原始观测 → 过滤 5 行 → 保留 7 条有效观测 → 按时间聚合成 5 行。
最终 cleaned.csv 内容如下。
| t_s | value_mean | sample_count |
|---|---|---|
| 0 | 0 | 1 |
| 1 | 12 | 2 |
| 2 | 22 | 2 |
| 3 | 30 | 1 |
| 4 | 40 | 1 |
t_s 的单位是秒;value 是无指定物理单位的合成数值,不代表实测电压或温度。这里的统计是每个时间戳的算术平均和观测数量。
2. 把规则固定下来
2.1 哪些行无效
本例的合成数值均为实数。过滤规则检查转换后的时间和数值是否有限、时间是否非负,以及去掉首尾空白后的状态是否严格等于小写 ok。五条被过滤的记录分别是:
| 原始数据 | 被过滤的原因 |
|---|---|
3,NaN,ok |
数值不是有限数 |
bad,40,ok |
时间无法转换为数值 |
5,50,bad |
状态不满足 ok |
6,Inf,ok |
数值是无穷大 |
-1,7,ok |
时间为负 |
同一个时间戳可以同时有坏记录和好记录。例如 3,NaN,ok 被过滤,而 3,30,ok 保留。不能因为发现一条坏记录,就把这个时间点的所有记录一起删除。
2.2 重复时间戳怎样处理
时间 1 对应有效数值 10、14,均值为 12;时间 2 对应 20、24,均值为 22。这里把它们解释为同一时刻的等权重复观测。
因此顺序固定为:先过滤,再排序,最后对有效观测分组求平均。sample_count 记录参与平均的有效观测数量。过滤减少了 5 行,聚合又减少了 2 行,这两类行数变化含义不同。
3. 完整可运行代码
下面是实际测试的完整函数。导入时把三列都设为字符串,再显式进行数值转换,避免把自动类型推断当成校验规则。readtable 与导入选项的关系见 官方文档。
matlab
function example02_csv(outDir, negativeMode)
% Generate and clean only this synthetic CSV. No real log is opened.
if nargin < 1, outDir=fullfile(fileparts(mfilename('fullpath')),'output02'); end
if nargin < 2, negativeMode=false; end
if ~isfolder(outDir), mkdir(outDir); end
fprintf('MATLAB_VERSION=%s\nNEGATIVE_MODE=%d\n',version,negativeMode);
raw=["t_s,value,status";"2,20,ok";"0,0,ok";"1,10,ok";"1,14,ok";...
    "3,NaN,ok";"bad,40,ok";"4,40,ok";"2,24,ok";"5,50,bad";...
    "6,Inf,ok";"-1,7,ok";"3,30,ok"];
rawFile=fullfile(outDir,'synthetic_raw.csv');
writelines(raw,rawFile);
% Explicit string import avoids depending on automatic type inference.
opts=delimitedTextImportOptions('NumVariables',3);
opts.DataLines=[2 Inf]; opts.Delimiter=',';
opts.VariableNames={'t_s','value','status'};
opts.VariableTypes={'string','string','string'};
T=readtable(rawFile,opts);
t=str2double(T.t_s); v=str2double(T.value);
valid=isfinite(t) & isfinite(v) & t>=0 & strtrim(T.status)=="ok";
ck(height(T)==12 && sum(valid)==7,'Counts','12 source rows and 7 valid observations');
validT=table(t(valid),v(valid),'VariableNames',{'t_s','value'});
validT=sortrows(validT,'t_s');
[uniqueT,~,group]=unique(validT.t_s,'sorted');
counts=accumarray(group,1);
meanValue=accumarray(group,validT.value,[],@mean);
if negativeMode
    % Wrong policy: discard later observations instead of averaging.
    meanValue=accumarray(group,validT.value,[],@(z) z(1));
end
ck(isequal(uniqueT,(0:4)'),'Times','Output timestamps sorted and unique');
ck(max(abs(meanValue-[0;12;22;30;40]))<1e-10,'Values','Duplicate timestamps require arithmetic means');
ck(isequal(counts,[1;2;2;1;1]),'GroupCounts','Counts preserve duplicate observations');
clean=table(uniqueT,meanValue,counts,'VariableNames',{'t_s','value_mean','sample_count'});
writetable(clean,fullfile(outDir,'cleaned.csv'));
roundTrip=readtable(fullfile(outDir,'cleaned.csv'));
ck(isequal(roundTrip{:,:},clean{:,:}),'RoundTrip','Exported CSV round trip');
fprintf('ROWS_RAW=%d ROWS_VALID=%d ROWS_REJECTED=%d ROWS_CLEAN=%d\n',height(T),sum(valid),sum(~valid),height(clean));
fprintf('CLEAN_TIME=%s\nCLEAN_VALUE=%s\nCOUNTS=%s\n',mat2str(uniqueT'),mat2str(meanValue'),mat2str(counts'));
fprintf('POLICY: finite numeric time/value, nonnegative time, status=ok; sort; duplicate mean. No interpolation.\n');
fig=figure('Visible','off','Color','w','Position',[100 100 1000 650]);
cleanup=onCleanup(@() close(fig));
tiledlayout(2,1,'TileSpacing','compact');
nexttile;
plot(t(valid),v(valid),'o--','LineWidth',1.1); hold on;
plot(uniqueT,meanValue,'s-','LineWidth',1.6);
grid on; xlabel('Synthetic time (s)'); ylabel('Synthetic value');
legend('Valid rows in original order','Sorted duplicate means','Location','northwest');
title('Synthetic log: remove invalid rows, sort, aggregate');
nexttile; stem(uniqueT,counts,'filled','LineWidth',1.2);
ylim([0 3]); grid on; xlabel('Synthetic time (s)'); ylabel('Observations per time');
title('Keep counts so duplicate aggregation remains visible');
exportgraphics(fig,fullfile(outDir,'csv_cleaning.png'),'Resolution',150);
fprintf('RESULT=PASS example02_csv\n');
end
function ck(ok,id,msg)
assert(ok,['lessonCSV:' id],msg); fprintf('ASSERT_PASS=%s\n',id);
end
4. 图里能看出哪些问题
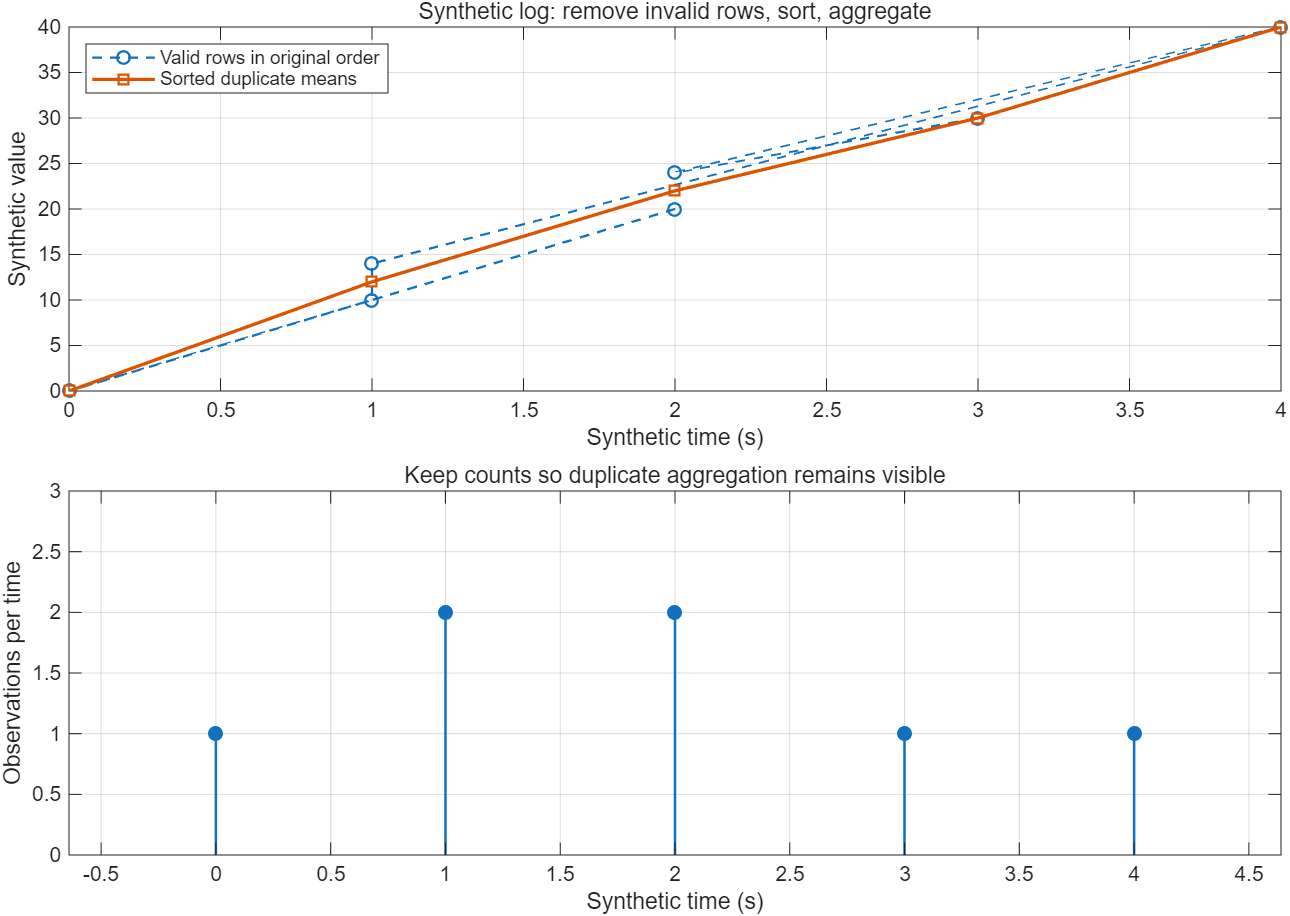
上图蓝色虚线按照原文件中有效行的顺序连线,时间顺序实际是 2、0、1、1、4、2、3。连线会往回走,因此不能把这条虚线当作按时间演变的物理轨迹。保留这个画法,是为了暴露"直接把导入的行连起来"的问题。
橙色方点按时间排序,并将重复观测聚合成均值。时间 1 的 10、14 合并为 12,时间 2 的 20、24 合并为 22。连线只是辅助阅读,本例没有生成插值样本。
下图保留了每个时间戳的参与数量。仅看上面的均值曲线,看不出 12 来自两条观测;结合 sample_count=2,数据处理过程才更容易追溯。
4.1 unique 和 accumarray 分别做什么
unique 的第三个输出 group 给每条有效观测分配组号。同一个时间戳对应同一个组号。接着:
accumarray(group,1)统计每组有多少条有效观测accumarray(group,validT.value,[],@mean)对每组数值求平均
这是按时间分组统计的两个结果,不应把组号当成原始行号。accumarray 文档说明了按下标收集并归约数据的用法。
4.2 为什么还要把 CSV 读回来
写文件成功,只能说明调用完成。代码随后重新读取 cleaned.csv,检查导出再导入后的数值与内存中的表完全相同。
这组输出由小整数构成,所以使用 isequal 检查完全相等。本次检查通过。换成一般浮点测量值时,文本格式和输出精度可能影响小数,应该根据允许误差设计检查,不能直接把本例的"完全相等"推广为所有 CSV 都逐位无损。写入行为可查 writetable 文档。
5. 错误去重策略的负对照
执行:
matlab
example02_csv('output02_negative',true)负对照保留了相同的过滤和时间分组,但故意把均值替换为"取每组第一条"。这样时间轴仍然正确,输出也仍然只有五行;如果测试只检查排序和行数,就会漏掉数值错误。
本次负向运行先通过 Counts 和 Times,随后在 lessonCSV:Values 失败,batch 退出码为 1。这里的两个先行通过不计入前面报告的 5 项正向断言。
这个例子说明,清洗测试至少要覆盖保留下来的具体数值,不能只检查程序是否报错或输出文件是否存在。
6. 换成真实日志时需要另做的决定
这份函数是固定三列、固定输入的教学实验。它每次都会重建合成 CSV,不是一个可以直接传入任意文件名的通用日志清洗器。扩展时尤其需要确认下面几件事。
先确认重复记录的业务含义。 如果后一条是对前一条的纠正,取均值就不合适;如果记录来自不同设备,应先把设备标识纳入分组键。同一时间戳不能自动证明是同一类观测。
浮点时间按精确值分组。 本例的时间是整数秒。实际日志里的 1 和 1.0000001 是否属于同一时刻,需要依据采样精度决定是否建立时间桶,不能未经说明随意四舍五入。
状态、单位和字段顺序要验证。 本例对小写 ok 做精确匹配,OK 不会自动等同。导入选项也按既定列序命名,没有另外做表头缺列、错列的通用校验。接入真实设备前需要补上这些约束。另外,str2double 能解析部分复数字符串,isfinite 本身不检查是否为实数;如果日志只允许实数,还需要另外验证虚部为零,不能把本例的有限性检查当作实数校验。
缺失值与长间隙应保留解释。 本例把无效观测过滤掉,不插值、不补零。真实日志删除记录后,剩余时间不一定等间隔,不能把它压缩成连续样本序号后直接做均匀采样 FFT。按规则删行也不保证统计无偏;如果缺失与数值本身相关,删除后会改变样本分布。
均值的权重不能悄悄改变。 每个时间点的均值再直接求平均,得到的是各时间点等权的结果;如果要让原始有效观测等权,就应使用 sample_count 加权。这两种统计回答的是不同问题,选哪一种应由分析目标决定。
保留原始文件与拒绝原因。 本例保留完整的合成原始 CSV,但没有导出逐行拒绝原因表。处理真实日志时可以另存审计表,并让清洗结果使用新文件名,便于回查每条记录的去向。
7. 参考来源与延伸阅读
从导入到可视化的教学安排参考了 Climate Data Visualization and Analysis 固定版本 README。其 LICENSE.md为 BSD 3-Clause。完整课程还使用图像处理、统计与机器学习、曲线拟合等工具箱;本文没有复制气候数据、代码或图片,12 行合成日志和处理函数均独立编写。
如果你正在整理 FPGA 采样结果,可以结合 ILA 在线调试:Vivado 抓取片内信号与定位下板问题检查采样时钟、有效标志和数据解释。本文的三列合成格式不等于 Vivado 的原生导出格式,接入时需要明确映射。
最后留一个具体问题:假设时间 1 的第二条记录 14 表示"修正前一次读数",你会把聚合结果改成 14,还是继续取 12?无论选择哪一种,应该怎样在清洗规则和输出中说明?