大屏很好看。但好看和能算,是两件事。
一块大屏上,全市水库的水位一目了然,红的黄的绿的一目了然。
有人问了一句:"未来三小时降雨加大,哪个水库会先超限?"
系统答不出来。它只能告诉你------现在已经超了。
这就是这一期要讲的事:**同样是"数字孪生",有的只是一个数字花瓶,有的却是一个能让你先在虚拟世界里试一遍的实验场。**两者的区别,可以用一句话分辨。
水里的物理:三种层次,一句话分辨
数字化水利系统大体分三个层次,我用三个词来区分,因为它们回答的问题完全不同:
**第一层:看板。**它回答"现在是什么 "。水位多少、流量多少、哪台泵在运行。这是可视化的层次------把现实搬到屏上。
**第二层:计算器。**它回答"如果......会怎样"。如果雨量再加 50 毫米,水位会涨到多少、什么时候到。这是能算的层次。
**第三层:推演器。**它回答"那我该怎么办"。不只是算出一个数字,还要给出方案:哪几个村先转移、闸门先开哪一个、水库之间怎么联调。这是能决策的层次。
分水岭就在第一层和第二层之间。
这个判断很实用,因为看板做得再漂亮,也不能代替计算器。一块大屏的成本可以很高,但如果它只能显示"已超阈值",那它在关键时刻提供的信息量,和一个报警灯差不多。
为什么会停在第一层?因为三层的工作量差别很大:可视化主要是数据接入和渲染 的活;计算器要建模、率定、验证 ;推演器还要把模型和业务流程、权限、预案接起来 。越往后,越不像是"做个软件"能解决的。
水里的案例:广州的两套系统,做到了什么
据广州市水务局 2025 年 12 月发布的一篇介绍(源头是该局的科技信息处),广州在推进数字孪生水利时选了两条不同的线,刚好可以对照着看。
第一套:花都区的流域防洪。
花都区以水库运行管理矩阵建设为切入点,建成覆盖全区 49 座水库 的数字孪生体系。硬件上部署了 98 处物联网水位站、45 套 AI 视频监控、12 座自动化雨量站 ,加上无人机、无人船、水下机器人,形成"天、空、地、水、工"的全域感知,回传延迟小于 3 秒。
而关键在于它上面跑的东西:洪水预报、水库调度、溃坝分析 等水利专业模型。平台具备"预报、预警、预演、预案"四项功能。
**请注意"预演"这两个字。**介绍里写的是:平台可以"模拟洪水演进、自动生成人员转移方案"。
**这就是从"看板"跨到了"推演器"。**它不只是报警,它能在虚拟世界里先把洪水推一遍,然后给出"哪些人该往哪转移"。报道里对这一步的总结是:实现了从"经验判断 "到"科学诊断"、从"局部排查"到"全域覆盖"的转变。
第二套:珠三角水资源配置工程。
这是一个引调水工程,它在建设之初就同步规划了数字孪生系统。它的目标设定很有层次感:"像起来、动起来、用起来"------对应刚才说的一、二、三层。
最值得看的是它的一段应用:充排水前做了精准的模拟预演,助力实体工程"一次性充水成功",时间误差小于 5%。
**"一次性充水成功"这六个字,才是数字孪生真正值钱的地方。**一个大型引调水工程第一次充水,是不允许出错的------水量、时间、水力过渡过程,任何一处算错都可能造成工程事故。而在真机上试一次的代价,远高于在模型里试一百次。
介绍里还提到:该系统由 38 个机理模型驱动的孪生体 构成,覆盖水力、电气、通风、调度、故障预测等专业领域;智能巡检融合机器人与 SCADA 系统后,异常识别准确率达 95% ,推动泵站实现"关门运行";优化调度模型每年节约用电超过 300 万元。
⚠️ 需要说明口径:以上都是广州市水务局(业主方)公布的成效 ,属于项目方的自述。它说明"这条路走得通",但不等于"已经普遍走通"。下一节就是这个区别。
但看整体,成熟度有一条断层
如果只看项目报道,你会觉得数字孪生在水利上已经很成熟了。但把视角拉到整个领域,结论不一样。
2026 年 6 月,一篇发表在《Discover Sustainability》上的系统文献综述(按 PRISMA 框架做)给出了一个让我印象很深的判断:
A notable maturity gap exists within the field: while water distribution networks demonstrate the highest proportion of fully operational, real-world deployments , applications in other domains remain largely confined to theoretical frameworks or simulation-based prototypes.
翻译过来:这个领域存在一条明显的"成熟度断层" ------配水网络 是唯一有较高比例真正投入实际运行 的方向,而其它领域的应用,大多还停留在理论框架或仿真原型阶段。
这篇综述还给了一个分布:62.5% 的研究集中在城市水务基础设施,另外 37.5% 面向自然系统。
所以真实情况是这样的:
- 配水管网------落地最好。原因后面讲。
- 水利工程(如泵站、引调水) ------有像广州这样做到"用起来"的案例,但属于标杆,不是常态。
- 流域级别的自然系统 ------大多数还在原型阶段。
也就是说:广州那两套系统是真的,但它们之所以值得被写成报道,恰恰因为它们还不普遍。
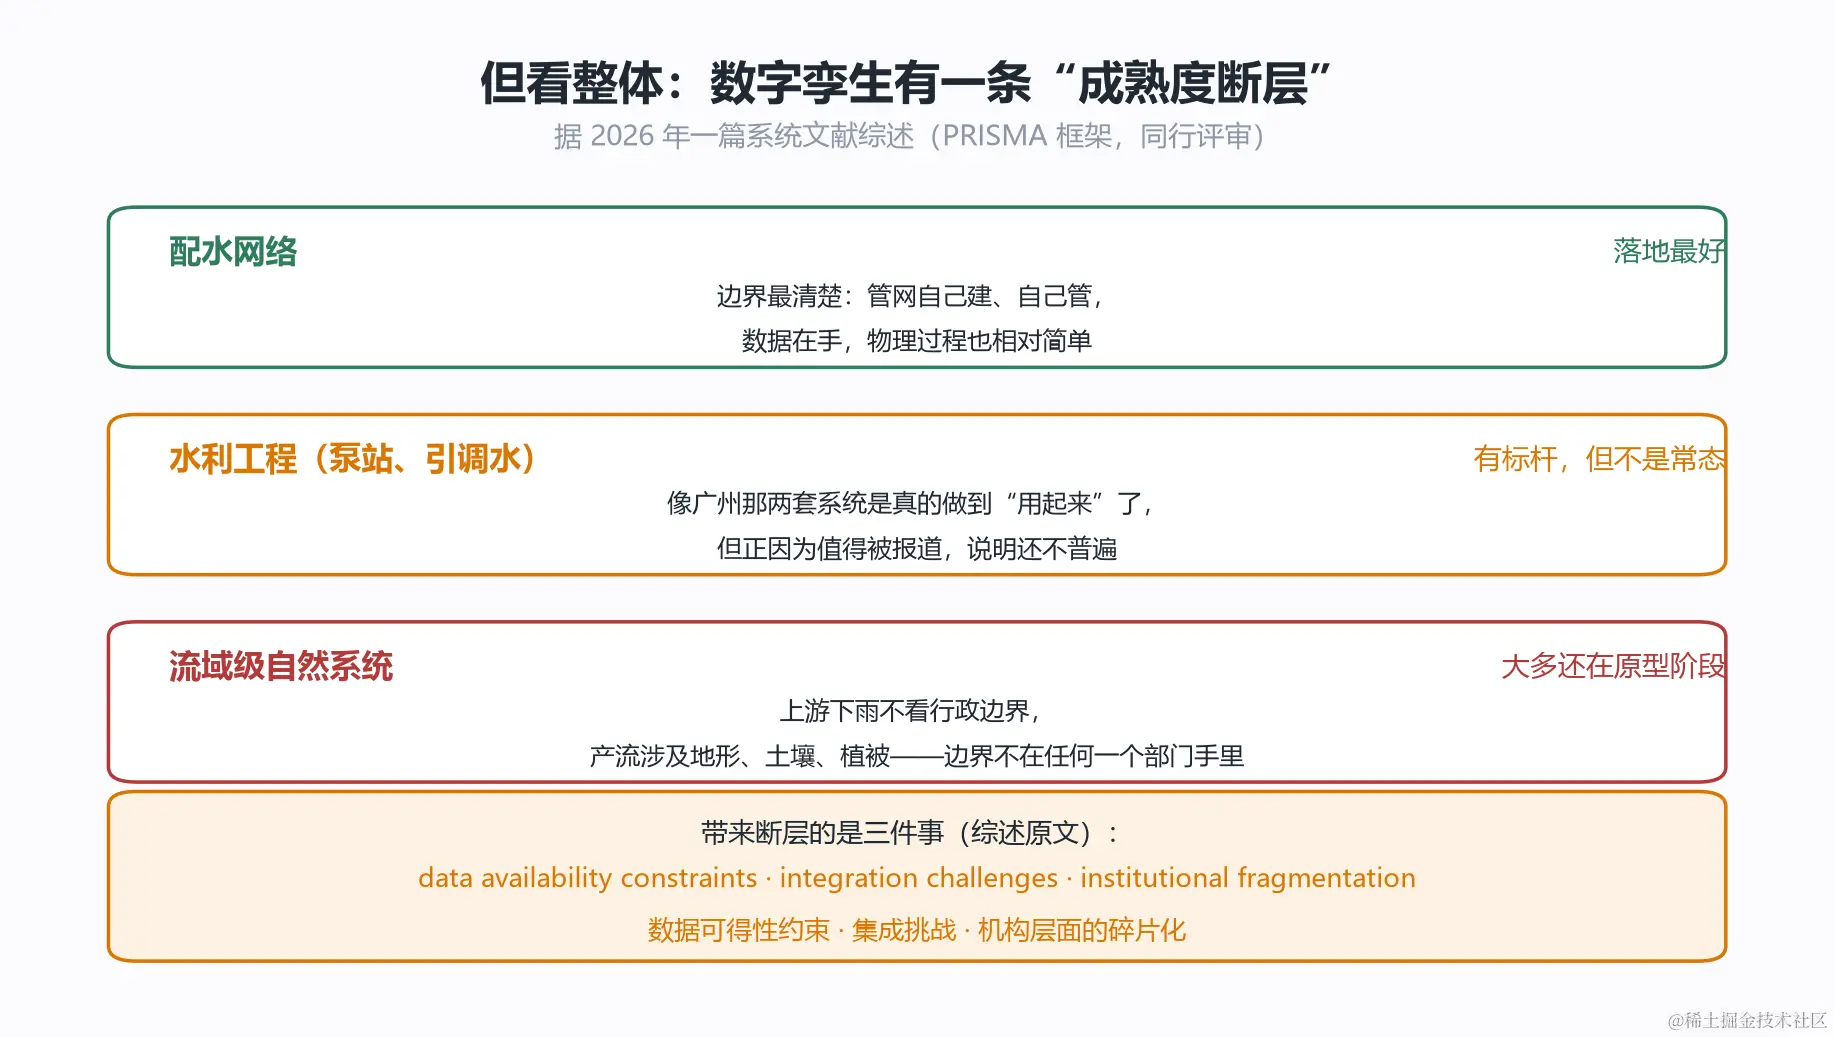
带来这条断层的三件事,下一节展开。
这一节的意义在于:当你看到"数字孪生"四个字时,要问的不是"它有没有大屏",而是"它属于断层上方,还是下方"。
顺带说,这篇综述还点出两个容易被忽略的地方。一个是地理分布 :研究产出主要集中在亚洲(主要由中国的数字化推进带动)和欧洲,而"低收入地区仍然明显代表性不足 "------也就是说,这项技术目前主要服务的是不缺钱的地方。另一个是它给出的出路方向 :面向低收入水务机构的开源平台、以及标准化的数据本体(ontology)。
最后这个词值得留意。 "数据本体"听起来很学术,说白了就是给"水位""流量""闸门开度"这些概念定一套大家共同遵守的定义 。听起来是小事,但没有它,A 单位的"水位"和 B 单位的"水位"可能基准都不一样------那三家数据凑在一起也未必算得对。
两条路线,一张表
把前面几层的意思合起来,其实只有两条路线可选:
| 路线一:可视化 + 人工分析 | 路线二:可视化 + 物理AI | |
|---|---|---|
| 系统回答什么 | 现在是什么 | 如果......会怎样、那我该怎么办 |
| 人做什么 | 看数据、靠经验判断 | 定目标、审方案、担责任 |
| 上限在哪 | 人的经验和响应速度 | 模型的精度 + 数据的覆盖 |
| 出事时的样子 | 事后复盘说"当时没想到" | 能拿出当时的推演过程 |
| 典型风险 | 大屏很贵,关键时用不上 | 模型不可信、数据接不上、推演结果没人敢用 |
注意最后一行------两条路线都有风险,只是风险的形状不同。
路线一的风险是"花了钱但没有解决问题 ";路线二的风险是"模型说了话,但没人敢信"。
而后一种风险,恰恰是下一节要讲的三个陷阱造成的。
落地的三个陷阱
那篇系统综述把障碍写得很清楚,原话是:
Despite proven operational benefits, widespread deployment is hindered by data availability constraints, integration challenges, and institutional fragmentation.
尽管运行收益已经被证明,但大规模部署受制于三件事:数据可得性约束、集成挑战、以及机构层面的碎片化。
这三条值得一条条对到现实里:
**陷阱一:数据可得性。**数字孪生要算,就得有输入。而模型需要的数据,往往比你已有的监测多得多------你需要的是上游的雨量、支流的流量、闸门的开度,而你可能只有一个断面上的水位计。
**陷阱二:集成挑战。**这既是技术问题也是接口问题。上一期我们讲过"接口越窄、模块越能换"------数字孪生是把很多套系统接在一起,接口没定义清楚,就变成一改全改。
**陷阱三:机构层面的碎片化。**这一条最少被谈,但可能最致命。**流域是自然划的,管理权是行政划的。**上游的降雨数据在 A 单位,下游的闸门在 B 单位,城市的排水在 C 单位------而"未来三小时会不会淹"这个问题,需要三家的数据同时在手。
那篇综述还点出了另外三个缺口:网络安全保障、成本效益证据、以及社会公平指标 。最后一条尤其值得注意------数字孪生算出来的"人员转移方案",对不同人群的影响是不一样的,而目前很少有研究去衡量这一点。
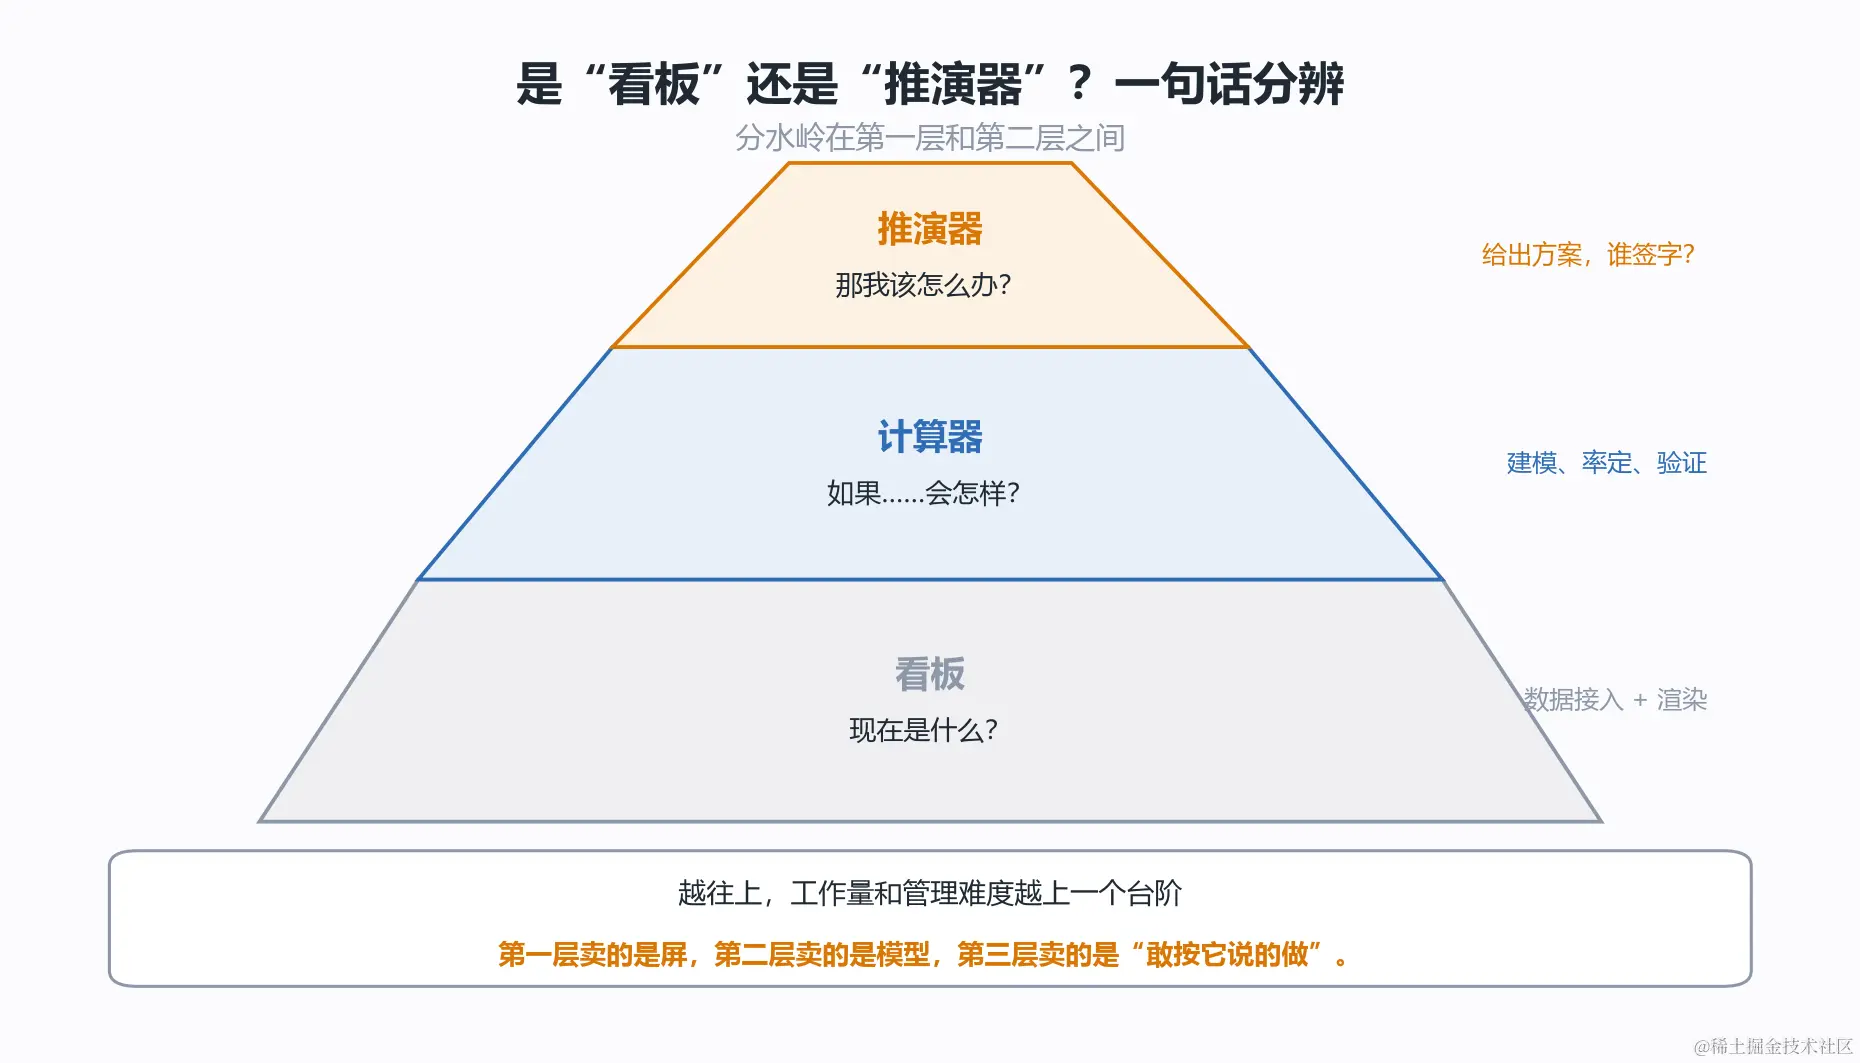
第一层卖的是屏,第二层卖的是模型,第三层卖的是"敢按它说的做"。
回过头来就能解释那条例外了:为什么配水管网落地最好?
因为它的边界最清楚 。管网是你自己建的、你自己管的,数据在自己手里,物理过程相对简单(压力、流量、水质),而且用户侧的数据(水表)天然每天都有。
**而流域不一样。**上游下雨不看你的行政边界,支流的水来自别人的辖区,山洪的产流过程涉及地形、土壤、植被------它的边界,本质上不在任何一个部门手里。
所以这一期最想给出的一句判断是:
**能算的前提,是你得先能划出这个系统的边界。**划不出边界,再好的模型也没有完整的输入。
决策者清单:哪些必须算,哪些先看见
如果这些内容要变成你手上能做决定的东西,我建议分三步问:
第一问:哪些决策"错了就回不去"?
**优先给这类决策做推演。**珠三角要"一次性充水成功",就是因为试错的代价太高。反过来,如果一件事做错了可以重来、代价也不大,那先做个看板就够了。
第二问:这个系统的输入,我能不能拿全?
如果拿不全,就在项目启动时 把这个缺口写清楚------它通常不是技术问题,是协调问题 ,需要的是跨单位的机制,而不是更贵的模型。这是最容易低估的一条。
第三问:推演结果出来了,谁签字?
这句话听着官僚,但它决定了系统有没有用。**如果一个推演结果谁都不敢用,那它就退化成了一个很贵的看板。**所以在建之前就要问:这个方案由谁审、按什么流程进预案、责任怎么划。
"哪些场景必须算、哪些先看见"------这个判断本身就是一项能力,而且它比技术选型更早、更重要。
你的行业
这一期讲的是水利的数字孪生,但那个分水岭是通用的。
你们的数字化系统,是"看板"还是"推演器"?
有一个很简单的测试方法:你上一次问系统一个"如果......会怎样"的问题,它答得出来吗?
- 如果它只能告诉你"本月成本已经超预算了"------那是看板;
- 如果它能告诉你"如果再招三个人,Q4 的成本会走到哪儿"------那才算计算器;
- 如果它还能告诉你"那你应该先砍哪一项"------那才算推演器。
大多数公司的系统停在哪一层?我想你心里有数。
而更值得带走的,是那个关于边界的结论。
你想算的东西,边界在不在你手里?
这个问题会筛掉一大批"看起来该做"的项目:
- 想预测供应链,但供应商的产能数据在对方手里;
- 想预测员工流失,但关键信息(面试、情绪、私下沟通)从来没被记录过;
- 想优化渠道投放,但转化发生在别人的平台上,你看不到后链路。
这三种情况都不是"模型不够好",而是"边界不在你手里"。
它们也不是不能做 ------但正确的做法是先去解决边界(签数据协议、建立共享机制、换一个你能拿到全链路的场景),而不是先买一个模型。
先解决边界,再谈智能。顺序反了,钱就花在第一层上了。
所以最后两个问题留给你:
你们想算的那件事,边界在谁手里?
如果不在你手里,你打算怎么把它拿过来?