文档处理场景中,经常需要将一份大的 Word 文档拆分成多个独立文件:比如把一份几百页的报告按章节拆分,或者提取指定页码范围单独分发。
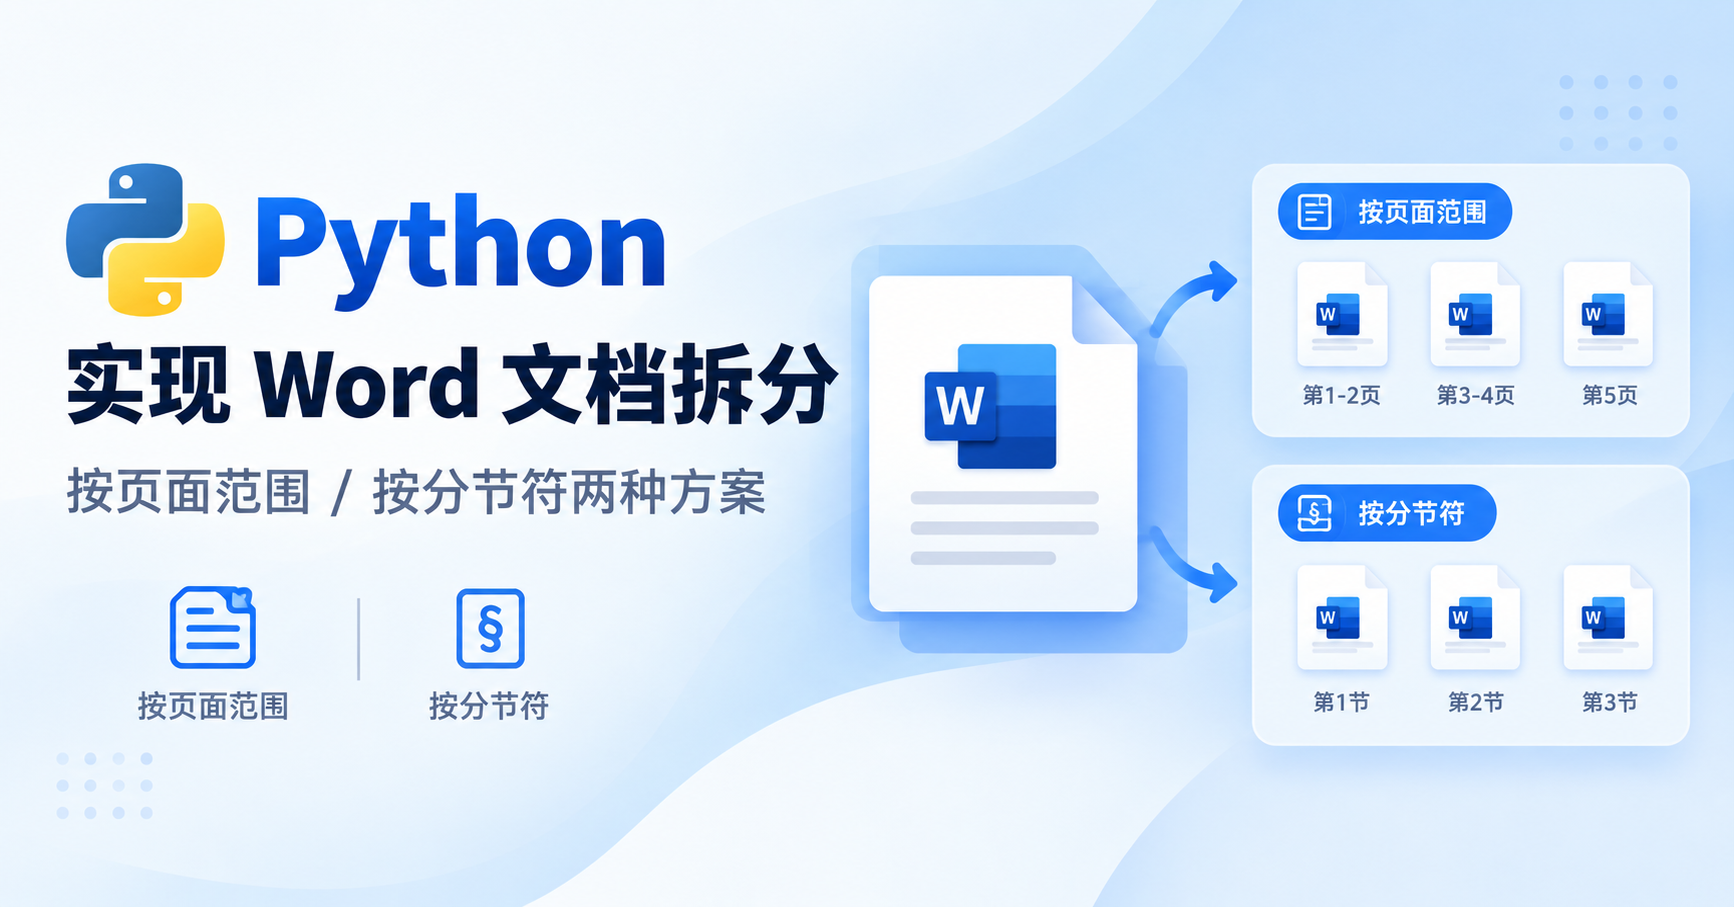
使用 Python 处理 Word 文档,常见方案有 python-docx、Spire.Doc for Python 等。python-docx 更擅长段落级别的读写,但原生不支持直接获取文档渲染后的分页信息;而 Spire.Doc for Python 可以直接读取文档的页面布局与文档节(Section)结构,支持两种常用拆分策略:
- 按页面范围拆分 :依据文档最终渲染后的页面布局,提取指定页码区间生成新文档;
- 按文档节(Section)拆分 :根据 Word 分节符,把每一节单独保存为文件,适合按章节划分的文档。
说明:Spire.Doc for Python 是独立文档处理库,运行环境无需安装 Microsoft Word。
环境准备
通过 pip 直接安装依赖包:
pip install Spire.Doc方案一:按页面范围拆分 Word 文档
ExtractPages(startIndex, count) 方法可以按照文档渲染后的页面布局,提取一段连续页面,生成新文档。 页面索引从 0 开始 ,startIndex 是起始页索引,count 为要提取的页面数量。
示例需求:将文档前 3 页提取为一个文件,剩余页面保存为另一个文件。
from spire.doc import *

# Load the Word document
doc = Document()
doc.LoadFromFile("input.docx")
# Extract pages 1-3
first_part = doc.ExtractPages(0, min(3, doc.PageCount))
first_part.SaveToFile("Page1-3.docx", FileFormat.Docx)
first_part.Dispose()
# Extract the remaining pages if the document has more than 3 pages
if doc.PageCount > 3:
    second_part = doc.ExtractPages(3, doc.PageCount - 3)
    second_part.SaveToFile("Page4-End.docx", FileFormat.Docx)
    second_part.Dispose()
doc.Dispose()
代码说明
doc.LoadFromFile("input.docx"):加载源 Word 文档;doc.PageCount:获取文档总页数;min(3, doc.PageCount)做边界保护,避免文档总页数不足 3 页时报错;ExtractPages返回新的 Document 对象,调用SaveToFile保存为 docx;Dispose():释放文档资源,避免内存占用。
注意:按页面拆分是基于文档最终排版布局。文档字体、图片、页面边距变化,都会影响分页结果,和 Word 打开后看到的页面保持一致。
方案二:按文档节(Section)拆分 Word 文档
Word 的 节(Section) 由分节符定义,常用于区分不同章节、不同页眉页脚、横竖混排等内容。适合书籍、论文、手册这类天然按章节使用分节符划分的文档。
思路:遍历文档所有 Section,将每一个 Section 克隆并添加到新文档对象,单独保存为独立文件。
from spire.doc import *

# Load the Word document
doc = Document()
doc.LoadFromFile("Sample.docx")
# Split the document by section
for i in range(doc.Sections.Count):
    new_doc = Document()
    # Clone the current section and add it to the new document
    new_doc.Sections.Add(doc.Sections.get_Item(i).Clone())
    # Save the section as an individual Word document
    new_doc.SaveToFile(
        f"output/SplitDocument/SplitBySectionBreak_{i+1}.docx"
    )
    new_doc.Close()
doc.Close()
代码说明
doc.Sections.Count:获取文档内总节数;doc.Sections.get_Item(i).Clone():克隆当前节。克隆可以完整保留该节的页面设置、页眉页脚、样式;- 循环内新建空白文档,把克隆后的节添加进去,保存为独立文件;
new_doc.Close():关闭子文档,释放资源。
提示:使用前需要手动创建
output/SplitDocument目录,否则保存文件会抛出路径不存在异常。
两种拆分方式对比
| 拆分方式 | 拆分依据 | 适用场景 | 局限性 |
|---|---|---|---|
| 按页面范围拆分 | 文档渲染后的页面布局 | 提取固定页码区间、按页数切割文档 | 文档内容修改后分页位置会变化 |
| 按节拆分 | Word 分节符 | 文档使用分节符划分章节、页眉页脚独立 | 如果文档没有插入分节符,则只有 1 个节,无法拆分 |
常见注意事项
- 资源释放 :Document 对象使用完毕后,务必调用
Dispose()/Close(),长时间批量处理文档时防止内存泄漏; - 目录提前创建 :输出文件到子目录时,需要使用
os.makedirs()创建文件夹; - 试用版限制 :Spire.Doc 试用版本会在输出文档添加水印并存在部分功能限制,生产环境使用需要参考官方授权说明;
- 文件编码与路径 :Windows 环境下中文路径建议尽量使用英文路径,避免编码问题。
扩展思路
- 批量拆分:遍历文件夹下所有
.docx文件,循环执行拆分脚本; - 单页拆分:循环调用
ExtractPages(i,1),每一页保存为独立文档; - 混合策略:先按节拆分,再对拆分后的单个文档做页面提取。
总结
Spire.Doc for Python 提供了两种简单直接的 Word 文档拆分能力:按页面范围 适合根据可视化页面切割,按节拆分适合基于文档结构(分节符)的章节拆分。几十行代码即可完成自动化文档拆分,省去人工复制文档的重复工作,适合集成到自动化办公脚本、数据处理流水线中。
如果你需要,我可以再补充完整可运行批量单页拆分脚本 或者增加自动创建输出目录、异常捕获的增强版本代码。