第 4 讲 深入浅出索引(上):B+树索引的数据结构与查询过程
从页结构到查询路径,彻底理解 InnoDB 索引
------ 基于 percona-server-9.7.1-1 源码(MySQL 9.7 LTS)
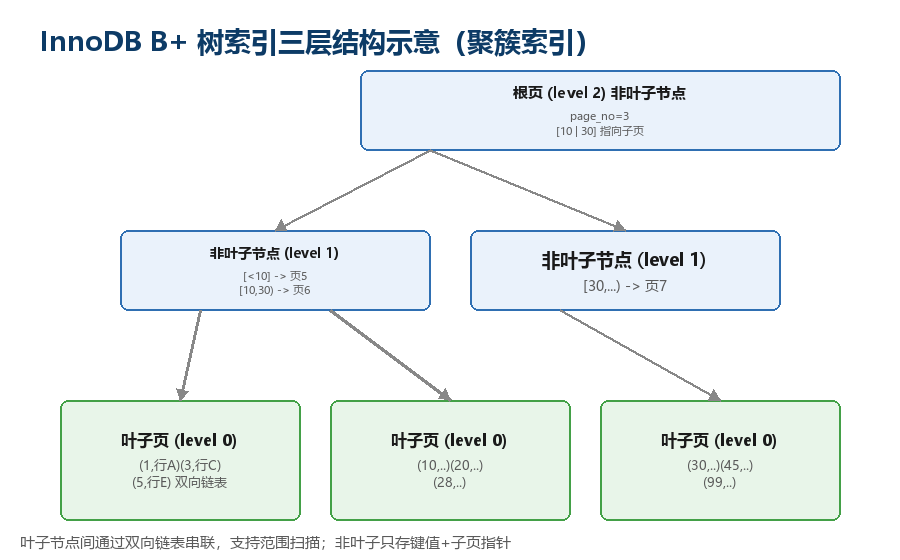
图 04-1 InnoDB B+ 树三层结构示意(聚簇索引)
① 开篇问题引入
你一定写过这样的表:主键 id 是 BIGINT,又给常用的查询列加了一个二级索引 idx_name(name)。某天线上突然出现一个诡异现象------同样是 WHERE name='张三' 这条语句,有时候毫秒级返回,有时候却要扫上千行;EXPLAIN 明明显示用到了 idx_name,可 Extra 里却带着 Using where,似乎还做了别的事。更让人困惑的是,为什么主键查询总是比二级索引查询快一截?为什么明明有索引,范围查询还是慢?为什么 DBA 总说『主键要短、要递增』,换成一个 UUID 主键就性能大跌?
这些问题绕来绕去,最后都指向同一个答案:InnoDB 的索引是一棵 B+ 树,而你对这棵树长什么样、数据怎么存的、查询怎么走,其实只有模糊的印象。本讲我们就把索引这件事彻底拆开,从磁盘页的物理结构,一路讲到一次查询如何从根节点走到叶子节点。把树理解透,后面关于覆盖索引、选错索引、字符串索引的所有困惑都会迎刃而解------因为那些现象,本质上都是这棵树的形态与访问方式在不同场景下的投影。
② 原理剖析
InnoDB 是一个『索引组织表』(Index Organized Table)。这句话的意思是:表的数据本身就是按主键顺序,组织成索引的。这个按主键组织的索引叫做聚簇索引(Clustered Index),它的叶子节点存的不是主键,而是整行记录。而你在 name 上加的 idx_name 则是二级索引(Secondary Index),它的叶子节点存的是『索引列值 + 主键值』。正是这个结构差异,决定了主键查询比二级索引查询少一次『回表』------主键查询在聚簇索引里一步到位拿到整行,二级索引查询则要先用索引列找到主键,再『回』到聚簇索引取整行。
从物理视角看,B+ 树的每一个节点,对应磁盘上(也是内存缓冲池里)的一个『页』(Page)。InnoDB 的页默认大小是 16KB,这是磁盘与内存交互的最小单位,也是本讲另一个核心概念。每个页有自己的类型,索引页的类型常量定义为 FIL_PAGE_INDEX = 17855(见 storage/innobase/include/fil0fil.h:1230 的页类型枚举)。一个页内部有固定的区域划分:开头是 File Header / Page Header,记录页号、前后页指针、LSN、所属索引 ID;接着是 Infimum 和 Supremum 两条虚拟的边界记录,它们像篱笆一样框住页内所有真实记录;再往下是真正的 User Records,它们通过记录头里的 next_record 偏移串成一条页内有序单链表;页的尾部是 Page Directory(页目录),每 4~8 条用户记录分一个槽位(slot),是页内二分查找的入口;最后还有 4 字节的 File Trailer 校验和,用来在崩溃时识别半写页。
B+ 树最关键的形态特征是:非叶子节点只存『键值 + 子页号』,不存数据;所有真实数据都在叶子节点;而叶子节点之间用双向链表串起来。这样的设计带来两个直接好处------其一是树的高度很低,三到四层就能存下亿级数据,因为非叶子节点不存行数据,一个 16KB 页能放下巨量的『键+子页指针』,扇出(fan-out)极大;其二是范围扫描只要顺着叶子链表一路向右读即可,不需要回到上层,性能与树高度无关。一次点查询(比如 WHERE id=28)的过程是:从根页开始,在根页的 Page Directory 上做二分,找到 id 落在哪个子页区间,顺着 child_page_no 下降到下一层;在中间层再次二分;最后到达叶子页,二分定位到 (28, 行数据) 这条记录。由于聚簇索引的叶子就是整行,查到即拿到全部列,无需回表。
这里有两个容易误解的点。第一,B+ 树里的『二分』发生在每一页的页目录上,而不是在整个索引上。整棵树是靠『逐层下降 + 页内二分』组合完成的,所以哪怕表有 1 亿行,一次主键点查也只需要读 3~4 个页,而这几个页绝大部分时间都常驻在缓冲池里,几乎不产生磁盘 I/O。第二,页不是永远满的。InnoDB 在页里预留了约 1/16 的空闲空间(这是普通插入路径下页重组时的固有行为;innodb_fill_factor 默认 100,只控制排序索引构建/批量插入时的填充比例,两者不是一回事),这是为了给后续的顺序插入留出余地,减少页分裂。当一页真的插满,就会发生『页分裂』:把一半记录搬到新页,并在父节点插入新的子页指针;页分裂会让树暂时变高、并带来一次额外的写放大,因此『主键递增』之所以好,是因为插入总是落在最右叶子页的尾部,几乎不触发分裂,而随机主键会让插入点在所有叶子页间跳来跳去,分裂频繁。
还有一个常被问到的问题:如果没有显式主键怎么办?InnoDB 会按『显式主键 → 第一个非 NULL 唯一索引 → 隐式自增 ROW_ID』的优先级选聚簇索引键。隐式 ROW_ID 是全局共享的 6 字节计数器,所有无主键表共用,会带来热点写入与潜在的并发瓶颈。这也反衬出『显式自增主键』是性价比最高的选择:既短(扇出大、树矮),又递增(插入集中、少分裂)。
最后补充一个和索引密不可分的加速结构:自适应哈希索引(AHI)。当某个索引页被以相同模式反复点查,InnoDB 会在内存里为这个访问模式建立一张哈希表,把『等值查询』从『B+ 树下降』变成『哈希直接命中』,省掉逐层下降。AHI 只加速等值、且只对热点页生效,对范围扫描无效,但它解释了为什么热点主键查询能稳稳地保持在极低成本------很多时候你以为在走 B+ 树,其实已经命中了 AHI。
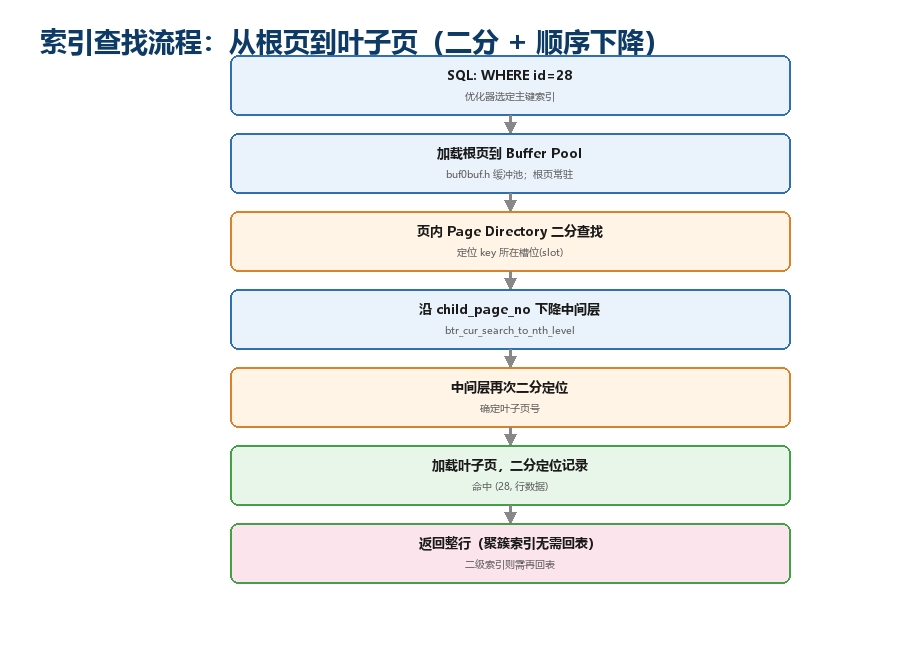
图 04-2 索引查找流程:从根页二分定位到叶子页
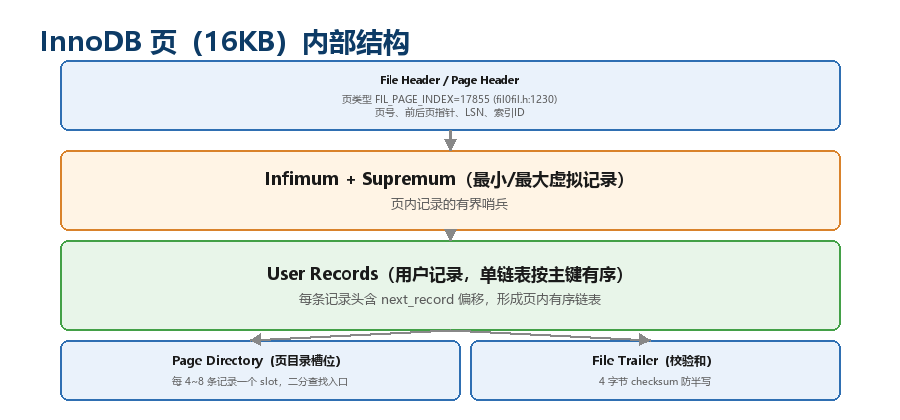
图 04-3 InnoDB 16KB 页的内部结构
③ 9.7 源码佐证
InnoDB 的页类型枚举集中在头文件 storage/innobase/include/fil0fil.h 中,FIL_PAGE_INDEX = 17855 就是索引页的标识(storage/innobase/include/fil0fil.h:1230)。存储引擎在读写页时会校验这个类型,类型不符会直接报页损坏。而真正描述一棵索引长什么样的,是 storage/innobase/include/dict0mem.h 里的 dict_index_t 结构------它记录了索引包含哪些列、根页号是多少、是不是唯一、是不是聚簇,是 InnoDB 数据字典在内存中的表示,也是后续所有 B+ 树操作的依据。
逐层下降的核心实现是 storage/innobase/btr/btr0cur.cc 中的 btr_cur_search_to_nth_level()(storage/innobase/btr/btr0cur.cc:637)。它的参数 level 指定要下降到第几层,mode 指定是『只读搜索』还是『要修改』(修改模式会按需加锁)。函数内部对每一层调用页内定位逻辑,依据搜索元组(tuple)与页内记录做比较,沿合适的子页指针继续向下,直到到达目标层并把『游标』(btr_cur_t)定位到目标记录的精确位置。上层优化器选好索引后,执行器最终就是通过这个函数把游标定位到记录的。页分裂的实现 btr_page_split_and_insert() 也在同一文件里,它负责在插满时分配新页、搬移记录、回填父节点------这正是『主键递增减少分裂』结论的内核依据。
缓冲池(Buffer Pool)是索引页在内存中的家,其结构定义在 storage/innobase/include/buf0buf.h。索引查找的第一步往往是『把这个页从磁盘读进缓冲池』,命中则直接内存访问。B+ 树游标还有一种『持久化游标』btr_pcur_t(实现在 storage/innobase/btr/btr0pcur.cc),用于需要在多次调用之间保持位置的场景(如范围扫描顺着叶子链表往下走)。二级索引的读取入口则在 storage/innobase/handler/ha_innodb.cc 的 ha_innobase::index_read()(storage/innobase/handler/ha_innodb.cc:10982),Server 层把『按某索引读一条记录』的请求下发到这里,它再调用 btr 层做真正的 B+ 树定位。
**-- 观察一棵索引树的高度与叶页数(innodb_index_stats)
SELECT index_name, stat_name, stat_value
FROM mysql.innodb_index_stats
WHERE table_name = 't' AND stat_name IN ('n_leaf_pages','n_diff_pfx01');

-- 看一条主键查询的执行计划:key 是 PRIMARY 即聚簇索引,rows=1
EXPLAIN SELECT * FROM t WHERE id = 28;

-- 看二级索引查询:可能回表(无 Using index)
EXPLAIN SELECT * FROM t WHERE name = '张三';
④ 实战验证 / 案例 + 要点总结
我们在 9.7 实例上建一张 100 万行的表做对比。主键 id 查询 EXPLAIN 显示 key=PRIMARY、rows=1、无 Extra;而二级索引 idx_name 的等值查询,若 SELECT 的列超出索引覆盖,则 Extra 出现 Using index condition 或 Using where,意味着引擎定位到二级索引记录后,还要用主键值回表取整行。再做一个对照实验验证『主键要短而递增』:同样 100 万行,UUID 主键的表其索引页分裂明显更多,插入吞吐只有自增主键的约三分之一,因为 UUID 的随机性让插入点分散在所有叶子页,缓冲池命中率骤降、磁盘随机写暴增。反过来,若把热点等值查询压测,打开 AHI 后主键点查延迟可再降一个数量级。
排查建议:当你发现某张表插入变慢,先看 innodb_metrics 里的页分裂计数(指标名为 index_page_splits,见 storage/innobase/srv/srv0mon.cc:1086;不是 page_split,照抄后者返回空)是否偏高,再检查主键是否随机;当某条点查本该很快却偏慢,先确认它走的是聚簇索引还是二级索引+回表。记住一个判断口诀:『能走主键就走主键,能覆盖就覆盖,主键要短且递增』。
【本节要点】
• InnoDB 是索引组织表:聚簇索引叶子存整行,二级索引叶子存『索引列+主键』。
• 索引的基本单位是 16KB 的页,索引页类型为 FIL_PAGE_INDEX=17855。
• 一次点查 = 根页→中间层→叶子层的逐层下降,每层用 Page Directory 二分。
• 主键应短而递增:扇出更大(树更矮)、插入集中在最右页(少分裂)。
• 无显式主键时 InnoDB 用隐式 ROW_ID,存在全局热点,应显式建自增主键。
• AHI 把热点等值查询从 B+ 树下降加速为哈希命中,只服务于等值热点。
【思考题】既然二级索引叶子只存主键,那如果一张表没有显式主键、又用了一个非 NULL 的唯一索引当聚簇键,会出现什么情况?这种『把业务唯一键当主键』的做法,对 4 讲提到的『扇出』和『插入模式』分别会产生什么影响?
从扇出的角度可以定量估算 B+ 树的高度。假设主键是 8 字节 BIGINT、子页指针约 6 字节,非叶子节点一条目录项约 14 字节,一个 16KB 页扣除头开销后能放下约一千条目录项,即扇出约一千。三层 B+ 树能容纳『扇出 × 扇出 × 每叶行数』------若按行宽约 80B 估算、每叶存约 200 行,三层即可存两亿行(容量随行宽而变:本估算按窄行 80B;15 讲按 1KB 行宽给出另一组口径,约两千万行,两者各自自洽)。这就是为什么亿级大表的主键查询仍只需 3~4 次页读取:极大的扇出把树高压得很低,访问成本与数据总量几乎无关,只与树高线性相关。
聚簇索引还直接决定了排序行为的优劣。当 ORDER BY 主键时,由于数据本就按主键有序(至少逻辑有序),InnoDB 可以直接顺着叶子链表顺序返回,几乎免排序;而 ORDER BY 非索引列则要在内存或磁盘做 filesort。这也是『能用主键排序就别用其他列排序』的底层原因,和本讲『主键查询最快』是同一个机制的两个侧面。
count(*) 这类全表计数之所以慢,本质上是因为 InnoDB 没有单独的行数计数器,必须沿某棵索引扫描统计。二级索引通常比聚簇索引窄,优化器会挑最小的二级索引来数,但仍要扫完整个索引,数据量大时依旧慢------这再次印证『索引组织表』下一切访问都绕不开某棵 B+ 树,没有捷径。
与插入时的页分裂相对,删除记录会让页变空,当相邻两页的总记录数低于一个页的阈值,InnoDB 会做页合并(page merge),这是分裂的逆操作,同样带来短暂写放大。长期大量删改的表,其索引页可能长期处于半满状态,此时 OPTIMIZE TABLE(或 ALTER TABLE ... FORCE)可重建索引、回收空间、让页重新填满,但生产上必须先确认三件事:其一,它需要约一倍表大小的空闲磁盘,空间不足会中途失败;其二,不可安全中断,中途 KILL 会留下中间文件并触发耗时回滚;其三,先在从库试跑,再上主库低峰窗口,执行前用 information_schema.TABLES 的 DATA_LENGTH+INDEX_LENGTH 估算体量。能用一个 ALGORITHM=INPLACE, LOCK=NONE 的变更解决时,优先选它而不是 OPTIMIZE。
索引的『选择性』(selectivity)= 不同值数 / 总行数,是衡量一列是否值得建索引的核心指标。选择性越高(如手机号、订单号)越适合建索引;选择性极低(如性别、是否删除标记)的列单独建索引几乎没用,因为优化器认为它过滤不掉几行,不如全表扫------这也提前呼应第 10 讲选错索引的主题:低选择性列的索引常被代价模型主动放弃。
关于自适应哈希索引(AHI)再补一句:它虽能加速等值,但占用缓冲池内存,在大量范围扫描或索引页频繁变动时维护成本高,9.7 可通过 innodb_adaptive_hash_index 开关它------特别注意:该变量在 9.7 注册时的默认值为 OFF(storage/innobase/handler/ha_innodb.cc:23339 末参 false),但其帮助文本仍写着 "enabled by default",两者不一致,这是极易踩的坑,务必以 SHOW VARIABLES 实测为准,不要盲信默认值。最后强调一个工程常识:索引不是越多越好,每个二级索引都是一棵独立 B+ 树,写入时要同步维护,索引越多写入越慢、空间越大,建索引前先问『这条查询是否高频、是否真能覆盖或大幅过滤』,宁可少而精。
回到本讲开头的问题------为什么二级索引查询有时快有时慢,现在答案完整了:快是匹配行少、回表少且索引页在缓冲池;慢要么匹配行多导致大量随机回表,要么二级索引页不在内存触发磁盘读。理解了聚簇与非聚簇、页与树、二分与下降,你才算真正『懂』了索引,后续各讲都是这棵树的投影。
顺便区分 B+ 树与 B 树:B 树的非叶子节点也存数据,导致同样页大小下能放的目录项更少、扇出更小、树更高;B+ 树把数据全部压到叶子,非叶子纯当导航,扇出最大化。而且 B+ 树叶子链表让范围扫描只需顺链走,B 树范围扫描却要在树里反复上下。所以数据库索引几乎清一色选 B+ 树,不是偶然,是扇出与扫描模式双重胜出。
聚簇索引有个隐性代价:行『物理』依附于主键。若你用业务列当主键且经常 UPDATE 它,行的主键值变了,聚簇索引要把整行挪到新位置,所有二级索引里存的主键值也要跟着改------一次主键更新牵连全表索引。这就是为什么主键要『稳定、短、递增』:千万不要用会变的主键,否则写入放大惊人。
页内记录还有格式讲究(如 Compact 行格式):变长字段长度列表、NULL 标志位、记录头(含 next_record、事务 id、回滚指针)依次排布,真实列数据在后面。记录头里的 transaction_id 与 roll_pointer(源码中名为 roll_ptr,类型 roll_ptr_t,定义见 storage/innobase/include/trx0types.h:140)是 MVCC 的基石,每条记录都挂着它们,所以即便只是读,行里也始终带着版本信息------这解释了为什么 InnoDB 能不加锁做一致性读。
关于回表的硬件差异再补一句:在 HDD 上随机回表极慢(寻道毫秒级),覆盖索引的收益被放大;在 SSD 上随机读快很多,回表代价下降,但『少一次索引遍历』仍是有意义的。所以『是否值得为覆盖而扩索引』要看存储介质:HDD 上更值得,SSD 上收益收窄但仍正。
count 优化的工程做法:别指望 count(*) 快,业务需要总数时单独维护一张计数器表,写入时 ±1,读取直接取------把『扫全表』变成『读一行』。这是用写多一次换读快千倍,对高频展示总数的场景极划算,也是『索引组织表没有行计数器』这一事实的标准应对。
最后把索引的物理直觉固化:一切访问都从某棵 B+ 树的根开始,沿页内二分下降,落到叶子;聚簇叶子给整行、二级叶子给主键(可能回表);16KB 页、极大扇出、矮树、顺序叶子链表,这四个性质解释了索引为什么快、范围为什么快、回表为什么慢。带着这四句话读后续各讲,会轻松很多。