目录
[二、5W2H 系统性解析 LangChain](#二、5W2H 系统性解析 LangChain)
[1、What:LangChain 是什么?](#1、What:LangChain 是什么?)
[2、Why:为什么要用 LangChain?](#2、Why:为什么要用 LangChain?)
[3、Who:谁适合使用 LangChain?](#3、Who:谁适合使用 LangChain?)
[4、When:什么时候选择 LangChain?](#4、When:什么时候选择 LangChain?)
[5、Where:LangChain 在整个大模型开发架构的位置](#5、Where:LangChain 在整个大模型开发架构的位置)
[6、How:LangChain 架构、模块组成,模块之间如何协作](#6、How:LangChain 架构、模块组成,模块之间如何协作)
[LangChain 核心模块清单](#LangChain 核心模块清单)
[模块之间如何协作(以本次故障诊断 RAG 为例)](#模块之间如何协作(以本次故障诊断 RAG 为例))
[7、How much:成本与门槛](#7、How much:成本与门槛)
[1、框架层面:LangChain VS Spring](#1、框架层面:LangChain VS Spring)
[1.1 相同点(框架设计层面)](#1.1 相同点(框架设计层面))
[1.2 框架层面核心不同点](#1.2 框架层面核心不同点)
[2、业务视角:传统后端业务开发 VS LLM 应用开发](#2、业务视角:传统后端业务开发 VS LLM 应用开发)
[四、案例展示:Java 故障诊断 RAG Demo(基于 LangChain+LCEL)](#四、案例展示:Java 故障诊断 RAG Demo(基于 LangChain+LCEL))
一、前言
前面我们已经了解了大语言模型应用开发全景地图,知道了LangChain属于编排层,是开发框架。编排层是提供组件抽象与执行编排能力,本身不具备业务功能,是搭建 AI 能力的基础设施。在这篇文章中我们将系统的学习一下 LangChain,并做一个小 demo。
二、5W2H 系统性解析 LangChain
1、What:LangChain 是什么?
名字拆解:LangChain = Lang + Chain
- Lang = Language,特指 Large Language Model(大语言模型 LLM) 框架的核心主体是大语言模型,所有组件都是为了扩展 LLM 能力。不是编程语言,不是 Python/Java 这种开发语言。
- Chain = 链,编排流水线 将 LLM、Prompt、检索器、工具等独立组件串联起来,按顺序执行,数据流在组件间传递。
一句话定义:LangChain 是一套面向大语言模型的应用开发组件化编排框架,提供标准化抽象,让开发者可以把 LLM 和外部能力(知识库、工具、数据库)组装成完整业务应用。
2、Why:为什么要用 LangChain?
原生直接调用 LLM API,只能完成单次问答。 业务场景往往需要串联多步操作:改写查询→检索知识库→组装 Prompt→调用 LLM 生成结果。 如果手写原生代码,会大量重复编写胶水代码、上下文传递、异常处理。 LangChain 提供统一抽象(Runnable),标准化所有组件,简化组装,复用组件。
3、Who:谁适合使用 LangChain?
后端研发(Java/Python):把 LLM 能力接入业务系统
AI 应用开发者:快速搭建 RAG、Agent 原型 Demo
本次案例使用者:我是多年 Java 后端研发,利用已有后端架构思维迁移到大模型应用开发。
4、When:什么时候选择 LangChain?
✅ 适合:
- 构建 RAG 知识库问答(本次故障诊断 Demo)
- 多步骤线性流水线任务
- 需要复用 LLM、Prompt、检索组件
❌ 不适合:
- 仅单次简单 LLM 问答,不需要外部检索、多步骤串联(直接调用 LLM API 即可)
- 超高并发生产级核心链路(需要额外深度封装、性能优化)
5、Where:LangChain 在整个大模型开发架构的位置
LangChain 在大模型开发架构里属于【应用编排层】。
从演进视角来看:业务需求驱动业务能力范式诞生;落地这类范式遇到工程痛点,进一步推动编排框架迭代。原生 LLM 缺少私有知识,业务上产生知识库问答需求,催生 RAG 能力;手写代码搭建 RAG 胶水代码繁杂,催生 LangChain 线性链式编排;当业务需要模型自主多步规划,诞生 Agent 业务范式;Agent 依赖状态、循环、分支,线性流水线无法承载,于是催生 LangGraph 图编排框架,用来支撑 Agent 运行。
类比传统后端:LLM = 数据库;LangChain=Spring;RAG = 基于 Spring 写的一个业务模块;LangGraph=Spring StateFlow 状态机。
6、How:LangChain 架构、模块组成,模块之间如何协作
LangChain 采用组件化架构 ,所有组件都实现统一抽象:Runnable。
Runnable 统一接口:invoke(input) -> output,输入进、输出出。所有组件都满足这个规范,所以可以用 LCEL 管道|串联。
LCEL: LangChain Expression Language,LangChain 表达式语言 是 LangChain 官方推出的流水线组合语法 ,专门用来把各个 AI 组件(大模型、Prompt、检索器、自定义函数、输出解析器)串成链路。
一句话:LCEL = LangChain 自带的管道语法,
|是管道运算符。
LangChain 核心模块清单
| 模块 | 作用 |
|---|---|
| Models 模型模块 | 封装 LLM / ChatModel。统一封装各类大模型 API 调用,屏蔽不同厂商 API 差异 |
| Prompts 提示词模块 | PromptTemplate,模板渲染,占位符填充。把变量注入提示词,构造给 LLM 的指令 |
| Retrieval 检索模块 | RAG 核心。包含文档加载、文本切分、Embedding、向量库、检索器。读取私有文档,向量相似度检索获取相关上下文 |
| Chains 链模块 | LCEL 为核心,把多个 Runnable 组件串联,构成完整流水线。子 Chain 可以单独封装复用 |
| Memory 记忆模块 | 存储多轮对话上下文,保存历史对话信息,实现连续对话 |
| Tools & Agents 工具模块 | 工具封装;Agent 基于工具 + LLM 自主决策,选择调用工具 |
| Callbacks 回调模块 | 链路埋点、日志、耗时采集、事件监听。类似 AOP 拦截,不侵入主业务逻辑 |
模块之间如何协作(以本次故障诊断 RAG 为例)
本图为入门精简版本,仅展示本次故障诊断 RAG Demo 用到的核心组件。LangChain 还有 Tools、Agent、Memory 等模块,属于进阶能力,后续学习 Agent 场景再引入。
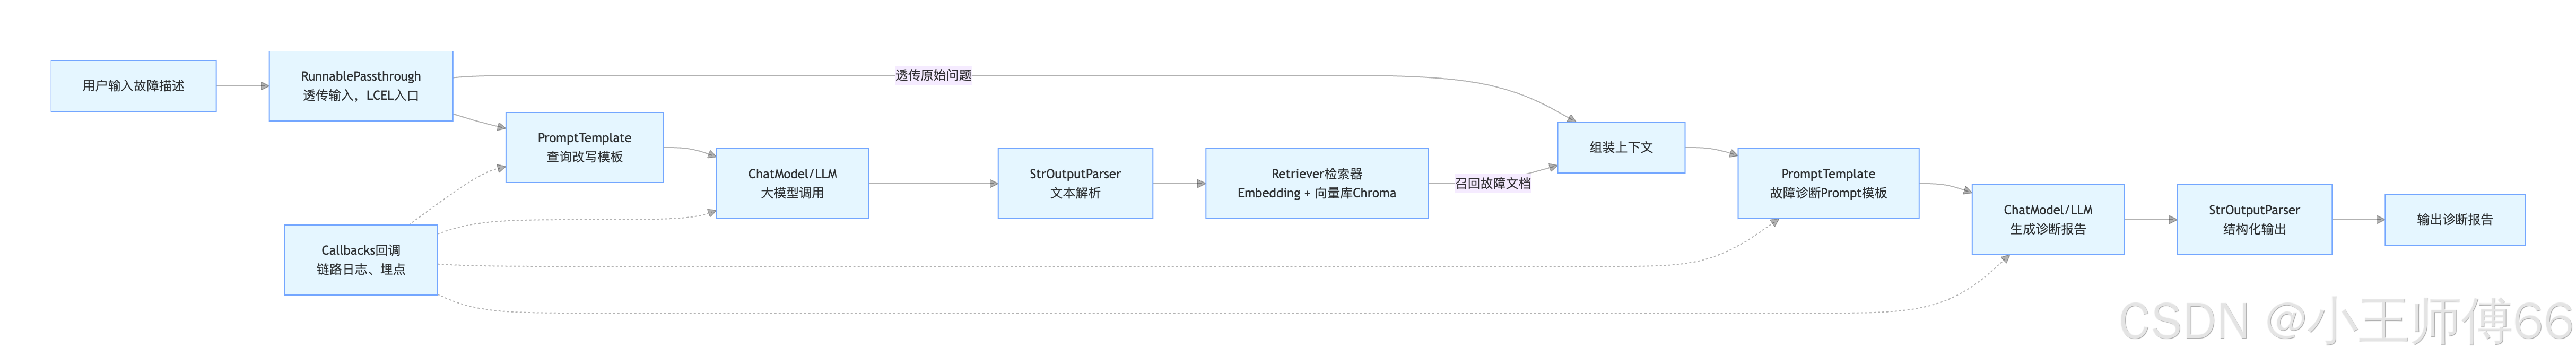
核心规则:所有组件都是 Runnable,上一个组件输出,作为下一个组件输入,LCEL | 负责数据流传递。
7、How much:成本与门槛
1、编码成本:有后端研发经验 + AI 辅助(Trae),Demo 搭建速度很快;
2、认知门槛:不在于写代码,而在于理解组件抽象、LLM 输出的不确定性;
3、运行成本:LLM 调用按 token 计费,向量库存储文档占用磁盘。学习前期可以使用各大平台提供的免费额度,足够运行简单的demo。
三、全局化分析
1、框架层面:LangChain VS Spring
前置说明:LangChain 和 Spring 同属于应用开发框架。本段只对比框架设计、抽象模型、组件编排、扩展机制,不混入大模型业务特性。
1.1 相同点(框架设计层面)
- 统一组件抽象 Spring:所有业务组件统一抽象为 Bean,具备统一生命周期,可注入、可复用。 LangChain:所有可执行单元统一抽象为
Runnable,统一invoke()契约,输入→输出,任意组件可以互相组合。 - 模块化、可组合、可复用 Spring:拆分 Service/Repository,抽取公共 Bean,嵌套组合。 LangChain:拆分 Prompt、Retriever、LLM Model,抽取子 Chain,子链可以嵌入更大链路。
- 声明式编排能力 Spring:支持责任链、Pipeline,也可以通过注解 / 配置声明式组装组件。 LangChain:LCEL 管道语法
A | B | C,声明式定义数据流,不用手写大量胶水代码。 - 非侵入式扩展 / 埋点 Spring:AOP,在方法执行前后做日志、监控,不修改业务代码。 LangChain:Callback 回调,监听 Runnable 执行事件,采集链路日志、耗时,不侵入主业务链。
- 统一异常与容错封装 框架内置基础异常处理能力,提供扩展点,业务代码在上层捕获处理。
1.2 框架层面核心不同点
| 维度 | Spring(Java 后端应用框架) | LangChain(LLM 应用编排框架) |
|---|---|---|
| 框架定位 | 编排后端业务组件:Bean、数据库、缓存、MQ、HTTP 客户端 | 编排 AI 组件:Prompt 模板、大模型调用、向量检索、工具调用、对话记忆 |
| 组件的输入输出 | Bean 方法出入参:Java 对象(强类型,编译期校验) | Runnable 出入参:字典 / 文本(弱类型,运行期动态拼接) |
| 编排模型 | 对象依赖注入为主 + 命令式流程编排 | 以数据流管道为核心(LCEL),依赖注入为辅 |
| 扩展插件模型 | Bean 后置处理器、AOP、SPI | Runnable 自定义封装、Callback 回调、自定义工具 |
| 原生内置组件 | 内置数据库、事务、缓存、web、消息等后端中间件集成 | 内置 LLM 模型封装、向量库、文档解析、Prompt 模板等 AI 领域组件 |
一句话总结框架对比: Spring 是面向传统业务对象与中间件 的组件编排框架;LangChain 是面向AI 能力单元 的组件编排框架。二者的架构思想高度同源,只是内置组件、编排载体不同。
2、业务视角:传统后端业务开发 VS LLM 应用开发
前置说明:这一层对比不是框架差异。无论你用 Spring 还是裸写 Java,传统后端业务都具备这些特点;无论你用 LangChain,还是直接调用 LLM 原生 API,LLM 应用开发都会面临下面这些特性。
| 维度 | 传统后端业务开发 | LLM 应用开发 |
|---|---|---|
| 结果确定性 | 相同输入,结果强确定,逻辑固定不变 | 大模型生成文本天然非确定性;相同输入,输出存在浮动;额外存在幻觉、格式错误等语义问题 |
| 业务规则载体 | 业务规则全部写在代码、注解、配置文件中 | 业务规则分为两部分:代码逻辑 + Prompt 提示词。Prompt 属于业务规则,需要反复调试迭代 |
| 核心调用开销 | CPU、内存、数据库 IO;本地或内网调用,开销低 | LLM 为远程 API 调用;存在网络延迟、Token 计费、接口限流 |
| 主要故障类型 | 程序异常:空指针、SQL 异常、IO 超时等程序层面错误 | 除程序异常外,新增业务语义类问题:知识库召回不准、模型幻觉、输出格式不符合预期 |
| 调试方式 | 断点调试,逐行观察变量状态 | 需要查看完整 Prompt 上下文、召回文档、模型返回文本,更多是链路观测与 Prompt 调优 |
一句话总结业务层面差异:
传统后端追求确定、可复现;LLM 应用开发,需要在非确定的生成能力之上,通过检索、提示词、校验机制,把业务结果收敛到可用范围。
四、案例展示:Java 故障诊断 RAG Demo(基于 LangChain+LCEL)
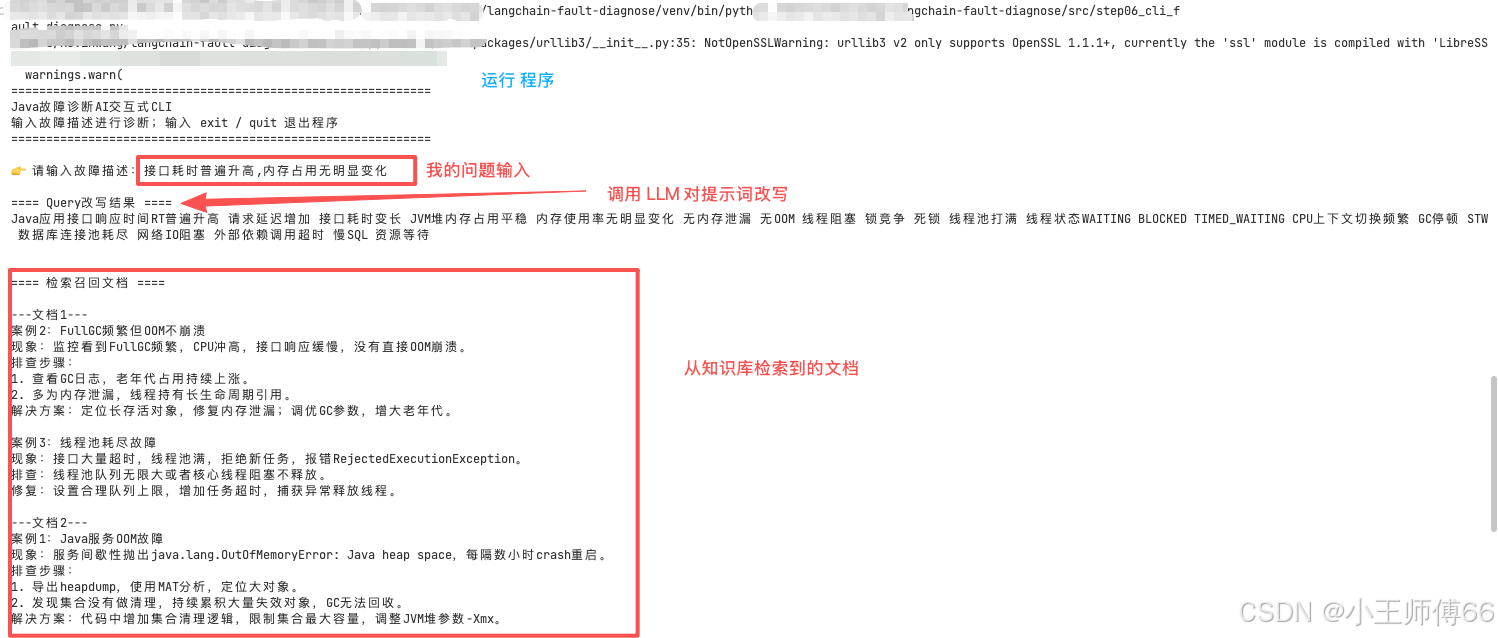
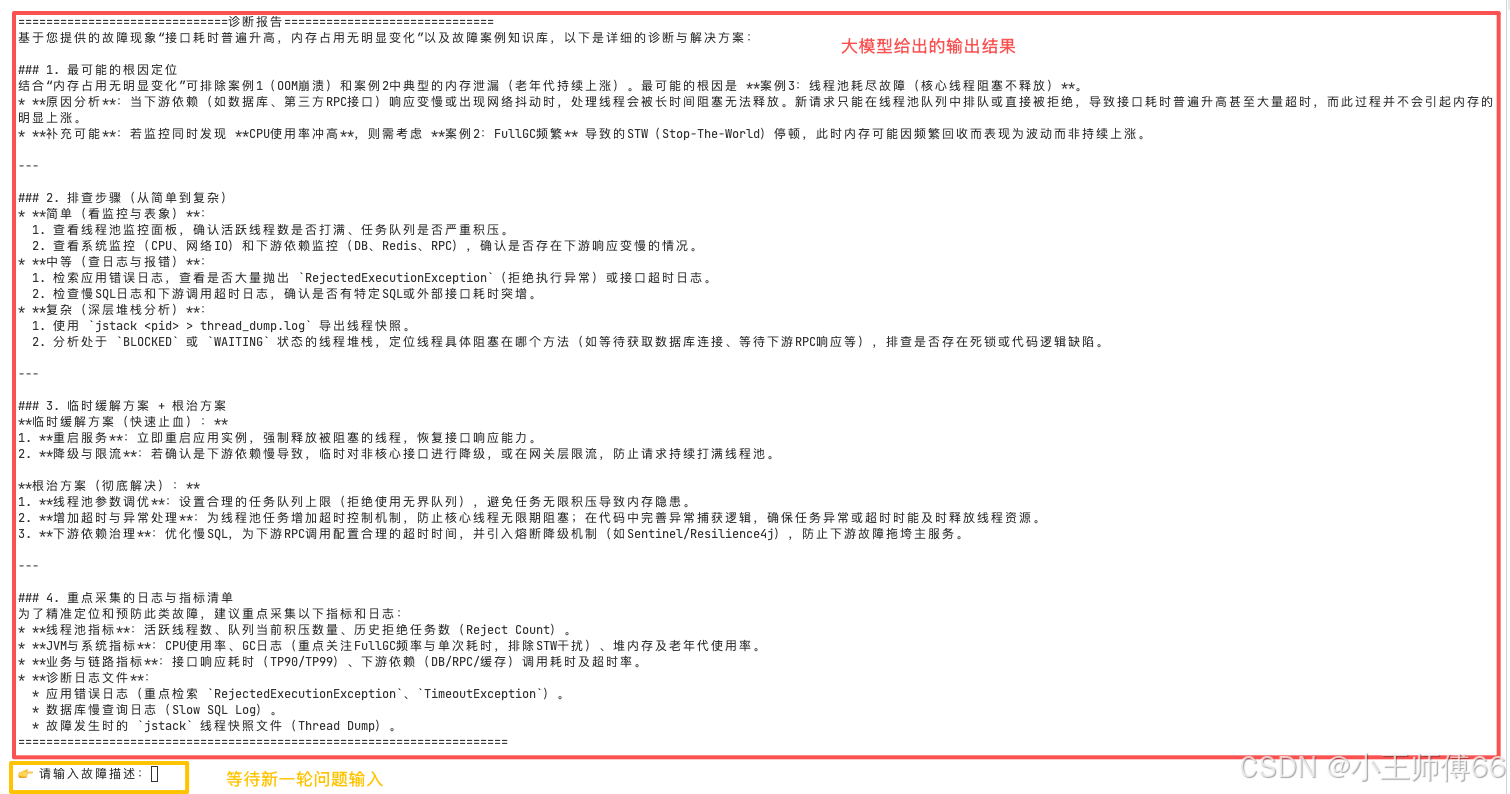
这是一套完整的Java故障诊断RAG实现,底层包含Query重写、向量库RAG检索、LLM推理生成诊断报告核心能力,封装为可循环交互的命令行CLI程序,可反复输入不同故障现象获取诊断结果。
代码:
python
import os

from dotenv import load_dotenv

from langchain_openai import ChatOpenAI

from langchain_chroma import Chroma

from langchain_community.embeddings import DashScopeEmbeddings

from langchain_core.prompts import ChatPromptTemplate

from langchain_core.output_parsers import StrOutputParser

from langchain_core.runnables import RunnablePassthrough


# ====================== 加载环境变量 ======================

load_dotenv()


llm_api_key = os.getenv("LLM_API_KEY")

llm_base_url = os.getenv("LLM_BASE_URL")

llm_model = os.getenv("LLM_MODEL", "qwen3.7-plus")

embed_model_name = os.getenv("EMBED_MODEL", "text-embedding-v4")

persist_dir = os.getenv("CHROMA_PERSIST_DIR", "./chroma_fault_db")


# ====================== Embedding & 向量库 ======================

embedding = DashScopeEmbeddings(

model=embed_model_name,

dashscope_api_key=llm_api_key

)


vector_db = Chroma(

persist_directory=persist_dir,

embedding_function=embedding

)

retriever = vector_db.as_retriever(search_kwargs={"k": 2})


# ====================== LLM实例 ======================

llm = ChatOpenAI(

api_key=llm_api_key,

base_url=llm_base_url,

model=llm_model

)


# ====================== Query改写子链 ======================

query_rewrite_prompt = ChatPromptTemplate.from_template("""

你是故障检索关键词扩写助手。

把用户简短的Java故障描述,扩展成适合向量检索的详细查询语句,提炼故障现象、异常关键字、JVM信息。

只输出改写后的查询文本,不要多余解释。


用户原始故障:{raw_question}

""")

query_rewrite_chain = query_rewrite_prompt | llm | StrOutputParser()


# ====================== 诊断Prompt ======================

diagnose_prompt = ChatPromptTemplate.from_template("""

你是Java后端故障诊断专家。基于提供的故障案例知识库内容回答用户问题。

【知识库参考】

{context}


【用户原始故障描述】

{raw_question}


要求:

1. 先定位最可能的根因;

2. 给出排查步骤(从简单到复杂);

3. 给出临时缓解方案 + 根治方案;

4. 最后给出需要重点采集的日志指标清单。

""")


# ====================== 自定义Runnable节点 ======================

def rewrite_and_retrieve(input_dict):

raw_question = input_dict["raw_question"]

rewrite_query = query_rewrite_chain.invoke(raw_question)

print(f"\n==== Query改写结果 ====\n{rewrite_query}\n")

docs = retriever.invoke(rewrite_query)

print("\n==== 检索召回文档 ====")

for idx, doc in enumerate(docs):

print(f"\n---文档{idx+1}---")

print(doc.page_content)

context = "\n\n".join([doc.page_content for doc in docs])

return {

"context": context,

"raw_question": raw_question

}


rewrite_and_retrieve.__name__ = "rewrite_and_retrieve"


# ====================== LCEL 完整链路 ======================

chain = (

RunnablePassthrough()

| rewrite_and_retrieve

| diagnose_prompt

| llm

| StrOutputParser()

)


# ====================== 交互式CLI主循环 ======================

if __name__ == "__main__":

print("=" * 60)

print("Java故障诊断AI交互式CLI")

print("输入故障描述进行诊断;输入 exit / quit 退出程序")

print("=" * 60)


while True:

try:

user_input = input("\n👉 请输入故障描述:").strip()

if user_input.lower() in ["exit", "quit"]:

print("程序退出,再见!")

break

if not user_input:

print("输入不能为空,请重新输入。")

continue


q_input = {"raw_question": user_input}

res = chain.invoke(q_input)

print("\n" + "="*30 + "诊断报告" + "="*30)

print(res)

print("="*70)


except Exception as e:

print(f"\n❌ 本次查询异常:{str(e)}")

print("可继续输入下一条故障,程序不会退出\n")
输出截图:
五、总结:
我从连接大模型到输出完整的故障诊断 RAG Demo,边理解边编码,耗时一天。如果使用 Workbuddy这类RAG低代码平台工具,一小时就能快速跑出原型。
我的感受:作为多年 Java 后端研发,这个 Demo 的开发体验,就像用 SpringBoot 写一个组合查询接口,编码实现并不难。即便采用 Python 开发,在 TRAE 的辅助下,跨语言编写调试代码的成本很低。
编码只是表层工作。真正的难点,是挖掘、拆解业务需求,同时学会管理大模型的不确定性,设计稳定可靠的 AI 应用方案,最终依靠 AI 给企业创造实际价值。 传统后端我们追求确定的返回结果;而 LLM 应用开发,最大挑战,是在模型输出天然不确定的特性之上,构建一套能稳定交付业务价值的系统。