一、Ollama 介绍
Ollama 是一款强大的本地大模型运行工具,它极大地简化了在本地电脑上部署和运行大语言模型(LLM)的流程。无论是热门的 Llama 3、Qwen,还是 Mistral 等模型,Ollama 都能让你通过简单的命令行操作,轻松完成下载、安装和运行,无需复杂的 Python 环境配置或 GPU 集群支持。
Ollama 的核心优势在于其开箱即用的特性。它将模型权重、依赖库和运行环境打包在一起,用户只需执行一条命令,即可启动一个功能完整的模型服务,并通过 API 或命令行进行交互。这使得开发者可以快速进行本地原型验证,也让人工智能爱好者能够在自己的电脑上体验前沿模型的魅力。
二、官网下载
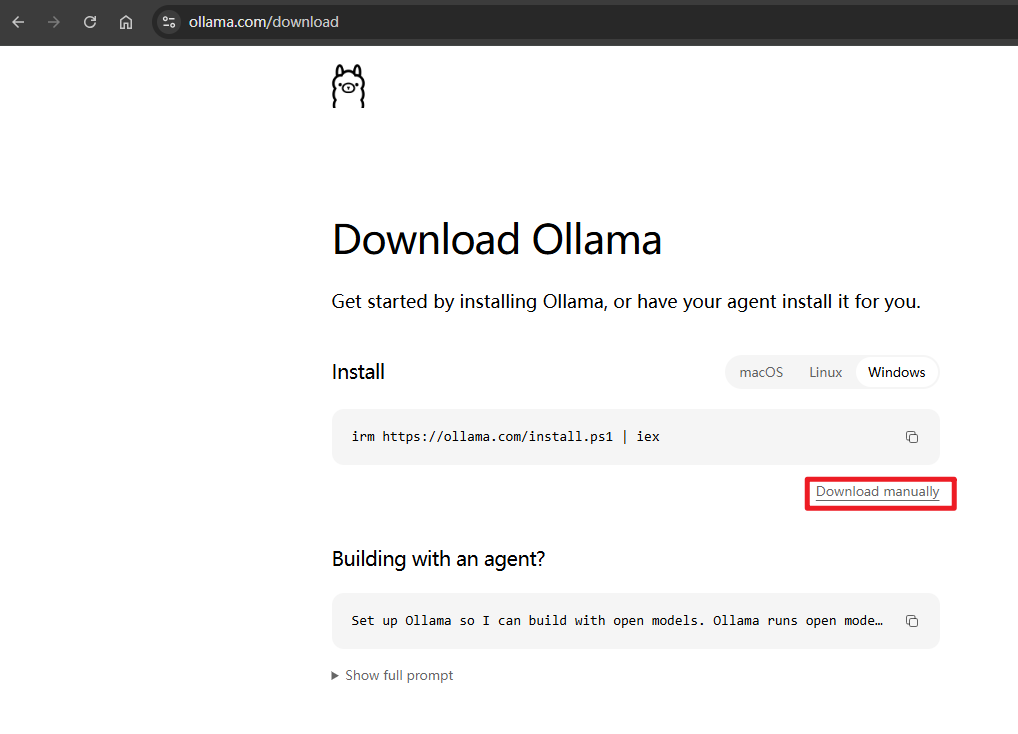
Ollama 的官方下载页面提供了多种安装方式,以适应不同用户的需求。官网下载地址:https://ollama.com/download
1. exe 下载
对于大多数 Windows 用户,直接下载可执行文件(.exe)是最直观的方式。点击官网下载页面的「Windows」按钮,即可获取 OllamaSetup.exe 安装包。
2. 终端下载
如果你习惯使用命令行,可以通过 Windows PowerShell 或终端执行以下命令,自动下载并安装最新版本的 Ollama:
powershell
irm https://ollama.com/install.ps1 | iex该命令会从官方服务器拉取安装脚本并执行,整个过程无需手动点击,非常适合喜欢自动化操作的用户。
三、安装
1. 以 Win10,OllamaSetup.exe 安装为例
双击下载好的 OllamaSetup.exe 文件,会弹出安装向导。点击「Install」按钮即可开始安装。
目前的 Ollama 会默认安装到 C 盘,路径如下:C:\Users\%username%\AppData\Local\Programs\Ollama,并不会让用户自定义选择安装路径。安装完成后,Ollama 会自动在后台运行,并常驻于系统托盘。
2. Setting 配置
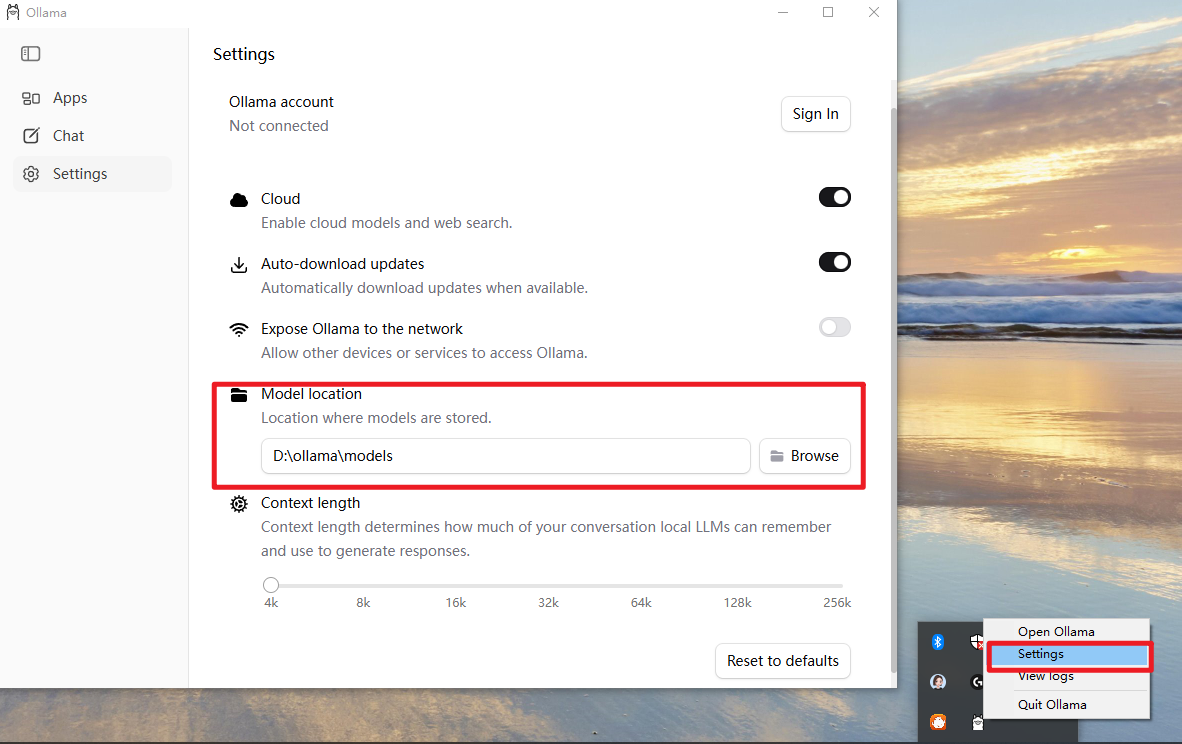
Ollama 的默认模型存储路径如下:C:\Users\%username%\.ollama\models。随着下载的模型越来越多,这个文件夹会占用大量磁盘空间。为了避免 C 盘空间不足,强烈建议将模型存储路径修改到其它盘符。
可以根据Ollama APP中Settings设置修改存储路径
3. 模型说明
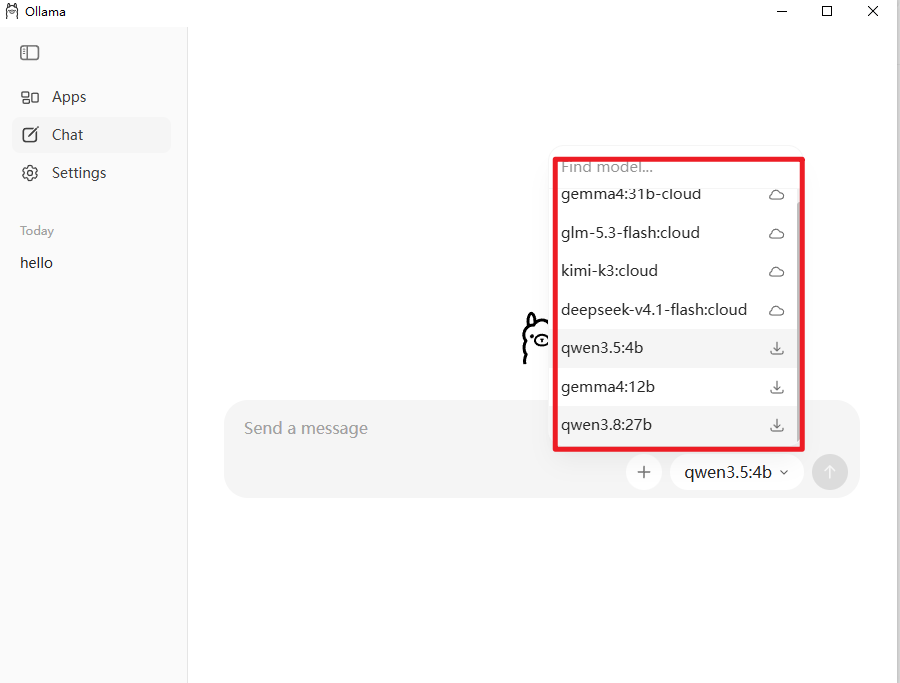
在 Ollama 中运用的模型叫蒸馏模型。
蒸馏模型就是对标准大模型核心技能的学习,并进行瘦身,从而获得更低的性能要求。简单来说,蒸馏模型通过知识蒸馏技术,将一个大而强的"教师模型"的能力,迁移到一个更小、更快的"学生模型"上。这样,我们就能在普通家用电脑上,以更低的显存占用和更快的推理速度,运行一个能力不俗的模型。
4. 参数量选择
选择合适的模型参数量(以 B 为单位,即十亿参数)是获得良好体验的关键。以下是针对不同硬件配置的参考建议:
- 集显:1.5b
- 4G 独显:8b 以内
- 8G 独显:14b 以内
具体可以自己试试。参数量越大对硬件要求越高,如果硬件能力不足,模型运算和吐字速度会下降。因此,建议根据自己电脑的实际配置,从较小的模型开始尝试,逐步找到性能与效果的最佳平衡点。
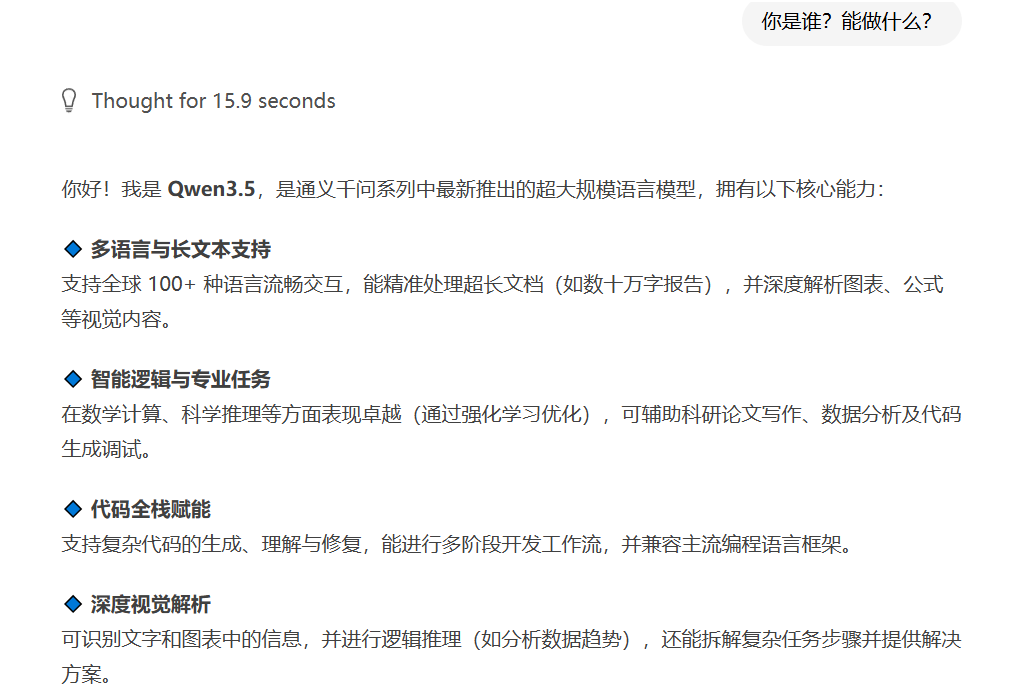
下面以选择 qwen3.5:4b 模型为例,Ollama 会自动下载并运行该模型:
运行结果:
四、Python 代码调用
除了在终端交互,Ollama 还提供了与 OpenAI 兼容的 API 接口,方便你在自己的 Python 程序中调用本地模型。下面以 qwen3.5:4b 为例进行演示。
首先确保已安装 openai 库,若未安装可执行:
bash
pip install openai然后编写如下 Python 代码:
python
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:11434/v1",
    api_key="ollama"
)

completion = client.chat.completions.create(
    model="qwen3.5:4b",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "你是谁,能做什么?"},
    ],
    stream=True
)

for chunk in completion:
    print(chunk.choices[0].delta.content, end="", flush=True)
运行上述代码后,程序会以流式方式逐字输出模型的回答,例如:
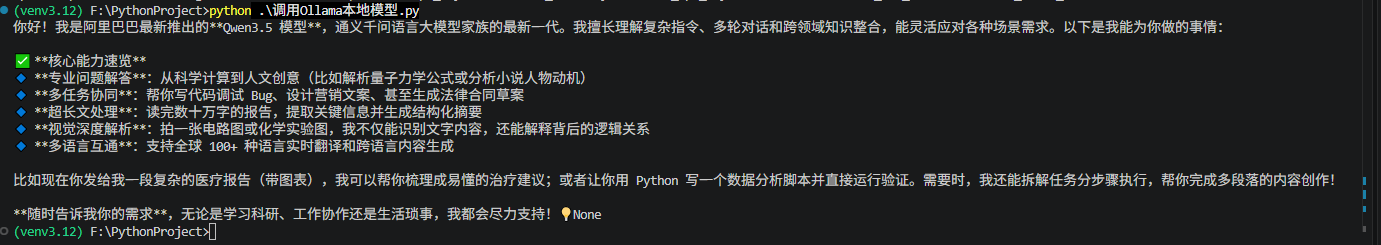
这样,你就可以在任意 Python 项目中,通过标准的 OpenAI 接口无缝接入本地 Ollama 模型,实现完全离线、无需联网的 AI 能力。