Playwright MCP 为 AI Agent 提供浏览器自动化工具。模型可以读取页面可访问性快照、选择元素、执行操作,再根据页面变化继续判断。但浏览器操作成功不等于测试通过。本文以一个可复现的待办事项应用为例,分析 Playwright MCP 的调用链路、环境配置、测试断言以及适用边界,并提供真实 Playwright 浏览器基线数据。
一、传统 Playwright 与 AI Agent,差别在哪里?
一个典型的 Web 回归用例,需要工程师预先写好定位器、操作步骤和断言。
业务流程稳定时,这种方式确定性强,容易纳入 CI/CD。遇到新页面或者经常变化的表单,测试人员则需要不断调查页面结构、修改脚本。
Playwright MCP 为另一种交互方式提供了入口:测试人员用自然语言描述任务,由 AI Agent 根据页面状态逐步选择浏览器工具。
它没有取代 Playwright 底层的自动化能力,而是改变了操作步骤的编排方式。
| 对比维度 | Playwright 脚本 | Playwright MCP + Agent |
|---|---|---|
| 决策来源 | 预先编写的代码 | 模型结合页面状态选择工具 |
| 页面定位 | 开发者维护 Locator | 模型参考页面快照与元素引用 |
| 失败处理 | 代码分支、重试、人工修复 | 重新观察页面并尝试后续动作 |
| 结果验证 | 显式代码断言 | 页面反馈与明确验证工具 |
| 适用场景 | 稳定回归、批量执行 | 探索性操作、流程理解、辅助构造测试 |
从工程角度看,MCP 解决的是"Agent 如何调用浏览器"的问题。
至于测试用例是否可靠,还取决于预期结果、数据隔离与断言设计。
二、Playwright MCP 的架构与职责边界
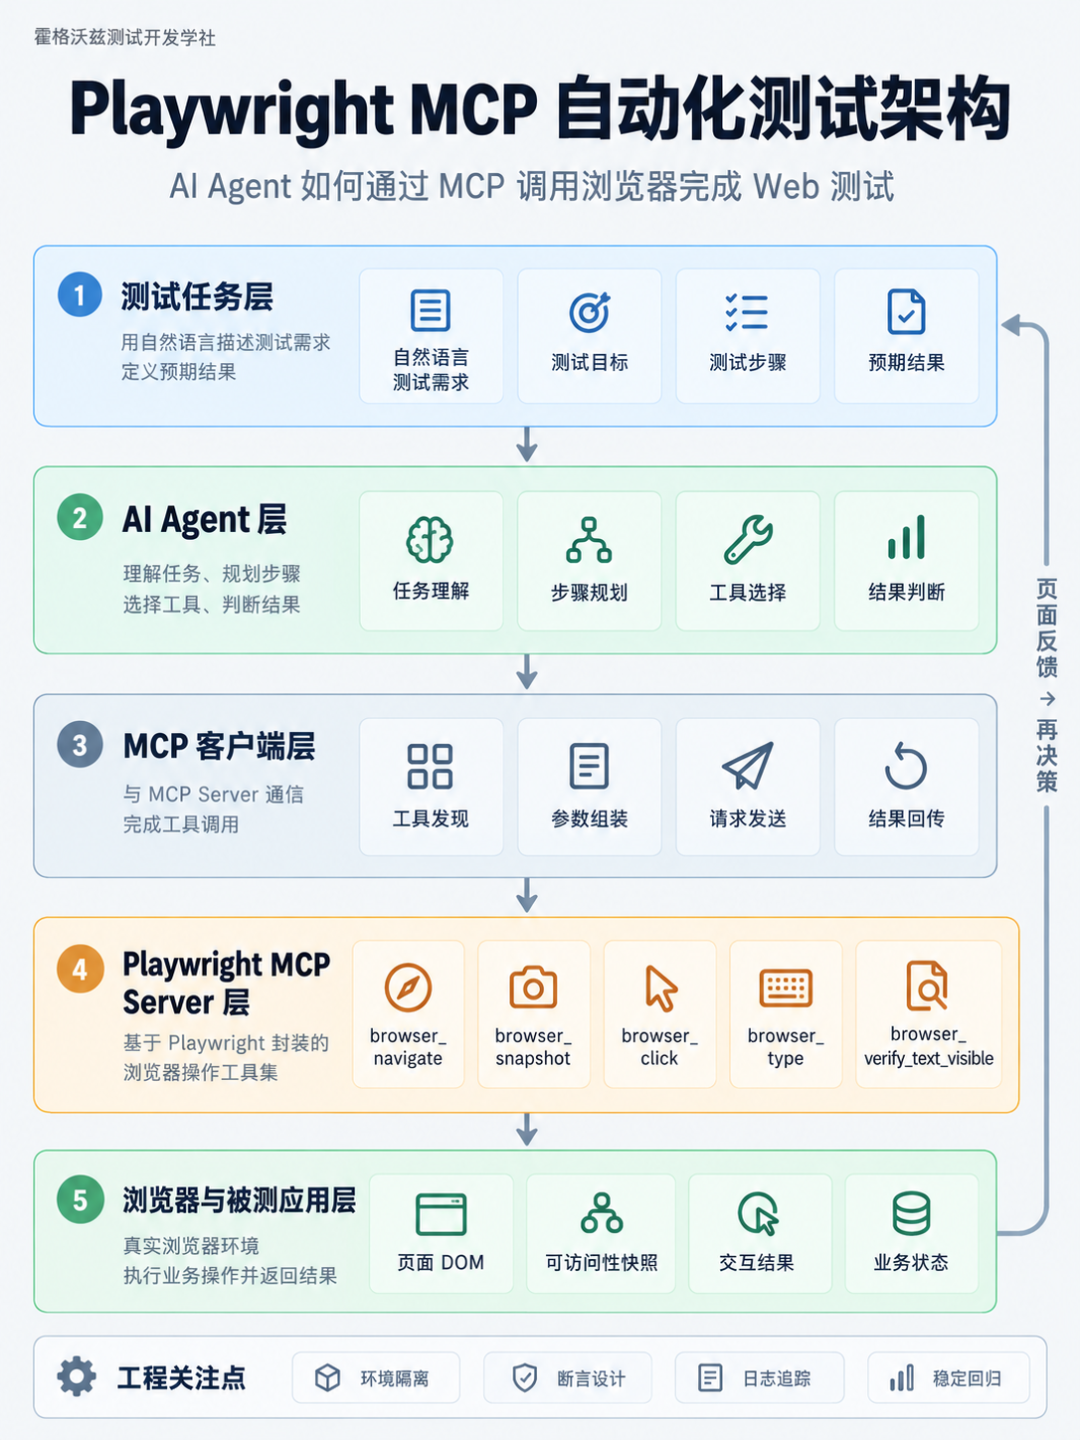
整个系统可以拆成五个部分:
1. 自然语言测试任务
测试人员描述需要执行的场景,包括测试对象、操作步骤和预期结果。
例如:
"打开待办事项页面,新增三条任务,将第一条标记为已完成,验证剩余任务数量。"
2. AI Agent
Agent 负责理解测试任务、选择工具,并根据浏览器返回的信息决定下一步。
这里的 Agent 不只是大语言模型本身,还包括工具调用与反馈处理的执行循环。
3. MCP 客户端
负责发现 MCP Server 提供的工具、传递调用参数、接收执行结果,并将相关反馈提供给 Agent。
4. Playwright MCP Server
将浏览器操作封装成标准化工具。
典型能力包括:
| 工具名称 | 功能 |
|---|---|
browser_navigate |
导航到指定页面 |
browser_snapshot |
获取页面可访问性快照 |
browser_type |
向可编辑元素输入文本 |
browser_click |
点击指定页面元素 |
browser_take_screenshot |
获取浏览器截图 |
browser_verify_text_visible |
验证指定文本是否可见 |
需要注意,验证类工具属于额外的 Testing 能力,需要按配置启用。
5. 浏览器与被测页面
Playwright 最终驱动浏览器执行操作,获取页面结构、交互状态和执行结果。
这一架构形成完整的反馈循环:
任务理解 → 工具调用 → 浏览器操作 → 页面状态反馈 → 下一步决策。
传统自动化脚本由代码决定执行路径;Agent 则可以根据浏览器反馈动态选择后续动作。
但动态决策也会引入模型输出不确定性和额外的工具调用开销。
三、AI Agent 如何理解页面并执行操作?
这是 Playwright MCP 工作机制中非常值得关注的部分。
很多人第一次接触 AI 浏览器自动化,会认为模型需要不断截图,再根据图片寻找按钮坐标。
Playwright MCP 的默认方案并不是这样。
它主要利用浏览器页面的结构化可访问性快照(Accessibility Snapshot),把页面中具有语义的元素信息提供给大模型。
1. 通过 MCP 发现浏览器工具
MCP Server 向客户端提供工具名称、描述及参数 Schema。
例如,browser_type 需要知道目标元素和输入文本。
模型根据任务内容选择该工具,并生成符合参数约束的调用。
2. 获取页面可访问性快照
以官方 TodoMVC 示例为例,浏览器返回的信息可以简化为:
- heading "todos" [level=1] [ref=e3]
- textbox "What needs to be done?" [ref=e5]
这里包含三类重要信息:
-
textbox:说明元素的交互角色。 -
What needs to be done?:元素的可访问名称。 -
ref=e5:当前页面快照中的元素引用。
模型可以根据角色、名称和上下文判断这个输入框是否符合测试意图。
3. 将元素引用转换成操作参数
模型随后调用 browser_type。
{
  "target": "e5",
  "text": "Buy groceries",
  "submit": true
}
这组参数来自 Playwright MCP 官方示例。
target 表示操作目标,text 是需要输入的内容,submit 表示输入后执行提交操作。
浏览器完成输入后,再返回更新的页面状态。
模型便可以继续检查新增任务是否出现在列表中。
4. 页面变化后重新获取状态
这里有一个工程细节:
快照中的元素引用不应当被视为永久稳定的定位符。
例如,用户点击"新增任务"之后,页面可能重新渲染,列表可能新增元素,之前的页面结构也可能发生变化。
此时应重新观察页面状态,使用最新的元素信息执行下一次操作。
这也是为什么在动态页面测试中,需要合理设计观察、操作和验证的顺序。
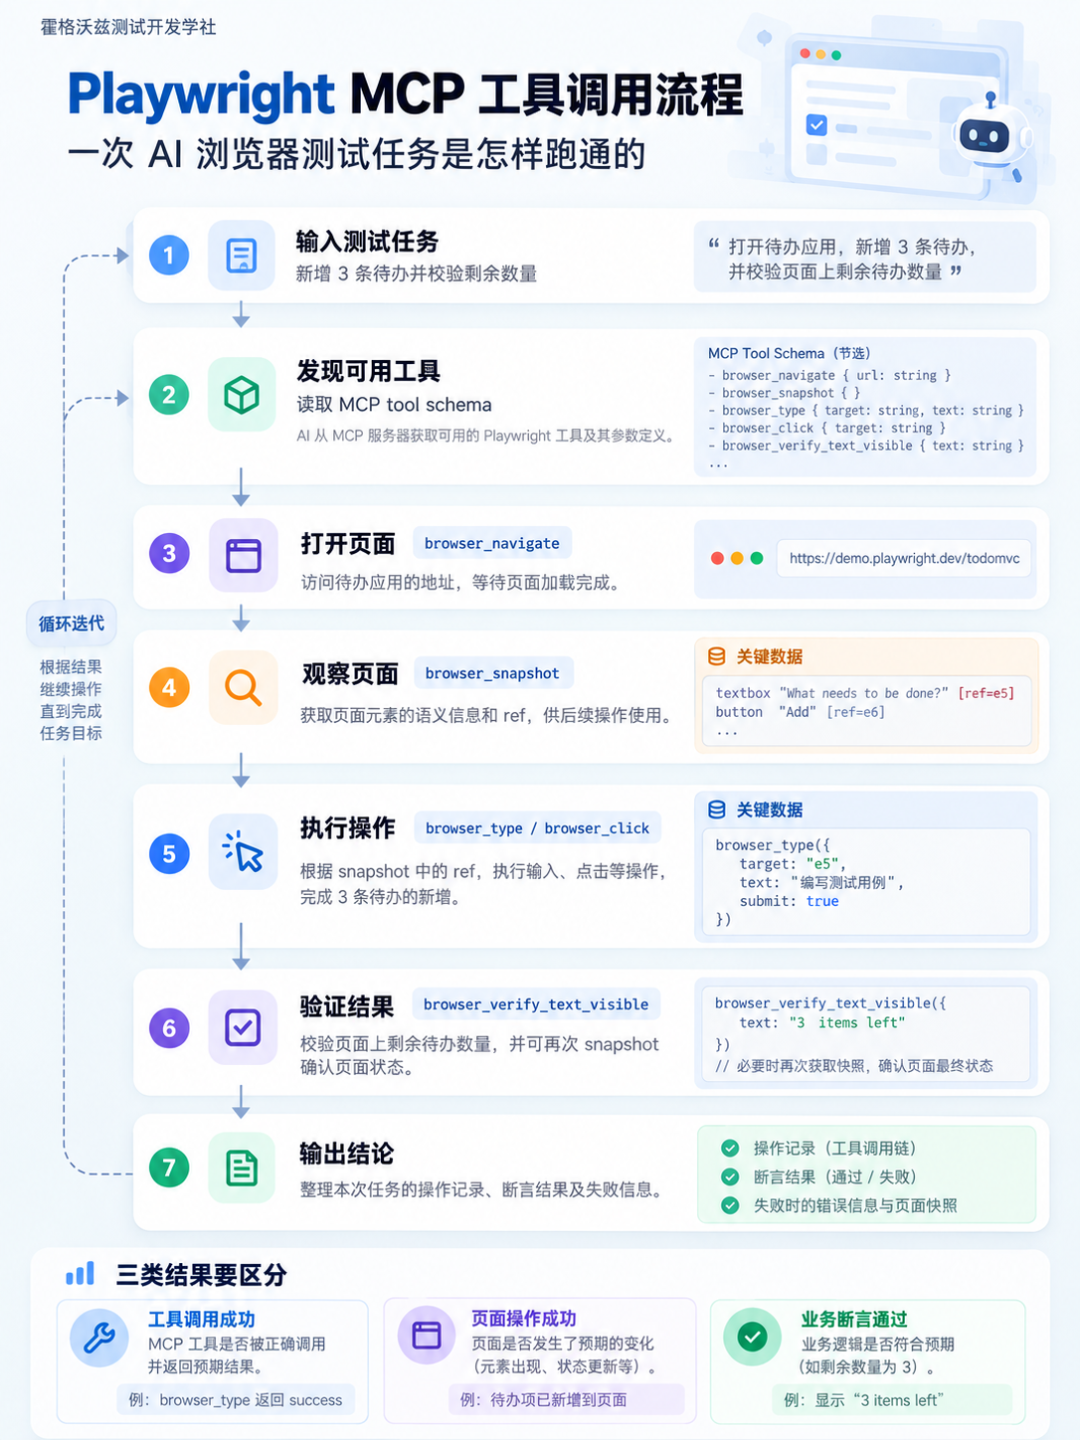
5. 工具执行成功,不代表测试通过
假设 Agent 成功点击了提交按钮,MCP 工具也返回成功。
但实际业务可能出现三种情况:
-
浏览器点击操作成功;
-
页面发起了请求,但服务器返回异常;
-
页面显示操作完成,实际数据却没有保存。
因此,自动化测试至少需要区分三个结果:
工具调用成功、页面操作成功、业务断言通过。
对于简单交互,可以使用 MCP Testing 工具验证页面状态。
对于订单、支付、库存等复杂业务,还需要结合接口响应、数据库或其他可信数据来源确认最终结果。
这部分决定了 AI 浏览器操作能否进一步用于工程化测试。
人工智能技术学习交流群
伙伴们,对AI测试、大模型评测、质量保障感兴趣吗?我们建了一个 「人工智能测试开发交流群」,专门用来探讨相关技术、分享资料、互通有无。无论你是正在实践还是好奇探索,都欢迎扫码加入,一起抱团成长!期待与你交流!👇

四、Playwright MCP 环境搭建
本次以 VS Code 中支持 MCP 的 AI Agent 为例。
1. 基础环境
按照 Playwright MCP 官方入门文档,推荐准备:
-
Node.js 20 或更新版本;
-
支持 MCP 的 AI 客户端;
-
可用的 Chromium 浏览器环境;
-
正常访问 npm 依赖源的网络。
首先检查 Node.js 和 npm:
node -v
npm -v
2. 配置 MCP Server
在项目根目录创建 .mcp.json。
{
  "mcpServers": {
    "playwright": {
      "command": "npx",
      "args": [
        "-y",
        "@playwright/mcp@latest",
        "--caps=testing",
        "--isolated"
      ]
    }
  }
}
这份配置包含两个额外参数。
--caps=testing
启用测试断言相关工具,例如验证文本是否可见、元素是否存在、元素值是否符合预期。
--isolated
使用隔离浏览器会话,浏览器 Profile 不持久化到磁盘,适合教学演示与独立测试任务。
注意,VS Code 还支持 .vscode/mcp.json 配置格式,但它使用顶层 servers 字段,而根目录可移植 .mcp.json 使用 mcpServers。
不要混用两种配置格式。
3. 为什么不建议默认打开所有 MCP 工具?
Playwright MCP 将工具划分为 Core、Testing、Network、Storage、DevTools 等不同能力集合。
按照需要启用工具,可以减少暴露给模型的工具描述和参数 Schema。
这样能够减少上下文消耗,也有助于降低模型选错工具的概率。
例如:
普通页面操作只需要 Core 能力;
需要断言时再启用 Testing;
需要分析网络请求、调试追踪时,再根据实际任务启用相应能力。
对于测试工程,工具选择应当由任务需求决定,而不必一次性加载全部功能。
五、实战:构建一个可复现的 Web 自动化测试环境
没有企业内部业务系统,也可以构建用于验证的测试页面。
本次制作了一个独立的待办事项应用,包含输入框、按钮、任务列表、复选框、状态统计和列表筛选。
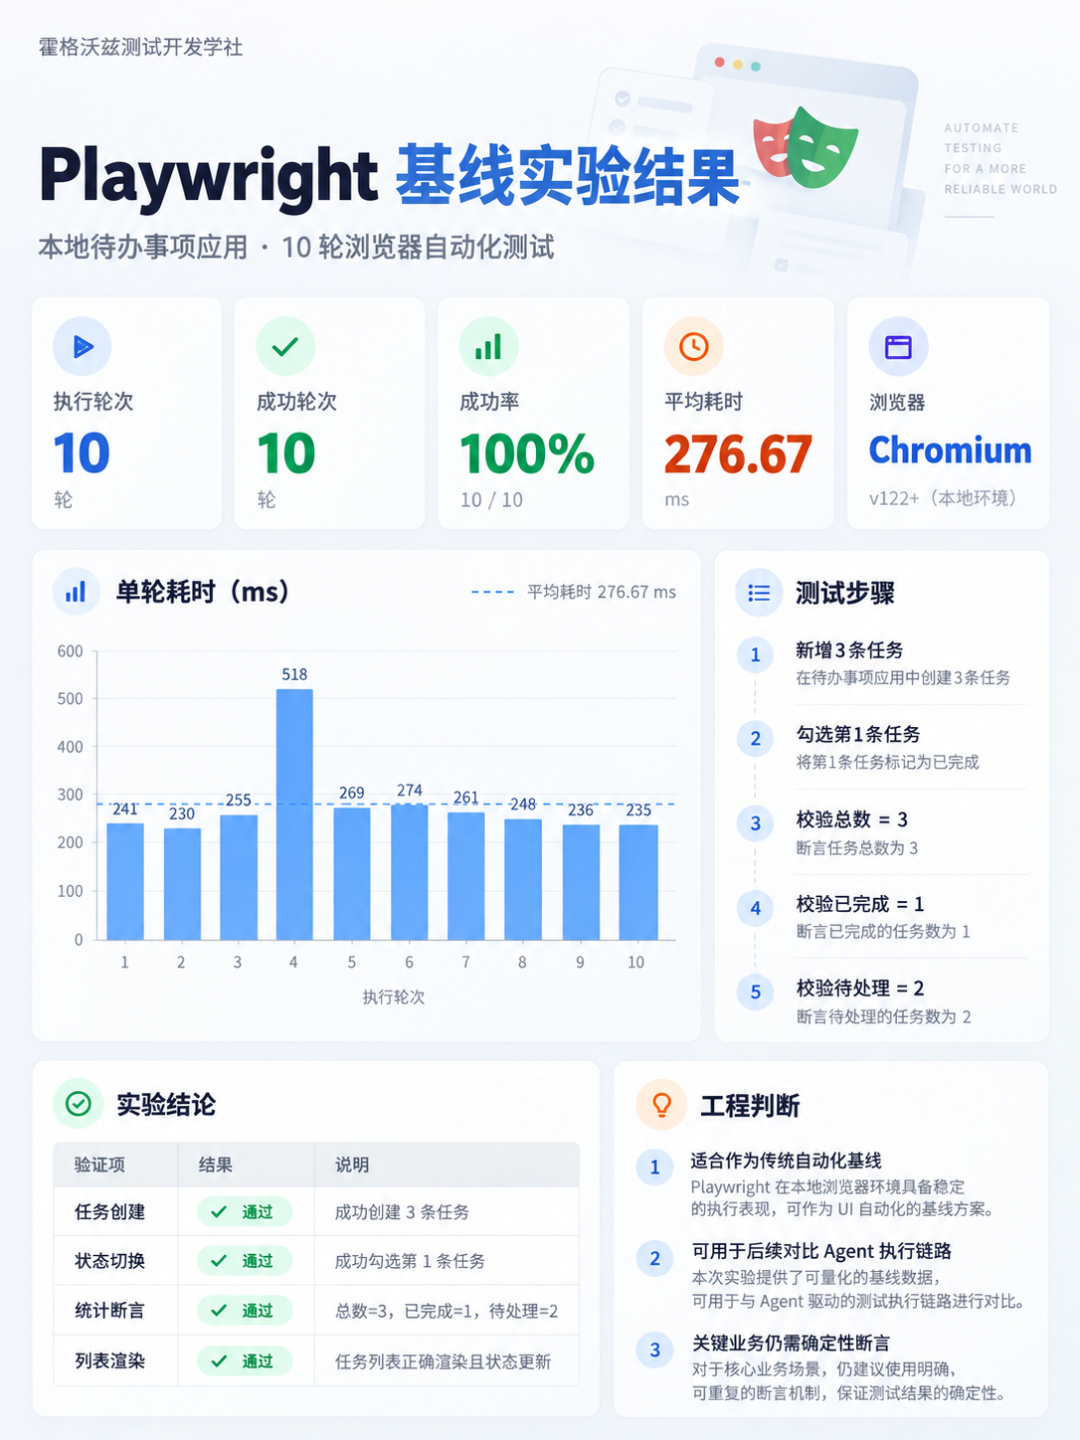
这次测试使用以下业务流程:
-
新增"编写测试用例"。
-
新增"执行自动化测试"。
-
新增"查看测试报告"。
-
将第一条任务标记为已完成。
-
检查任务总数、已完成数和待处理数。
预期结果为:
| 检查项 | 预期结果 |
|---|---|
| 任务总数 | 3 |
| 已完成 | 1 |
| 待处理 | 2 |
| 第一条任务状态 | 已完成 |
| 其余两条任务 | 未完成 |
为了验证页面和断言逻辑,先使用传统 Playwright Python 运行测试基线。
核心代码如下:
assert page.get_by_role('listitem').count() == 3

page.get_by_role(
    'checkbox',
    name='完成任务:编写测试用例'
).check()

expect(page.locator('#status')).to_have_text(
    '共 3 项任务 · 已完成 1 项 · 待处理 2 项'
)
这段代码使用元素语义定位和明确断言,而不是根据一张截图主观判断执行结果。
实验结果
在本地 Linux 容器中,使用 Chromium 无头浏览器进行了连续 10 轮测试。
| 测试指标 | 本地实验结果 |
|---|---|
| 执行次数 | 10 |
| 成功次数 | 10 |
| 最短耗时 | 230.16 ms |
| 最长耗时 | 518.19 ms |
| 平均耗时 | 276.67 ms |
实验采用本地 HTML 页面,通过 Playwright set_content 装载页面。每轮耗时包括新建页面、加载内容、执行操作和断言,不包含首次启动浏览器,也不包含真实网络传输。
需要特别说明:以上数据来自 Playwright Python 原生自动化测试,并非 Playwright MCP + AI Agent 的运行结果。
目前尚未完成 MCP 与大模型的端到端实测,因此不能把这个结果当成 MCP 的成功率或性能数据。
它的作用是建立一个可复现的传统测试基线,方便后续研究 Agent 驱动测试的执行机制和稳定性。
六、实战:通过 AI Agent 执行完整的 Web 自动化测试
前面已经介绍了 Playwright MCP 的架构、工具调用机制和环境配置。接下来,通过一个可公开访问的 Web 应用,验证 AI Agent 如何完成页面操作、状态检查和测试结果判断。
6.1 测试环境与业务场景
本次选择 Playwright 官方提供的 TodoMVC 演示应用。
测试地址:
https://demo.playwright.dev/todomvc
TodoMVC 是一个典型的待办事项管理应用,支持新增任务、修改完成状态、删除任务以及按照任务状态筛选列表。
虽然业务逻辑比较简单,但它包含了 Web 自动化测试中几个常见的交互场景:
-
文本输入与表单提交
-
动态列表更新
-
Checkbox 状态切换
-
页面状态和数量统计
-
多步骤操作后的业务断言
本次测试不需要编写传统 Playwright 操作脚本,而是由 AI Agent 通过 Playwright MCP 完成浏览器交互。
6.2 定义测试任务与预期结果
为了保证测试结果可以被验证,首先明确测试数据和预期行为。
| 测试步骤 | 预期结果 |
|---|---|
| 打开 TodoMVC 页面 | 页面成功加载,输入框可见 |
| 新增"编写测试用例" | 列表显示该任务 |
| 新增"执行自动化测试" | 列表显示两条任务 |
| 新增"查看测试报告" | 列表共有三条任务 |
| 勾选第一条任务 | 第一条任务进入已完成状态 |
| 检查剩余任务数量 | 页面显示 2 items left |
| 切换 Active 筛选 | 显示两条未完成任务 |
| 切换 Completed 筛选 | 显示一条已完成任务 |
在支持 MCP 的 AI Agent 客户端中,输入下面的测试指令:
请使用 Playwright MCP 测试以下 Web 应用:
https://demo.playwright.dev/todomvc
测试要求:
打开页面,通过 browser_snapshot 获取页面结构。
检查页面初始状态,确保任务列表为空。如果存在历史任务,请先清理演示数据。
依次新增"编写测试用例""执行自动化测试""查看测试报告"三条任务。
验证三条任务均成功显示在页面中。
将"编写测试用例"标记为已完成。
验证页面显示"2 items left"。
点击 Active,确认只显示两条未完成任务。
点击 Completed,确认只显示一条已完成任务。
返回 All 视图,获取最终页面截图。
执行约束:
优先使用 Playwright MCP 的页面快照和元素语义信息进行定位;页面发生变化后重新读取状态,不要复用已经失效的元素引用。
使用可用的测试验证工具检查关键结果。不要仅凭工具调用成功就认定测试通过。
最终输出实际调用的工具、关键参数、验证结果以及失败原因。
这份指令包含明确的测试对象、操作顺序、预期结果和执行约束,能够减少模型自行补充测试目标带来的不确定性。
6.3 分析 MCP 工具调用过程
按照 Playwright MCP 的工作机制,Agent 执行测试时需要依次完成页面导航、页面观察、元素交互和结果验证。
第一步:访问被测页面
Agent 首先可以调用 browser_navigate:
{
  "url": "https://demo.playwright.dev/todomvc"
}
Playwright MCP Server 接收到工具调用后,通过浏览器打开指定地址。
第二步:获取页面结构
Agent 调用:
browser_snapshot工具返回页面的结构化可访问性信息。
以官方 TodoMVC 文档中的页面结构为例,快照中可以包含:
- heading "todos" [level=1]
- textbox "What needs to be done?" [ref=e5]
这里的 textbox 表示可编辑输入框,ref=e5 是当前快照中的元素引用。
需要注意,e5 只是示例值,实际运行时必须使用最新页面快照提供的引用。
第三步:输入并提交任务
Agent 根据页面快照选择输入框,调用 browser_type。
例如:
{
  "target": "e5",
  "text": "编写测试用例",
  "submit": true
}
其中:
-
target指定页面元素; -
text指定输入内容; -
submit表示输入完成后提交。
后续两条任务采用同样的方式执行。
每次提交后,Agent 都可以重新读取页面,确认任务是否成功加入列表。
第四步:修改任务状态
三条任务创建完成后,Agent 需要找到第一条任务对应的复选框。
可以通过 browser_snapshot 获取当前任务列表和复选框信息,再调用 browser_click。
由于列表存在多个 Checkbox,Agent 应当结合任务名称和所在位置选择正确目标,避免将其他任务错误地标记为已完成。
第五步:验证页面结果
页面操作完成后,调用测试验证工具:
{
  "text": "2 items left"
}
对应工具为:
browser_verify_text_visible该工具检查指定文本是否在当前页面中可见。
如果返回成功,说明这项页面文本断言通过;如果返回错误,则需要继续分析页面状态。
随后还可以检查 Active 和 Completed 视图中的任务名称及完成状态。
这里应当关注一个细节:验证剩余数量为 2,并不能单独证明第一条任务被正确勾选。
还需要确认已完成的是"编写测试用例",而不是另外两条任务。
6.4 分析 Agent 的执行反馈循环
上述过程并不是一次性生成全部浏览器操作后盲目执行。
更典型的执行过程是:
接收测试任务
      ↓
发现可用 MCP 工具
      ↓
browser_navigate
      ↓
browser_snapshot
      ↓
理解当前页面状态
      ↓
browser_type / browser_click
      ↓
重新获取页面状态
      ↓
检查预期结果
      ↓
通过 / 失败 / 继续执行
每次工具调用都会产生新的执行信息,Agent 可以依据这些信息决定下一步动作。
例如,新增任务之后没有在页面中找到对应文本,Agent 不应该直接进行下一步,而应检查:
-
输入框是否选择正确;
-
提交操作是否真正触发;
-
页面是否仍在更新;
-
新增任务是否出现在其他列表状态中。
这构成了 AI Agent 驱动浏览器自动化测试的基础执行闭环。
6.5 如何判断测试真正通过?
传统自动化测试通常使用显式断言判断测试结果。
AI Agent 虽然可以理解页面语义,但仍然需要遵守相同的测试原则。
建议将验证结果划分为三个层次:
| 验证层次 | 检查内容 |
|---|---|
| 工具执行 | MCP 工具是否成功调用 |
| 页面状态 | 页面是否发生预期变化 |
| 业务断言 | 任务数量、完成状态和筛选结果是否正确 |
例如,browser_click 返回成功只能说明点击动作已执行,并不能保证对应业务状态正确更新。
对于本次 TodoMVC 测试,只有三条任务都存在、指定任务被正确勾选、剩余数量正确,并且 Active 和 Completed 筛选结果符合预期,才能判定整个测试场景通过。
如果任何一项断言失败,应当记录对应步骤,而不是让模型直接生成"测试成功"的结论。
工程实践中,建议保留 MCP 工具调用记录、最终页面快照、断言结果以及执行截图,作为问题分析和测试复现的依据。
通过这个案例,可以建立 Playwright MCP 最基础的自动化测试执行流程。后续再引入动态页面、复杂元素定位、失败恢复和测试代码生成,就能逐步扩展到更加完整的 AI Web 自动化测试体系。
七、工程实践:Playwright MCP 适合哪些测试场景?
Playwright MCP 并不适合无差别替代所有现有自动化脚本。
对于频繁执行、流程稳定、业务断言明确的回归测试,传统 Playwright 依然具备明显优势。
它的执行路径可以被准确控制,也容易与持续集成流水线结合。
对于新页面探索、复杂交互分析、辅助构造自动化操作流程等任务,Agent + MCP 提供了另一种工程实现方式。
实际落地时,建议关注三个问题。
1. 测试环境隔离
Agent 能够执行浏览器操作,就意味着它可能修改页面中的业务数据。
应使用测试账号、独立环境以及可以恢复的测试数据。
对于删除、支付、批量修改等敏感操作,应设置明确的权限限制和审批机制。
2. 断言与执行分离
让 Agent 负责操作,不意味着应该完全依赖模型来判断测试是否成功。
对于关键业务,应当使用确定性断言,并在必要时通过接口或后端数据进行交叉验证。
3. 执行过程可追溯
记录提示词、模型版本、浏览器环境、工具调用参数、页面状态、失败信息和最终断言。
否则即使偶尔完成测试,也很难复现失败,更难形成稳定的自动化回归能力。
八、总结
Playwright MCP 使 AI Agent 可以通过标准化工具调用访问浏览器,并根据页面状态执行连续操作。
它提供了浏览器自动化与大模型任务决策之间的连接机制。
对于测试开发工程师,理解这套机制需要掌握几个关键点:
-
MCP Server 如何暴露工具及其参数。
-
Agent 如何读取页面可访问性快照。
-
元素引用如何参与下一次工具调用。
-
页面状态变化后如何重新观察和决策。
-
如何通过独立断言确认业务结果。
当这条基础执行链路清楚之后,才适合进一步研究复杂动态页面、定位失败恢复、自动化用例生成和 Agent 测试评测。