论文方向:多模态大模型、向量检索、语义证据生成、表示学习
论文链接:arXiv:2609.33659 · 2026 年 9 月 27 日提交 · 腾讯 Yuanbao Technical Report
这篇论文提出 EviAlign(Evidence-Aligned Readout,证据对齐读取),研究一个很值得关注的问题:多模态大模型即使能够生成高质量的检索相关描述,也不代表这些信息一定会被有效地编码进最终的检索向量中。作者尝试将生成的语义结构与向量读取位置直接绑定,让模型在生成不同类型的证据后,从对应的语义边界提取隐藏状态,最终融合为一个用于检索的向量。
本文按照"动机---解决的问题---方法---实验设计与评价指标"的顺序展开,并重点解释其核心创新:为什么不只生成语义证据,还要在证据边界读取向量?
一、动机:为什么生成了有用的证据,检索效果仍然可能不好?
1.1 多模态向量检索的基本问题
传统的多模态检索通常将文本、图像或者图文组合映射到向量空间,然后通过向量相似度检索相关内容。例如,用户输入:
找一张图片:一只金色的狗趴在红色地毯上,位于桌子下面。
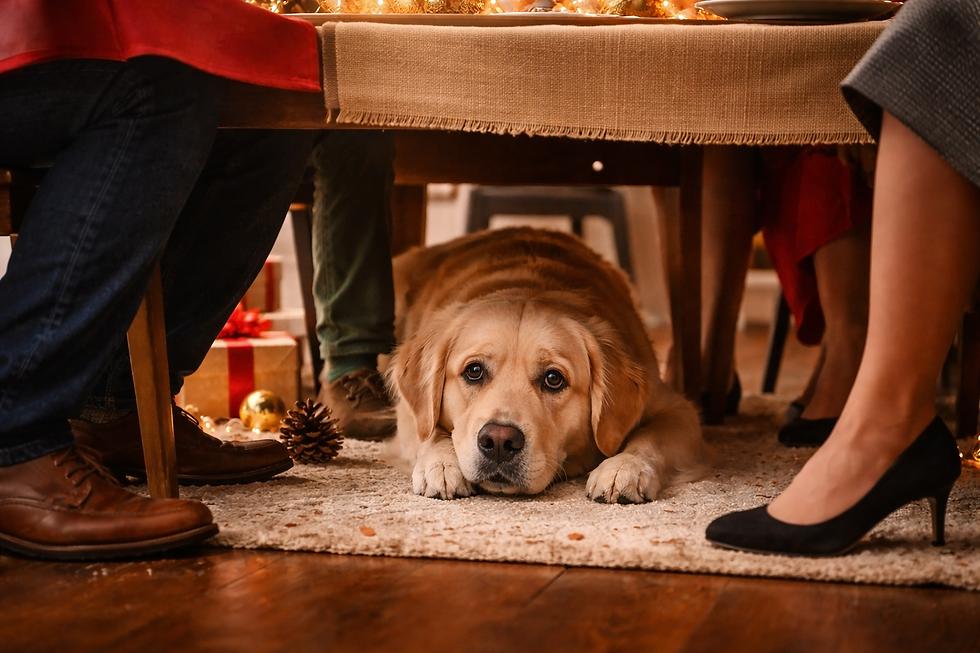
系统需要在大量候选图片中找到满足描述的图片。这里的匹配不能只依靠"狗"这个主体,还需要同时考虑:
-
实体(Entity):金色的狗、红色地毯、木桌。
-
属性(Attribute):室内场景、暖色光线。
-
关系(Relation):狗在地毯上,桌子在狗的上方。
-
细节(Detail):狗的姿态、桌面上的其他物体。
-
总结(Summary):整张图片的整体语义。
如果模型最终只保留了"狗"这一主要语义,就可能把没有红色地毯或者空间关系不正确的图片排到前面。
因此,多模态检索的核心并不只是识别输入包含什么,还要把与当前检索任务有关的实体、属性、关系及细节共同编码进表示中。
1.2 现有方法存在什么不足?
问题一:单个末尾隐藏状态可能压缩掉关键证据
许多多模态嵌入模型从最后一个 token 的隐藏状态中提取向量。生成结束时,模型虽然已经处理过多个语义信息,但最后一个状态是否完整保留了所有对检索有用的信息,并没有保证。
问题二:生成了推理过程,不等于有效利用了推理过程
让模型先生成一段自由形式的思维链(Chain of Thought,CoT),再提取最终向量,确实可能提升检索表现。但生成文本中的哪些部分应该进入向量、每部分应该发挥什么作用,并没有得到明确规定。
问题三:多个读取位置不一定带来有效的语义互补
即使从多个 token 读取隐藏状态,再将它们聚合为向量,如果这些位置只是按照固定长度或人为指定的位置选择,它们也不一定对应真正有意义的语义单元。
以上三个问题指向同一个研究空缺:生成端如何组织信息,与表示端从哪里读取信息,应该联合设计,而不是各自独立处理。
1.3 论文的核心假设
作者提出:如果生成过程明确地将检索证据组织成具有不同语义职责的单元,那么这些单元的结束位置就可以成为读取向量的依据。
举例来说,模型依次生成实体、属性、关系、细节和总结。当它生成完"实体"单元时,读取此时的隐藏状态;生成完"关系"单元时,再读取对应的隐藏状态。
这样,每个读取状态都能看到原始输入以及此前生成的证据,同时又对应一个明确的语义边界。
论文的核心思想可以概括为:语义证据生成(Semantic Evidence Generation) + 证据边界读取(Boundary Readout) + 对比学习(Contrastive Learning)。
二、解决的问题:EviAlign 到底要解决什么?
论文的目标不是单纯提升多模态大模型的文本生成能力,而是解决如何把生成过程中出现的检索证据,转化为更有区分能力的向量表示。
2.1 问题一:末尾读取无法显式控制不同证据的贡献
设输入为,模型生成证据序列
,然后读取隐藏状态得到最终嵌入。
一般的生成增强型嵌入方法可以写成:
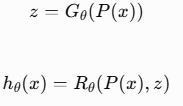
其中:
-
:输入的图像、文本或图文组合。
-
-
-
-
-
传统末尾读取通常只使用生成结束位置的一个隐藏状态。即使模型在中间生成了实体、关系、空间布局等内容,表示读取过程也没有明确要求这些不同证据分别对应哪些向量读取位置。EviAlign 的改进是:让生成序列中的语义边界直接决定读取位置。
2.2 问题二:语义组织与读取策略之间缺乏协同
论文通过受控实验区分了两个因素:
-
Evidence Organization(证据组织):不同类型的证据是否始终按照一致的语义角色排列。
-
Representation Readout(表示读取):最终向量是从序列末尾读取、在固定长度位置读取,还是在语义边界读取。
关键在于,这两个因素并不是独立的。
如果证据按照"实体---属性---关系---细节---总结"排列,但读取位置只按序列长度均匀分布,那么某个读取状态可能落在一个语义单元的中间。
反过来,如果模型在语义边界读取,却没有稳定的语义角色与边界对应关系,读取位置也未必具有一致的含义。因此,作者提出的研究问题是:
在训练数据内容和读取状态数量尽量保持一致时,语义组织与边界读取结合,是否比单独使用其中一种策略更有效?
三、方法:EviAlign 如何实现证据与向量读取对齐?
EviAlign 由两个紧密配合的模块构成。
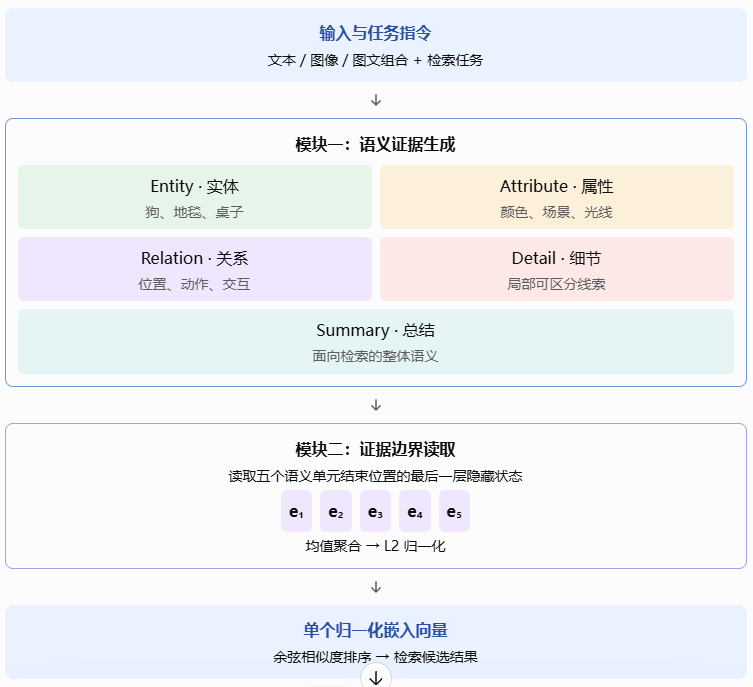 根据论文方法整理的 EviAlign 核心流程
3.1 模块一:Semantic Evidence Generation(语义证据生成)
作者将输入的检索相关信息划分为五个语义单元,并使用五个特殊边界 token 标记各单元的结束位置。
| 语义单元 | 边界 token | 主要职责 |
|---|---|---|
| Entity(实体) | <ENT> |
识别对象、概念及其身份特征 |
| Attribute(属性) | <ATT> |
描述颜色、场景、光照等属性 |
| Relation(关系) | <REL> |
描述空间关系、动作和对象交互 |
| Detail(细节) | <DET> |
保留局部、细粒度的判别线索 |
| Summary(总结) | <SUM> |
形成面向检索的整体语义描述 |
这些特殊 token 是新增词表项,初始化时使用 [EOS] 的嵌入。每种语义角色与一个固定的边界 token 对应。例如,对于"找一张金色的狗在桌子下面、红色地毯上的图片",模型可以按照以下逻辑组织证据:
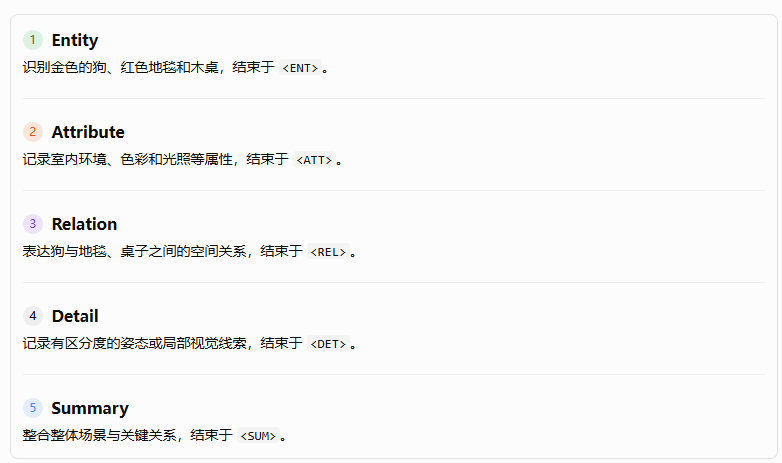
注意:上面是为了说明方法而整理的示意内容,并非论文提供的某条实际生成样本。
关键点: 这五个单元不仅用于让生成文本更有条理,也决定了后续表示提取的位置。这使生成模块和读取模块共享同一套语义结构。
3.2 模块二:Boundary Readout(证据边界读取)
这是论文最核心的技术设计。
自回归语言模型在生成每个 token 时,都会计算对应位置的隐藏状态。由于使用因果注意力,当前 token 的隐藏状态可以利用原始输入和此前已经生成的内容。
因此,当模型生成 <REL> 时,对应的隐藏状态已经能够访问实体、属性以及关系证据;生成 <DET> 时,则还能访问此前的细节前缀。
作者在每个边界 token 的位置提取最后一层隐藏状态,作为该边界对应的表示。
用公式表示:
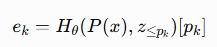
其中:
-
-
-
-
-
-
这里有一个容易误解的地方:并不是只表示当前语义单元的独立特征。它是一个上下文化状态,可以利用原始输入和截至该位置的全部前序证据。
因此,<REL> 对应的状态并非只编码"关系",还可能包含此前的实体和属性信息;"关系"表示的是这个状态的语义读取角色,而不是对隐藏状态信息的硬性隔离。
3.3 如何将五个隐藏状态融合成一个向量?
提取五个边界状态后,作者采用均值池化(Mean Pooling),再进行 L2 归一化。
首先,求五个边界状态的均值:
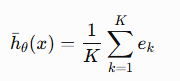
其中k=5,即五个语义单元。
然后进行归一化:
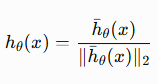
这样,五个读取状态被整合成一个单位长度的向量。
对于查询 q 和候选项 c,模型使用向量内积进行相似度计算:
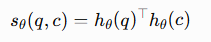
因为两个向量都经过 L2 归一化,所以这个内积等价于余弦相似度。
这意味着,EviAlign 在内部使用多个读取状态,但对外仍然是传统的单向量检索接口。不需要为每个候选保存五套独立索引,也不需要使用 ColBERT 一类多向量方法的 late interaction 机制。
3.4 训练目标:生成损失 + 双向对比损失
EviAlign 不只训练模型生成结构化证据,也要求这些证据边界上的隐藏状态能够形成高质量的检索表示。
整体训练目标为:
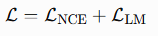
其中,语言建模损失为查询端和候选端生成损失之和:
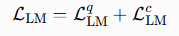
(1)语言建模损失
训练时,模型通过教师强制(Teacher Forcing)学习生成目标语义证据序列,包括证据文本和对应的边界 token。
它的作用是教会模型按照预定的语义角色组织检索相关信息,并且在正确的位置输出边界 token。
(2)对比学习损失
在一个 batch 中,已匹配的查询与候选是正样本对,不匹配的查询与其他候选构成负样本。
定义相似度:
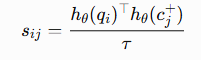
其中 是温度参数。
论文采用双向的批内对比目标:既优化查询到候选的检索,也优化候选到查询的检索。
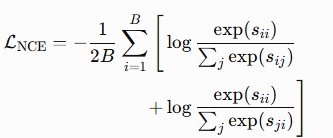
其中 B 为 batch 中的查询---候选配对数量。
直观地说,语言建模损失让模型"按规定生成证据",对比损失则让模型"用这些证据构造能够区分正确候选的向量"。
两种目标共同作用于同一个多模态大模型,而不是先训练一个独立的证据生成器,再训练一个完全独立的嵌入模型。
3.5 训练与推理流程的区别
训练阶段
-
输入查询或候选及其任务指令。
-
使用人工构造流程生成的目标证据序列,通过教师强制获得五个边界状态。
-
聚合边界状态,计算查询与正候选之间的对比损失。
-
计算证据生成损失,将两类损失相加,联合优化模型。
推理阶段
-
输入查询或候选,模型自回归生成五类证据。
-
根据实际生成的边界 token 位置提取隐藏状态。
-
将五个状态均值池化并进行 L2 归一化。
-
计算查询与候选向量的余弦相似度,返回排序结果。
如果生成过程中缺失某个预期的边界 token,论文实现会退回到最后一个生成 token 的最后一层隐藏状态作为该读取位置的替代。
这也意味着 EviAlign 不是只在推理时追加一个后处理步骤,而是在训练阶段就让生成结构与检索向量的构造相互配合。
四、实验设计:如何验证 EviAlign 的有效性?
论文的实验不只验证最终检索分数,还专门设计了控制变量实验,以回答一个更关键的问题:性能提升究竟来自生成了更多文本、使用了更多读取状态,还是来自证据组织与读取位置之间的对齐?
4.1 数据集与实验设置
论文主要使用 MMEB(Multimodal Embedding Benchmark)中的 12 个检索任务进行训练与评估。默认主干模型为 Qwen3-VL-8B-Instruct,并使用约 50 万组查询---候选训练配对。
评估数据集及任务
| 数据集 | 检索任务 | 主要考察能力 |
|---|---|---|
| VisDial | 文本检索图像 | 多轮视觉对话语境理解 |
| CIRR | 图文组合检索图像 | 理解参考图像与修改要求 |
| VisualNews t2i | 文本检索图像 | 新闻实体与视觉内容匹配 |
| VisualNews i2t | 图像检索文本 | 图像与新闻描述对齐 |
| MSCOCO t2i | 文本检索图像 | 通用图文语义匹配 |
| MSCOCO i2t | 图像检索文本 | 图像与自然语言描述匹配 |
| NIGHTS | 图像检索图像 | 细粒度视觉相似度 |
| WebQA | 文本检索图文候选 | 知识密集型、多跳问题检索 |
| OVEN | 图文检索图文 | 开放域视觉实体识别 |
| FashionIQ | 图文组合检索图像 | 服饰属性修改与细粒度匹配 |
| EDIS | 文本检索图文 | 新闻实体与事件检索 |
| Wiki-SS-NQ | 文本检索图文 | 视觉文档理解 |
论文将前 8 个任务作为域内(In-Domain)评估,后 4 个任务作为域外(Out-of-Domain)评估。每个测试任务包含 1,000 个查询,每个查询对应 1 个正样本和 999 个负样本。
需要注意,域外评估是指在独立的域外测试任务上进行检索评估,并不代表所有测试领域都与训练数据完全无关。
4.2 评价指标:Recall@1
论文的主要评价指标为 Recall@1,并报告 12 个任务的平均值。
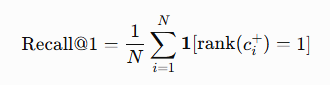
其中:
-
-
-
-
由于每个查询只有一个正样本,因此在该实验协议下,Recall@1 等于 Precision@1。
例如,某个任务有 1,000 个查询,其中 769 个查询的正确候选排在第一位,则 Recall@1 为 76.9%。
这个指标直接考察最重要的检索结果是否正确,但不能单独反映前 10 或前 100 个候选的整体排序质量。因此,论文主要通过它衡量首位检索准确性,而不是完整的排序质量。
4.3 主实验:与现有多模态嵌入方法比较
论文比较了三类方法:
-
直接嵌入:GME、LamRA-Ret、VLM2Vec、VLM2Vec-V2、UniME-V2。
-
显式生成或推理:UME-R1、RIME、Think-Then-Embed。
-
潜在推理:PLUME、LaME。
主要结果如下,单位为 Recall@1(%)。
| 方法 | 主干模型 | 训练数据规模 | 域内平均 | 域外平均 | 总平均 |
|---|---|---|---|---|---|
| GME | Qwen2-VL-7B | 约 8M | 70.9 | 71.8 | 71.2 |
| LamRA-Ret | Qwen2-VL-7B | 约 1.4M | 70.0 | 69.9 | 70.0 |
| VLM2Vec | Qwen2-VL-7B | 约 662K | 75.2 | 57.9 | 69.4 |
| UME-R1 | Qwen2-VL-7B | 约 1.5M | 75.4 | 64.8 | 71.9 |
| RIME | Qwen2-VL-7B | 约 1.5M | 77.0 | 65.6 | 73.2 |
| Think-Then-Embed | Qwen2-VL-7B 嵌入器 + 独立推理器 | 约 662K | --- | --- | 75.9 |
| EviAlign | Qwen2-VL-7B | 500K | 80.7 | 65.1 | 75.5 |
| EviAlign | Qwen3-VL-8B | 500K | 81.6 | 67.7 | 76.9 |
数据来源:论文 Table 1。不同方法使用的主干模型、训练数据与训练策略并不完全相同,不能将所有分数差异都归因于 EviAlign 的读取机制。
从结果中可以得到三个观察。
第一,EviAlign 在较少的训练配对下取得了较强的整体检索性能。 使用 50 万组训练配对,Qwen3-VL-8B 版本达到 76.9 的平均 Recall@1。与表中训练数据规模约为 150 万的 RIME 相比,整体分数高 3.7 个百分点。
第二,域内和域外表现并不相同。 EviAlign 的域内平均值达到 81.6,但域外平均值为 67.7。尤其是域外部分,GME 的平均值为 71.8,仍高于 EviAlign。这说明该方法的优势不是在所有领域都成立。
第三,单向量检索接口得以保留。 模型内部虽然读取五个隐藏状态,但最终只存储和比较一个归一化向量。这对需要大规模建立候选索引的实际检索系统具有意义。
4.4 核心消融实验:为什么必须对齐语义边界?
这是整篇论文最值得重点阅读的实验。
作者设计了一个的因子实验,同时改变两个因素。
第一个因素是证据组织方式:
-
Semantic:证据始终按照实体、属性、关系、细节、总结的语义角色组织。
-
Mixed:保留相同的证据片段,但在不同样本中打乱它们与固定边界位置之间的角色对应关系。
第二个因素是读取策略:
-
Trailing:只读取最后的
<SUM>状态。 -
Distributed:在与证据语义无关、按照序列长度确定的五个位置读取状态。
-
Boundary:直接读取五个语义单元的结束位置。
所有六种配置都使用相同的主干模型、50 万组训练配对、相同的优化设置,并尽可能匹配证据内容和读取状态数量。这样就可以比较语义组织与读取策略的联合效果。
实验结果:平均 Recall@1(%)
| 证据组织方式 | Trailing | Distributed | Boundary |
|---|---|---|---|
| Mixed | 73.60 | 74.20 | 74.55 |
| Semantic | 73.74 | 74.85 | 76.94 |
| Semantic − Mixed | +0.14 | +0.65 | +2.39 |
结果最值得关注的是最后一行。
当只读取末尾状态时,语义组织带来的优势仅为 0.14 个百分点;当使用五个按长度分布的读取位置时,优势增加到 0.65 个百分点;当读取位置与证据边界对齐时,优势达到 2.39 个百分点。
作者进一步计算了协同交互效应:
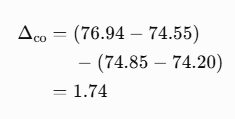
这个结果说明,在该受控实验中,语义组织与边界读取结合后,产生的收益比仅仅采用多位置读取、但不对齐语义边界时更大。
这里需要准确理解:1.74 个百分点是两种读取策略下"语义组织收益"的差值,而不是 EviAlign 相对所有基线的总提升。
4.5 消融实验:提升到底来自哪里?
作者进一步分别控制生成方式和表示读取方式。
| 生成方式 | 读取方式 | 平均 Recall@1(%) |
|---|---|---|
| 不生成证据 | 单个末尾状态 | 68.30 |
| 不生成证据 | 五个读取状态 | 70.30 |
| 自由形式 CoT | 单个末尾状态 | 73.75 |
| 结构化语义证据 | 单个末尾状态 | 73.74 |
| 结构化语义证据 | 五个末尾读取 token | 73.07 |
| 自由形式 CoT + 结构化证据 | 边界读取 | 76.59 |
| 结构化语义证据 | 边界读取,Qwen 生成监督 | 75.60 |
| 结构化语义证据 | 边界读取,GLM 生成监督 | 76.94 |
来源:论文 Table 3;各对照使用相同的 Qwen3-VL-8B 学生模型和 500K 训练配对。
这些实验支持以下结论。
-
生成本身有效。 自由形式 CoT + 单个末尾状态从 68.30 提升到 73.75。
-
结构化证据本身不是全部原因。 结构化证据配合单个末尾状态得到 73.74,与自由形式 CoT 的 73.75 基本相同。
-
读取状态数量也不是全部原因。 不生成证据、直接使用五个读取状态只达到 70.30。
-
简单地增加读取 token 不保证提升。 结构化证据后增加五个末尾读取 token 的结果为 73.07,反而低于单个末尾读取。
-
边界读取才体现了联合设计的收益。 结构化证据配合边界读取达到 76.94,比结构化证据配合单个末尾读取高 3.20 个百分点。
因此,作者不是简单证明"CoT 有用"或者"多向量有用",而是试图证明:当证据的语义组织直接决定读取位置时,生成与表示构造之间可以产生额外收益。
4.6 其他实验:语义单元数量与读取状态贡献
作者还研究了语义单元数量、不同主干模型规模以及五个读取状态各自的贡献。
语义单元数量实验
其他训练条件保持一致,联合调整证据结构与读取配置。不同语义单元数量的检索表现 MMEB 12 个任务的平均 Recall@1。
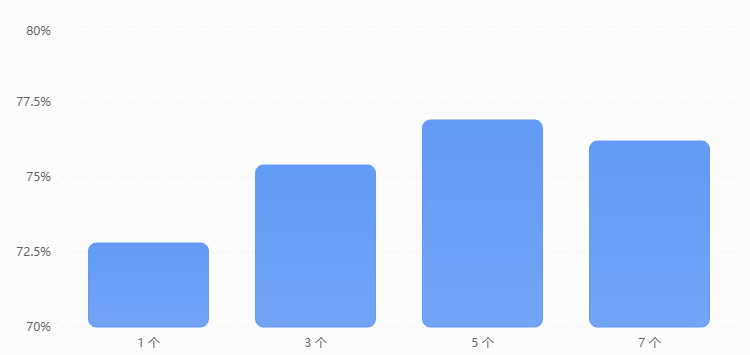
五个单元取得最佳结果。继续增加 Context(场景上下文)和 Emotion(情绪)后,平均 Recall@1 从 76.9 降至 76.2,说明语义单元并不是越多越好。
不同读取状态的贡献
只使用 Entity 状态时,平均 Recall@1 为 76.12;使用五个状态的完整聚合时为 76.94。移除任意一个读取状态,平均性能都会下降 0.23--0.36 个百分点。
这表明五个上下文化状态提供了互补信息,但它们并非完全独立的语义向量。
4.7 训练细节与效率
论文默认训练配置如下。
| 配置 | 设置 |
|---|---|
| 主干模型 | Qwen3-VL-8B-Instruct |
| 训练配对 | 约 500K |
| 视觉编码器 | 冻结 |
| 语言模型与投影层 | 全参数微调 |
| 优化器 | AdamW |
| 学习率 | 5e-5 |
| 对比损失温度 | 0.02 |
| 学习率调度 | Cosine Decay |
| 训练轮数 | 1 epoch |
| 有效全局 batch size | 256 对 |
| 精度 | BF16 |
| 硬件 | 32 张 NVIDIA H20 80GB |
训练证据由 GLM-4.1V-9B-Thinking 生成,并经过自动过滤,去除格式错误、重复过多或超过 8192 token 安全限制的样本。
论文还报告,在 batch size 为 4 的效率对比中,直接嵌入的端到端 batch 时间为 94.6 ms,EviAlign 为 1,502.5 ms,而先生成自由形式 CoT、再生成结构化证据并执行边界读取的版本为 9,825.3 ms。对应平均生成长度约为 114.3、702.1 个 token。该比较表明,EviAlign 虽然比直接嵌入计算昂贵,但比额外叠加长 CoT 的版本更高效。需要注意,这些是论文指定实验环境下的测量值,不能直接当作所有部署环境的延迟保证。
五、论文总结与评价
5.1 方法的主要创新
这篇论文最重要的贡献不是提出一种全新的对比损失,也不是简单地将多模态大模型接入向量检索,而是提出一种语义组织与表示读取位置协同设计的机制。
它把原本分开的两个设计问题联系起来:
-
生成模块决定模型需要组织哪些检索相关信息。
-
读取模块依据生成出的语义边界,决定从哪些隐藏状态构造表示。
通过对比学习,模型进一步学会让这些状态的聚合结果适合候选排序。
这种设计保留了单向量索引的优点,同时利用生成阶段的结构信息改善表示构造。
5.2 与现有方法的区别
| 方法类型 | 主要做法 | 与 EviAlign 的区别 |
|---|---|---|
| 直接多模态嵌入 | 从末尾 token 或指定隐藏状态提取向量 | 不一定显式组织检索证据 |
| CoT 增强嵌入 | 先生成推理文本,再读取向量 | 生成的语义单元与读取位置不一定对应 |
| 多读取状态 | 从多个位置提取状态并聚合 | 读取位置可能只按长度确定 |
| EviAlign | 生成五类语义证据,在每个语义边界读取状态并聚合 | 语义结构直接控制读取位置 |
5.3 方法的局限性
第一,推理成本较高。 与不生成证据的直接嵌入相比,EviAlign 需要额外生成结构化文本。这会增加查询侧的在线编码延迟。虽然候选向量可以离线预计算,但动态查询仍然需要执行生成过程。
第二,证据生成的质量会影响最终表示。 如果模型遗漏了关键关系、生成了错误属性,或者无法正确输出边界 token,读取机制也无法自动纠正这些错误。论文虽然报告了较高的边界格式有效率,但格式正确并不等于语义正确。
第三,五个语义角色并非对所有任务都最优。 实验中五单元结构优于一、三、七单元配置,但这只是论文评估的联合配置。其他领域是否应该增加时间、因果、空间或其他语义角色,仍然需要单独验证。
第四,域外泛化仍有提升空间。 EviAlign 的域外平均 Recall@1 为 67.7,低于 GME 的 71.8。虽然整体平均表现较强,但不能据此认为它在所有任务或领域都优于现有方法。
第五,实验中的性能提升需要与模型规模和训练预算分开分析。 论文的主结果表涉及不同主干模型和训练数据规模;其中关于边界读取机制的因果解释,主要依赖在相同主干模型和训练预算下的受控消融,而不是直接依赖跨模型排行榜。
5.4 对后续研究的启发
我认为这篇论文最值得借鉴的思想是:不要只优化生成了什么内容,还要考虑生成过程中的哪些状态应该用于下游任务。
这个思路可以延伸到其他任务:
-
在 RAG 中,可以尝试让模型分别生成实体证据、来源证据和关系证据,并在对应边界读取表示,验证能否提升检索与重排。
-
在多轮对话中,可以探索将用户目标、约束、历史状态和最终总结组织成不同单元,再比较语义边界读取与末尾读取的差异。
-
在多模态医学任务中,可以探索将病灶位置、形态、邻近结构和影像总结组织为不同证据单元,再研究这些状态是否有助于图文检索或病例匹配。
这些属于基于论文思想的研究方向,并不是论文已经验证的结果。尤其对于医学任务,必须额外验证证据的临床正确性、区域定位准确性和错误信息对最终表示的影响。
六、最终结论
这篇论文给出的核心答案是:高质量的生成证据不一定自动转化为高质量的检索向量;让证据的语义边界与隐藏状态读取位置对齐,可以进一步改善检索表示。论文在 12 个 MMEB 检索任务上报告了 76.9 的平均 Recall@1,并表明证据组织与边界读取之间存在可测量的协同效应。即将中间生成结构直接用于控制下游表示的构造,并通过受控实验验证两者之间的协同收益。