ESP32 唤醒成功,离线命令为什么没有执行?
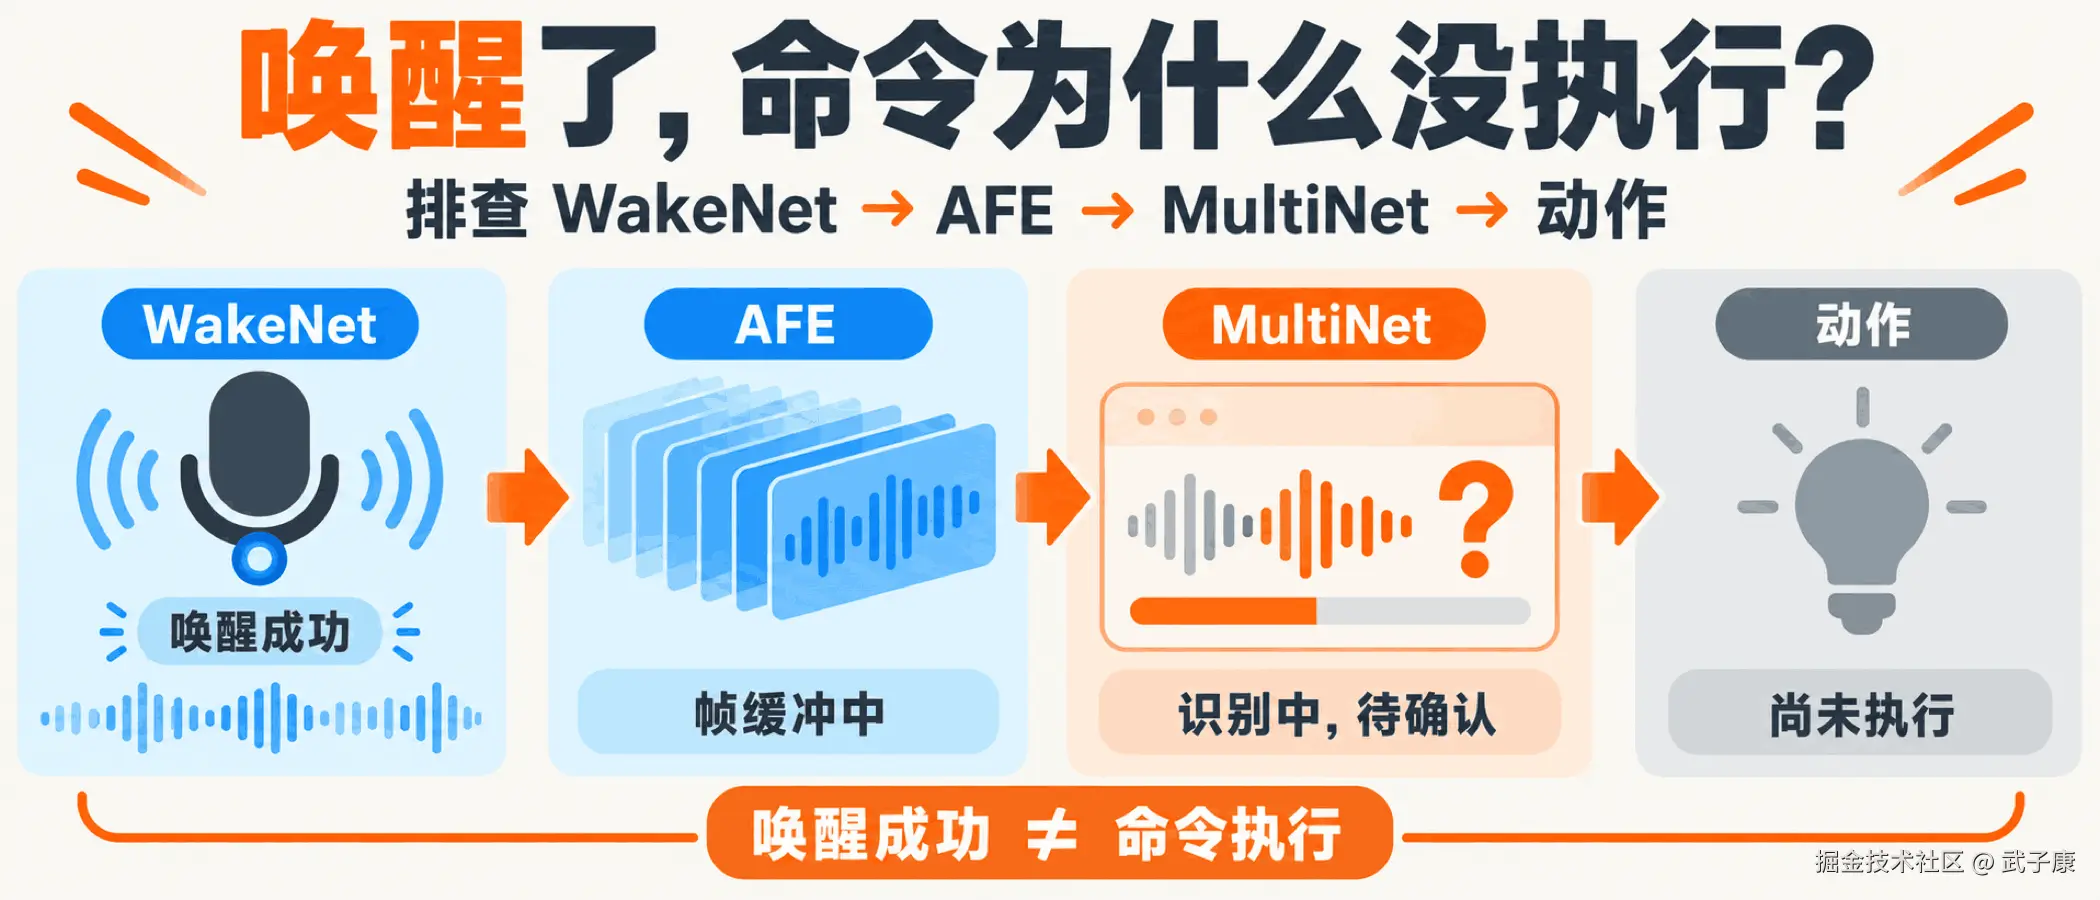
设备听到唤醒词、亮了灯,接着却没有执行"打开卧室灯"。把这次故障直接归为"离线识别不准",可能跳过了真正断开的交接。唤醒事件不等于命令 ID,更不等于设备动作 。本文针对 ESP-SR 的 WakeNet、AFE、MultiNet 组合路径,给出一份现场排障记录。开头的中文口令是设问;后文引用的 ESP-Skainet 英文示例没有演示中文命令。本文也没有实体板卡、识别率或时延实测。
唤醒发生,命令阶段启动了吗?
官方英文示例中,feed_Task 向 AFE 送音频,detect_Task 从 AFE fetch 取结果。唤醒发生后,示例会清理 MultiNet 状态;单通道路径在 WAKENET_DETECTED 后设置 wakeup_flag,多通道路径则等 WAKENET_CHANNEL_VERIFIED。只有标志生效后,才把 res->data 送给 multinet->detect。这说明只记录"唤醒成功"还不够:还要证明命令检测循环真的开始。
现场先记录本次 wakeup_state、通道数、命令阶段标志、第一帧送入 detect 的时刻。唤醒到了但标志没打开,检查状态分支和多通道确认;标志打开却没有 detect 调用,检查任务调度、AFE fetch 返回和数据队列。不要先改识别词条。
灯亮了,只是应用选择展示了一个事件
用户看到亮灯,通常会理解成设备已经准备听命令;代码里的亮灯却可能绑定在最早的唤醒事件上,而命令阶段要等后续条件成立。这个时间差就是排障需要拆出的第一处边界。可以给同一轮记录三个时刻:检测到唤醒、命令窗口实际打开、首个有效音频帧交给 MultiNet。如果 UI 提示出现在窗口之前,用户立即说出的命令可能落在业务尚未接收的区间。这里是应用设计假设,不是对官方示例时延的测量。
初始化记录固定通道配置与模型版本,再核对当前分支所等的事件:单通道触发条件不能误套多通道,当前配置不会产生的确认事件也不能一直等待。后面的构造序列会展示同一次唤醒在通道确认前后的不同结果。
再检查命令窗口如何关闭。用户取消、音频错误、识别超时和执行完成,都可能使应用退出当前阶段;退出之后是否重新允许唤醒,必须按业务设计明确。如果上一轮关闭窗口后标志没有恢复,下一次亮灯可能来自另一个路径,而 MultiNet 始终没有拿到帧。连续两轮短命令可以暴露这种状态交接,单次开机成功却覆盖不到。这里建议的是状态记录与复测,不要求另建复杂调度系统。
还有一种假设是检测任务被网络、日志或设备动作同步调用占住。唤醒标志已经打开,输入帧却迟迟未消费。应记录任务实际取得帧的进度,而不是只记录标志赋值。若发现阻塞,就先定位占用时间和队列积压,再考虑分离长操作。任务优先级的变化可能影响调度,但不能替代对命令窗口和音频连续性的证明。
AFE 有声音,MultiNet 收到合规帧了吗?
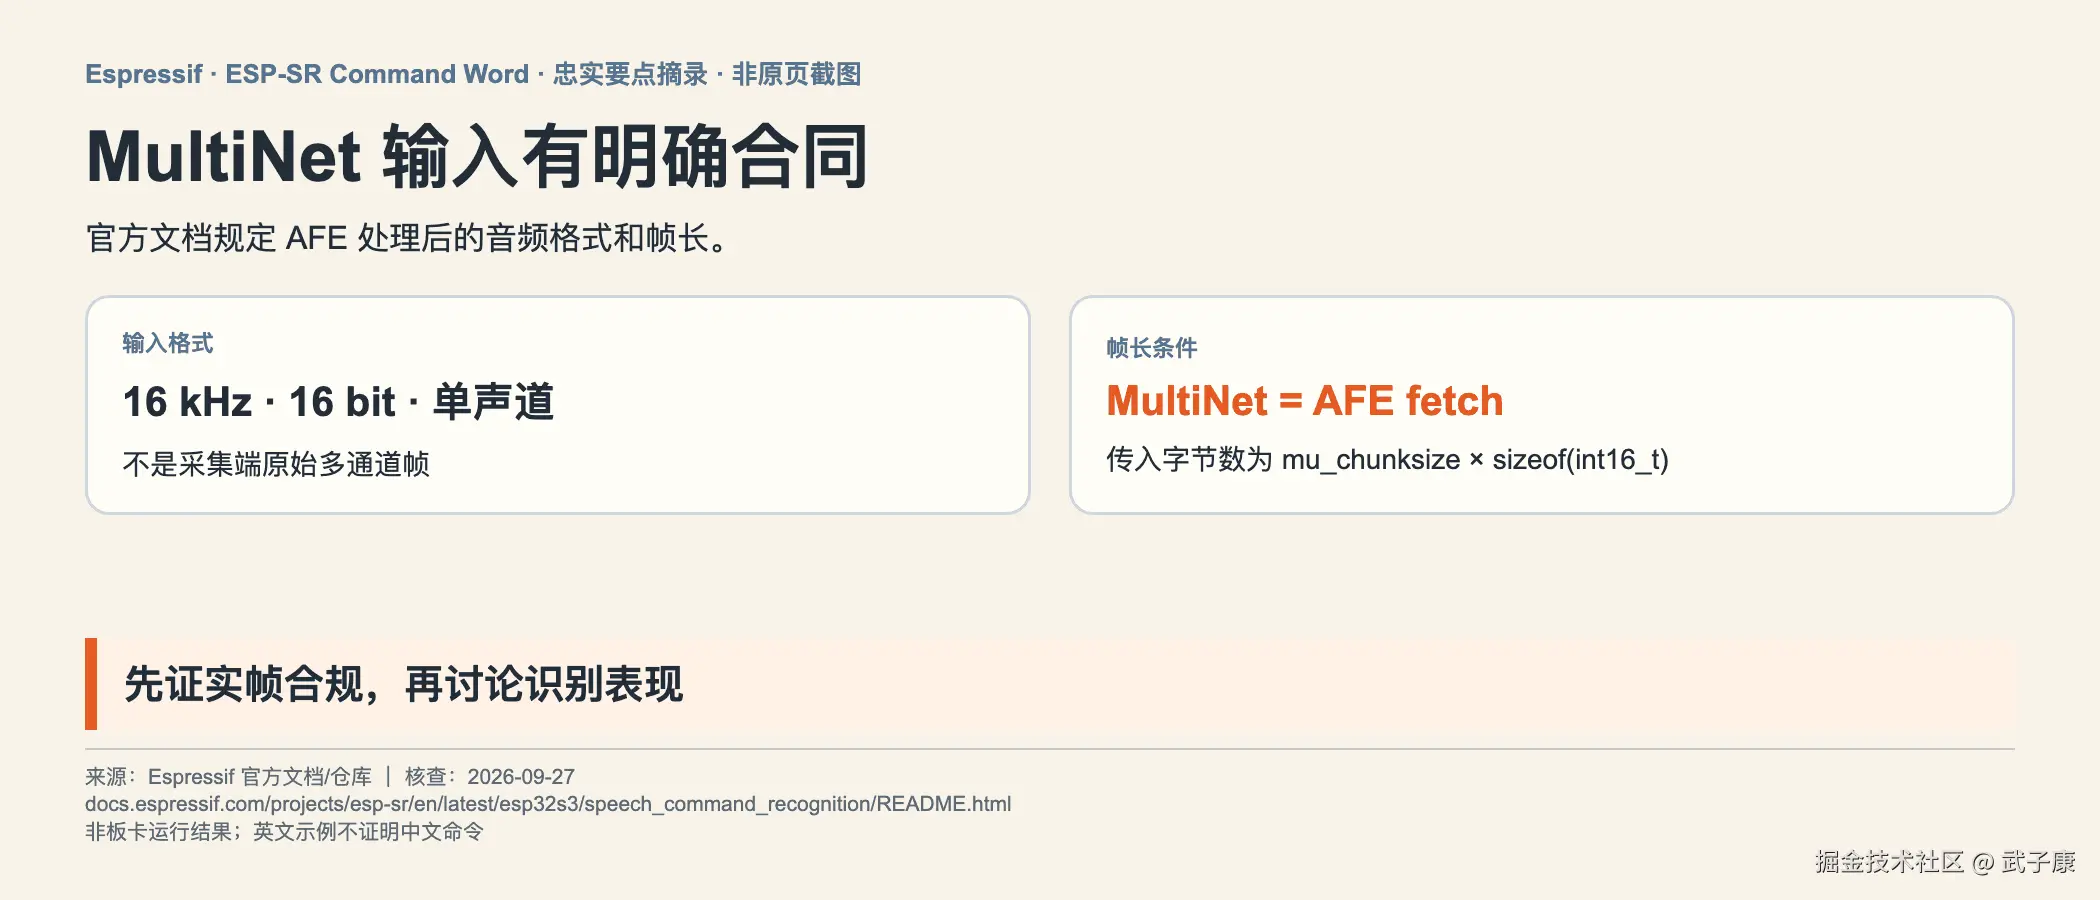
乐鑫 MultiNet 文档规定:输入是 AFE 处理后的 16 kHz、16 bit、单声道 音频;MultiNet 帧长必须等于 AFE fetch 帧长,传入字节数对应 mu_chunksize * sizeof(int16_t)。官方示例也断言 get_samp_chunksize 与 get_fetch_chunksize 相等,并把 res->data 交给 detect。
因此"麦克风有波形"不是足够的证据。记录两端 chunksize、样本格式、实际缓冲区、fetch 错误码和对应帧序号;不要把采集端的多通道原始交织数据当成 AFE 的单声道 fetch 结果。帧长不符或传错缓冲区时,先修交接,再比较识别表现。
合规的含义,是实际指针和实际范围一致
初始化时 chunksize 相同,是必要检查;运行时真正传进 detect 的内容仍要核对。应用可能在多个缓冲之间切换,把采集缓冲、处理后缓冲或上一帧缓冲传错。记录生产者、消费者和采样范围,比打印一个指针地址更有解释力。地址只能说明当时用了哪块内存,不能证明该块内存仍属于当前音频,也不能证明它包含正确通道。
长度检查也需要区分样本数与字节数。若接口要求固定个数的 int16_t 样本,业务复制和发送范围应围绕同一个约定计算;不能一个地方按样本数分配,另一个地方按字节数写入。本文沿用官方文档已经说明的输入合同,不凭 size 或 chunk 名称推断其他接口的单位。跨版本接入时,查当前头文件与示例的实际调用,避免把旧版本经验带进新构建。
交接记录需要帧序号;断裂时查队列丢弃,重复时查重试或缓存复用。本地例子会将重复与断裂留作失败输入,即使存在命令 ID,也不把它们当作连续交接的证明。
保存可重放输入,才有条件比较识别修改
原始麦克风音频用于诊断采集与前端,真正交给 MultiNet 的处理后音频用于诊断命令识别。两者都可以保留,但必须标明来源,不能用原始音频回放结果替处理后链路结论背书。假设现场口令失败,而同一段处理后输入离线复放成功,那么下一步应查现场输入的时序和应用状态;若复放仍失败,则可以进一步检查模型、语言与活动词表。
重放时还要固定帧组织方式与检测窗口。一个完整文件如果一次性送入,与现场分帧连续送入不是相同交接。应按当前接口要求划分帧,并保留从进入命令阶段到结束的状态序列。本文没有运行这个重放实验,因而只把它作为区分问题层级的方法,不报告任何复放准确率或处理速度。
识别在运行,词表和状态也要核对
MultiNet 支持运行时增删改命令,但文档明确:调用 esp_mn_commands_update() 后,修改才会生效;缓存命令与活动命令是两份需要区分的视图。打印当前活动词表、命令 ID、模型和语言,再用该模型支持的口令测试。官方文档还提醒命令词不支持中英文混写,也不能含阿拉伯数字或特殊字符。只看到配置文件写了某个词,不能断言运行模型已经启用它。
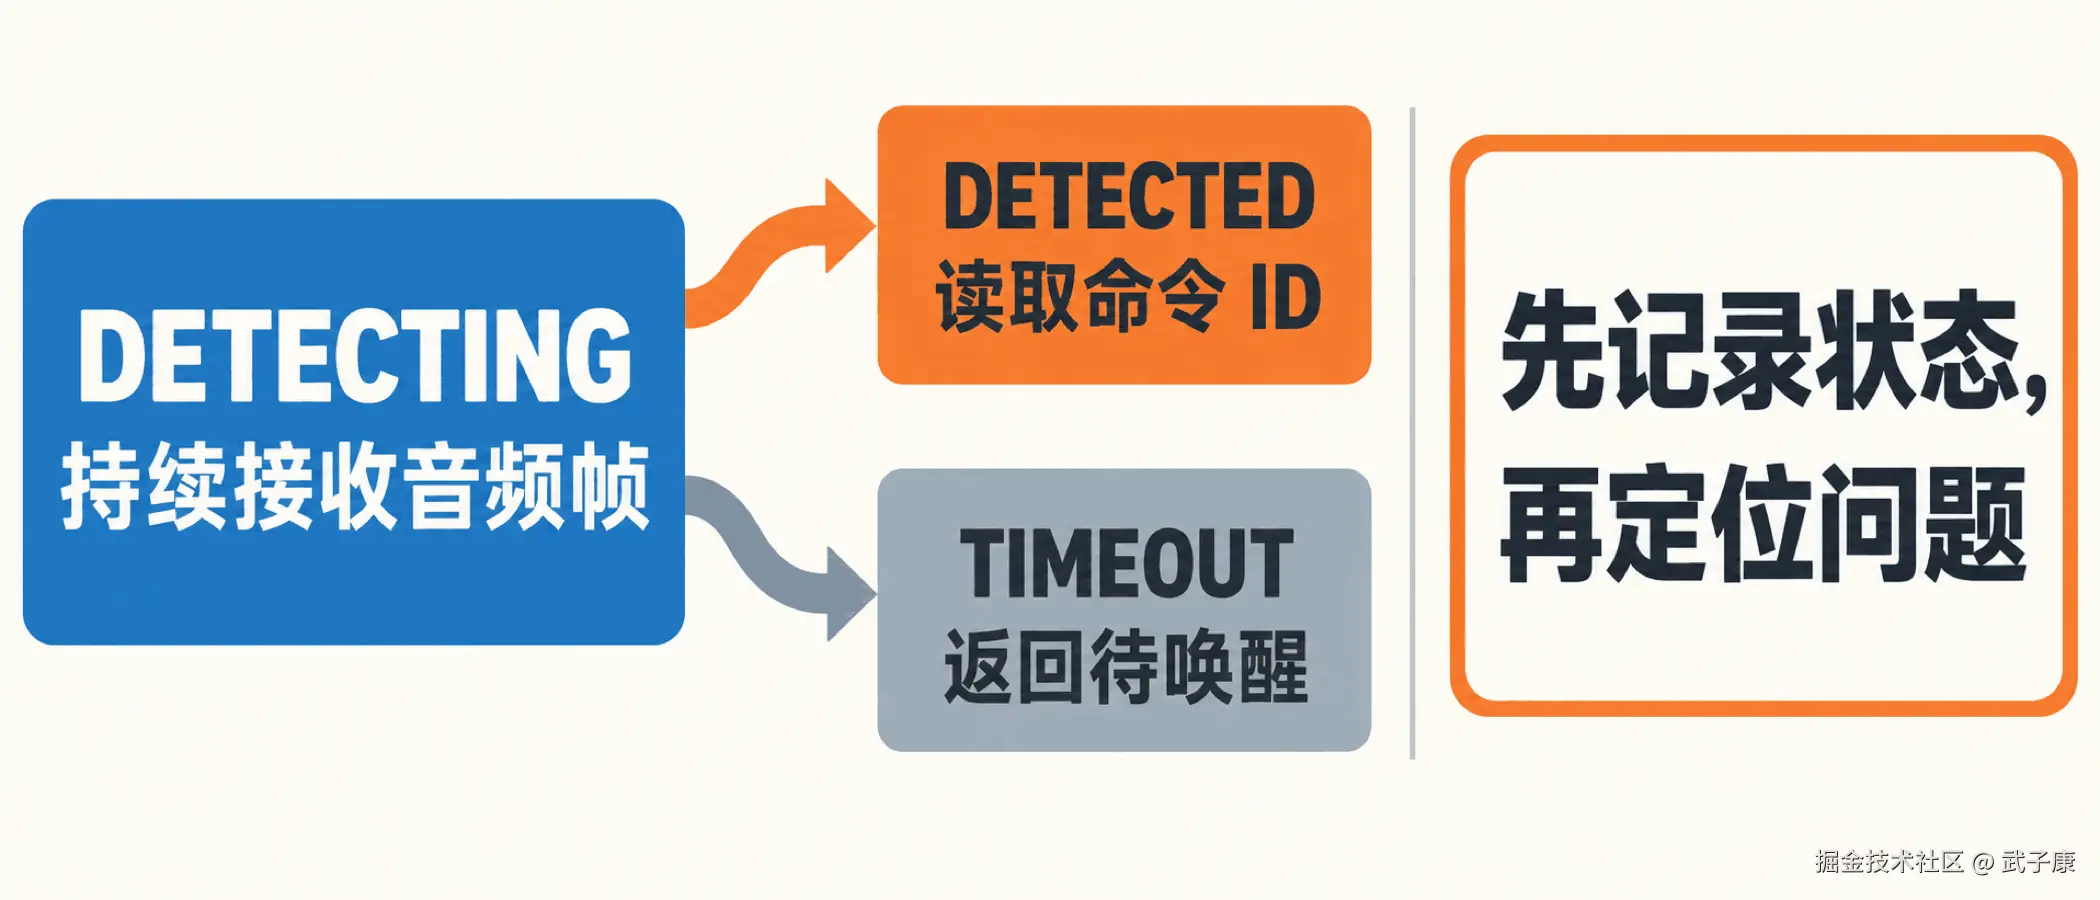
检测循环至少记录三种状态。DETECTING 表示尚未命中;DETECTED 时读取 get_results 的 command_id、phrase_id 与概率,并核对 ID 是否在活动词表中;TIMEOUT 表示命令窗口里未识别到目标词,示例重新启用 WakeNet。超时不等于已经识别但设备没动作。单次和连续识别模式的退出条件可能不同,复测前要锁定实际配置。
配置中的命令,和模型正在用的命令分开看
一个常见假设是界面已显示新增词条,但运行模型仍使用更新前的词表。界面来自业务缓存,检测来自活动词表,两者各自正确也可能彼此不一致。记录更新调用的结果,并输出当前活动条目,才能证明配置改动已经跨过生效边界。测试人员只拿配置文件截图,无法证明运行设备已加载那份配置。
命令 ID 与口令也需要作为一组绑定。假设两条短语都映射到"开灯",识别返回的 phrase_id 可以帮助解释听到哪条短语,而应用动作应按其既定 ID 映射处理。若代码错误地把短语序号当作业务命令 ID,识别可能成功但动作错位。这里不是说官方接口会返回错误 ID,而是提醒应用不能因为两个字段都是整数就混用它们。
语言约束应在声学实验之前检查。中文设问需要实际中文模型和合法词条支撑;官方英文示例只能证明英文示例中的交接流程。不能把它打印出 command_id 的截图贴到中文产品验收里,宣称中文口令已验证。对含数字、品牌名或中英文混写的业务表达,也要先确认当前模型与配置允许的表示,再讨论用户说法如何映射;本文不为不支持的词形设计猜测性的替代规则。
状态序列比一条最终日志更能解释失败
持续 DETECTING 与最终 TIMEOUT 都不是根因标签:它们需要与输入帧、活动词表和窗口时刻一起解释。声音质量差、词表不匹配可能走同一结果;没有帧时,应用等待超时甚至不能冒充模型已返回 TIMEOUT。
遇到 DETECTED 时,先保存返回结果,再交给业务执行。执行耗时较长的产品应明确识别阶段此刻是否退出,是否仍消费后续帧,以及重复命中如何处理。这些属于应用控制选择,不能由"模型有连续识别能力"自动推出业务应该无限连续执行。若命令阶段已关闭,后续结果也要按轮次确认归属,避免旧轮次结果触发新轮次的动作。
概率值可用于理解本次模型输出,但不能直接变成跨模型通用的质量分数。本文没有当前模型的概率校准实验,不设置一个看起来精确的通用门槛。先确认结果属于正确活动词条,再结合失败样本设计同条件对照;否则提高门槛可能只是隐藏输入或映射错误,降低门槛则可能把更多不相关结果交给动作层。
官方示例的关键分支能证明什么?
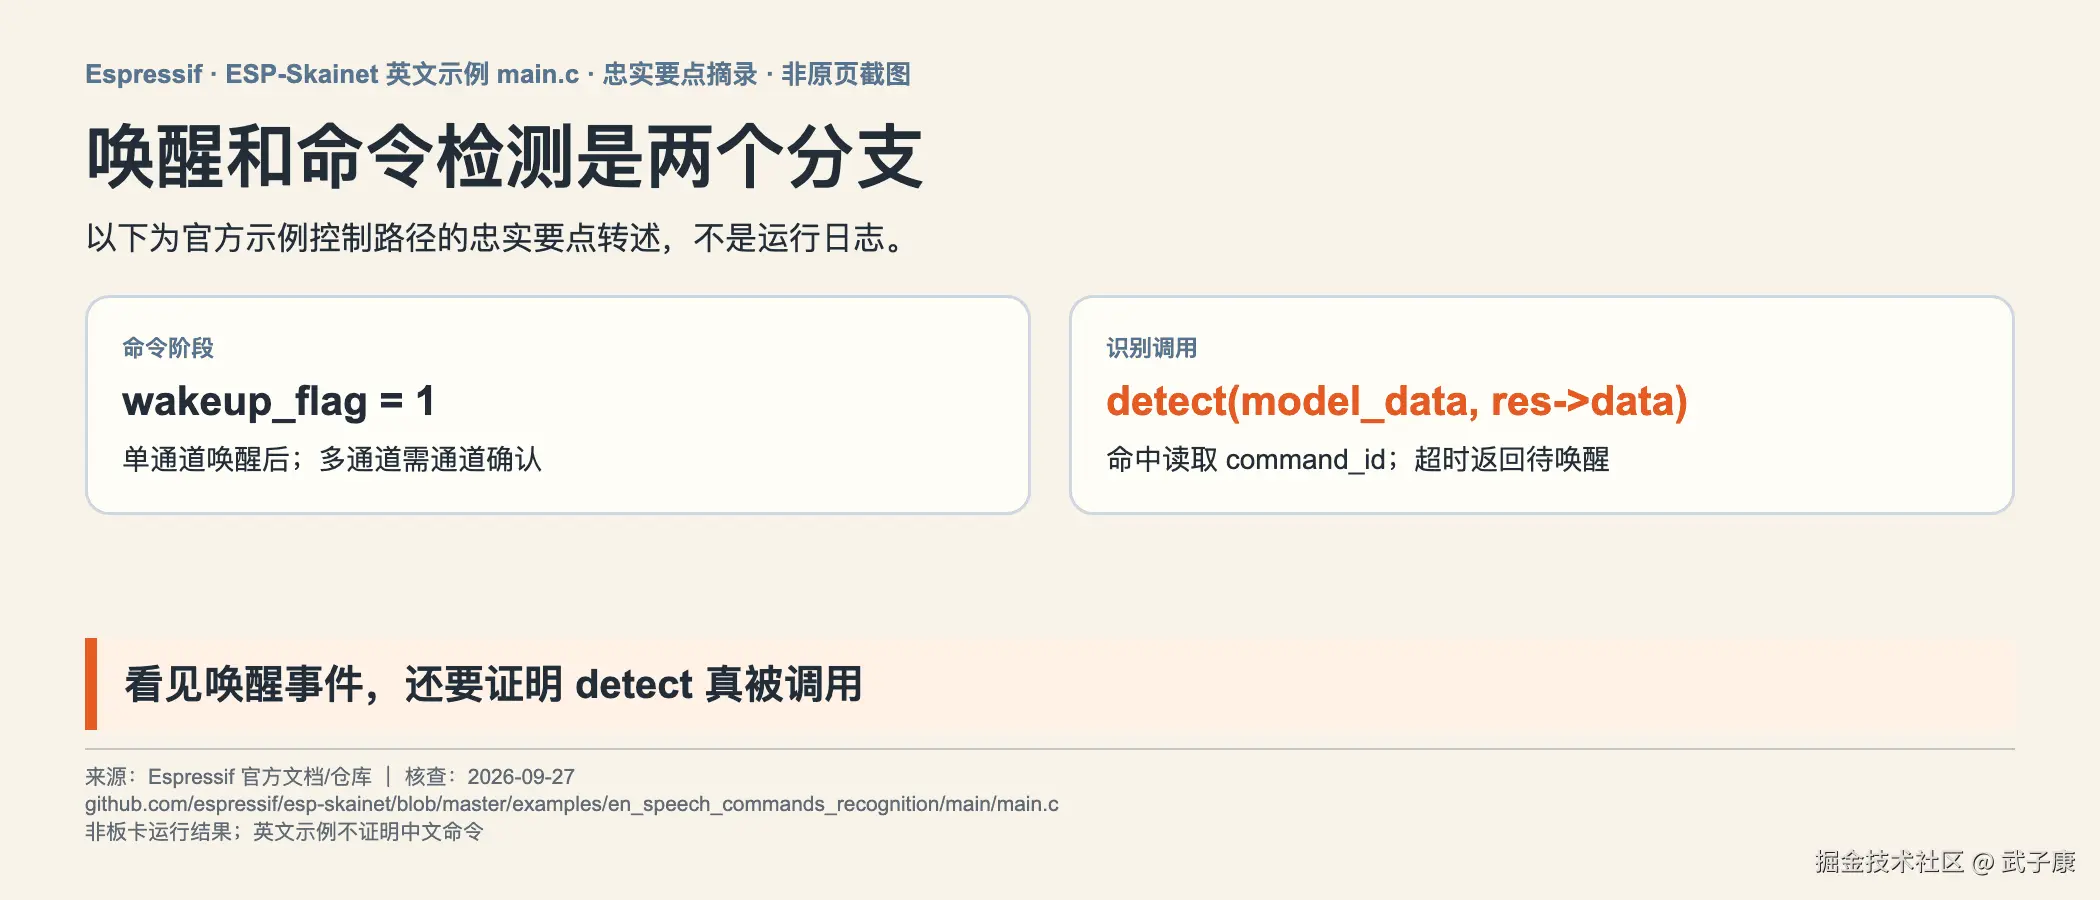
本轮于 2026-10-13 将 ESP-Skainet 英文示例固定到提交 97885d425d95。该版本仍在通道条件之后开放 detect,命中时打印 command_id/phrase_id,超时时重新启用 WakeNet 并清除 wakeup_flag。固定提交使本文的源码判断可回看,不能据此认定目标板卡已运行它。
还有一个版本细节:当前 MultiNet 文档的结果结构示意列出 phrase_id/prob,而本轮核对的英文源码还访问 command_id/string。读者应以自己依赖的头文件和实际 API 为准,不能从文档摘录直接拼一份跨版本结构体;本文对 command_id 的源码描述限定在上述提交。
若已有 DETECTED 和有效 command_id、设备仍没动作,问题已越过 MultiNet:检查 ID 到动作的映射、发送结果、设备执行回执与最终状态。命令 ID 只是识别输出,不是继电器或灯具完成动作的证明。
用最小输入序列检查交接,而不是重写识别库
将下面代码保存为 handoff_checks.py,以 Python 3.10 或更新版本运行 python3 handoff_checks.py。它只检查作者定义的帧元数据与阶段序列,不导入 ESP-SR,不处理真实音频,也不识别任何口令。4 个样本、8 个字节以及唯一活动 ID 7 都是构造值;实际 chunksize 必须查询当前 AFE 和模型,不能把示例常量写进固件。
Frame 将序号、样本数、字节数、格式与来源分开,Window 检查命令窗口是否开放。多通道的 WAKENET_DETECTED 之后暂不消费命令帧,直到通道确认;新一轮清空上一轮帧计数。为避免旧确认误开窗口,这个作者例还要求本轮先出现唤醒;这是示例自身的约束,不能冒充官方 C 代码完整实现。
consume 的 state 参数是我们手工指定的 DETECTING、DETECTED 或 TIMEOUT,command_id 同样是构造结果。它们用于检查"如果收到这样的可信输出,应用该如何解释",不是由零音频跑模型得到。没有帧的开放窗口只显示 frames=0;仅有应用定时器超时不能伪造一个 MultiNet TIMEOUT。代码只在合法帧通过后消费提供的模型状态,避免不合规输入带着一个成功标签直接穿透。
python
"""Constructed handoff records; no ESP-SR, recognition or device control."""
from dataclasses import dataclass, replace


@dataclass(frozen=True)
class Frame:
    seq: int = 0
    samples: int = 4
    nbytes: int = 8
    rate: int = 16000
    bits: int = 16
    channels: int = 1
    source: str = "afe_fetch"
    fetch_ok: bool = True


class Window:
    def __init__(self, channels=1, afe_samples=4, mn_samples=4):
        if channels < 1 or afe_samples <= 0 or afe_samples != mn_samples:
            raise ValueError("invalid channels or unequal chunksize")
        self.channels, self.samples = channels, mn_samples
        self.open, self.wake_seen = False, False
        self.frames, self.last_seq = 0, None

    def wake(self, state):
        if state == "WAKENET_DETECTED":
            self.wake_seen = True
            self.open = self.channels == 1
            self.frames, self.last_seq = 0, None
        elif state == "WAKENET_CHANNEL_VERIFIED":
            self.open = self.wake_seen and self.channels > 1
        else:
            raise ValueError("unknown wake state")

    def consume(self, frame, state="DETECTING", command_id=None):
        # shortcut: trusted frame metadata and symbolic model output;
        # check real buffer lifetime, audio and versioned APIs at integration.
        if not frame.fetch_ok:
            return "fetch_error"
        if not self.open:
            return "window_closed"
        if (frame.rate, frame.bits, frame.channels, frame.source) != (16000, 16, 1, "afe_fetch"):
            return "invalid_format_or_source"
        if frame.samples != self.samples or frame.nbytes != self.samples * 2:
            return "invalid_frame_length"
        if self.last_seq is not None and frame.seq != self.last_seq + 1:
            return "frame_gap_or_duplicate"
        if state not in ("DETECTING", "DETECTED", "TIMEOUT"):
            raise ValueError("unknown model state")
        self.last_seq = frame.seq
        self.frames += 1
        if state == "TIMEOUT":
            self.open, self.wake_seen = False, False
            return "timeout_await_wake"
        if state == "DETECTED":
            return "recognized_command:7" if command_id == 7 else "unknown_command_id"
        return "detecting"


def main():
    frame = Frame()
    single, multi = Window(), Window(channels=2)
    single.wake("WAKENET_DETECTED")
    multi.wake("WAKENET_DETECTED")
    assert single.open and single.frames == 0
    checks = [("open_without_frames", "open=True, frames=0; not model TIMEOUT")]
    checks.append(("multi_before_verify", multi.consume(frame)))
    multi.wake("WAKENET_CHANNEL_VERIFIED")
    checks.append(("multi_after_verify", multi.consume(frame, "DETECTED", 7)))
    checks.append(("wrong_format", single.consume(replace(frame, channels=2))))
    checks.append(("wrong_source", single.consume(replace(frame, source="raw_i2s"))))
    checks.append(("short_buffer", single.consume(replace(frame, nbytes=4))))
    checks.append(("fetch_failure", single.consume(replace(frame, fetch_ok=False))))
    assert single.frames == 0
    checks.append(("valid_detecting", single.consume(frame)))
    checks.append(("duplicate_frame", single.consume(frame)))
    checks.append(("gap_frame", single.consume(replace(frame, seq=2))))
    assert single.frames == 1
    checks.append(("unknown_id", single.consume(replace(frame, seq=1), "DETECTED", 99)))
    checks.append(("timeout", single.consume(replace(frame, seq=2), "TIMEOUT")))
    checks.append(("late_frame", single.consume(replace(frame, seq=3), "DETECTED", 7)))
    single.wake("WAKENET_DETECTED")
    checks.append(("rewake", single.consume(frame, "DETECTED", 7)))
    try:
        Window(afe_samples=4, mn_samples=8)
    except ValueError:
        checks.append(("unequal_chunksize", "rejected"))
    else:
        raise AssertionError("unequal chunksize accepted")
    expected = ["open=True, frames=0; not model TIMEOUT", "window_closed",
                "recognized_command:7", "invalid_format_or_source",
                "invalid_format_or_source", "invalid_frame_length", "fetch_error",
                "detecting", "frame_gap_or_duplicate", "frame_gap_or_duplicate",
                "unknown_command_id", "timeout_await_wake", "window_closed",
                "recognized_command:7", "rejected"]
    if [value for _, value in checks] != expected:
        raise AssertionError(checks)
    for name, value in checks:
        print(f"CONSTRUCTED {name}: {value}")
    print(f"PASS {len(checks)} handoff checks; no recognition or device execution")


if __name__ == "__main__":
    main()
本次在 Python 3.11.6、macOS arm64 环境运行,退出码为 0;实际 stdout 如下。全部检查逐项比较预期结果,不一致会抛 AssertionError。CONSTRUCTED 表示本地构造输入,不是板卡日志。
text
CONSTRUCTED open_without_frames: open=True, frames=0; not model TIMEOUT
CONSTRUCTED multi_before_verify: window_closed
CONSTRUCTED multi_after_verify: recognized_command:7
CONSTRUCTED wrong_format: invalid_format_or_source
CONSTRUCTED wrong_source: invalid_format_or_source
CONSTRUCTED short_buffer: invalid_frame_length
CONSTRUCTED fetch_failure: fetch_error
CONSTRUCTED valid_detecting: detecting
CONSTRUCTED duplicate_frame: frame_gap_or_duplicate
CONSTRUCTED gap_frame: frame_gap_or_duplicate
CONSTRUCTED unknown_id: unknown_command_id
CONSTRUCTED timeout: timeout_await_wake
CONSTRUCTED late_frame: window_closed
CONSTRUCTED rewake: recognized_command:7
CONSTRUCTED unequal_chunksize: rejected
PASS 15 handoff checks; no recognition or device execution
第一对反例是 multi_before_verify 与 multi_after_verify:同样存在唤醒,前者命令窗口仍关闭,后者才接受帧及构造结果。open_without_frames 又把标志与消费分开:窗口开放但帧数仍为零,检查任务调度、fetch 与队列,不能直接进入识别质量结论。
wrong_format、wrong_source 和 short_buffer 分别挡住多通道帧、采集端 raw_i2s 标注与短缓冲;fetch_failure 保留取帧失败。它们均不增加已消费帧数。构造帧 samples=4、nbytes=8 用来验证样本与字节的对应关系,不能证明任意 8 字节都包含合规语音;源标签也必须在真实生产与消费位置记录,不能由调用者随意填成 afe_fetch。
valid_detecting 只说明这份合规元数据与未命中状态进入本例。duplicate_frame 与 gap_frame 被拒绝,说明每次提交应有可复查顺序。真实系统若允许丢帧,必须另定义断裂后的恢复方式;这里选择停止接收该反例,不替官方识别器声称丢帧必然失败。实际缓冲生命周期、指针复用和采样内容都仍需要现场检查。
unknown_id 不会映射成动作;timeout 关闭本轮,late_frame 即使携带 ID 7 也被挡在窗口外,rewake 则开启新一轮并重新计数。这组顺序核对的是结束与恢复的应用边界,不计算识别窗口时长,也不重现官方模型如何产生 TIMEOUT。recognized_command:7 的含义仍仅为"构造输出 ID 已通过本例活动 ID 校验",后续发送、执行和物理动作完全未发生。
实际设备上应把这类检查放在已有交接位置,复用原任务和日志即可。先锁定头文件、ESP-SR/模型版本、活动词表和 AFE 配置,再把真实帧序号及状态接到同一条时间线。输入已确认连续合法、词表也已生效后,才有条件比较模型或声音质量;这些元数据自检不能替代处理后音频留样。
下游失败路径仍要单独记录。识别 ID 被放入发送队列,只证明业务受理;设备离线、发送失败、执行拒绝或取消应按产品合同结束本轮并恢复可唤醒状态。若只实现成功路径,动作错误可能让下一轮不再消费帧。设备回执与最终状态缺失时,反馈停在"请求已发送"或"设备报告执行成功",不能借 recognized_command 跨过它们。
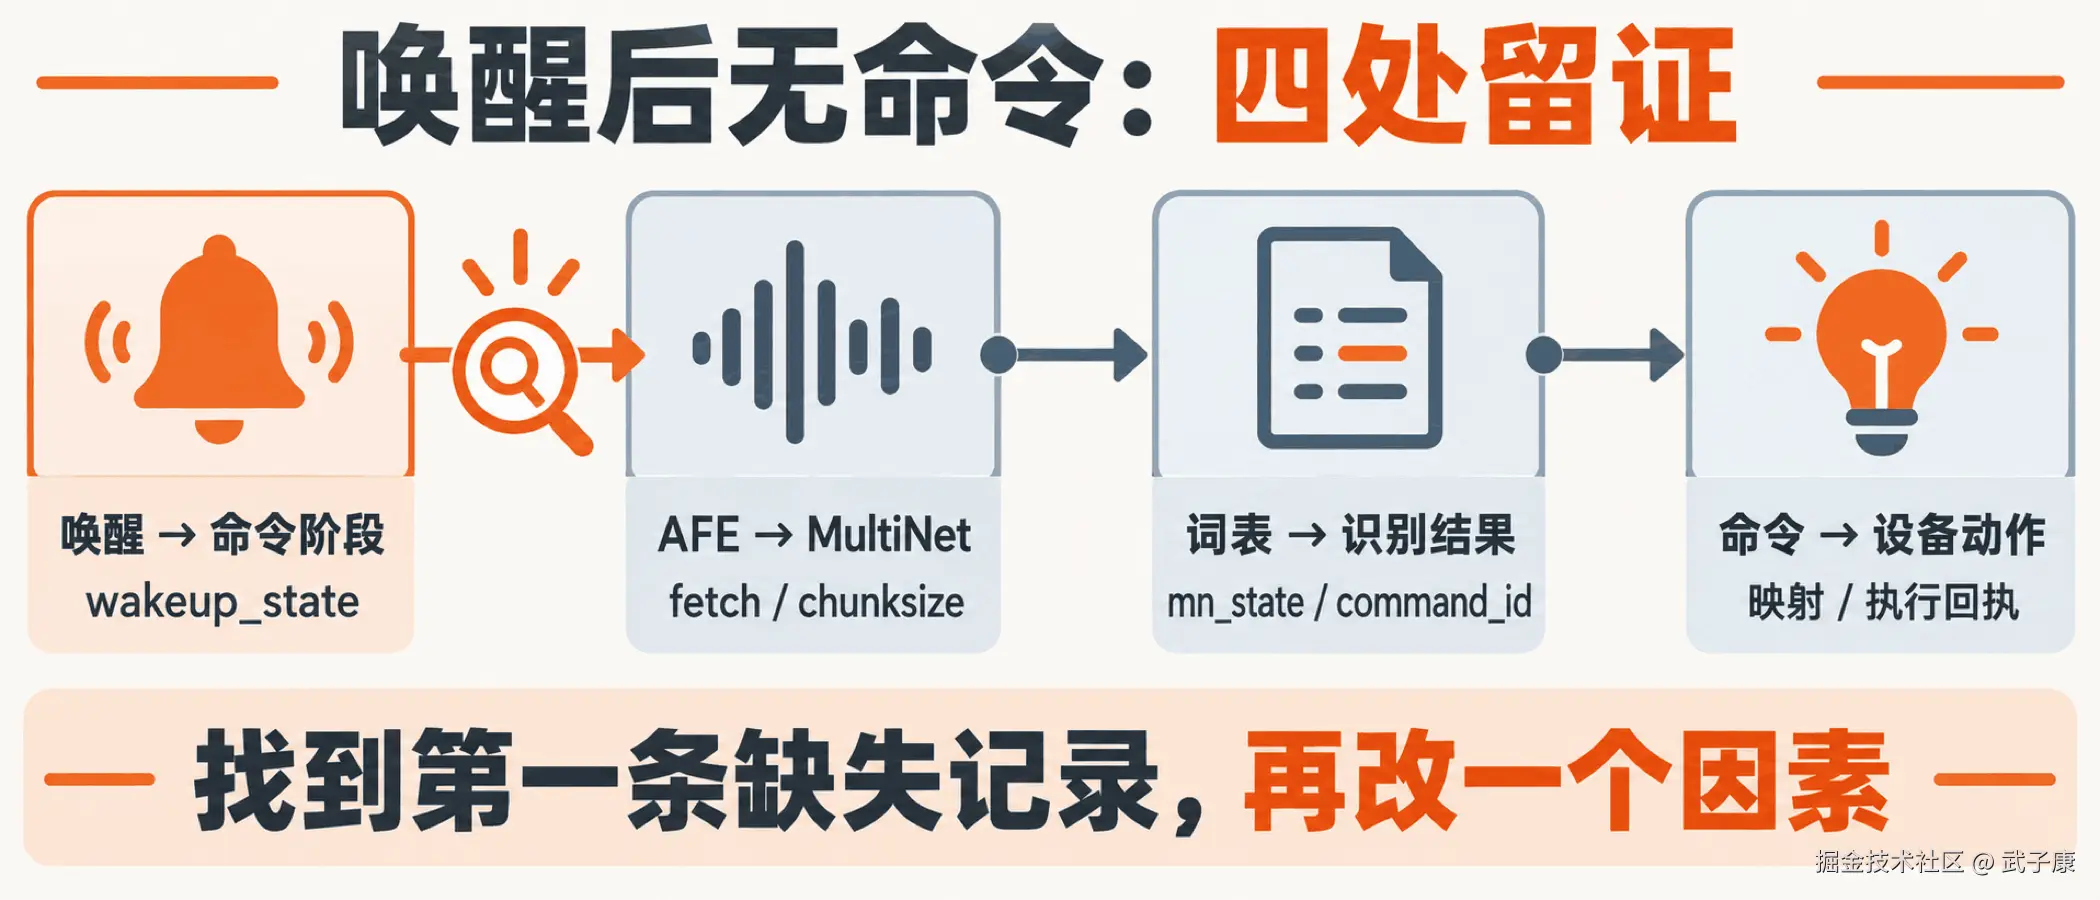
留下四条记录,再只改一个因素
| 边界 | 本次最小记录 | 缺失时先查 |
|---|---|---|
| 唤醒 → 命令阶段 | wakeup_state、通道确认、阶段开始时刻 |
状态分支与开关 |
| AFE → MultiNet | fetch 返回、两端 chunksize、缓冲区格式 |
帧长和输入交接 |
| 词表 → 识别结果 | 活动词表、模型语言、mn_state、command_id |
更新是否生效、命令窗口 |
| 命令 → 设备动作 | ID 映射、发送结果、执行回执 | 应用与设备链路 |
四条记录分别覆盖入口、帧、结果和动作;先定位证据缺口,再只改一个因素重跑原失败输入。个人语音留样仅展示脱敏摘要。本轮源码已固定、15 项本地交接检查已运行;真实板卡部分仍是待执行排障设计,没有运行 ESP32-S3,也没有修复实设备故障的证据。
按第一条缺失证据选择最小实验
将现场失败与本例结果对齐:window_closed 查入口,fetch_error 与帧错误查交接,unknown_command_id 查词表与映射。全部结构证据齐全却仍未命中时,再用处理后音频与合法词条设计识别对照;不要把本例输出当作真实根因判定。
复测可以包括四种交互:唤醒后立即说、稍停后说、没有说命令直至超时、取消后重新唤醒。它们分别覆盖录音交接、正常窗口、超时退出和恢复。每种交互保留同一套四边界记录,失败时即可定位哪个阶段没有发生。若某种场景尚未执行,就在交付里标未覆盖,不因另外三种成功而推断它也成功。
交接结论写最后一个已证实边界,例如"AFE 已输出连续合规帧,活动词表未确认";修复后回归原失败输入,并检查取消、超时与动作分支没有退化。中文命令、识别率、目标板性能和动作成功仍各自需要项目证据。
对于稳定复现但无法留完整音频的现场,也应保留每个边界的顺序、帧数与错误状态,并明确证据不足以判断声学质量。结构化摘要能帮助排除未进入检测的路径,却不能代替判断输入是否清楚的声音。若客户现场和实验室结果相反,先比较实际固件、模型和活动词表,不能仅因硬件型号相同就认为实现完全相同。输入条件与运行配置一致之后,才值得进一步讨论环境影响。