10 月 13 日,谷歌把 Gemini 4 Argon 端了上来------Gemini API、AI Studio、Gemini App 全量 GA。这是谷歌被催了半年多才端出来的新旗舰[6](#6 "#ref-week")。同一周,Claude Haiku 5.5 发布即降价到上一代十分之一,Anthropic 在旧金山开 pre-IPO 投资者日,传闻估值 1.8--2 万亿美元[7](#7 "#ref-recap")[8](#8 "#ref-ipo")。
但刷完各家报道,我发现大家都把注意力放在"重回第一梯队""性价比斩杀"这些词上,真正重要的那条规格反而被一笔带过了:
单次输出上限从 64K token 拉到 100 万 token ------不是上下文,是输出 。模型可以在一次任务里不间断地思考、生成、修正,中途不用把控制权交还给人类[4](#4 "#ref-jrj")。
这个数字本身就是谷歌这 7 个月的答案:大模型的战场正在从"比谁更聪明"转向"比谁能一口气把活干完" 。这篇文章不聊虚的,我把 Argon 官方文档和模型卡翻了个底朝天,讲清楚三件事:100 万输出在工程上是怎么实现的(续写协议)、13/18 项跑分第一到底赢在哪输在哪、以及它的定价为什么敢比 Opus 5.5 便宜三分之二。
速览(6 条硬事实)
- 定位 :Gemini 4 Argon 是全新旗舰,不是旧模型的微调版;大规模稀疏 MoE,原生多模态输入(文本/图像/音频/视频),文本输出[2](#2 "#ref-card")。
- 窗口 :输入 + 思考 + 输出共享一个 1,048,576 token 的统一窗口;单响应输出上限 64K → 100 万[1](#1 "#ref-doc")。
- 跑分 :官方模型卡 18 项对比里赢 13 项,Vals Index 68.9% 排 41 个模型第一;但 Artificial Analysis 综合智能指数 53 分,与 GPT-6 Astra 并列,只排第 6[2](#2 "#ref-card")[3](#3 "#ref-vals")[5](#5 "#ref-yicai")。
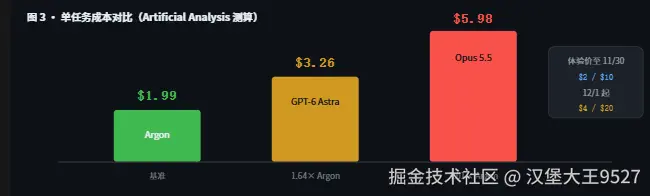
- 成本 :AA 测算单任务成本 1.99,GPT−6Astra是3.26,Opus 5.5 是 $5.98[4](#4 "#ref-jrj")。
- 定价 :11 月 30 日前体验价 2/10(每百万输入/输出 token),之后 4/20;隐式缓存命中再省 95%[1](#1 "#ref-doc")。
- 注意 :不支持免费层;
temperature/top_p/top_k被直接移除,推理深度改用thinking_level控制[1](#1 "#ref-doc")。
①为什么"100 万输出"比"100 万上下文"重要得多
先厘清一个很容易被混淆的点:100 万 token 的上下文窗口 不新鲜,Gemini 系列早就有。这次真正的新东西是输出侧 ------单个响应最长可以生成 100 万 token(减去你的输入)[1](#1 "#ref-doc")。
上一代的上限是 65,536。听起来已经不少了?够用聊天的场景确实够。但谷歌在文档里把动机写得很直白:
Gemini 4 Argon 可以针对复杂的数学、科学和编码问题进行更长时间的思考 。当模型有足够的空间在单次推演中生成数十万 token 时,推理深度就不再受输出预算的硬约束[1](#1 "#ref-doc")。
翻译成人话: reasoning 模型的"思考"是要花 token 的 。一个复杂任务的思维链(thinking tokens)可能轻松烧掉几万 token。在 64K 的硬顶下,思考越深入,留给最终答案的预算就越少------模型经常被迫"想一半就交卷"。金融界那篇报道说得形象:输出上限的意义不是"能写更长的小说",而是模型中途不用把控制权交还给人类 [4](#4 "#ref-jrj")。
这就是"比聪明"和"比干活"的分水岭。聊天场景比的是单轮回答质量;Agent 场景比的是一个任务从接手到交付,中间不中断、不丢状态、不需要人接管。后者吃的就是长解码能力。
统一输入+输出窗口 : (1,048,576 token)
输出上限提升倍数 : 65,536 → 1,048,576
每个续写 hop 的最大
token 数:64k
thinking_level:
low / medium / high
②工程拆解:100 万输出是怎么"续"出来的
100 万输出不是模型一口气吐出来的。谷歌的官方文档把机制写得很清楚,我拆成三层讲[1](#1 "#ref-doc")。
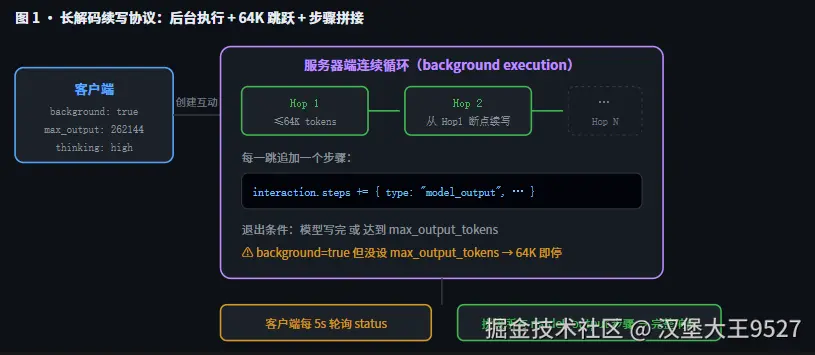
机制:64K 一跳的"续写协议"
要生成超过 64K 的输出,你需要两件事:开启后台执行(background: true),并把 max_output_tokens 设到 65,536 以上 。之后模型以每次最多 64K token 的"跳跃"(hop) 生成长响应,每一跳从上一跳停下的位置继续。服务器替你跑完这个连续循环,直到模型写完或撞上 token 上限[1](#1 "#ref-doc")。
每一跳都会往 interaction.steps 里追加一个 model_output 步骤。所以拿到最终结果的方式是:轮询互动状态直到完成,然后把所有 model_output 步骤的文本按顺序拼起来 [1](#1 "#ref-doc")。
官方给的 JS 示例(我保留了关键结构),一个"证明素数定理"的 26 万 token 级任务长这样:
javascript
import { GoogleGenAI } from "@google/genai";

const client = new GoogleGenAI({});

let interaction = await client.interactions.create({
  model: "gemini-4-argon",
  input: "Write a complete, rigorous proof of the prime number theorem.",
  background: true,
  generation_config: {
    max_output_tokens: 262144,
    thinking_level: "high",
  },
});

// 后台执行期间轮询状态
while (interaction.status === "in_progress" || interaction.status === "queued") {
  await new Promise((r) => setTimeout(r, 5000));
  interaction = await client.interactions.get(interaction.id);
}

// 每一跳都是一个 model_output 步骤,全部拼接才是完整答案
const text = interaction.steps
  .filter((s) => s.type === "model_output")
  .flatMap((s) => s.content ?? [])
  .filter((c) => c.type === "text")
  .map((c) => c.text)
  .join("");
有三个坑文档里专门标了,直接抄作业时注意:
- 开了
background: true但没设max_output_tokens,服务器会在 64K 处直接停 ------长解码不会自动开启[1](#1 "#ref-doc")。 max_output_tokens是思考 + 输出的合计硬顶 。思考级别越高,烧在思维链里的预算越多,限额要给足,否则答案被截断[1](#1 "#ref-doc")。- 硬任务可能要跑几分钟 :要么用后台执行,要么把 HTTP 客户端超时调到至少 15 分钟[1](#1 "#ref-doc")。
旋钮换代:temperature 没了,thinking_level 上位
一个容易被忽略的破坏性变更:Argon 会直接忽略 temperature、top_p、top_k ,迁移时要从请求里删掉[1](#1 "#ref-doc")。控制生成行为的旋钮换成了三档思考级别:
| 思考级别 | token 消耗 / 延迟 | 适用场景 |
|---|---|---|
low |
最少 token、最低延迟 | 简单任务、成本敏感型工作、轻度分析写作 |
medium(默认) |
均衡 | 大多数任务,包括复杂代码和 Agent 用例 |
high |
最多 token、首 token 最慢 | 复杂推理、数学科学、最难的代码/Agent 任务;长解码绝配 |
谷歌的建议很工程化:三个级别都跑一遍评估,选满足质量要求的最低档 [1](#1 "#ref-doc")。因为输出 token 是连思考一起计费的($10/百万),high 档随便一开,账单就是思维链的长度。
架构层面的信号
移除采样参数、用思考级别做唯一旋钮、思考 token 计入输出计费------这三件事合起来说明:谷歌已经把 Argon 彻底当"推理引擎"而非"文本生成器"在设计。你控制的不再是随机性,而是推理预算。
③跑分地图:13/18 赢在哪,5 项输在哪
DeepMind 官方模型卡给了 18 项对比,对手是 GPT-6 Astra、Claude Fable 5.1、Claude Opus 5.5[2](#2 "#ref-card")。我把全表搬过来,加粗的是该项第一:
| 类别 | 评测 | Argon | GPT-6 Astra | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|---|
| 知识工作 | Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% | |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% | |
| Harvey 法律 Agent | 19.6% | 5.4% | 6.7% | 3.8% | |
| Agentic 编码 | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% | |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% | |
| Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% | |
| ML 工程 | PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% |
| 科学与数学 | Terminal-Bench Science | 57.6% | 68.1% | 52.6% | 63.3% |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% | |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% | |
| 长上下文 | GraphWalks ≤128K | 99.7% | 98.7% | 91.4% | 90.6% |
| GraphWalks 256K--1M | 84.2% | 71.8% | 65.0% | 66.8% | |
| 计算机使用 | Agent's Last Exam | 39.5% | 34.2% | --- | 38.2% |
| OSWorld-2.0 | 69.2% | 72.6% | --- | --- | |
| 多模态理解 | Chartography | 71.6% | 71.0% | 46.2% | 66.3% |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% | |
| 网络安全 | CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
18 项里 Argon 拿 13 个第一。仔细看分布,赢的全是"干活"类 :知识工作 4 项横扫(其中 Harvey 法律 Agent 19.6% 对第二名 6.7%,接近 3 倍------虽然绝对值都不高,说明法律 Agent 本身还是早期)、长上下文两项(尤其 256K--1M 区间 84.2% 对 GPT-6 的 71.8%,长窗口衰减控制明显更好)、Agentic 编码里的 DeepSWE 和 Vibe Code Bench、多模态两项[2](#2 "#ref-card")。
输的 5 项也很诚实 :FrontierSWE v2 输 GPT-6 十个点(55.0 对 65.5)、Terminal-bench 4.0 输 Opus 5.5 九个点(57.4 对 66.4)、Terminal-Bench Science 输 GPT-6 十个点、OSWorld 计算机使用输 GPT-6、PostTrainBench 输 Opus[2](#2 "#ref-card")。注意一个规律:带 "Terminal" 字样的长程终端场景,Argon 全输了------命令行多步操作这个细分场景,Opus 5.5 依然是王。
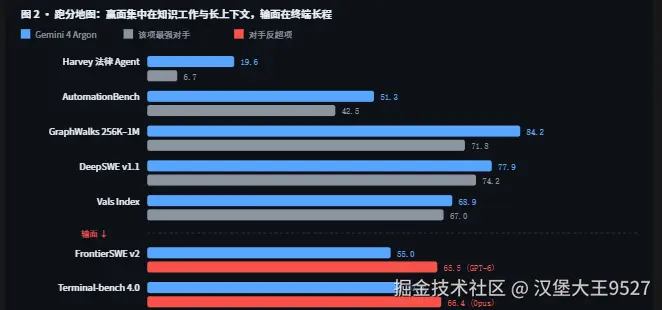
但这里必须泼一盆冷水:跑分第一不等于综合智能第一 。Artificial Analysis 的综合智能指数上,Argon 是 53 分,与 GPT-6 Astra、Claude Fable 5.1 并列,总榜只排第 6 [5](#5 "#ref-yicai")。怎么理解这个反差?模型卡那张表是谷歌挑的"干活向"评测组合,反映的是它在知识工作、长上下文、Agentic 编码上的场景优势 ;AA 指数是更宽口径的综合智能,大家还在同一梯队。谷歌赢在赛道选择,不是全面碾压。
④成本经济学:$1.99 一单是怎么算出来的
跑分之外,Argon 真正的杀手锏是成本。Artificial Analysis 测算:完成一个智能指数任务的平均成本,Argon 是 1.99,GPT−6Astra是3.26,Opus 5.5 是 $5.98 [4](#4 "#ref-jrj")。同档智能,价格分别是对手的 6 折和 3.3 折。
这个价格怎么来的?三个层面:
- 定价本身激进 :11 月 30 日前体验价 2/百万输入、10/百万输出;之后也才 4/20[1](#1 "#ref-doc")。对比 Opus 4.7 世代 $25/百万输出的价位,差了一个量级[4](#4 "#ref-jrj")。
- 隐式缓存 95% 折扣 :≥4,096 token 的提示默认开启隐式缓存,命中后缓存输入 token 只要 $0.10/百万[1](#1 "#ref-doc")。Agent 场景反复携带长系统提示和工具定义,缓存命中率天然高。
- 稀疏 MoE 架构 :模型卡确认 Argon 是大规模稀疏 MoE[2](#2 "#ref-card")------每次前向只激活部分参数,这是 2026 年所有"便宜又大碗"模型的共同底色。
但要提醒一句:体验价 11 月 30 日截止,之后翻倍到 4/20 [1](#1 "#ref-doc")。现在基于 $1.99 单任务成本做的架构决策,年底要重新算一遍账。另外 Argon 不进免费层,也不含在 Google AI Pro 里[1](#1 "#ref-doc")------谷歌把它明确定位成"干活的生产力工具",不是拉新玩具。
⑤迁移清单:8 条官方 checklist 里的实战要点
如果你现有应用跑在旧 Gemini 上,官方迁移清单有 8 条[1](#1 "#ref-doc"),我按"容易踩坑程度"重新排序并加注:
- 改模型 ID :
gemini-4-argon。 - 删采样参数 :
temperature/top_p/top_k传了也会被忽略------旧代码里如果靠 temperature 控制风格,行为会变,要回归测试。 - 停用显式上下文缓存 :Argon 不支持
cachedContents/caches.create,相关调用全部移除;隐式缓存(≥4,096 token 默认开)命中享 95% 折扣。 - 抬高
max_output_tokens:旧应用如果显式设过 32K 以下的限额,至少提到 32,768------Argon 会把更多预算用于思考,限额太低直接截断。 - 配 thinking_level:三档都测,选满足质量要求的最低档(成本直接挂钩)。
- 超 64K 输出走后台执行 :
background: true+max_output_tokens > 65,536。 - 客户端超时拉到 15 分钟以上:硬任务要跑几分钟,别用默认值。
- 多轮对话用
previous_interaction_id在服务器端保留状态,别再每次全量重传历史。
知识截止与稳定性提醒
模型卡写明:知识截止 2026 年 3 月;仍可能幻觉,"偶尔会有响应缓慢或超时"[2](#2 "#ref-card")。长解码任务跑几分钟是常态,生产环境务必配好重试和超时兜底。
⑥判断:从"比聪明"到"比干活",选型逻辑怎么变
把这周的几件事串起来看------Gemini 4 Argon 押注长解码和知识工作、Claude Haiku 5.5 发布即降价 10 倍、Anthropic 以近 2 万亿估值冲刺 IPO[7](#7 "#ref-recap")[8](#8 "#ref-ipo")------头部厂商的动作指向同一个判断:综合智能的军备竞赛进入平台期,"能干完活"和"干活便宜"成了新的差异化战场。
对开发者的选型含义,我给三条:
第一,按"任务时长"分层选型。 单轮问答、短交互------各家旗舰智能并列(AA 指数 53 分大家打平[5](#5 "#ref-yicai")),选便宜的;几十分钟级的长程知识工作(法律分析、金融研究、大型重构)------Argon 的长解码 + 长上下文衰减控制(GraphWalks 1M 区间 84.2% 对 71.8%[2](#2 "#ref-card"))目前是独一档;终端命令行密集的场景------Opus 5.5 依然最稳(Terminal-bench 66.4%[2](#2 "#ref-card"))。 "一个模型打天下"的时代结束了。
第二,把"思考预算"纳入成本模型。 思考 token 计入输出计费,thinking_level: high 加长解码,一个任务烧几十万输出 token 是常态。体验价 10/百万下是几美元一单,12月1日翻倍后要重算。选型时别只看单价,∗∗用真实任务测"单任务成本"才是有效指标∗∗------AA的1.99 就是这么算出来的[4](#4 "#ref-jrj")。
第三,关注"服务器端状态"这个新范式。 后台执行、interaction.steps、previous_interaction_id------谷歌这套 API 设计把越来越多状态挪到了服务器端。对开发者是省事(不用自己管续写循环和对话历史),但也意味着更深的平台绑定。这套互动模型一旦深度采用,迁回别家的成本会变高。架构决策时这是个真实的权衡。
一句话总结
Gemini 4 Argon 不是在"更聪明"上赢------AA 指数上它和对手并列。它赢在把"输出长度"这个被忽视的维度拉开了 15 倍,并用 1/3 的价格把战场引向"谁能一口气把活干完"。如果你的场景是长程知识工作,值得立刻测;如果是终端密集或短交互,手里的牌不用换。
💬留三个问题给你
- 100 万输出的真实利用率会有多高? 思维链烧 token 没有上限,"想得更久"和"想得更好"之间的边际收益在哪拐点?你有测过思考级别对最终质量的真实影响吗?
- Harvey 法律 Agent 上 19.6% 对 6.7% 的 3 倍差距,是能力断层还是评测口味? 绝对值都不到 20%,法律 Agent 这个赛道是不是根本没到可用线?
- 服务器端状态(后台执行 + previous_interaction_id)带来的平台绑定,你愿意用多少迁移成本换开发便利?