尝试理解公网
真实的互联网公网结构十分复杂。公网 IP 由 ICANN 负责分配管理,IP 地址会在全球按照亚太、北美、欧洲等大区进行规划划分;同时各个国家内部,又由多家 ISP(互联网服务提供商,运营商)负责落地运营。整体网络拓扑庞大且错综复杂。 我们接下来简化整个传输流程,只需要从宏观层面理解公网的核心原理即可。
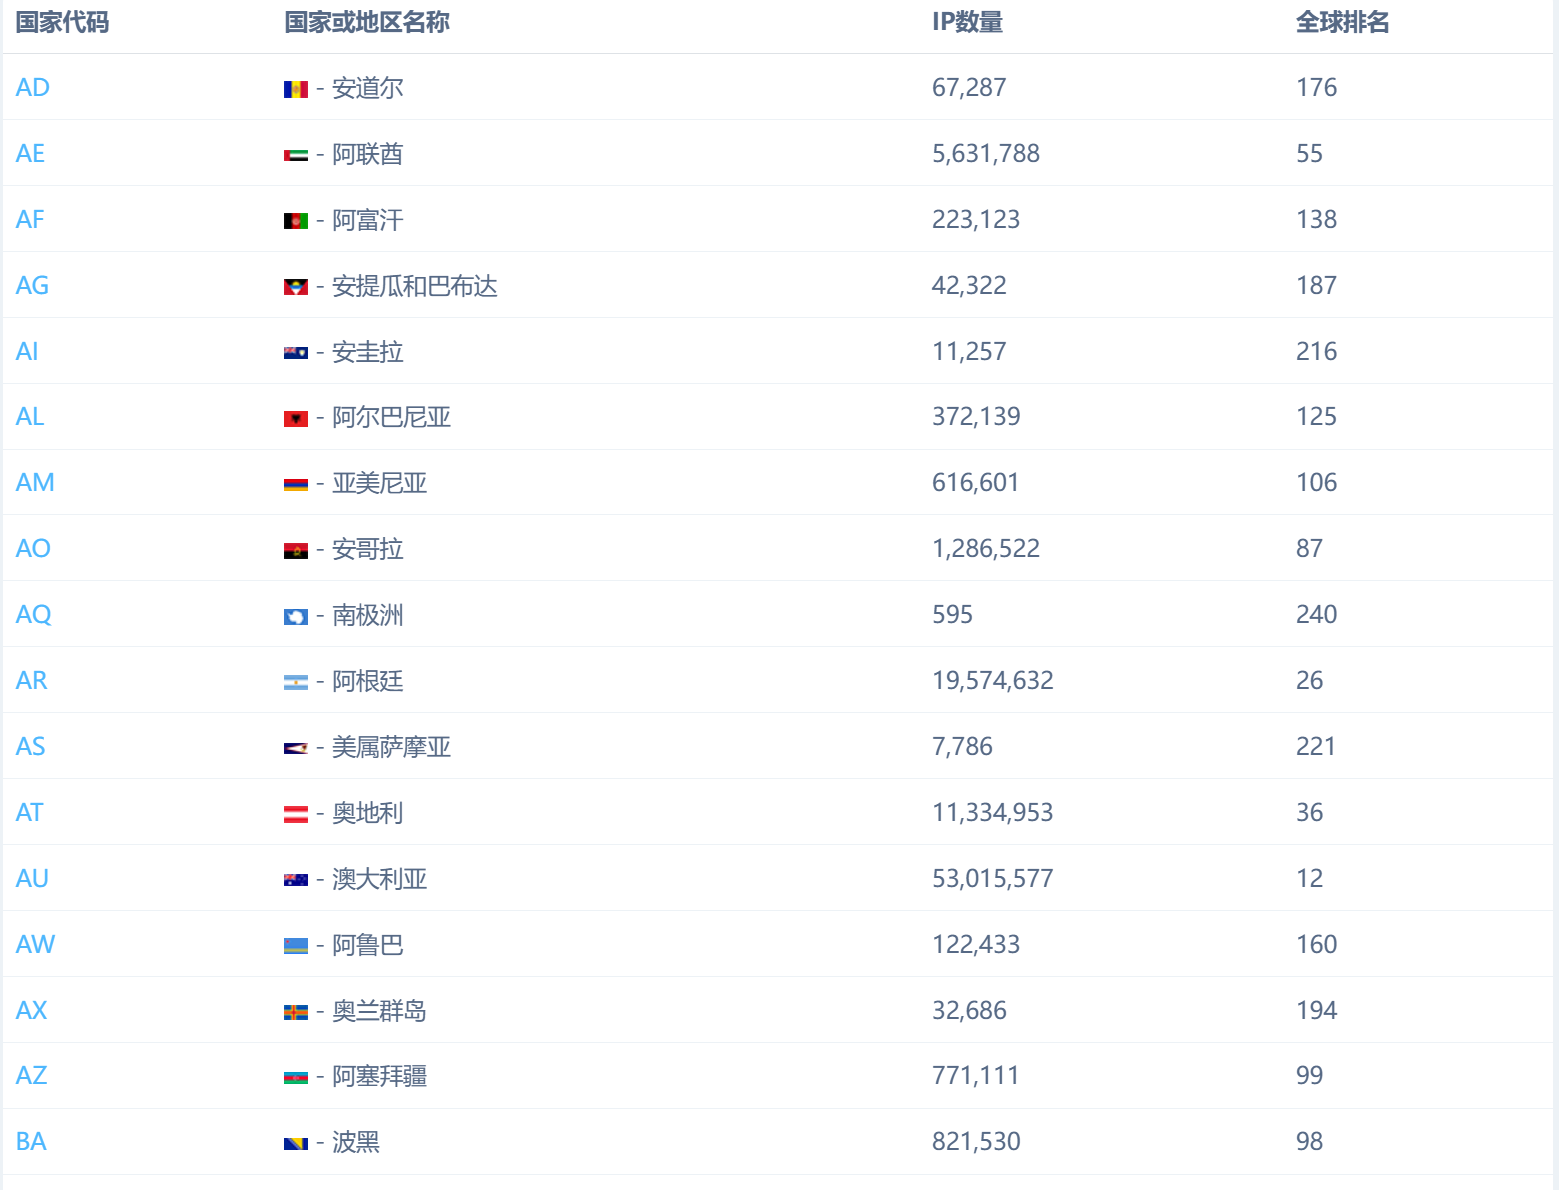
ip数量的划分不是根据国家来的,可能有组织或者上面其他的因素使得各国的ip数量很不一样
全球各大洲依靠海底光缆互相连通,构成了互联网的国际骨干网。国际骨干网中使用的核心路由器,都具备极强的数据转发性能。除海底光缆外,陆地长途光纤同样承担洲际网络传输。这类骨干路由器可以每秒处理海量数据包,支撑全球跨国家的数据转发。
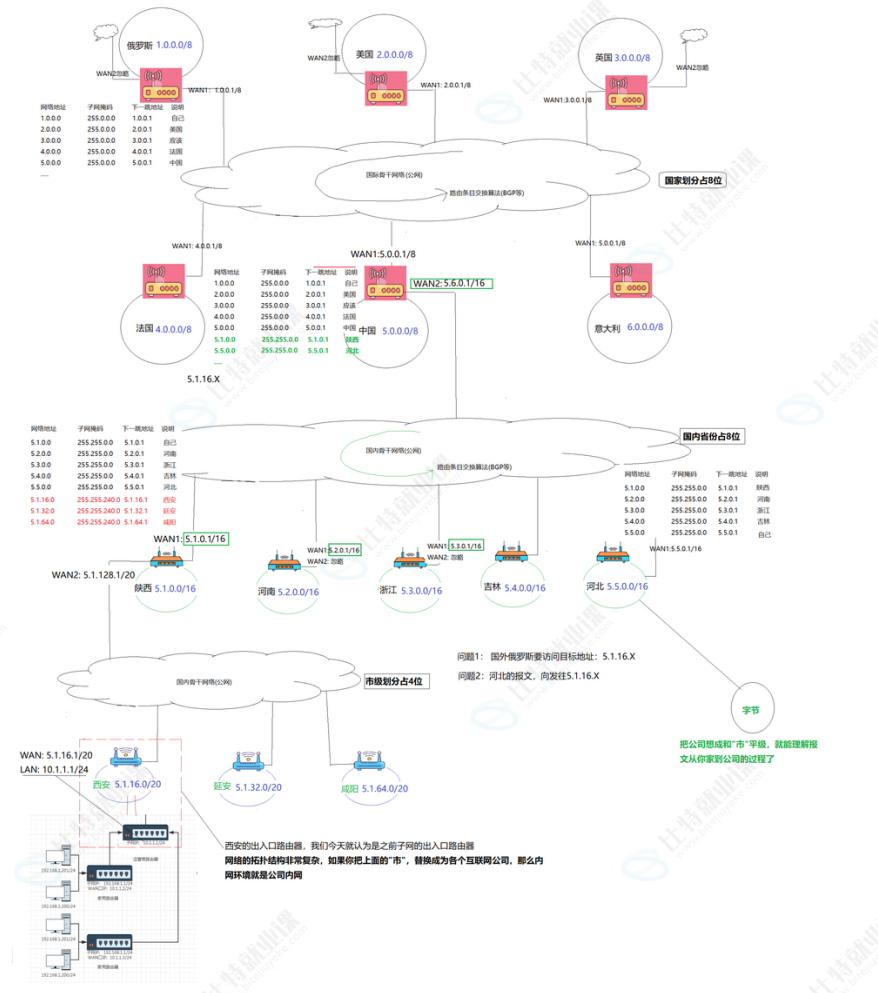
为了方便理解,我们做了理想化简化:把公网 IP 按国家、省份、城市逐级划分,就像快递系统,一层一层分拣。
顶层国际骨干网,各个国家的边界路由器互联,交换全球路由;国家拿到大段 IP 之后,再由运营商拆分,分配到各个省份;省份再细分到各个城市;城市出口路由器再对接企业 / 家庭内网。
路由器转发报文的核心逻辑:拿到目的 IP,和路由表里面的子网掩码做按位与运算,算出网络号,匹配路由条目,转发给对应的下一跳。
重要提醒:真实互联网并不是按国家分配 / 8 网段,这只是教学简化模型。真实 IP 分配是由 ICANN、RIR 区域互联网注册机构分配给各个运营商,并非直接绑定国家。
路由
每个主机都是有路由表的
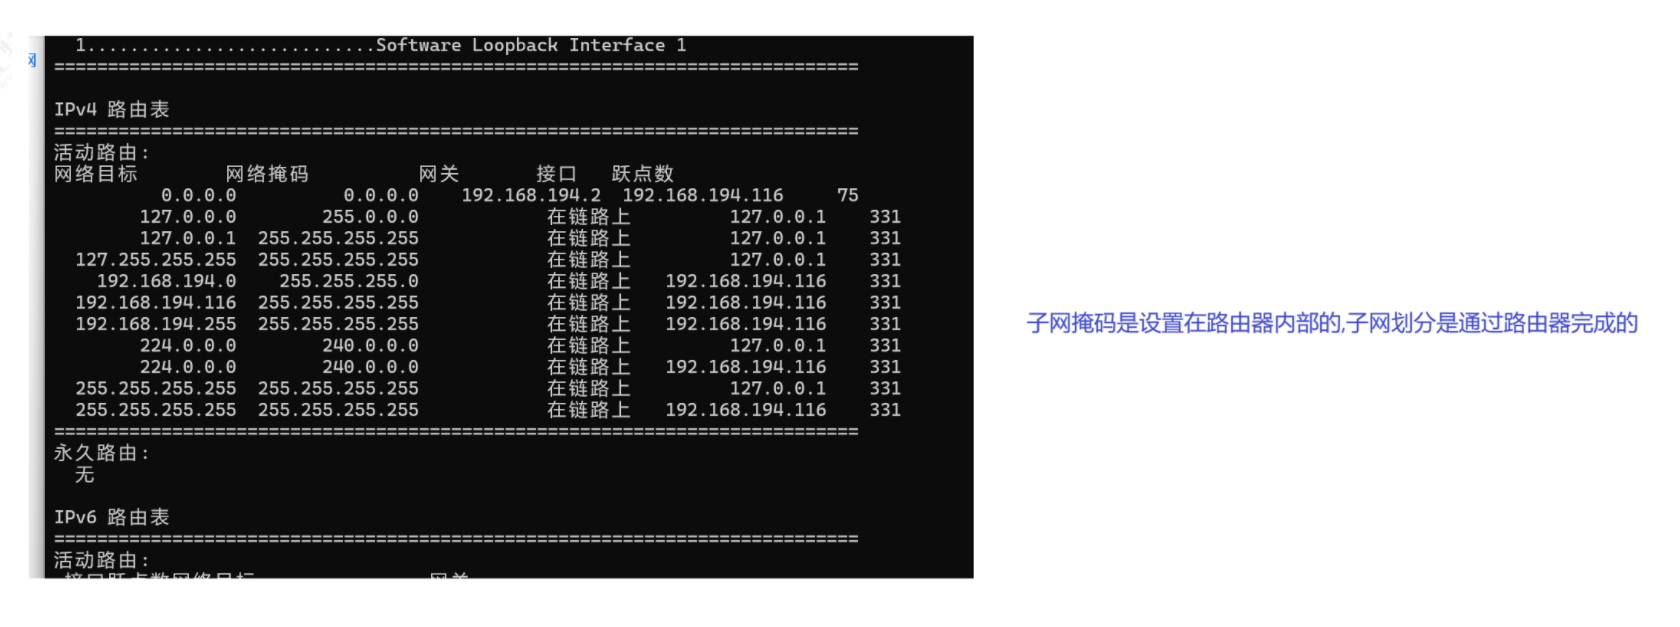
访问同局域网主机 192.168.194.200
目的 IP:192.168.194.200
- 目的 IP 和子网掩码
255.255.255.0做按位与,得到网络号192.168.194.0 - 在路由表匹配条目:
192.168.194.0 mask 255.255.255.0,标注【在链路上】 - "在链路上" = 目标和本机在同一个网段,不需要发给网关
- 本机直接 ARP 广播,获取
192.168.194.200的 MAC 地址,数据包直接二层交付给目标主机
路由转发核心逻辑:拿到目的 IP,和路由表里面每条路由的子网掩码做按位与运算,计算网络号;遵循最长前缀优先原则匹配路由条目。
- 如果匹配到【在链路上】的路由:目标主机和本机处于同一局域网,直接 ARP 获取 MAC,二层通信,不经过网关。
- 没有任何网段匹配,则命中默认路由
0.0.0.0,数据包转发给默认网关,交由网关继续跨网段转发。
回到报头
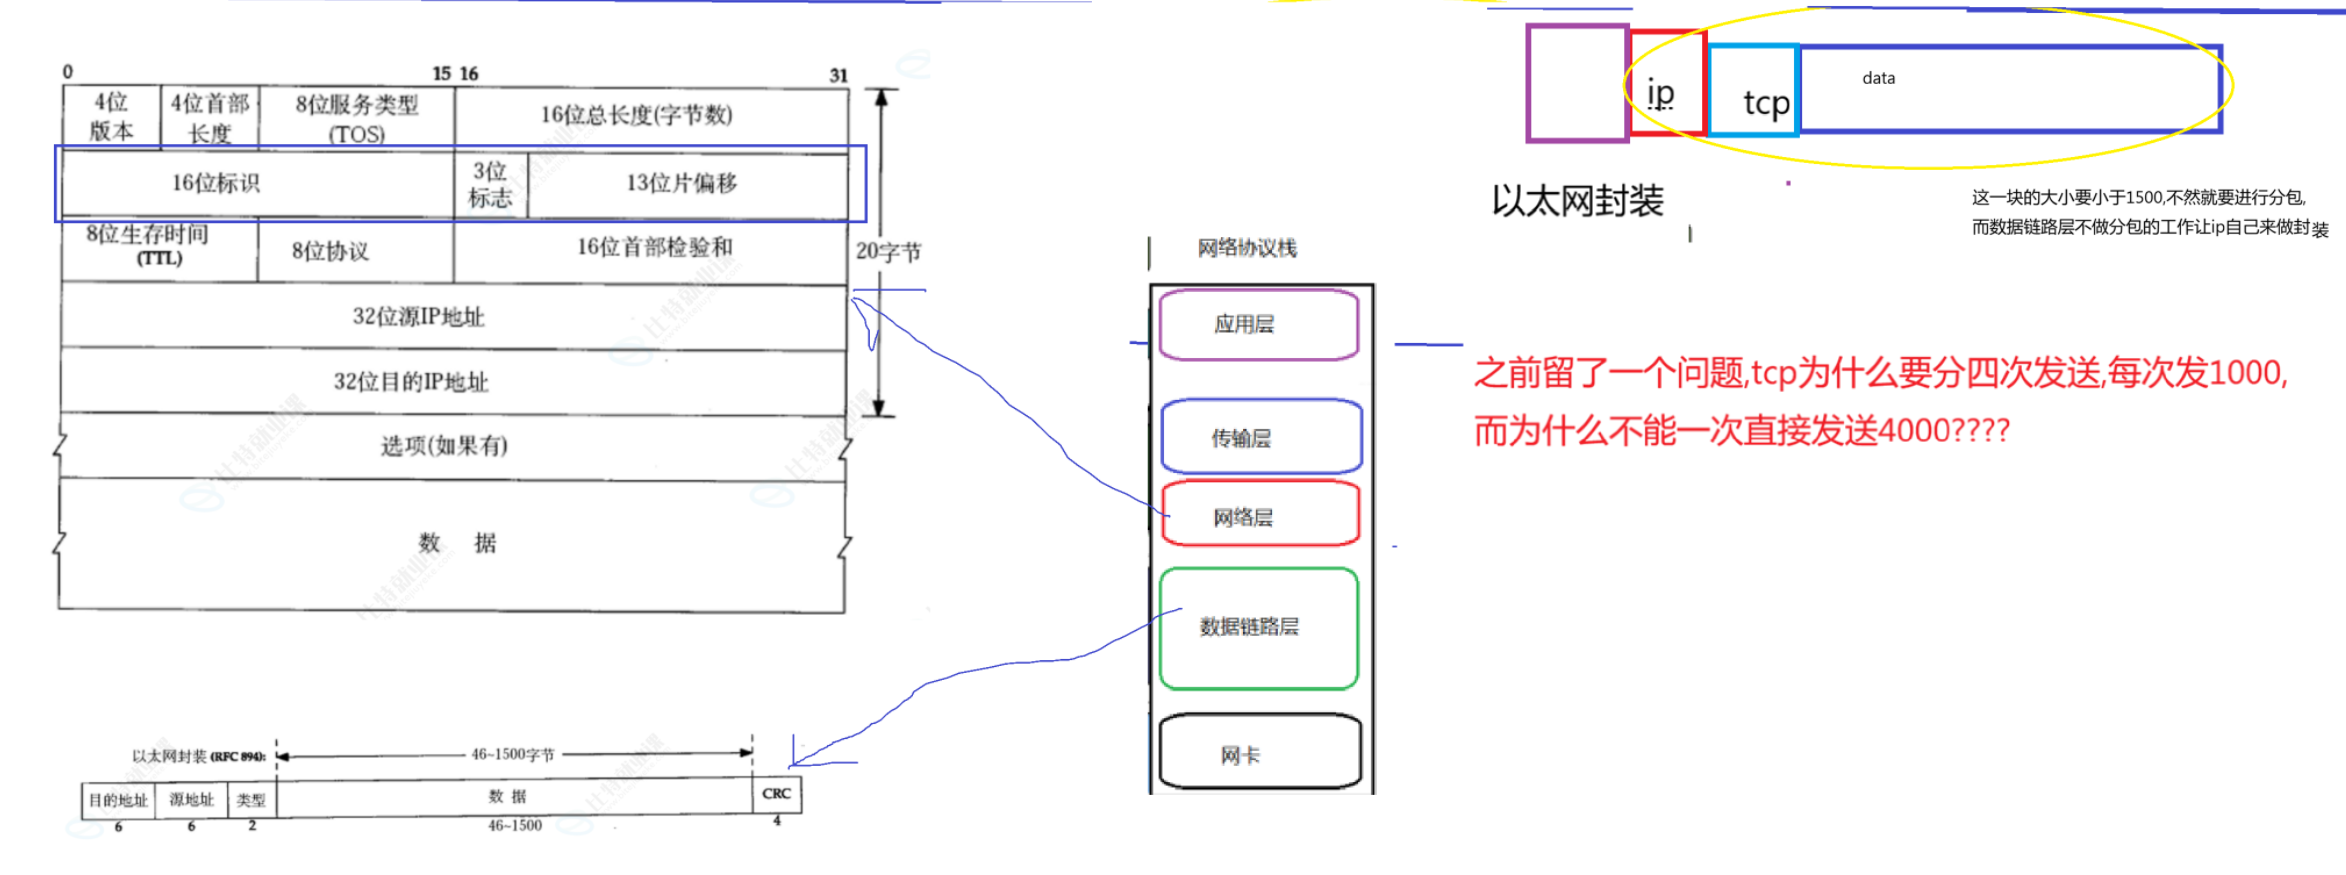
如果应用层一次性交给 TCP 4000 字节,能不能 TCP 打包成一个 TCP 报文段直接下发?
假设 TCP 直接封装 4000 字节应用数据
TCP 头部 20 + 4000 数据 = 4020 字节,交给网络层 IP。 IP 加上 20 字节 IP 头,整个 IP 包大小 = 4040 字节。 这个 IP 数据包交给数据链路层封装进以太网帧。 但是以太网规定:帧里面的数据区最大只能 1500 字节 ,4040 字节远超 1500。 数据链路层不会做分包 (图里标注了这句话),分包工作交给 IP 层完成。 IP 就要对这个大包进行IP 分片,把 4040 字节拆成多个 IP 分片,分别打包、单独传输。
IP 分片有很大缺点
- 只要任意一个分片丢了,整个 IP 数据包全部重传 IP 分片是网络层的工作,IP 本身没有重传机制。只要其中 1 片丢失,接收方无法重组,整个 4000 字节的数据全部失效,TCP 必须重新发送全部 4000 字节,性能很差。
- 分片会增加路由器处理开销,某些网络环境会直接丢弃大分片包。
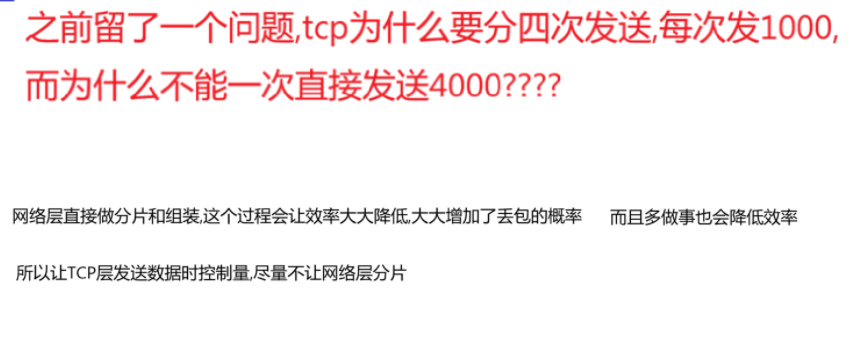
尽量传输层的数据<1460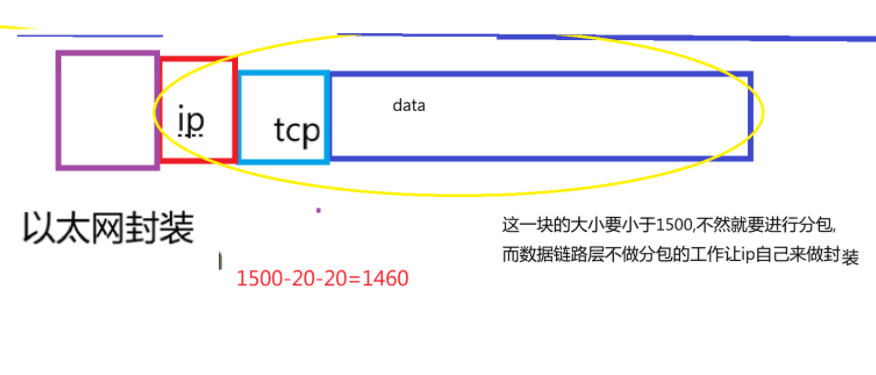
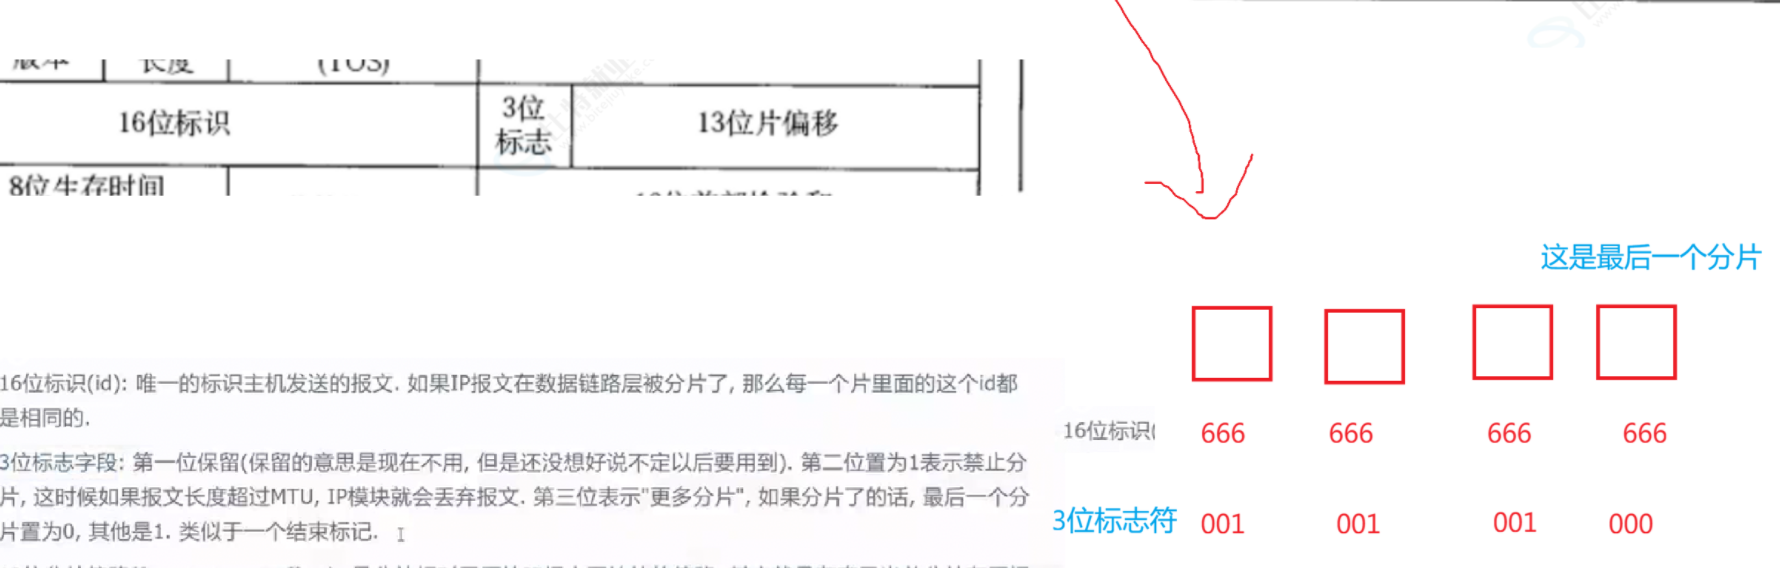
16位标识(id)
唯一的标识主机发送的报文. 如果IP报文在数据链路层被分片了, 那么每一个片里面 的这个id都是相同的.
3 位标志位规则(从左往右:保留 | DF 禁止分片 | MF 更多分片)
001:MF=1 → More Fragment=1,代表后面还有分片,不是最后一块000:MF=0 → 没有更多分片,这就是整个报文的最后分片
分片核心规则
- 同一原始 IP 报文拆分出来的所有分片,ID 标识完全相同(这里全是 666)。接收主机依靠这个 ID,把属于同一个大数据包的分片收集起来重组。
- 除最后一个分片以外,前面所有分片的数据部分长度必须是 8 字节的整数倍,保证偏移对齐。
- 分片到达接收端可以乱序,依靠片偏移的值排序重组,不需要按发送顺序到达。
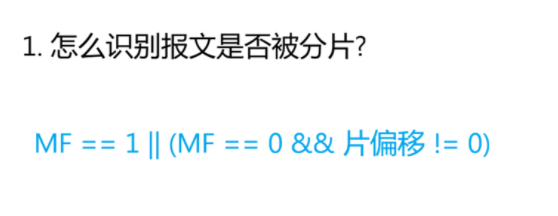
判断 IP 报文是否分片: 只要 MF=1,一定是分片; 如果 MF=0,但片偏移不为 0,也属于分片(整个报文的最后一块分片)。 只有 MF=0 且 片偏移=0,才是没有分片的原始 IP 报文。
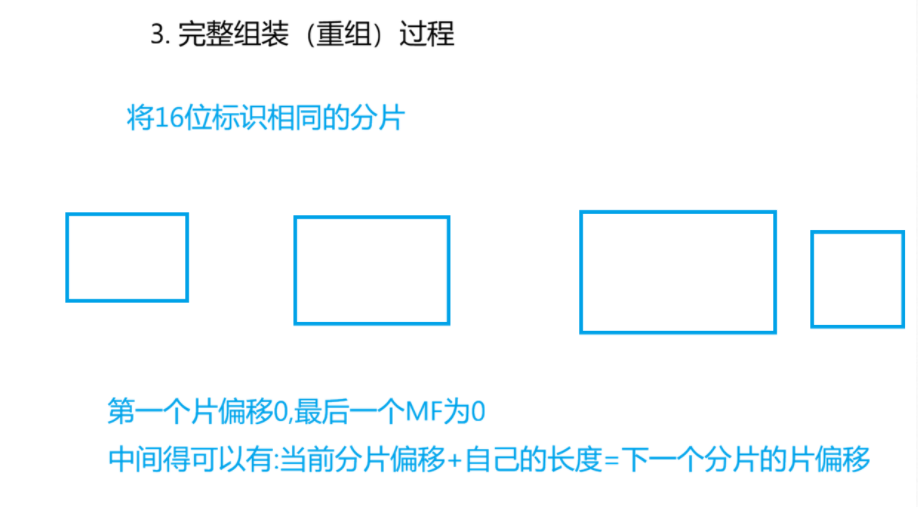
接收端只把 16 位标识 ID 相同的分片,划为同一组,进行重组。
重组判定规则
- 同一组分片,第一个分片片偏移 = 0,代表这是原始报文数据的起点。
- 本组最后一个分片 MF=0,标记分片序列结束。
- 分片之间的对齐条件:
当前分片的片偏移(×8 得到字节) + 当前分片的数据长度 = 下一个分片的片偏移对应的字节位置 也就是:
当前起始字节 + 当前分片数据长度 = 下一片起始字节保证分片之间紧密衔接、没有空隙、不重叠。
重点:分片到达可以乱序 ! 接收端不靠到达先后排序,依靠【片偏移】字段,计算位置,把分片放到正确位置。
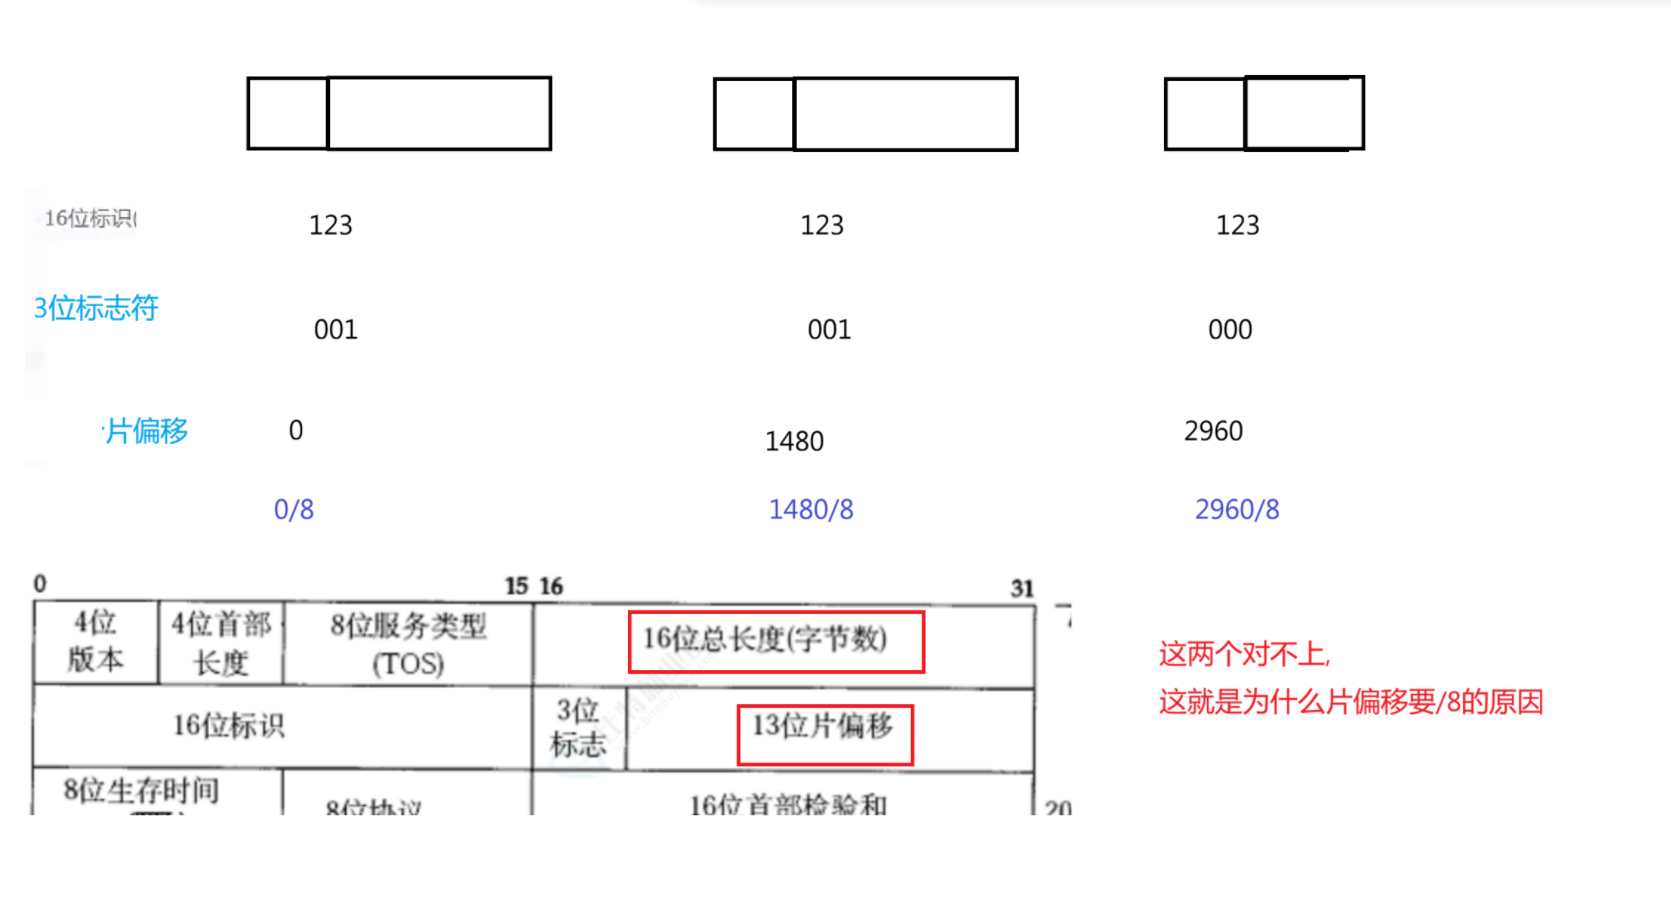
为什么片偏移要除以 8
13 位片偏移字段,最大能表示的值 = 2¹³ -1 = 8191 如果片偏移直接代表字节: 最大只能描述 8191 字节。但 IP 报文最大可以到 65535 字节,根本放不下,范围不够。
那直接放大单位,单位 = 8 字节: 8191 × 8 = 65528 字节,刚好覆盖 IP 报文最大长度(65535)。
代价:前面所有分片的数据长度,必须是 8 字节整数倍! 只有最后一片不受这个限制,可以不是 8 的倍数。
片偏移只有 13bit,取值范围 0~8191。 如果单位是 1 字节,最多只能偏移 8191 字节,小于 IP 报文最大 65535 字节,寻址不够。 所以规定片偏移单位 = 8 字节。 13bit 最大值 8191 ×8 = 65528,刚好覆盖 IP 报文最大长度。 代价:除最后分片外,其余分片数据长度必须是 8 字节整数倍。