文章目录
-
- [1. 先把问题讲清楚:为什么不总用最大模型](#1. 先把问题讲清楚:为什么不总用最大模型)
- [2. 小模型为什么能变强](#2. 小模型为什么能变强)
- [3. 权重内存怎么估算](#3. 权重内存怎么估算)
- [4. KV Cache 对小模型也重要](#4. KV Cache 对小模型也重要)
- [5. 量化不是免费午餐](#5. 量化不是免费午餐)
- [6. SLM + RAG:不要让小模型背所有知识](#6. SLM + RAG:不要让小模型背所有知识)
- [7. 蒸馏:让小模型学大模型的行为](#7. 蒸馏:让小模型学大模型的行为)
- [8. 大小模型协同:不要让一个模型做所有事](#8. 大小模型协同:不要让一个模型做所有事)
- [9. 端侧部署检查清单](#9. 端侧部署检查清单)
- [10. 什么时候不该用小模型](#10. 什么时候不该用小模型)
- [11. 常见误区](#11. 常见误区)
- [12. 小结](#12. 小结)
- 大模型视角
- 下一篇
摘要:SLM(Small Language Model,小语言模型)的价值不是全面超过大模型,而是在成本、延迟、隐私、本地部署和任务可控性上更适合。Phi、Gemma 等小模型路线提醒我们:高质量数据、蒸馏、明确任务边界、量化、RAG、工具调用和大小模型协同,可以让小模型在很多场景中"足够好"。本文会从端侧约束讲起,解释小模型为什么有用、如何估算权重和 KV Cache 内存、量化会带来什么取舍、SLM+RAG 如何设计、大小模型如何路由,以及什么时候不该用小模型。
- 前置知识:专栏一混合精度、模型评估、 KV Cache
- 阅读时间:55-70 分钟
- 代码环境:Python 3.10+,示例只依赖标准库
- 读完目标:能判断任务是否适合 SLM,能估算权重/KV Cache 内存,能设计 SLM+RAG 或大小模型协同方案,能做量化后回归评估
1. 先把问题讲清楚:为什么不总用最大模型
大模型能力强,但代价也高:
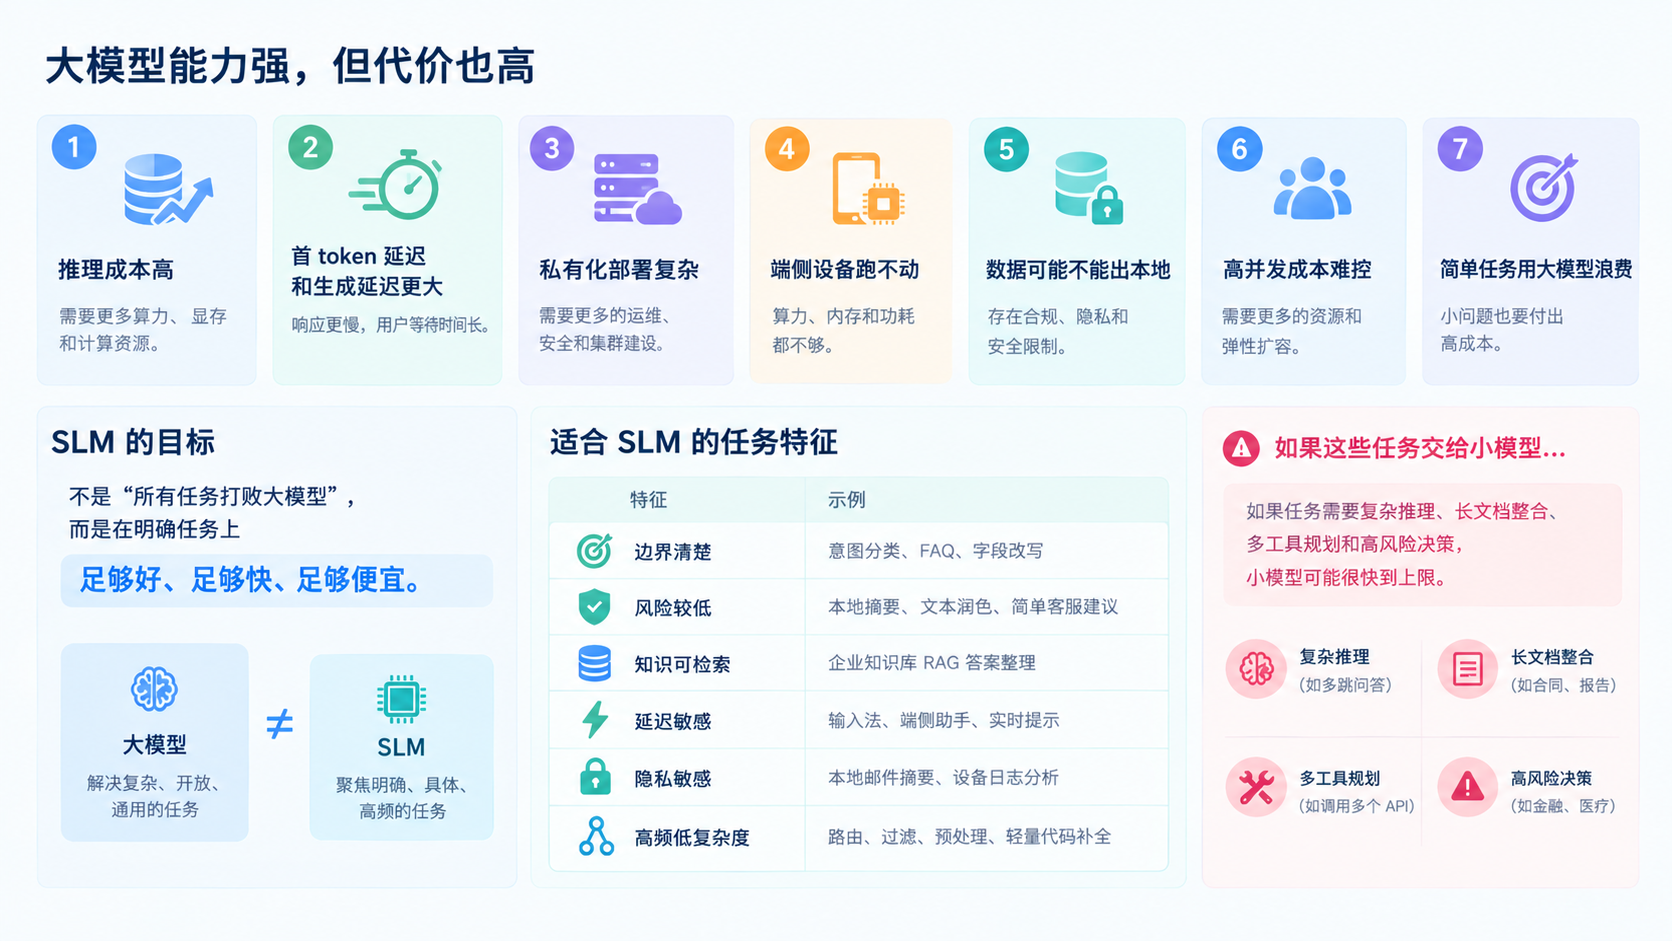
SLM 的目标不是"所有任务打败大模型",而是在明确任务上足够好、足够快、足够便宜。
适合 SLM 的任务通常有几个特征:
| 特征 | 示例 |
|---|---|
| 边界清楚 | 意图分类、FAQ、字段改写 |
| 风险较低 | 本地摘要、文本润色、简单客服建议 |
| 知识可检索 | 企业知识库 RAG 答案整理 |
| 延迟敏感 | 输入法、端侧助手、实时提示 |
| 隐私敏感 | 本地邮件摘要、设备日志分析 |
| 高频低复杂度 | 路由、过滤、预处理、轻量代码补全 |
如果任务需要复杂推理、长文档整合、多工具规划和高风险决策,小模型可能很快到上限。
2. 小模型为什么能变强
小模型参数少,但不等于低质量。小模型能力来自多种方法组合:
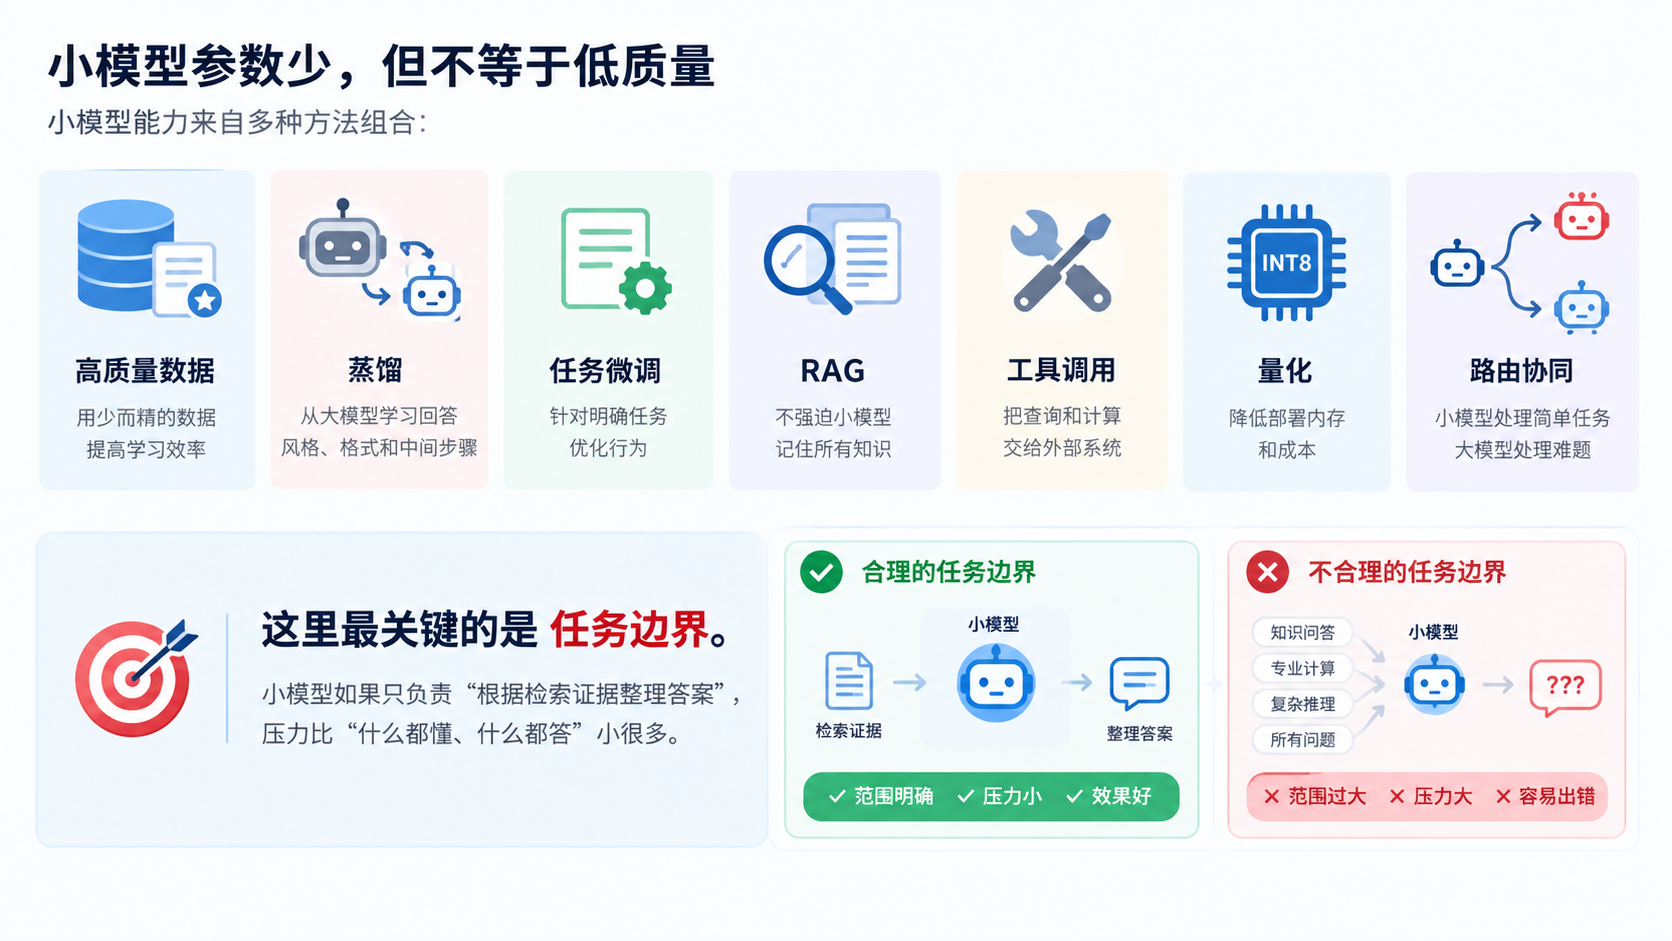
这里最关键的是任务边界。小模型如果只负责"根据检索证据整理答案",压力比"什么都懂、什么都答"小很多。
可以这样理解:大模型像全科专家,小模型更像训练良好的专职助手。专职助手在清晰流程里效率很高,但不能要求它处理所有疑难杂症。
公开资料里的两个代表也印证了这张表。微软的 Phi 系列走的是"高质量数据"路线:不堆网页噪声,而是用大模型生成和筛选接近教科书质量的合成数据,让小模型在更少但更精的 token 上学到更密的知识,再用微调对齐行为。Google 的 Gemma 则明显使用了蒸馏路线:让小尺寸模型学习更大教师模型的输出分布,把大模型的能力部分迁移到 2B、7B 这样的尺寸上。两条路线的共同点是:小模型的能力不是"天然就有",而是被数据策略和训练策略刻意设计出来的。所以选 SLM 时,除了参数量,还应该看它的数据来源、蒸馏对象和训练方法,这些往往比参数规模更能预测它在你的任务上的表现。
3. 权重内存怎么估算
部署前先算权重大小。粗略公式:
memory = params × bits 8 \text{memory} = \frac{\text{params} \times \text{bits}}{8} memory=8params×bits
其中:
- params:参数量;
- bits:每个参数使用多少 bit;
- 除以 8:bit 转 byte。
代码估算:
python
# Python 3.10+

def weight_memory_gb(params_billion, bits):
    return params_billion * 1_000_000_000 * bits / 8 / 1024**3

for params in [1.5, 2, 7, 14]:
    print(f"\n{params}B model")
    for bits in [16, 8, 4]:
        print(f"  {bits}bit: {weight_memory_gb(params, bits):.2f} GB")
这只是权重,不包括:
text
1. KV Cache;
2. 运行时临时张量;
3. 推理框架缓存;
4. tokenizer 和 CPU 预处理;
5. 操作系统和图形内存;
6. 多并发 batch 开销。
端侧设备还要考虑内存带宽、散热、电量、NPU/GPU 支持和后台进程竞争。
4. KV Cache 对小模型也重要
小模型权重小,但长上下文仍然会占 KV Cache。尤其端侧场景内存很紧,不能只看模型文件大小。
KV Cache 粗略估算:
python
# Python 3.10+

def kv_cache_mb(layers, seq_len, kv_heads, head_dim, bytes_per_value=2):
    return layers * seq_len * kv_heads * head_dim * 2 * bytes_per_value / 1024**2

for seq_len in [2048, 8192, 32768]:
    mb = kv_cache_mb(layers=24, seq_len=seq_len, kv_heads=8, head_dim=64)
    print(seq_len, f"{mb:.1f} MB")
如果 batch 或并发增加,KV Cache 还会乘以请求数。端侧任务不要盲目追长上下文。很多时候更好的方案是:
text
1. 先检索相关片段;
2. 对长文档做摘要压缩;
3. 分段处理;
4. 只保留短期对话状态;
5. 超出能力范围交给云端大模型。
5. 量化不是免费午餐
量化能把权重从 FP16/BF16 压到 INT8、INT4 等格式,显著降低内存。但它可能影响模型行为。
量化后必须重新评估:
| 能力 | 可能变化 |
|---|---|
| 中文表达 | 细节和流畅度下降 |
| JSON 输出 | 括号、引号、字段更容易错 |
| 数学计算 | 数值推理更不稳定 |
| 代码生成 | 语法和 API 更容易错 |
| 长上下文 | 远距离信息利用下降 |
| 安全拒答 | 边界回答被扰动 |
| 重复和乱码 | 低 bit 下更容易退化 |
一个最小量化回归记录:
python
# Python 3.10+

results = [
    {"case": "json_schema", "fp16": True, "int4": False},
    {"case": "faq_answer", "fp16": True, "int4": True},
    {"case": "safety_refusal", "fp16": True, "int4": True},
    {"case": "math_short", "fp16": True, "int4": False},
]

for r in results:
    print(r["case"], "changed=", r["fp16"] != r["int4"])
量化方案是否可接受,取决于任务。意图分类可能很稳,代码和 JSON 可能更敏感。
6. SLM + RAG:不要让小模型背所有知识
小模型记忆容量有限,企业知识最好放在检索系统里。小模型负责理解问题、整理证据、生成简洁答案。
典型流程:
text
用户问题 -> 检索相关文档 -> 小模型基于证据回答 -> 输出引用 -> 无证据拒答这样做有几个好处:
text
1. 知识更新不用重训;
2. 答案可引用;
3. 私有数据可以留在本地;
4. 小模型只承担有限推理;
5. 成本和延迟更可控。
但 RAG 也会出错。检索错了,小模型很难凭空纠正。因此要加无证据拒答和引用校验。
一个 toy 版证据约束:
python
# Python 3.10+

def answer_with_evidence(question, retrieved_docs):
    if not retrieved_docs:
        return "根据当前资料无法确认。"
    joined = "\n".join(retrieved_docs)
    return f"请仅基于以下资料回答:\n{joined}\n\n问题:{question}"

print(answer_with_evidence("退款多久到账?", []))
print(answer_with_evidence("退款多久到账?", ["退款审核通过后通常3-5个工作日原路退回。"]))
真实系统里,这段 prompt 还要配合检索质量、引用格式和答案校验。
7. 蒸馏:让小模型学大模型的行为
蒸馏(Distillation)是让小模型学习大模型输出的一种方法。大模型可以生成高质量答案、推理步骤、格式样本或拒答样本,小模型用这些数据做 SFT。
适合蒸馏的内容:
text
1. 固定格式回答;
2. 简单推理步骤;
3. 结构化输出;
4. FAQ 改写;
5. 工具调用参数;
6. 拒答和澄清行为。
风险:
text
1. 大模型错误被小模型继承;
2. 生成数据风格单一;
3. 蒸馏样本过度理想,不像真实用户输入;
4. 小模型容量不足,学不到复杂行为;
5. 评估集被蒸馏数据污染。
蒸馏不是"复制大模型能力",更像把某些可控行为压缩到小模型里。
8. 大小模型协同:不要让一个模型做所有事
更现实的架构是大小模型协同:
text
小模型处理高频简单任务;
大模型处理复杂推理和低频难题;
小模型做路由、过滤、摘要;
大模型做最终复杂回答;
高风险任务转人工。
示例路由规则:
python
# Python 3.10+

def route_task(task):
    if task["risk"] == "high":
        return "human_review"
    if task["needs_long_context"]:
        return "large_model"
    if task["complexity"] == "low":
        return "small_model"
    return "large_model"

cases = [
    {"risk": "low", "complexity": "low", "needs_long_context": False},
    {"risk": "low", "complexity": "high", "needs_long_context": False},
    {"risk": "high", "complexity": "low", "needs_long_context": False},
]

for c in cases:
    print(c, "->", route_task(c))
这个规则很粗,但体现了核心思想:模型选择是系统设计问题,不是单个模型能力问题。
9. 端侧部署检查清单
端侧部署比服务器部署更受限制。检查项包括:
| 维度 | 要看什么 |
|---|---|
| 设备 | CPU/GPU/NPU、内存、带宽、散热、电量 |
| 模型 | 参数量、量化格式、上下文长度、tokenizer |
| 框架 | llama.cpp、ONNX Runtime、Core ML、MLC、厂商 SDK |
| 延迟 | 首 token、tokens/s、prefill 时间 |
| 质量 | 量化前后业务评估 |
| 隐私 | 日志、缓存、崩溃转储是否泄露数据 |
| 更新 | 模型版本、灰度、回滚、兼容性 |
| 安全 | 本地越权、敏感文件访问、提示注入 |
端侧 demo 能跑,不代表大规模设备稳定可用。散热、内存碎片、后台任务、电量限制都可能影响体验。
10. 什么时候不该用小模型
不适合小模型优先的场景:
text
1. 复杂数学、代码和多步规划;
2. 长文档跨段推理;
3. 多工具 Agent 自动执行;
4. 高风险医疗、法律、金融建议;
5. 开放域问答且没有 RAG;
6. 用户容错率极低的生产场景;
7. 需要强多语言和复杂指令遵循。
如果必须用小模型,应降低任务难度:加 RAG、加工具、加模板、加人工审核、加大模型兜底。
11. 常见误区
误区一:小模型就是低质量模型。 小模型通用能力弱,但明确任务中可能更合适。
误区二:量化只影响内存。 它也可能影响格式、推理、长上下文和安全边界。
误区三:端侧只看模型文件大小。 还要看 KV Cache、运行时、内存带宽、散热和电量。
误区四:小模型要替代大模型。 更合理的是协同和路由。
误区五:RAG 可以弥补所有小模型能力缺口。 RAG 提供知识,不一定提供复杂推理和可靠判断。
12. 小结
SLM 的价值在于成本、延迟、隐私和部署可控。它适合边界清楚、可评估、成本敏感的任务。通过高质量数据、蒸馏、微调、RAG、工具、量化和大小模型路由,小模型可以在很多场景中足够好。
但小模型不是万能。复杂推理、长文档、多工具 Agent、高风险决策仍需要大模型、工具或人工协作。正确做法是按任务路由,而不是盲目追求最大或最小。
大模型视角
从应用架构看,未来不是所有请求都交给最大模型,而是由不同尺寸模型、检索、工具和人工组成分层系统。SLM 是这个系统里处理高频、低成本、本地化任务的重要组件。
下一篇
下一组文章进入预训练技术。理解模型架构之后,我们要看一个基础模型如何从数据、算法和基础设施中训练出来。