写在前面
【从零走向AGI 】旨在深入了解通用人工智能(AGI)的发展路径,从最基础的概念起,逐步构建完整的知识体系。
项目地址 🔗:https://github.com/AI-mzq/From-Zero-to-AGI.git
AIGC算法岗/开发岗面试面经交流社群 (涵盖AI Agent、AIGC图像创作、AI视频、LLM大模型、AI多模态、数字人、传统深度学习、具身智能等AIGC面试干货资源)欢迎大家加入:https://t.zsxq.com/YtJ09
京东 WLA³详解:用世界状态转换统一人类视频和机器人动作
导读
WLA³ 是京东 Joy Future Academy 提出的通用机器人策略框架,针对异构数据瓶颈:人类视频多但缺低噪声动作标签;机器人轨迹可执行,却昂贵且绑定本体。
论文把"世界状态如何变化"作为跨数据源动作接口。World Latent Action Model(WLAM)联合编码相机视角和本体状态,将局部转换压缩为 32 维 latent action,并保留 transition feature;前者服务动力学与控制,后者池化为 Semantic Latent Aggregate(SLA),直接监督 VLM。
WLA³ 将这些表示用于三层训练:LAC-WM 学习 latent action 条件下的物理动态;SLA 给 VLM 提供语义监督;LARA expert 联合预测 latent action 和机器人动作。84.1K 小时语料覆盖人类视频、真机、仿真和 UMI;六个 AgiBot G1 任务上平均成功率 81.9%。
猫先生认为,WLA³ 的关键不是又一个 VLA,而是把 latent action 从"预训练中间产物"提升为贯穿语义、动力学和控制的全栈接口。多粒度复用让人类视频和机器人轨迹互相补充,而不是简单堆在一起。
- 论文标题:WLA³: World Latent Action Modeling for Semantics, Dynamics, and Kinematics
- 论文地址:https://arxiv.org/abs/2609.15870
- 项目主页:https://wla-3.github.io/
- 论文 HTML:https://arxiv.org/html/2609.15870
原文脉络
1-2. 背景与相关工作:动作标签不是唯一接口
通用策略模型要从视觉观测和语言指令映射到机器人控制,但异构数据扩展受限于动作标签。机器人动作维度、坐标系和控制语义随硬件变化;人类视频有丰富交互,但 3D 手部姿态估计噪声较大。
3. 方法:WLAM 如何支撑语义、动力学和控制
3.1 World Latent Action Model
在时刻 t t t, I t I_t It 表示相机观测, r t r_t rt 表示本体状态, e e e 表示 embodiment profile。世界状态写作:
s t = ( I t , r t , e ) . s_t=(I_t,r_t,e). st=(It,rt,e).
缺失的模态直接省略。WLAM 处理端点状态 s t s_t st 和 s t + h s_{t+h} st+h,输出 transition feature:
g t , h = E ϕ t r a n s ( s t , s t + h ) C L S ∈ R 1024 . \mathbf{g}{t,h}=\leftE_{\\phi}\^{\\mathrm{trans}}(s_t,s_{t+h})\\right{\\mathrm{CLS}}\in\mathbb{R}^{1024}. gt,h=Eϕtrans(st,st+h)CLS∈R1024.
该特征参数化高斯后验并采样 32 维 latent action:
z t , h ∼ q ϕ ( ⋅ ∣ g t , h ) , z t , h ∈ R 32 . \mathbf{z}{t,h}\sim q{\phi}(\cdot\mid \mathbf{g}{t,h}),\quad \mathbf{z}{t,h}\in\mathbb{R}^{32}. zt,h∼qϕ(⋅∣gt,h),zt,h∈R32.
下游训练使用后验均值 z ˉ t , h \bar{\mathbf{z}}_{t,h} zˉt,h 作为确定性目标。对从 t t t 到 t + T t+T t+T 的片段,模型平均池化局部 transition feature 得到 SLA:
c t s e g = 1 T − h + 1 ∑ k = 0 T − h g t + k , h . \mathbf{c}t^{\mathrm{seg}}=\frac{1}{T-h+1}\sum{k=0}^{T-h}\mathbf{g}_{t+k,h}. ctseg=T−h+11k=0∑T−hgt+k,h.
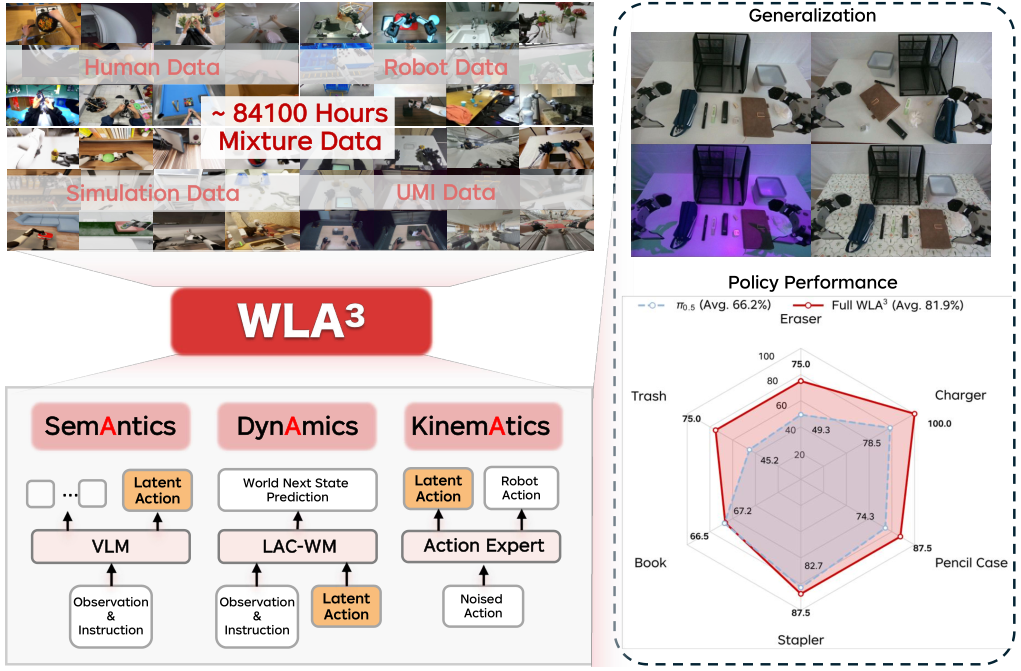
图 1:WLA³ 从异构世界状态转换中学习局部 latent action 和片段级 transition feature,分别支撑动力学、语义和动作生成。来源:论文 Figure 1。
训练时使用跨模态 dropout:随机丢弃部分相机或本体状态流,但至少保留一路;同一 mask 同时作用于 t t t 和 t + h t+h t+h,避免输入缺失被误学为物理变化。解码器接收初始状态并重建端点模态。
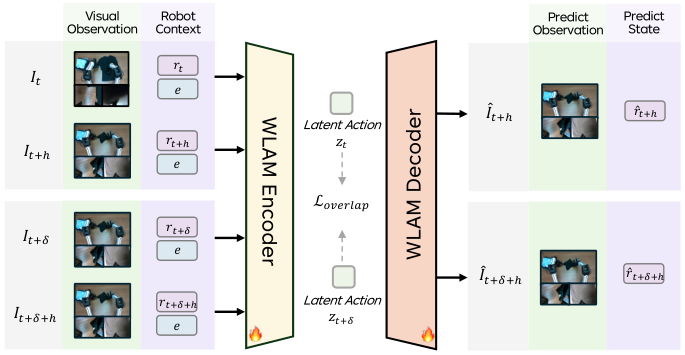
图 2:WLAM 联合编码相机转换和本体状态转换,经跨模态 dropout 和端点重建学习紧凑动作表示。来源:论文 Figure 2。
对重叠时间窗,模型最小化两个后验均值的 cosine distance:
L o v e r l a p = E 1 − z ˉ t , h ⊤ z ˉ t + δ , h ∥ z ˉ t , h ∥ 2 ∥ z ˉ t + δ , h ∥ 2 + ϵ . \mathcal{L}_{\mathrm{overlap}}= \mathbb{E}\left 1-\\frac{\\bar{\\mathbf{z}}_{t,h}\^{\\top}\\bar{\\mathbf{z}}_{t+\\delta,h}} {\\\|\\bar{\\mathbf{z}}_{t,h}\\\|_2\\\|\\bar{\\mathbf{z}}_{t+\\delta,h}\\\|_2+\\epsilon} \\right. Loverlap=E1−∥zˉt,h∥2∥zˉt+δ,h∥2+ϵzˉt,h⊤zˉt+δ,h.
完整目标为:
L W L A M = L r e c + λ o v e r l a p L o v e r l a p + β D K L ( q ϕ ∥ N ( 0 , I ) ) . \mathcal{L}{\mathrm{WLAM}}= \mathcal{L}{\mathrm{rec}} +\lambda_{\mathrm{overlap}}\mathcal{L}{\mathrm{overlap}} +\beta D{\mathrm{KL}}\left(q_{\phi}\|\mathcal{N}(0,I)\right). LWLAM=Lrec+λoverlapLoverlap+βDKL(qϕ∥N(0,I)).
3.2 LAC-WM:用 latent action 条件化动力学
当前观测和指令可能对应多种物理转换。LAC-WM 接收视觉特征、指令和 latent action chunk,用 Conditional Flow Matching 预测未来视觉特征。
给定目标未来特征 y \mathbf{y} y、噪声 ϵ \epsilon ϵ 和 τ ∼ U ( 0 , 1 ) \tau\sim\mathcal{U}(0,1) τ∼U(0,1),插值为:
x τ = ( 1 − τ ) ϵ + τ y , v τ ⋆ = y − ϵ . \mathbf{x}{\tau}=(1-\tau)\epsilon+\tau\mathbf{y}, \qquad \mathbf{v}{\tau}^{\star}=\mathbf{y}-\epsilon. xτ=(1−τ)ϵ+τy,vτ⋆=y−ϵ.
模型预测 Conditional Flow Matching 的速度场,训练目标包含速度回归和时间差正则。语言和 latent action 独立 dropout,使模型支持 observation-only、language-only、latent-only 和联合条件模式。
3.3 SLA 与 LARA:语义监督与联合动作生成
SLA 直接监督 VLM。将一个 learned semantic query 加入 VLM 输入,当前观测和指令经过 VLM 后,由投影头预测片段级 SLA:
c ^ t s e g = P s e m ( V ξ ( I t , ℓ , q s e m ) q s e m ) . \hat{\mathbf{c}}t^{\mathrm{seg}} =P{\mathrm{sem}}\left(V_{\xi}(I_t,\ell,q_{\mathrm{sem}})q_{\\mathrm{sem}}\right). c^tseg=Psem(Vξ(It,ℓ,qsem)qsem).
损失为:
L s e m = ∥ c ^ t s e g − c t s e g ∥ 2 2 . \mathcal{L}_{\mathrm{sem}} =\left\|\hat{\mathbf{c}}_t^{\mathrm{seg}}-\mathbf{c}_t^{\mathrm{seg}}\right\|_2^2. Lsem=∥c^tseg−ctseg∥22.
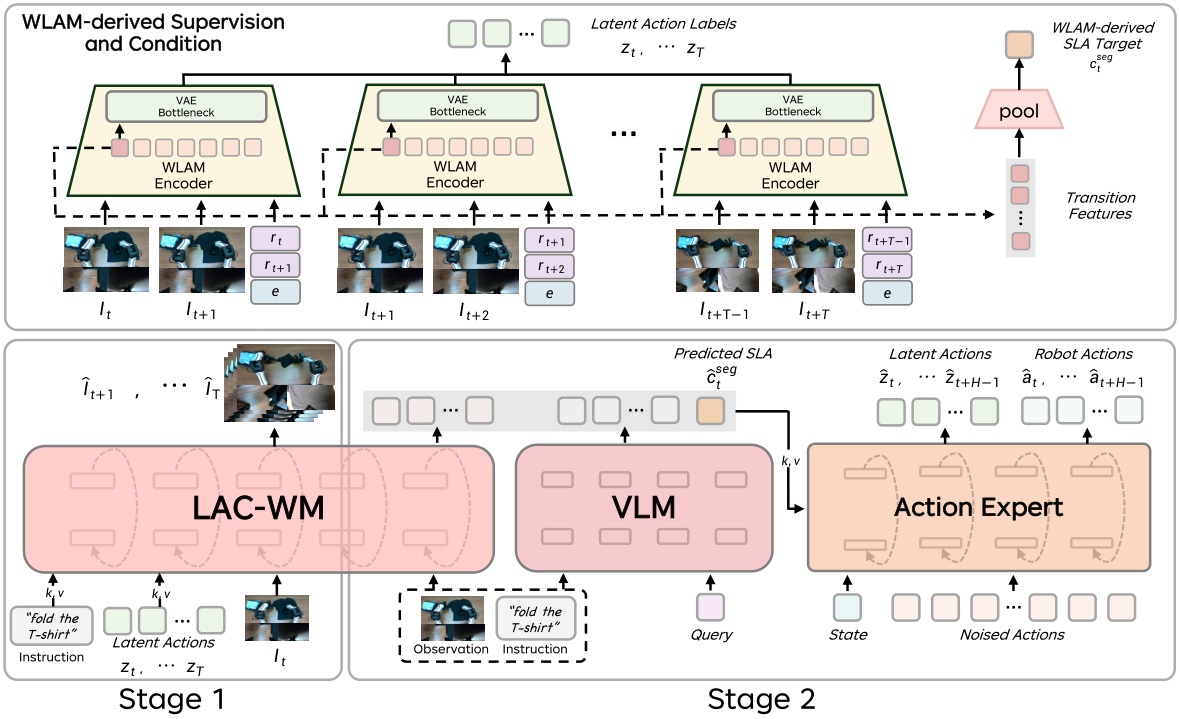
图 3:LAC-WM 预训练和通用策略中间训练。SLA 监督 VLM,LARA 联合预测 latent action 和机器人 action chunk。来源:论文 Figure 3。
LARA expert 处理控制。不同本体的动作维度不同,WLA³ 将状态和动作统一到 32 维接口:本体动作占据前 d e d_e de 维,其余补零并在损失中 mask。每个控制步的联合目标为:
x k = z ˉ k , h ∣ a k r o b ∈ R 64 . \mathbf{x}_k=\left\\bar{\\mathbf{z}}_{k,h}\\mid \\mathbf{a}_k\^{\\mathrm{rob}}\\right\in\mathbb{R}^{64}. xk=zˉk,h∣akrob∈R64.
Perceiver action expert 使用 Conditional Flow Matching 预测 30 步联合 action chunk,策略上下文由 VLM 和冻结 LAC-WM 特征拼接。总损失为:
L p o l i c y = λ l a t L l a t + λ r o b L r o b + λ s e m L s e m . \mathcal{L}{\mathrm{policy}} =\lambda{\mathrm{lat}}\mathcal{L}{\mathrm{lat}} +\lambda{\mathrm{rob}}\mathcal{L}{\mathrm{rob}} +\lambda{\mathrm{sem}}\mathcal{L}_{\mathrm{sem}}. Lpolicy=λlatLlat+λrobLrob+λsemLsem.
部署时执行机器人动作分支的有效坐标;latent 分支用于跨数据监督,不直接执行。
猫先生认为,WLA³ 的工程价值来自"粒度分工":latent action 描述局部控制变化,SLA 描述片段语义,LAC-WM 连接未来状态。相比把所有信息塞进一个 action token,这种结构更接近策略模型需要的监督尺度。
4. 数据:84.1K 小时异构语料
训练数据分为 53,874 小时人类视频、14,151 小时真机、11,676 小时仿真和 4,393 小时 UMI。
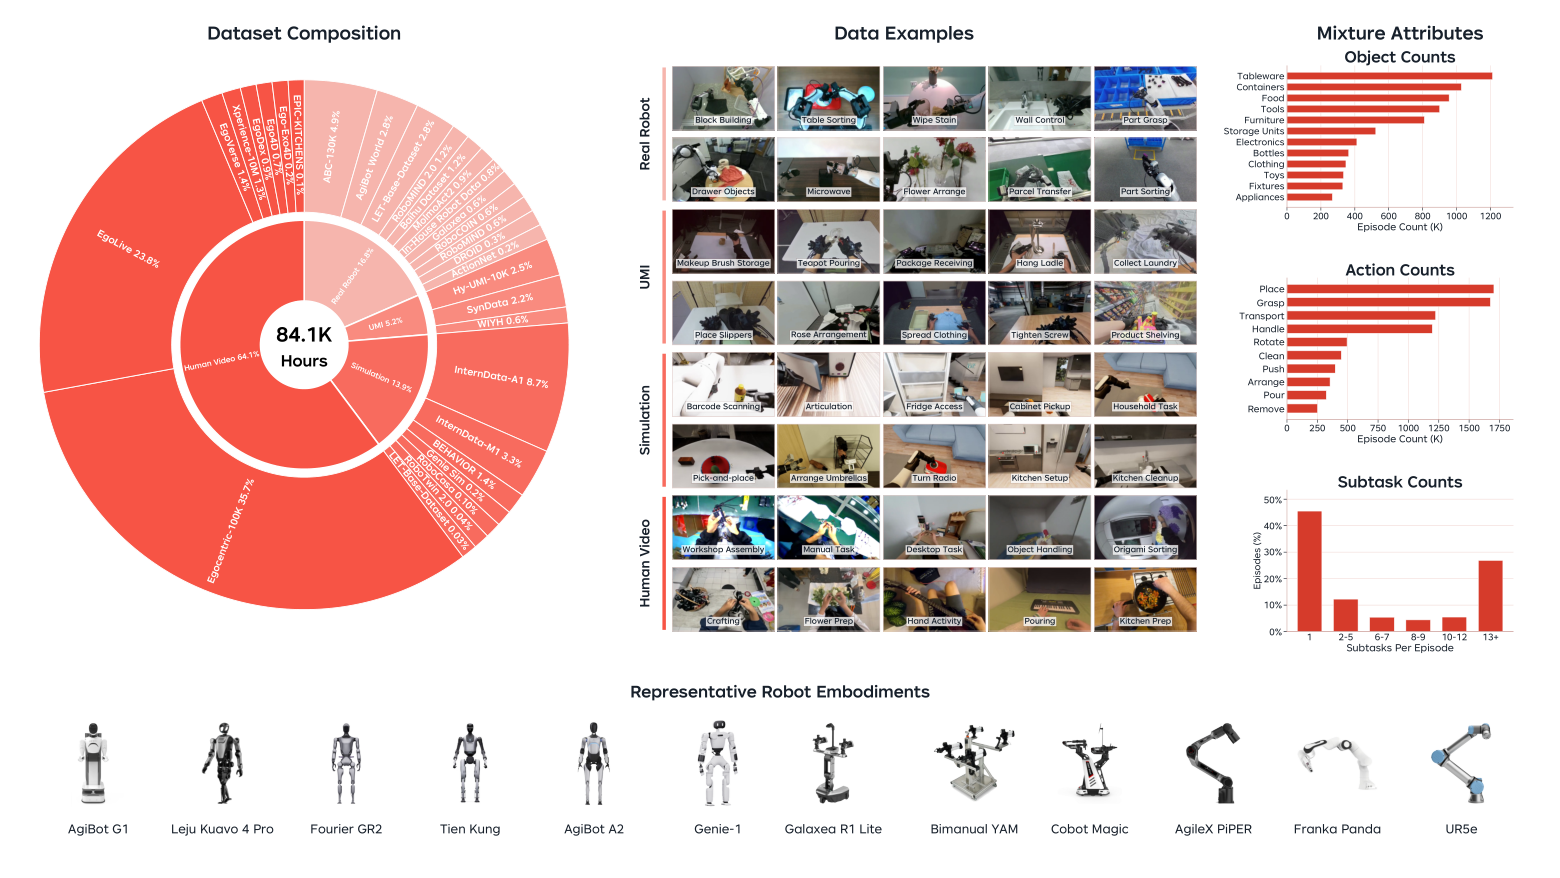
图 4:84.1K 小时训练语料,覆盖人类视频、真机、仿真和 UMI 四类数据及多种机器人本体。来源:论文 Figure 4。
5. 实验与结果
5.1 真机评测设置
论文在 AgiBot G1 上评估六个桌面任务:Eraser、Charger、Pencil Case、Stapler、Book、Trash,测试空间扰动、光照变化和未见背景纹理三种泛化,指令和成功标准不变。
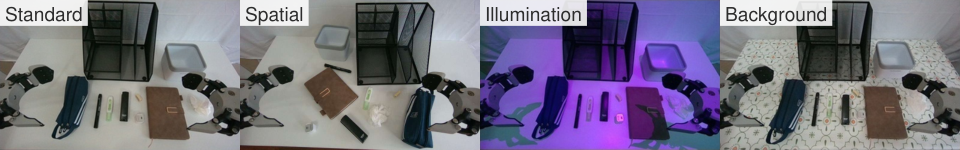
图 5:真机评测中的标准配置、空间扰动、光照变化和背景纹理变化。来源:论文 Figure 5。
5.2 LARYBench 表示质量
标准表示协议中,WLAM 平均语义分类准确率 70.75%,比 DiLA 高 7.49 个百分点;平均控制回归 MSE 0.37,比 CLAP 低 21%。CALVIN 和 VLABench 未用于训练,WLAM 仍达到 0.25 和 0.09 的 MSE。
最终 32 维 latent action 保留 67.89% 分类准确率和 0.49 MSE,均优于对比方法。
5.3 真机策略表现
WLA³ 六任务平均成功率 81.9%,π0.5 为 66.2%。WLA³ 在五个任务上更好,Trash、Eraser 和 Charger 分别提升 29.8、25.7 和 21.5 个百分点;Book 与 π0.5 相差 0.7 个百分点以内。
数据规模实验固定 WLAM、LAC-WM、结构、初始化、后训练数据和评测,只改变策略中间训练数据量。平均成功率从 5K 小时的 57.6% 提升到 10K 的 65.9% 和 20K 的 81.9%,说明共享转换表示能持续转化异构数据。
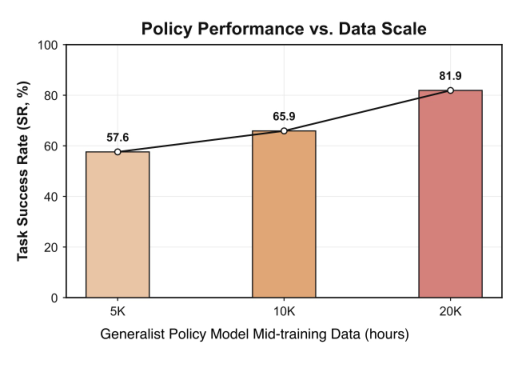
图 6:通用策略中间训练数据从 5K 增加到 20K 小时时,WLA³ 真机平均成功率持续上升。来源:论文 Figure 7。
5.4 组件消融
策略消融从 72.1% 开始:加入 LAC-WM 后 76.3%,加入 LARA 后 79.8%,再加入 SLA 后 81.9%。三个组件分别贡献 4.2、3.5 和 2.1 个百分点,说明动力学上下文、局部监督和片段级 VLM 监督互补。
WLAM 消融显示,只用主视角时分类准确率 60.54%、MSE 0.61;加入腕部视角后 64.81%、0.55;再加入本体状态达到 67.89%、0.49。去掉跨模态 dropout 降至 60.46%、0.60;去掉重叠一致性为 66.13%、0.52。
5.5 人类视频能否补充机器人数据
Eraser 任务上,完整机器人数据成功率为 75%;减少到 5% 后降为 40%。同样 5% 机器人数据下,加入任务匹配人类视频后升至 60%,恢复 35 个百分点损失中的 20 个。人类视频只提供 latent action 监督,机器人动作损失被 mask。
这个结果说明人类视频能部分补充任务相关转换监督,但不能完全替代可执行机器人动作标签。
5.6 跨本体与跨上下文
在 12 个共享动作类别上,WLAM 的 H→R 和 R→H 平均准确率 20.98%,比 DiLA 高 5.27 个百分点;H→H 和 R→R 分别为 49.38% 和 47.38%。
6. 局限与可复现性
论文提供项目主页,但未见公开代码或模型检查点;数据表包含许多公开来源和内部机器人数据,完整复现难度较大。
WLAM 主要依赖多视角 RGB 和本体状态,接触、力、深度和物体状态仍通过视觉间接推断。论文把 measured depth、触觉/力反馈、更丰富物体状态、更可靠人手轨迹和更广泛语言监督列为未来工作。
总结:让世界转换成为通用策略的共享语言
WLA³ 的核心路线是:用 WLAM 从多模态世界状态转换中学习局部动作和片段特征;用 LAC-WM 把局部动作接入物理动力学;用 SLA 把片段转换证据写入 VLM;用 LARA 联合预测 latent action 和本体特定机器人动作。
最值得带走的是:异构具身数据不一定需要统一到同一个原生动作空间,统一到"世界如何变化"也可以成为可训练的动作接口。这让人类视频、仿真、UMI 和机器人轨迹能够在不同监督粒度上协作,同时保留每个本体的可执行控制。
推荐阅读
► 技术资讯: 魔方 AI 新视界
► 项目应用:开源视界
► 技术专栏: 多模态大模型最新技术解读专栏 | AI 视频最新技术解读专栏 | 大模型基础入门系列专栏 | 视频内容理解技术专栏 | 从零走向 AGI 系列