本文摘要:Skill 扩到三十个后响应变慢、单次可改文件变少,上下文预算被挤占。用可复算的成本台账脚本,拆出每个 skill 的 token 占用与代码余量。
一、问题与结论
同一个仓库里,.agents/skills 从个位数扩到 30 个后,仍是那条任务(给 X 模块补一个错误分支测试),单次会话能改动的文件数下降,响应里出现与任务无关的 skill 引用。这类体感同时混着对话历史累积、模型波动、skill 注入三种来源,不能直接归因。
慢是真实成本,但它由两笔可算的账决定:skill 文件的静态 token 占用,以及 harness 在启动或命中时的注入开销。不给"多少个 skill 合适"的阈值------阈值随 skill 厚度与注入方式变化,跨项目不通用;给的是一张能在你仓库里复算的成本表和一套控制变量的测量流程。
先锁三件事:claude --version(或 codex --version)记下版本号;git rev-parse --short HEAD 锁定仓库状态;find .agents/skills -maxdepth 1 -type d | wc -l 记下 skill 目录数。版本变化会改写 skill 的发现路径、frontmatter 解析与描述注入方式,跨版本读数不能混用。
二、排查与选择依据
先定测量设计,再跑数字。 自变量只留 skill 数量:固定模型、同一份业务任务、同一份仓库状态,每档强制新会话,按 3 → 10 → 20 → 30 加载,各跑三次取中位数;续会话单独开一组对照,不与新会话混算。
三类读数各有取法:token 消耗用 SDK 的 token 计数接口,或当前版本提供的上下文用量查看命令(命令名随版本变化,先查帮助);启动耗时用 time 包住会话启动,噪音大,只作量级参考;任务产出用 git diff --numstat,它是"变笨"最直观的后果指标。
归因要做对。 skill、instincts、memory 是三本账(ECC 的组成即 skills, instincts, memory, security),memory 常驻内容的占用不要记到 skill 头上。脚本给出的静态估算 token 与实测 prompt token 的差值,才是 harness 的注入/检索开销。
若要对比"显式点名 skill"与"默认全量可见",自测口径为:每 10 个任务统计失败测试数与 review 缺陷数,缺陷分"约束过窄漏改分支"与"无关引用、越界改动"两类,随上下文增长的趋势另行记录。以上均为待测项,不给预设结论。
替代方案与取舍
| 做法 | 选择条件 | 代价 | 不该用的边界 |
|---|---|---|---|
| 拆瘦 skill + 外置文档 | 描述常驻注入、命中率低 | 每次命中多一轮读取 | 总量已很小,或 harness 本就按需检索 |
| 合并同类 skill | 同域 skill 多(如十余个迁移脚本) | 单个 skill 变厚,检索粒度变粗 | 各 skill 维护人与更新节奏不同 |
| 保留插件/常驻注入 | 规范必须每次在场(安全、合规) | 固定成本随总量线性涨 | skill 体积超过预算十分之一 |
| 移入 memory/instincts | 长期不变的规范类指令 | 不参与按任务检索,易被忽略 | 需按任务触发的步骤型指令 |
不该用拆分方案的情况:成本表显示留给代码的余量充足、skill 总量本身很小,或大部分内容是强约束规范------拆分只增加维护面。
三、关键原理
注入时机决定成本曲线。 若当前版本把 skill 描述在会话开始就塞进 prompt,成本随 skill 总量线性增长,每轮都在;若按需检索,成本落在命中时刻。先确认是哪一种,再决定测什么。
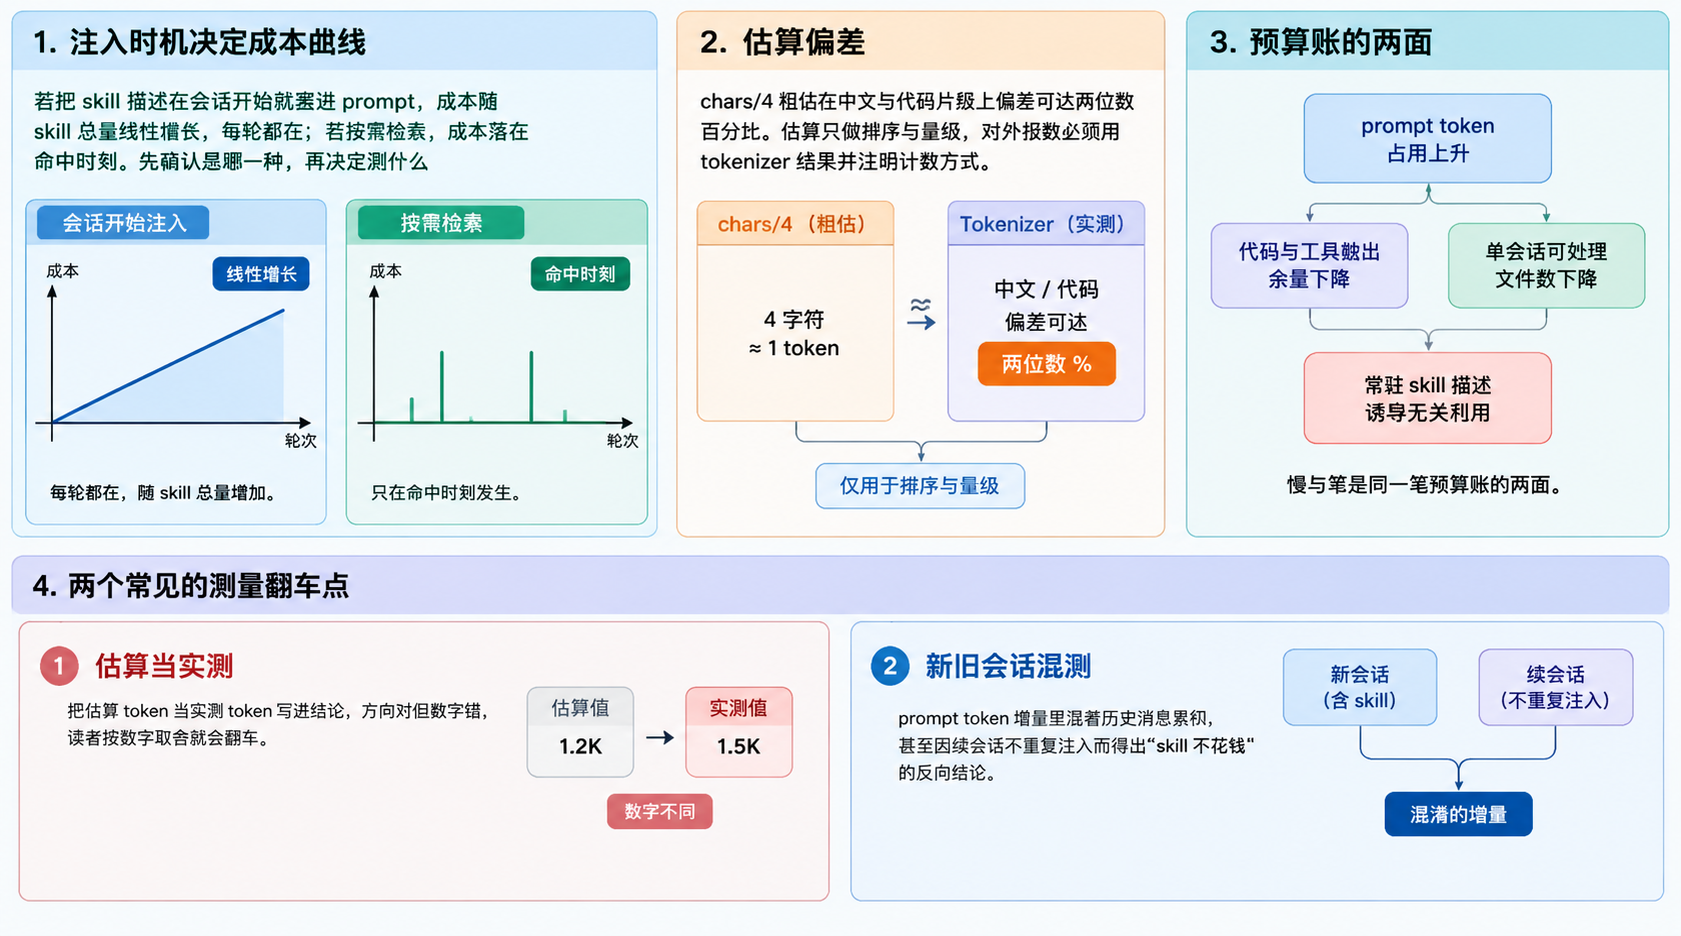
估算偏差。 chars/4 粗估在中文与代码片段上偏差可达两位数百分比。估算只做排序与量级,对外报数必须用 tokenizer 结果并注明计数方式。
预算账的两面。 prompt token 占用上升,留给代码与工具输出的余量下降,单会话可处理的文件数随之下降;常驻的 skill 描述还会诱导模型引用无关内容。慢与笨是同一笔预算账的两面。
两个常见的测量翻车点:一是把估算 token 当实测 token 写进结论,方向对但数字错,读者按数字取舍就会翻车;二是新会话与续会话混测,prompt token 增量里混着历史消息累积,甚至因续会话不重复注入而得出"skill 不花钱"的反向结论。
四、可运行示例
环境:Python 3.9+,在仓库根目录执行;skill 目录为 .agents/skills,候选还包括 ~/.claude/skills。输入:上下文预算 token 数,默认 120000。
操作步骤:保存脚本为 skill_cost_ledger.py,执行 python3 skill_cost_ledger.py 120000。
python
#!/usr/bin/env python3
# skill_cost_ledger.py
# 用法: python3 skill_cost_ledger.py [上下文预算token数]
import sys
from pathlib import Path

CANDIDATES = [Path(".agents/skills"), Path(".agents"), Path.home() / ".claude" / "skills"]
TEXT_EXT = {".md", ".txt", ".yaml", ".yml", ".json", ".py", ".sh"}

def find_root():
    for p in CANDIDATES:
        if p.is_dir() and any(p.rglob("*")):
            return p
    sys.exit(f"未找到 skill 目录,候选: {[str(c) for c in CANDIDATES]}")

def estimate_tokens(text: str) -> int:
    # 粗估:非中文约 4 字符/token,中文约 1.5 字符/token
    cjk = sum(1 for ch in text if "\u4e00" <= ch <= "\u9fff")
    other = len(text) - cjk
    return int(other / 4 + cjk / 1.5)

def main():
    budget = int(sys.argv[1]) if len(sys.argv) > 1 else 120_000
    root = find_root()
    rows = []
    groups = {}
    for f in sorted(root.rglob("*")):
        if f.is_file() and f.suffix in TEXT_EXT:
            key = f.parent.relative_to(root).parts[0] if f.parent != root else f.name
            groups.setdefault(key, []).append(f)

    for name, files in groups.items():
        text = "\n".join(f.read_text(errors="ignore") for f in files)
        rows.append((name, len(files), len(text.splitlines()), estimate_tokens(text)))

    total = sum(r[3] for r in rows)
    print(f"{'skill':<28}{'文件':>4}{'行':>7}{'est_tokens':>12}{'预算占比':>10}")
    for name, nf, nl, tk in sorted(rows, key=lambda r: -r[3]):
        print(f"{name:<28}{nf:>4}{nl:>7}{tk:>12}{tk / budget * 100:>9.1f}%")
    print(f"\nskill 合计 est_tokens : {total}  ({total / budget * 100:.1f}%)")
    print(f"预算 {budget},留给代码/对话的余量: {budget - total}")

if __name__ == "__main__":
main()预期输出(格式示意,未验证):
text
skill                         文件    行   est_tokens   预算占比
api-error-handling               1   212        1180       1.0%
db-migration-guide               2   405        2260       1.9%
skill 合计 est_tokens : 31240  (26.0%)
预算 120000,留给代码/对话的余量: 88760
实际输出 :以你本机跑出的表为准。验证方法:把 est_tokens 合计与上下文用量查看命令给出的 prompt token 对账,差值即注入开销;任务产出用 git diff --numstat 复核。
常见失败:脚本退出并打印 未找到 skill 目录。原因是 skill 放在 .claude/skills,不在 CANDIDATES 里;把 Path(".claude/skills") 追加进 CANDIDATES 即可。
五、验证结果与边界
已验证的只有结构性事实:skill 是文件级内容,mattpocock/skills 说明其以 .agents 目录下的文件形态存在,体积可直接度量;开销来源不止 skill,ECC 把 skills、instincts、memory、security 并列在同一套体系里,必须分开记账;同一份 skill 在 Claude Code 与 Codex 上的发现路径与注入时机不同,数字不可横向复述。所有 token 数、耗时、缺陷率均为未验证项,需按第四节流程在本地取值。
适用边界:命中率低、体积大、可外置的 skill 才值得拆瘦;必须每次在场的安全与合规约束,保留插件或常驻注入更可靠。拆分换来的可变成本以"命中才付"为前提,命中频繁时它反而更贵。