接连用 Flash 3.5 到 3.8 系列忽悠了用户半年多,迟迟没有更新正统旗舰的谷歌,紧随 Muse Wonder 之后,终于把压箱底的 Gemini 4 抬上来了。在开启小范围灰度测试两周后,Gemini 4 Argon 正式面向全球上线。(合理怀疑是感受到了 Meta 的威胁)
Argon 原意为氩气,无色无味且化学性质极其稳定,常年在精密焊接和半导体制造中充当惰性保护屏障。谷歌以氩气(Argon)命名新旗舰,看来是不再纠结于日常对话技巧的噱头,而是通过压低推理成本、拉长有效上下文、强化代码与物理空间推演,让大模型扎扎实实进入工业级代码库与复杂生产管线。而谷歌 AI 团队直言,这款模型的设计初衷就是接手那些耗时长、步骤繁琐、容错率极低的工业级难题。
走出实验室,先在谷歌内部啃硬骨头
不同于过去偏向聊天闲聊的产品节奏,Gemini 4 Argon 的重心全盘押在真实世界的长流程任务上,覆盖深层编程、金融审计、法务推演、网络防御以及前沿科研。
关键评测榜单全面领跑
在衡量关键商业任务表现的 Vals Index 评测中,Argon 拿下了综合第一。第三方机构 Artificial Analysis 的测试也显示,开启 high 推理档位后,Argon 取得 53 分,追平了 Claude Fable 5.1 与 GPT-6 Astra 的最高档位表现。在考察自主执行链条的 Agent Arena 榜单里,Argon 同样挤进了全球前五。
| 评测基准 | 官方公布成绩 | 对应技术能力 |
|---|---|---|
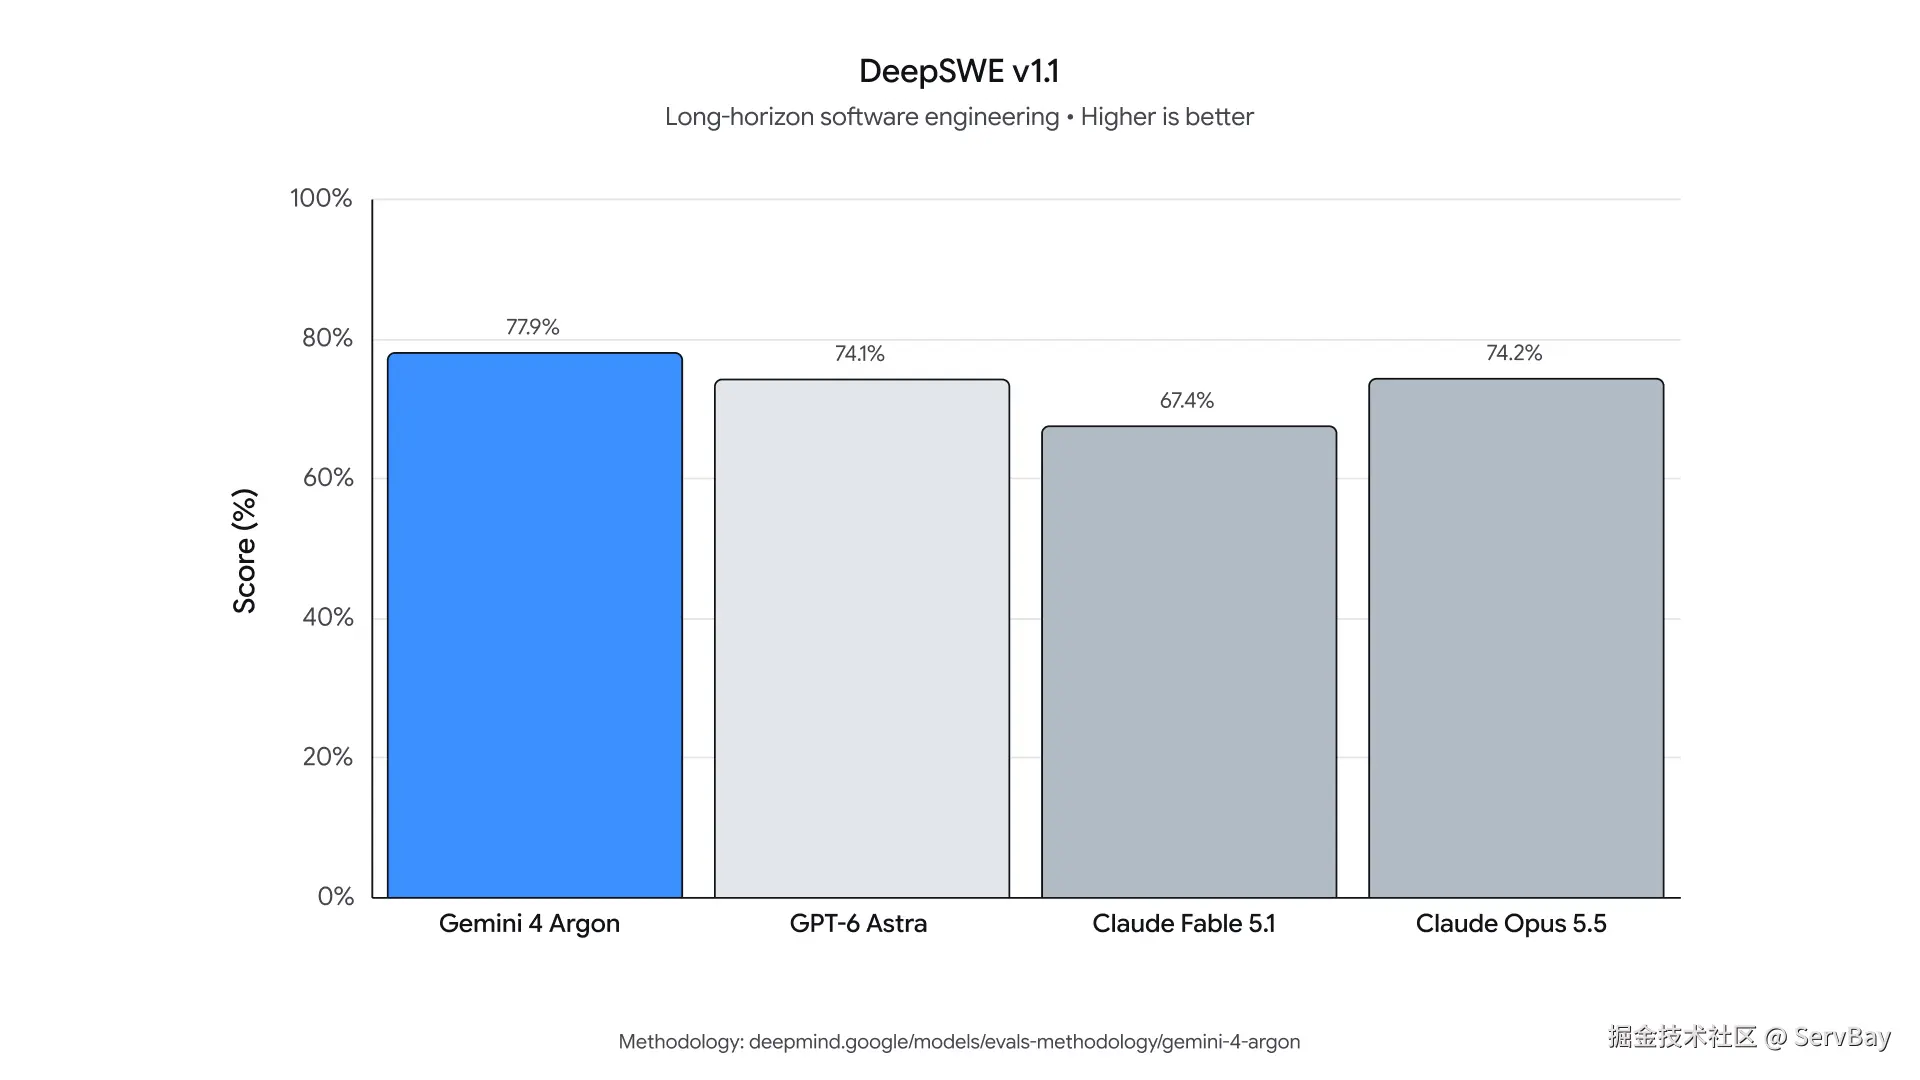
| DeepSWE v1.1 | 77.9% | 真实复杂软件工程与长代码编辑 |
| AutomationBench | 51.3% | 核心业务流程全自动端到端执行 |
| LVBench | 91.7% | 极长视频跨时段细节提取与理解 |
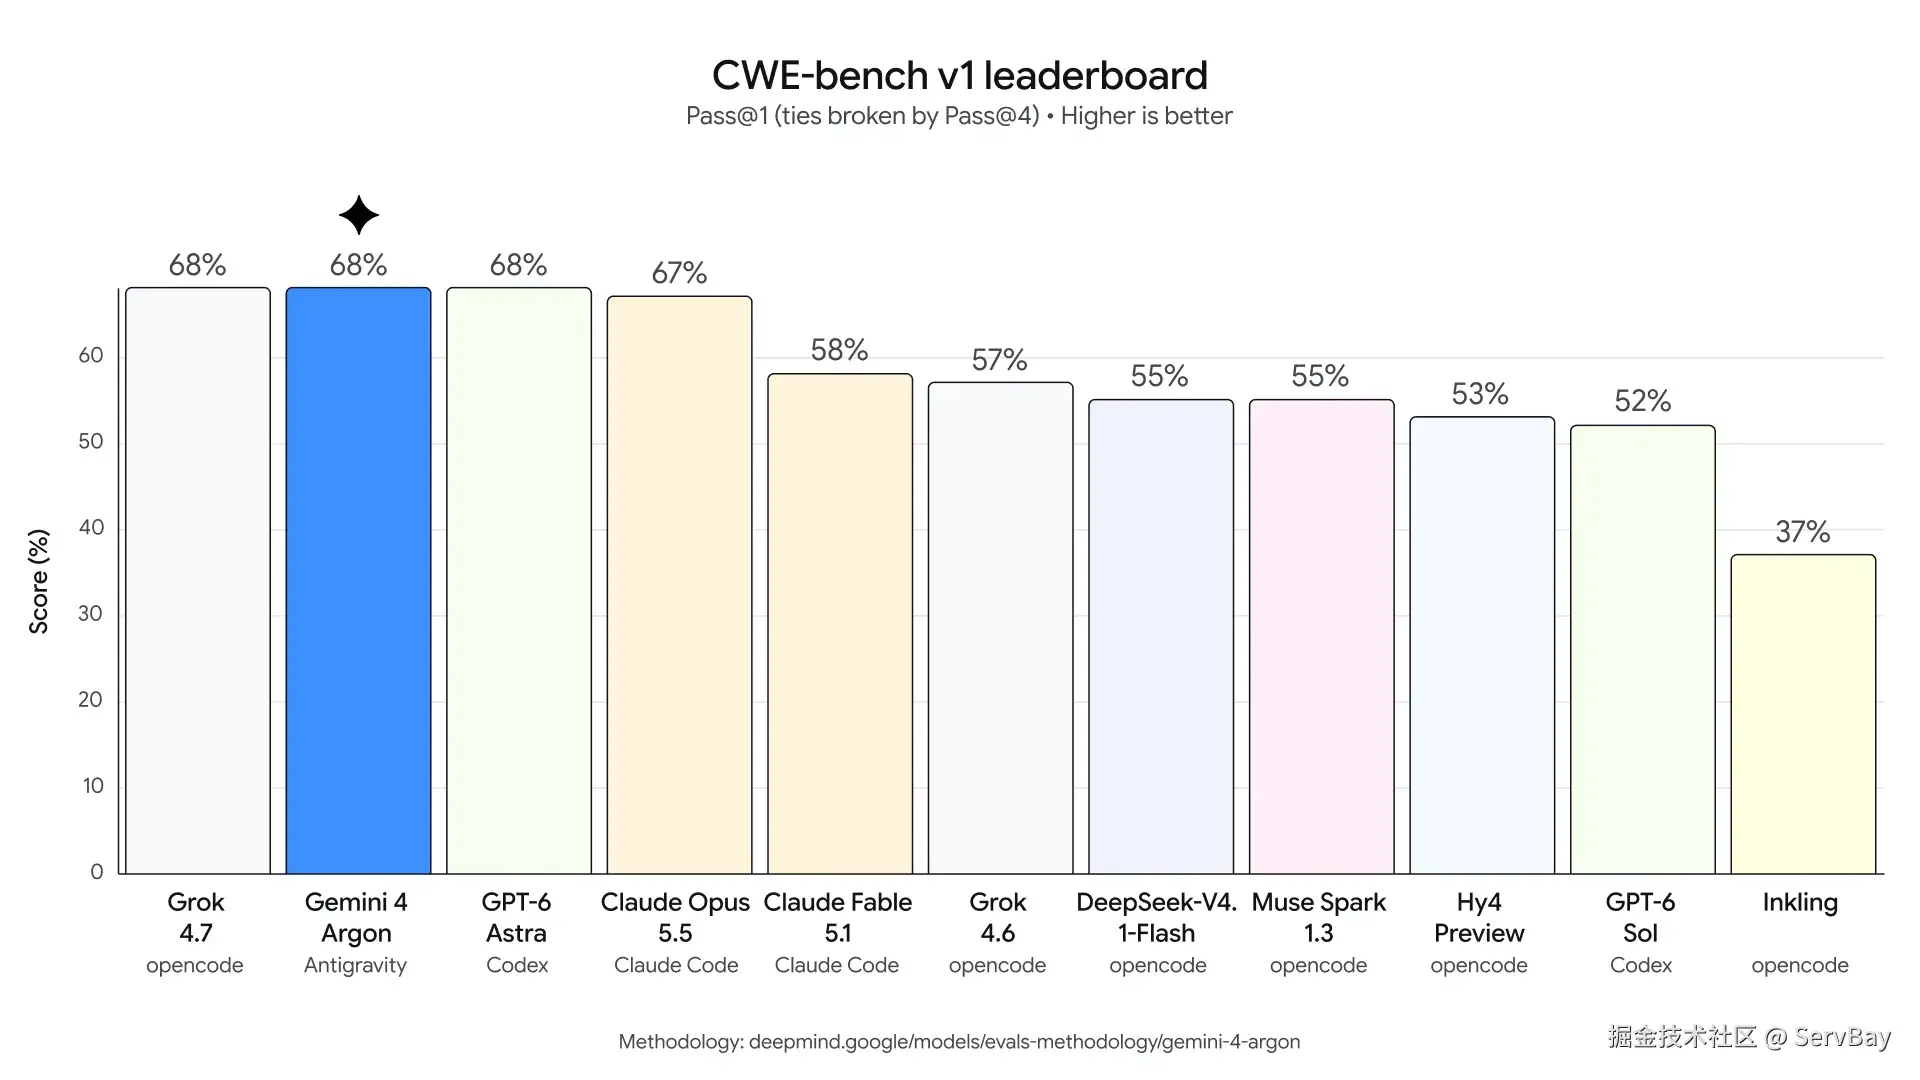
| CWE-bench v1 | 68.0% | 软件高危安全漏洞自主定位与修补 |
内部真实代码库的极限重构
比起榜单数字,谷歌内部工程团队提供的数据更具说服力。过去几周里,借助 Antigravity 平台接入 Argon,谷歌工程师的智能体代码提交量增长超过 35%,代码回滚率下降了近三分之一。
在实际重构场景中,Chrome 团队用它在数周内完成了 4000 万行历史代码库中 600 万行旧代码的重构,彻底修补了一类长期困扰浏览器的底层崩溃问题。在仅给定基础规则的情况下,模型在夜间自主重写了智能体框架 ADK 的内存调度逻辑,把长会话初始化时间缩短了 40%;随后又在几天内将开源小模型 Gemma 4 E2B 的端到端推理速度提升 2.85 倍,全程没有出现精度损失。
统一百万上下文与长生成机制
为了承载这类重型计算,谷歌提供了统一的 100 万 Token 上下文窗口。需要看清的是,输入内容、模型思考过程与最终输出共享这 100 万配额。输入资料塞得越满,预留给模型深思和写代码的空间就越小。单次标准调用的生成上限为 65,536 Tokens,如果需要一次性吐出几十万行工程代码,必须启用 long decode 机制或走后台异步的 Interactions API。
全网实测有惊艳也有短板,性价比直接上强度
模型开放之后,全球开发者在 3D 渲染、物理仿真和代码构建上展开了密集测试。
3D 空间构建、物理仿真与具身智能
在空间推理实测中,博主 Bhavy 展示了一个无需任何外部 3D 模型素材、纯靠数学代码在单个浏览器文件里跑起来的阳光书房,室内光线漫反射与远景山脉清晰规整。开发者 Adit_Yah 测试的微缩海岛树脂块,耗时 13 分钟、消耗 2% 的周配额,就做出了带有真实折射与波浪物理效果的交互界面。
在复杂综合任务拆解上,投资人 Justine Moore 在没有提供任何图文素材的前提下,让 Argon 制作一个苹果电脑博物馆网页。模型自主检索历史档案,自己写脚本清理旧图片,拉取半个世纪的硬件参数,最终搭出一个页面样式随年代滑动自动变形的 3D 封面流展示站。
在具身智能领域,模型仅凭观看人类抛掷沙包的实录视频,在几个小时内计算出受力关节轨迹并生成控制代码,部署到 Apollo 人形机器人上实现了真机实操连续七次投中。
速度与生成费用的正面交锋
与其他主流模型的对比,把 Argon 的运行速度和价格的优点展现得淋漓尽致。
AIHubmix 团队使用完全相同的提示词,让 Gemini 4 Argon 和 GPT-6 Astra 生成像素风古建筑夜景。GPT-6 Astra 耗时 25 分钟,花费 11 美元;Argon 用了 3 分钟跑完,花费 0.5 美元,色彩过渡与光影细节毫不逊色。在制作解释电动机工作原理 3D 动画的测试中,Argon 单次生成费用为 3.83 美元,远低于 Claude Opus 5.5 的 16.36 美元。
复杂生物模型短板与算力收紧门槛
不过,初代上线的 Argon 并不是各处都讨喜。测试机构 AI/ML API 在进行复杂生物模型生成对比时指出,Argon 虽然调用花费低,但在还原复杂有机生物的皮肤纹理与骨骼动态上,相比 GPT-6 仍有粗糙感。
同时,高强度推理带来的算力开销让谷歌收紧了闸门。免费用户目前默认被导流给极轻量的 Flash-Lite 模型;Gemini 网页端也启用了 5 小时动态刷新机制并挂钩每周上限。调高思考档位会急剧拉升配额消耗,想无所顾忌地调用满血能力,最终逃不开按量付费的 API 账单。
云端神仙打架,本地开发该怎么接?
模型能力再强,最终必须落回开发者的实际终端里。但在日常工程落地时,开发者总会撞上一道隐形墙:各家模型的协议完全不互通。
Codex 只认 OpenAI Responses 协议,Claude Code 锁死 Anthropic Messages 协议,Gemini 官方又是一套独立的 SDK。开发者手里拿着各家官方 Key、企业订阅号和第三方备用中转,换一个模型往往要把配置文件甚至底层请求逻辑改个底朝天;更不用提开发复杂智能体时,必须在本地起数据库、配 HTTPS、频繁遇到 429 报错中断的烦躁。
让各种智能体顺畅调用新模型,关键在于把机器本地的底座搭扎实。ServBay 正是为此设计的全功能本地底座,不仅一次性通好开发所需的水电煤,更自带全功能的本地 AI 网关。
配置超级简单,填入一把 Key,设置就完成了。
- 双向协议互转,所有客户端无脑使用:不论上层工具是 Codex、Claude Code 还是终端里的开源 Agent,也不管发出来的是 OpenAI 格式还是 Anthropic 格式,ServBay 本地网关几头通吃,在本地毫秒级双向转译。流式推送、函数调用与思考过程完整保留,下游应用不用改动代码,直接把 Gemini 4 Argon 当成原生模型来跑。
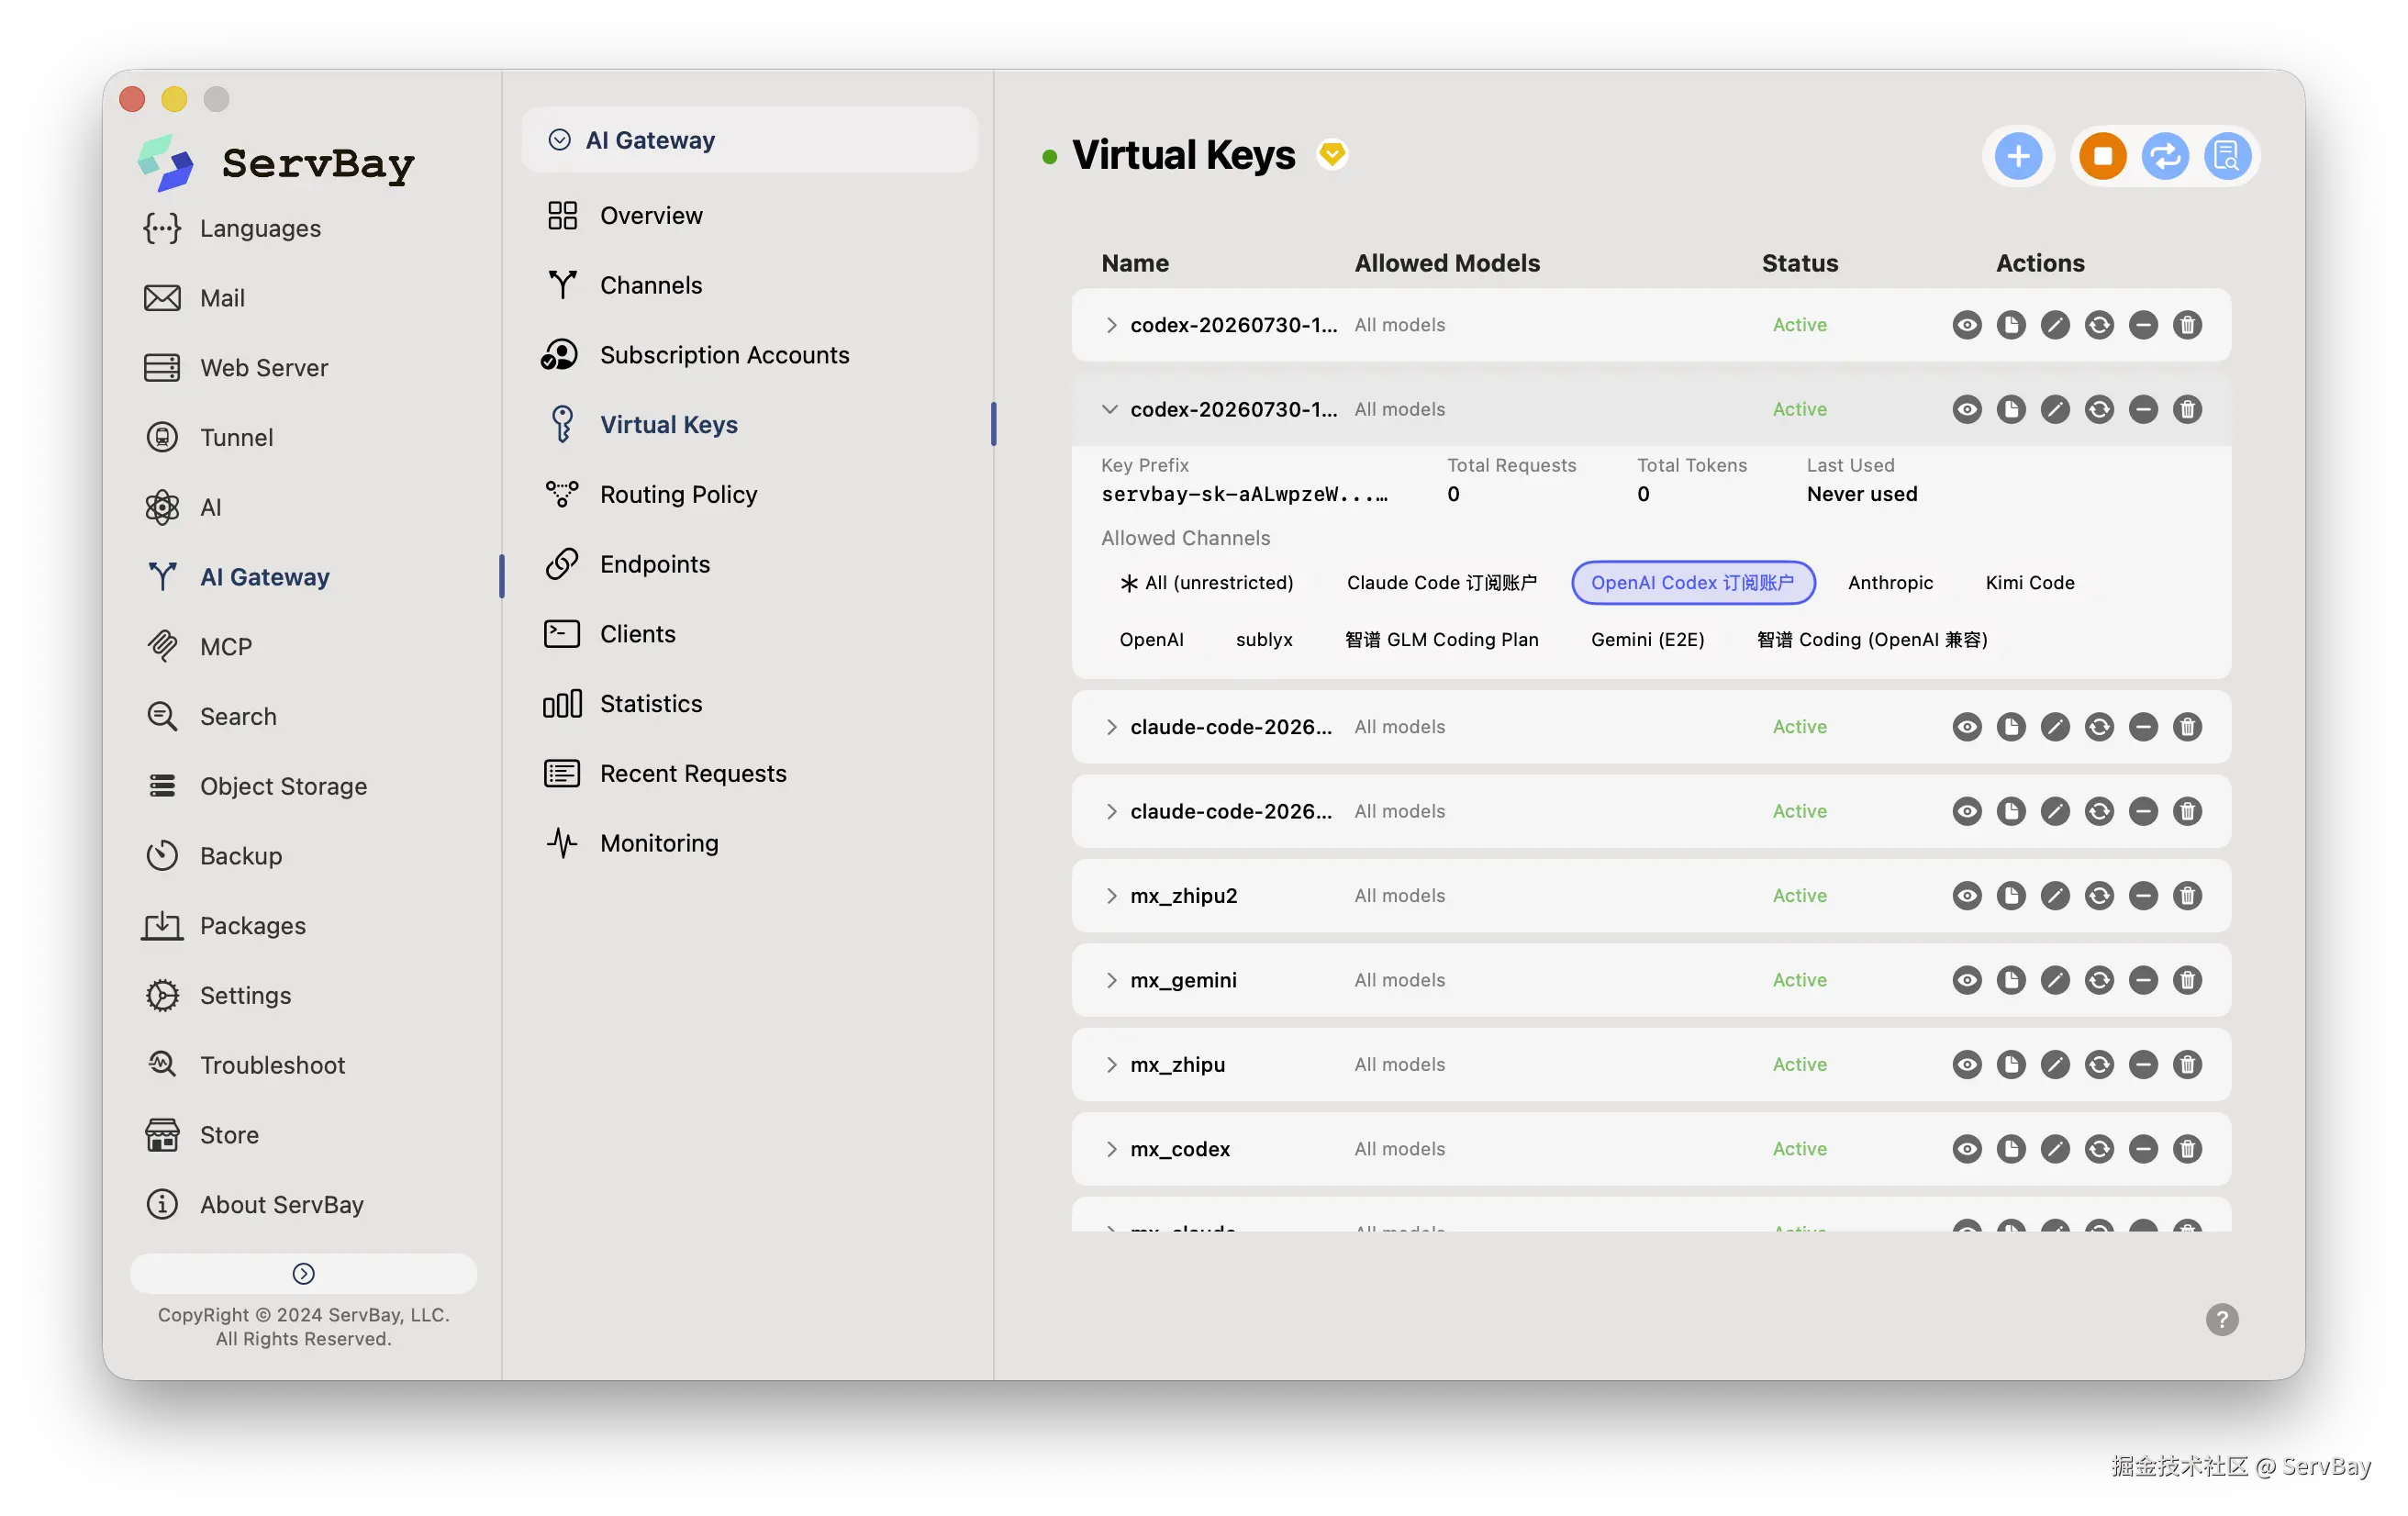
- 钥匙不出本机,各项目虚拟隔离:主 Key 留在本地加密保险柜,从不写入系统环境变量。开发者可以给不同的业务项目生成独立的本地虚拟 Key,单独划分预算、统计 Token 消耗和延迟数据。某把虚拟 Key 不慎泄露,点一下作废即可,主号毫无风险。可以把你所有订阅过的账号通通集中在一起,一把钥匙搞定。
-
智能调度与静默故障转移:支持把 Google 官方 API、Claude 订阅号、Ollama 本地模型与各种中转线路全部挂载进来。官方接口遭遇 429 限流或报错时,网关按照厂商规定的冷却时间静默退避,请求立刻无感转给备用渠道重试。改道在毫秒间完成,智能体终端一个报错都看不到。
-
本地环境即时闭环校验:Argon 编写的数据库操作脚本或后端代码,需要真实的运行环境来检验。ServBay 本地预置了 50 多种语言运行时与数据库,PHP、Node.js、Python、Go、MySQL、Redis 开箱即用。智能体改完代码,直接在本地沙盒起服务跑测试,发现报错即时自我修复,彻底形成研发闭环。
双向协议实时转译与静默故障转移
Codex 只认 OpenAI 协议,Claude Code 只认 Anthropic 协议。ServBay 本地网关两头通吃,在本地毫秒级实现双向转译。流式响应、函数调用与思考过程完整保留,下游应用不用改动代码,直接把 Gemini 4 Argon 当成原生兼容接口来调用。
bash
# 统一本地网关入口,各家客户端无脑调用
curl http://127.0.0.1:3425/v1/chat/completions \
  -H "Authorization: Bearer sk-local-servbay-key" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-4-argon",
    "messages": [{"role": "user", "content": "重构本地服务的数据库连接池配置"}],
    "stream": true
  }'
网关支持把 Google 官方 API、Claude 订阅号、Ollama 本地模型与各种中转线路全部挂载进来。官方接口遭遇 429 限流或网络异常时,网关按照厂商规定的冷却时间静默退避,请求立刻无感转给备用渠道重试。改道在毫秒间完成,智能体终端一个报错都看不到,长程任务绝不会中途溃退。
钥匙不出本机与本地闭环即时验证
真实的主 Key 留在本地加密保险柜,从不写入系统环境变量。开发者可以给不同的业务项目生成独立的本地虚拟 Key,单独划分预算、统计 Token 消耗和延迟数据。某把虚拟 Key 不慎泄露,点一下作废即可,主号毫无风险。
Argon 编写的数据库操作脚本或后端代码,需要真实的运行环境来检验。ServBay 本地预置了 50 多种语言运行时与数据库,PHP、Node.js、Python、Go、MySQL、Redis 开箱即用。智能体改完代码,直接在本地沙盒起服务跑测试,发现报错即时自我修复,彻底形成研发闭环。
计费明细与选型决策
Gemini 4 Argon 采用阶梯式定价,首发阶段采取了极具攻击性的价格策略。
| 计费周期 / 规格 | 每百万输入 Tokens | 每百万输出 Tokens | 缓存输入折扣 |
|---|---|---|---|
| 推广优惠期(截至 2026 年 11 月 30 日) | $2.00 | $10.00 | 95% 折扣($0.10/M) |
| 正式商业定价(2026 年 12 月 1 日起) | $4.00 | $20.00 | 95% 折扣($0.20/M) |
在实际工程核算中,深度推理会生成数万甚至数十万的思维链与代码,输出费用的占比远高于输入端。借助 ServBay 网关的本地监控面板,团队能够清楚看到每一个虚拟 Key 的具体花销,避免自动化任务陷入死循环把余额烧穿。
那什么时候选择Gemini 4 Argon最具性价比》
-
优先选型的场景:涉及数万行跨文件代码重构、跨文档交叉审计、数十分钟长视频信息检索,以及需要长时间运行、自主纠错的复杂智能体。
-
建议避开的场景:毫秒级单轮问答、常规文本翻译或轻量数据提取。这类需求交给低延迟小模型处理,速度更快,成本也低得多。
总结
AI 行业的竞争正在告别单纯的跑分秀,转向工程实效。Gemini 4 Argon 凭借扎实的推理深度、100 万上下文以及激进的定价,证明了自己在大规模代码重写与复杂推演中的硬核价值。
上层模型负责深度推演,底层基础设施负责平稳承托。通过 ServBay 筑牢本地开发底座,借助本地 AI 网关抹平 OpenAI 与 Anthropic 的协议鸿沟,让密钥安全留存、渠道静默容灾,前沿推理模型才能真正告别玩具属性,在开发者的日常生产管线中稳定运转。