目录
[1.1 什么是线程](#1.1 什么是线程)
[1.2 进程和线程的关系](#1.2 进程和线程的关系)
[1.3 线程的优点](#1.3 线程的优点)
[1.4 线程的缺点](#1.4 线程的缺点)
[1.5 线程异常](#1.5 线程异常)
[1.6 线程用途](#1.6 线程用途)
[2.1 测试代码](#2.1 测试代码)
[2.2 引入pthread库](#2.2 引入pthread库)
[2.3 线程控制的接口](#2.3 线程控制的接口)
[2.3.1 创建线程](#2.3.1 创建线程)
[2.3.2 线程等待](#2.3.2 线程等待)
[2.3.3 线程终止](#2.3.3 线程终止)
[2.3.3.1 return](#2.3.3.1 return)
[2.3.3.2 pthread_exit](#2.3.3.2 pthread_exit)
[2.3.3.3 pthread_cancel](#2.3.3.3 pthread_cancel)
[2.3.4 线程分离](#2.3.4 线程分离)
[2.3.5 多线程编程实战](#2.3.5 多线程编程实战)
[4.1 情况1:不分离](#4.1 情况1:不分离)
[4.2 情况2:启动之前分离](#4.2 情况2:启动之前分离)
[4.3 情况3:启动之后分离](#4.3 情况3:启动之后分离)
一、Linux线程概念
1.1 什么是线程
- 在一个程序里的一个执行路线就叫做线程(thread)。更准确的定义是:线程是"一个进程内部的控制序列"
- 一个进程至少都有一个执行线程
- 线程在进程内部运行,本质是在进程地址空间内运行
- 在Linux系统中,在CPU眼中,看到的PCB都要比传统的进程更加轻量化
- 透过进程虚拟地址空间,可以看到进程的大部分资源,将进程资源合理分配给每个执行流,就形成了线程执行流
进程:内核数据结构+代码和数据(执行流)。
线程:是进程内部的一个执行分支(执行流)。
从内核和资源的角度:
进程:承担分配系统资源的基本实体
线程:CPU调度的基本单位
程序运行后,相关的代码和数据会被 load 到内存中,然后操作系统为其创建对应的**PCB** 数据结构、生成虚拟地址空间、分配对应的资源,并通过页表建立映射关系
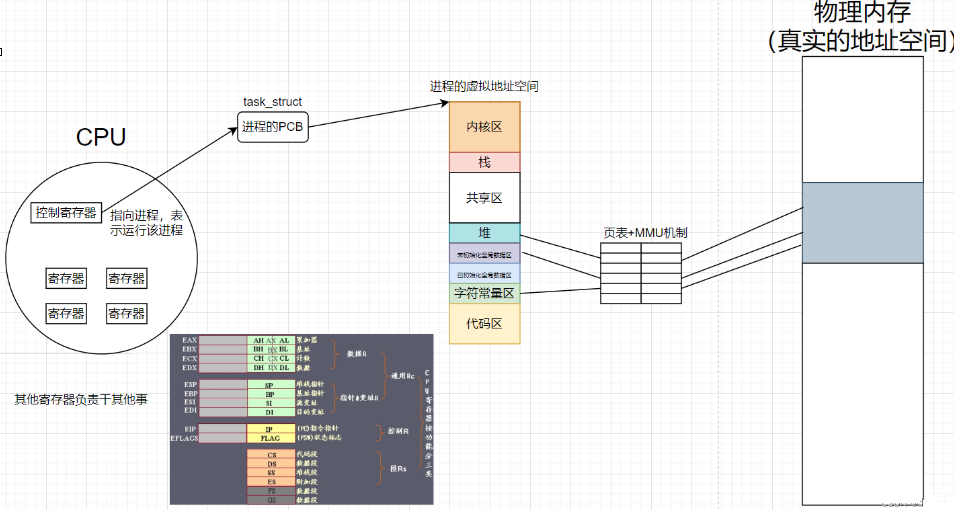
- 即使是 父子进程,他们也有各自的 虚拟地址空间、映射关系、代码和数据(可能共享部分数据,出现修改行为时引发 写时拷贝机制)
- 如果我们想要创建 其他进程 执行任务,那么 虚拟地址空间、映射关系、代码和数据 这几样东西是必不可少的,想象一下:如果只有进程的概念,并且同时存在几百个进程,那么操作系统调度就会变得十分臃肿
- 操作系统在调度进程时,需要频繁保存上下文数据、创建的虚拟地址空间及建立映射关系
线程的出现
- 为了避免这种繁琐的操作,引入了 【线程】 的概念,所谓 【线程】 就是:额外创建一个 task_struct 结构,该 task_struct 同样指向当前的虚拟地址空间,并且不需要建立映射关系及加载代码和数据,如此一来,操作系统只需要 针对一个 task_struct 结构即可完成调度,成本非常低
为什么【切换进程】比 【切换线程】 开销大得多?
- 在 CPU 内部包括:运算器、控制器、寄存器、MMU、硬件级缓存(cache),其中 硬件级缓存 cache 又称为 高速缓存,遵循计算机设计的基本原则:局部性原理,会预先加载 部分用户可能访问的数据 以提高效率。
- 如果【切换进程】,会导致 高速缓存 中的数据无法使用(进程具有独立性),重新开始 预加载,这是非常浪费时间的(对于 CPU 来说)。
- 但【切换线程】就不一样了,因此线程从属于进程,切换线程时,所需要的数据的不会发生改变,这就意味值 高数缓存 中的数据可以继续使用,并且可以接着 预加载 下一波数据
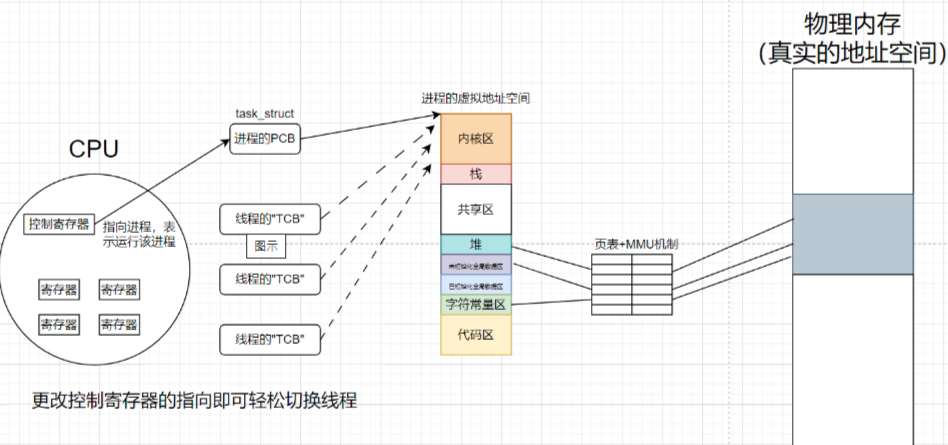
进程(
process) 的task_struct称为PCB,线程(thread) 的task_struct则称为TCB
- 从今天开始,无论是 【进程】 还是 【线程】 ,都可以称为 执行流 ,线程 从属于 进程 :当进程中只有一个线程时,我们可以粗粒度的称当前进程为一个单独的执行流;当进程中有多个线程时,则称当前进程为多执行流,其中每一个执行流就是一个个的线程
总结:执行流的调度由操作系统负责,CPU 只负责根据 task_struct 结构进行计算
- 若下一个待调度的执行流为一个单独的进程,操作系统仍需创建
PCB及 虚拟地址空间、建立映射关系、加载代码和数据 - 但如果下一个待调度的执行流为一个线程,操作系统只需要创建一个
TCB,并将其指向已有的虚拟地址空间即可
1.2 进程和线程的关系
- 【进程】是 承担系统资源分配的实体 ,比如 程序运行必备的:虚拟地址空间、页表映射关系、相关数据和代码 这些都是存储在 进程 中的,也就是我们历史学习中 进程 的基本概念
- 【线程】是 CPU 运行的基本单位,程序运行时,CPU 只认 task_struct 结构,并不关心你是 【线程】 还是 【进程】,不过,线程 包含于 进程 中,一个 进程 可以只有一个 线程,也可以有很多 线程,当只有一个 线程 时,通常将其称为 进程,但对于 CPU 来说,这个 进程 本质上仍然是 线程;因为 CPU 只认 task_struct 结构,并且 PCB 与 TCB 都属于 task_strcut,所以才说 线程是 CPU 运行的基本单位
总结:
- 【进程】是由操作系统将程序运行所需地址空间、映射关系、代码和数据打包后的资源包
- 【线程/轻量级进程/执行流 】则是利用资源完成任务的基本单位
线程包含于进程中,进程本身也是一个线程
我们之前学习的进程概念是不完整的,引入线程之后,可以对进程有一个更加全面的认识
通常将程序启动,比如 main 函数中的这个线程称为 主线程 ,其他线程则称为 次线程
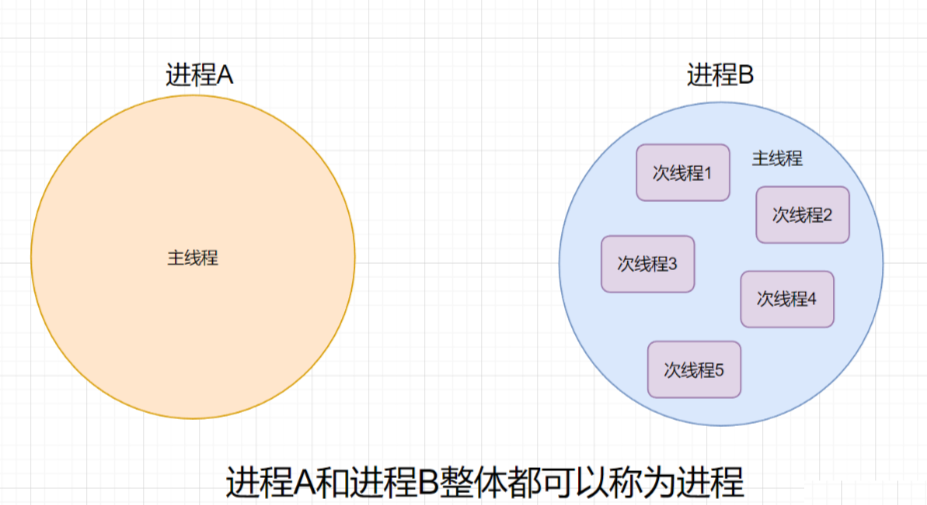
实际上 进程 = PCB + TCB + 虚拟地址空间 + 映射关系 + 代码和数据,这才是一个完整的概念
以后谈及进程时,就要想到 一批执行流+可支配的资源
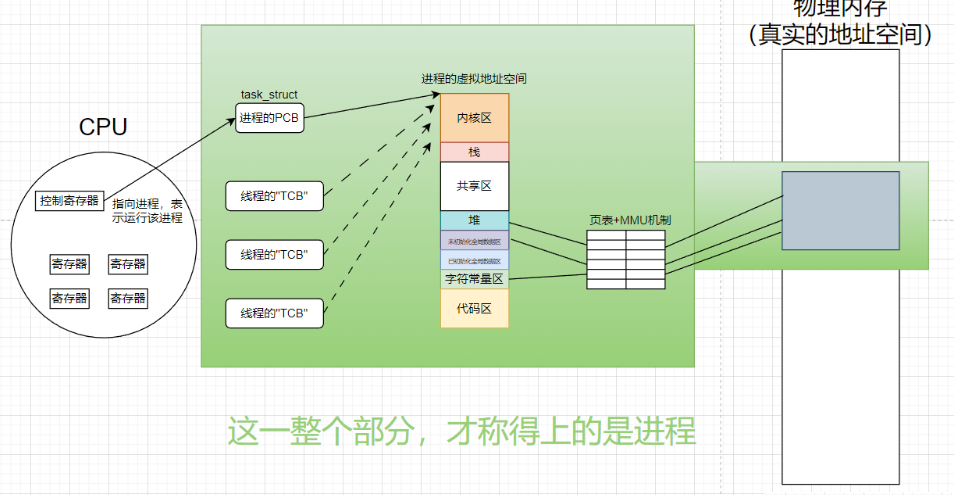
【进程】与【线程】的概念并不冲突,而是相互成就
- 在 Linux 中,认为 【PCB】 与 【TCB】 的共同点太多了,于是直接复用了 PCB 的设计思想和调度策略,在进行 【线程管理】 时,完全可以复用 【进程管理】 的解决方案(代码和结构),这可以大大减少系统调度时的开销,做到 小而美,因此 Linux 中实际是没有真正的 线程 概念的,有的只是复用 PCB 设计思想的 TCB
- 在这种设计思想下,【线程】 注定不会过于庞大,因此 Linux 中的 线程 又可以称为 轻量级进程(LWP),轻量级进程 足够简单,且 易于维护、效率更高、安全性更强,可以使得 Linux 系统不间断的运行程序,不会轻易 崩溃
在Linux系统中,所有的执行流都被称为轻量级进程 (Lightweight Process,LWP),实际上就是操作系统概念中的线程。在Linux中,线程和进程的区别并不是很明显,因为Linux将线程实现为与进程相似的实体,即轻量级进程。
在Linux中,每个【轻量级进程】(线程)都对应一个task_struct结构体,操作系统通过调度算法选择下一个要执行的轻量级进程,而不关心这个task_struct属于哪个进程,或者是属于一个进程的其中一个线程。
因此,在Linux中,CPU调度的实际执行单元是轻量级进程(线程),而不是进程。每个轻量级进程都有自己的执行流,可以独立执行代码,拥有独立的栈空间和寄存器状态。多个轻量级进程可以共享一个进程的资源,实现并发执行。
1.3 线程的优点
- 线程 最大的优点就是 轻巧、灵活,更容易进行调度
- 创建一个线程的代价比创建一个进程的代价要小得多
- 最主要的区别是线程的切换虚拟内存空间依然是相同的,但是进程切换是不同的。这两种上下文切换的处理都是通过操作系统内核来完成的。内核的这种切换过程伴随的最显著的性能损耗是将寄存器中的内容切换出。
- 另外一个隐藏的损耗是上下文的切换会扰乱处理器的缓存机制。简单的说,一旦去切换上下文,处理器中所有已经缓存的内存地址一瞬间都作废了。还有一个显著的区别是当你改变虚拟内存空间的时候,处理的页表缓冲TLB(快表)会被全部刷新,这将导致内存的访问在一段时间内相当的低效。但是在线程的切换中,不会出现这个问题,当然还有硬件cache。
- 调度线程比调度进程要容易得多
- 线程占用的系统资源远小于进程
- 可以充分利用多处理器的并行数量(进程也可以)
- 在等待慢速 IO 操作时,程序可以执行其他任务(比如看剧软件中的 "边下边看" 功能)
- 对于计算密集型应用,可以将计算分解到多个线程中实现(比如 压缩/解压 时涉及大量计算)
- 对于 IO密集型应用,为了提高性能,将 IO操作重叠,线程可以同时等待资源,进行 高效IO(比如 文件/网络 的大量 IO 需要,可以通过 多路转接 技术,提高效率)
- 线程 的合理使用可以提高效率,但 线程 不是越多越好,而是 合适 最好,让每一个线程都能参与到计算中
1.4 线程的缺点
- 性能损失,当 线程 数量过多时,频繁的 线程 调度所造成的消耗会导致 计算密集型应用 无法专心计算,从而造成性能损失
- 健壮性降低,在一个多线程程序里,因时间分配上的细微偏差或者因共享了不该共享的变量而造成不良影响的可能性是很大的,换句话说线程之间是缺乏保护的
- 缺乏访问控制,进程是访问控制的基本粒度,在一个线程中调用某些OS函数会对整个进程造成影响
1.5 线程异常
- 单个线程如果出现除零,野指针问题导致线程崩溃,进程也会随着崩溃
- 线程是进程的执行分支,线程出异常,就类似进程出异常,进而触发信号机制,终止进程,进程终止,该进程内的所有线程也就随即退出
1.6 线程用途
- 进程:适合用于多任务、多用户的独立应用,如操作系统中的服务程序、独立的应用程序等。
- 线程 :适合用于需要并行执行 、共享大量数据的任务,如服务器的多线程处理、实时图像处理等。
二、Linux线程控制
在linux操作系统之中,如果想要创建多线程,必须使用一个第三方库来创建多线程,如下所示:
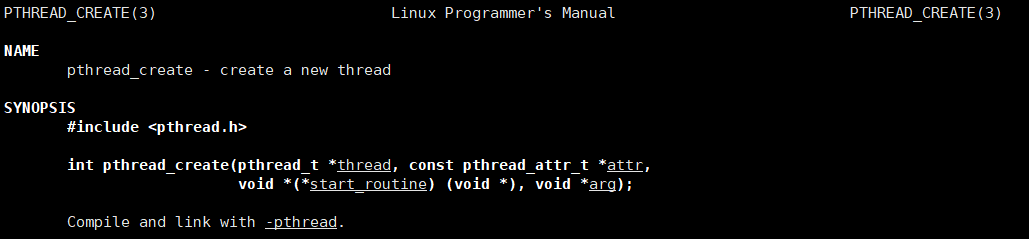
这个函数的作用是创建一个新的线程。
第一个参数:线程id,是一个输出型参数。
第二个参数:线程属性,可以设置为nullptr。
第三个参数:返回值为void*,参数为void*的函数指针。
第四个参数:传递给函数的参数。
2.1 测试代码
cpp
#include <iostream>
#include <string>
#include <pthread.h>
#include <unistd.h>
void *threadrun(void *args)
{
    std::string name = (const char *)args;
    while (1)
    {
        std::cout << "我是新线程:name:" << name << std::endl;
        sleep(1);
    }
    return nullptr;
}
int main()
{
    pthread_t tid;
    pthread_create(&tid, nullptr, threadrun, (void *)"thread_1");

    while (1)
    {
        std::cout << "我是主线程" << std::endl;
        sleep(1);
    }
    return 0;
}
运行如下所示:
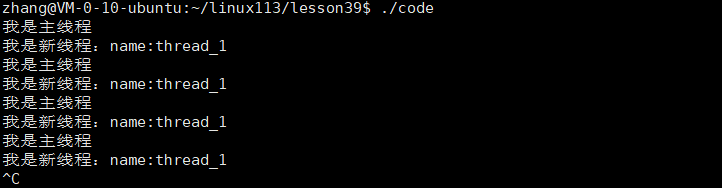
当代码执行到pthread_create之后,此时进程之中就会多一个执行流了,也就会多一个线程。主线程继续往下执行,新线程去执行threadrun函数。
上面代码有两个死循环,而我们没有使用fork来创建多个进程来执行。此时是单进程的情况下,两个循环同时运行,在以前的代码不创建子进程是不可能同时运行的。所以能绝对证明是两个线程。
使用ps -axj | head -1&& ps -axj | grep code1来查看进程,如下所示:

发现确实只有一个进程在运行。
当我们按下 ctrl+c可以发现两个线程同时结束运行。所以说信号的处理动作是所有线程共享的。
我们可以使用ps -aL来查看线程,如下所示:
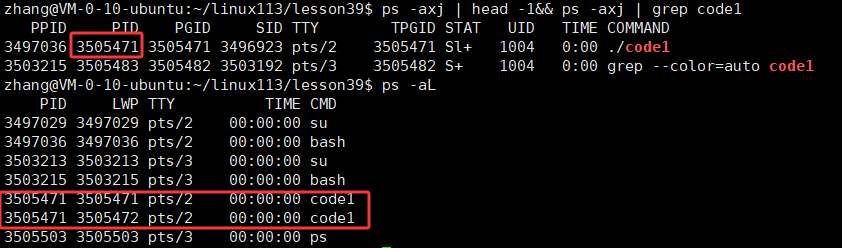
我们可以发现这两个线程的PID是一样的。就证明了即使是两个执行流,这两个线程也是属于同一个进程。
LWP叫做light weight process,也叫做轻量级进程。两个线程的LWP号不一样,这也就证明了我们的进程内部存在两个轻量级进程,他们的编号为3505471,3505472。上面一个进程是主进程,因为我们没有执行pthread_create的时候,只有一个进程,所以PID和LWP是一样的。从这里也可以看出来,在linux中,创建一个轻量级进程,相当于创建了一个PCB。只不过为了维护进程之间的关系,PCB里面不仅需要包含pid也需要包含LWP。
所以cpu调度的时候,看的是LWP。
1:关于调度时间片的问题:
当我们创建新线程的时候,系统里面是多了一个轻量级进程的,那么我们需要为这个进程需要重新分配时间片嘛?是不需要的,一个进程内部的轻量级进程(线程)是共享时间片的。也就是两个线程会等分时间片。
2:任何一个线程都会导致整个进程崩溃。
在多线程这里,一个线程会影响另一个线程。
而在多进程这里,一个进程不会影响另一个进程。
2.2 引入pthread库
在linux系统下,创建一个线程,为什么会有一个库,这个库是什么东西?
linux系统中,不存在正在意义上的线程,他所谓的概念,是使用轻量级进程模拟的,在linux中,只有轻量级进程。所谓模拟线程,是我们用户的说法。所以linux只会给你提供创建轻量级进程的系统调用。比如说vfork函数,他就是创建轻量级进程的系统调用。
Linux系统只存在轻量级进程,所以它在创建子进程的模式上,无非就两种,一种就是把整个进程拷贝,第二种就是创建轻量级进程,虚拟地址空间不变,pcb拷贝一份。所以操作系统并不会给我们用户提供创建线程的接口。
作为用户,我们只认识线程,因为所有的操作系统教材只会讲线程,教我们使用线程,创建线程等等。用户根本不考虑linux操作系统当中还有轻量级进程这么回事。
但是在操作系统层面上它只提供创建轻量级进程的接口,用户说我不懂轻量级进程,我只认线程。所以在linux系统中,使用线程,操作系统和用户就出现上了概念的鸿沟。两者不匹配了。所以Linux的设计者为了解决用户的问题,也为了把linux系统中的轻量级进程封装起来,给用户提供一层软件层,这层软件层被称之为pthread库,它的核心任务就是把创建轻量级进程封装起来,给用户提供一批创建线程的接口,从此以后,我们的用户他想要线程,就需要使用pthread库的接口。而底层的轻量级进程的概念,用户就不需要关心了。
所以linux的线程实现,是在用户层实现的。我们称之为用户级线程。他并不是内核级的,轻量级进程只不过是线程概念的底层载体,在用户看来,你的线程就是在用户层系统调用之上创建的线程。
因此我们将pthread库叫做原生线程库!!也就是说它原来就出生在linux系统上的线程库,它需要和linux系统强绑定,但是它属于用户层。
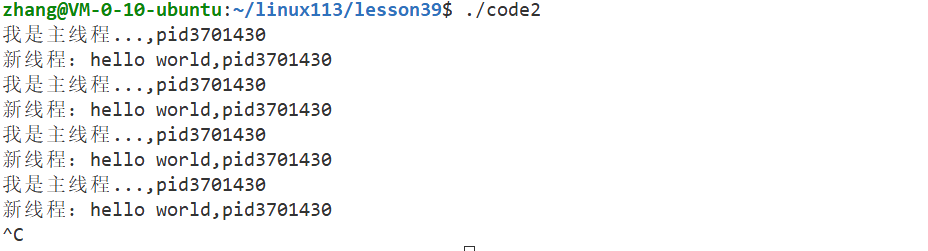
C++11也引入了多线程,测试代码如下所示:
cpp#include <iostream> #include <string> #include <unistd.h> #include <thread> void hello() { while (1) { std::cout << "新线程:hello world,pid" << getpid() << std::endl; sleep(1); } } int main() { std::thread t(hello); while (true) { std::cout << "我是主线程...,pid" << getpid() << std::endl; sleep(1); } t.join(); return 0; }运行代码如下所示:两个线程同时运行
C++11的多线程,在linux下,本质是封装了pthread库。在windows下,封装了windows创建线程的接口。
C++语言为什么要对线程库做封装呢?为了保证语言的跨平台性和可移植性!!
语言的跨平台性和可移植性是怎么实现的?所有平台都实现一份,然后条件编译,形成库!
2.3 线程控制的接口
2.3.1 创建线程
这个函数的作用是创建一个新的线程。
第一个参数:线程id,是一个输出型参数。
第二个参数:线程属性,可以设置为nullptr。
第三个参数:返回值为void*,参数为void*的函数指针。代表新线程要执行的函数入口。
第四个参数:传递给函数的参数。
2.3.2 线程等待
创建线程之后,线程就在内核中以LWP的形式运行,主线程需要对曾经自己创建的新城进行等待,如果不等待,会造成类似僵尸进程的问题,也是一种内存泄漏。所以需要使用函数来等待线程。
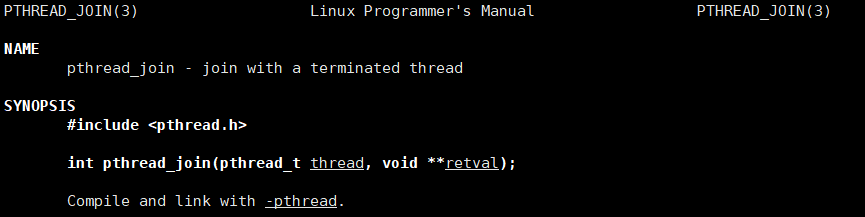
第一个参数:线程id
第二个参数:线程入口函数的返回值。
测试代码如下:
cpp
#include <iostream>
#include <cstdio>
#include <string>
#include <unistd.h>
#include <pthread.h>

void showtid(pthread_t &tid)
{
    printf("tid:0x%lx\n", tid);
}
void *routine(void *args)
{
    std::string name = static_cast<const char *>(args);
    int cnt = 5;
    while (cnt)
    {
        std::cout << "我是一个新线程,我的name:" << name << std::endl;
        sleep(1);
        cnt--;
    }
    return nullptr;
}

int main()
{
    pthread_t tid;
    int n = pthread_create(&tid, nullptr, routine, (void *)"thread-1");

    showtid(tid);

    pthread_join(tid, nullptr);
    return 0;
}
运行如下所示:
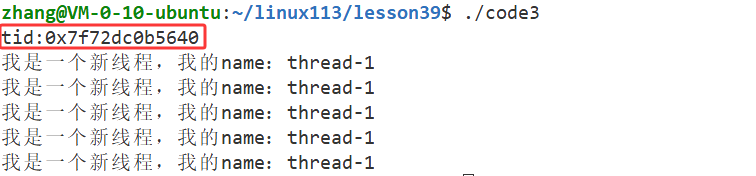
我们这里打印的线程id为什么这么大啊?它不是我们底层的LWP。它确实不应该是底层的LWP。因为我们使用的线程库本来就是线程做的封装,LWP是轻量级进程的概念,是一个进程,我们需要的是线程的id。如果用户拿到的线程id是LWP,用户还需要了解LWP,轻量级进程的概念。linux封装了轻量级进程,就需要封装彻底,不要让用户看到轻量级进程的概念。
所以刚刚输出的线程id,不是LWP。
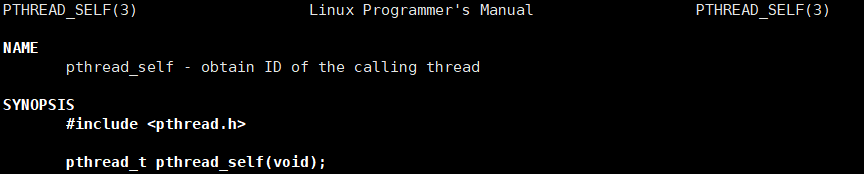
那现在我们如何证明主线程拿到的线程id就是这个线程的呢?我们可以使用pthread_self函数,如下所示:
测试代码如下:
cpp
#include <iostream>
#include <cstdio>
#include <string>
#include <unistd.h>
#include <pthread.h>

void showtid(pthread_t &tid)
{
    printf("tid:0x%lx\n", tid);
}
void *routine(void *args)
{
    std::string name = static_cast<const char *>(args);
    pthread_t tid = pthread_self();
    int cnt = 5;
    while (cnt)
    {
        std::cout << "我是一个新线程,我的name:" << name << std::endl;
        std::cout << "我是一个新线程,我的tid:";
        showtid(tid);
        sleep(1);
        cnt--;
    }
    return nullptr;
}

int main()
{
    pthread_t tid;
    int n = pthread_create(&tid, nullptr, routine, (void *)"thread-1");

    showtid(tid);

    pthread_join(tid, nullptr);
    return 0;
}
运行如下所示:
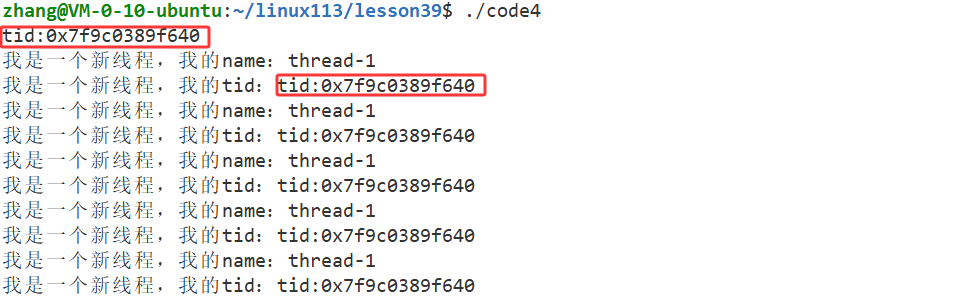
主线程打印的tid和线程里面打印的tid值是一样的,所以我们可以确定是同一个线程。
新线程退出之后,我们如何拿到新线程的退出码呢?我们可以使用第二个参数,第二个参数要求传入void**类型的变量,如下所示:
cpp
#include <iostream>
#include <pthread.h>
#include <unistd.h>
#include <string>

void *routine(void *args)
{
    std::string name = static_cast<const char *>(args);
    int cnt = 10;
    while (cnt--)
    {
        std::cout << "我是新线程,name" << name << std::endl;
        sleep(1);
    }
    return (void *)123;
}
int main()
{
    pthread_t tid;
    pthread_create(&tid, nullptr, routine, (void *)"thread-1");

    int cnt = 5;
    while (cnt--)
    {
        std::cout << "我是main线程" << std::endl;
        sleep(1);
    }
    void *ret = nullptr;
    pthread_join(tid, &ret);
    std::cout << "新线程结束,退出码" << (long long)ret << std::endl;
    return 0;
}
运行如下所示:
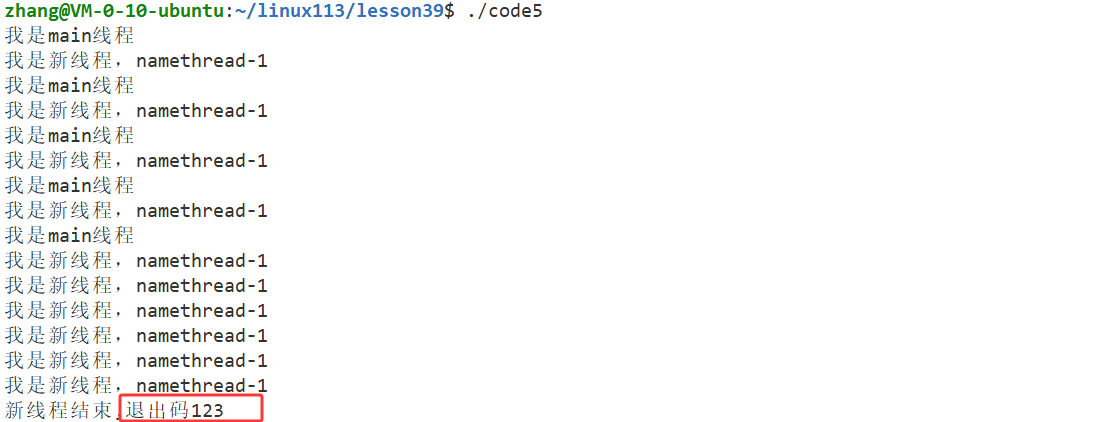
当mian线程的循环跑完之后,执行pthread_join函数的时候,新线程还没有执行完,此时主线程就会阻塞等待新线程,当新线程执行完成时候,主线程就会join结束,拿到新线程的退出码。
1:当main函数结束,代表主线程结束,一般也代表进程结束
2:新线程对应的入口函数,运行结束的话,就代表当前线程运行结束
3:给线程传入的参数和返回值可以是任意类型的。包括自定义类型,测试代码如下:
cpp#include <iostream> #include <pthread.h> #include <unistd.h> #include <string> class Task { public: Task(int a, int b) : _a(a), _b(b) {} int Execute() { return _a + _b; } ~Task() {} private: int _a; int _b; }; class Result { public: Result(int result) : _result(result) {} int GetResult() { return _result; } ~Result() {} private: int _result; }; void *routine(void *args) { Task *t = static_cast<Task *>(args); sleep(1); Result *res = new Result(t->Execute()); sleep(1); return res; } int main() { pthread_t tid; Task *t = new Task(10, 20); pthread_create(&tid, nullptr, routine, t); Result *ret = nullptr; pthread_join(tid, (void **)&ret); int n = ret->GetResult(); std::cout << "新线程结束,运行结果" << n << std::endl; delete t; delete ret; return 0; }
2.3.3 线程终止
2.3.3.1 return
当线程的入口函数里面执行return之后,就是线程终止了,我们之前在讲进程的时候,可以使用exit来终止进程,那么线程可以使用exit函数来终止嘛?我们来测试一下,代码如下所示:
cpp
#include <iostream>
#include <pthread.h>
#include <unistd.h>
#include <string>

class Task
{
public:
    Task(int a, int b) : _a(a), _b(b) {}
    int Execute()
    {
        return _a + _b;
    }
    ~Task() {}

private:
    int _a;
    int _b;
};
class Result
{
public:
    Result(int result) : _result(result) {}
    int GetResult()
    {
        return _result;
    }
    ~Result() {}

private:
    int _result;
};
void *routine(void *args)
{
    Task *t = static_cast<Task *>(args);
    sleep(1);
    Result *res = new Result(t->Execute());
    sleep(1);
    exit(13);
    return res;
}
int main()
{
    pthread_t tid;
    Task *t = new Task(10, 20);
    pthread_create(&tid, nullptr, routine, t);

    Result *ret = nullptr;
    pthread_join(tid, (void **)&ret);
    int n = ret->GetResult();
    std::cout << "新线程结束,运行结果" << n << std::endl;
    delete t;
    delete ret;
    return 0;
}
运行如下所示:
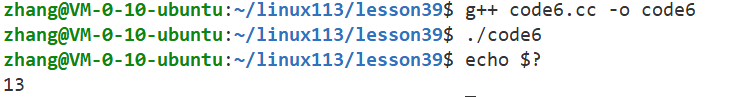
如果想要线程终止,绝对不能调用exit,除非你是故意这么写的。因为线程一旦调用了exit,就相当于进程调用了exit,exit本质是终止进程的。所以任意一个线程自己的代码里面调用了exit,都会导致进程的所有线程退出。
2.3.3.2 pthread_exit
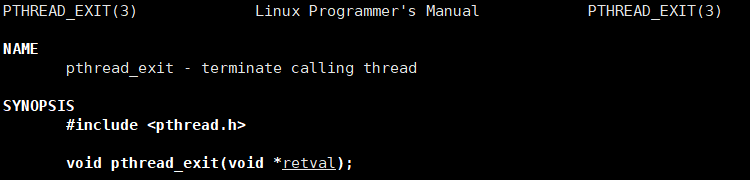
在pthread库里面,有一个pthread_exit函数,我们可以使用它来终止线程。如下所示:
测试代码如下所示:
cpp
#include <iostream>
#include <pthread.h>
#include <unistd.h>
#include <string>

class Task
{
public:
    Task(int a, int b) : _a(a), _b(b) {}
    int Execute()
    {
        return _a + _b;
    }
    ~Task() {}

private:
    int _a;
    int _b;
};
class Result
{
public:
    Result(int result) : _result(result) {}
    int GetResult()
    {
        return _result;
    }
    ~Result() {}

private:
    int _result;
};
void *routine(void *args)
{
    Task *t = static_cast<Task *>(args);
    sleep(1);
    Result *res = new Result(t->Execute());
    sleep(1);
    pthread_exit(res);
}
int main()
{
    pthread_t tid;
    Task *t = new Task(10, 20);
    pthread_create(&tid, nullptr, routine, t);

    Result *ret = nullptr;
    pthread_join(tid, (void **)&ret);
    int n = ret->GetResult();
    std::cout << "新线程结束,运行结果" << n << std::endl;
    delete t;
    delete ret;
    return 0;
}
2.3.3.3 pthread_cancel
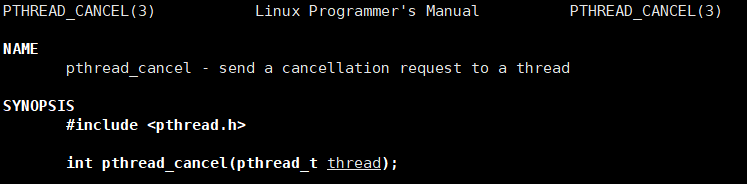
这个函数的使用方法一般都是主线程取消新线程。
取消的使用一定需要保证新线程以及启动了。
测试代码如下:
cpp
#include <iostream>
#include <pthread.h>
#include <unistd.h>
#include <string>

class Task
{
public:
    Task(int a, int b) : _a(a), _b(b) {}
    int Execute()
    {
        return _a + _b;
    }
    ~Task() {}

private:
    int _a;
    int _b;
};
class Result
{
public:
    Result(int result) : _result(result) {}
    int GetResult()
    {
        return _result;
    }
    ~Result() {}

private:
    int _result;
};
void *routine(void *args)
{
    Task *t = static_cast<Task *>(args);
    Result *res = new Result(t->Execute());
    sleep(100);
    pthread_exit(res);
}
int main()
{
    pthread_t tid;
    Task *t = new Task(10, 20);
    pthread_create(&tid, nullptr, routine, t);

    sleep(3);
    pthread_cancel(tid);

    void *ret = nullptr;
    pthread_join(tid, &ret);
    std::cout << "新线程被取消了,ret:" << (long long)ret << std::endl;
    return 0;
}
运行如下所示:

当我们的新线程还没有运行结束,如果被主线程取消的话,此时新线程的返回值为-1。
2.3.4 线程分离
我们之前在讲信号的时候,子进程退出之后,会给父进程发送SIGCHLD信号,父进程可以捕捉该信号,可以将处理动作设置为SIG_IGN。这样fork出来的子进程在终止时会自动清理掉,不会产生僵尸进程,也不会通知父进程,父进程也不需要wait了。
如果主线程不想再去关心新线程,而是当新线程结束的时候,让它自己释放,不要让主线程阻塞式的join了。我们可以设置线程为分离状态。
线程默认是需要被等待的,也就是joinable的,一个线程被创建出来,主线程必须要等待这个新线程。如果不想要等待新线程,而是想让新线程结束之后,将新线程的资源自己释放掉。这个时候我们就需要设置新线程为分离状态(!joinable或者 detach)。
分离的线程依旧在进程的地址空间之中,进程的所有资源,被分离的线程依旧可以访问,可以操作。只不过就是主线程不再需要等待新线程了。
我们可以在主线程里面设置分离新线程,也可以在新线程里面设置自己为分离状态。
系统调用如下:
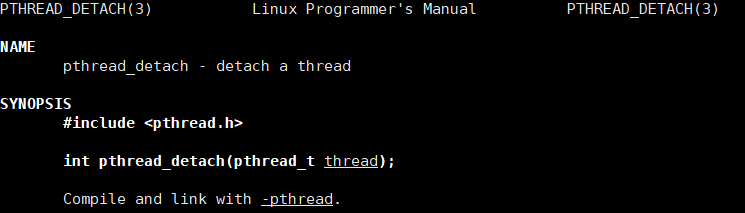
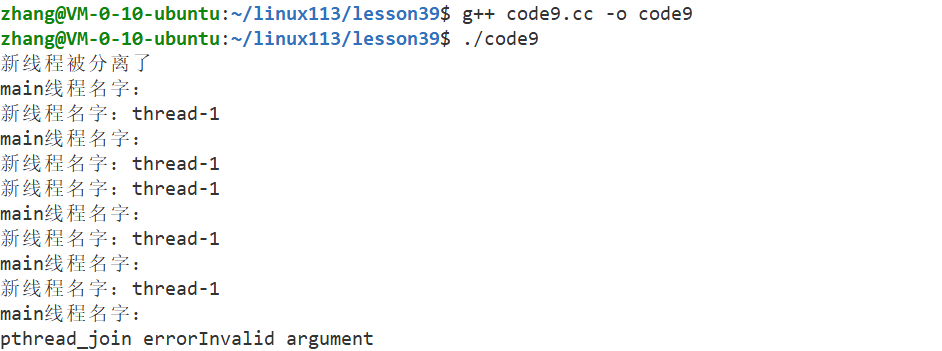
主线程分离新线程,代码如下所示:
cpp
#include <iostream>
#include <string>
#include <cstring>
#include <unistd.h>
#include <pthread.h>
#include <cstdio>

void *routine(void *args)
{
    std::string name = static_cast<const char *>(args);
    int cnt = 5;
    while (cnt--)
    {
        std::cout << "新线程名字:" << name << std::endl;
        sleep(1);
    }
    return nullptr;
}
int main()
{
    pthread_t tid;
    pthread_create(&tid, nullptr, routine, (void *)"thread-1");
    pthread_detach(tid);
    std::cout << "新线程被分离了" << std::endl;

    int cnt = 5;
    while (cnt--)
    {
        std::cout << "main线程名字:" << std::endl;
        sleep(1);
    }
    int n = pthread_join(tid, nullptr);
    if (n == 0)
    {
        std::cout << "pthread_join sucess" << std::endl;
    }
    else
    {
        std::cout << "pthread_join error" << strerror(n) << std::endl;
    }
    return 0;
}
运行如下所示:
新线程设置自己为分离状态,如下所示:
cpp
#include <iostream>
#include <string>
#include <cstring>
#include <unistd.h>
#include <pthread.h>
#include <cstdio>

void *routine(void *args)
{
    pthread_detach(pthread_self());
    std::cout << "新线程被分离了" << std::endl;
    std::string name = static_cast<const char *>(args);
    int cnt = 5;
    while (cnt--)
    {
        std::cout << "新线程名字:" << name << std::endl;
        sleep(1);
    }
    return nullptr;
}
int main()
{
    pthread_t tid;
    pthread_create(&tid, nullptr, routine, (void *)"thread-1");

    int cnt = 5;
    while (cnt--)
    {
        std::cout << "main线程名字:" << std::endl;
        sleep(1);
    }
    int n = pthread_join(tid, nullptr);
    if (n == 0)
    {
        std::cout << "pthread_join sucess" << std::endl;
    }
    else
    {
        std::cout << "pthread_join error" << strerror(n) << std::endl;
    }
    return 0;
}
运行如下所示:
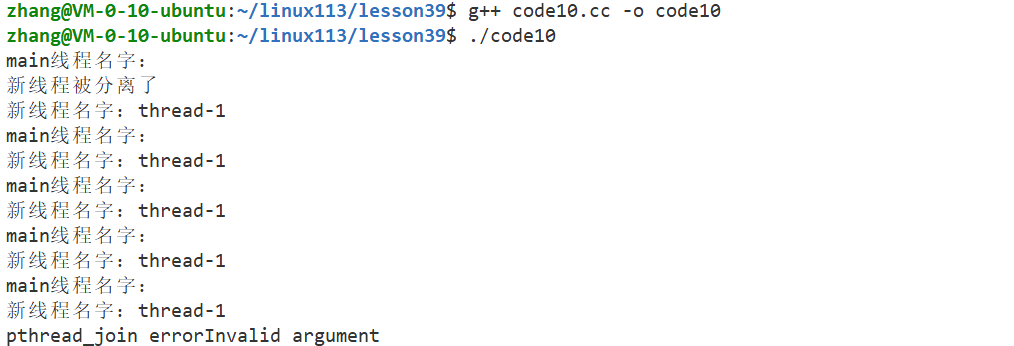
如果将新线程设计为分离状态,主线程就不需要join,如果执行join就会失败,当被分离的线程执行完后,它会自动释放自己的资源。
2.3.5 多线程编程实战
测试代码如下所示:
cpp
#include <iostream>
#include <string>
#include <vector>
#include <unistd.h>
#include <pthread.h>
#include <cstdio>
#include <cstring>

const int num = 10;
void *routine(void *args)
{
    std::string name = static_cast<const char *>(args);
    int cnt = 5;
    while (cnt--)
    {
        std::cout << "新线程名字:" << name << std::endl;
        sleep(1);
    }
    return nullptr;
}

int main()
{
    std::vector<pthread_t> tids;
    for (int i = 0; i < num; i++)
    {
        pthread_t tid;
        char id[64];
        snprintf(id, sizeof(id), "thread-%d", i);
        int n = pthread_create(&tid, nullptr, routine, id);
        if (n == 0)
        {
            tids.push_back(tid);
        }
        else
        {
            continue;
        }
    }
    for (int i = 0; i < num; i++)
    {
        int n = pthread_join(tids[i], nullptr);
        if (n == 0)
        {
            std::cout << "新线程等待成功" << std::endl;
        }
    }

    return 0;
}
运行如下所示:
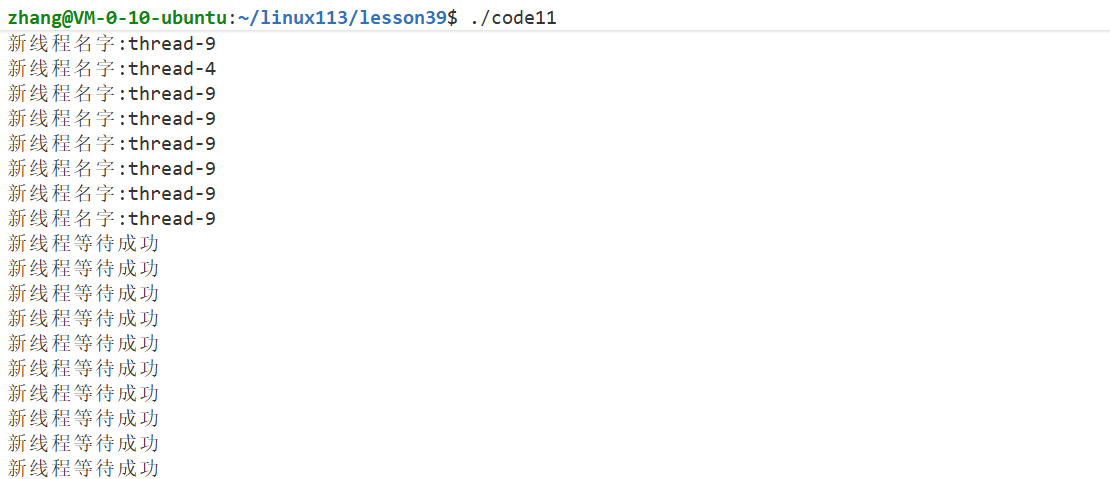
当我们在routine的函数里面增加一个1s的睡眠,如下所示:
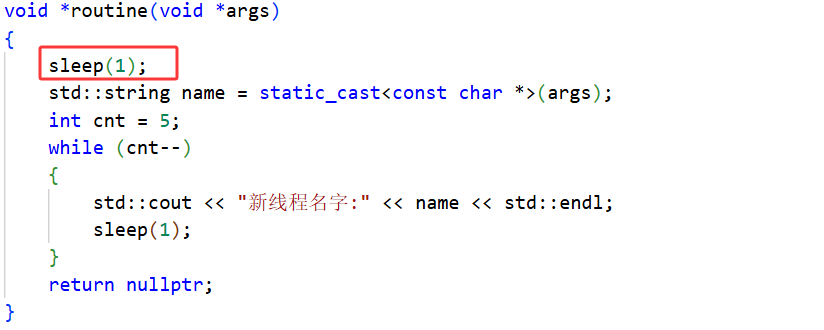
运行如下所示:
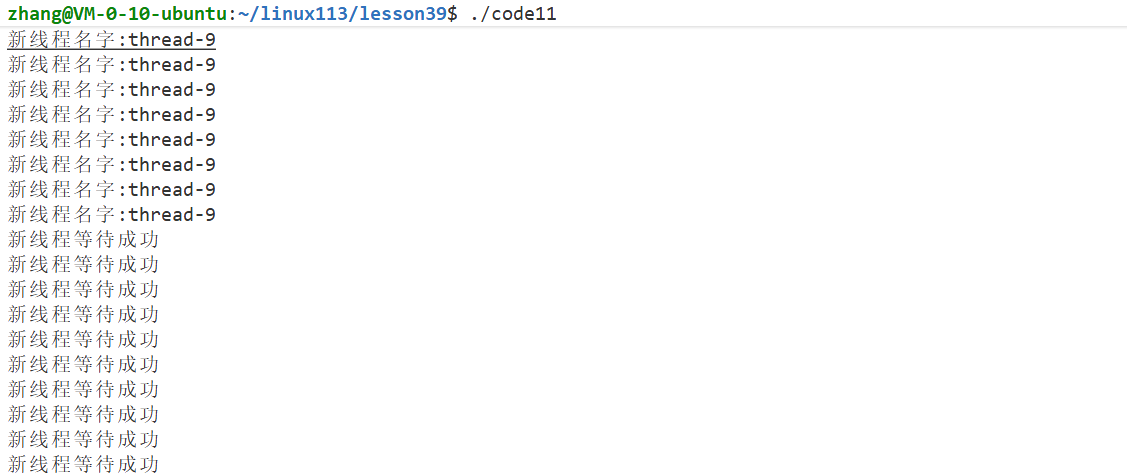
我们发现所有线程的名字都是thread-9,这是为什么呢?
当我们使用for循环创建10个新线程之后,这个10个线程飞快的创建出来了,此时都还没有执行routine函数,都没有拿到pthread_create传入给routine函数的参数。第10个新线程创建完成之后,id里面的内容是thread-9。创建新线程的时候,是将thread-9字符串的地址给新线程了,此时所有的新线程睡眠1秒之后拿到这个地址,此时这个空间的内容是thread-9。所以所有的新线程名字是thread-9。
创建出来的id会让所有线程都看见,所有线程看到的都是同一块内存空间。这里就导致了一个简单的线程安全问题,因为所有新线程看到的id都是都一块空间。
那么我们如何解决这个问题呢?我们可以在堆空间申请一个char64的空间,然后传入给新线程。第二次创建新线程的时候会重新申请一个char64的空间,每次创建新线程的时候,id指针都不一样。
代码如下所示:
cpp
#include <iostream>
#include <string>
#include <vector>
#include <unistd.h>
#include <pthread.h>
#include <cstdio>
#include <cstring>

const int num = 10;
void *routine(void *args)
{
    sleep(1);
    std::string name = static_cast<const char *>(args);
    int cnt = 5;
    while (cnt--)
    {
        std::cout << "新线程名字:" << name << std::endl;
        sleep(1);
    }
    delete (char *)args;
    return nullptr;
}

int main()
{
    std::vector<pthread_t> tids;
    for (int i = 0; i < num; i++)
    {
        pthread_t tid;
        char *id = new char[64];
        snprintf(id, 64, "thread-%d", i);
        int n = pthread_create(&tid, nullptr, routine, id);
        if (n == 0)
        {
            tids.push_back(tid);
        }
        else
        {
            continue;
        }
    }
    for (int i = 0; i < num; i++)
    {
        int n = pthread_join(tids[i], nullptr);
        if (n == 0)
        {
            std::cout << "新线程等待成功" << std::endl;
        }
    }

    return 0;
}
三、线程ID及地址空间布局
在上面讲解linux概念的时候说过**:linux操作系统中,没有真正的线程,它是用轻量级进程模拟的线程。因此Linux操作系统不会提供创建线程相关的接口,但是操作系统原理又有线程和进程的概念。所以需要在用户层封装轻量级进程,形成原生线程库。**
我们的程序运行起来,需要将可执行程序加载到内存,动态链接和动态地址重定向。要将动态库,加载到内存,并且映射到当前进程的地址空间之中。如下图所示:
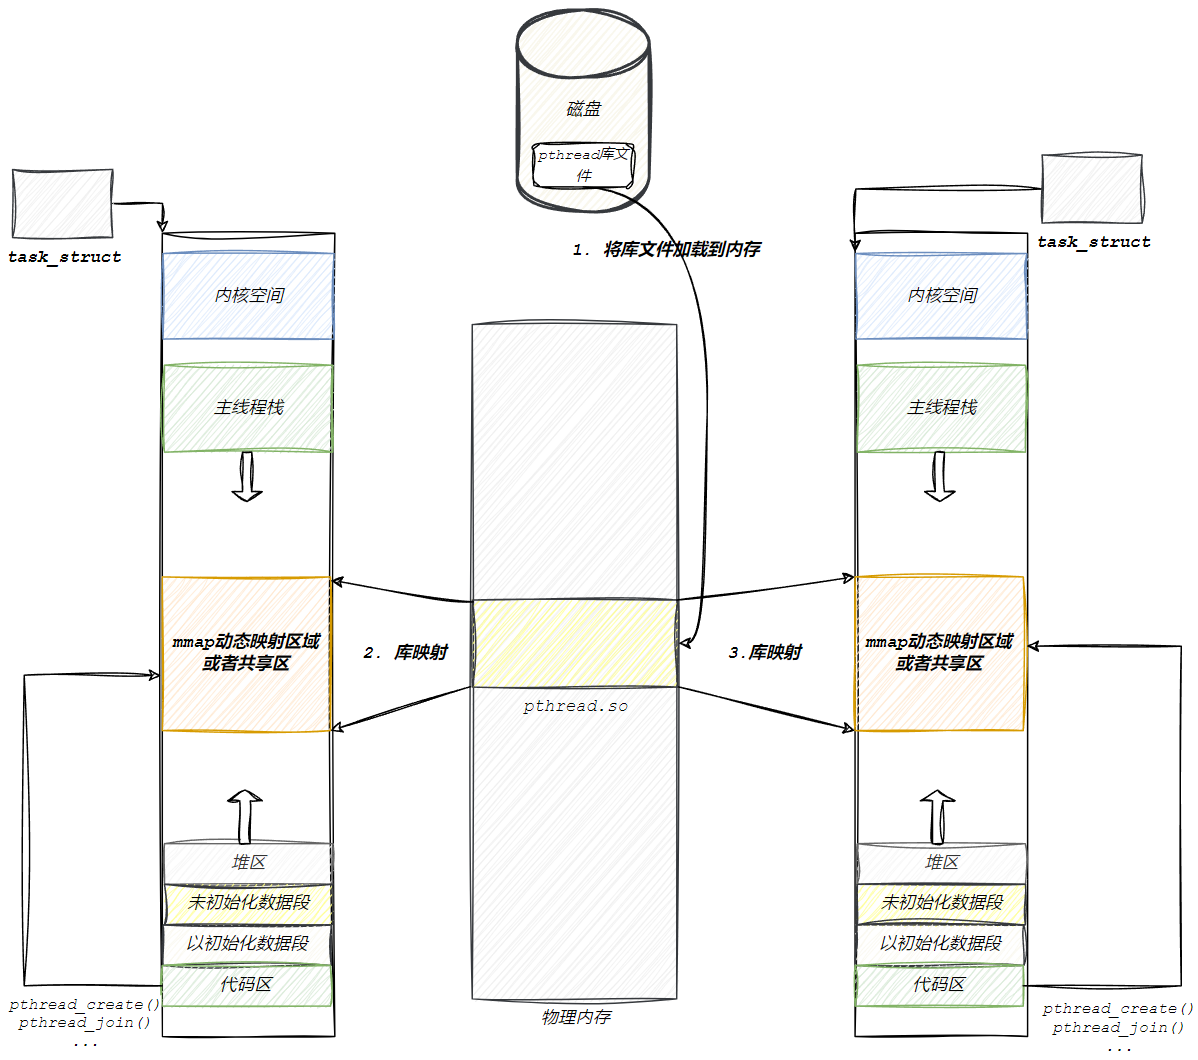
线程的概念是在库中维护的,在库内部,就可能存在很多的多线程,那么库内部需不需要管理线程呢?那肯定需要啊。那么怎么管理呢?先描述,在组织!!!
所以在库里面一定存在诸如struct tcb相关的东西,它里面描述了线程相关的属性,例如线程id,线程状态,线程独立栈结构,线程栈大小等等。。。所以当我们创建一个线程时,在线程库里面就需要为我们创建出来一个struct tcb,里面会包含线程相关的属性。但是这个tcb里面是没有优先级,时间片,上下文相关的东西的。这些东西是在PCB中的。所以说整个线程的概念一部分在内核之中实现,一部分在用户层实现。
在我们代码区里面,我们调用了pthread_create函数创建线程,会在动态库里面为我们创建出来一个TCB,这里面描述了线程相关属性。如果创建了10个线程,10个线程的TCB如何管理呢?如下所示:
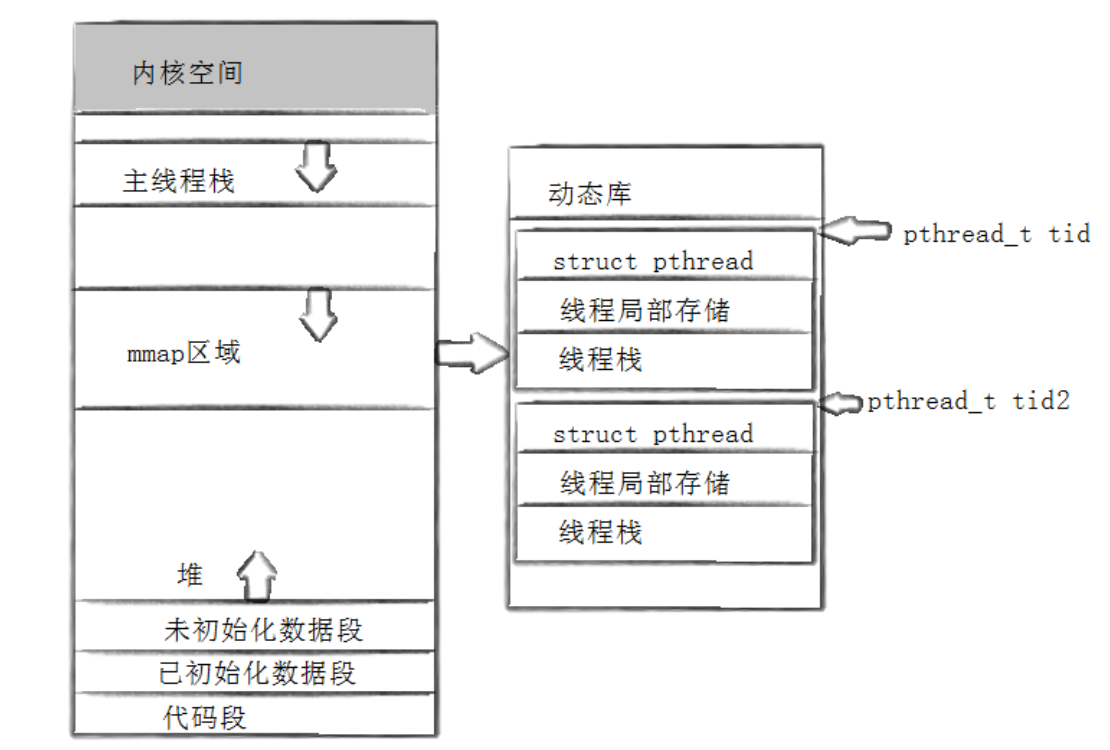
所以我们每一次创建一个线程,在库内部会为我们创建一个描述线程的结构。开头的部分叫做线程的TCB。线程局部存储下面再讲。更重要的时候,会给新线程创建一个线程栈结构。
那么我们创建线程库的时候,第一个参数tid是什么呢?为什么是这么大的数字呢?答案是,这个tid是库中对应管理块的起始虚拟地址。
在struct pthread结构体里面,有一个属性,叫做void* ret;当线程控制块对应的线程执行完成之后。会将return的返回值写到当前线程对应的控制块里面的ret之中。
然后线程运行结束之后,这个库里面的线程管理块还没有被释放。所以线程需要被join。所以主线程需要join新线程,释放地址空间,传入的第一个参数是tid,根据tid,主线程就可以找到库里面对象的线程管理块的地址,释放空间。第二个参数是void**类型的变量,如果需要返回值,就可以从控制块里面取出ret的值,并且写出到这个变量之中。
只要创建一个线程就需要创建一个对应的管理块。每一个线程都必须有自己独立的栈空间。这个栈空间在pthread动态库之中。所以主线程用地址空间里面的栈,而新创建的线程都会使用自己的线程栈。
pthread_create函数做的事情:
- 在库里面需要创建线程控制的管理块
- 要在内核中,调用系统调用,创建轻量级进程,需要告诉系统调用(clone**)执行什么方法,栈在哪里等等。**
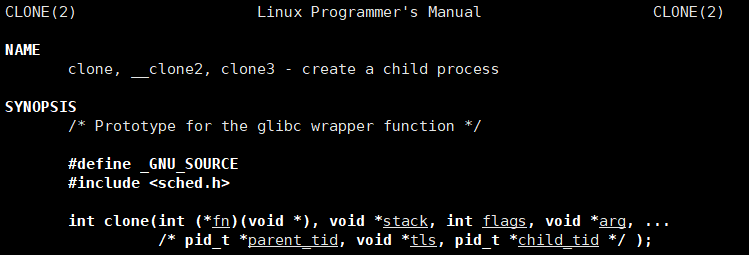
clone函数会创建一个轻量级进程,然后创建PCB,PCB里面的入口函数就是第一个参数。PCB里面的栈空间就是第二个参数,他指向动态库里面的线程栈。
所以当CPU调度的时候,会执行fn函数,形成的临时数据会入线程栈!!!所以我们的内核数据和用户数据在一定程度上就联动起来了。
总结:
1:线程id是什么?线程id是我们pthread_create的时候,我们在库中创建描述线程的线程控制块的起始虚拟地址。
2:线程分离:在线程控制块里面有一个线程状态,可以把它叫做int joinable。默认情况下,joinbale等于1.如果joinable=1,线程结束之后必须join。如果joinable=0,当线程退出的时候,线程库会自动将线程控制块给释放。
四、线程封装
cpp
#ifndef _THREAD_H_
#define _THREAD_H_
#include <iostream>
#include <string>
#include <cstdio>
#include <unistd.h>
#include <cstring>
#include <pthread.h>
#include <functional>
namespace ThreadModule
{
    static uint32_t number = 1;
    class Thread
    {
        using func_t = std::function<void()>;
        void EnableDetach()
        {
            std::cout << "线程被分离了" << std::endl;
            _isdetach = true;
        }

    public:
        Thread(func_t func)
            : _tid(0), _isdetach(false), _isrunning(false), _res(nullptr), _func(func)
        {
            _name = "thread-" + std::to_string(number++);
        }
        void Detach()
        {
            if (_isdetach) // 如果线程已经分离了,就不需要再分离了。
                return;
            if (_isrunning)
                pthread_detach(_tid);
            EnableDetach();
        }

        void EnableRunning()
        {
            _isrunning = true;
        }
        static void *Routine(void *args)
        {
            Thread *self = (Thread *)args;
            self->EnableRunning();
            if (self->_isdetach) // 如果线程的分离标志是true,就调用系统调用pthread_detach来将线程设置分离
                self->Detach();
            self->_func();
            return nullptr;
        }
        bool Start()
        {
            if (_isrunning)
                return false;
            int n = pthread_create(&_tid, nullptr, Routine, this);
            if (n != 0)
            {
                std::cerr << "create pthread error" << strerror(n) << std::endl;
                return false;
            }
            else
            {
                std::cout << _name << " create sucess" << std::endl;
            }
            return true;
        }
        bool Stop()
        {
            if (_isrunning)
            {
                int n = pthread_cancel(_tid);
                if (n != 0)
                {
                    std::cerr << "cancel pthread error" << strerror(n) << std::endl;
                    return false;
                }
                else
                {
                    _isrunning = false;
                    std::cerr << _name << " stop" << std::endl;
                }
            }
            return true;
        }
        bool Join()
        {
            if (_isdetach)
            {
                std::cout << "你的线程已经是分离的,不能进行join" << std::endl;
                return true;
            }
            int n = pthread_join(_tid, &_res);
            if (n != 0)
            {
                std::cerr << "join pthread error" << strerror(n) << std::endl;
                return false;
            }
            else
            {
                std::cerr << "join pthread sucess" << std::endl;
            }
            return true;
        }
        ~Thread() {}

    private:
        pthread_t _tid;    // 线程id
        std::string _name; // 线程名字
        bool _isdetach;    // 是否分离,默认不分离
        bool _isrunning;   // 线程状态,是否运行
        void *_res;        // 线程返回值
        func_t _func;      // 线程执行的任务
    };
}

#endif
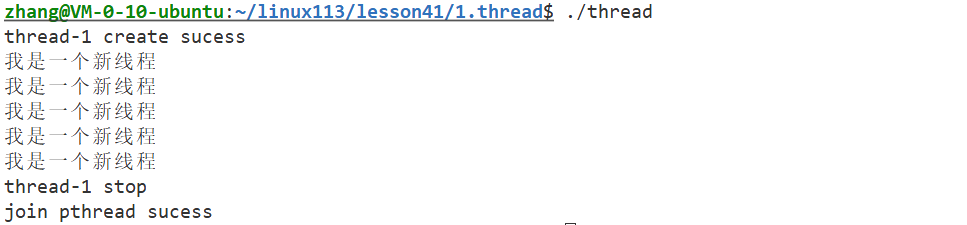
4.1 情况1:不分离
main函数代码
cpp
#include "Thread.hpp"

using namespace ThreadModule;

int main()
{
    Thread t([]()
             {
        while(true)
        {
            std::cout<<"我是一个新线程"<<std::endl;
            sleep(1);
        } });
    t.Start();
    sleep(5);
    t.Stop();
    sleep(5);
    t.Join();
    return 0;
}
运行如下所示:
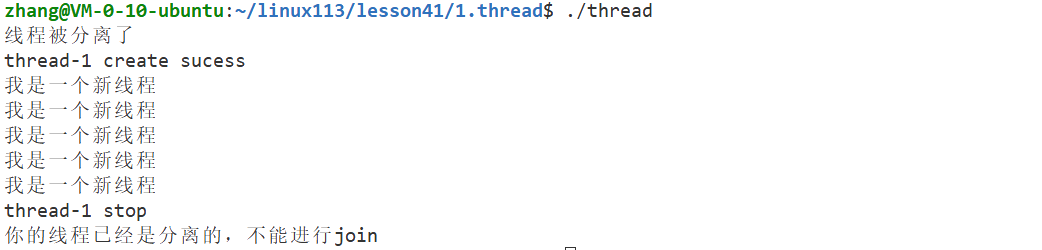
4.2 情况2:启动之前分离
main函数代码
cpp
#include "Thread.hpp"

using namespace ThreadModule;

int main()
{
    Thread t([]()
             {
        while(true)
        {
            std::cout<<"我是一个新线程"<<std::endl;
            sleep(1);
        } });
    t.Detach();
    t.Start();
    sleep(5);
    t.Stop();
    sleep(5);
    t.Join();
    return 0;
}
运行如下所示:
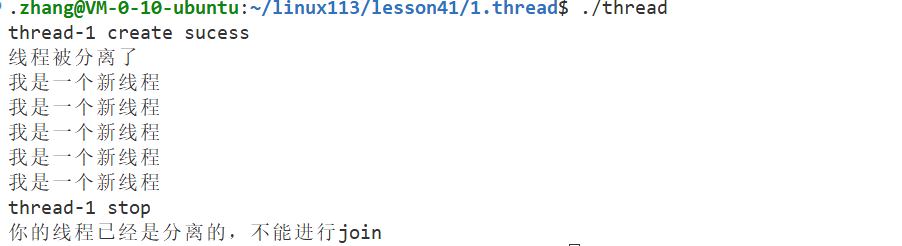
4.3 情况3:启动之后分离
main函数代码
cpp
#include "Thread.hpp"

using namespace ThreadModule;

int main()
{
    Thread t([]()
             {
        while(true)
        {
            std::cout<<"我是一个新线程"<<std::endl;
            sleep(1);
        } });
    t.Start();
    t.Detach();
    sleep(5);
    t.Stop();
    sleep(5);
    t.Join();
    return 0;
}
几个关键问题:
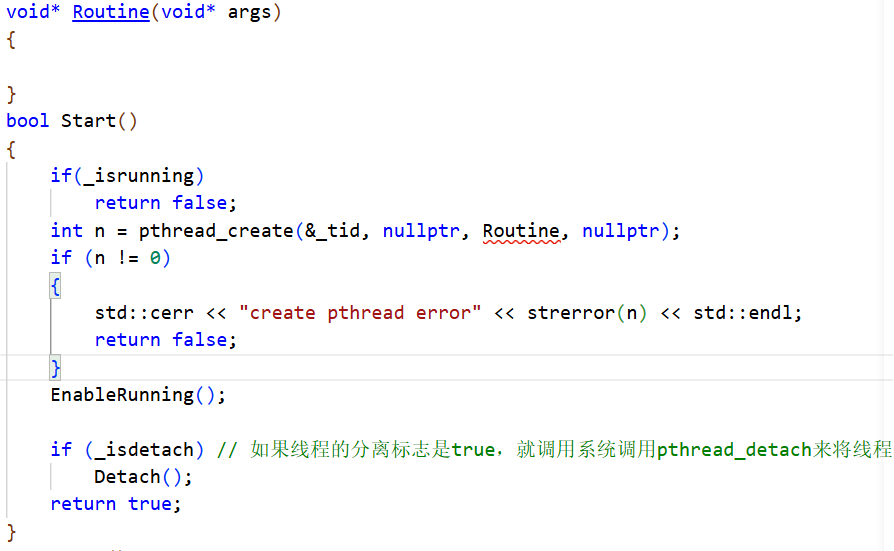
1:为什么有了Routine函数,pthread_create里面还有报错提示呢?如下所示:
这是因为,这里的Routine函数是类成员函数,它默认有一个this指针,Routine函数就有两个参数了。而pthread_create函数要求Routine函数只能有一个函数参数。所以两个函数都不是同一个函数。所以会报错。
那么如何解决呢?
我们可以将这个函数设计为static,这样参数就匹配了。
2:可是这样写的话,这个线程只能执行我们自己的类里面的方法了。我们创建这个线程是为了给这个线程指派任务的。所以任务必须是类外提供的方法。
我们可以使用function。如下所示:
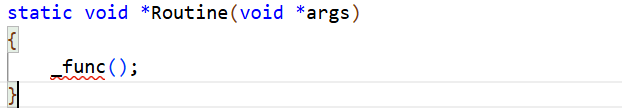
但是为什么这里还是报错呢?
这是因为static函数没有this指针,无法访问成员变量_func。
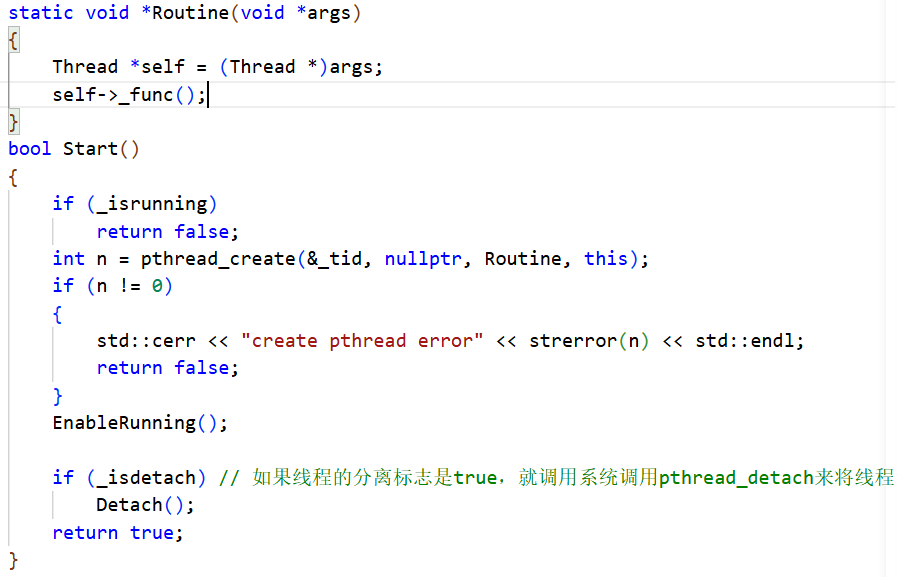
那怎么办呢?我们可以再pthread_create创建线程的时候,传入this,作为参数,如下所示:

五、线程局部存储
我们之前说过,每一个线程创建时,会在库里面给我们创建描述线程的结构体,内部也有指针指向栈。那么线程局部存储是什么呢?这是什么东西呢?
测试代码如下所示:
cpp
#include <iostream>
#include <pthread.h>
#include <string>
#include <unistd.h>
int count = 1;
std::string Addr(int &c)
{
    char addr[64];
    snprintf(addr, sizeof(addr), "%p", &c);
    return addr;
}
void *routine1(void *args)
{
    (void)args;
    while (true)
    {
        std::cout << "thread-1,count = " << count << "[我来修改count],"
                  << "&count:" << Addr(count) << std::endl;
        count++;
        sleep(1);
    }
}
void *routine2(void *args)
{
    (void)args;
    while (true)
    {
        std::cout << "thread-2,count = " << count
                  << ",&count:" << Addr(count) << std::endl;
        sleep(1);
    }
}

int main()
{
    pthread_t tid1, tid2;
    pthread_create(&tid1, nullptr, routine1, nullptr);
    pthread_create(&tid2, nullptr, routine2, nullptr);

    pthread_join(tid1, nullptr);
    pthread_join(tid2, nullptr);
    return 0;
}
运行如下所示:
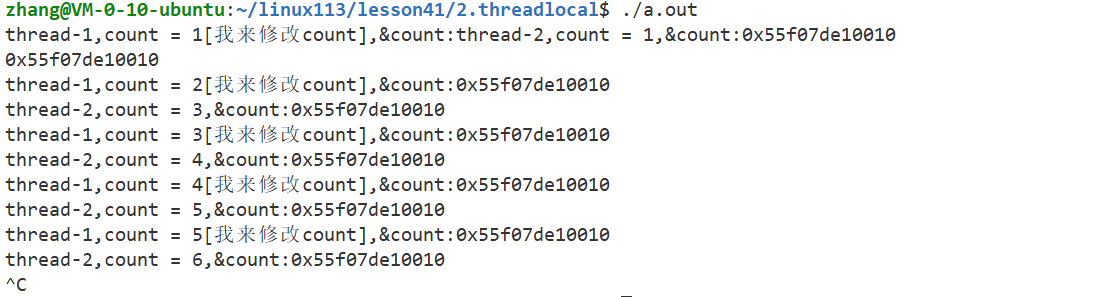
我们可以看见,count是两个进程所共享的,count的地址也都一样。
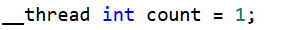
但是如果我们在count前面加一个__thread 所修饰呢?
运行如下所示:
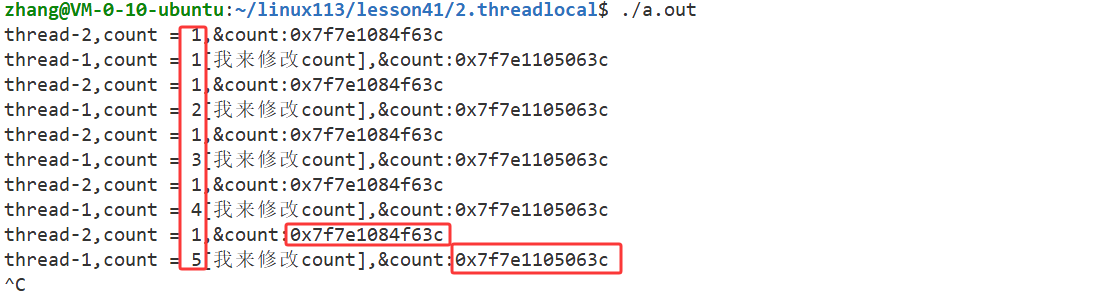
我们发现两个线程不共享count了,打印出来的地址都不一样了。这是为什么呢?
如果我们给count前面加上__thread修饰,它表示该count叫做线程的局部存储。编译器会在描述线程的结构中线程局部存储位置存放count变量。两个线程中这个变量的名字叫做count。但是虚拟地址已经不一样了。
线程局部存储有什么用呢?线程想要使用全局变量,但是我这个线程又不想让其他的线程看到我使用的全局变量。就可以使用__thread来定义线程局部存储。但是线程局部存储只能存储内置类型和指针!!
六、总结
- 线程概念:Linux 以轻量级进程 LWP 模拟线程;进程负责资源分配,线程是 CPU 调度单元;线程共享进程资源,私有栈和寄存器;单个线程崩溃会导致整个进程退出,线程切换开销低于进程切换。
- pthread 库 :内核提供
clone创建 LWP,pthread 做用户层封装,编译加-lpthread;区分内核 LWP ID 与用户层pthread_t。 - 常用接口
pthread_create:创建线程,避免传递栈局部变量。pthread_join:阻塞等待回收线程,分离线程不可 join。- 线程退出:
return、pthread_exit;禁止exit,会结束整个进程。 pthread_detach:线程分离,结束自动释放资源。pthread_cancel:取消目标线程。
- 补充 :
__thread实现线程局部存储;信号针对整个进程;线程数量不宜过多,防止上下文切换损耗性能。