上一篇我们建立了 IPC 的核心认知:进程通信的本质,是让互相通信的进程看到同一份由操作系统提供的公共资源 。从这一篇开始,我们正式学习第一种、也是 Unix 历史上最古老的 IPC 方式 ------ 管道(pipe) 。你每天在 Shell 里敲的 ls | grep txt、ps aux | wc -l,底层走的全是它。这一篇我们不满足于 "会用",而是要回答三个问题:管道在内核里长什么样?两个进程是怎么 "看到" 同一条管道的?管道的读写行为为什么是这样的? 把这些搞懂,你会发现管道的一切 "奇怪" 行为都是自然而然的。
文章目录
-
- 一、先搞懂:为什么不能用普通文件通信?
- 二、管道是什么:连接两个进程的一条数据流
- [三、pipe 接口:创建一条管道](#三、pipe 接口:创建一条管道)
-
- [3.1 函数原型](#3.1 函数原型)
- [3.2 为什么返回的是文件描述符?](#3.2 为什么返回的是文件描述符?)
- [3.3 fd 编号的规律](#3.3 fd 编号的规律)
- 四、内核视角:管道是 "披着文件外皮的内存"
-
- [4.1 第一步:pipe() 在内核里建了什么?](#4.1 第一步:pipe() 在内核里建了什么?)
- [4.2 第二步:fork 让子进程 "继承" 了管道](#4.2 第二步:fork 让子进程 "继承" 了管道)
- [4.3 第三步:关掉不用的端,形成单向通道](#4.3 第三步:关掉不用的端,形成单向通道)
- [4.4 第四步:为什么匿名管道只能用于亲缘进程?](#4.4 第四步:为什么匿名管道只能用于亲缘进程?)
- 五、动手实验:父子进程通信
-
- [5.1 简版:五句话完成一次通信](#5.1 简版:五句话完成一次通信)
- [5.2 完整版:双向验证与进程回收](#5.2 完整版:双向验证与进程回收)
- 六、四种读写规则:逐个实验验证
-
- [6.1 情况一:管道为空 && 读端正常 → 读阻塞](#6.1 情况一:管道为空 && 读端正常 → 读阻塞)
- [6.2 情况二:管道写满 && 读端正常 → 写阻塞](#6.2 情况二:管道写满 && 读端正常 → 写阻塞)
- [6.3 情况三:写端全部关闭 && 读端正常 → read 返回 0(EOF)](#6.3 情况三:写端全部关闭 && 读端正常 → read 返回 0(EOF))
- [6.4 情况四:读端全部关闭 && 写端正常 → SIGPIPE 杀死写进程](#6.4 情况四:读端全部关闭 && 写端正常 → SIGPIPE 杀死写进程)
- [6.5 补充:非阻塞模式](#6.5 补充:非阻塞模式)
- 七、管道的大小与写入原子性
-
- [7.1 管道容量有多大?](#7.1 管道容量有多大?)
- [7.2 PIPE_BUF 与原子性](#7.2 PIPE_BUF 与原子性)
- 八、管道的五大特性总结
- [九、常见坑:这几个错误 90% 的人都踩过](#九、常见坑:这几个错误 90% 的人都踩过)
- 十、总结与下一篇预告
-
- [10.1 本篇核心结论](#10.1 本篇核心结论)
- [10.2 下一篇预告](#10.2 下一篇预告)
一、先搞懂:为什么不能用普通文件通信?
在讲管道之前,先排除一个 "想当然" 的方案。
既然通信的前提是 "看到同一份资源",那磁盘上现成的文件不就是天然的吗?进程 A 把数据写进 log.txt,进程 B 打开 log.txt 读取 ------ 看起来完美。
但画一张图你就会发现问题:
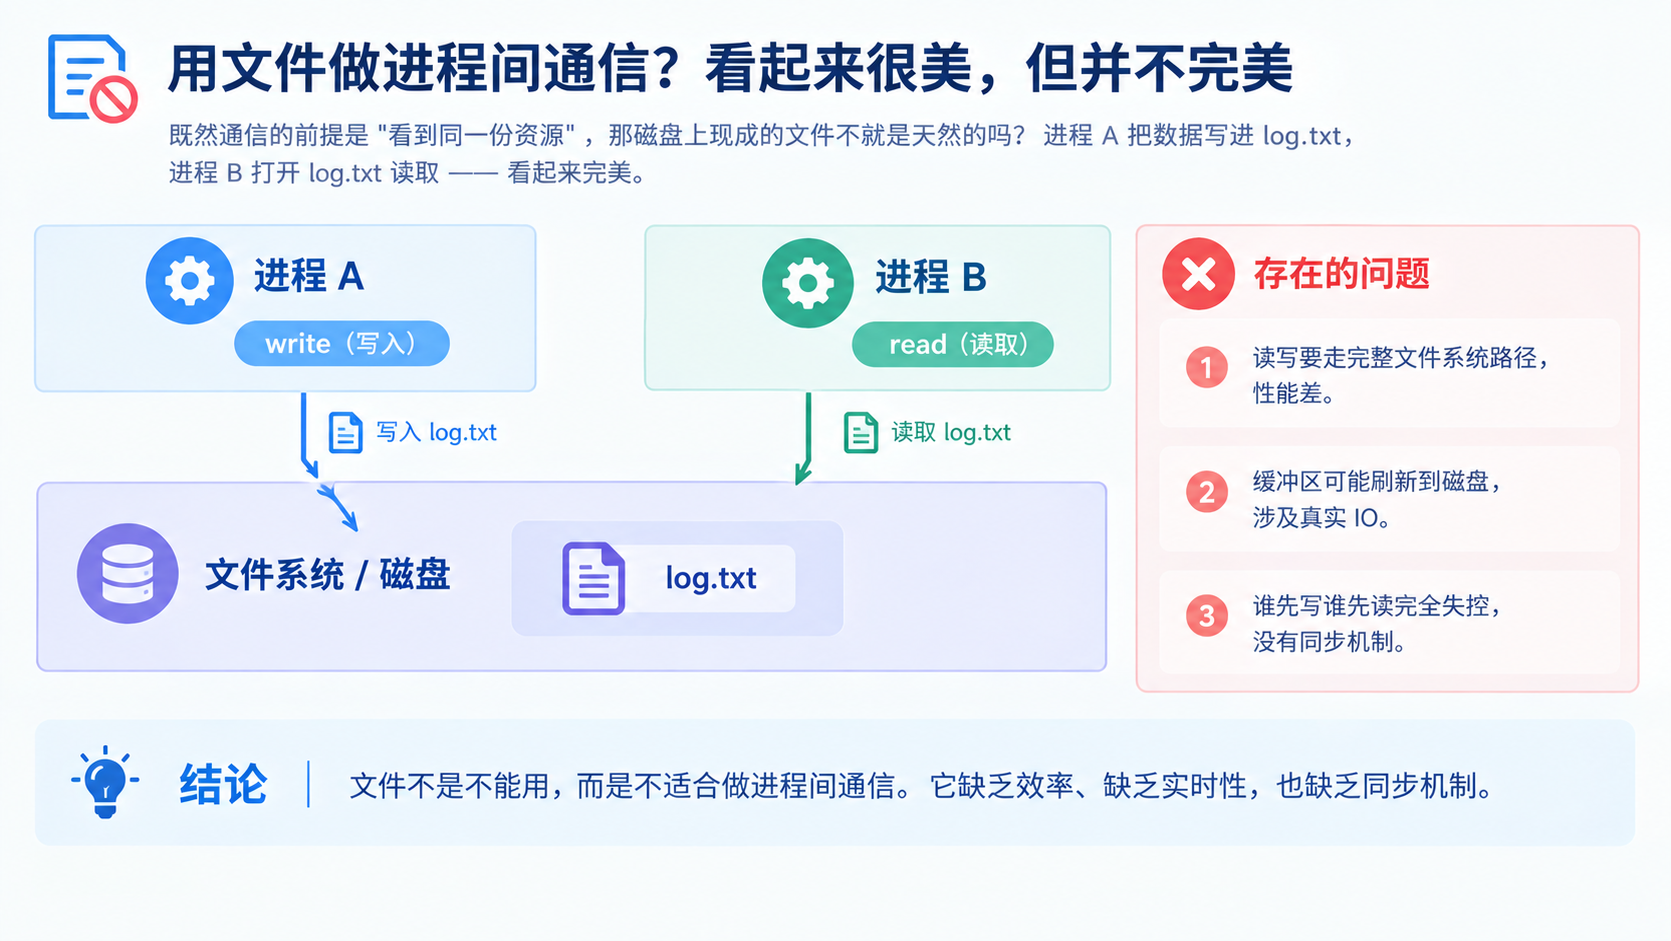
三个致命问题:
- 性能差:读写要走完整的文件系统路径(路径解析、inode 查找),还可能涉及刷盘;
- 时序失控:A 写了没写、B 什么时候能读,OS 不会帮你协调,全靠进程自己碰运气;
- 语义缺失:OS 不会因为 "文件里出现了新数据" 而通知任何人。
所以通信需要的是一份内存级的、由内核专门管理、自带协调能力的公共资源 ------ 这就是管道的出发点。
二、管道是什么:连接两个进程的一条数据流
管道是 Unix 中最古老的进程间通信形式。我们把从一个进程连接到另一个进程的一个数据流称为一个 "管道"。
这个名字起得非常形象 ------ 想象一根水管:
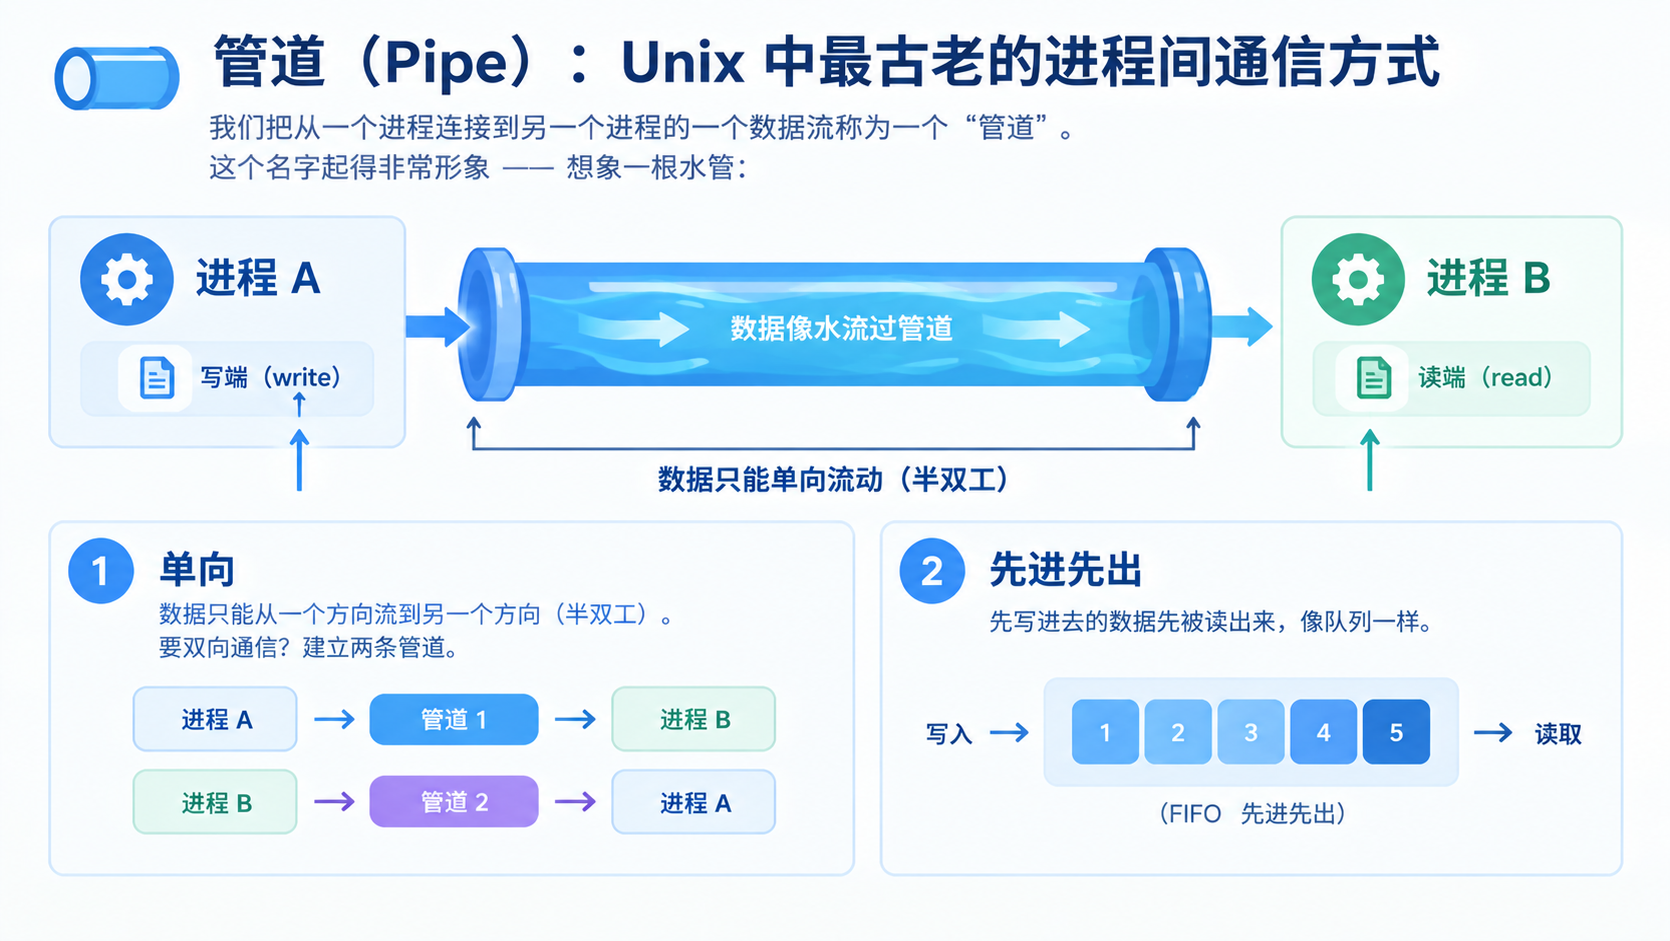
两个关键特征先立住:
- 单向:数据只能从一个方向流到另一个方向(半双工)。要双向通信?建立两条管道;
- 先进先出:先写进去的数据先被读出来,像队列一样。
三、pipe 接口:创建一条管道
3.1 函数原型
c
#include <unistd.h>

int pipe(int pipefd[2]);- 参数 :一个整型数组
pipefd,这是输出型参数 ------ 调用成功后,内核把两个文件描述符写回给你:pipefd[0]:读端(数据从这里流出)pipefd[1]:写端(数据从这里流入)- 这个约定顺序要记死 :
0像嘴巴(读)、1像笔(写),记反了后面全错。
- 返回值:成功返回 0,失败返回 -1(并设置 errno)。
3.2 为什么返回的是文件描述符?
一个细节:管道明明是一段内存,为什么返回的却是 fd(文件描述符)?
因为 Linux 遵循 "一切皆文件" 的设计哲学 ------ 管道被包装成了文件的形式,对管道的读写操作和读写普通文件完全一致 (都是 read/write/close),迎合了 "Linux 一切皆文件" 的思想。这样一来:
- 上层接口完全复用,不需要为管道学一套新 API;
- 内核里复用 struct file 那套框架来管理它(下一节展开)。
3.3 fd 编号的规律
验证一下:如果进程刚启动就调用 pipe(),返回的 fd 是多少?
c
int pipefd[2] = {0};
pipe(pipefd);
printf("pipefd[0]=%d, pipefd[1]=%d\n", pipefd[0], pipefd[1]);
// 输出:pipefd[0]=3, pipefd[1]=4
结果是 3 和 4 ------ 因为每个进程启动时,0、1、2 三个位置已经被标准输入、标准输出、标准错误(都指向终端 tty)占住了,新打开的 "文件" 只能从 3 开始编号。这个细节后面进程池实战中还有大用。
四、内核视角:管道是 "披着文件外皮的内存"
这是本篇最核心的一节。我们分四步,把管道从创建到使用的完整内核图景拼出来。
4.1 第一步:pipe() 在内核里建了什么?
调用 pipe() 时,内核在内存里 开辟一段缓冲区,并创建两个 struct file (一个读端、一个写端),挂进当前进程的文件描述符表 fd_array。注意两点:
- 这两个 struct file 对应的 inode 不指向磁盘上的任何文件 ------ 管道从头到尾不碰磁盘,不需要刷盘;
- 数据就放在 inode 关联的内存缓冲区里(内核按环形队列的方式组织它)。
4.2 第二步:fork 让子进程 "继承" 了管道
关键问题来了:pipe 是当前进程创建的,另一个进程怎么才能看到同一条管道?
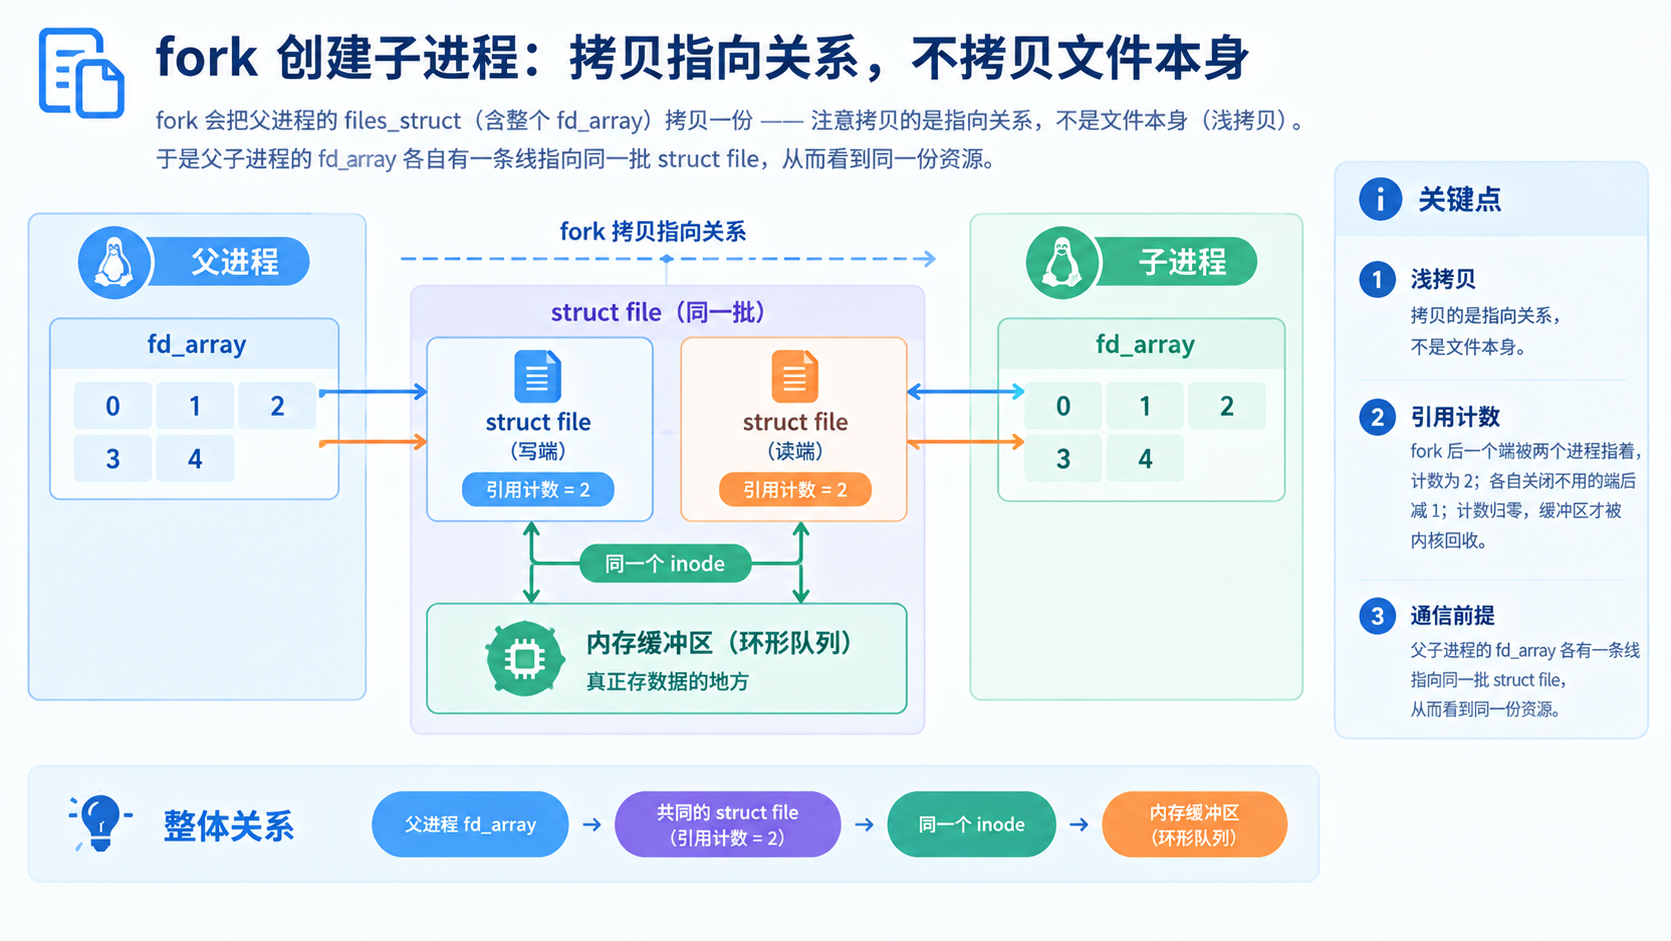
回忆一下:fork 创建子进程时,会把父进程的 files_struct(含整个 fd_array)拷贝一份 ------ 注意拷贝的是指向关系,不是文件本身 (浅拷贝)。于是:
text
        父进程                                 子进程
   ┌─────────────┐                       ┌─────────────┐
   │  fd_array   │                       │  fd_array   │
   │  0  1  2    │                       │  0  1  2    │
   │  3  4       │(fork 拷贝指向关系)      │  3  4       │
   └─┼────┼──────┘                       └─┼────┼──────┘
     │    │  ┌─────────────────────────────┘    │
     │    └──┼───────────────┐                  │
     ▼       ▼               ▼                  ▼
  ┌────────────────┐        ┌────────────────┐
  │ struct file    │        │ struct file    │
  │  (写端)        │        │  (读端)        │
  │  引用计数 = 2   │         │  引用计数 = 2    │
  └───────┬────────┘        └───────┬────────┘
          │      同一个 inode         │
          └──────────┬──────────────┘
                     ▼
          ┌──────────────────────┐
          │  内存缓冲区(环形队列) │   ← 真正存数据的地方
          └──────────────────────┘
父子进程的 fd_array 各有一条线指向同一批 struct file ------ 这就满足了通信的前提:两个进程看到了同一份资源。每个 struct file 上有引用计数,fork 之后一个端被两个进程指着,计数为 2;各自关闭不用的端后减 1;计数归零,缓冲区才被内核回收。
4.3 第三步:关掉不用的端,形成单向通道
管道是单向的,通信前双方要各让一步:
- 子进程要写、父进程要读 → 子进程
close(pipefd[0])(关读端),父进程close(pipefd[1])(关写端); - 这样就形成了 "父写子读"(或反过来)的单向数据流。
4.4 第四步:为什么匿名管道只能用于亲缘进程?
这是 "匿名" 二字的根本来源,一定要想透:
- 普通文件有路径名 ,两个毫不相干的进程可以各自
open("/tmp/log.txt")打开同一个文件; - 而管道没有路径、没有名字,是纯内存对象,第三方进程根本 "找不到" 它;
- 想拿到这条管道的 fd,唯一的途径就是 fork 那一刻对 fd 表的整体拷贝。
所以匿名管道天然只能用于有血缘关系的进程(父子、兄弟)之间。那没有亲缘关系的进程怎么办?------ 第四篇的命名管道 FIFO 会解决。
五、动手实验:父子进程通信
5.1 简版:五句话完成一次通信
c
// simple_pipe.c
#include <unistd.h>
#include <stdlib.h>
#include <stdio.h>
#include <errno.h>
#include <string.h>

#define ERR_EXIT(m) \
do { \
    perror(m); \
    exit(EXIT_FAILURE); \
} while(0)

int main(int argc, char *argv[])
{
    int pipefd[2];
    if (pipe(pipefd) == -1)
        ERR_EXIT("pipe error");

    pid_t pid;
    pid = fork();
    if (pid == -1)
        ERR_EXIT("fork error");

    if (pid == 0) {                     // 子进程:写端
        close(pipefd[0]);               // 关掉不用的读端
        write(pipefd[1], "hello", 5);
        close(pipefd[1]);
        exit(EXIT_SUCCESS);
    }

    close(pipefd[1]);                   // 父进程:关掉不用的写端
    char buf[10] = {0};
    read(pipefd[0], buf, 10);
    printf("buf=%s\n", buf);

    return 0;
}
运行输出 buf=hello。注意代码里的顺序纪律:先 pipe,再 fork ;fork 之后立刻关掉自己不用的那一端。
5.2 完整版:双向验证与进程回收
实际项目中我们还要处理 read 的三种返回值、回收子进程避免僵尸:
c
// testpipe.cc
#include <iostream>
#include <cstdio>
#include <cstring>
#include <cstdlib>
#include <unistd.h>
#include <sys/types.h>
#include <sys/wait.h>

const int size = 1024;

void Writer(int wfd)    // 子进程:写端
{
    std::string buffer = "hello, I am child-";
    pid_t self = getpid();
    int number = 0;
    char buffer_out[1024];

    while (true)
    {
        sleep(1);   // 每秒写一次,方便观察父进程的阻塞
        // 用 snprintf 组装带 PID 和序号的消息
        snprintf(buffer_out, sizeof(buffer_out), "%s%d-%d",
                 buffer.c_str(), self, number++);
        write(wfd, buffer_out, strlen(buffer_out));
        // 注意:只写 strlen(buffer),不要 +1 ------ 不把多余的 '\0' 写进管道
    }
}

void Reader(int rfd)    // 父进程:读端
{
    char buffer[1024];
    while (true)
    {
        sleep(5);   // 故意读得慢:5 秒才读一次
        ssize_t n = read(rfd, buffer, sizeof(buffer));
        if (n > 0)
        {
            buffer[n] = 0;              // 手动补 '\0' 才能安全当字符串打印
            std::cout << "父进程收到消息: " << buffer << std::endl;
        }
        else if (n == 0)                // 写端全部关闭且管道为空 → EOF
        {
            std::cout << "写端已关闭,读到了文件结尾(EOF)" << std::endl;
            break;
        }
        else
        {
            std::cerr << "read error" << std::endl;
            break;
        }
    }
}

int main()
{
    int pipefd[2] = {0};
    int n = pipe(pipefd);
    if (n < 0) return 1;

    pid_t id = fork();
    if (id == 0)
    {
        // 子进程
        close(pipefd[0]);               // 关读端
        Writer(pipefd[1]);
        close(pipefd[1]);
        exit(0);
    }
    // 父进程
    close(pipefd[1]);                   // 关写端
    Reader(pipefd[0]);

    pid_t rid = waitpid(id, NULL, 0);   // 回收子进程,避免僵尸
    (void)rid;
    return 0;
}
这段代码里埋了几个刻意的细节,都是实际编码的纪律:
write(wfd, buffer_out, strlen(buffer_out))只写有效长度,不要 +1 ------ 避免 '\0' 也进管道污染数据;- 读到的数据要手动
buffer[n] = 0------ 管道传的是裸字节,不保证字符串结尾; - 父进程故意读得慢(5 秒),子进程写得快(1 秒) ------ 就是为了引出下一节的读写规则;
waitpid(id, NULL, 0)回收子进程 ------ 配合(status >> 8) & 0xFF还能拿到子进程退出码,(status & 0x7F)拿到终止信号,这是进程控制系列的知识。
用 ps -l 观察还能看到血缘关系的铁证:子进程的 PPID 等于父进程的 PID ------ "匿名管道要求血缘关系" 在进程表上的直接体现。
六、四种读写规则:逐个实验验证
管道的行为可以浓缩成 "四种情况",每一种都值得亲手验证一遍。设读写双方 "正常" 指的是对方 fd 还开着。
6.1 情况一:管道为空 && 读端正常 → 读阻塞
上面 5.2 的代码就是这个实验:子进程每 1 秒写一条,父进程每 5 秒读一条。父进程读完管道里的存量数据后,管道空了,read 就不再返回,进程睡眠等待,直到子进程写入新数据。
当没有数据可读时:默认(
O_NONBLOCKdisable)read调用阻塞,进程暂停执行,一直等到有数据来到为止。
6.2 情况二:管道写满 && 读端正常 → 写阻塞
让子进程疯狂写、父进程睡大觉不读:
c
// full_test.c ------ 子进程不停写,父进程 100 秒后才读
if (id == 0) {
    close(pipefd[0]);
    const char *msg = "aaaaaaaaaaaaaaaaaaaa";
    while (1) write(pipefd[1], msg, 20);   // 全速写入
}
// 父进程 sleep(100) 之后才开始 read现象:子进程会写一阵子然后卡住 (管道满,write 阻塞),直到父进程开始读,子进程才继续写。用 ps 能看到子进程处于睡眠态 ------ 这就是管道自带的 "背压" 机制,内核自动控制了写入方的节奏。
6.3 情况三:写端全部关闭 && 读端正常 → read 返回 0(EOF)
c
// 子进程写一条就退出(写端随之关闭)
if (id == 0) {
    close(pipefd[0]);
    write(pipefd[1], "bye", 3);
    close(pipefd[1]);      // 写端关闭!
    exit(0);
}
// 父进程读完 "bye" 后继续 read:
// 返回值 n == 0 ------ 不是错误,是 EOF
注意区分 :read 返回 0 不是出错,而是 "所有写端都关了、管道也空了",等价于读到文件结尾(EOF)。5.2 完整版代码里 n == 0 分支就是处理这种情况 ------ 它是管道通信中判断 "对端退出" 的标准方法。
6.4 情况四:读端全部关闭 && 写端正常 → SIGPIPE 杀死写进程
反过来,父进程直接退出(读端关闭),子进程还在写:
c
// 父进程:close(pipefd[1]) 后 close(pipefd[0]),直接 return;
// 子进程还在 while(1) write(...);
现象:子进程写入时收到 SIGPIPE(13 号信号) ,默认动作是终止 ------ 子进程无声无息地死掉了。可以用 kill -l | grep PIPE 确认 13 号信号的存在。
这个行为的含义是:"都没人读了你还写,管道已经没有存在意义,内核直接处决写方"。它也是一把双刃剑 ------ 后面进程池实战中,控制子进程退出的正确姿势和这里的错误姿势都会反复出现。
6.5 补充:非阻塞模式
以上都是默认行为。如果通过 fcntl 给管道 fd 设置 O_NONBLOCK:
- 管道空时
read不再阻塞,立即返回 -1,errno 为EAGAIN; - 管道满时
write同样返回 -1、EAGAIN。
这个模式在 IO 多路复用场景会大量使用,本系列先知道有这回事即可。
七、管道的大小与写入原子性
7.1 管道容量有多大?
管道缓冲区不是无限的。Linux 中可以用两种方式查证:
bash
$ ulimit -a | grep "pipe size"      # 部分 shell 可以直接看
$ getconf PAGESIZE                  # 管道容量与页大小相关
在 Linux 2.6.11 之后,默认管道容量是 65536 字节(64KB)。验证思路就利用 6.2 的实验:子进程全速写、父进程不读,统计子进程实际写进去多少字节后卡住 ------ 正好卡在 64KB 附近。
7.2 PIPE_BUF 与原子性
容量之外还有一个更重要的常量 ------ PIPE_BUF(Linux 下默认 4096 字节):
- 要写入的数据量 不大于 PIPE_BUF 时,Linux 保证这次写入是原子的 ------ 要么完整写进去,要么一条都不写,多个进程同时往一条管道写也不会出现两条消息 "搅和" 在一起;
- 要写入的数据量 大于 PIPE_BUF 时,不再保证原子性 ------ 数据可能被分多次写入,中间可能夹杂其他进程的数据。
这解释了进程池实战中一个设计细节:任务码用 int(4 字节 < PIPE_BUF)传递,天然原子、不会乱序混叠。也再次埋下伏笔 ------ 管道是字节流,没有消息边界,需要接收方按约定长度切分;而第六篇的消息队列就是来解决 "边界" 问题的。
八、管道的五大特性总结
| 特性 | 含义 |
|---|---|
| 亲缘限制 | 只能用于具有共同祖先(亲缘关系)的进程之间通信;由一个进程创建后 fork 使用 |
| 半双工 | 数据只能单向流动;双方都要通信时,需要建立两条管道 |
| 流式服务 | 面向字节流,数据没有边界、没有类型,"写入多少次" 与 "读出多少次" 没有对应关系 |
| 生命周期随进程 | 一般而言,进程退出,管道释放 |
| 自带同步互斥 | 内核会对管道操作进行同步与互斥(读写阻塞、原子写入都是体现)------ 对比第五篇共享内存 "完全裸奔",这里是内核帮你兜底 |
其中 "流式服务" 值得单独强调:你写 3 次、每次 10 字节,对端可能一次 read 读出 30 字节,也可能分 3 次读出 ------ 字节流在管道里就是一条连续的水流,没有 "一条一条消息" 的概念。想要边界,要么像进程池那样 "定长任务码" 约定,要么用分隔符协议,要么换消息队列。
九、常见坑:这几个错误 90% 的人都踩过
- 先 fork 后 pipe ------ 两个进程各自建了各自的管道,永远通信不上。正确顺序永远是:先
pipe(),再fork(); - 忘记关闭不用的端 ------ fork 把 fd 表拷贝给子进程后,只要还有任何进程持有写端,引用计数就不会归零,读端永远等不到 EOF;读端同理,会干扰 SIGPIPE 的触发判断。fork 之后立刻各关一端;
write(fd, buf, strlen(buf) + 1)------ 把 '\0' 也写进管道,接收方数据被污染;管道传裸字节,长度自己约定;- 把 read 返回 0 当错误 ------ 它是 EOF,是 "对端关闭" 的信号,处理错了通信就断了;
- 低估 SIGPIPE ------ 读端关闭后继续写,进程被 13 号信号默认杀掉,且没有 core 信息,很多人以为程序 "凭空消失"。服务程序里通常要捕获或忽略 SIGPIPE 自行处理。
十、总结与下一篇预告
10.1 本篇核心结论
- 管道的本质是内核内存里的一段缓冲区,借用文件框架(struct file / inode)组织,不碰磁盘 ------ "披着文件外皮的内存";
- 通信的前提是 "看见":pipe() 先在父进程 fd 表里挂上读写两端,fork() 时子进程整体拷贝 fd 表(拷贝的是指向关系),两个进程因此共享同一条管道;
- 四种读写规则:空读阻塞、满写阻塞、写关读返 0(EOF)、读关写收 SIGPIPE;
- 写入量 ≤ PIPE_BUF(4096)时保证原子性;管道容量默认 64KB;
- 五大特性:亲缘、半双工、字节流、生命周期随进程、内核自带同步互斥。
10.2 下一篇预告
管道的接口虽然只有一个 pipe(),但它的工程价值远不止 "父子传话"。下一篇《进程通信系列(三):匿名管道实战 ------ 手写多进程任务分发进程池》,我们用它做一个真实的小项目:父进程(Master)创建一批子进程(Worker),通过管道负载均衡地派发任务码,并处理 "退出时管道该怎么关、子进程该怎么收" 这类看似简单实则暗藏 bug 的收尾问题 ------ 其中有一个藏得很深的 fd 泄漏 bug,值得亲自踩一遍。