很多人以为,AI 会写代码了,架构师就要失业了。相反,我认为 AI coding 用一句话概述:其实就是软件工程和项目管理
我最近又研究了一下很火的 Matt Pocock 那套开源的 skills(github.com/mattpocock/skills,一套装进 Claude Code / Codex 这类 AI 编程工具、用 /命令 调用的技能包)一个个拆开读完,我发现它整个骨架压根不是「教 AI 怎么用工具」------它是在复习软件工程基本功。
先看这个仓库的骨架:四个失败模式
它的 README 里有一节叫「Why These Skills Exist」,作者把自己用 AI 编程工具踩过的坑列成了四条。这是他自己的原话标题,我直译过来:
- Agent 没做我想要的东西------对齐失败
- Agent 太啰嗦了------话太多,token 烧得太快
- 代码跑不起来------它写了一堆,但没验证过
- 我们建出了一坨泥------能跑,但没人敢改
这四条,干过两年开发的人应该都不陌生。它们跟 AI 没关系,它们是软件工程自己的老毛病------只是 AI 把它们放大了一遍。
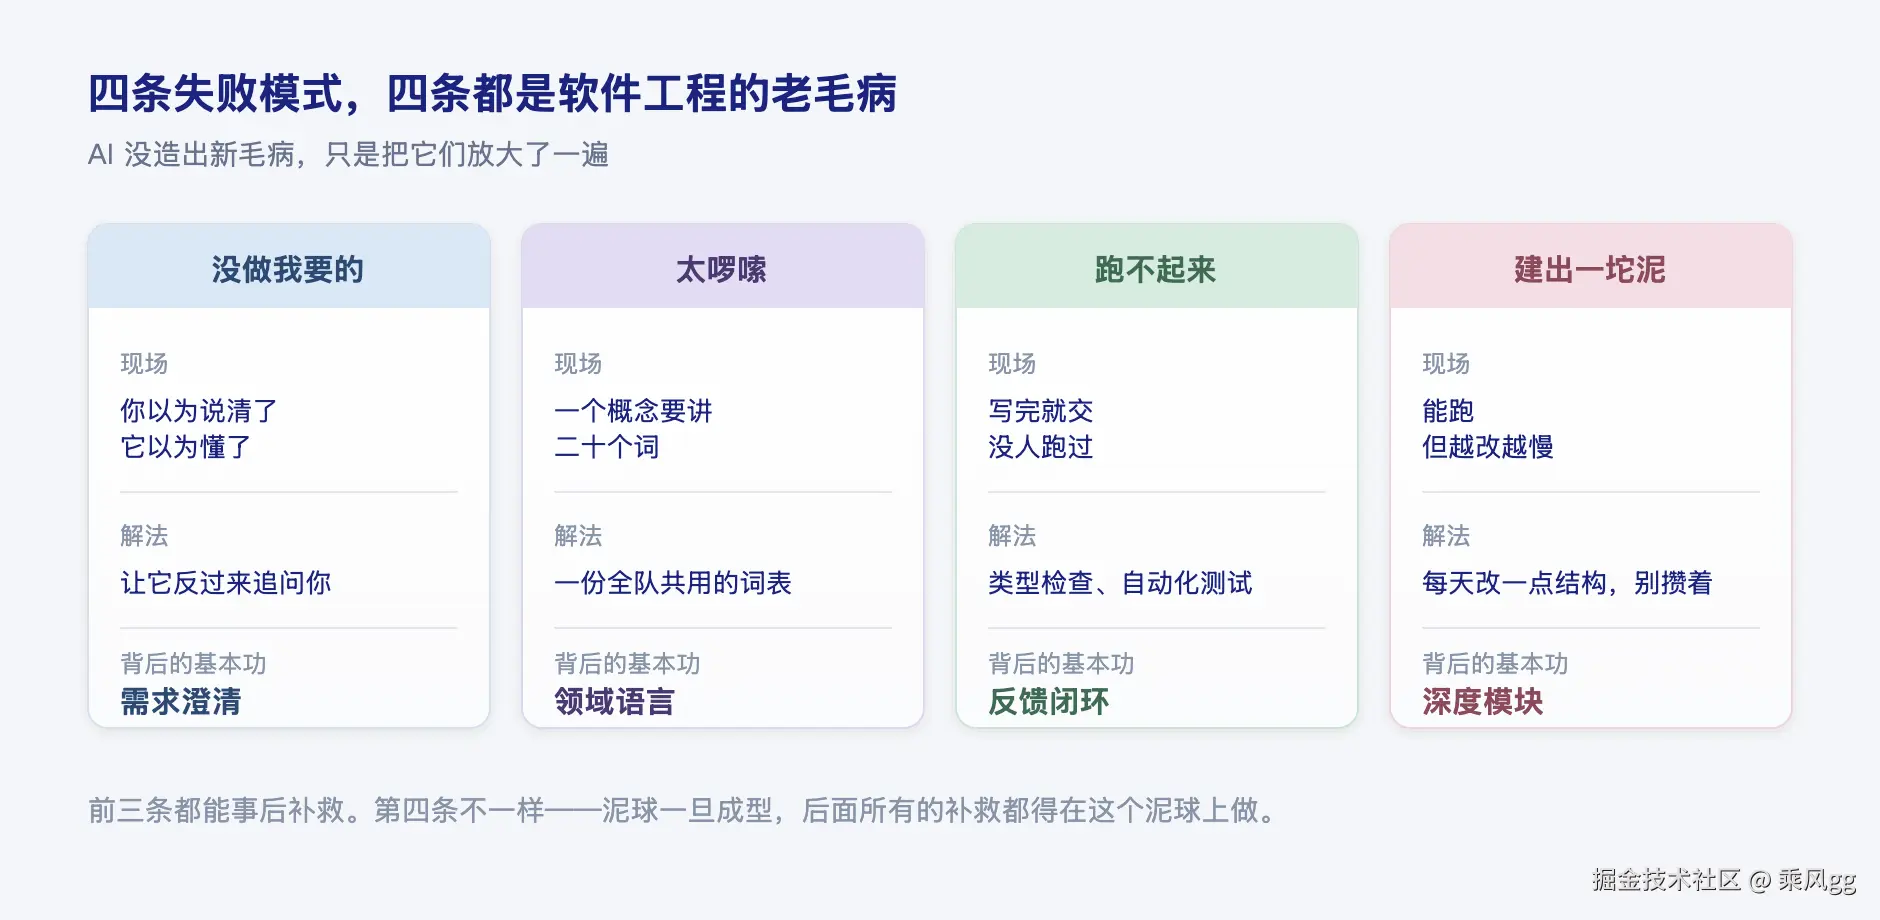
| 失败模式 | 现场什么样 | 这个仓库怎么解 | 背后那门基本功 |
|---|---|---|---|
| 没做我要的 | 你以为说清了,它以为懂了 | 让它反过来追问你 | 需求澄清 |
| 太啰嗦 | 一个概念讲二十个词 | 一份全队共用的词表(CONTEXT.md) |
领域语言 |
| 跑不起来 | 写完就交,没人跑过 | 类型检查、自动化测试 | 反馈闭环 |
| 建出一坨泥 | 能跑,但越改越慢 | 每天改一点结构,别攒着 | 深度模块 |
四条都得管,只是轻重不同
前三条能事后补救------对齐没做好,多聊几轮还能补;啰嗦,那是提示词问题;跑不起来,加测试就行。
第四条不一样,它不可逆。 泥球一旦成型,你后面所有的补救都得在这个泥球上做。
所以这一篇先讲第四条------它最要命,也最不可逆;前三条留到下一篇。
人忍得了烂代码,AI 忍不了
人对烂代码是有耐受度的。
在一个二十个文件互相 import 的项目里,老人靠记忆和经验维护------他知道「这几个文件是鉴权相关的」,改的时候绕开坑走。忍一忍,还能干活。
AI 没有这种耐受度。 它每次都从零开始读你的代码库,而且它没有品味,只会抄------代码库里有一个烂模式,它就一直复制。你在 CLAUDE.md(那份每次请求都会一起发给 AI 的项目说明)里白纸黑字写「别这么写」,它下一轮照样照着代码库的样子抄。
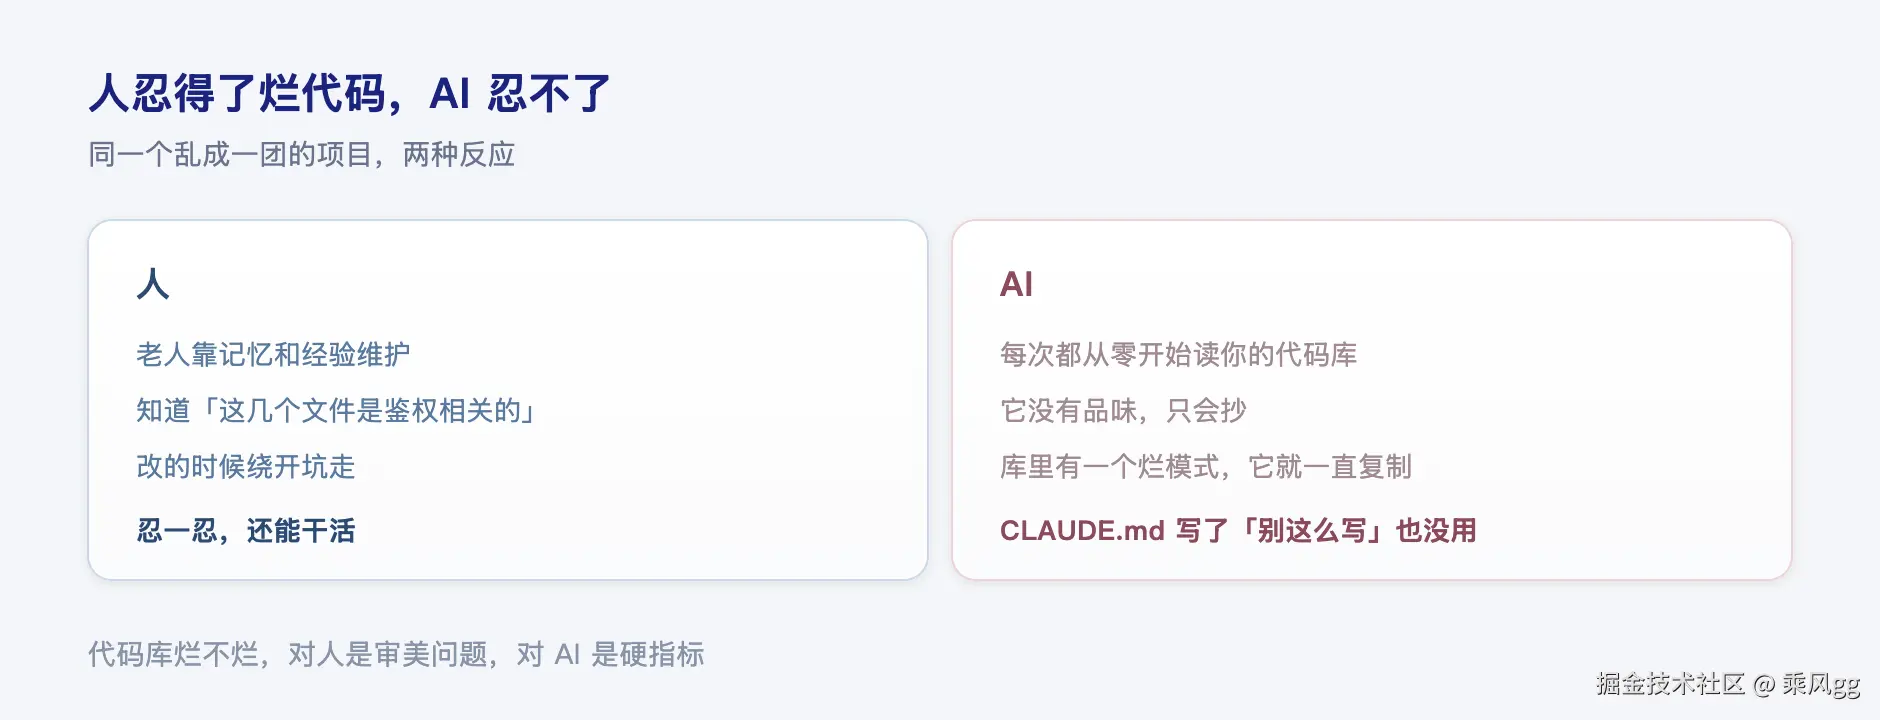
这个仓库的 README 里还有一句判断:AI 能大幅加快写代码的速度,同时也加快了「软件熵」的增长------熵就是系统自发变乱的趋势,而它变乱的速度前所未有。
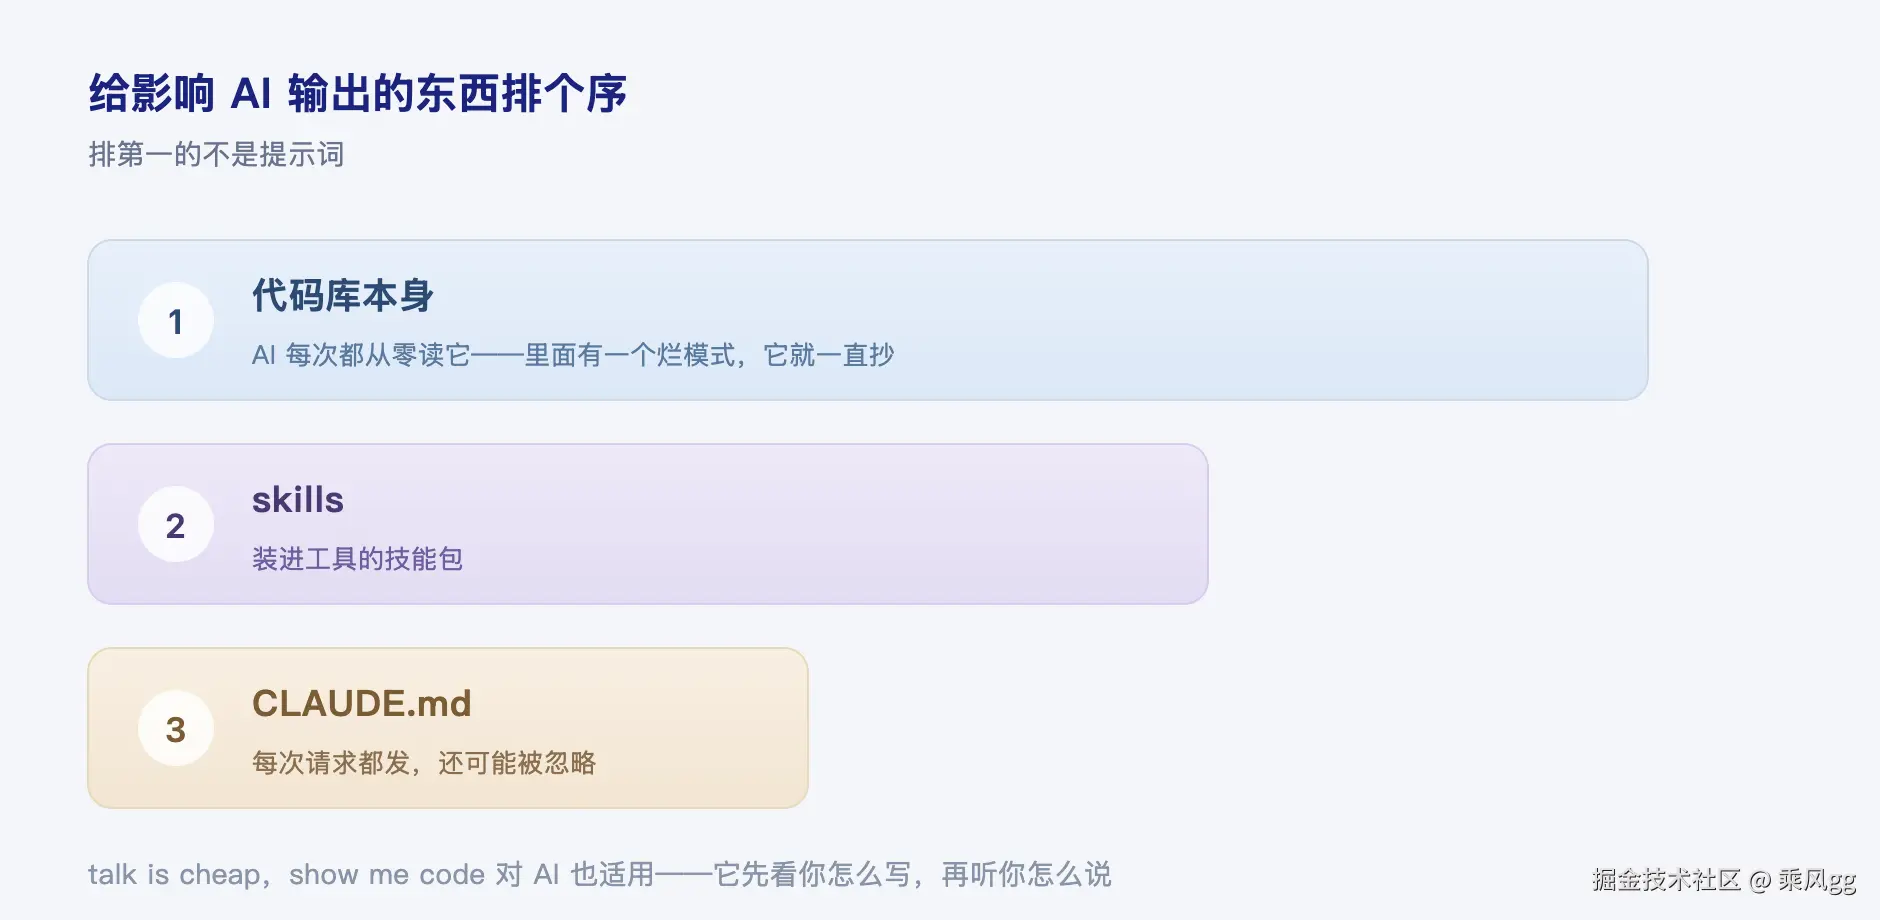
代码库的最终架构和可维护性,是你能给 AI 的最强参考和约束。 给影响 AI 输出的东西排个序,是代码库 > skills > CLAUDE.md ------排第一的不是提示词,是你代码库本身长什么样,所以 talk is cheap,show me code 对 AI 也适用。
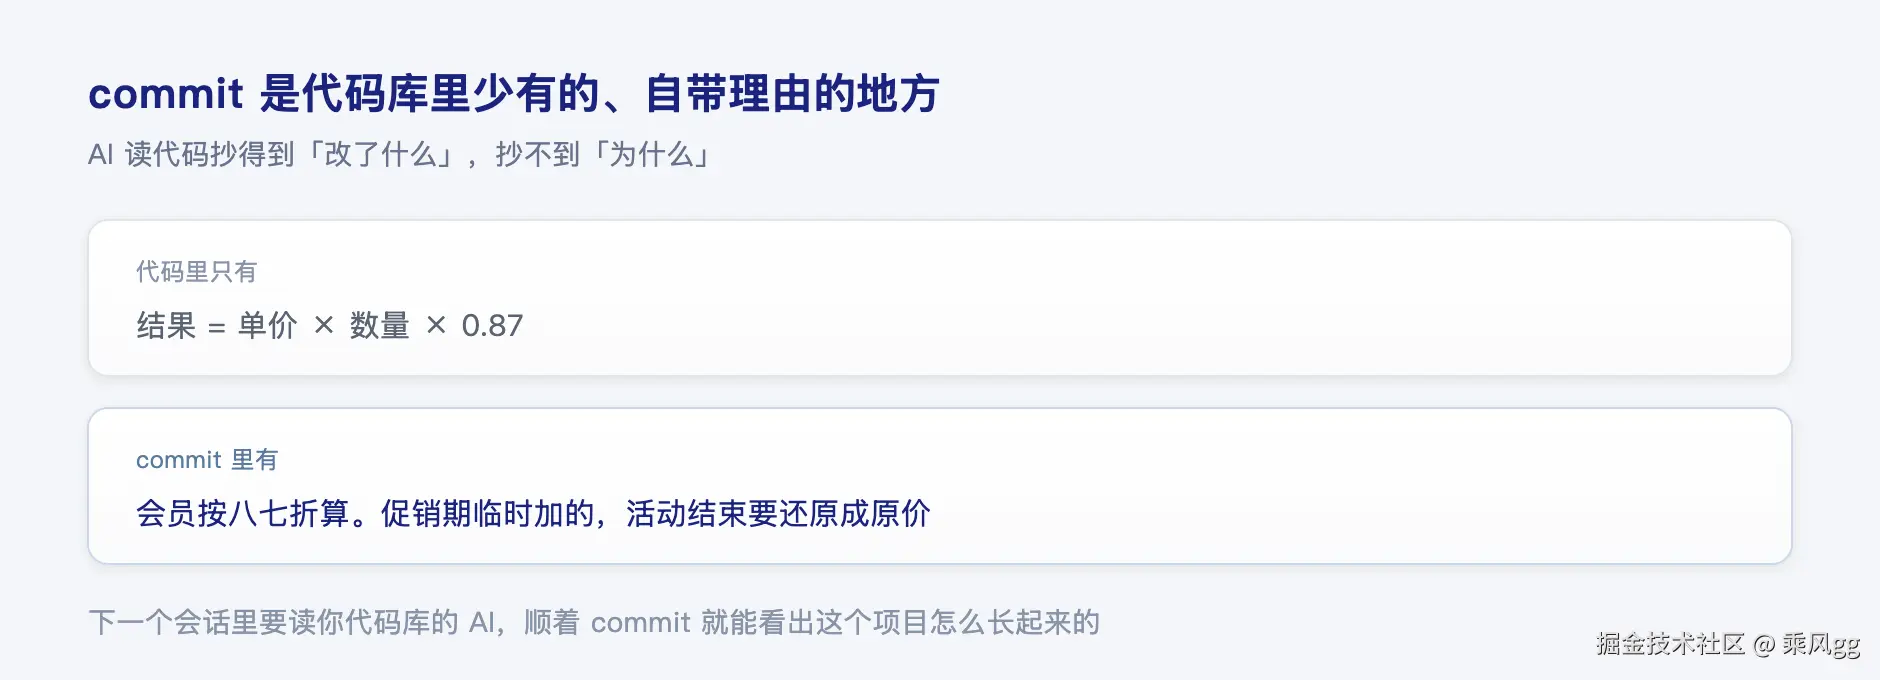
还有一样东西被 AI 其实很看重:commit message。
以前它是写给同事看的,潦草点没人管。现在它多了一个读者------下一个会话里要读你代码库的 AI。commit 把「改了什么」和「为什么改」绑在一起,是代码库里少有的自带理由的地方。AI 顺着它就能看出这个项目怎么长起来的、哪些地方绕开过。
代码里只有「改了什么」,commit 里有「为什么」。AI 读代码抄得到前者,抄不到后者------除非你写下来。
好架构的标准:改得动、读得懂、边界清楚
在展开解法之前,得先把「什么叫架构好」说清楚,不然「深度模块」听着像又一个设计模式。
John Ousterhout 给过一个定义,我很认同。他是斯坦福的教授,写了本《A Philosophy of Software Design》------这本书专讲怎么设计模块,下面要说的「深度模块」也出自那里。
他说,复杂度就是任何让系统难以理解和修改的东西。顺着这个,我把「架构好不好」折成三句话:
- 改得动:一次改动影响的面小,不连锁(变更放大低)
- 读得懂:读的人第一次猜就猜对,不需要额外信息才能动手(认知负荷低、没有未知的未知)
- 边界清楚:复杂度被压在少数深模块里,接口薄,决策不外泄(依赖少、不晦涩)
这三条平淡得不像架构理论,但每一条都能在十分钟内验。随便挑一个你最近改过的模块,回想一下:这次改动波及了几个文件?有没有一个你不敢动的地方?
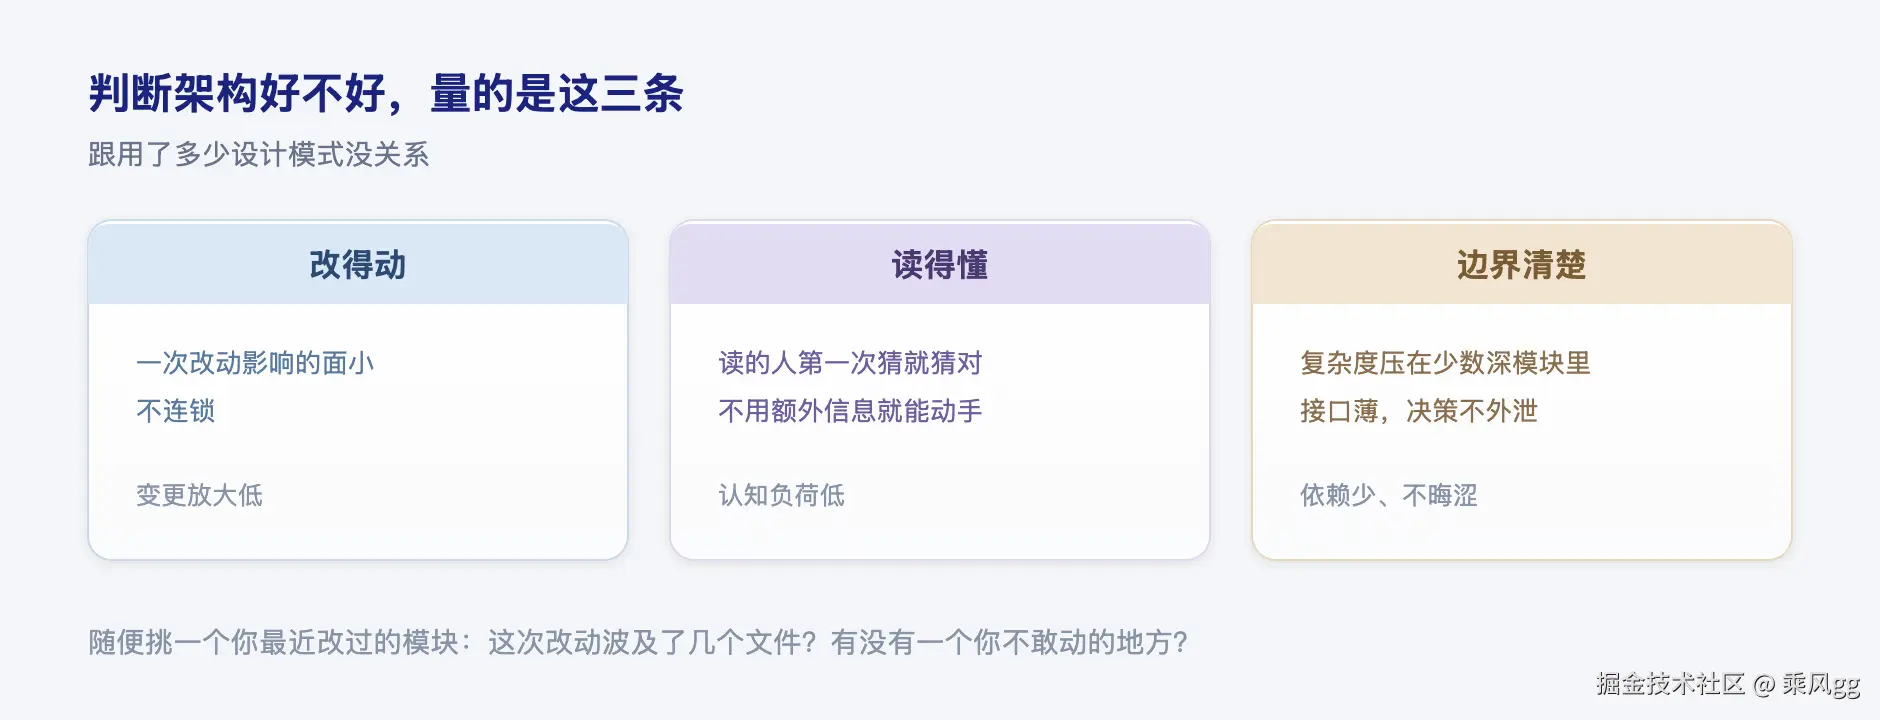
判断架构好坏,量的是这三条,跟用了多少设计模式没关系。
什么叫「深度模块」
「深度模块」这个词同样出自 Ousterhout 那本书。一句话:大量行为藏在一个小接口后面。
反过来叫浅模块 ------接口的复杂度跟它藏起来的东西差不多。这种模块看着很规整(一个文件、一个导出、职责单一),但它什么都没藏住------不开五个文件就理解不了一个概念,改一处还得往下翻三层。
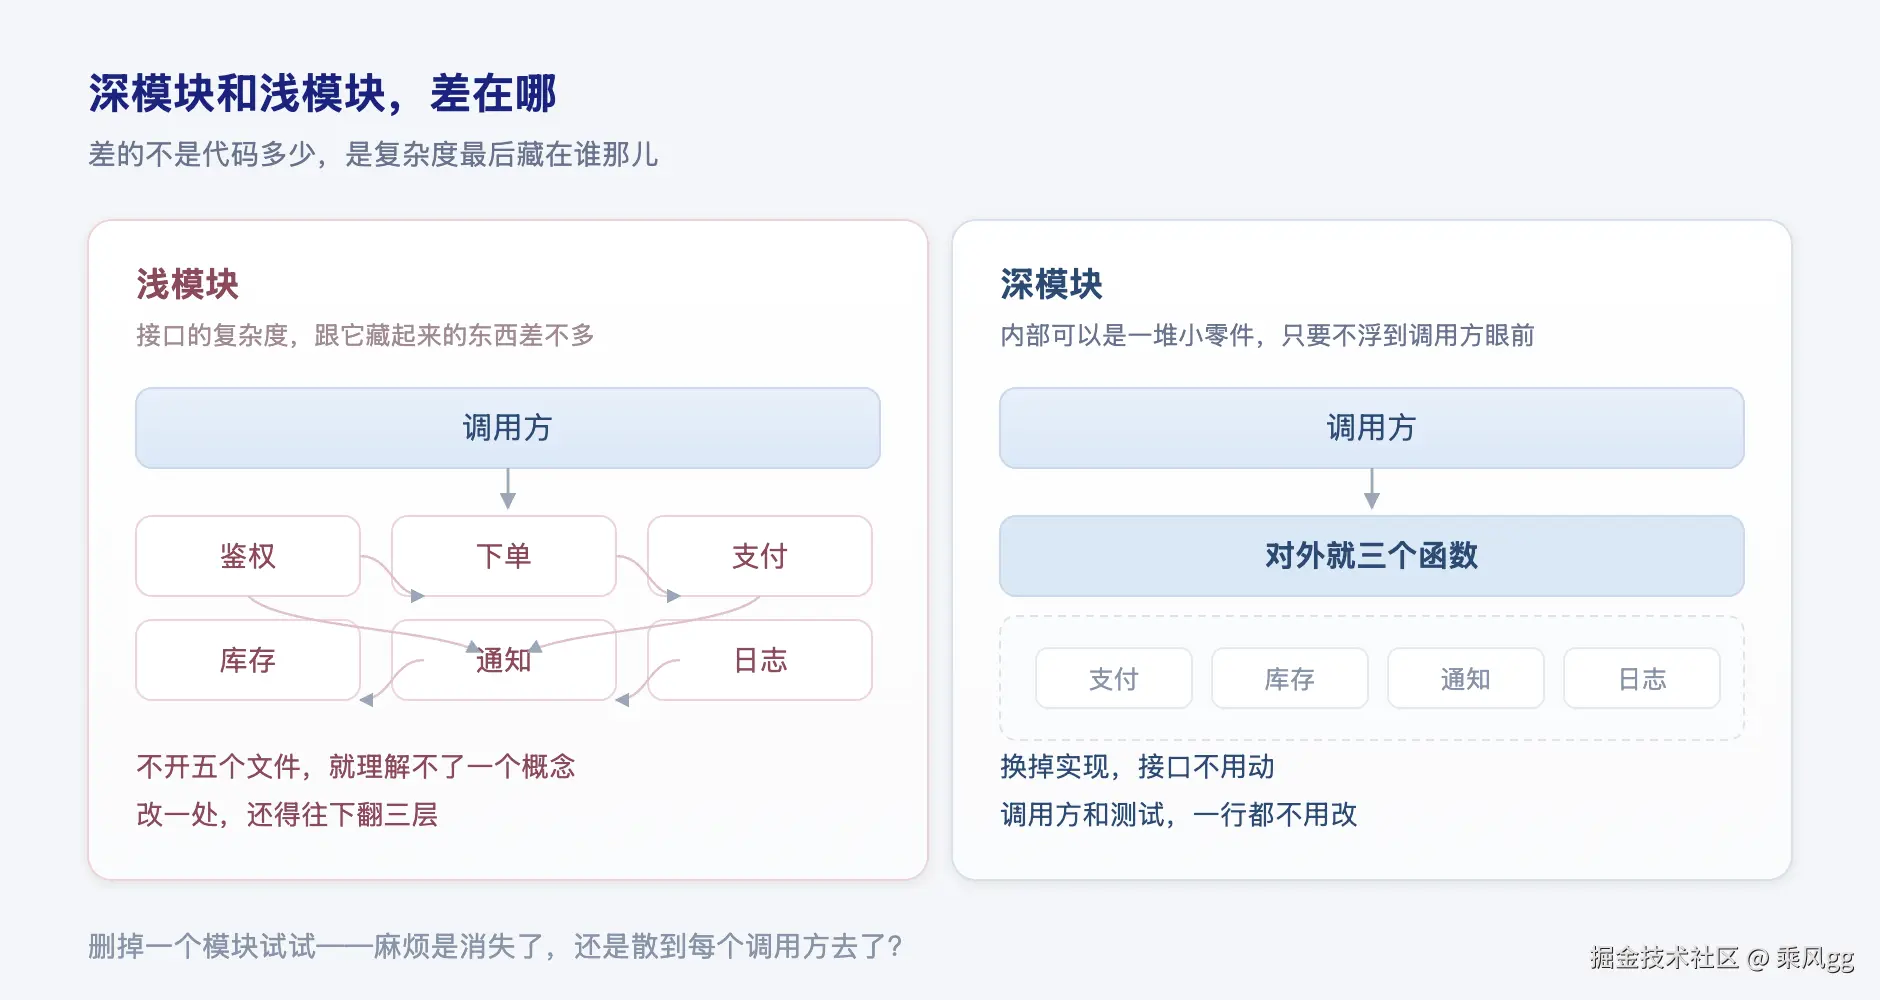
换掉实现,接口不用动
容易误会的一点:深度模块不是「黑盒」------把东西锁进去,谁也别看。这个仓库里的比喻更准:它是灰盒,出了事你可以往里看。
深度是接口的属性,不是实现的属性。 一个深度模块内部可以是一堆小而可替换的零件,只要它们不浮到调用方眼前。
于是默认的分工就是:人管接口,AI 管实现。 搬到 AI 协作里,这个分工还能再推一步:实现是可以整个丢掉的。 只要接口没变,后面那坨实现你可以删干净让 AI 重写,调用方和测试一行都不用动。
所以在深度模块里,测试比实现更值得读------测试锁住的是接口的行为,不是某一段代码的写法。
怎么判断深浅
删减测试
想象把这个模块整个删掉,看会发生什么。 只有两种结果。
一种是删了之后什么都没变 ------调用它的地方,只要把调用的名字换一下(原来调它,现在直接调它下面那个),逻辑一行都不用补。这说明它平时干的唯一一件事,就是把调用转手给别人------转一手,删了正好。
另一种是删了之后麻烦散得到处都是------原本一句话就能调的地方,现在每个调用方都得自己把里面的逻辑补一遍。这说明复杂度本来被它收着,现在散了。
只有第二种是深模块------复杂度被它收着,深度就出来了。第一种不算,它只是把调用转了一手。
一句话概括这个检验:这个模块是把复杂度藏住了,还是只把它换了个地方放?
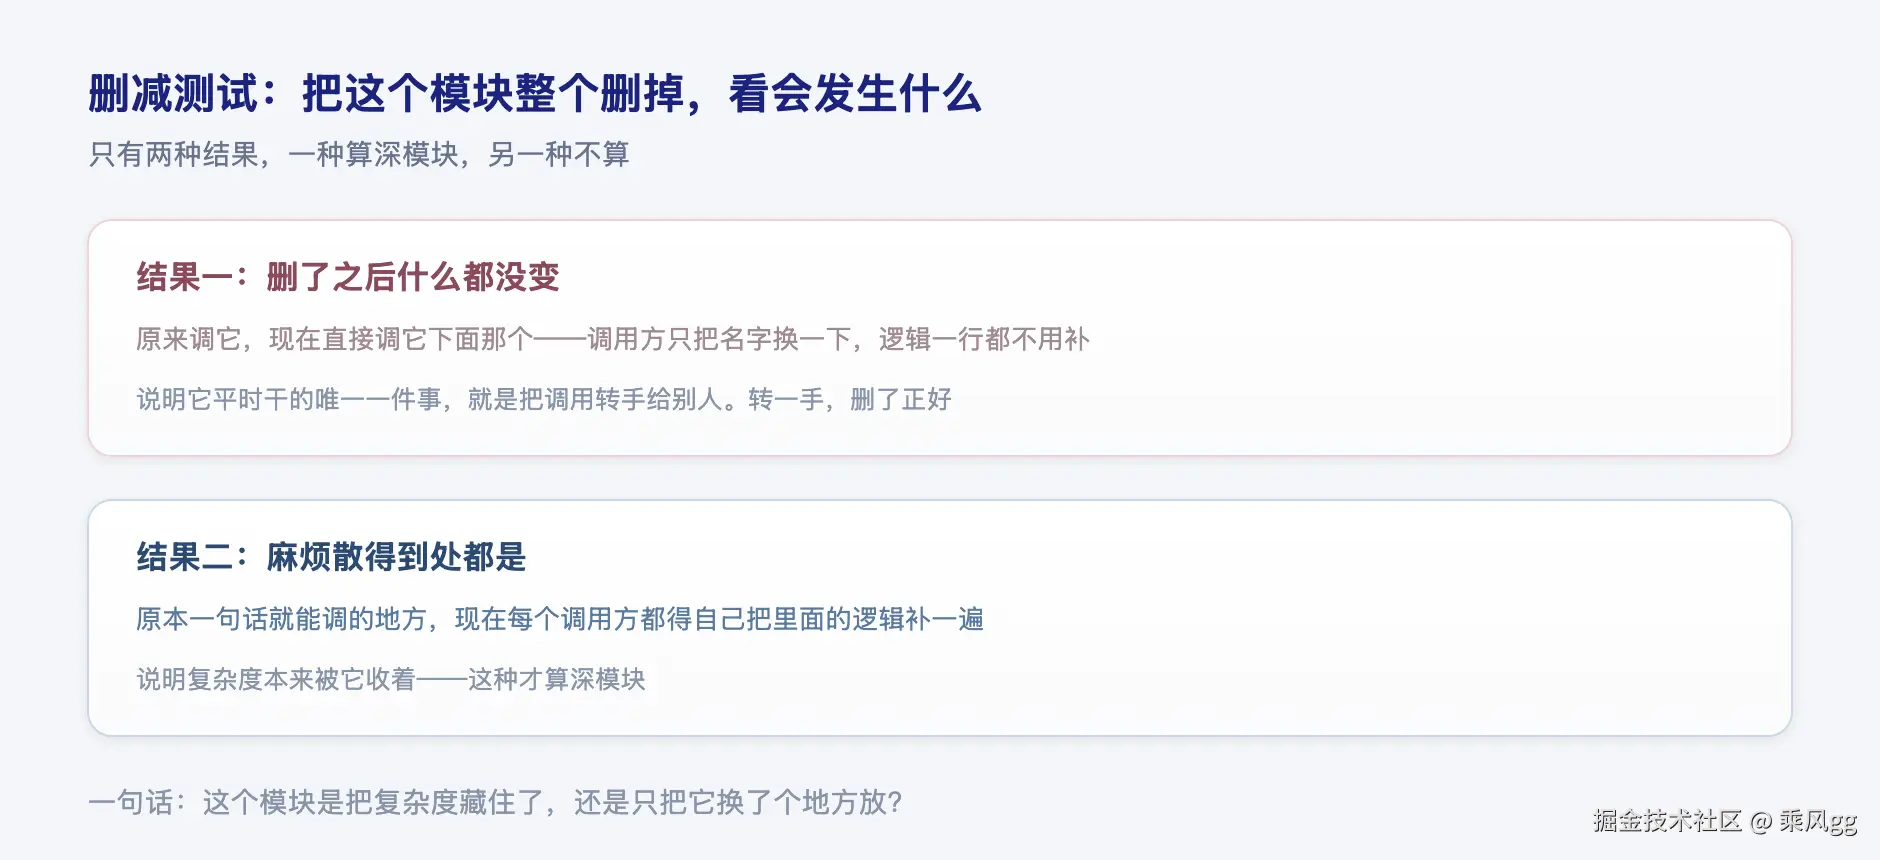
举个小例子。系统里有个「下单」模块,把它删掉试试:如果各个页面只是把 order.create() 换成 orderService.create(),别的什么都没变,那是第一种;如果各个页面开始自己拼参数、自己调支付、自己判库存,那就是第二种。
只有一个实现,就别切接口
假设你写了个模块,心里想着「以后可能要换数据库」,于是先在中间垫一层接口。这层该不该垫?
这个仓库的答案很简单:看有没有第二个实现。
眼下只有一种实现,这层接口就是你想出来的------底下从来没换过东西,它也就没起过作用,只多了一层要维护的转发。等你真接上第二种(从 MySQL 换到 Postgres,或者测试时塞一个假的进去),再切这一刀也不迟。
别为想象中的变化预留接口。 这一条也是给「深度模块」装的刹车:不是接口越多越架构。一层接口的用处,是底下换掉的时候,上头不用跟着改。 你到现在只用过一种数据库,这件事从来没发生过------那它就只是多出来的一层。
测试写不下去,问题在架构
修 bug 时,你一般会先写一条测试把它复现出来。但如果写着写着发现:根本没地方写。
一般人到这儿就算了,觉得"这段代码不好测"。换个角度:不是代码不好测,是这套架构没给你留地方。
要写测试,代码里得有一处能切入的地方------从那儿能观察到出问题的行为,又不用惊动一片调用方。这个仓库管这种地方叫接缝(seam)。翻遍代码库找不到,就意味着这个 bug 你没法用测试看住,它还会再冒出来。
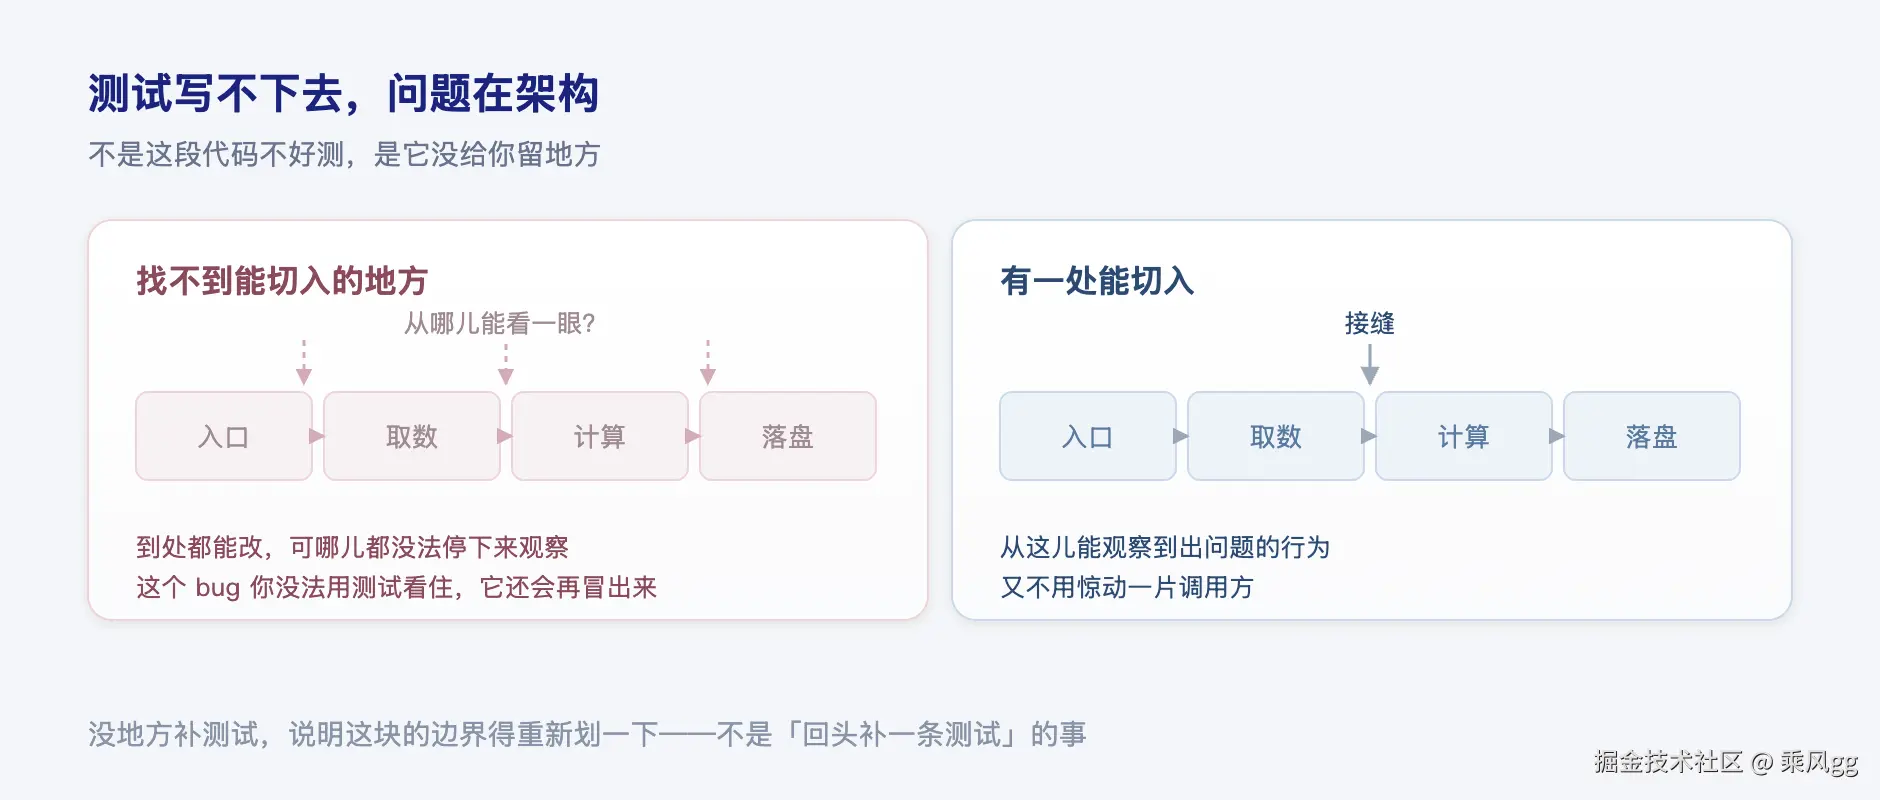
别把它记成一件没做完的事。 它不是在提醒你「回头补一条测试」------没地方补,补了也白补。它是在说:这块的边界得重新划一下。
让 AI 每次只读它需要的
前面说浅模块的症状是「不开五个文件就理解不了一个概念」。反过来,深度模块给了 AI 两样东西:一个入口,和一条从粗到细的路。
这个仓库里管这叫渐进式披露------材料按「读的人有多急需」排成一条梯子:
- 第一级:步骤。 这件事怎么做,直接摆出来
- 第二级:同层的参考。 做的时候可能要用到的细节,放在旁边
- 第三级:外部的参考。 只有少数情况才要的,推到另一个文件里,靠一句指路带过去
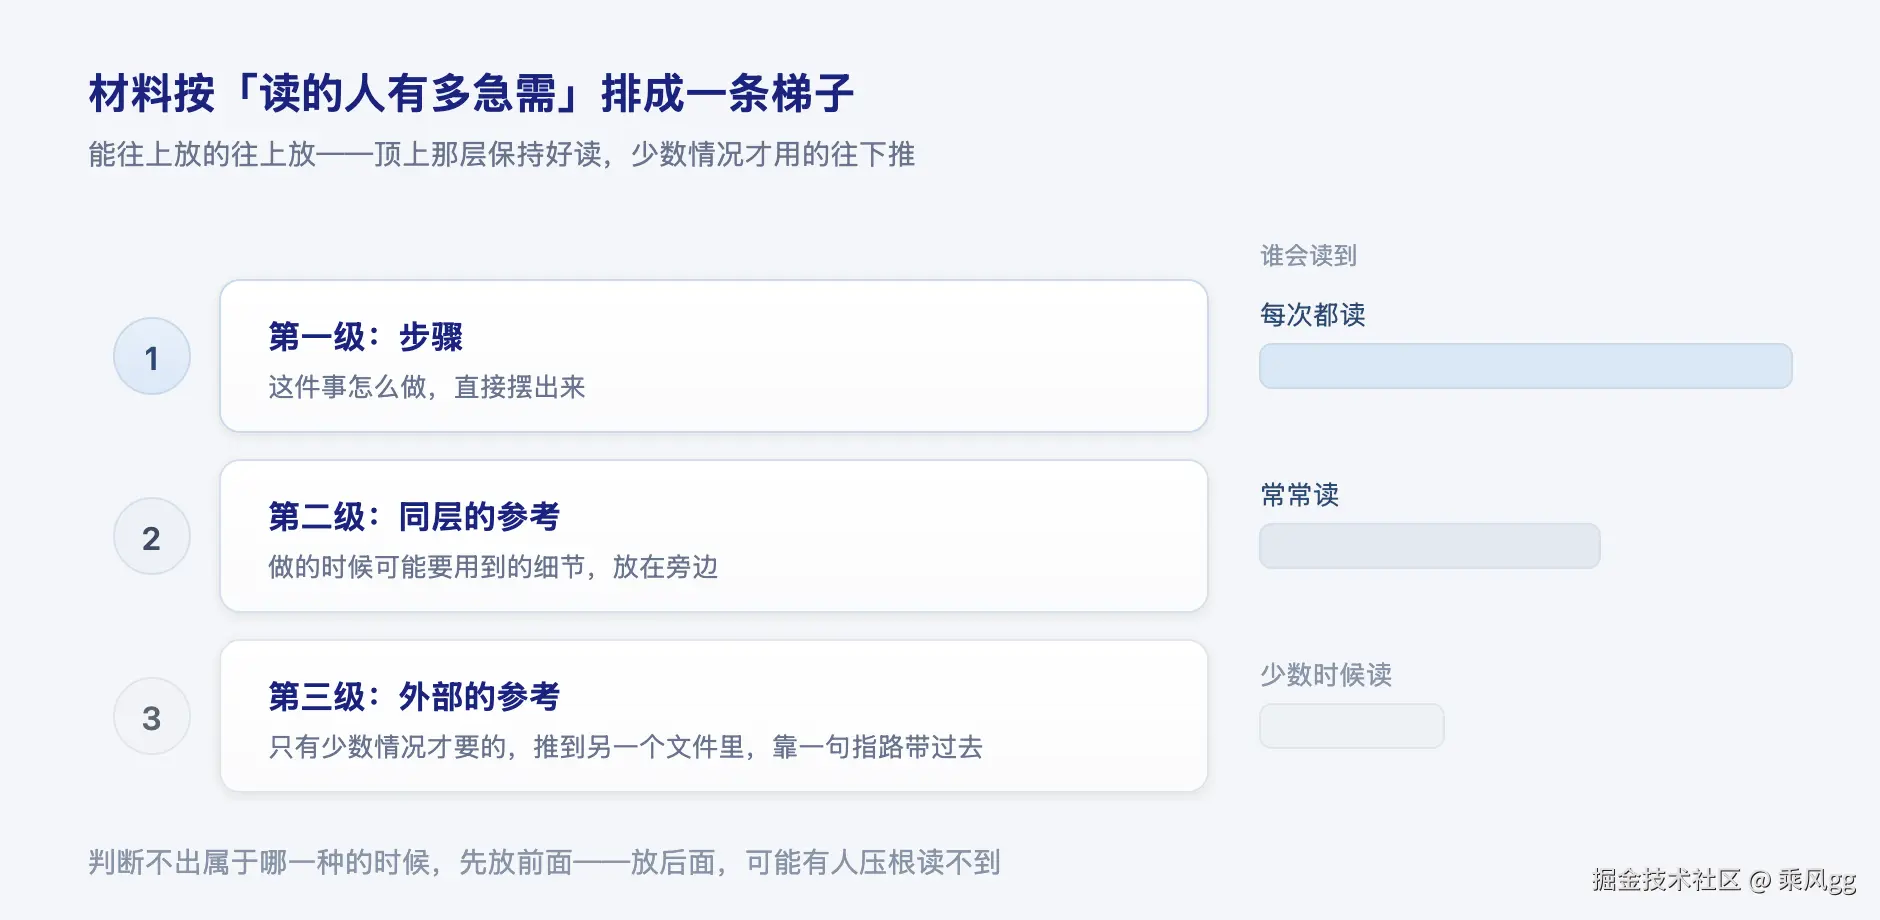
渐进式披露,就是能往上放的往上放,让顶上那层保持好读;只有少数情况才用得到的,才往下推。
代码里是同一条梯子。一个模块对外只露三个函数,那是第一级;想看它怎么实现,点进源代码,第二级;单测挂了才翻出来的那份设计说明,第三级。大部分时候,AI 只要看第一级就够了------真要细节,它自己会往下翻。
这条原则还带一个很实用的判断:不管哪种用法都用得上的,放前面;只有一部分用法才用得上的,推到后面。 判断不出属于哪一种的时候,先放前面------放前面最多是让人多读一段,放后面,可能有人压根读不到。
一个具体的场景:二十个文件,bug 全在边界上
场景角色:一个课程视频管理项目,我跟着看它从原型一路长成正式产品。
核心目标:让 AI 能安全地改这块代码,同时人也能看懂、改得动。
输入:前端状态管理、后端 API、CLI、本地存储,摊在二十来个文件里。每个文件都往外导出一大堆小函数,互相之间靠 import 串起来。
处理流程:
- 想搞懂一个概念------比如「一节课被正式挂到文件系统里」------AI 得先跨好几个文件,把 import 链从头捋到尾,才能拼出这个流程。这就是典型的浅模块 症状:不开五个文件,就理解不了一个概念。
- 而 bug 几乎全出在子系统之间的边界上:一个状态在 A 里改、在 B 里读、在 C 里落盘,三处对不齐,就炸了。
- 这一坨最后被包成了一个深度模块,对外只留一个薄接口,复杂度全沉到后面。
改动前后,业务方要写的东西差这么多:
js
// 改之前:调用的顺序得自己记,漏一步就出 bug
const lesson = await store.load(lessonId);
await fs.materialize(lesson);
await index.update(lesson);

// 改之后:只剩一个入口,其余全沉在模块里
await courseManager.publish(lessonId);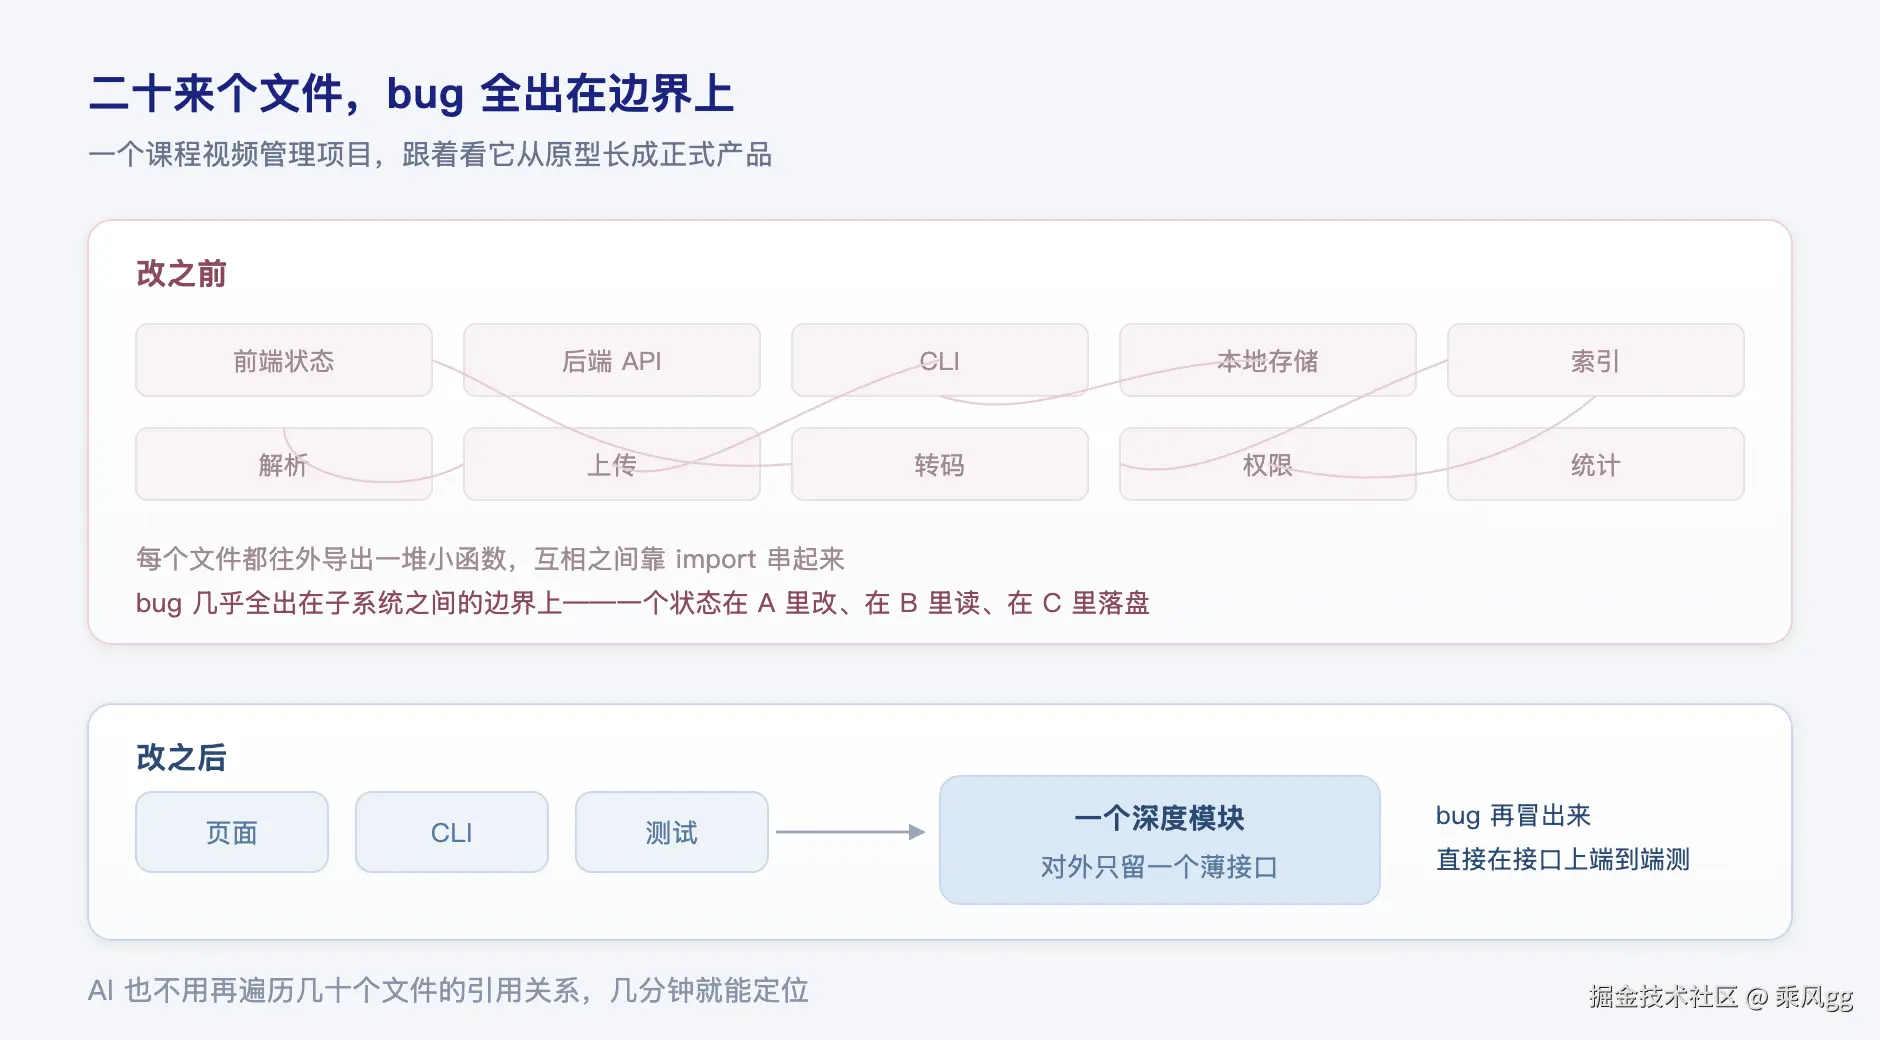
输出与校验:bug 再冒出来,直接在接口上端到端测,几分钟定位。AI 也不用再遍历几十个文件的引用关系了。
总结
回头看,这篇其实只回答了一个问题:为什么一个没有记忆、只会照抄的 AI,反而让你的代码库质量从审美问题变成了硬指标。
以及,那份代码库里到底什么值得藏、什么值得露------深度模块管前半句,渐进式披露管后半句。
但代码库只是起点。真正每天要做的,是决定「这件事怎么切、跟它怎么对齐、怎么知道它做对了」。 下一篇我会细说~
欢迎大家关注我的公众号:深入浅出AI