YOLO 系列(一):目标检测基础与 YOLO V1 原理
前言 :前面我们学了用神经网络进行图像分类,模型输出的是"这张图是什么"。本篇我们将进入一个更有挑战性的任务------目标检测 ,不仅要识别图像中有什么,还要定位它们在哪里。YOLO(You Only Look Once)是目标检测领域最具代表性的算法之一,它以端到端、速度快著称,广泛应用于自动驾驶、安防监控、工业质检等场景。
目录
- 一、目标检测概述
- 二、单阶段 vs 两阶段
- 三、YOLO V1 核心思想
- 四、置信度与 IoU
- 五、精确率与召回率
- 六、mAP 评价指标
- 七、YOLO V1 网络架构
- 八、YOLO V1 损失函数
- 九、NMS 非极大值抑制
- 十、YOLO V1 的优缺点
- 十一、总结
一、目标检测概述
1.1 什么是目标检测?
目标检测(Object Detection) 是计算机视觉的核心任务之一,它要求模型同时完成两件事:
| 任务 | 说明 |
|---|---|
| 分类(Classification) | 识别图像中有什么物体 |
| 定位(Localization) | 确定物体在图像中的位置(画框) |
简单来说:图像分类输出"是什么",目标检测输出"是什么 + 在哪里"。
1.2 目标检测的经典方法
| 方法 | 代表算法 | 特点 |
|---|---|---|
| 单阶段(One-stage) | YOLO 系列、SSD | 一步到位,速度快 |
| 两阶段(Two-stage) | Faster R-CNN、Mask R-CNN | 先生成候选框,再分类,精度高 |
1.3 应用场景
| 场景 | 说明 |
|---|---|
| 自动驾驶 | 检测行人、车辆、交通标志 |
| 安防监控 | 人脸识别、异常行为检测 |
| 工业质检 | 检测产品缺陷 |
| 医疗影像 | 检测病灶位置 |
| 无人零售 | 识别商品、自动结算 |
二、单阶段 vs 两阶段
2.1 单阶段检测器
单阶段检测器直接在特征图上预测目标的位置和类别,无需生成候选框。
代表算法:YOLO 系列、SSD
| 优点 | 缺点 |
|---|---|
| 识别速度非常快,适合做实时检测任务 | 正确率相比较低 |
典型性能对比:
| 模型 | mAP | FPS |
|---|---|---|
| SSD300 | 41.2 | 46 |
| SSD500 | 46.5 | 19 |
| YOLOv2 608×608 | 48.1 | 40 |
| Tiny YOLO | --- | 200 |
2.2 两阶段检测器
两阶段检测器是一种先生成候选框,然后对候选框进行分类和回归的检测方法。
代表算法:R-CNN、Fast R-CNN、Faster R-CNN、Mask R-CNN
工作流程:
| 阶段 | 说明 |
|---|---|
| 第一阶段 | 生成候选框。通常通过类似 Selective Search 或 EdgeBoxes 等区域提名算法,从输入图像中生成候选框。每个候选框都会经过一个 CNN 模型进行特征提取,然后通过分类器进行过滤,保留与目标物体更相似的候选框 |
| 第二阶段 | 在保留的候选框上进行精细的分类和回归。这个阶段通常使用另一个 CNN 模型或类似 SVM 的分类器来进行分类和回归。对于每个候选框,可能需要预测物体的类别、位置和大小等 |
| 优点 | 缺点 |
|---|---|
| 正确率比较高,识别效果理想 | 识别速度比较慢,通常达到 5 FPS |
2.3 两者的对比
| 对比维度 | 单阶段 | 两阶段 |
|---|---|---|
| 速度 | 快 | 慢 |
| 精度 | 相对低 | 高 |
| 代表算法 | YOLO、SSD | Faster R-CNN |
| 适用场景 | 实时检测 | 精度优先 |
三、YOLO V1 核心思想
3.1 什么是 YOLO?
YOLO(You Only Look Once) 由 Joseph Redmon 等人于 2016 年提出,是一种基于深度学习的单阶段目标检测算法。它的核心思想是:把目标检测问题转换为回归问题,通过一个神经网络直接预测目标的类别和位置。
"You Only Look Once" 的意思是:只需看一次图像,就能同时预测所有目标的类别和位置。这得益于它的端到端设计------不像两阶段方法需要先生成候选框再分类。
3.2 网格划分
YOLO V1 将输入图像分成 7×7 的网格(Grid Cell):
图像 → 7×7 网格 → 每个网格负责预测落在其中的目标核心规则:
如果某个物体的中心落在一个网格中,那么这个网格就负责预测这个物体。
3.3 每个网格预测什么?
每个网格预测 2 个边界框(Bounding Box),每个边界框包含 5 个值:
| 值 | 说明 |
|---|---|
| x | 边界框中心的 x 坐标(相对网格归一化) |
| y | 边界框中心的 y 坐标(相对网格归一化) |
| w | 边界框的宽度(相对整图归一化) |
| h | 边界框的高度(相对整图归一化) |
| confidence | 边界框包含目标的置信度 |
此外,每个网格还要预测 20 个类别的概率。
3.4 输出维度
YOLO V1 的最终输出是 7×7×30 的张量:
| 维度 | 值 | 说明 |
|---|---|---|
| 7×7 | 49 | 网格数量 |
| 30 | (2×5 + 20) | 2 个边界框 × 5 个值 + 20 个类别概率 |
公式:
S×S×(B×5+C)=7×7×(2×5+20)=7×7×30 S \times S \times (B \times 5 + C) = 7 \times 7 \times (2 \times 5 + 20) = 7 \times 7 \times 30 S×S×(B×5+C)=7×7×(2×5+20)=7×7×30
其中:
- S = 7:网格大小
- B = 2:每个网格预测的边界框数量
- C = 20:类别数量
四、置信度与 IoU
4.1 置信度(Confidence)
置信度表示某个预测框中存在目标的可能性大小,是一个介于 0 到 1 之间的数值。
例如:一个预测框的目标存在置信度为 0.8,意味着模型有 80% 的把握认为该预测框中包含一个目标。
4.2 IoU(Intersection over Union)
IoU(交并比) 是预测框和真实框面积的交集与并集的比值 (两边界框相交部分面积与相并部分面积之比):
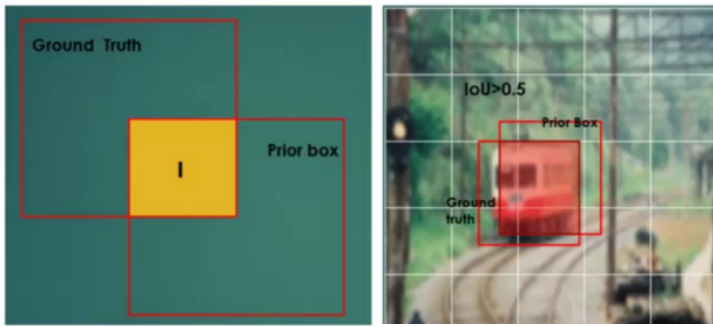
IoU=SGround Truth∩SPrior boxSGround Truth∪SPrior box \text{IoU} = \frac{S_{\text{Ground Truth}} \cap S_{\text{Prior box}}}{S_{\text{Ground Truth}} \cup S_{\text{Prior box}}} IoU=SGround Truth∪SPrior boxSGround Truth∩SPrior box
| 概念 | 说明 |
|---|---|
| Ground Truth | 真实框(人工标注) |
| Prior box | 预测框(模型输出) |
| 交集(∩) | 两个框重叠的部分 |
| 并集(∪) | 两个框合并覆盖的部分 |
判断规则:
一般认为 IoU > 0.5 的 prior box 才是有价值的(即预测正确)。
4.3 通俗理解
- IoU = 1:预测框和真实框完全重合(完美)
- IoU = 0:预测框和真实框完全不重叠(完全错误)
- IoU > 0.5:预测框和真实框重叠超过一半(通常认为预测正确)
五、精确率与召回率
5.1 混淆矩阵
在二分类问题中,样本被分为正例(Positive) 和负例(Negative) 。模型预测后,会出现四种情况,用混淆矩阵(Confusion Matrix) 表示:
| 预测为正 | 预测为负 | |
|---|---|---|
| 实际为正 | TP(真正例) | FN(假负例) |
| 实际为负 | FP(假正例) | TN(真负例) |
| 缩写 | 全称 | 含义 |
|---|---|---|
| TP | True Positive | 实际为正,预测也为正(预测正确) |
| TN | True Negative | 实际为负,预测也为负(预测正确) |
| FP | False Positive | 实际为负,但预测为正(误报) |
| FN | False Negative | 实际为正,但预测为负(漏报) |
通俗理解:
- TP、TN:预测对了
- FP:无中生有(把不是的当成是的)
- FN:视而不见(把是的当成不是的)
5.2 精确率(Precision)
精确率 表示预测的结果中有多少是正确的:
Precision=TPTP+FP \text{Precision} = \frac{TP}{TP + FP} Precision=TP+FPTP
直观理解:模型预测为正的样本中,真正为正的比例。精确率越高,说明模型的"误报"越少。
5.3 召回率(Recall)
召回率 表示真实的结果中有多少被预测正确了:
Recall=TPTP+FN \text{Recall} = \frac{TP}{TP + FN} Recall=TP+FNTP
直观理解:实际为正的样本中,被模型成功找出来的比例。召回率越高,说明模型的"漏报"越少。
5.4 检测任务中的计算
在目标检测中,精确率和召回率的计算方式类似,但需要先设定阈值:
| 步骤 | 说明 |
|---|---|
| 1. 限制阈值 | 例如置信度阈值设为 0.9,超过 0.9 表示检测正确 1,否则检测失败 0 |
| 2. 统计 TP、FP、FN | 根据阈值判断每个预测框是否正确 |
| 3. 计算精确率和召回率 | 代入公式计算 |
举例:图片中有 3 个人,模型只检测到 1 个(置信度 0.95),另外 2 个漏检。
用混淆矩阵表示:
| 预测为人 | 预测为非人 | |
|---|---|---|
| 实际为人(3 个) | TP = 1 | FN = 2 |
| 实际为非人 | FP = 0 | TN = --- |
| 指标 | 值 |
|---|---|
| TP | 1 |
| FP | 0 |
| FN | 2 |
| Precision | 1/1 = 1 |
| Recall | 1/3 |
FN 的含义:图片中有人,但是没有预测到。
六、mAP 评价指标
6.1 AP(Average Precision)
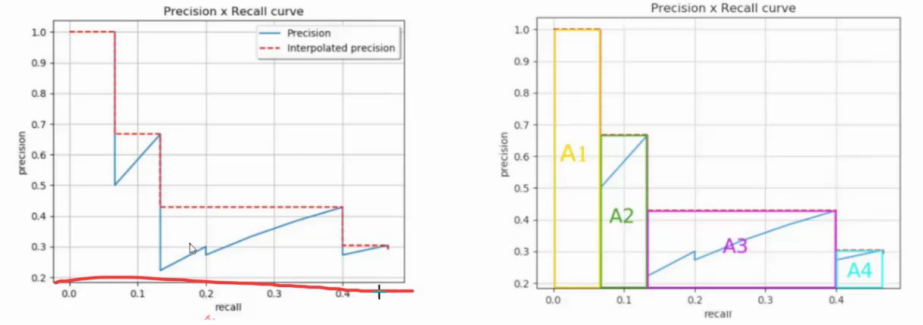
AP 是 Precision-Recall 曲线下的面积。具体做法:
| 步骤 | 说明 |
|---|---|
| 1. 改变阈值 | 使用不同的置信度阈值,得到不同的精确率和召回率 |
| 2. 绘制曲线 | 以召回率为横轴、精确率为纵轴,绘制 P-R 曲线 |
| 3. 计算面积 | 曲线下方的面积即为 AP 值 |
AP 越大,表示模型性能越好。
6.2 mAP(mean Average Precision)
mAP 是所有类别 AP 的平均值。例如检测 20 个类别,每个类别都有一个 AP,取平均就是 mAP。
6.3 mAP50 与 mAP50-95
| 指标 | 说明 |
|---|---|
| mAP50 | 当 IoU 阈值为 0.5 时模型的平均精度。即只考虑预测框与真实框的重叠部分达到 50% 及以上的情况,计算所有类别的 AP 的平均值 |
| mAP50-95 | 衡量的是模型在 IoU 阈值从 0.5 到 0.95 范围内的平均精度。计算的是所有类别的 AP 的平均值,其中 AP 是在 IoU 阈值从 0.5 到 0.95 的每个 0.05 步长上计算的 |
| 对比 | mAP50 | mAP50-95 |
|---|---|---|
| IoU 范围 | 仅 0.5 | 0.5 ~ 0.95 |
| 严格程度 | 宽松 | 更严格 |
| 数值 | 较高 | 通常较低 |
| 评估全面性 | 单一阈值 | 多阈值综合 |
简单理解:mAP50 只看"框得大概准不准",mAP50-95 看"框得精细不精细"。mAP50-95 能够评估模型在不同重叠程度下的性能,提供了更全面的模型性能评估,是一个更严格的评估指标。
七、YOLO V1 网络架构
7.1 网络结构
YOLO V1 的网络结构借鉴了 GoogLeNet:
| 层级 | 说明 |
|---|---|
| 24 个卷积层 | 提取图像特征 |
| 2 个全连接层 | 输出预测结果 |
| 1×1 卷积 | 用于降维(减少计算量) |
| 3×3 卷积 | 替代 GoogLeNet 的 Inception 模块 |
7.2 输入输出
| 项目 | 值 |
|---|---|
| 输入 | 448 × 448 × 3 的彩色图像 |
| 输出 | 7 × 7 × 30 的张量 |
7.3 输出张量的含义
每个 grid(网格)的 30 维向量:
| 维度 | 含义 |
|---|---|
| 第 1~5 维 | 第 1 个边界框的 (x, y, w, h, confidence) |
| 第 6~10 维 | 第 2 个边界框的 (x, y, w, h, confidence) |
| 第 11~30 维 | 20 个类别的概率 |
7.4 坐标归一化
| 坐标 | 归一化方式 |
|---|---|
| x, y | 相对于网格单元格边界的归一化(0~1) |
| w, h | 相对于整张图像宽高的归一化(0~1) |
八、YOLO V1 损失函数
8.1 损失函数的三部分
YOLO V1 的损失函数包括三部分:
| 部分 | 说明 |
|---|---|
| 位置误差 | 边界框坐标 (x, y, w, h) 的误差 |
| 置信度误差 | 边界框 confidence 的误差 |
| 分类误差 | 类别概率的误差 |
损失函数的设计目标是让坐标、置信度、分类这三个方面达到很好的平衡。
8.2 符号说明
在看损失函数公式之前,先解释几个关键符号:
| 符号 | 含义 |
|---|---|
| S² | 网格总数(S=7,所以 S²=49) |
| B | 每个网格预测的边界框数量(B=2) |
| 1ijobj\mathbb{1}_{ij}^{\text{obj}}1ijobj | 指示函数 :第 i 个网格的第 j 个边界框负责预测某个目标时为 1,否则为 0 |
| 1ijnoobj\mathbb{1}_{ij}^{\text{noobj}}1ijnoobj | 指示函数 :第 i 个网格的第 j 个边界框不负责预测目标时为 1,否则为 0 |
| 1iobj\mathbb{1}_{i}^{\text{obj}}1iobj | 指示函数 :第 i 个网格包含目标中心时为 1,否则为 0 |
| λcoord\lambda_{\text{coord}}λcoord | 位置误差的权重(通常取 5,加大位置误差的影响) |
| λnoobj\lambda_{\text{noobj}}λnoobj | 无目标时置信度误差的权重(通常取 0.5,减小无目标框的影响) |
| xi,yi,wi,hix_i, y_i, w_i, h_ixi,yi,wi,hi | 第 i 个网格预测的边界框坐标(预测值) |
| x^i,y^i,w^i,h^i\hat{x}_i, \hat{y}_i, \hat{w}_i, \hat{h}_ix^i,y^i,w^i,h^i | 真实框的坐标(真实值,带 ^ 表示 ground truth) |
| CiC_iCi | 预测的置信度 |
| C^i\hat{C}_iC^i | 真实的置信度 |
| pi(c)p_i(c)pi(c) | 第 i 个网格预测为类别 c 的概率 |
| p^i(c)\hat{p}_i(c)p^i(c) | 第 i 个网格真实为类别 c 的概率 |
通俗理解指示函数:指示函数就像一个"开关",条件成立就输出 1,条件不成立就输出 0。它用来控制某项误差是否参与计算。
8.3 损失函数公式
第一项:中心坐标误差
λcoord∑i=0S2∑j=0B1ijobj(xi−x\^i)2+(yi−y\^i)2 \lambda_{\text{coord}} \sum_{i=0}^{S^2} \sum_{j=0}^{B} \mathbb{1}_{ij}^{\text{obj}} \left (x_i - \\hat{x}_i)\^2 + (y_i - \\hat{y}_i)\^2 \\right λcoordi=0∑S2j=0∑B1ijobj(xi−x\^i)2+(yi−y\^i)2
| 部分 | 说明 |
|---|---|
| λcoord\lambda_{\text{coord}}λcoord | 权重系数(默认 5),放大位置误差的贡献 |
| 1ijobj\mathbb{1}_{ij}^{\text{obj}}1ijobj | 只在"该框负责预测目标"时才计算误差 |
| (xi−x^i)2+(yi−y^i)2(x_i - \hat{x}_i)^2 + (y_i - \hat{y}_i)^2(xi−x^i)2+(yi−y^i)2 | 中心坐标的平方误差 |
第二项:宽高误差
λcoord∑i=0S2∑j=0B1ijobj(wi−w\^i)2+(hi−h\^i)2 \lambda_{\text{coord}} \sum_{i=0}^{S^2} \sum_{j=0}^{B} \mathbb{1}_{ij}^{\text{obj}} \left (\\sqrt{w_i} - \\sqrt{\\hat{w}_i})\^2 + (\\sqrt{h_i} - \\sqrt{\\hat{h}_i})\^2 \\right λcoordi=0∑S2j=0∑B1ijobj(wi −w\^i )2+(hi −h\^i )2
| 部分 | 说明 |
|---|---|
| wi,hi\sqrt{w_i}, \sqrt{h_i}wi ,hi | 对宽高开根号,让大小框的误差更均衡 |
| 其余部分 | 与第一项类似 |
第三项:有目标时的置信度误差
∑i=0S2∑j=0B1ijobj(Ci−C^i)2 \sum_{i=0}^{S^2} \sum_{j=0}^{B} \mathbb{1}_{ij}^{\text{obj}} (C_i - \hat{C}_i)^2 i=0∑S2j=0∑B1ijobj(Ci−C^i)2
| 部分 | 说明 |
|---|---|
| CiC_iCi | 预测的置信度 |
| C^i\hat{C}_iC^i | 真实置信度(有目标时通常为 1) |
第四项:无目标时的置信度误差
λnoobj∑i=0S2∑j=0B1ijnoobj(Ci−C^i)2 \lambda_{\text{noobj}} \sum_{i=0}^{S^2} \sum_{j=0}^{B} \mathbb{1}_{ij}^{\text{noobj}} (C_i - \hat{C}_i)^2 λnoobji=0∑S2j=0∑B1ijnoobj(Ci−C^i)2
| 部分 | 说明 |
|---|---|
| λnoobj\lambda_{\text{noobj}}λnoobj | 权重系数(默认 0.5),减小无目标框的影响 |
| 1ijnoobj\mathbb{1}_{ij}^{\text{noobj}}1ijnoobj | 只在"该框不负责预测目标"时才计算误差 |
| C^i\hat{C}_iC^i | 无目标时通常为 0 |
为什么要降低无目标框的权重? 因为一张图里绝大多数网格都不含目标,如果它们的误差都按同样权重计算,会盖过真正有目标框的误差。所以 YOLO 用 λ_noobj 来降低这些背景框的影响。
第五项:分类误差
∑i=0S21iobj∑c∈classes(pi(c)−p^i(c))2 \sum_{i=0}^{S^2} \mathbb{1}{i}^{\text{obj}} \sum{c \in \text{classes}} (p_i(c) - \hat{p}_i(c))^2 i=0∑S21iobjc∈classes∑(pi(c)−p^i(c))2
| 部分 | 说明 |
|---|---|
| 1iobj\mathbb{1}_{i}^{\text{obj}}1iobj | 只在"该网格包含目标中心"时才计算 |
| pi(c)p_i(c)pi(c) | 预测为类别 c 的概率 |
| p^i(c)\hat{p}_i(c)p^i(c) | 真实类别(one-hot 形式,正确类别为 1,其他为 0) |
8.4 各项汇总
| 项 | 名称 | 作用 |
|---|---|---|
| 第 1 项 | 中心坐标误差 | 让预测框的中心接近真实框中心 |
| 第 2 项 | 宽高误差 | 让预测框的大小接近真实框大小(开根号平衡大小框) |
| 第 3 项 | 有目标置信度误差 | 让模型对"确实有目标"的框给出高置信度 |
| 第 4 项 | 无目标置信度误差 | 让模型对"没有目标"的框给出低置信度 |
| 第 5 项 | 分类误差 | 让模型正确预测目标的类别 |
8.5 为什么要开根号?
对宽高开根号是因为:
| 情况 | 影响 |
|---|---|
| 不开根号 | 大框的小误差 vs 小框的大误差,数值差异大 |
| 开根号 | 数值被压缩,大框和小框的误差更加平衡 |
直观理解:小框对大误差更敏感,开根号可以让大小框的误差对损失函数的贡献更均衡。
九、NMS 非极大值抑制
9.1 为什么需要 NMS?
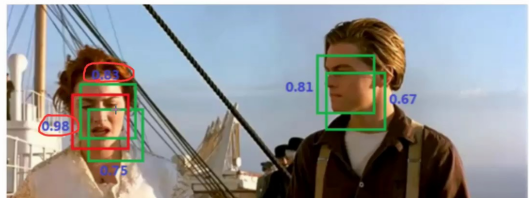
目标检测模型可能会在同一个目标上产生多个重叠的预测框 。比如一张人脸可能被检测出 3~4 个框,但我们只需要保留最好的那一个。
NMS(Non-Maximum Suppression,非极大值抑制) 就是用来解决这个问题的。
9.2 NMS 的步骤
| 步骤 | 说明 |
|---|---|
| 1. 排序 | 按置信度从高到低对所有预测框排序 |
| 2. 选最高 | 选择置信度最高的框,保留 |
| 3. 计算 IoU | 计算其余框与保留框的 IoU |
| 4. 抑制 | IoU 大于阈值的框被抑制(删除) |
| 5. 重复 | 从剩余的框中选择置信度最高的,重复步骤 3-4 |
9.3 举例说明
假设模型在同一张人脸上输出了 4 个框,置信度分别是:
| 框 | 置信度 | 处理 |
|---|---|---|
| A | 0.98 | 保留(最高) |
| B | 0.95 | 与 A 的 IoU 高,抑制 |
| C | 0.81 | 与 A 的 IoU 低,保留 |
| D | 0.67 | 与 A 的 IoU 高,抑制 |
最终只保留 A 和 C。
十、YOLO V1 的优缺点
10.1 优点
| 优点 | 说明 |
|---|---|
| 速度快 | 单阶段检测,端到端训练,一次前向传播即可完成检测 |
| 结构简单 | 一个 CNN 就能解决,可以对视频进行实时检测,应用领域非常广 |
10.2 缺点
| 问题 | 说明 |
|---|---|
| 问题 1:每个 cell 只预测 1 个类别 | 如果重叠无法解决 |
| 问题 2:小物体检测效果一般 | 长宽比可选,但单一 |
十一、总结
核心知识点速查
| 知识点 | 关键概念 |
|---|---|
| 目标检测 | 同时完成分类和定位 |
| 单阶段 vs 两阶段 | 单阶段快,两阶段准 |
| YOLO V1 核心思想 | 把检测问题转换为回归问题 |
| 网格划分 | 7×7 网格,每个网格负责预测中心落在其中的目标 |
| 输出维度 | 7×7×30 |
| 置信度 | 框内存在目标的可能性 |
| IoU | 预测框与真实框的交并比 |
| 精确率 | 预测的结果中有多少是正确的 |
| 召回率 | 真实的结果中有多少被预测正确 |
| mAP | 所有类别 AP 的平均值 |
| NMS | 非极大值抑制,去重保留最佳框 |
| 损失函数 | 位置误差 + 置信度误差 + 分类误差 |
核心公式速查
| 公式 | 用途 |
|---|---|
| Precision=TPTP+FP\text{Precision} = \frac{TP}{TP + FP}Precision=TP+FPTP | 精确率 |
| Recall=TPTP+FN\text{Recall} = \frac{TP}{TP + FN}Recall=TP+FNTP | 召回率 |
| IoU=交集并集\text{IoU} = \frac{\text{交集}}{\text{并集}}IoU=并集交集 | 交并比 |
| S×S×(B×5+C)S \times S \times (B \times 5 + C)S×S×(B×5+C) | YOLO 输出维度计算 |
注意事项
| 要点 | 说明 |
|---|---|
| 网格归属 | 物体中心落在哪个网格,哪个网格负责预测 |
| IoU 阈值 | 通常设为 0.5,超过则视为检测正确 |
| 置信度阈值 | 影响精确率和召回率,需要权衡 |
| NMS 阈值 | 控制抑制程度,值越大保留的框越多 |
| YOLO V1 局限 | 小目标和重叠目标检测效果一般 |