1.Remote_Photoplethysmography_in_Real-World_and_Extreme_Lighting_Scenarios 室外与极端光照场景下的远程光电容积描记(rPPG)
1.1 技术路线
面向真实室外与极端光照场景,构建仅依赖 RGB 可见光的端到端视频 Transformer 框架。输入自然视频后,按人脸关键点将皮肤划分为多个非重叠区域,据此构建时空图(STMap),同时构造背景时空图与全局时空图;随后由 U 形 Swin 视频 Transformer 编码,提取粗粒度与细粒度特征,以背景扰动为参考进行自监督解耦以去除外部干扰,最终经时空重建与细粒度回归输出 BVP 信号与心率。
1.2 创新点
一是首个仅利用 RGB 可见光即可在户外变光照条件下学习 rPPG 的方法,摆脱了对红外等辅助设备与高昂成本的依赖;二是提出"全局干扰共享+背景扰动参考+自监督解耦+频域与生理先验约束"的策略组合,能稳健对抗未知复杂干扰;三是模型整体轻量,相比现有噪声解耦方法更易在终端灵活部署;四是全部学习支撑基于面部光学反射模型与特征映射相关性计算,不引入额外成像模态和过多分支模块。
1.3 如何实现
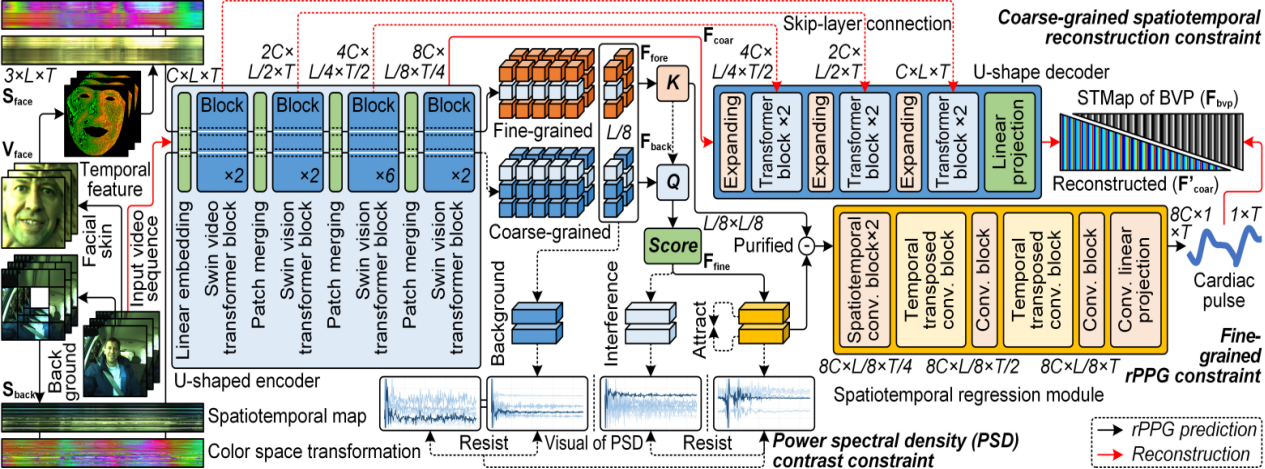
U 形 Swin Video Transformer 主干,双分支解耦:粗粒度时空重建分支 + 细粒度 rPPG 回归分支;同时用 PSD 功率谱对比约束做辅助训练
双任务目的:优化编码器
分支 1(重建):特征经过 U 解码器 → 重建 BVP 时空图 → 计算重建 Loss → 反向更新编码器权重
任务 1 是重建「时空图张量」,然后拿重建出来的张量,去计算一个额外的损失项(重建损失 Loss_rec)。
分支 2(回归):纯化特征送入时空回归模块 → 预测一维脉搏波形 → rPPG Loss → 更新编码器 + 回归头权重
先将 RGB 视频变换到 YUV 颜色空间,按 68 个关键点划分皮肤子块并求各区域平均像素,形成面部时空图;基于"心率 40--240 bpm"的生理先验,用滑动窗口增强(BioSE)放大细微色差与尖峰特征,并与原始时空图拼接为 6 通道输入;背景时空图作为参考,通过 Softmax 注意力构造细粒度张量,并结合潜对比学习损失拉远、推近人脸与背景中相关子块以完成解耦;以时空重建损失(用真值堆叠重建 STMap)实现由粗到细的感知,细粒度回归采用时域反卷积网络并以皮尔逊相关作为损失;频率约束聚焦 0.66--4 Hz,总损失为 0.5 倍重建损失加 0.5 倍对比损失加回归损失,并将 Swin 的窗口移动改为空间移动以保持皮肤时序连续性。
2.rPPG-VQA A Video Quality Assessment Framework for Unsupervised rPPG(rPPG-VQA:面向无监督 rPPG 训练的视频质量评估框架)
2.1 技术路线
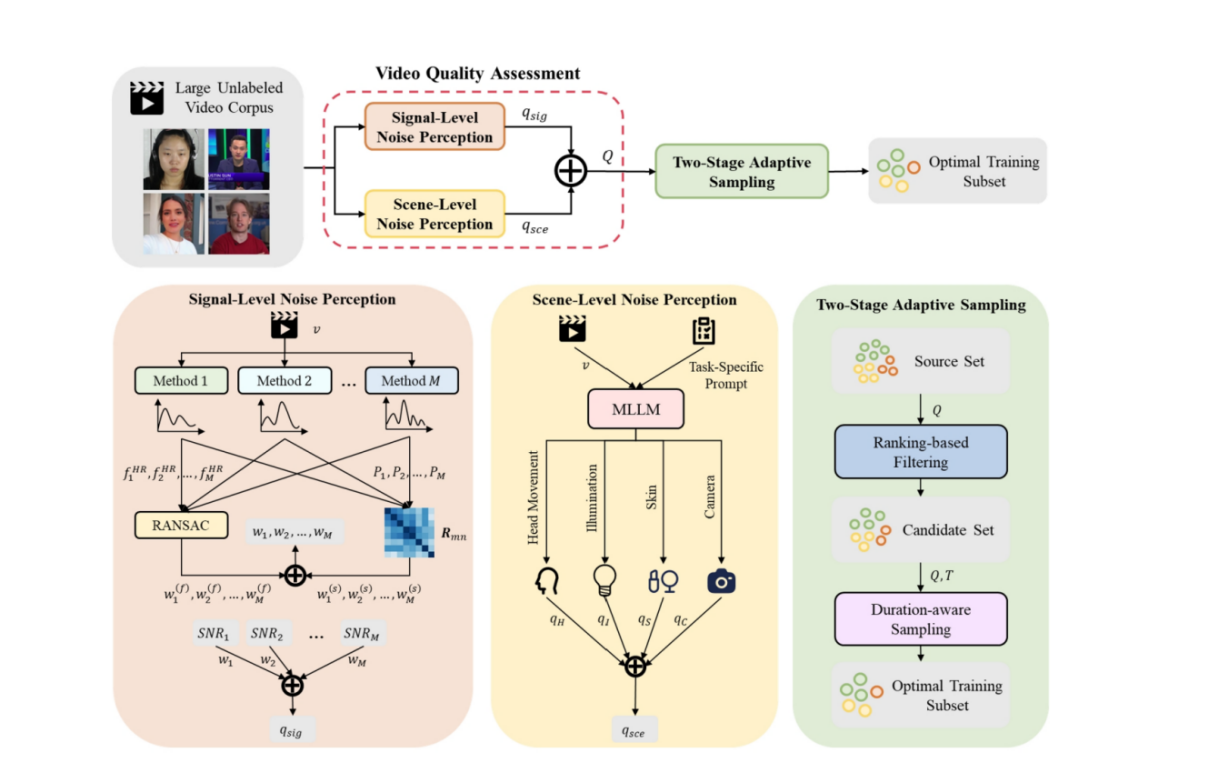
面向无监督 rPPG 训练,构建双分支视频质量评估框架。信号级分支以多种 rPPG 算法的一致性融合信噪比(SNR),评估视频中生理信号的完整性;场景级分支利用多模态大语言模型(MLLM)识别头部运动、光照、皮肤与相机等场景干扰;两支分数融合为统一质量分,再由两阶段自适应采样(TAS)从大规模无标注语料中筛选最优训练数据集。
融合意义:信号级分支能识破:看着稳定但没有生理信号的假视频(如 AI 生成人脸);场景级分支能识破:有周期闪光导致 SNR 虚高的伪信号。二者结合才构成完整判断
2.2 创新点
一是首次系统研究无监督 rPPG 的视频质量评估问题,将关注点从"人眼感知质量"转向"生理信号完整性";二是提出信号级与场景级双分支联合评估,弥补单一 SNR 指标易被闪光等非生理干扰欺骗的缺陷;三是提出两阶段自适应采样策略,以质量分为依据从无标注视频中构造高质量且多样的训练集;四是验证了经筛选的大规模 in-the-wild 数据能显著提升无监督 rPPG 模型的精度。
2.3 如何实现
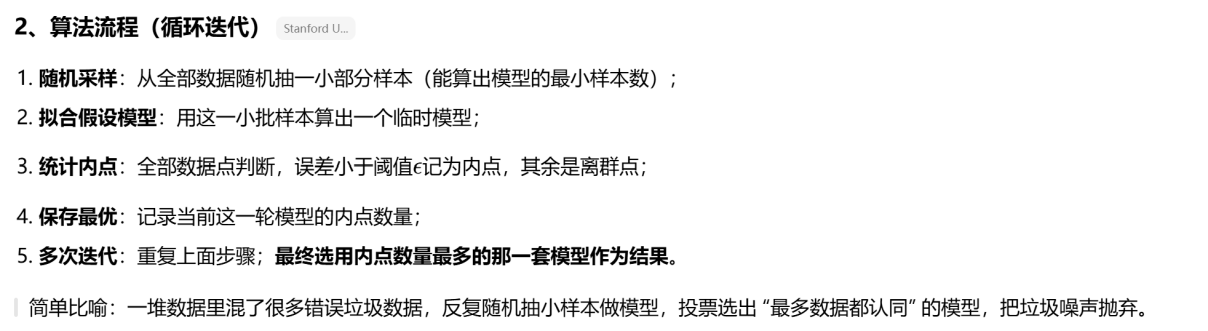
信号级分支融合 GREEN、ICA、CHROM、LGI、PBV、POS、OMIT 七种传统方法,分别提取 rPPG 信号并计算 SNR;用 RANSAC 求得共识心率频率,以频率一致性权重与谱相关权重对各方法加权,得到信号级分数;场景级分支用 Qwen3-VL 按头部运动(0--3)、光照(0--3)、皮肤(0--2)、相机(0--2,乘以帧率补偿因子)四个维度打分并求和;两分支分数经 IQR(四分法) 去异常与 min-max 归一化后,按 α=0.8 加权得到统一质量分;采样阶段先按质量分排序取前 η 倍候选集,再以同时计入质量与时长(log 调整因子)的 softmax 概率采样,结合随机取整构造目标训练集(140 段视频)。
补充:RANSAC:
3. Ying_FusionPhys_A_Flexible_Framework_for_Fusing_Complementary_Sensing_Modalities_in_ICCV_2025_paper FusionPhys:互补传感模态融合的远程生理测量框架
3.1 技术路线
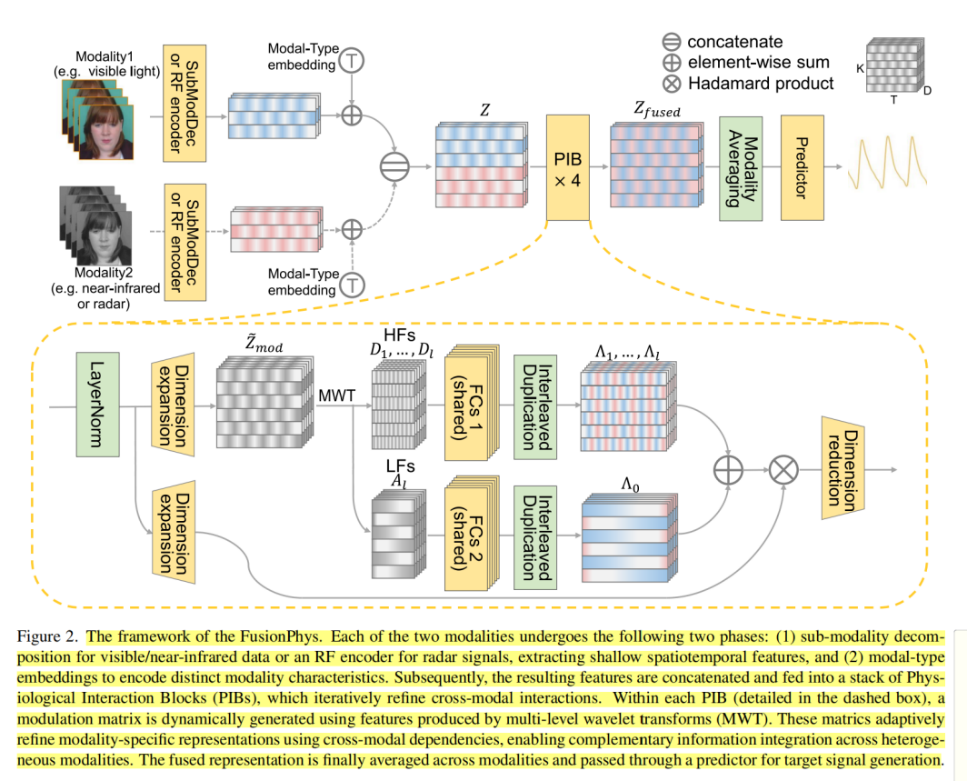
将可见光、近红外、雷达等不同物理原理的传感模态统一建模为随时间变化的生理信号,通过自适应整合机制精化各模态的互补信息。各模态先做特征预提取并对齐到统一形状、加入可学习的模态类型嵌入,随后拼接并输入堆叠的生理交互块(PIB)进行跨模态交互,最后对模态维度取平均并经预测器输出 BVP 信号;对单模态视频则通过子模态分解扩展同一融合思想。
3.2 创新点
一是提出统一建模框架,将可见光/近红外/雷达的融合形式化为自适应整合机制(受 McGurk 效应启发,模态可经调制因子相互精化);二是提出子模态分解技术,将融合原理扩展到单模态视频,统一了多模态与单模态两种场景,无需针对不同模态改动架构;三是设计生理交互块,基于多层小波变换动态生成调制矩阵,实现对异构模态特征的自适应精化与互补信息整合。
3.3 如何实现
可见光/近红外输入经子模态分解(步长为 (1,2,2) 的卷积组与空间展平)得到多子模态浅层特征;雷达信号经一维卷积编码器并降采样到统一时序;各模态特征加入可学习模态类型嵌入后按维拼接,得到 Z∈R^(D×T×K);Z 经过 4 个生理交互块得到融合特征:块内先做维度扩展,再用多层 Haar 小波提取各尺度的近似与细节系数,经共享全连接层与交错复制得到调制矩阵,与基础特征做哈达玛积后恢复维度;最后对模态维度平均、经逐点卷积预测器输出 BVP,采用负皮尔逊损失训练,并在 UBFC-rPPG、PURE、MMSE-HR、EquiPleth、OBF 五个数据集上验证了融合与单模态场景的性能。
补充:多级小波变换同时拿到时间 + 频率局部信息 ,用一个叫小波基函数的小波形(小波),在信号上滑动、缩放,和原信号做内积,提取局部时频特征。