流式处理对于使基于LLM的应用程序能够响应最终用户至关重要。其通过逐步显示输出,甚至在完整的响应准备就绪之前,流式传输可以显着改善用户体验。
我们之前直接使用invoke的调用方式属于非流式传输,看到的现象是聊天模型直接返回全量内容,若模型思考时间较长,则我们等待的时间就越长。
简单的说:
- 非流式:等厨师把整桌子菜全部做完,一次性端上来。
- 流式:厨师做好一盘菜,就一盘一盘陆续端给你。
流式不是传输更快,模型总耗时基本一样 。只是用户更早看到部分内容,减少等待焦虑。
那么对于LangChain的聊天模型来说,它同样支持流式返回。
4.1 stream()流式同步传输
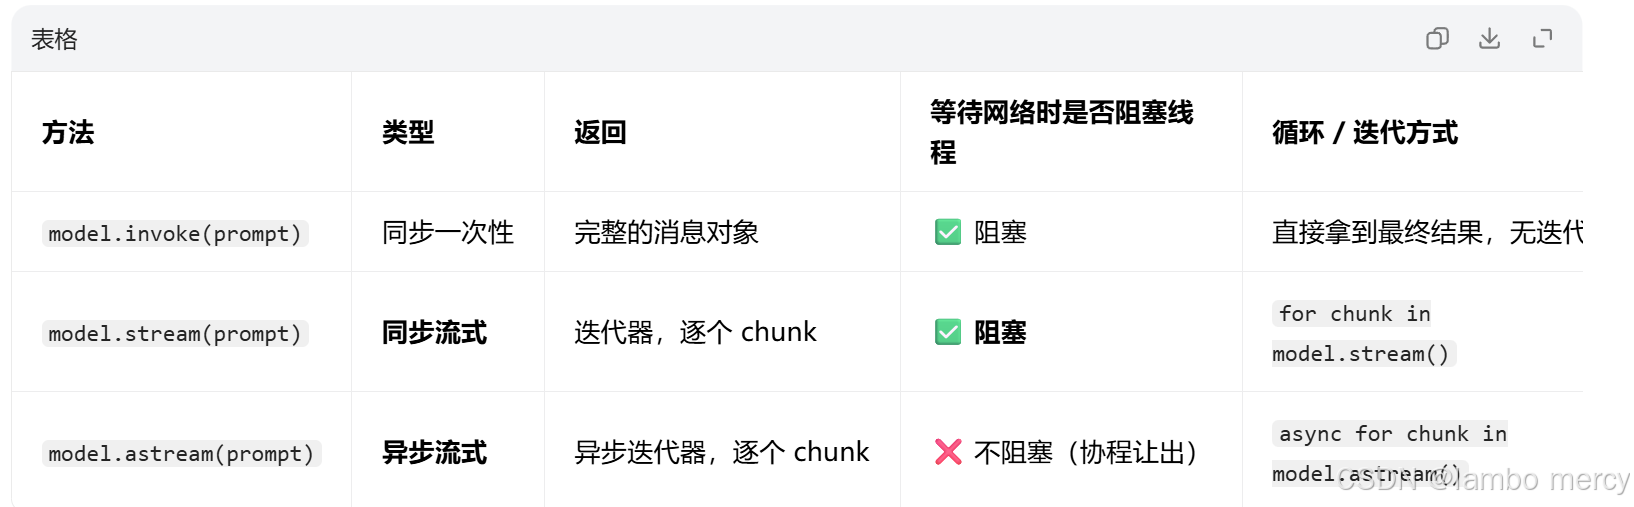
在LangChain聊天模型中,可以使用其.stream()方法,来同步生成流式响应的效果。聊天模型的.stream()方法返回一个迭代器 ,该迭代器在生成输出时,同步产生输出消息块。可以使用for 循环实时处理每个块。
# 流式输出
chunks = []
for chunk in model.stream("讲⼀个50字的笑话"):
    chunks.append(chunk)
    print(chunk.content, end="|", flush=True)

#输出
|有|⼀天|,|兔|⼦|和|乌|⻳|⽐赛|跑|步|。|兔|⼦|跑|得|⻜|快|,|没|想到|中|途|睡|着|了|。|等|它|醒|来|,|发现|乌|⻳|快|到|终|点|了|,|兔|⼦|急|了|:"|怎么|可能|!"|乌|⻳|笑|着|说|:"|慢|就是|快|,我|在|享|受|⻛|景|!"||
通过调试,让我们来看下 chunk 是什么
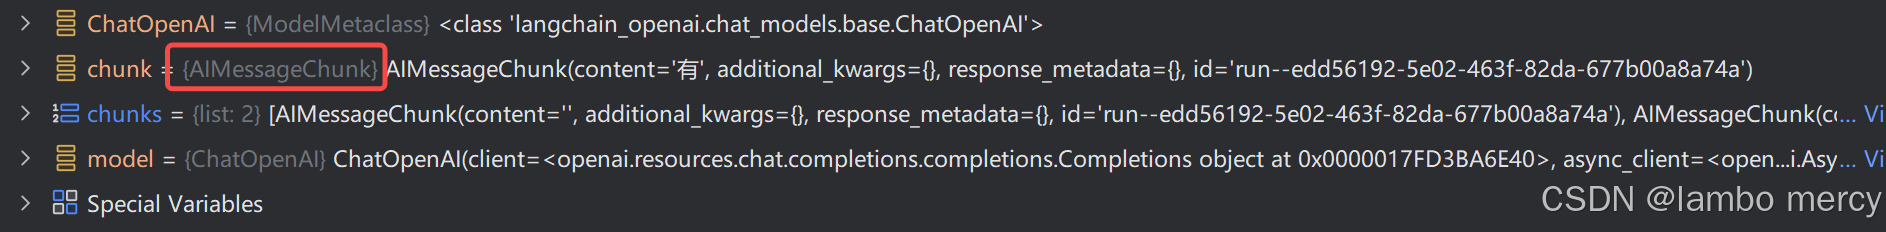
我们得到了一个叫做 AIMessageChunk的东西,它也是AIMessage的一部分,也就是消息块(message chunk)。
chunk 消息块还可以直接相加:
print("\n")
print (chunks[0] + chunks[1] + chunks[2] + chunks[3] + chunks[4])

#content='有⼀天,兔' additional_kwargs={} response_metadata={} id='run--e619cbc3-9ee9-4ae7-a73e-32edb166d401'
4.2 astream()流式异步传输
4.2.1 什么是异步、协程
异步 = 不用等一件事做完,就可以先去做别的事;等那件事完成后,再来处理结果。
协程,也叫用户态轻量级线程。
核心特点
- 协程在同一个线程内运行;
- 可以主动让出控制权(yield /await):遇到耗时 IO 的时候,主动暂停当前协程,把执行权交出去;
- I/O 完成之后,再从暂停的地方恢复继续执行;
- 创建、切换开销极小,远小于操作系统线程。
对比:
- 线程切换:要内核保存上下文,开销大;
- 协程切换:在用户态完成,不陷入内核,开销很低。
协程的切换则由程序员决定在何时暂停或恢复协程。
协程是一个特殊的函数,它可以在执行过程中暂停,并在稍后恢复执行。
它用async def 定义,并在需要暂停的地方使用await。
定义协程
import asyncio

# 煮⽔协程1
async def boil_water_async():
    print("开始煮⽔...")
    await asyncio.sleep(5) # 关键! await 表⽰"等待这个操作完成,但期间让事件循环去
做别的事"
    print("⽔开了!")

# 短信协程2
async def send_message_async():
    print("开始发短信...")
    await asyncio.sleep(2) # 同样,等待2秒,但让出控制权
    print("短信发送成功!")
什么是事件循环?
一个在单线程内调度和管理所有协程的核心机制,就是事件循环。它不停地检查哪些协程可以执行,哪些在等待。本质就是一个 while 死循环(伪代码)
事件循环是asyncio(用于编写异步I/O操作的代码)的核心,你可以把它想象成一个总调度员。
它的工作流程非常简单:
1.它维护着一个任务列表(比如:煮水、发短信)。
2.它不断地循环检查每个任务:
a.如果任务处于"等待I/O"状态(比如等水开、等网络响应),就暂停它,立即去执行下一个
已经"就绪"的任务。
b.如果任务的等待时间到了或者I/O操作完成了,事件循环就恢复执行这个任务。
# 主程序(也是⼀个协程)
async def main():
    # 把两个协程包装成Task,提交给事件循环,**立刻并发调度**
    task1 = asyncio.create_task(boil_water_async())
    task2 = asyncio.create_task(send_message_async())

    # 等待任务都完成
    await task1
    await task2

# 它负责创建事件循环,并将第⼀个协程(主程序)放⼊其中运⾏。
asyncio.run(main())

# 执行boil_water_async → 打印开始烧水 → 遇到await asyncio.sleep(2) → 协程挂起,交出执行权,事件循环去找别的就绪任务
# 切换到send_message_async → 打印开始发消息 → await asyncio.sleep(1),挂起
# 1 秒后:sleep (1) 就绪,恢复 task2 → 打印✅ 消息发送完成,task2 结束
# 再过 1 秒(总共 2s):sleep (2) 就绪,恢复 task1 → 打印✅ 水烧好了,task1 结束
# await task1等待完成;await task2此时 task2 已经跑完,直接返回
asyncio.create_task(协程)
作用:将协程包装成 Task 对象,注册到事件循环,事件循环会自动去调度执行
⚠️ 重点:创建 Task 那一刻,协程就已经被安排跑起来了,不是等到await task才执行!
两个 task 创建完,两个协程几乎同时启动,实现并发。
await task1 / await task2
await暂停当前协程,等待可等待对象完成,让出执行权,也就是阻塞 main 协程,直到这个 task 执行完毕- 哪怕 task2 早就跑完了,
await task2也不会报错,只是直接拿到结果
asyncio.run(main())
asyncio 入口函数,创建事件循环 ,运行传入的协程对象(main()),等它全部跑完,最后关闭事件循环,清理资源。
总结一下:
协程是 asyncio 的核心概念之一。它是一个特殊的函数,可以在执行过程中暂停,并在稍后恢复执行。协程通过 async def 关键字定义,并通过 await 关键字暂停执行,等待异步操作完成。
要运行一个协程,可以使用 asyncio.run() 函数,它会创建一个事件循环,并运行指定的协程。事件循环是 asyncio 的核心组件,负责调度和执行协程。它不断地检查是否有任务需要执行,并在任务完成后调用相应的回调函数。
4.2.2.astream方法
可以使用.astream()方法,来异步生成流式响应的效果,这专为非阻塞工作流程而设计。可以在异步代码中使用它来实现相同的实时流式处理行为。代码如下:
# 异步调⽤
async def My_async_stream():
    print("=== 异步调⽤ ===")
    # async for:异步迭代器,配合流式输出
    async for chunk in model.astream("讲⼀个50字的笑话"):
        print(chunk.content, end="|", flush=True)

asyncio.run(My_async_stream())

# 输出
=== 异步调⽤ ===
|有|⼀天|,⼀|只|鸭|⼦|⾛|进|药|店|,|问|:"|你|们|有|⼝|红|吗|?"|药|剂|师|说|:"|没
有|。"|鸭|⼦|失|望|地|摇|摇|头|,|转|⾝|离|开|。|第⼆|天|,|鸭|⼦|⼜|来|:"|你|们|有|
⼝|红|吗|?"|药|剂|师|说|:"|我|说|过|没有|!"|鸭|⼦|说|:"|那|你|们|为什么|不|进|货|
呢|?"||
model.astream()_大模型异步流式接口
4.3使用 StrOutputParser 解析模型的输出
流式传输实际上并不算是聊天模型定义的能力,而是只要实现了Runnable接口的实例都具备的能力!!
但要注意,并非所有组件都必须实现流式处理:在某些情况下流式处理要么是不必要的,要么很困难,要么根本没有意义。例如,Retrievers检索器,就不提供任何流式处理。
那么再得出一个关于流式传输的结论:.stream()和.astream()方法产生的块类型取决于正在流式传输的组件。例如,我们当前正在使用聊天模型的流式传输,返回的每个块都将是一个AIMessageChunk。但是,对于其他组件,块类型可能不同。
接下来让我们使用LCEL构建一个简单的链,该链结合了模型和解析器,并验证流是否有效。不要忘了使用LCEL创建的链也实现了Runnable接口。
我们将使用StrOutputParser 来解析模型的输出,它从AIMessageChunk 中提取内容字段,为我们提供模型返回的令牌。代码如下:
# 定义⼤模型
model = ChatOpenAI(model="gpt-4o-mini")

# 定义输出解析器
parser = StrOutputParser()

# 定义链
chain = model | parser

# 同步流式调用
for chunk in chain.stream("写⼀段关于爱情的歌词,需要5句话"):
    print(chunk, end="|", flush=True)

# 输出
|在|星|空|下|许|下|⼼|愿|,|
|你的|笑|容|如|晨|光|温|暖|,|
|⼿|握|⼿|⾛|过|每|段|光|阴|,|
|⽆|论|⻛|⾬|依|然|不|离|不|弃|,|
|爱|是|永|恒|,|⼼|与|⼼|相|连|。| ||
4.4自定义流式输出解析器
上面我们演示了如何让聊天模型进行流式输出。若此时我们希望修改上一步的输出样式(一个字或两个字的输出),或者将输出改为一句话一句话的输出,同时保留流式处理功能。那么我们需要在链中使用生成器函数,即可完成自定义流式输出的能力 。
还记得之前说过,聊天模型的.stream()方法返回的是一个迭代器,该迭代器在生成输出时同步产生输出消息块。那么我们的将实现的这些生成器的签名应该是IteratorInput->Iteratoroutput。或者对于异步生成器:AsyncIteratorInput->AsyncIteratoroutput
下面是句号分隔列表的自定义输出解析器的示例:
# 定义输出解析器
parser = StrOutputParser()

# 定义⽣成器
def split_into_list(input: Iterator[str]) -> Iterator[List[str]]:
    buffer = ""
    for chunk in input:
        buffer += chunk
        while "。" in buffer:
            # 只要缓冲区中包含句号,就找到第⼀个句号的位置
            stop_index = buffer.index("。")
            # 将句号之前的内容(去除⾸尾空格)作为⼀个句⼦放⼊列表中并产出
            yield [buffer[:stop_index].strip()]
            # 更新缓冲区,保留句号之后的内容
            buffer = buffer[stop_index + 1 :]
    yield [buffer.strip()]

# 定义链
chain = model | parser | split_into_list

for chunk in chain.stream("写⼀份关于爱情的歌词,需要5句话,每句话⽤句号分割"):
    print(chunk, end="|", flush=True)

# 输出
['在星空下许下承诺的誓⾔']|['你的笑容如同晨曦,温暖了我的⼼']|['⽆论时光如何流转,我愿与
你携⼿共⾏']|['爱情是我们⼼中永恒的旋律']|['每⼀次相拥,都是⼀场甜蜜的重逢']|['']|
yield
用来把普通函数变成【生成器函数】;函数执行到 yield 时,暂停,并且把后面的值产出;下次迭代进来,从暂停位置继续往下跑。
一旦 buffer 找到句号:执行 yield 句子
- 函数在这里暂停!buffer 变量会保留,不会销毁
4.5深度探索流式传输
4.5.1 什么是SSE协议
HTTP协议本身设计为无状态的请求-响应模式,严格来说,是无法做到服务器主动推送消息到客户端,但通过 Server-Sent Events(服务器发送事件,简称SSE)技术可实现流式传输,允许服务器主动向浏览器推送数据流。
也就是说,服务器向客户端声明,接下来要发送的是流消息(streaming),这时客户端不会关闭连接,会一直等待服务器发送过来新的数据流。
SSE(Server-Sent Events)是一种基于HTTP的轻量级实时通信协议,浏览器可以通过内置的EventSource API接收并处理这些实时事件。
# 服务端向浏览器发送 SSE 数据,需要设置必要的 HTTP 头信息:
Content-Type: text/event-stream;charset=utf-8
Connection: keep-alive
每一次发送的消息,由若干个message组成,每个message之间由\n\n分隔,每个message内部由若干行组成,每一行都是如下格式: field: value\n
Field可以取值为:
data必需:数据内容
event非必需:表示自定义的事件类型,默认是message事件
id非必需:数据标识符,相当于每一条数据的编号
retry非必需:指定浏览器重新发起连接的时间间隔
除此之外,还可以有以冒号:开头的行,表示注释。
4.5.2 LangChain流式传输流程
LangChain本身并不"创造"或"规定"一个底层的网络传输协议,而是依赖于其底层的大模型供应商(如OpenAI)和我们自身服务应用所使用的Web框架(如FastAPI)的协议。
因此对于LangChain的流式传输能力,本身是因为大模型供应商提供了流式传输能力,由LangChain进行调用后接收并处理成一个个的AIMessageChunk
4.5.2.1通过源码分析流程
当我们向OpenAI发起流式请求,LangChain实际上会通过BaseChatOpenAI 类中的_stream()方法发起调用。
_stream()方法的关键流程性源码见:class langchain_openai.chat_models.base.BaseChatopenAI
可以看到,流式逐块产生AIMessageChunk聊天消息**。**
那么接下来看三个问题:
1.发起调用时,底层使用什么协议?
2.如何支持流式传输?
3.返回的块是什么格式,如何转换成AIMessageChunk?
这三个问题都掌握后,整个流式传输的流程就都能理解了。
4.5.2.2 LangChain 请求 OpenAI 使用什么协议?
我们找到 class langchain_openai.chat_models._client_utils. _SyncHttpxClientWrapper。发现LangChain使用了OpenAI的官方的OpenAI SDK for Python接入方式,继承了openai._base_client定义的一个HTTP客户端。
因此,在调用时,发起的是 HTTP调用。
4.5.2.3 LangChain如何支持流式传输?
当我们发起请求时,会在请求中设置stream=True(_stream()源码中的第一步),表示OpenAI服务器将在生成 Response 时向客户端发出数据(server-sent events,SSE)。此时 API会保持HTTP连接打开,并以特定格式发送数据。
例如,我们向原生的GPT模型发起一次设置了stream=True的HTTP请求:"你好,我是张三"。此时,我们会收到来自OpenAI的事件块(简化后的有效负载序列)。
4.5.2.4 OpenAI返回的块是什么格式,如何转换成AlMessageChunk?
我们已经从上面知道OpenAl返回的数据块格式是LangChain自定义的 AIMessageChunk,这是通过_convert_chunk_to_generation_chunk() 方法完成的。
到此,我们就知道了LangChain流式传输的完整流程与底层协议。总结一下:
1.langchain-openai 包通过集成 OpenAI Python SDK,提供了一个HTTP客户端。
2.因此,支持LangChain向OpenAI的API发起调用请求。
3.若希望发起流式传输请求,则需在请求中加入stream=True,向OpenAI说明以SSE协议进行流式返回。
4.LangChain接收OpenAI的SSE格式的响应,并将其转换为LangChain自封装的消息格式,如AIMessageChunk消息。这样就可以以统一的方式处理来自不同模型提供商(OpenAl,Anthropic等)的流式响应。
5.使用LangSmith 跟踪LLM应用
使用LangChain构建的许多应用程序,可能会包含多个步骤和多次的LLM调用。随着这些应用程序变得越来越复杂,作为开发者,我们能够检查链或代理内部到底发生了什么变得至关重要。最好的方法是使用LangSmith。
LangSmith 与框架无关,它可以与 langchain和langgraph一起使用,也可以不使用。LangSmith是一个用于帮助我们构建生产级LLM应用程序的平台,它将密切监控和评估我们的应用。LangSmith平台地址:LangSmith
要想让 LangSmith跟踪LLM应用,第一步申请LangSmith API Key,点击Settings,就会跳转到"API Keys"设置页面,若没有跳转,可以在左侧tab栏中找到进入。
创建完成后,保存好你的 API Key。配置两个环境变量:
LANGSMITH_TRACING="true"
LANGSMITH_API_KEY="你的 LangSmith API Key"
配置完成后,让我们任意执行代码,查看 LangSmith 平台,这将在 LangSmith 的默认跟踪项目中生成调用的跟踪。
点击最新一次的调用追踪:跟踪会以瀑布流形式展示调用的完整步骤,以及每个步骤的详细 信息和耗时。让我们能够检查内部到底发生了什么!!
在使用LangSmith时并没有代码介入,只需要配置下环境,就可以直接监控我们的应用。