AI Agent 设备指令超时后,重试会执行两次吗?
用户对语音 Agent 说"把灯光亮度增加 20%"。云端等了十秒只显示"超时";用户于是再说一次。第一次可能已经让设备动作,只是结果回报迟到。若第二次被当作新的相对动作,亮度就可能累计增加 40%。这是设计推演的失败场景,没有真实灯具或 AWS 账号实测。
"设置亮度为 60%"是目标状态命令,"增加 20%"是相对命令。两者重复执行的后果不同。Agent 需要先弄清第一次的结果,不能把"我没等到回报"直接翻译成"设备没做"。
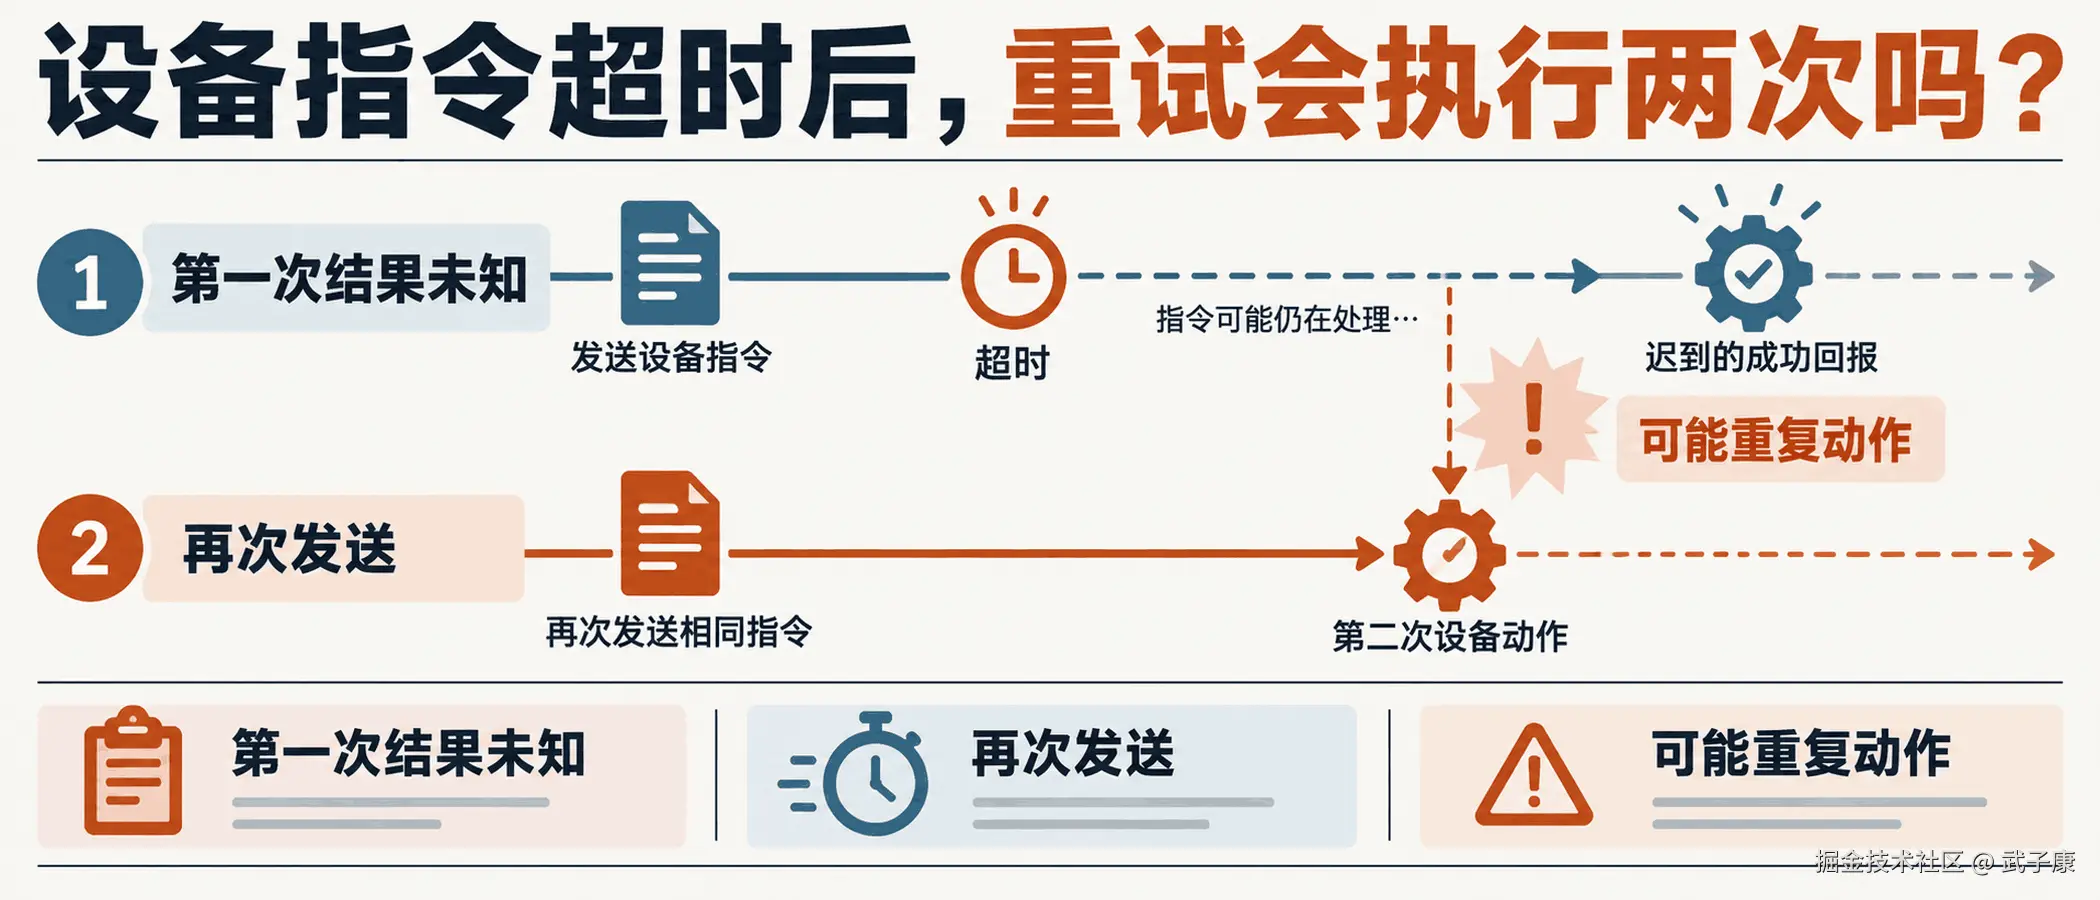
超时先查原执行
AWS IoT Commands 执行文档明确:设备在期限内没有回报时,云端可将 execution 标成 TIMED_OUT,原因码为 $NO_RESPONSE_FROM_DEVICE。设备可能离线、尚未完成,也可能已完成但没有及时报告。由云端报告的 TIMED_OUT 是非终态 ;设备随后仍可回报 SUCCEEDED、FAILED 或 REJECTED,覆盖这个超时状态。
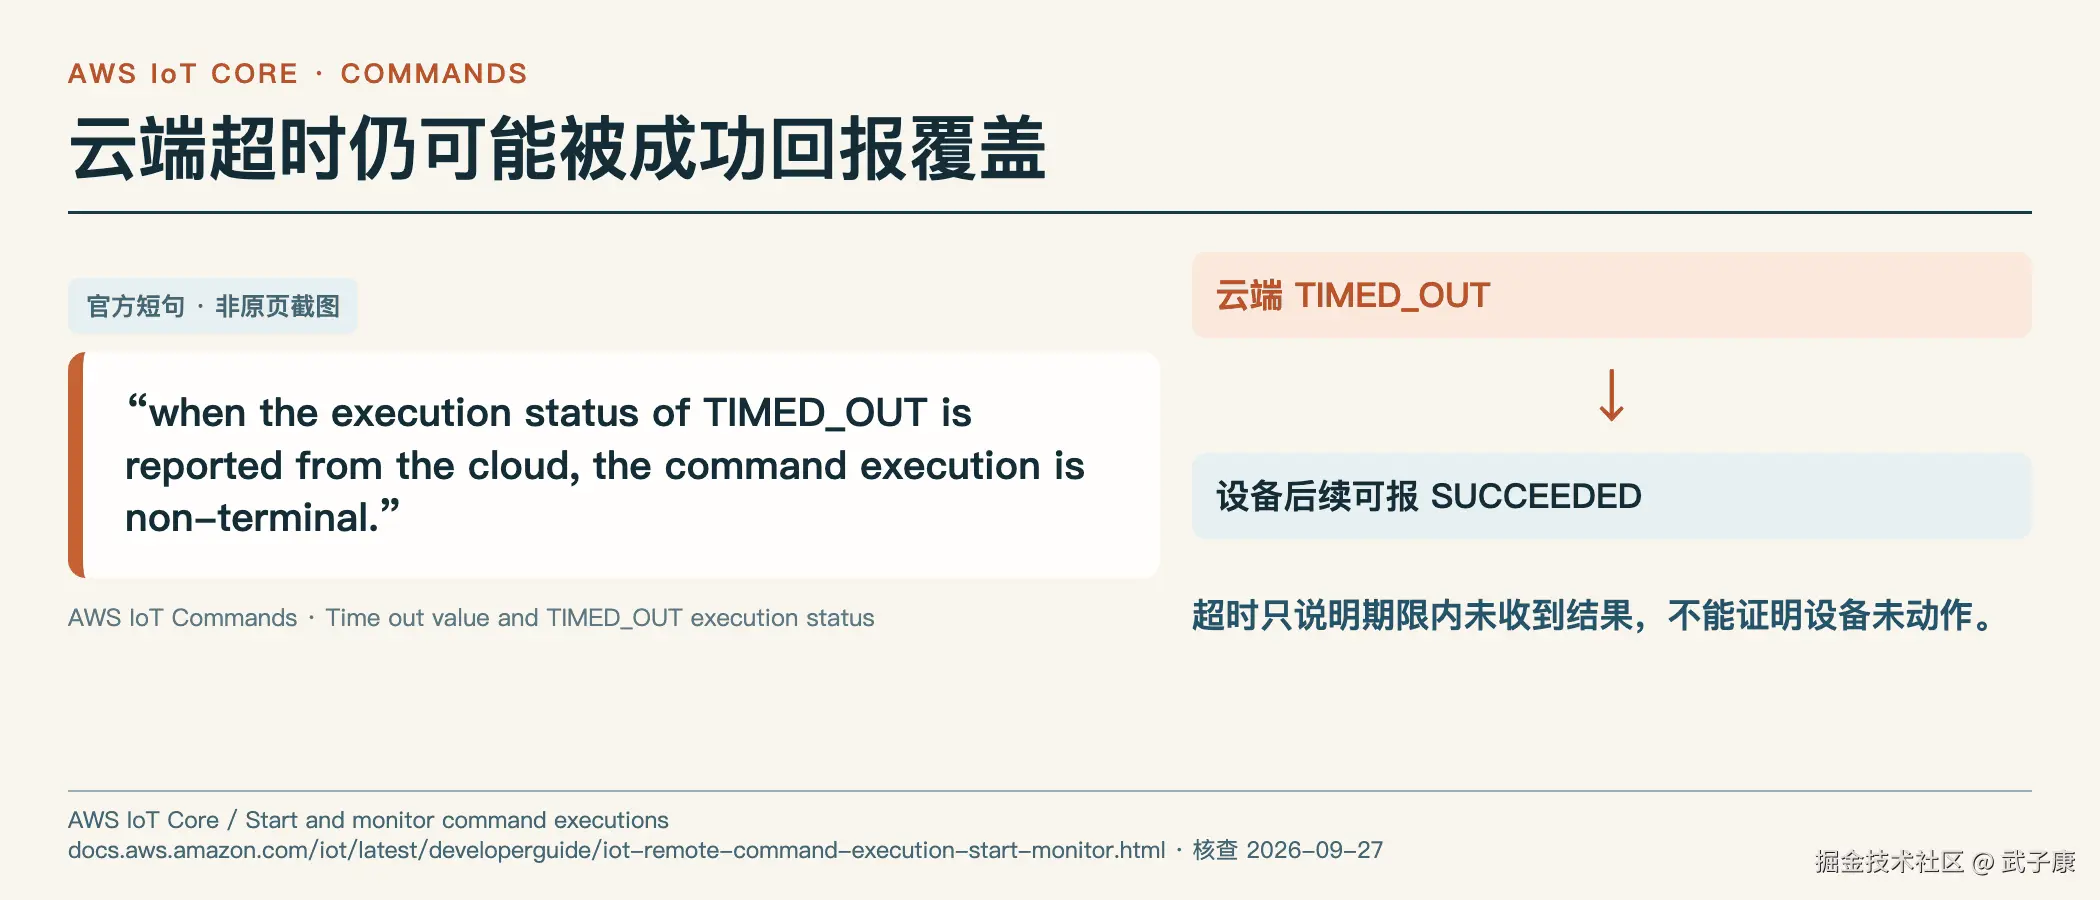
因此,"超时"只说明在期限内没有取得可确认结果。AWS StartCommandExecution 返回的 execution ID 可以追踪同一次平台执行;先用它查询原结果。若设备一直没有回报,查询仍只能得到未知,不能凭多等几秒改写为"未执行"。
这里的状态含义属于 AWS IoT Commands,不是 AWS IoT Jobs 的状态表。还要区分谁报告超时:设备可以把云端超时更新为设备报告的 TIMED_OUT,这时 execution 成为终态,不再接受后续更新。同一个状态字符串并不足以决定能否继续更新;需要一起保存报告来源与原因。普通 MQTT 发布或自建平台的超时字段各有契约;本文不把 AWS 产品状态当作所有设备的通用规则。上述文档于 2026 年 10 月 13 日再次核实。
超时发生在哪一段,决定下一步查什么
一次工具调用会经过本地提交、服务端受理、消息交付、设备动作和结果回传。客户端没有收到响应,可能连 execution ID 都拿不到,但这并不证明服务端没有创建执行。若在受理前断开,查询本地 operation_id 对应记录;若已经拿到平台 ID,继续查该执行;若已有设备动作证据,则重点查回报关联。不要仅凭最外层一个 TimeoutError 把所有情况归为设备未执行。
建议在首次发出动作前持久化用户意图和业务 ID,再把平台执行 ID 追加到同一记录。这样客户端重连后能够找到上次提交,而不需要根据聊天文本猜一个 ID。若上次请求是否受理仍不可判断,可以先查询已保存映射或按平台实际支持的受理查询机制处理。平台没有相应能力时,明确保留这段未知;应用自建 ID 不能自动赋予外部接口幂等性。
晚到成功也要绑定原操作。设想第一次超时,用户随后明确提出新动作,旧成功在新动作之后到达。它说明第一次后来有结果,不能成为第二次成功的证明;当前亮度也可能已经由第二次改变。把执行历史与当前设备状态分开,能够同时说明两件事,而不是让最后到达的一条消息替全部操作结算。
两种重复的来源
第一种来自传输层。MQTT 5.0 标准定义 QoS 1 为至少一次交付。标准的 DUP 位针对 MQTT 控制报文重传,不代表应用消息是否第一次出现;即便 DUP=0、Packet Identifier 不同,也可能承载重复的应用消息。AWS IoT Core 的 MQTT 文档说明其支持 QoS 0/1,QoS 1 在 PUBACK 前可重发。传输保证把消息送达,不负责"灯只调一次"。AWS IoT Core 产品对 DUP 的支持又有自身限制,不能把标准字段当成它的应用去重接口。
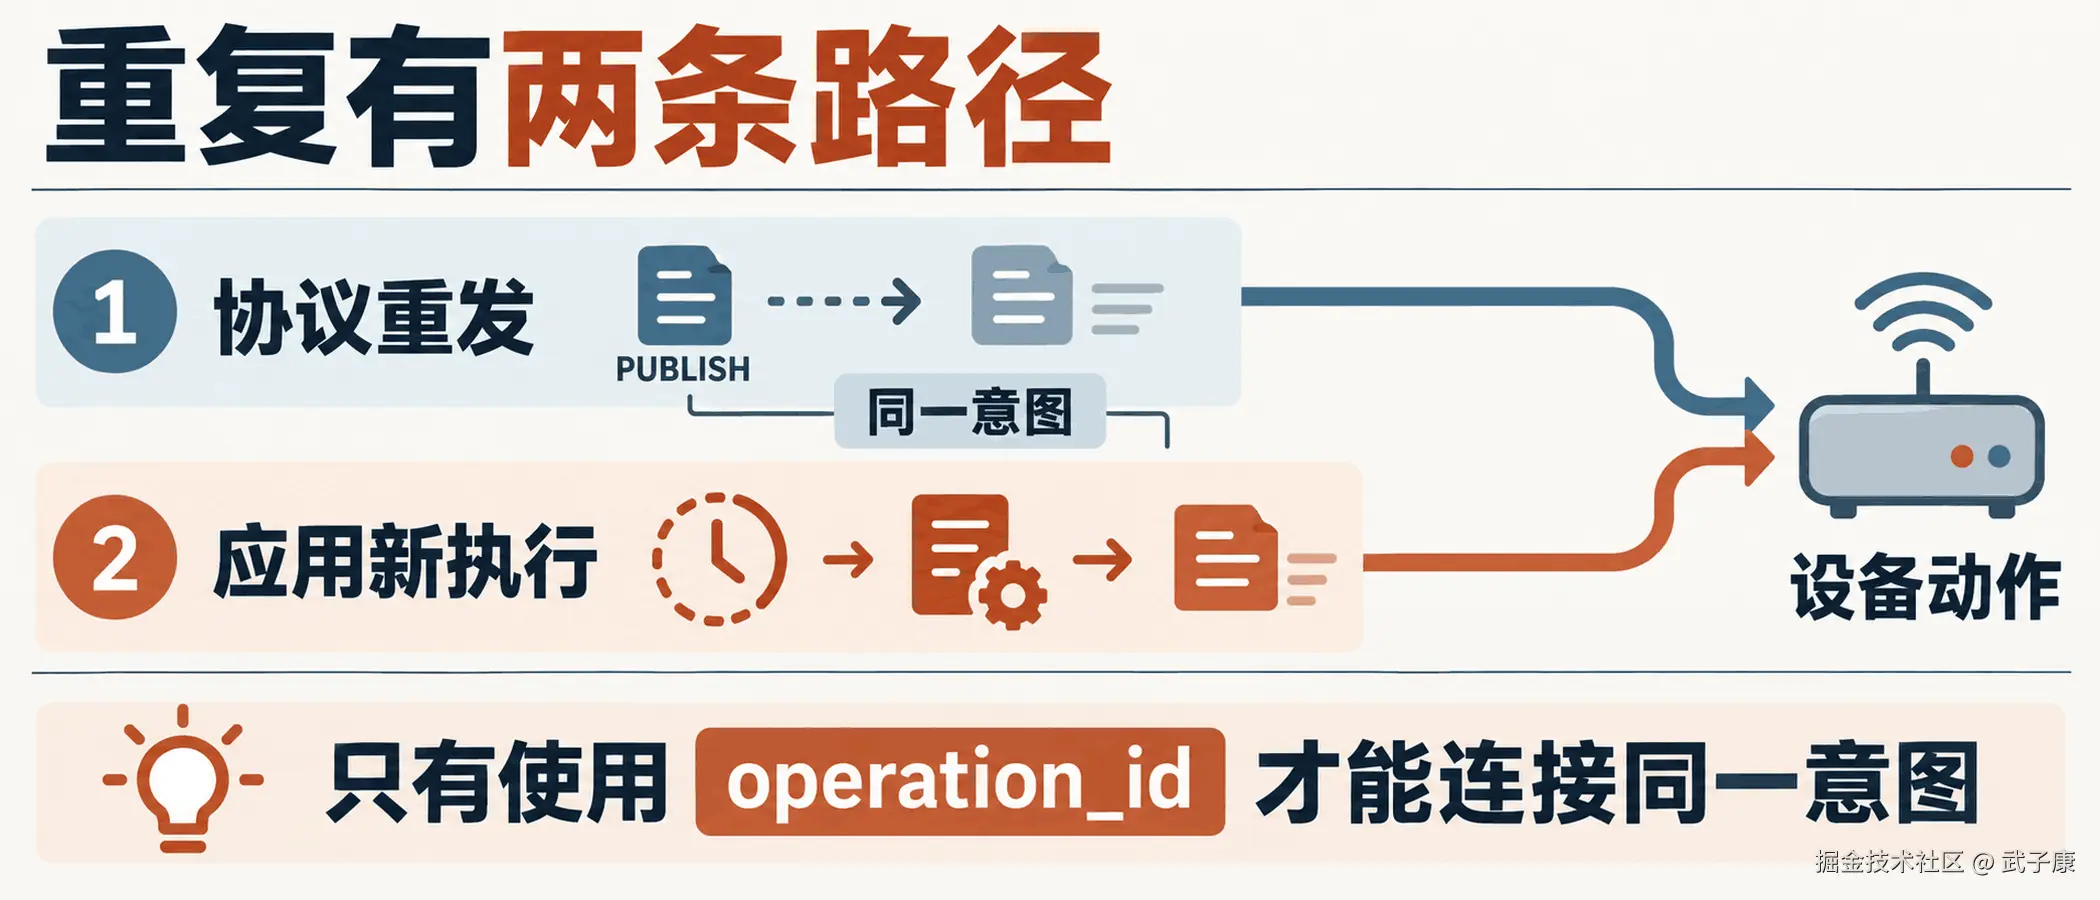
第二种来自应用层。Agent 的工具调用超时后,服务端又创建一次新的业务执行。即使两条 MQTT 消息各自只交付一次,设备仍可能接到两条有效的"增加 20%"。平台 execution ID 代表一次发送;它和 MQTT Packet Identifier 都无法独自判断两次发送是否来自同一个用户意图。用户的第二句话也可能是有意要求再加 20%,这时不应被错误去重。语义不明确时,先说明第一次结果未知,再问是否要追加动作。
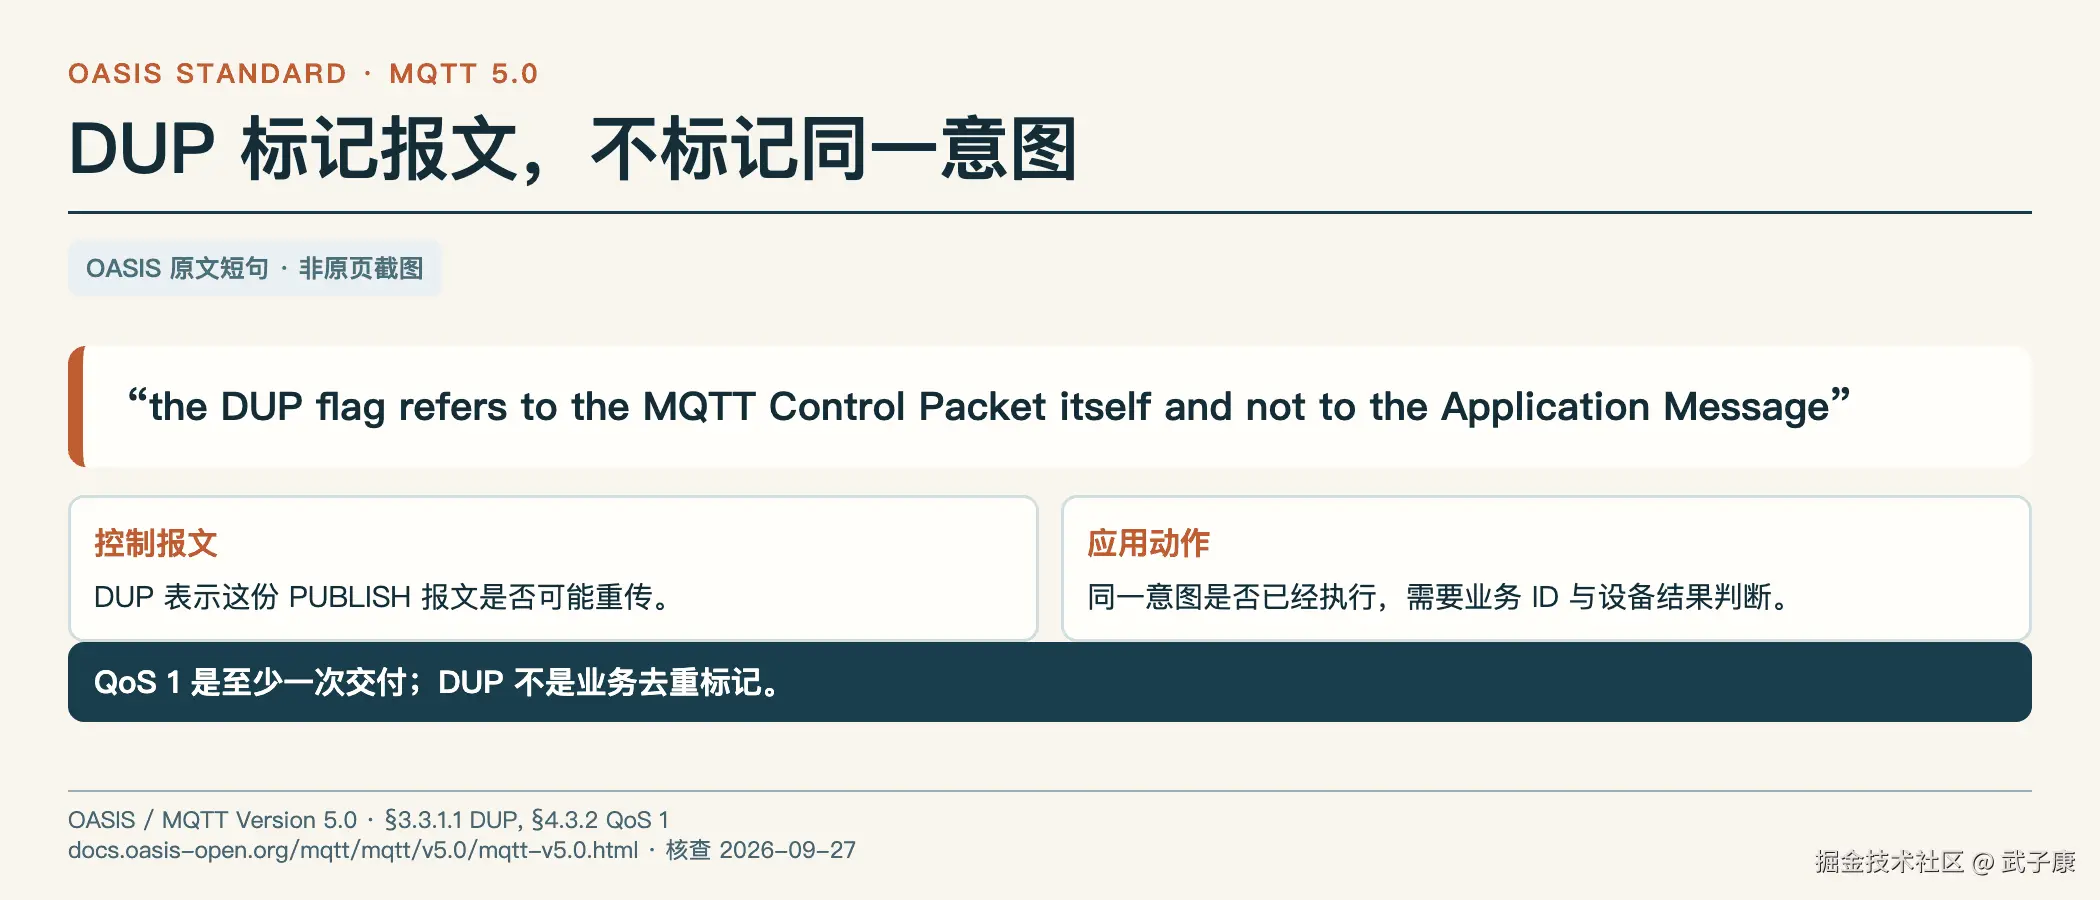
三种身份分别回答三个问题
业务 operation_id 回答"这是用户哪一次意图",平台 execution ID 回答"服务端哪一次发送或执行",协议往返标识回答"这是哪次消息交换"。一次业务操作可以因重送产生多个平台执行,平台消息也可能发生重传。只保留最底层标识,上层就失去判断重复意图的依据;只保留业务 ID,又不容易查某一次平台失败。
可以在一条业务记录中保存全部关联:原始动作参数、每次提交的平台执行、设备回报及最终判断。参数不可默默改变。例如原 operation_id 是增加 20%,后续重送却变成设置 60%,这是不同动作,应拒绝复用旧身份或重新建立明确的新意图。否则设备返回旧结果时,云端可能以为新参数已经执行。
业务去重的范围也要固定。同一个 operation_id 若在不同设备上出现,应该由设备身份一起区分,不能把给客厅灯的结果拿来回答书房灯。若命令还包含能力或通道,持久记录要足以检查目标与参数是否相同。这里不是要求发明复杂的通用键,而是避免身份信息不足导致错误复用。
目标状态也有时间边界。重复设置 60% 从累加角度看较容易幂等,但用户之后已经改成 30%,旧设置 60% 的重送就会覆盖新意图。幂等描述的是同样动作重复的效果,不代表任何时刻都安全。重试前仍应检查当前授权、命令有效期和状态版本。
什么时候才能再发一次
应用可在首次下发前生成业务 operation_id,记录设备、动作参数、创建时间和有效截止时间。这个 ID 表示一次用户意图,是作者建议的应用字段,不是 MQTT 自动提供的字段。AWS execution ID 继续追踪平台上的某次发送;若设备协议传不了业务 ID,就不能宣称设备侧可以按它去重。
| 原命令的证据 | 决策 | 可对用户说的话 |
|---|---|---|
| 设备已回报执行,且结果可核对 | 返回第一次的结果,不再发送同一相对动作 | "刚才已执行,当前亮度为......" |
| 设备给出拒绝等终态,且旧命令已无法再执行 | 结合风险与有效期决定是否重新发送 | "刚才未执行,正在重试"或请用户确认 |
| 只有云端超时、设备离线或回报缺失 | 保持未知,暂停相对动作自动重发 | "暂不能确认刚才是否执行,我先不重复调节" |
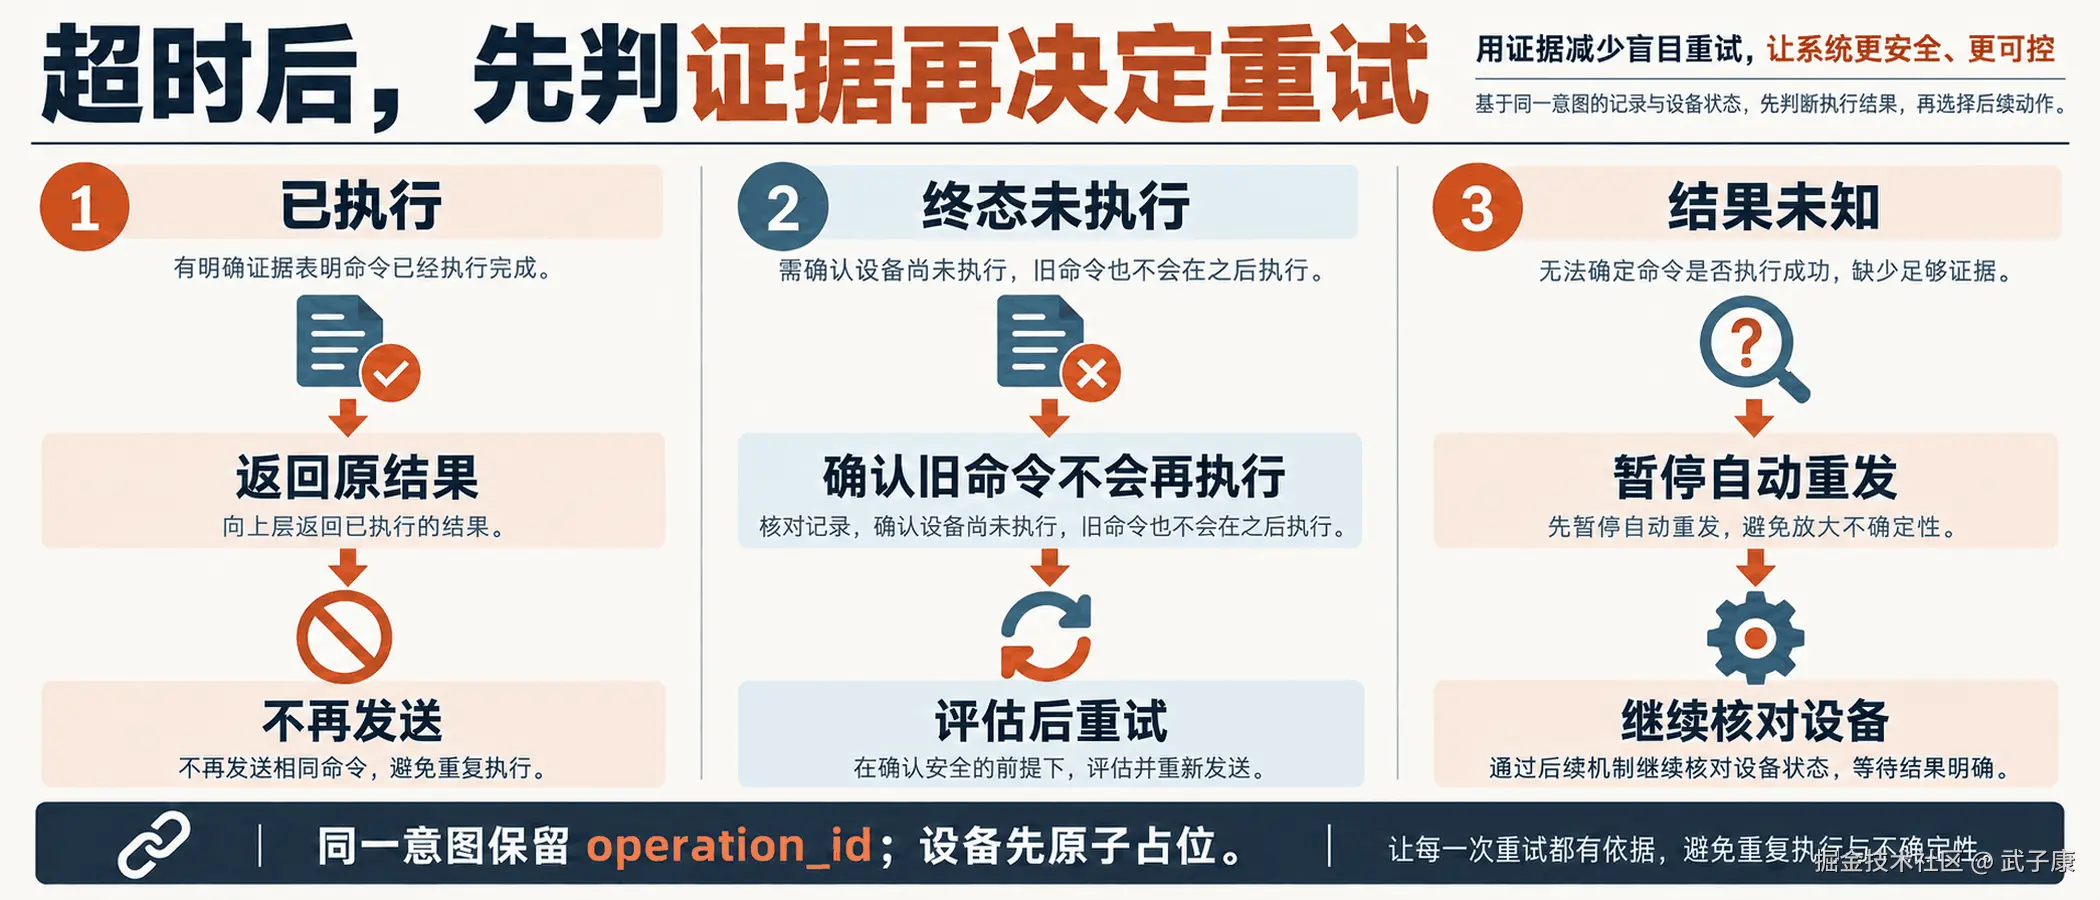
如果业务确实要重送同一次意图 ,新平台 execution 仍应携带原 operation_id。设备收到请求时,先用"设备 ID + operation_id"原子占位,再启动动作:已完成就返回旧结果,进行中就等待或返回进行中,不再启动第二次;相同 ID 携带不同动作参数必须拒绝或报警。去重记录的保留时间要覆盖离线与重试窗口;旧命令到达时也要检查业务有效期。
"旧命令当前尚未执行"不是允许重试的终态。设备下一瞬间仍可能执行它。只有旧命令已进入此后不会再执行的设备侧终态,才能把"第一次未执行"作为新动作依据。云端超时本身不满足这个条件。
原子占位只挡一部分重复
设备若先查表、再写表、再启动动作,两个并发请求可能都查到不存在,从而各做一次。原子占位让"谁获得这次操作"成为一次不可拆的决定,第二个请求看到已有记录后返回进行中或原结果。它解决并发重复启动,却还没有解决占位之后断电该怎么办。
可以按掉电位置保留不同恢复证据:占位前崩溃,设备没有该次记录;占位后动作前崩溃,记录显示进行中但物理动作未必开始;动作后结果写入前崩溃,进行中记录同样存在,而物理动作可能完成。后两种在软件表里看起来相似,恢复逻辑不能用同一条"再做一次"处理。
如果能读取当前亮度,目标状态任务可以把读数与目标比较;相对任务却还可能受到并发操作影响。当前值是 60% 不一定能证明此前增加了 20%,因为另一位用户也可能调节过。要判断相对动作是否发生,通常还需要可信的先前基线、动作关联或设备动作序号。读到当前状态有帮助,但不是对所有相对动作都充分。
结果持久化后收到重复请求,则应该返回同一个操作结果,注明当前设备状态可能已经变化。历史上增加成功与此刻亮度保持不变,是两个不同事实。缓存旧结果用于去重,不能把旧亮度当成当前实时读数。若用户询问现在多少,应另查新鲜状态。
掉电后,去重表也不知道灯亮了没有
原子占位可以拦住并发重复请求,却不能让物理动作和存储记录变成一个事务。设备可能在占位后、动作启动前断电,也可能动作已经发生、结果还没写入就断电。重启后只看记录,仍无法判断灯到底调过没有。对这类相对动作,不能靠"数据库唯一键"承诺物理上恰好一次。
能读取可靠传感状态时先核对;不能判定物理结果时保留未知,停止自动补发,交给用户或现场流程。若业务需要更强保证,设备硬件和协议必须提供可验证的动作序号或事务边界。
复制运行:让动作次数暴露重复风险
下面把原来的待运行测试推进成一个已执行的最小例。它只处理一盏模拟灯,初始亮度为 40,亮度范围是 0 到 100;set 设置目标值,add 增减百分点。这里的"增加 20%"固定解释为增加 20 个亮度百分点,而不是把原值乘以 1.2。真实产品应在协议里写清这个单位,不能让设备与 Agent 各自解释。
SQLite 只保存业务操作历史,Python 字典代表模拟设备状态。二者刻意分开,才能看到存储记录不能直接代替物理状态。操作 ID 的唯一范围只限这一个灯的数据库;多设备系统应再加设备身份。例子不实现网络队列、并发工作线程、权限管理、消息有效期或跨进程恢复,目标是复现重试判断最容易混淆的几条分支。
保存为 device_retry.py,用 Python 3.8 或以上版本执行;只用标准库,没有安装步骤。不要使用 python -O,因为本例的反例检查使用 assert。
bash
python3 device_retry.py
python
"""Local contract demo, one lamp; no network or real device."""
import sqlite3


def fresh():
    db = sqlite3.connect(":memory:")
    db.execute("CREATE TABLE ops (id TEXT PRIMARY KEY, kind TEXT, value INTEGER, "
               "status TEXT, result INTEGER)")
    return db, {"brightness": 40, "actions": 0}


def submit(db, lamp, operation_id, kind, value, crash=None):
    if (not operation_id or kind not in {"set", "add"}
            or type(value) is not int or not -100 <= value <= 100
            or (kind == "set" and value < 0)
            or crash not in {None, "before", "after"}):
        raise ValueError("invalid command")
    with db:
        claimed = db.execute(
            "INSERT INTO ops VALUES (?, ?, ?, 'RUNNING', NULL) "
            "ON CONFLICT(id) DO NOTHING", (operation_id, kind, value)
        ).rowcount
        old_kind, old_value, status, result = db.execute(
            "SELECT kind, value, status, result FROM ops WHERE id = ?",
            (operation_id,)
        ).fetchone()
    if (old_kind, old_value) != (kind, value):
        return "CONFLICT", None
    if not claimed:
        return ("CACHED", result) if status == "DONE" else ("UNKNOWN", None)
    if crash == "before":
        return "UNKNOWN", None
    target = value if kind == "set" else lamp["brightness"] + value
    lamp["brightness"] = max(0, min(100, target))
    lamp["actions"] += 1
    if crash == "after":
        return "UNKNOWN", None
    with db:
        db.execute("UPDATE ops SET status = 'DONE', result = ? WHERE id = ?",
                   (lamp["brightness"], operation_id))
    return "DONE", lamp["brightness"]


def main():
    db, lamp = fresh()
    assert submit(db, lamp, "set-1", "set", 60) == ("DONE", 60)
    assert submit(db, lamp, "set-2", "set", 60) == ("DONE", 60)
    assert lamp == {"brightness": 60, "actions": 2}
    print("target/new IDs: brightness=60 actions=2")

    db, lamp = fresh()
    assert submit(db, lamp, "op-1", "add", 20) == ("DONE", 60)
    cloud_status = "TIMED_OUT"
    decision = "UNKNOWN" if cloud_status == "TIMED_OUT" else "CHECK_RESULT"
    assert decision == "UNKNOWN" and lamp["brightness"] == 60
    print("cloud timeout: decision=UNKNOWN device_brightness=60")
    cloud_status = "SUCCEEDED"  # A constructed late report, not an AWS call.
    assert cloud_status == "SUCCEEDED"
    print("late report: original_execution=SUCCEEDED")
    assert submit(db, lamp, "op-1", "add", 20) == ("CACHED", 60)
    assert lamp["actions"] == 1
    print("relative/same ID: brightness=60 actions=1 result=CACHED")
    assert submit(db, lamp, "op-2", "add", 20) == ("DONE", 80)
    assert lamp["actions"] == 2
    print("relative/new ID: brightness=80 actions=2")
    assert submit(db, lamp, "op-1", "add", 10) == ("CONFLICT", None)
    assert lamp["actions"] == 2
    print("same ID/different payload: CONFLICT actions=2")
    assert submit(db, lamp, "op-1", "add", 20) == ("CACHED", 60)
    assert lamp["brightness"] == 80
    print("history/current: cached_result=60 current_brightness=80")

    crash_rows = []
    for phase, expected in (("before", 40), ("after", 60)):
        db, lamp = fresh()
        assert submit(db, lamp, "crash-1", "add", 20, phase) == ("UNKNOWN", None)
        actions = lamp["actions"]
        assert submit(db, lamp, "crash-1", "add", 20) == ("UNKNOWN", None)
        assert lamp["brightness"] == expected and lamp["actions"] == actions
        crash_rows.append(db.execute("SELECT * FROM ops").fetchall())
        print(f"crash/{phase}: brightness={expected} retry=UNKNOWN actions={actions}")
    assert crash_rows[0] == crash_rows[1]

    db, lamp = fresh()
    assert submit(db, lamp, "forgotten", "add", 20) == ("DONE", 60)
    with db:
        db.execute("DELETE FROM ops WHERE id = ?", ("forgotten",))
    assert submit(db, lamp, "forgotten", "add", 20) == ("DONE", 80)
    assert lamp["actions"] == 2
    print("deleted history/same ID: brightness=80 actions=2")
    try:
        submit(db, lamp, "bad", "set", -1)
    except ValueError:
        pass
    else:
        raise AssertionError("invalid target accepted")
    assert lamp["actions"] == 2
    print("PASS: assertions and negative cases")


if __name__ == "__main__":
    main()
2026 年 10 月 13 日本地运行的实际标准输出如下,退出码为 0:
text
target/new IDs: brightness=60 actions=2
cloud timeout: decision=UNKNOWN device_brightness=60
late report: original_execution=SUCCEEDED
relative/same ID: brightness=60 actions=1 result=CACHED
relative/new ID: brightness=80 actions=2
same ID/different payload: CONFLICT actions=2
history/current: cached_result=60 current_brightness=80
crash/before: brightness=40 retry=UNKNOWN actions=0
crash/after: brightness=60 retry=UNKNOWN actions=1
deleted history/same ID: brightness=80 actions=2
PASS: assertions and negative cases
首先看目标态的两次调用:两个不同 ID 都执行了,因此动作次数是 2,但模拟亮度仍是 60。这只是"重复写同一目标不累加"的例子,不代表执行没有成本。如果命令还会触发提示音、写闪存或机械运动,即使亮度一样,也需要评估这些副作用。若用户先设成 30 后旧 60 重送,前节的有效期与意图版本问题同样存在。
再看相对动作。第一次 op-1 把亮度从 40 加到 60;随后构造云端超时,设备值却已经是 60。超时的判定仍是 UNKNOWN,直接给出"没执行"的反馈会与模拟事实矛盾。晚到成功那一行只是给原执行添加了一个构造回报;没有发起 AWS 请求,没有验证 AWS 网络时序,也没有做完整的云端状态机。官方规则说明为什么需要这个分支,代码仅检查应用对这一分支的解释。
重复提交 op-1 返回 CACHED,动作次数保持 1;改成 op-2,亮度变为 80、动作次数变为 2。后一行正是危险反例:如果 Agent 每次工具重试都新建业务身份,设备按 ID 去重也挡不住第二次相对动作。另一方面,用户明确要求"再增加一次"时,这又是正确结果。应用必须保存"重送原意图"或"追加新意图"的决定,不能靠设备看到相同文字自动裁决。
参数冲突行让旧 op-1 携带增加 10 的参数,返回 CONFLICT 且没有增加动作次数。此时返回旧成功会让调用方误以为新幅度执行了,直接重做又会把同一个 ID 变成两种含义。拒绝冲突既保护身份语义,也能暴露上层在重试过程中改参的问题。代码还检查了非法负目标不会进入动作路径,避免演示输入边界时静默裁剪成有效命令。
历史与当前状态一行容易被忽视:op-1 的缓存结果仍是 60,但 op-2 之后当前亮度是 80。把 CACHED 的 60 直接填进"现在亮度为 60"就是一个反馈错误。操作结果回答那一次做了什么,新鲜读数回答此刻是什么;响应结构应保留两者的来源和时间,必要时另查状态。
两种掉电位置,同一条历史记录
crash/before 在占位提交之后、动作之前停止,模拟亮度仍为 40,动作次数为 0;crash/after 在动作之后、完成结果写入之前停止,亮度已经 60,动作次数为 1。两种情况下数据库都只留下同一条 RUNNING、结果为空的记录,脚本直接断言两组数据库行完全相同。由此可以构造两段不同的动作历史,却得到相同的软件证据;仅看记录不可能区分它们。
随后用相同 ID 调用,两组都返回 UNKNOWN,动作次数不变。这里的 UNKNOWN 既可能表示另一执行仍在进行,也可能表示被中断后待核实;例子没有线程状态,因此采用保守处理,不把所有 RUNNING 自动当成掉电。线上服务应先识别仍存活的执行与恢复中的执行,再查询设备侧证据。若没有足够证据,等待、查询或人工核对比把 RUNNING 改成"失败可重试"更准确。
这不是一次真实掉电实验。代码没有杀进程,也没有读取重启后的磁盘数据库;crash 参数只是跳过不同位置的语句,故障前的记录保留在当前进程内,字典里的模拟亮度可被测试直接观察。真实设备能否持久保存 RUNNING、掉电后驱动有没有继续运动、传感器读数是否可靠,都不在本次证明范围。例子证明的是"同样的记录可能对应不同动作历史",不是 SQLite 已提供物理 exactly-once。
最后的删除历史反例,把已完成的 forgotten 记录删除后重送同一 ID,亮度从 60 变成 80,动作次数达到 2。业务 ID 字符串仍然一样,但系统已失去识别它的历史。实际清理策略要覆盖离线积压、调用方重试和迟到消息的窗口;无法确定消息最晚到达时间时,还要由设备拒绝过期操作。不能以"我们用了唯一键"省掉记录保留与失效规则。
从本地断言到设备验收,还差哪些观察
本例用单条 INSERT ... ON CONFLICT 竞争唯一键,避免示范"先 SELECT、不存在再 INSERT"的竞态写法;自检执行的是顺序调用,没有运行多连接或多进程竞争。因此它可以证明本例的分支与反例,但不能声称线上并发占位压测已经通过。接入实际服务时,应检查所有动作入口是否都经过同一占位路径,数据库冲突和锁等待如何处理,失败入口是否会绕过去重再次发送。
真机验收应把同 ID 重送、明确新 ID 动作、动作前断电、动作后结果写入前断电分别记录。每次同时保存业务身份、平台执行身份、物理观察和反馈文本;先看动作次数或动作序号,再看最终状态。只看最终亮度,有可能漏掉先增加后被另一条命令减回去的重复;只看 API 成功,也可能漏掉驱动实际没动作。没有观察到的部分继续标为待验证。
若设备协议无法携带业务 ID,先选择能力范围较窄的做法:查询原平台执行、禁止结果未知时自动重做相对动作、允许用户明确提出新的请求。不要用云端唯一键声称设备已去重。等设备提供可核验的身份与恢复协议后,再扩大自动重试能力。
重试策略还要区分查询与动作。重复查询执行结果通常不会重复物理动作,但查询接口也可能失败。可以按平台允许的频率重查,记录查询时间和返回状态;无论查询多少次,未知都不能自动转成未执行。若平台限制查询频率,保留下一次核对计划,避免为了让对话尽快结束而直接创建新动作。
自动重试的触发者也值得记录。可能是 HTTP 客户端、任务队列、Agent 工具层或用户手动重试;若每层独立重试,发送次数会被叠加放大。先找实际调用方,明确同一 operation_id 由哪层负责重送、哪层只负责查结果。这个要求可以减少重复风险,不需要一开始建立复杂的分布式调度框架。
新的执行创建成功以后,映射记录不能只留下最新 ID。原执行可能仍处于运行或迟到回报阶段,丢掉它就无法解释后来哪次动作成功。保存同一业务操作关联的执行列表,并分别记结果,再依据设备侧去重和真实观察汇总。平台 ID 多个而业务动作一次,应有明确证据;平台 ID 一个也不意味着设备物理只做一次。
用户反馈可附当前状态来源,例如"原操作后来报告成功;现在查询亮度为某值"。如果只有执行成功、没有当前状态,就别补出亮度;如果只有新鲜状态、没有执行关联,就说明状态已达到目标而原操作归因仍未知。两种证据都能帮助用户,但应各自表达,避免用一个成功句子覆盖缺失部分。
拿这份例子接入自己的协议时,先替换输入记录与设备证据,不急着扩大自动重试范围。相同业务身份能减少可避免的重复,无法解释的物理结果仍要留为待核实;这两个条件应同时体现在动作路径和用户反馈里。