Grafana 从入门到实战:不装 Prometheus,我把业务表直接变成了监控面板
写在前面:一个反常识的认知
提到 Grafana,很多人的第一反应是「Prometheus 的配套画图工具」。我最初也是这么以为的,直到给自己的多 Agent 项目(CAS 竞品分析系统,下文简称 CAS)做监控时,我做了个反常规的选择:不部署 Prometheus,让 Grafana 直连 PostgreSQL,用 SQL 把业务表画成了 17 个监控面板,全程没有写一行新的业务代码。
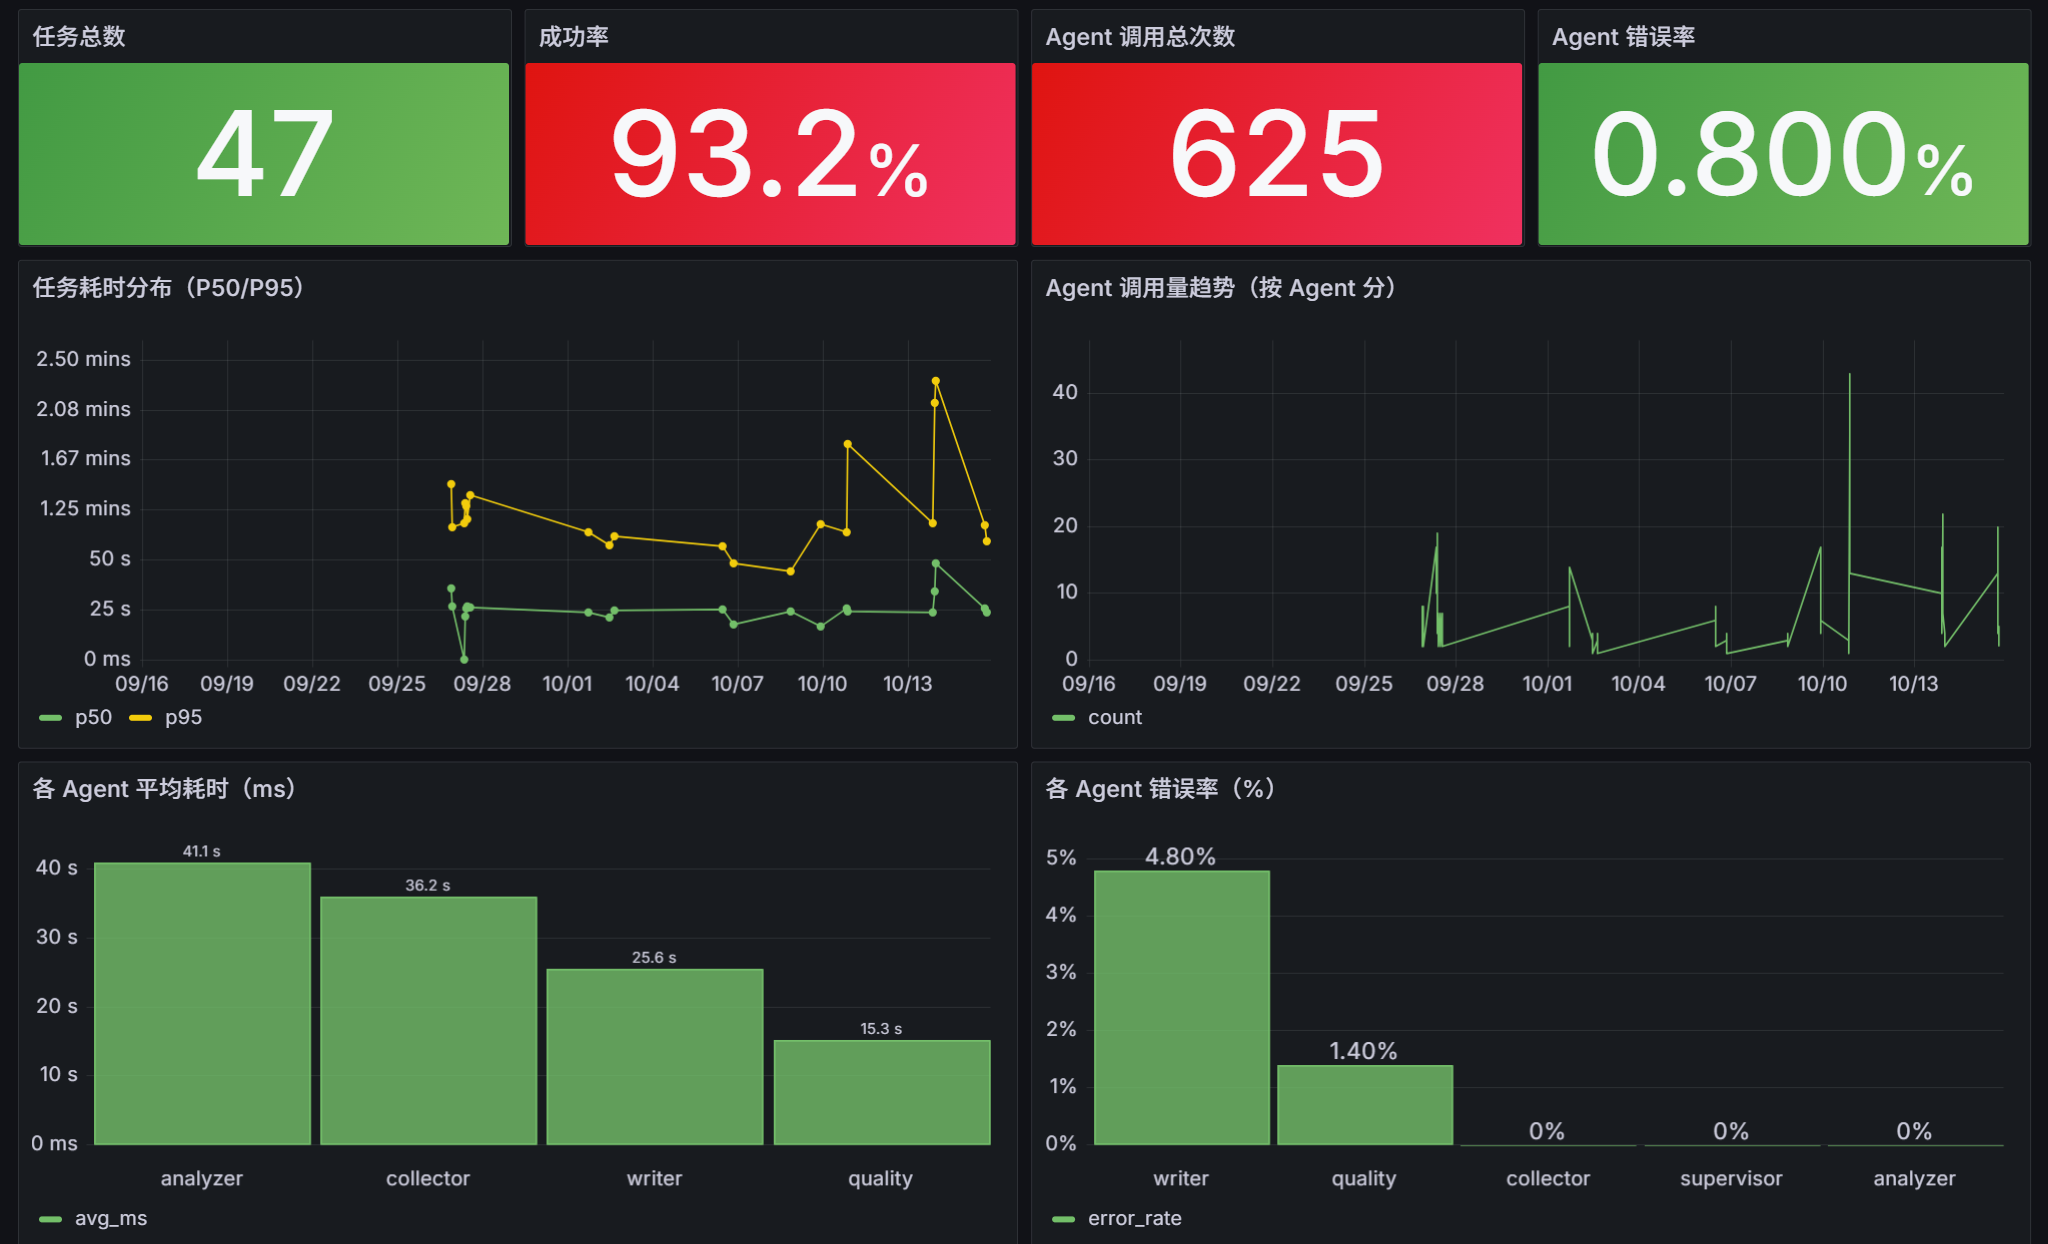
这篇会分两部分讲:前半部分完全脱离项目,把 Grafana 本身的概念讲透------它是什么、不是什么、数据从哪来;后半部分进入实战,讲清楚 CAS 为什么敢绕开 Prometheus,以及完整可复制的落地配置。
一、先把 Grafana 讲透
1.1 Grafana 是什么,不是什么
一句话定义:Grafana 是一个可视化查询引擎------它把「执行查询 → 拿到数据 → 按面板类型渲染」这件事做成了产品。
但更重要的是它的三个「不是」:
- 它不采集数据。没有任何 Agent 进程跑在你的服务器上帮你抓指标;
- 它不存储数据。所有查询都是实时的、无状态的,问数据源要,要完就丢;
- 它不做计算持久化。每个面板每次刷新都重新执行一遍查询。
所以 Grafana 的本质 = 定时执行查询的调度器 + 渲染器。理解了这一点,后面很多设计决策都会变得自然。
1.2 四个核心概念
用这四个概念就能描述绝大多数 Grafana 使用场景:
| 概念 | 是什么 | 类比 |
|---|---|---|
| Data Source(数据源) | 数据的来源连接,声明「去哪查、用什么账号查」 | 数据库连接串 |
| Dashboard(仪表盘) | 一组面板的容器,通常对应一个系统或一个主题 | 一页 PPT |
| Panel(面板) | 最小可视化单元,绑定一种图表类型 + 一条查询 | PPT 里的一张图 |
| Query(查询) | 面板背后的取数逻辑,用什么语法由数据源决定 | SQL / PromQL / LogQL |
Panel 的类型和查询语言是解耦的:选了 PostgreSQL 数据源,Query 就是 SQL;选了 Prometheus,Query 就是 PromQL。图表类型(Stat、Timeseries、Barchart、Table......)只关心「查询返回的列长什么样」,不关心数据从哪来------这正是它能直连任意数据源的原因。
第五个值得认识的概念是变量(Templates) :在 Dashboard 层定义 $env、$agent 这样的下拉变量,面板 SQL 里直接引用,就能让一个仪表盘服务多套环境------比如顶部一个环境切换器,底下所有面板自动跟着过滤。CAS 目前是单机单环境还没用上,但多环境部署后这是第一个要补的能力。
1.3 数据源图谱:它远不止能连 Prometheus
Grafana 官方支持 100+ 数据源,常见的大致分三类:
- 时序数据库:Prometheus、InfluxDB------存的是「指标时间序列」,查询语言为指标而生;
- 日志/链路:Loki、Elasticsearch、Tempo------面向日志文本和分布式 Trace;
- 关系数据库:PostgreSQL、MySQL、SQL Server------就是你天天在写的业务库。
第三类是本文的主角。业务表里的每一行数据(订单、任务、调用日志)本质上都是带时间戳的事件,天然可以按时间窗口聚合出曲线。 这是很多人忽略的能力:监控不一定需要一套新的指标体系,你的业务表本身就是监控数据源。
1.4 五分钟跑起来 + 配置即代码
用 Docker 起一个 Grafana 只需要一条命令:
bash
docker run -d --name grafana -p 3000:3000 grafana/grafana:10.4.5如果部署在本地,打开 http://localhost:3000,登录,你就可以在 Web UI 里手动添加数据源、手动建面板了。但请立刻忘掉这种玩法------UI 上点出来的配置存在 Grafana 自己的数据库里,换个环境就要重新点一遍,无法进 Git、无法 Code Review、无法复现。
正确姿势是 Provisioning(配置自动装载):Grafana 启动时会扫描约定目录下的 YAML/JSON 文件,自动注册数据源、自动装载仪表盘。目录结构长这样:
grafana/
├── provisioning/
│   ├── datasources/postgres.yml    # 自动注册数据源
│   └── dashboards/dashboard.yml    # 声明从哪读仪表盘 JSON
└── dashboards/
    └── xxx-monitoring.json         # 仪表盘本体(面板都在这里)
三个文件各司其职:
datasources/postgres.yml ------ 告诉 Grafana「有个 PostgreSQL 数据源,名叫 cas-postgres」:
yaml
apiVersion: 1
datasources:
  - name: PostgreSQL
    uid: cas-postgres          # 固定 UID,面板 JSON 靠它引用数据源
    type: postgres
    access: proxy              # 由 Grafana 服务端代发查询
    url: host.docker.internal:5432
    database: cas_db
    user: postgres
    secureJsonData:
      password: "123456"       # 生产环境请用密钥管理,别学我
    jsonData:
      sslmode: disable
      postgresVersion: 1600
    readOnly: true             # 监控只查不写,最小权限
    editable: false            # 禁止在 UI 里改,以文件为准
provisioning/dashboards/dashboard.yml ------ 告诉 Grafana「去这个目录找仪表盘文件」:
yaml
apiVersion: 1
providers:
  - name: "My Monitoring"
    folder: "业务监控"
    type: file
    updateIntervalSeconds: 30   # 每 30s 检查文件变化
    options:
      path: /var/lib/grafana/dashboards
dashboards/xxx.json ------ 仪表盘本体。可以手工导出,也可以像 CAS 一样直接维护 JSON 进 Git,改配置 = 改文件 + 重启容器。
这套「配置即代码」的思路,和 Terraform、K8s manifest 是一脉相承的:基础设施的期望状态进版本库,环境重建时自动收敛。
1.5 写出第一个面板:认识两个宏
面板 Query 里最常用的是两个时间宏,Grafana 会按面板右上角选的时间范围自动替换:
$__timeFilter(created_at)→ 展开为created_at BETWEEN '...' AND '...',只取时间窗内的数据;$__timeGroup(created_at,'1h')→ 按小时分桶,时序图的 X 轴就靠它。
比如「每小时错误率趋势」:
sql
SELECT
  $__timeGroup(created_at,'1h') AS time,
  ROUND(100.0 * SUM(CASE WHEN error IS NOT NULL THEN 1 ELSE 0 END)
        / NULLIF(COUNT(*),0), 1) AS error_rate
FROM agent_logs
WHERE $__timeFilter(created_at)
GROUP BY 1 ORDER BY 1
到这里,Grafana 的通用知识已经够用了。还有最后一块拼图:面板的可视化选项 。同一条 SQL,选 Stat 就是大数字卡片,选 Timeseries 就是折线------除此之外还值得配三样东西:阈值(Thresholds) ,比如错误率超过 5% 曲线自动变红,问题一眼可见;单位(Unit) ,毫秒、百分比、字节数,选对了 Y 轴刻度才不会出现 1.2e+6 这种反人类刻度;图例(Legend)与悬浮提示(Tooltip),时序图多系列时全靠它们分辨「哪条线是谁」。这三个选项都在面板右侧的配置栏里,属于「花两分钟、颜值和可读性翻倍」的投入。
下面进入实战。
二、实战:给 CAS 多 Agent 系统接上监控
2.1 项目背景
CAS 是一个多 Agent 竞品分析系统:用户输入「分析飞书和钉钉的功能差异」这类任务后,Supervisor 调度 Collector(采集)、Analyzer(分析)、Writer(撰写)、Quality(质检)四个 Agent 协作完成一份竞品分析报告,底层是 LangGraph + DeepSeek + PostgreSQL。
它的监控痛点很典型:一次任务要跑 4 个 Agent、十几次 LLM 调用,挂了想定位「哪个 Agent 慢、哪个 Agent 错得多、这个月 token 花在哪」,只能翻表。
2.2 选型决策:为什么不上 Prometheus
标准答案是「Prometheus 抓指标 + Grafana 画图」,但我评估后发现这条路对 CAS 是负资产:
| 对比项 | Prometheus 路线 | Grafana 直连 PG |
|---|---|---|
| 新增组件 | Prometheus + Exporter + 抓取配置 | 零(Grafana 一个容器) |
| 埋点改造 | 每个 Agent 要暴露 /metrics 端点 |
零------业务日志早就写进 agent_logs 表 |
| 数据二次存储 | 指标要从 PG「搬运」到 TSDB | 不搬运,原地查 |
| 覆盖需求 | 基础设施指标(CPU/QPS) | 业务指标(成功率/耗时/Token/质检分),恰恰是 CAS 要的 |
关键事实是:CAS 的 agent_logs 表本来就记录每次 Agent 调用的 agent_name / action / duration_ms / error,它是安全护栏(HarnessGuard)审计层的副产品 ------不管请求放行还是拦截,都会写一条。数据一直在,只是没人「读」。另外我一开始也照惯例在 metrics.py 定义了 7 个 Prometheus 指标函数,结果没人去 scrape /metrics 端点,指标定义了等于白写------这也让我彻底想明白了采集式方案的前提:你得先有「采集端常驻」的架构承诺。
监控选型的分水岭其实不在「Grafana 还是 Prometheus」,而在**「数据此刻在哪」**:已经落库的,直连画图就行;没落库的,才需要埋点或采集器。基础指标(CPU/内存)将来要上 Prometheus 也随时可以补------Grafana 加一个数据源就行,两者不冲突。
2.3 数据链路
整体链路如下图:左半段「数据产生」是业务代码本来就有的,中间是 PostgreSQL 的四张表,右半段才是 Grafana 唯一负责的「读 + 画」。
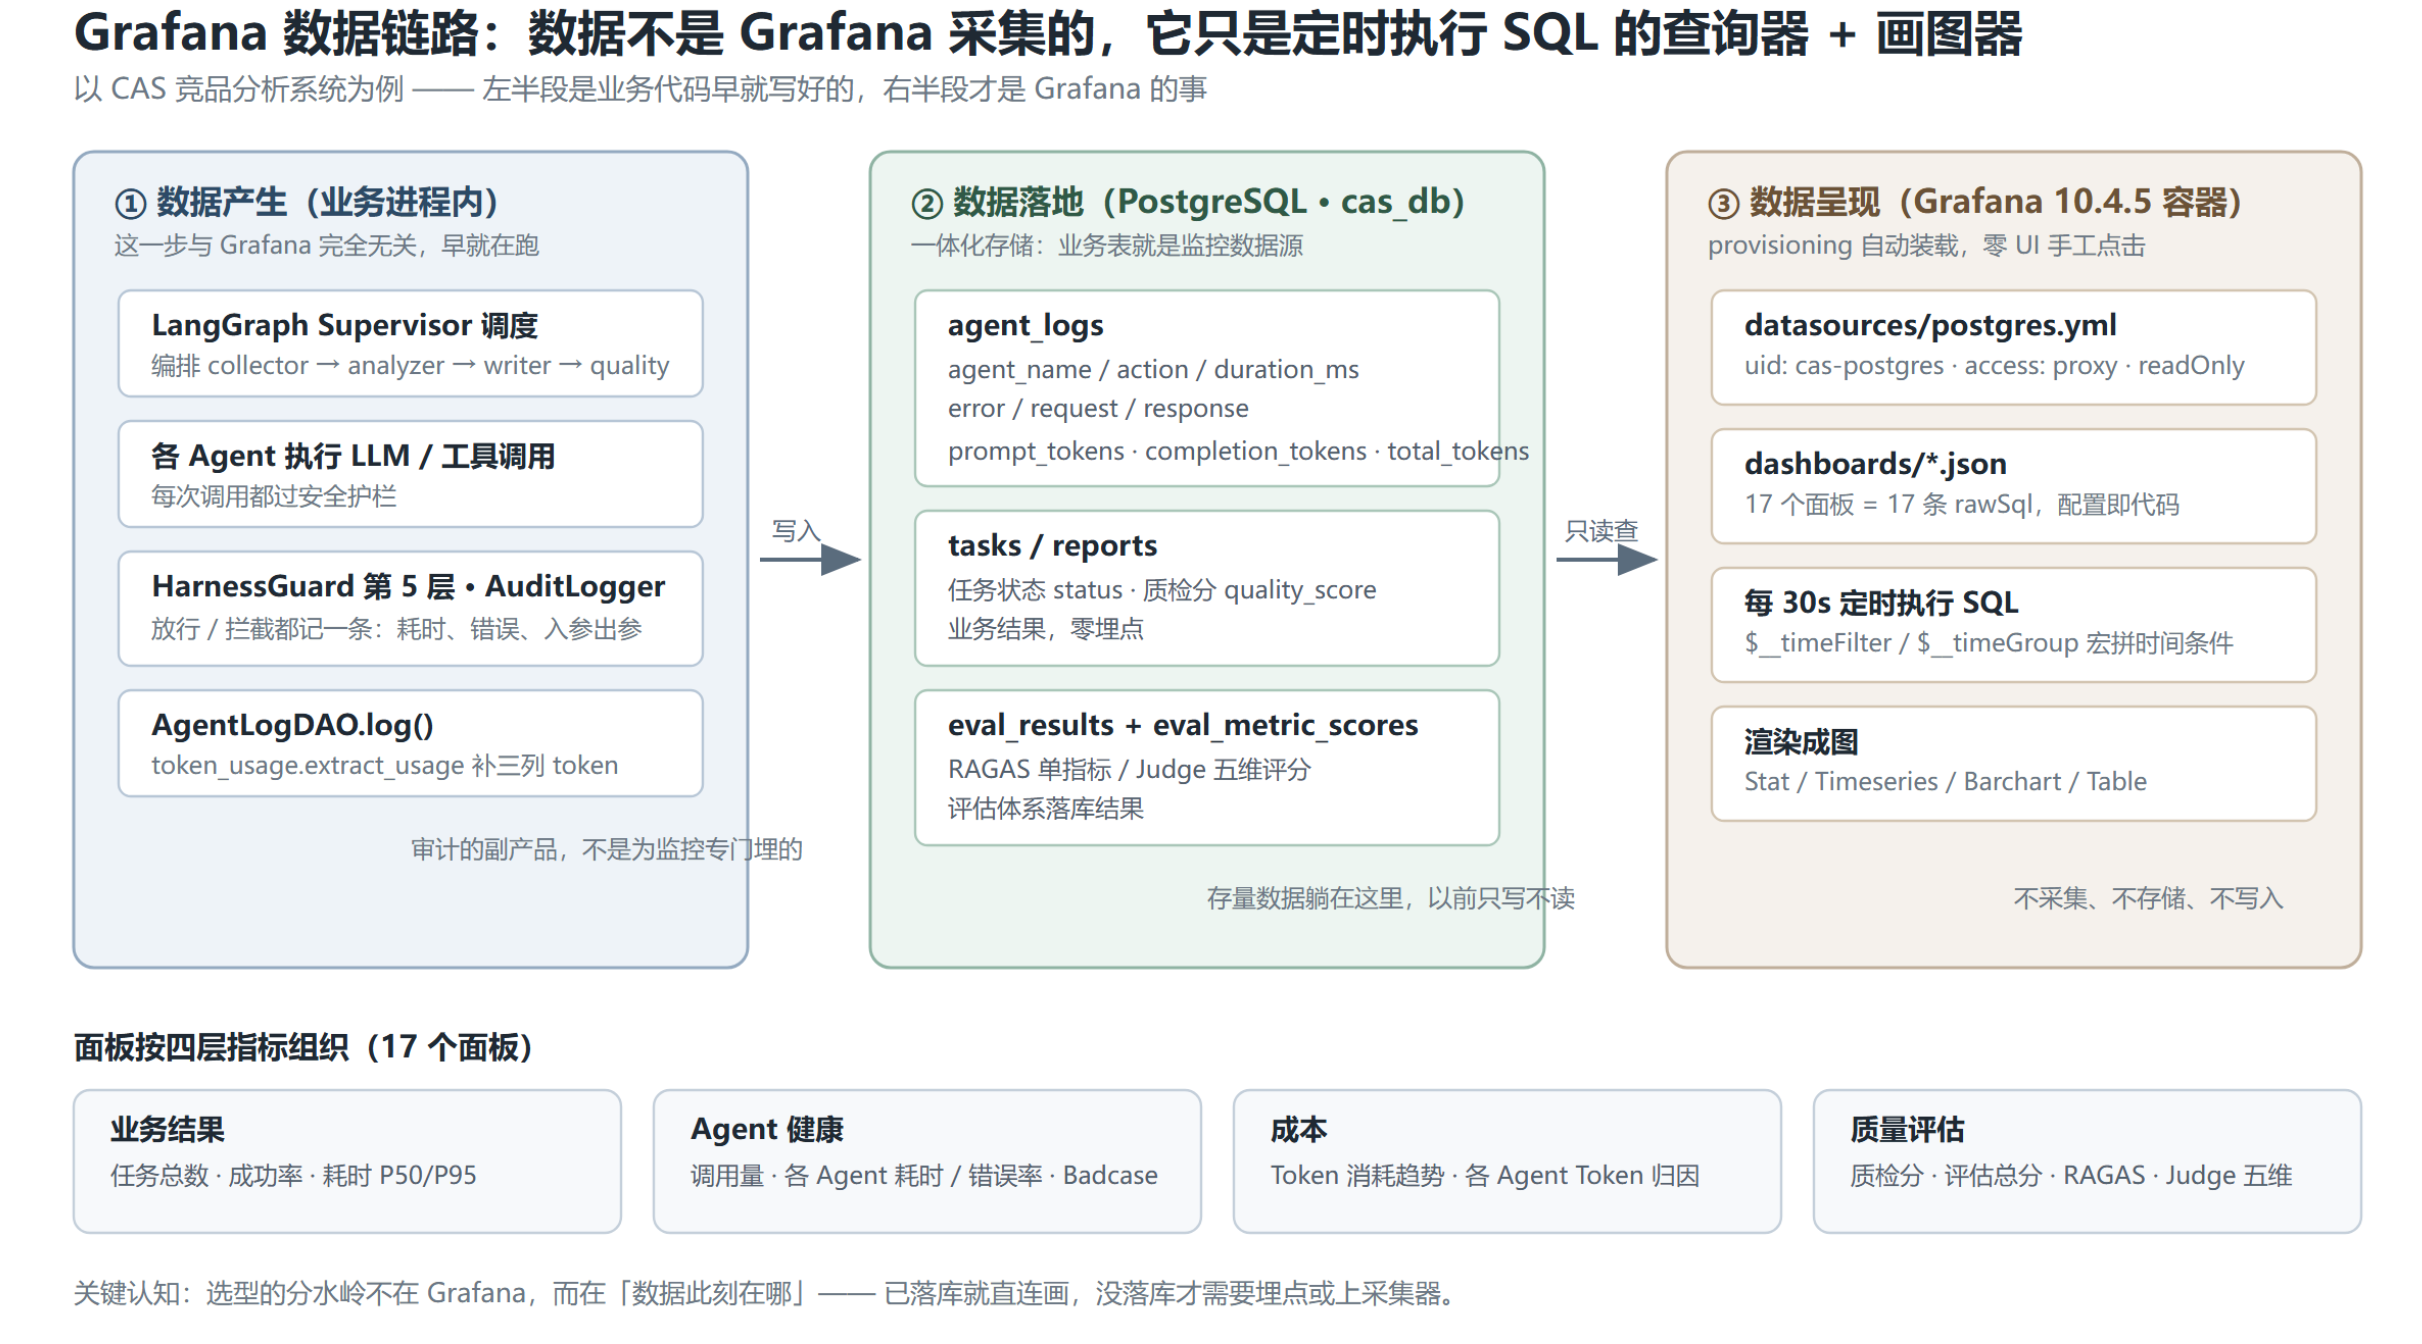
一句话总结:Grafana 每 30 秒对 agent_logs / tasks / reports / eval_results 跑一遍 SQL,把结果渲染成面板。
2.4 落地三件套:完整可复制的配置
① docker-compose.yml(Grafana 服务部分):
yaml
services:
  grafana:
    image: grafana/grafana:10.4.5
    container_name: cas-grafana
    restart: unless-stopped
    ports:
      - "127.0.0.1:3000:3000"    # 只绑回环,监控面板不暴露公网
    extra_hosts:
      # 关键:让容器内的 host.docker.internal 解析到宿主机
      - "host.docker.internal:host-gateway"
    environment:
      GF_SECURITY_ADMIN_USER: admin
      GF_SECURITY_ADMIN_PASSWORD: admin
      GF_USERS_ALLOW_SIGN_UP: "false"
      GF_AUTH_ANONYMOUS_ENABLED: "false"
    volumes:
      - grafana-data:/var/lib/grafana
      - ./grafana/provisioning:/etc/grafana/provisioning:ro
      - ./grafana/dashboards:/var/lib/grafana/dashboards:ro

volumes:
  grafana-data:
name: cas-grafana-data启动:docker compose up -d grafana,打开 http://127.0.0.1:3000,数据源和仪表盘已经自动就位------这就是 provisioning 的价值:环境的期望状态全部在文件里,docker compose up 一次收敛。
② 数据源与仪表盘的 yml:见 1.4 节,原样可用(本文的 PostgreSQL 数据源 yml 就是 CAS 仓库里的真实文件)。
③ 仪表盘 JSON :17 个面板全部定义在 competitive-analysis-monitoring.json 里,每个面板的核心就是一条 rawSql。
2.5 面板设计:四层指标
17 个面板按四层组织,这个分层思路比面板本身更值得带走------监控不是堆图,是从「结果 → 过程 → 成本 → 质量」逐层下钻:
| 层 | 面板 | 数据来源 |
|---|---|---|
| 业务结果 | 任务总数、成功率、耗时 P50/P95 | tasks、agent_logs |
| Agent 健康 | 调用量趋势、各 Agent 耗时/错误率、Badcase 列表 | agent_logs |
| 成本 | Token 消耗趋势、各 Agent Token 归因 | agent_logs 的 token 三列 |
| 质量评估 | 质检分趋势、RAGAS 单指标、Judge 五维评分 | reports、eval_metric_scores |
日常使用时的下钻路径也顺着这个分层走:先看顶部成功率有没有异动 → 异常了再看「各 Agent 错误率」定位是哪一环 → 再下钻到 Badcase 表格看具体报错。监控面板的价值不在「好看」,而在把一次排障从「翻日志大海捞针」压缩成「三层点击」。
挑三条有代表性的 SQL(完整 17 条见文末仓库链接):
成功率(Stat 卡)------只统计已终态的任务,避免「跑一半的任务」拉低分母:
sql
SELECT ROUND(100.0 * SUM(CASE WHEN status='completed' THEN 1 ELSE 0 END)
       / NULLIF(COUNT(*),0), 1) AS value
FROM tasks WHERE status IN ('completed','failed')
耗时分位数(Timeseries) ------PG 原生 percentile_cont 算 P50/P95,比平均值更能暴露长尾:
sql
SELECT $__timeGroup(created_at,'1h') AS time,
       percentile_cont(0.50) WITHIN GROUP (ORDER BY duration_ms) AS p50,
       percentile_cont(0.95) WITHIN GROUP (ORDER BY duration_ms) AS p95
FROM agent_logs
WHERE duration_ms IS NOT NULL AND $__timeFilter(created_at)
GROUP BY 1 ORDER BY 1
RAGAS 单指标趋势 ------评估结果落库在 eval_metric_scores,join 一下就能画质量曲线:
sql
SELECT $__timeGroup(m.created_at,'1d') AS time,
       m.metric_name AS metric, ROUND(AVG(m.score)::numeric,3) AS value
FROM eval_metric_scores m
JOIN eval_results e ON m.eval_id = e.id
WHERE m.metric_name IN ('faithfulness','context_precision','answer_relevancy')
  AND $__timeFilter(m.created_at)
GROUP BY 1,2 ORDER BY 1
2.6 数据从哪来:零埋点与半埋点
四层指标里有一个有意思的对比,它解释了「可观测性不是事后补的」:
- 质检分是零埋点的 ------Quality Agent 每次评分本来就写
reports表,我只需要「加个面板」; - Token 是半埋点的 ------
agent_logs原本只有耗时和错误,token 数以前随llm.ainvoke()的返回值被丢掉了。所以补了三列(prompt_tokens / completion_tokens / total_tokens),在 5 个 LLM 调用点用统一的extract_usage()从usage_metadata提取后随日志写入。
做法上有个小设计值得提:extract_usage() 做统一容错和字段映射(DeepSeek 返回 input_tokens,OpenAI 风格是 prompt_tokens),total_tokens 缺失时回退为输入+输出之和,保证调用方拿到的永远是「可以无脑累加的整数」。先看数据在哪落地:落地了就画图,没落地就补埋点------顺序反了就会为监控而监控。
2.7 配置里的三个细节(都是踩出来的)
localhost连不上数据库 :Grafana 在容器里,localhost指它自己。要连宿主机上映射的 PG,得写host.docker.internal,并在 compose 里加extra_hosts: host-gateway;部署到服务器时若 PG 也是 compose 起的,直接写服务名postgres:5432走内部网络更干净------同一个数据源文件,本地和服务器各写一份连接地址。- 改 admin 密码,环境变量不生效 :
GF_SECURITY_ADMIN_PASSWORD只在数据目录首次初始化时读取,volume 建好之后再改环境变量是无效的,必须进容器执行grafana-cli admin reset-admin-password。 - 改了 JSON 不热更新 :provisioning 装载的仪表盘以文件为准,改完要
docker restart容器重新装载(或直接在 UI 改,但会被文件覆盖)。
2.8 效果
最终仪表盘顶部是四张 Stat 卡(任务总数 / 成功率 / 调用量 / 错误率),中部时序图看趋势,底部表格直接列出最近的 Badcase------点开 error 字段就能回到具体哪次调用出了问题。仪表盘默认时间范围 now-30d、30 秒自动刷新,无需任何人工操作。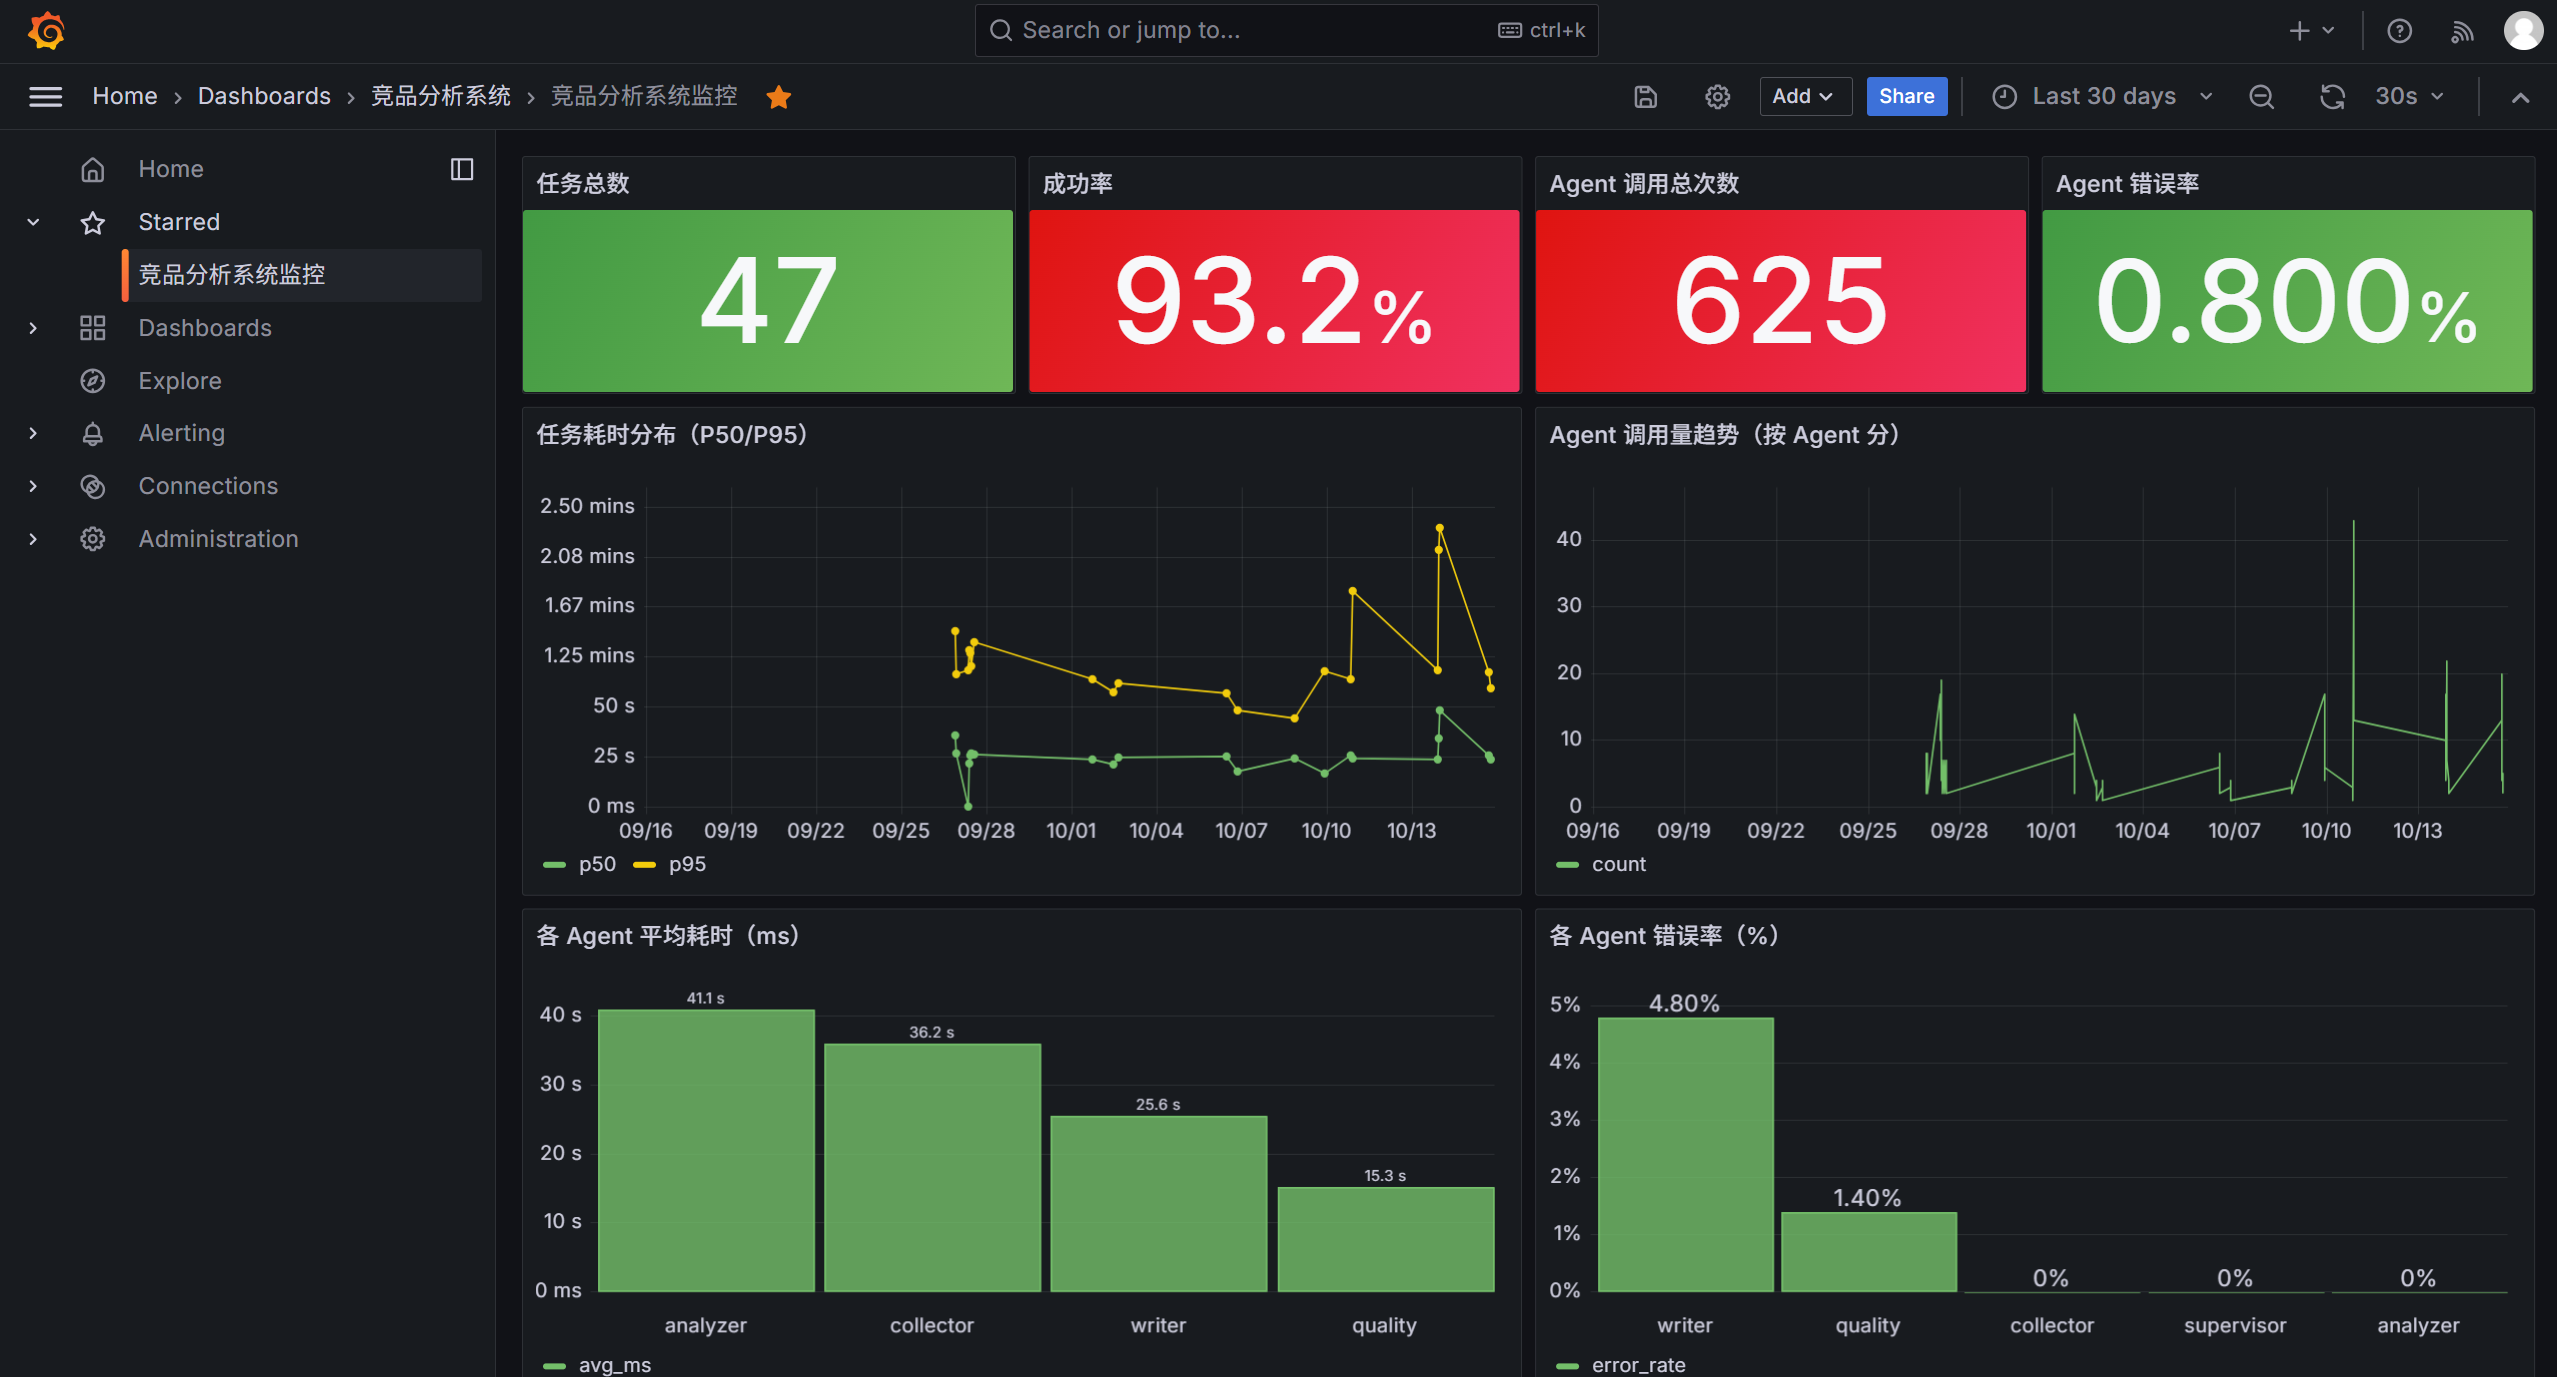
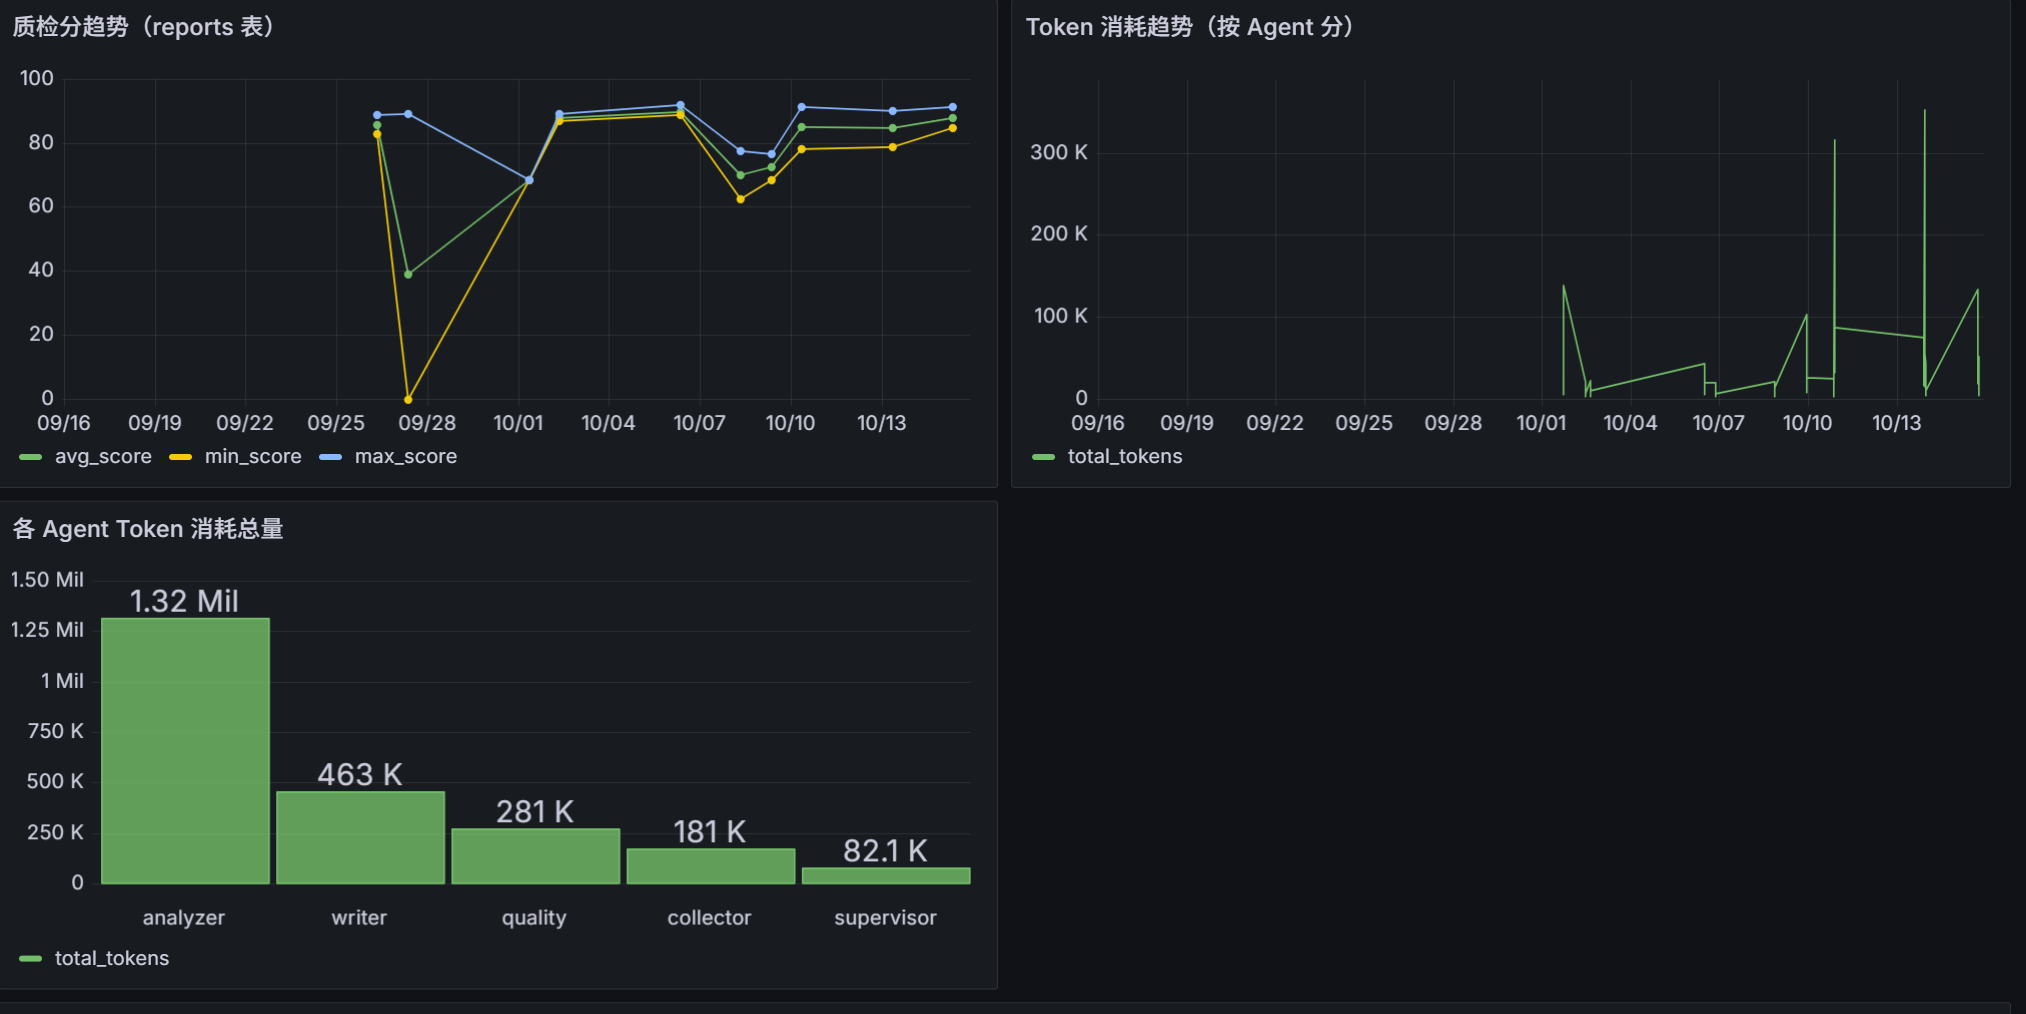
从「想看系统状态」到「打开浏览器一个标签页」,这套监控把系统的运行状态变成了一份随时可看的活文档------而且它的每一像素都对应着一条你能读懂的 SQL,没有任何黑盒。
三、什么时候才轮到 Prometheus 上场
直连业务库不是银弹,它的边界很清晰:
- 高频采集撑不住:SQL 聚合是对业务库的真实查询,QPS 高、面板多时会给数据库压力;Prometheus 的 TSDB 就是为高频写入+降采样设计的;
- 不适合基础设施指标:CPU、内存、网络这类数据本来就不在业务表里,需要 node_exporter;
- 告警语义不同:PromQL 算「5 分钟内错误率 > 1%」很自然,SQL 也能写但表达成本高。
我的建议是分层演进:业务监控(低频、已有落库数据)→ Grafana 直连数据库起步;基础设施指标和告警体系成熟了 → 再补 Prometheus,Grafana 同时挂两个数据源。 CAS 现在的单机场景,前者就够了。
总结
回顾这篇的三个核心认知:
- Grafana 不采集、不存储任何数据,它只是「定时执行查询 + 渲染」的可视化引擎,数据源决定了查询语言;
- 业务表天然是监控数据源------带时间戳的业务数据按窗口聚合就是曲线,选型的分水岭在「数据此刻在哪」;
- 配置即代码:provisioning 让数据源、仪表盘全部进 Git,环境可重建、变更有记录。
如果你也想动手,最小路径是:docker run 起 Grafana → 写一个 datasource yml 连上你手头任意一个 MySQL/PG → 用 $__timeFilter 写一条聚合 SQL 出第一张时序图。相信我,看到自己业务表的数据变成曲线的那一刻,你会开始用新的眼光审视自己的表结构设计。
本文实战部分基于我的开源项目 CAS(多 Agent 竞品分析系统),完整配置见仓库 docker/grafana/ 目录;配图源文件与 17 个面板的完整 SQL 均在仓库中。