前言
大家好,这里是程序员阿亮!
今天想到一个很有意思的问题,为什么在InnoDB里面不用跳表,为什么Redis里面不用B+树
"跳表实现简单,查询效率也是O(logN),MySQL 为什么不用跳表做索引?"
"反过来,B+树那么强大成熟,Redis 在实现有序集合(Zset)时,又凭什么弃用 B+树而选择跳表?"****
初听起来,它们都在做同一件事------高效地存储有序数据,并支持快速单点查找与范围查询。
但如果脱离了硬件存储介质去谈算法,结论往往会南辕北辙。今天我们就来彻底扒开 MySQL 和 Redis 的底裤,看看它们是如何根据"磁盘"与"内存"量体裁衣的。
01 第一回合:为什么 MySQL(InnoDB)死磕 B+树?
一句话先定调:InnoDB 选择 B+树,核心是为了"讨好"慢吞吞的磁盘。
在计算机世界里,CPU 访问 L1 缓存只要 1 纳秒,访问内存大概需要几十到上百纳秒;而访问传统的机械磁盘甚至需要 10 毫秒(SSD 随机寻址也要数十微秒)------内存和磁盘之间存在着数个数量级的鸿沟。
因此,关系型数据库索引设计的首要纲领,就是:千方百计减少磁盘 I/O 次数。
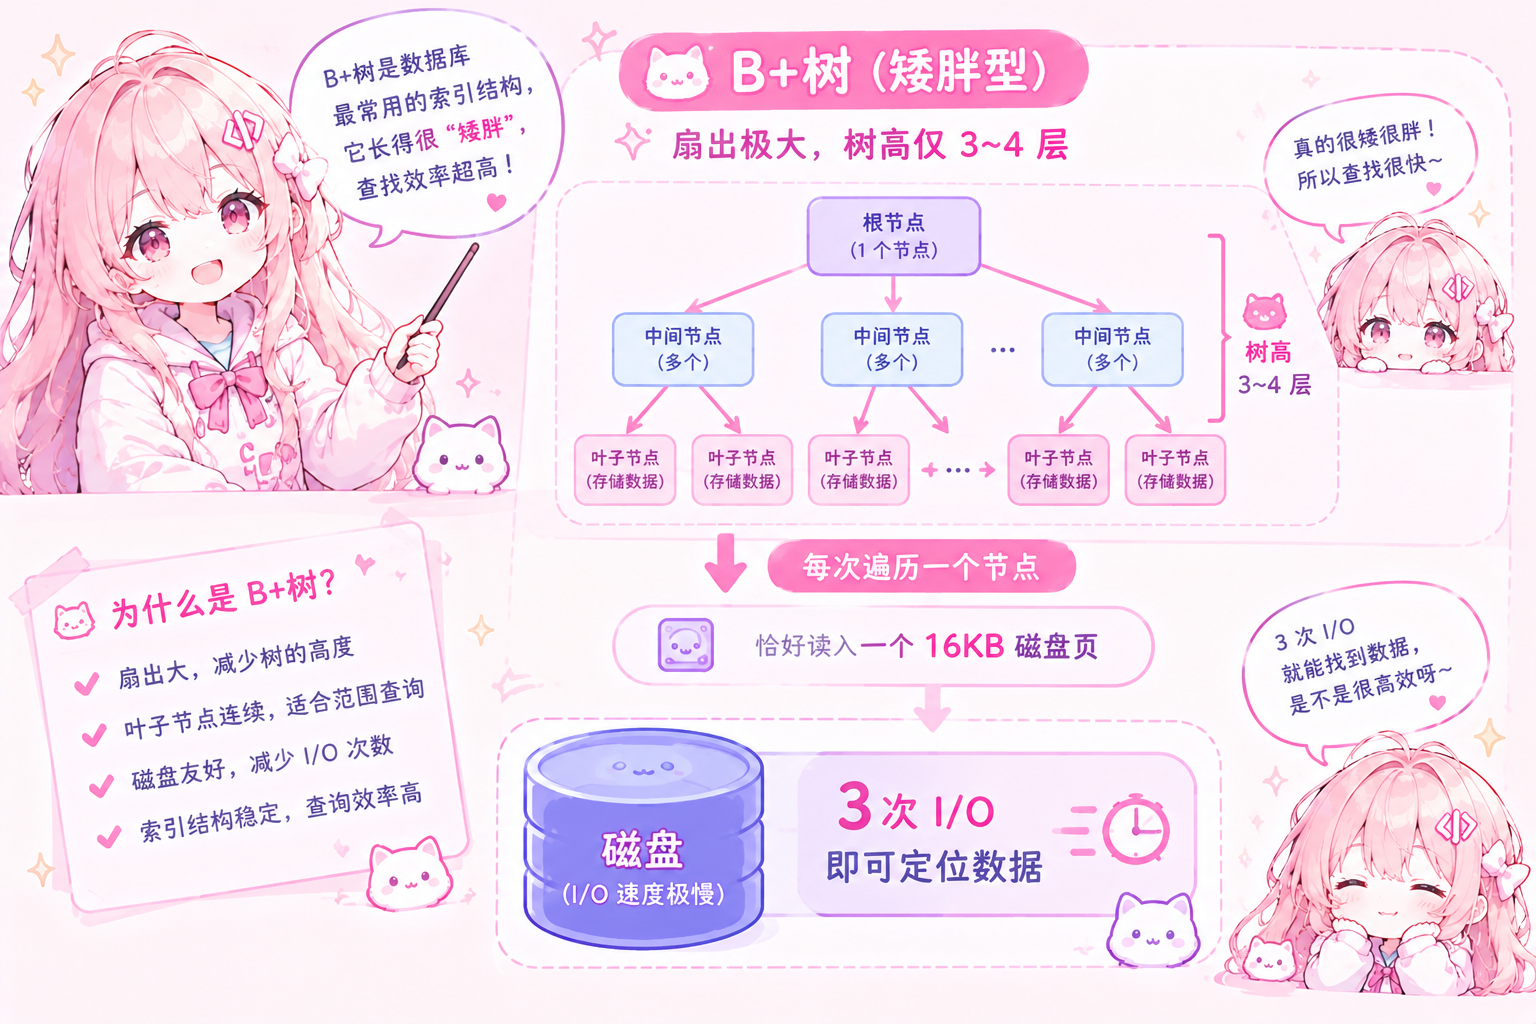
1. 极高的"扇出(Fan-out)"与极矮的树高
B+树非叶子节点只存索引键(Key)和指针,不存具体的业务数据(Data) 。
在 InnoDB 中,一个页(Page)的默认大小是 16KB。假设一个主键 ID 占 8 字节,指针占 6 字节,那么一个 16KB 的索引节点就能塞下超过 1000 个分叉!
-
第一层(根节点):1 个节点,索引 1000 个子节点;
-
第二层:1000 个节点,索引1000×1000=100万个叶子节点;
-
第三层(叶子节点):假设每行数据 1KB,能存100万×16≈1600万∼2000万条记录。
这就是著名的"单表 2000 万数据"分水岭。
在如此庞大的数据量下,B+树的高度仅仅只有 3 层!在冷数据全在磁盘的情况下,仅需 3 次磁盘 I/O 就能精准定位目标行。
2. 天然契合操作系统的"磁盘预读与页对齐"
操作系统和磁盘控制器在读取数据时,不是按字节读的,而是按"块(Block)/页(Page)"整块预读的(空间局部性原理)。
InnoDB 的页大小(16KB)与操作系统的 I/O 块天然对齐。B+树一次载入一个节点,正好就是读取一个物理页,把磁盘预读机制榨干到了极致。
3. 叶子节点双向链表,范围扫描(Range Query)极其残暴
当你在 MySQL 里执行 WHERE age BETWEEN 18 AND 30 时:
B+树只需要通过根节点走 3 次 I/O 定位到 age = 18 的那个叶子节点,随后直接沿着叶子节点之间的双向链表横向顺序读盘即可。由于叶子页在物理上往往是连续或局部聚簇的,磁盘顺序读的吞吐量比随机寻道高几个数量级。
02 致命设想:如果让 InnoDB 换成跳表会怎样?
有人说:"跳表的平均查找复杂度也是O(logN)啊,为什么 MySQL 不用?"
我们来看看跳表的底层结构:它是一条多层的有序链表,上层索引节点通过指针指向下层。
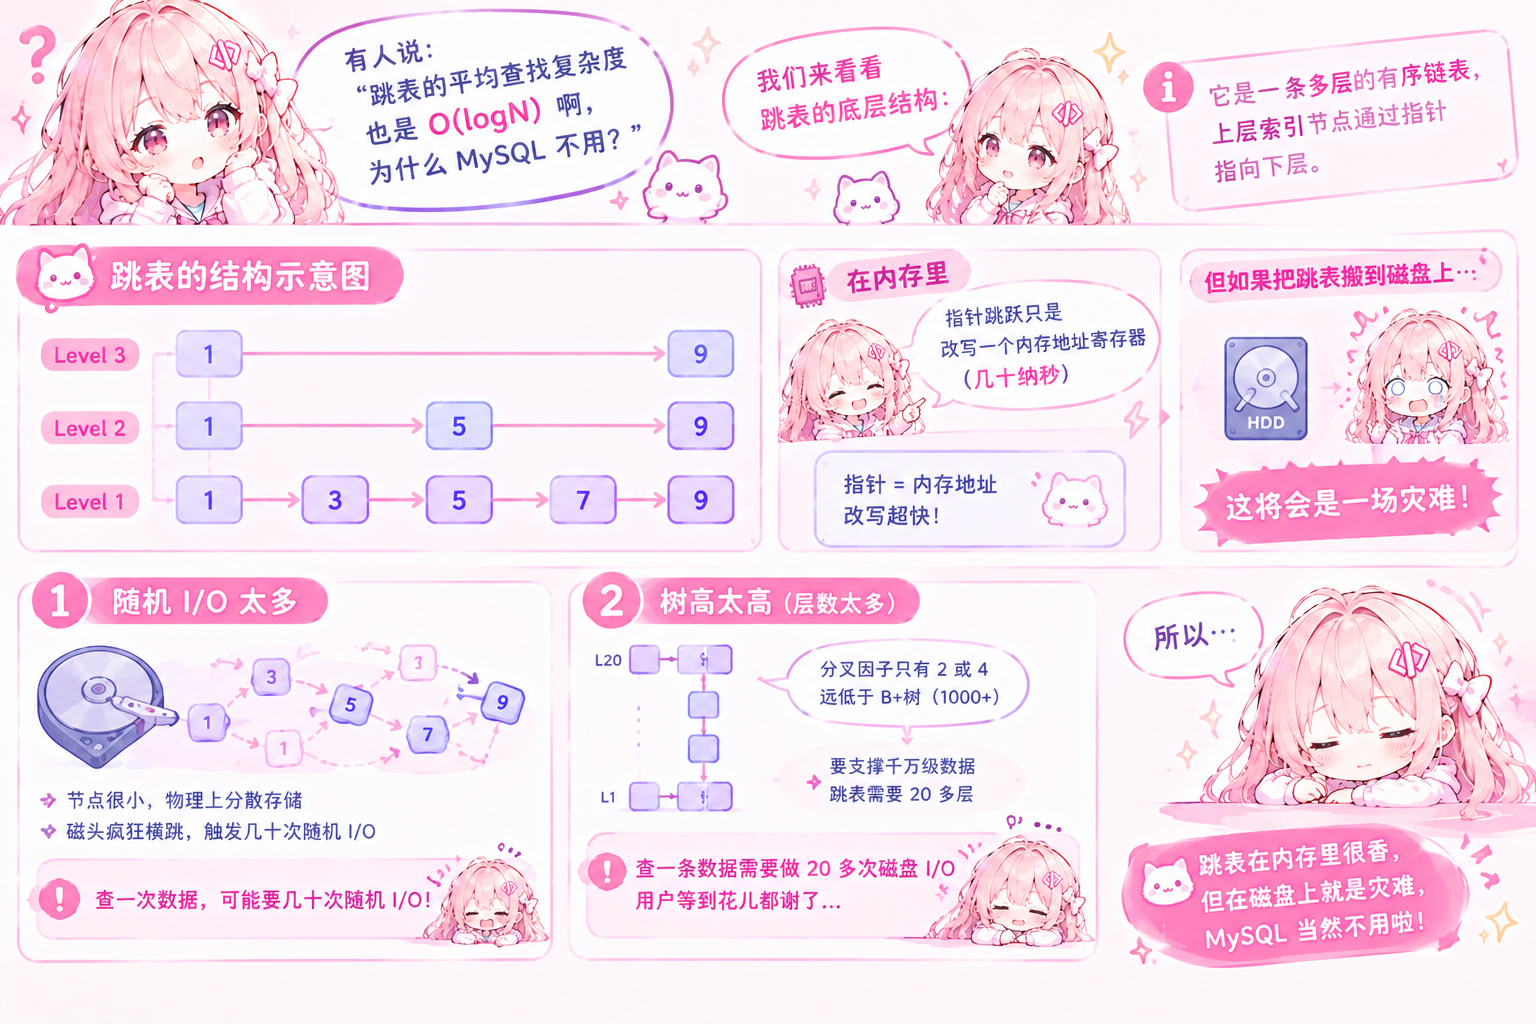
在内存里,指针跳跃只是轻飘飘地改写一个内存地址寄存器(几十纳秒)。
但如果把跳表搬到磁盘上,这将会是一场灾难:
-
散落各地的随机 I/O(Random Seek):跳表的节点非常小,且在物理磁盘上是分散存储的。沿着跳表指针找数据,相当于磁头在磁盘的盘片上疯狂横跳。查找一次数据可能要触发几十次随机 I/O,数据库性能当场跌入谷底。
-
极其感人的树高(层数) :跳表的分叉因子(通常是 2 或 4)远远低于 B+树(1000+)。要支撑千万级的数据,跳表需要跳跃二十多层。查一条数据需要做二十多次磁盘 I/O,用户等到花儿都谢了。
03 第二回合:为什么 Redis(Zset)对 B+树说"不"?
好了,既然 B+树这么优秀,为什么内存数据库王者 Redis 在实现核心的 Zset(有序集合) 时,没有选用 B+树,而是坚定地选择了跳表(SkipList + HashTable)?
答案反转了:因为在纯内存的世界里,磁盘 I/O 这个最大的矛盾凭空消失了!
当数据完全常驻内存时,内存寻址耗时极短,树高带来的几次内存指针跳转微不足道。此时软件工程的考量重心变成了:代码复杂度、内存开销与写入性能。
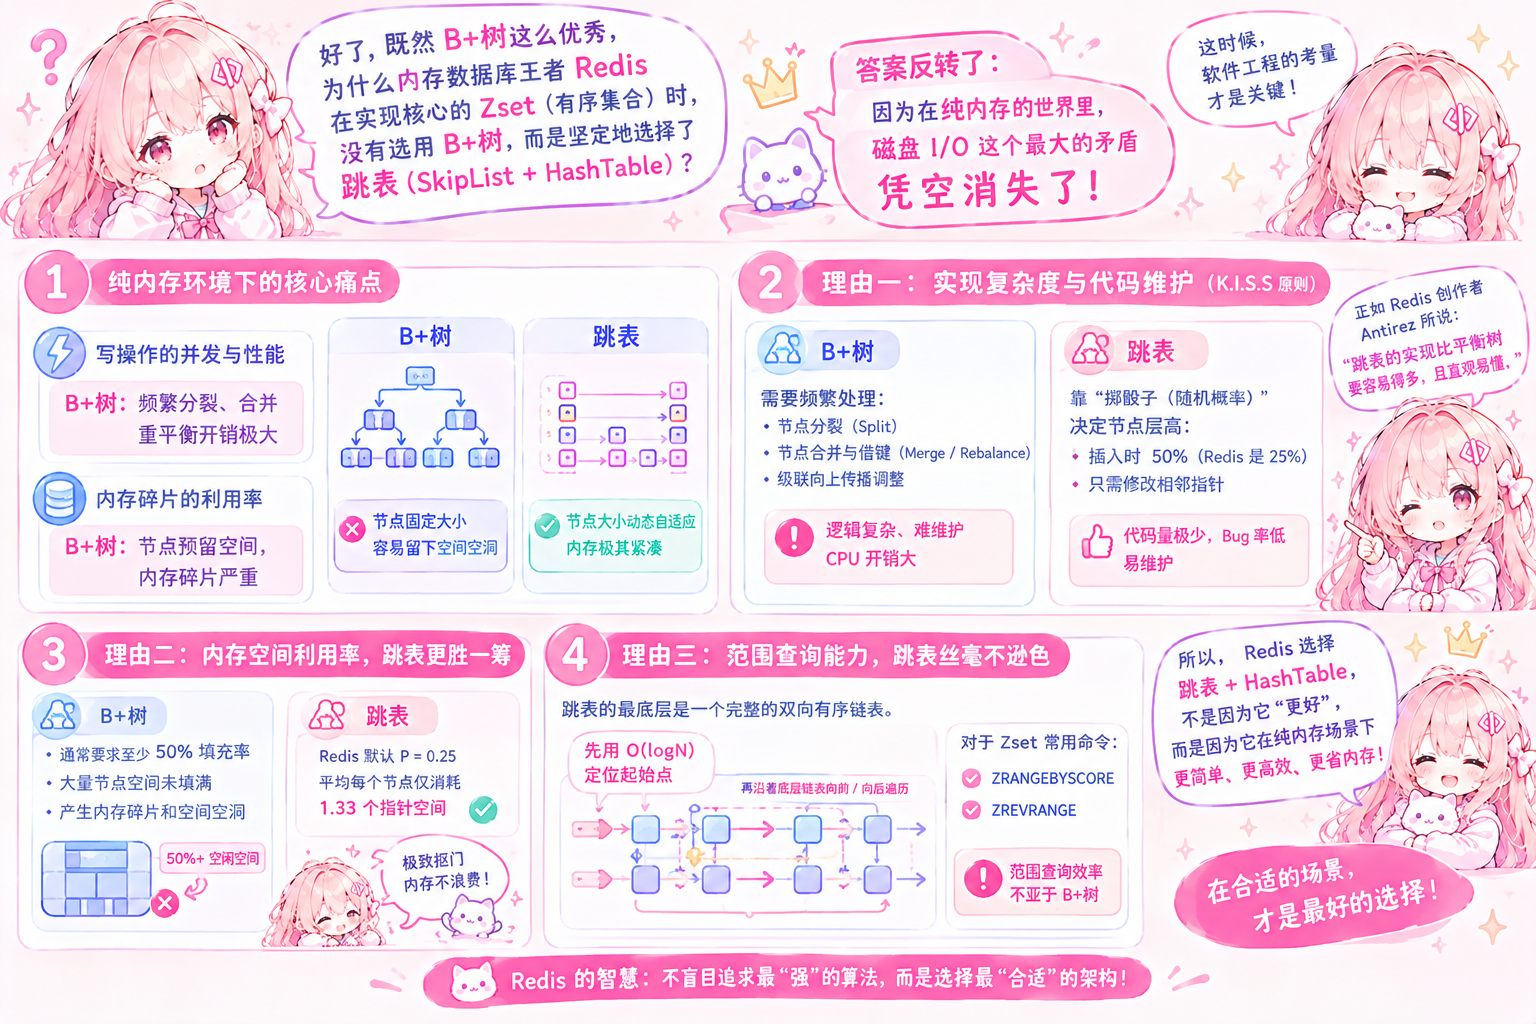
理由一:实现复杂度与代码维护(K.I.S.S 原则)
B+树为了维持绝对的平衡,算法实现极为复杂。遇到高频插入和删除时,需要频繁处理:
-
节点分裂(Split)
-
节点合并与借键(Merge / Rebalance)
-
级联向上传播调整
在纯内存操作的高吞吐场景下,这些重平衡操作不仅 CPU 开销巨大,而且逻辑复杂极难维护。
而跳表的维护哲学极其轻量优雅------靠"掷骰子(随机概率)"来决定节点层高:
-
插入一个新节点时,随机抛一枚硬币:有 50%(Redis 中是 25%)的概率长出一层索引。
-
它不需要全局平衡,插入和删除只需修改目标节点前后的几个指针,代码量极少,Bug 率极低。正如 Redis 创作者 Antirez 亲口所说:"跳表的实现比平衡树要容易得多,且直观易懂。"
理由二:内存空间利用率,跳表更胜一筹
在磁盘里,我们喜欢"页(16KB)";但在内存里,大块固定内存意味着巨大的浪费。
-
B+树为了防止频繁分裂,每个节点通常要求至少 50% 填充率(Page Fill Factor)。这意味着大量节点的空间是空闲未填满的,在昂贵的内存中留下了大量内存碎片和空间空洞。
-
Redis 的跳表则非常抠门:每一个节点需要多少层指针,全凭随机概率生成(默认概率因子P=0.25)。根据概率学计算,平均每个跳表节点仅仅消耗 1.33 个指针空间!内存浪费被压缩到了极限。
理由三:范围查询能力,跳表丝毫不逊色
跳表的最底层也是一个完整的双向有序链表。
对于 Zset 常用的命令(如 ZRANGEBYSCORE、ZREVRANGE),跳表先用O(logN)
定位到范围起始点,然后顺着底层链表向前或向后一滑到底,范围遍历的效率完全不亚于 B+树。
04 终极对决:全维度深度对比表
我们将两者放在同一张战力榜上进行对比:
|---------------|-------------------------|-------------------------|------------------------|
| 评估维度 | B+ 树 (B+ Tree) | 跳表 (SkipList) | 优胜者与原因 |
| 主战场介质 | 磁盘 / SSD | 纯内存 (RAM) | 各有所长 |
| 分叉因子 / 树高 | 扇出极大(1000+),高度极矮(3~4层) | 分叉极少(2~4),高度较深(十几层) | B+树胜:极大降低读盘 I/O 次数 |
| 插入/删除开销 | 极高(涉及复杂的节点分裂、旋转与合并) | 极低(仅更新局部相邻指针,无需重平衡) | 跳表胜:写入响应更快,无重构锁负担 |
| 内存碎片率 | 较高(节点按整页预留空间,常有半满情况) | 极低(节点按需分配,平均仅 1.33 个指针) | 跳表胜:在内存昂贵时更精打细算 |
| 范围查询能力 | 优秀(底层叶子节点双向链表横向扫) | 优秀(底层节点单/双向链表横向扫) | 平手:二者均能秒级顺着链表滑动 |
| 算法实现复杂度 | 极其复杂,几千行代码,边界繁杂 | 优雅简洁,几百行代码搞定,易于排障 | 跳表胜:符合工业软件的极简哲学 |
总结
软件工程中从来没有"最好"的数据结构,只有"最合适"的场景权衡(Trade-off)。
MySQL InnoDB 的世界,被"磁盘 I/O"主宰。哪怕算法再复杂、实现再痛苦,只要能把磁盘寻道次数从 20 次压到 3 次,B+树就是无可替代的神;
Redis 的世界,被"极致内存利用与极简"主宰。当内存抹平了一切 I/O 延迟后,跳表凭借其极低的实现门槛、精简的内存开销和无锁负担的指针微调,逆袭成了内存数据库的最优解。