上一篇结尾我留了三个问题:
- 凭什么敢把消息一直留在磁盘上?
- 追加写入的 Log 凭什么比想象中快得多?
- 这个「Log」到底是个什么东西------数据库里有它,文件系统里有它,Kafka 里又有它?
这一篇主要回答第三个问题。第三个问题答完,前两个问题也能得到一半答案:快,是因为 Log 的写路径从头到尾只有顺序追加,这一半放在本篇说;另一半(Page Cache 与 Zero Copy)和「凭什么敢留」(retention 怎么删)分别在后面存储引擎部分展开。所以本篇的任务就一个:把 Log 这个抽象本身搞清楚。
- 为什么数据库、文件系统、消息系统这些看起来八竿子打不着的系统,最后都长出了一个叫「Log」的东西?
- 把一切抽象成 Log,到底买到了什么?
- Log 与 Queue 的根本区别在哪?
先排除一个误会:此 Log 非彼 log
第一次读 Kafka 文档的人多半会在这里愣一下:消息存在「日志」里?Kafka 是个存日志文件的系统吗?
不是。Kafka 说的 Log 不是运行日志(application log,程序跑起来打的那些行),而是一种数据结构。Jay Kreps------Kafka 三位作者之一------2013 年写过一篇著名的长文《The Log: What Every Software Engineer Should Know About Real-Time Data's Unifying Abstract》,后来又扩展成了一本小书《I ❤ Logs》。本篇标题「Everything Is A Log」正是化用这篇文章的核心主张。他对 Log 的定义大意是(转述,非原文):一个只能向末尾追加、按写入先后全序排列的记录序列------这大概是最简单的存储抽象。
拆开来说,这个抽象有三个要点:
- append-only:只能往末尾追加,不能改写中间的内容,也不能从中间删除;
- 全序:谁在前面谁在后面,由写入顺序唯一决定,每条记录在序列中的位置就是它的地址(数据库里叫 LSN,Kafka 里叫 Offset);
- 不可变:写进去就是历史事实,不存在「更新一条旧记录」这个动作。
Queue 也能排队,为什么不算 Log?因为 Queue 的语义是「取走」:消息被确认后就离开了。Log 的语义是「堆积」:记录只进不出(直到被成段清理)。一字之差,后面会看到整个系统的形态都因此不同。
Log 的三处现身
带着这个定义,去看三个不相干的系统。
数据库里:先写日志,再动数据
InnoDB 更新一行的流程里有个绕不开的角色:redo log。修改数据页之前,先把「做了什么改动」顺序写到 redo log 里,然后才慢慢把 B+ 树上的数据页改掉、刷盘。这就是所谓的 WAL------Write-Ahead Log,PostgreSQL 干脆直接用这个词称呼自己的日志。名字把协议都念出来了:先写日志。
为什么要多此一举?因为数据页在磁盘上是随机分布的,就地更新意味着随机写;而日志是纯追加的,顺序写。先花很小的代价把变更固化在顺序介质上,真正的数据页慢慢落盘也不怕------崩溃之后从日志里重放一遍,就能把没来得及落盘的修改补回来。Log 在数据库里是崩溃恢复的依据。
文件系统里:Journal
ext3/ext4 的 journal 是同一个套路:元数据的变更先记入日志区,再去改真实的数据结构;掉电之后,要么把日志里没做完的操作重放完,要么把没提交的丢弃,总之文件系统能恢复到一致状态。Windows 的 NTFS、各种分布式文件系统,也都有各自的 journal。
Kafka 里:Log 就是数据本身
到了 Kafka 这儿,情况变了。数据库和文件系统里,Log 是手段 :真正的数据在别处(B+ 树的页、inode),日志只是帮它们安全落盘的脚手架,checkpoint 之后旧日志就可以覆盖循环使用了。而 Kafka 把手段变成了本体:Producer 发来的消息写进 Log,这就是它的最终形态,没有第二步「落到某个查询结构里」的转换。消息在 Log 上躺多久,由 retention 决定,跟有没有人消费过无关。
同一个抽象为什么反复出现
三个系统,三种用法,但抽象出来同一个东西。我的理解是,Log 这个抽象打包了三个别的结构很难同时给出的性质:
- 写得快:追加写是顺序写,不挑介质,磁盘、SSD 都能跑出接近满带宽的吞吐;
- 天然有序:写入顺序就是全序,每条记录有唯一地址,恢复、复制、排序都以它为准;
- 可回放:只要记录还在,从任意位置重读一遍就能重建状态------数据库的崩溃恢复靠的正是这个性质。
数据库主要要前两条(顺带用第三条做恢复),文件系统要后两条,Kafka 则是三条全要------尤其第三条,对它来说不是恢复机制,是产品需求本身:回放、补数、多下游各自消费,全部建立在「历史还在」这一基石上。
Log 如何解决重放问题:挪游标,不是搬数据
现在可以正面回答上一篇的核心痛点:RabbitMQ 里消息确认后就没了,想重跑一遍昨天的数据做不到。
在 Queue 的世界里,消费 = 把消息搬走。消息属于投递过程,交付完成,生命周期结束。所以重放无从谈起------不是 Queue 做不到「再发一遍」(重发是可以的),而是不存在一份「过去」可供重读。
在 Log 的世界里,消费 = 读数据 + 移动游标。数据本体原地不动。想重新来一遍,把游标拨回去;想给新系统喂历史数据,给它一条从 0 开始的新游标。上一篇实验里 --reset-offsets --to-earliest 让计费系统重算了一遍全部订单,背后的动作只是把 billing 这个 Group 的游标拨回最早处------两条消息一个字节都没动过。这一篇末尾的实验里我们会再从文件层面确认一次这件事。
这也解释了上一篇的另一个现象:多个 Consumer Group 消费同一个 Topic 互不干扰,不是 Kafka 额外实现的功能,而是 Log 语义的自然推论。数据只有一份、不动,各 Group 拿各自的游标读,互不干扰是必然的。RabbitMQ 想做到同样的事,得为每个下游复制一份数据到各自的 Queue------因为它的消息被取走就没了,不复制就没得读。
Log 与 Queue 的根本区别
上一篇讲的是两者在行为上的差异(消费即删 vs 保留)与选型判据;这里我们来探讨一些更深层次的差异------结构。
结构上,二者之间主要有三条区别:
| Queue | Log | |
|---|---|---|
| 数据所有权 | 消息属于投递过程,确认后即删除 | 数据属于历史,写完即独立存在,与消费无关 |
| 消费者间关系 | 不同消费者要各自一份拷贝(扇出靠复制) | 所有 Consumer Group 共享一份数据,各自持有独立游标 |
| 时间维度 | 面向当下:只有「在途、未确认」的消息有意义 | 面向历史:任意时点可定位、可回溯 |
- 第一条规定了数据模型:Queue 的消息是投递中的包裹,Log 的记录是不可变的事实。
- 第二条规定了扇出方式:Queue 的多下游 = 多份拷贝,Log 的多下游 = 多条游标。
- 第三条最重要:Queue 只回答「现在有什么待处理」,Log 是一部编年史,只要记录还在,「第 1000 条是什么」就有答案。
Consumer Group 组内的关系要单独说一句免得误会:同一个 Group 内部,一个 Partition 同一时刻只归一个 Consumer 消费,组内是竞争的------这一点像 Queue。但组间是彻底独立的。组内怎么分、成员变动怎么办,是第五部分的大戏,这里按下不表。
再看 LinkedIn 的问题
上一篇讲的 LinkedIn 痛点------多下游扇出、消费速率悬殊、需要回放------现在可以用一句话重新表述:
生产者只管往 Log 里追加事实;每个下游各自持一条游标,从哪里读、读多快、要不要拨回去重读,全是消费者自己的事。
生产侧与消费侧由此彻底解耦:Hadoop 凌晨批量拉一天的数据,搜索引擎秒级跟进,互不干扰;数仓 job 跑挂了拨回游标重跑;新系统上线从 Offset 0 开始暖机。Kafka 作为「数据总线」的本质,就是公司里所有事件汇聚成若干条 Log,谁需要谁来读。
打开源码看一眼:一个 Log 长什么样
讲了这么多抽象,落到代码里,Kafka 的 Log 长什么样?先说明:本节只建立一些直观的认识,只了解类的骨架和一次写入的路径,segment 内部的文件格式、索引、保留与清理等,全部留给后面的专篇。
注:这一系列文章的源码均参考自 Kafka 4.3.1 tag 的代码。
Kafka 4.x 里存储层已经从 Scala 搬到了 Java,都在 storage/src/main/java/org/apache/kafka/storage/internals/log/ 下(旧资料里的 core/src/main/scala/kafka/log/Log.scala 已不存在,那个类如今叫 UnifiedLog)。每个 Partition 对应一个 UnifiedLog 实例,这层挂接关系在 core/src/main/scala/kafka/cluster/Partition.scala:202:
java
@volatile var log: Option[UnifiedLog] = NoneUnifiedLog 这个名字里的 Unified,指的是它统一了本地 segment 和分层存储(tiered storage,把冷数据搬到对象存储的新特性)的视图,类的 javadoc 写明「The active segment is always guaranteed to be local」------正在写的那个 segment 永远在本地磁盘上。分层存储不是本篇的事,知道名字来历即可。
那「一个 Log」在物理上是什么?答案是若干个 LogSegment 文件的顺序拼接。UnifiedLog.java:128 持有一个 LocalLog,其中以 LogSegments 管理着全部 segment;最后一个 segment 叫 active segment(LogSegments.java:322 的 activeSegment()),是唯一一个还在接受写入的 segment。
写入的调用链,从 UnifiedLog#appendAsLeader(UnifiedLog.java:1020 起)进来之后:
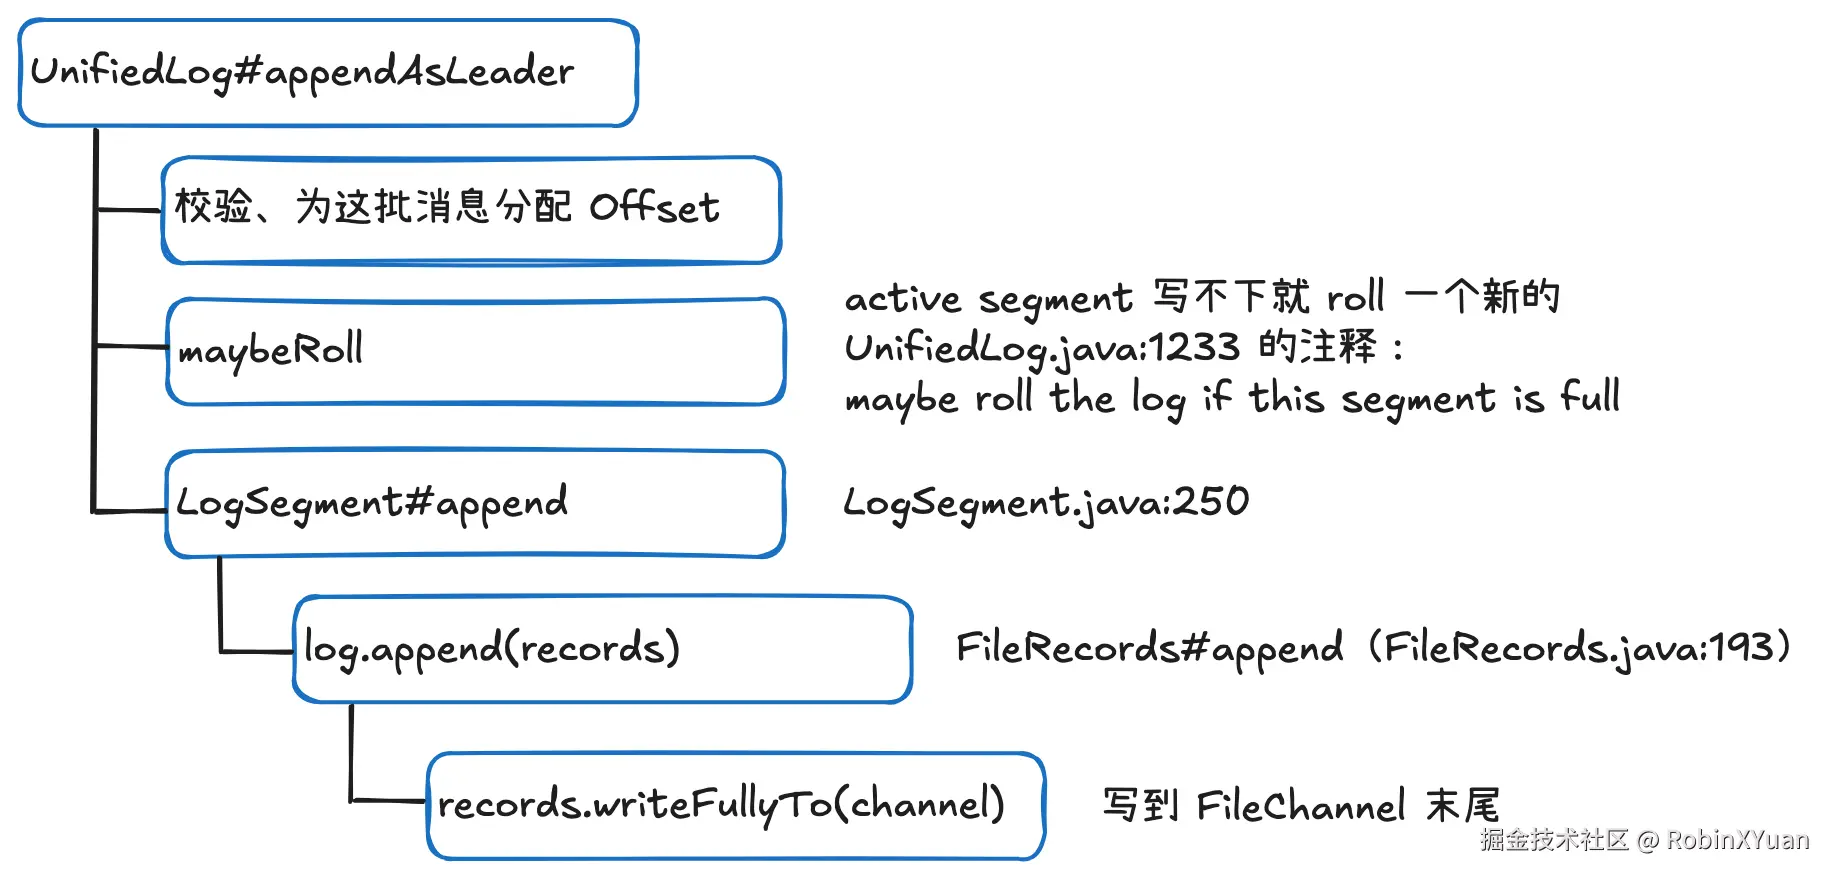
LogSegment 的字段(LogSegment.java:79-86)能看出一个 segment 的主要家当:
FileRecords log:真正存消息的文件;LazyIndex<OffsetIndex>与LazyIndex<TimeIndex>:两类索引;TransactionIndex:事务索引;long baseOffset;- 另有几个控制索引密度与滚动抖动的参数字段。
至于索引是干什么的、怎么用,后面会专门讲,这里只需要知道「每段消息配了几个小索引文件」。
链路的最底端是 FileRecords#append,它做的事就是 records.writeFullyTo(channel)------把字节写到 FileChannel 当前位置,也就是文件末尾。整条写路径上没有任何「seek 到文件中间改几个字节」的操作,这就是「追加式」三个字在代码层面的全部含义。消息没有主键、没有索引查找、没有原地更新,进来多少字节,顺序落盘多少字节。
每个 segment 的文件名就是它的起始 Offset。LogFileUtils.java:102 的 filenamePrefixFromOffset 把 Offset 格式化成 20 位数字,再拼上 .log 后缀(LogFileUtils.java:127)。于是磁盘上一个 Partition 目录长这样:
text
orders-0/                                  ← 一个 Partition 的目录
├─ 00000000000000000000.log   Offset 0--7    ← 已封存,940K
├─ 00000000000000000008.log   Offset 8--15   ← 已封存,940K
├─ 00000000000000000016.log   Offset 16--23  ← 已封存,940K
├─ 00000000000000000024.log   Offset 24--29  ← active segment,正在写
├─ 00000000000000000000.index / .timeindex  ← 各 segment 的索引(还有 .txnindex、.snapshot 等)
├─ leader-epoch-checkpoint                  ← 副本相关
└─ partition.metadata
逻辑上的「一条无限长的 Log」,物理上就是这些按 base offset 递增拼接的文件。Offset 25 这个地址,落在文件名 24 的 segment 里、文件内偏移 120095 字节处------下一节我们亲眼去看。
动手实践:亲眼看一看 Log
这次实验的目标是把上面那幅图落到可观察的实体上:亲眼看 segment 滚动、看消息躺在文件里、验证消费不动数据。容器还是用上一篇的 apache/kafka:4.3.1。
为了肉眼看到滚动,我想把 segment.bytes 调小。先随便试了个值:
bash
docker exec kafka /opt/kafka/bin/kafka-topics.sh --bootstrap-server localhost:9092 \
  --create --topic orders --config segment.bytes=512
# Invalid value 512 for configuration segment.bytes: Value must be at least 1048576被拒了。翻源码,LogConfig.java:150 的定义上白纸黑字:atLeast(1024 * 1024)------这个配置有 1 MB 的下限。那就用 1 MB,把消息撑大一点:发 30 条、每条约 120 KB 的订单消息(带一段无意义的填充串),总共约 3.5 MB,足够滚出几个 segment:
bash
docker exec kafka /opt/kafka/bin/kafka-topics.sh --bootstrap-server localhost:9092 \
  --create --topic orders --config segment.bytes=1048576

python3 -c '
pad = "a" * 120000
for i in range(1, 31):
    print(f"{{\"orderId\":{i},\"pad\":\"{pad}\"}}")' \
| docker exec -i kafka /opt/kafka/bin/kafka-console-producer.sh \
    --bootstrap-server localhost:9092 --topic orders
然后去找数据目录。这里我犯了个想当然的错:直接去 ls /var/lib/kafka/data,发现是空的。进容器 grep 配置才确认,这个镜像的 log.dirs 是 /tmp/kraft-combined-logs (/etc/kafka/docker/server.properties 里写着)。看目录:
bash
docker exec kafka ls /tmp/kraft-combined-logs/orders-0/
text
00000000000000000000.log   00000000000000000008.log
00000000000000000016.log   00000000000000000024.log
00000000000000000000.index ... .timeindex  (每个 segment 一组)
leader-epoch-checkpoint    partition.metadata
四个 .log 文件,文件名正是 0、8、16、24------每个装满的 segment 放了 8 条消息就滚动开新文件(8 × 120095 字节 ≈ 940K,再塞一条就超 1 MB,于是 roll)。上一节那张示意图,就是照着这个真实目录画的。
接下来是本篇的主角登场------kafka-dump-log,Kafka 自带的 segment 文件查看器,直接把 .log 文件里的二进制内容解出来给人看:
bash
docker exec kafka /opt/kafka/bin/kafka-dump-log.sh \
  --files /tmp/kraft-combined-logs/orders-0/00000000000000000024.log
text
Dumping /tmp/kraft-combined-logs/orders-0/00000000000000000024.log
Log starting offset: 24
baseOffset: 24 lastOffset: 24 count: 1 baseSequence: 24 lastSequence: 24 producerId: 0 producerEpoch: 0 partitionLeaderEpoch: 0 isTransactional: false isControl: false deleteHorizonMs: OptionalLong.empty position: 0 CreateTime: 1790006788090 size: 120095 magic: 2 compresscodec: none crc: 1301694245 isvalid: true
baseOffset: 25 lastOffset: 25 count: 1 ... position: 120095 ... size: 120095 ...
baseOffset: 26 lastOffset: 26 count: 1 ... position: 240190 ... size: 120095 ...
...
每行是一个 RecordBatch(console producer 每敲一行就自成一个 batch,所以 count 都是 1)。值得留意的是 position:0、120095、240190......这是这个 batch 在文件内的物理字节偏移。Offset 是逻辑地址,position 是物理地址,两者在这个文件里一一对应------后面讲的稀疏索引,干的就是加速这个映射的事,这里我们对此有个印象即可。
再看消息本体。加上 --print-data-log,每条记录的 payload 会解出来(填充串太长,我截断了):
bash
docker exec kafka /opt/kafka/bin/kafka-dump-log.sh \
  --files /tmp/kraft-combined-logs/orders-0/00000000000000000000.log \
  --print-data-log
text
Log starting offset: 0
baseOffset: 0 lastOffset: 0 count: 1 ... position: 0 ...
| offset: 0 CreateTime: 1790006787563 keySize: -1 valueSize: 120022 sequence: 0 headerKeys: [] payload: {"orderId":1,"pad":"aaaa......(省略)......aaaa"}
| offset: 1 ... payload: {"orderId":2,"pad":"aaaa......"}
orderId: 1 赫然映入眼帘。所谓「消息写进 Log」,物理上就是这么朴素:字节按顺序落在文件末尾,仅此而已。
最后验证本篇的核心论断:消费不动数据。先用一个 Group 把 30 条全消费掉:
bash
docker exec kafka sh -c '/opt/kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server localhost:9092 --topic orders --group billing2 \
  --from-beginning --timeout-ms 8000 | wc -l'        # 输出 30

docker exec kafka /opt/kafka/bin/kafka-consumer-groups.sh \
  --bootstrap-server localhost:9092 --group billing2 --describe | tail -1
# GROUP     TOPIC   PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG
# billing2  orders  0          30              30              0
CURRENT-OFFSET 30------游标在 30。此刻再 dump 一次 segment 0:8 个 batch 一条不少地躺在文件里。然后把游标拨回去,再消费一遍:
bash
docker exec kafka /opt/kafka/bin/kafka-consumer-groups.sh --bootstrap-server localhost:9092 \
  --group billing2 --topic orders --reset-offsets --to-earliest --execute
# GROUP     TOPIC   PARTITION  NEW-OFFSET
# billing2  orders  0          0

docker exec kafka sh -c '/opt/kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server localhost:9092 --topic orders --group billing2 \
  --timeout-ms 8000 | wc -l'                          # 输出 30
30 条又消费了一遍。整个过程里,磁盘上那四个文件没有任何变化(不信可以再 dump 一遍,或者对比文件的 mtime)。消费是读加挪游标,数据是数据------这就是 Log 语义在物理层面的样子。
还有一个验证没做:两个 Group 同时在 Log 上,互不影响。此刻 billing2 消费过、重放过、游标停在 30,让审计系统此刻才上线,从最早处开始读:
bash
docker exec kafka sh -c '/opt/kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server localhost:9092 --topic orders --group audit2 \
  --from-beginning --timeout-ms 8000 | wc -l'        # 输出 30
audit2 拿到的是完整的 30 条。billing2 消费过也好、拨回过游标也好,对它没有分毫影响;反过来,它这一遍消费也没有动 billing2 的游标和任何数据。两个 Group,一份数据,两条互不相识的游标------「互不干扰」不是 Kafka 额外实现的功能,是 Log 语义的必然推论。
对比参照:Log 是手段,还是本体
MySQL 和 Kafka 都有 Log,但两者的地位天差地别,而这个差别不是谁更高级,是约束不同。
MySQL 面对的约束是事务性更新:同一行的数据会被反复 UPDATE,系统的核心数据结构必须支持「按主键定位、就地修改」,于是 B+ 树才是数据的本体,行在树上原地变化。Log 在这里是为树服务的:redo log 保证树变更的崩溃安全,checkpoint 推进之后,旧的 redo 日志就完成了使命,可以被循环覆盖。数据是「最新状态」,历史只是临时借道。
Kafka 面对的约束是追加式事实流:事件发生了就是发生了,不存在「把昨天的页面浏览改成另一种浏览」,数据天然不可变,也就不需要任何支持就地更新的结构。于是 Log 直接就是本体,消息写进 Log 就是最终形态,永不转换、永不 UPDATE。自然而然地我们可以得到一个推论:Kafka 没有「按 key 改一条消息」的 API,这不是功能缺失,是这个模型里压根不存在这个动作------一条记录一旦写入,它在序列中的位置和内容就都定死了。
同一个抽象,在一个系统里是脚手架,在另一个系统里是承重墙。下次在某个系统里见到「Log / Journal / WAL」,可以先问一句:它是手段,还是本体?这一问基本能定调这个系统一半的设计。
工程启示
用好 Kafka:游标思维。 把「消费进度是游标,不是删除标记」刻进直觉,很多运维问题会变成一行命令的事:修完 bug 要重算,--reset-offsets;补数,--to-datetime 拨到出问题的时刻;多算了,--shift-by -100 退一百条。重置的姿势不止 --to-earliest 一种,ConsumerGroupCommandOptions.java:51 列出了全套可能的操作:--to-datetime、--by-duration、--to-earliest、--to-latest、--shift-by、--from-file、--to-current、--to-offset。但有一个边界必须清楚:游标能拨回去的前提是数据还在。retention 删掉的是整个整个的 segment 文件(这也是为什么删除对追加式结构毫无伤害------删文件不改文件),一旦想拨回去的位置已被删掉,auto.offset.reset 就会接管,行为可能是跳到最新------「回到过去」是有边界的,边界就是 Log 的起点。这条边界怎么划,后面细说。
设计借鉴:append-only 数据 + 外置游标。 这个组合的可迁移性极强。事件溯源(Event Sourcing)干脆把「状态 = 对事件日志的重放」用在业务建模上,等于把数据库的崩溃恢复原理反哺成了业务架构;CDC 的源头 binlog 本身就是一份 WAL,CDC 工具做的事本质上是「给 binlog 接上一条外部游标」;还有各种 outbox / 业务消息表方案------业务事件先追加进表,投递进度由下游各自维护。共同收益:不可变的数据可多读者、可回放、可审计,读者的故障与进度不伤数据本身。凡是「一份事实、多方消费、各自进度」的场景,都值得想想这个模式。
小结
这一篇做了三件事:给了 Log 的严格定义(append-only、全序、不可变),看了它在数据库、文件系统、Kafka 里的三次现身,解释了同一个抽象为何反复出现(写得快、天然有序、可回放,三个性质打包);把 Log 与 Queue 的区别探索到了结构层面(数据所有权、消费者关系、时间维度);最后在源码和磁盘上确认了 Kafka Log 的物理形态------UnifiedLog,由若干 LogSegment 顺序拼接而成,写路径自上而下只有顺序追加。
上一篇的三个问题至此有了着落:Log 是什么,本篇回答了;凭什么快,顺序追加是结构原因,Page Cache 与 Zero Copy 后面再聊;凭什么敢一直留在磁盘上,文件级的 retention 是答案。
但还有一个更大的问题:单机的 Log 讲得再通,一台机器也装不下一个公司的活动数据,更扛不住一台机器挂掉。Kafka 必须把 Log 做成分布式的------怎么拆、怎么复制、怎么在机器故障后继续工作?这是接下来「架构总览」要建立的全景,也是整个系列后半段的主战场。
下一篇:Kafka 架构总览。