你的 API 只返回 30 条,为什么数据库还是被打满了?
一个趋势接口只返回 30 个点,直觉上应该很便宜。可如果数据库先扫描全部历史、完成分组和排序,再执行 LIMIT 30,小响应照样能制造大查询。
GitHub 最近重构 star history API 时,就碰到了这个问题。旧链路让工具分页拉取 stargazer 明细,再丢掉用户名画曲线;新链路直接返回时间桶,并把时间过滤放在聚合之前。可迁移到其他系统的关键只有一句:先限制工作范围,再做昂贵计算。
小 JSON 不代表小成本
很多接口评审会检查 page_size,却不检查数据库为了生成这一页做了多少工作。典型错误顺序是:
text
读完整历史 → 分组 → 排序 → OFFSET/LIMIT → 返回 30 条客户端看到 30 条,数据库看到的却可能是数百万行。分页只裁掉结果,没有裁掉前置成本。
更健康的顺序是:
text
用索引圈定时间窗口 → 对窗口内数据分组 → 返回趋势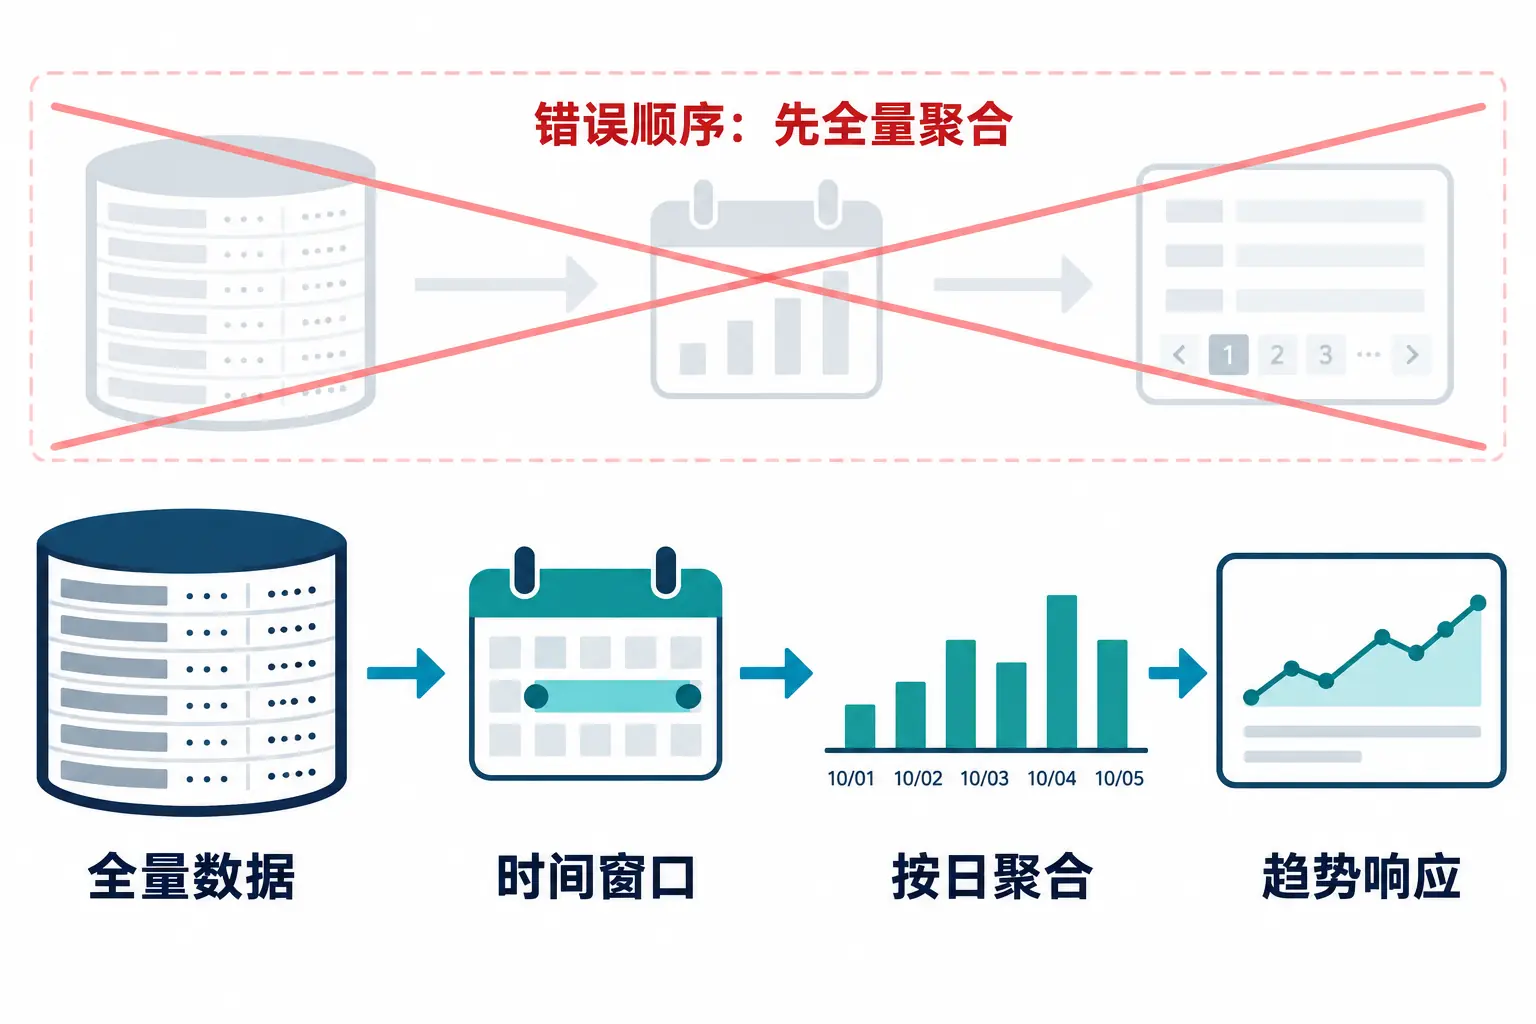
这要求查询条件能落到索引范围上。例如 (resource_id, created_at) 复合索引配合明确的 [from, to),通常比聚合全部历史后再翻页更可控。
别把存储模型当成用户需求
数据库里一条记录对应一个用户,不代表趋势接口就该返回用户。工具真正要的是"某次发布前后,增长曲线有没有变化",身份只是旧接口顺手暴露的中间数据。
这类需求拆解可以用一个很实用的顺序:
- 任务是什么:看趋势、找明细,还是做审计?
- 最小输出是什么:日期和计数是否已经足够?
- 哪些中间数据既昂贵又可能被滥用?
如果趋势足够,就让服务端产出趋势。不要把明细交给每个调用方,再期待所有调用方都正确地删除无关身份。
接口要限制扫描范围,而不只是返回条数
per_page=30 不是性能护栏。更有用的契约包括:
- 单次最大时间范围;
- 固定桶粒度和时区;
- 空桶补零还是省略;
- 翻页游标如何对应时间边界;
- 异常密集窗口如何降级或拒绝;
- 取消、删除等逆向事件怎样影响历史。
把页码映射成自然周或自然月,是一种让工作量更可预测的办法。但"窗口有限"仍不等于"行数有限":某一周突然涌入大量事件时,查询依然可能变慢。高密度业务还需要预聚合、增量计数或明确的扫描预算。
改造时最容易漏掉的三件事
第一,函数可能让索引失效。WHERE DATE(created_at) = ... 往往不如直接使用原始时间范围,具体要看数据库与执行计划。
第二,趋势的语义可能是近似的。如果系统只保留当前成员,而删除退出记录,用现存集合重建的"历史"并不等于真实事件史。
第三,只看平均延迟会掩盖热点。普通项目很快,不代表高热资源或异常密集窗口不会击穿 P99。
一个足够小的验收清单
EXPLAIN显示范围过滤先于聚合;- 监控 scanned rows,而不只监控 response size;
- 普通、长期、热点三类窗口分别压测;
- 接口文档写清桶粒度、空桶和撤销语义;
- 响应字段逐项做"任务必需性"检查;
- 对超预算窗口有超时、降级或预聚合方案。
最后
性能和隐私在这里不是两条独立的优化线。只返回任务需要的聚合结果,既减少身份暴露,也迫使接口围绕真正的查询目标重新设计。小响应只有在小工作量之后产生,才是真的小接口。