ESP32-S3 分核后仍报 AFE 缓冲区满?先查输入合同
唤醒成功后,串口却提示 Ringbuffer of AFE(FEED) is full。把 feed 与 fetch 放到不同核心仍没有消除告警,下一步是调大缓冲区吗?ESP-SR issue #157中的报告者确实贴出了两个分核任务,以及唤醒后的告警和异常命令结果。但这份代码里还有一处比任务调度更该先看的差异:get_feed_channel_num() 的日志为 nch:2,i2s_buff 却按单通道大小分配和读取。
这是一则用户报告,不是乐鑫的根因裁定。告警文字提醒可能丢失或覆盖数据;该页面没有逐帧统计,不能据此说已经测出掉帧。本文给出两步排查:先证实送入 AFE 的数据符合接口,再测输入与结果消费的节奏。
第一处证据:配置为两通道,缓冲却只留一通道
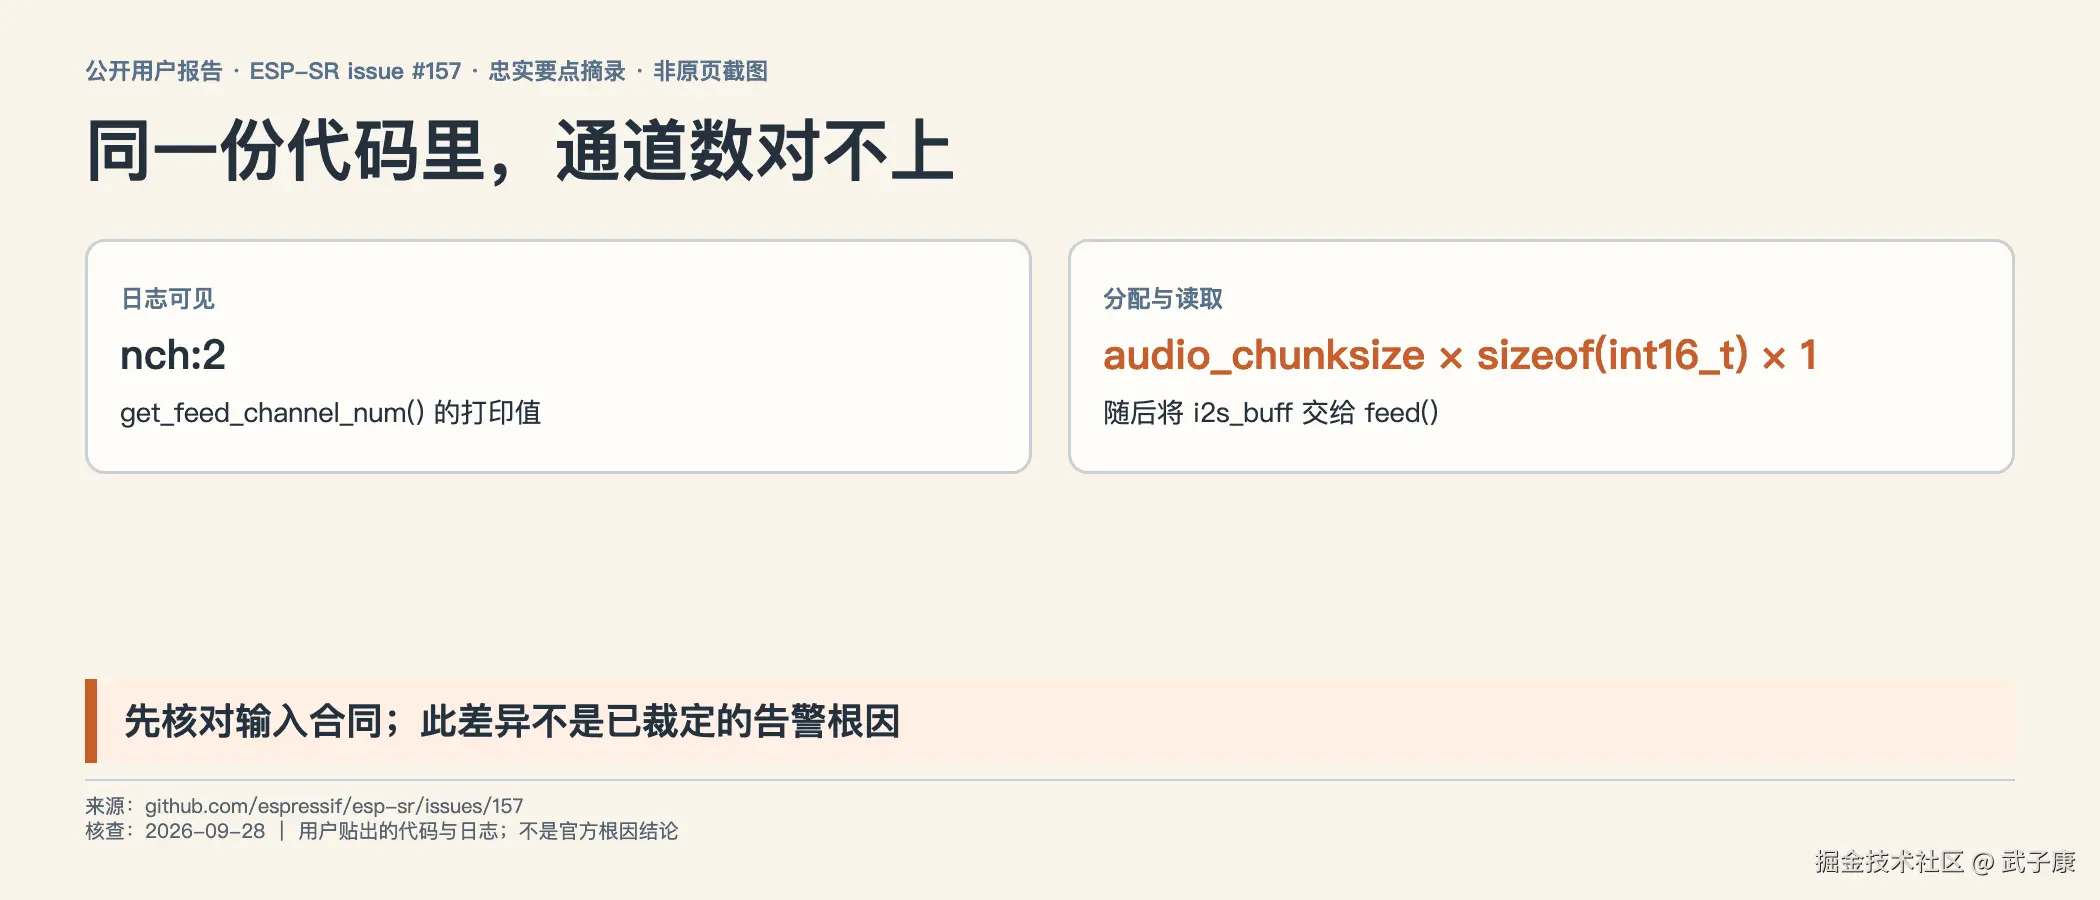
报告者的 feed_Task 先调用 get_feed_chunksize() 和 get_feed_channel_num(),日志打印 nch:2。随后却执行 malloc(audio_chunksize * sizeof(int16_t) * 1),I2S 也只向这个缓冲区读取同样的单通道字节数,最后把指针交给 afe_handle->feed()。这里的 ×1 是源码可见的,不是本文推测出来的运行配置。
若 feed() 在该配置下按双通道读取完整一帧,传入的内存便不足,存在越界读取与异常输入风险。不过页面没有隔离修复前后的对照,不能断言这就是缓冲区满的唯一原因 。实际麦克风与 I2S 输出几通道、数据如何交错也需要现场确认;不要盲目把 ×1 改成 ×2,却仍只读入一通道数据。
先区分"配置想要的"与"硬件实际给的"
这里同时存在三个通道概念:采集硬件输出、业务整理后的输入排列、AFE 配置期望。它们可以经过明确转换后不同,但不能在一次 feed 交接中模糊处理。假设硬件只采一支麦克风,而 AFE 期望还包含播放参考,那么扩大内存并不会生成第二路参考;假设硬件给出两个声道,其中某一路并非期望的信号,大小正确也不能证明内容正确。先标出每个通道的来源,再按当前配置核对。
可以先做不改变检测算法的输入审计:记录读入请求字节数、实际读取字节数、分配容量以及传给 feed 的有效范围。若采集读入不足一帧,应用如何处理尾部?是等待补齐、放弃此帧,还是错误地把旧数据一并交出去?这属于目标代码需要明确的行为,不能由分配公式自动保证。对完整帧的检查,比仅打印 I2S 调用成功更接近实际接口合同。
反例是容量已经乘以两通道,实际仍只填了一路。此时内存足够,却可能存在未填充或历史内容;如果第二路应是参考信号,输入语义仍错。另一个反例是两路都填满,排列却按整段一路接整段另一路,而接口要求通道交错。这两种情况都说明"字节数对了"只排除一类长度错误,不能替代通道内容和排列检查。
第二处证据:AFE 的输入长度由接口决定
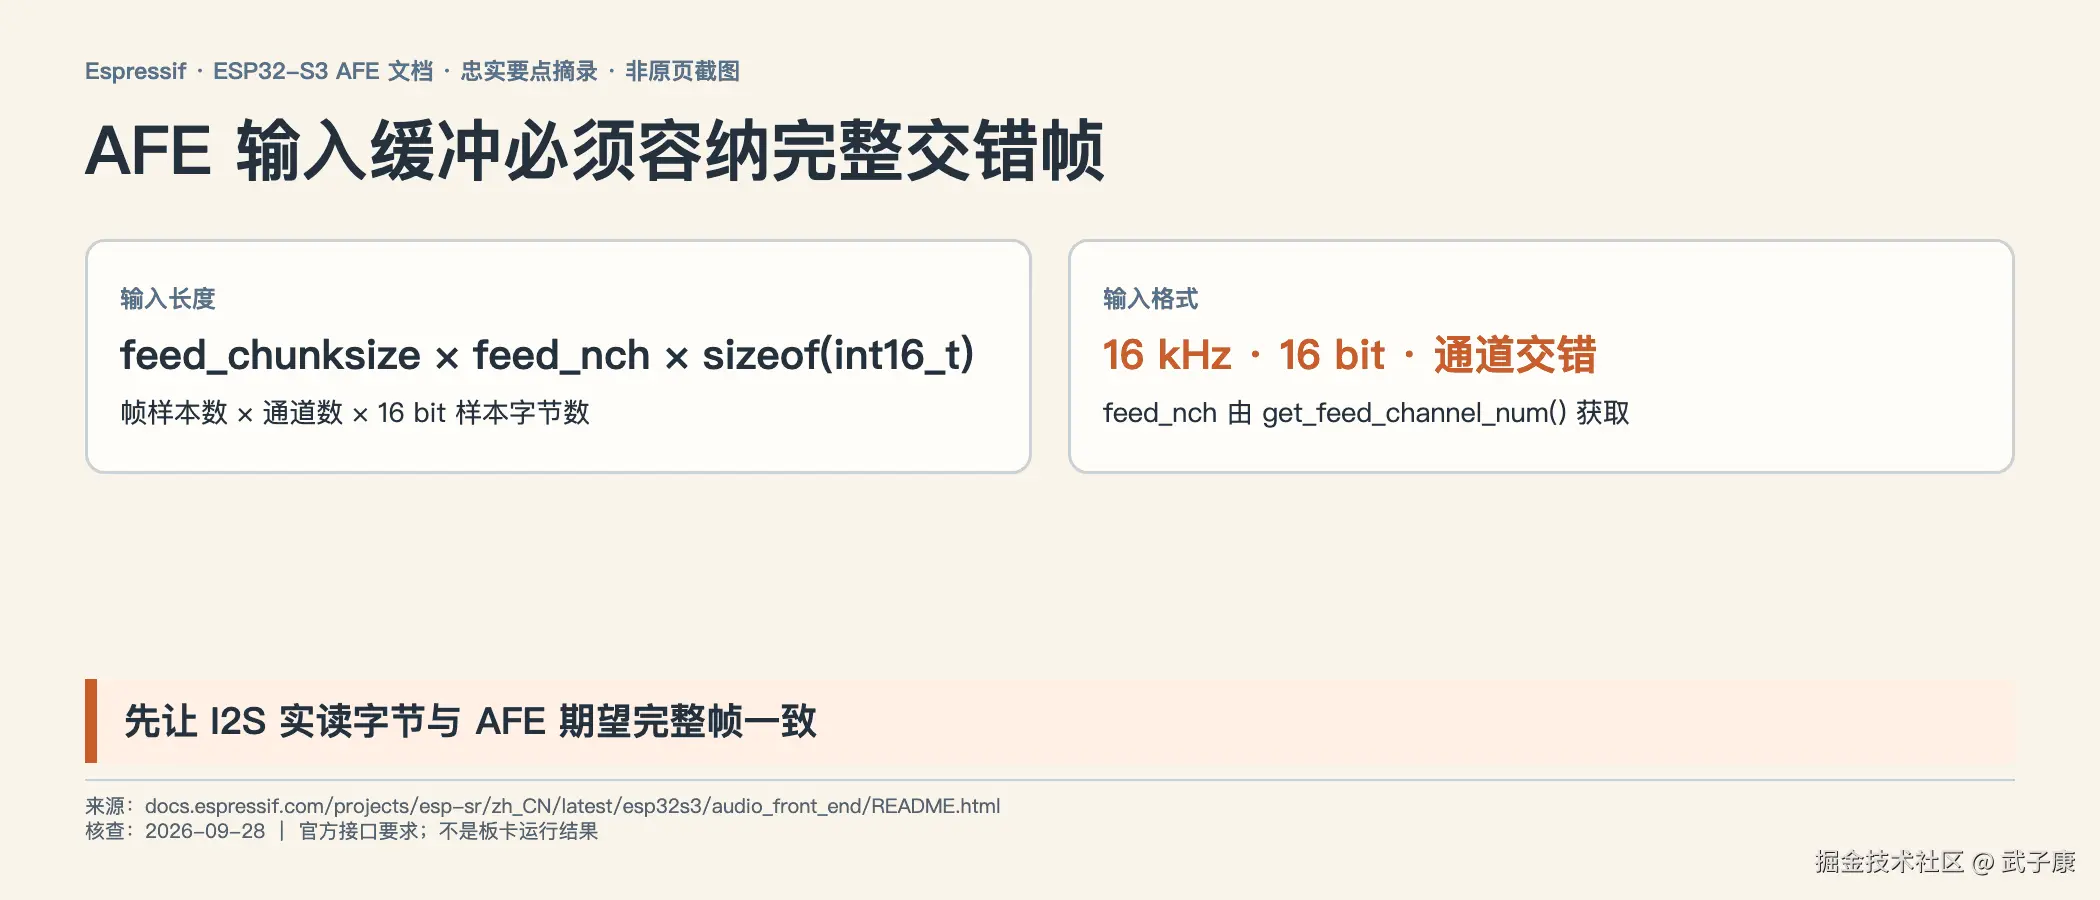
乐鑫 ESP32-S3 AFE 文档要求用 get_feed_chunksize()、get_feed_channel_num() 获取帧长和通道数,输入缓冲区按 feed_chunksize × feed_nch × sizeof(int16_t) 分配;音频为 16 kHz、16 bit、通道交错的 PCM。它还给出 feed 和 fetch 分别运行在 CPU0、CPU1 的示例。分核是示例中的任务安排,不会放宽 feed() 的输入合同。
现场先把五个量写在一起:AFE 配置的通道布局、feed_nch、feed_chunksize、I2S 实际读入字节数、传入 feed() 的已分配字节数。检查读入缓冲是否真的包含完整交错帧,且没有用原始硬件通道数代替 AFE 期望通道数。输入无误后,再继续查消费节奏。
把长度换算成音频时间,才有可比较的节奏
输入缓冲公式中的 chunksize 是接口返回值,项目应以实际查询结果为准。若要估算一帧代表多久,应使用每通道样本数除以采样率。假设实际返回 512 个样本,在 16 kHz 下代表 32 ms;这里的 512 只是算术示例,不是默认值、推荐值或板卡实测。交错多通道会增加一帧字节数,却不使它代表的时间按通道数倍增。
这个区别影响积压判断。假设开发者把双通道输入的总样本数当成单路音频时长,输入进度会被算成两倍;或者把 fetch 的单通道输出与 feed 的交错样本总数直接相减,也会制造假积压。统一使用各路对应的音频时间,并标明帧转换与前端延迟,才有条件观察哪个阶段领先。不能简单把累计输入与累计输出的差都称为队列占用,因为算法内部处理也可能保留一定历史。
采集读取的墙钟时间与音频时间也要区分。重放文件时,若没有按照预期节奏投喂,输入可能远快于实时声音;现场连续 I2S 读取则有自己的实际到达节奏。测试同一个 AFE 模型时,这两类输入会产生不同压力。报告应注明是实时采集还是回放,并保存 feed 调用间隔,防止把过快回放导致的告警解释成真实麦克风场景不能运行。
分核之前和之后,接口检查都应保持
跨任务传递时还要确认采集缓冲何时可复用。生产者填写下一帧之前,消费者是否已完成使用?如果业务用了自己的队列,队列究竟复制内容还是只保存指针?这里提出的是需要核对的问题,并不推断官方 feed 一定异步持有指针。实际所有权应从当前版本实现和应用调用关系确认,日志中的地址复用只能作为线索。
输入正确后,才去测 fetch 是否被拖慢
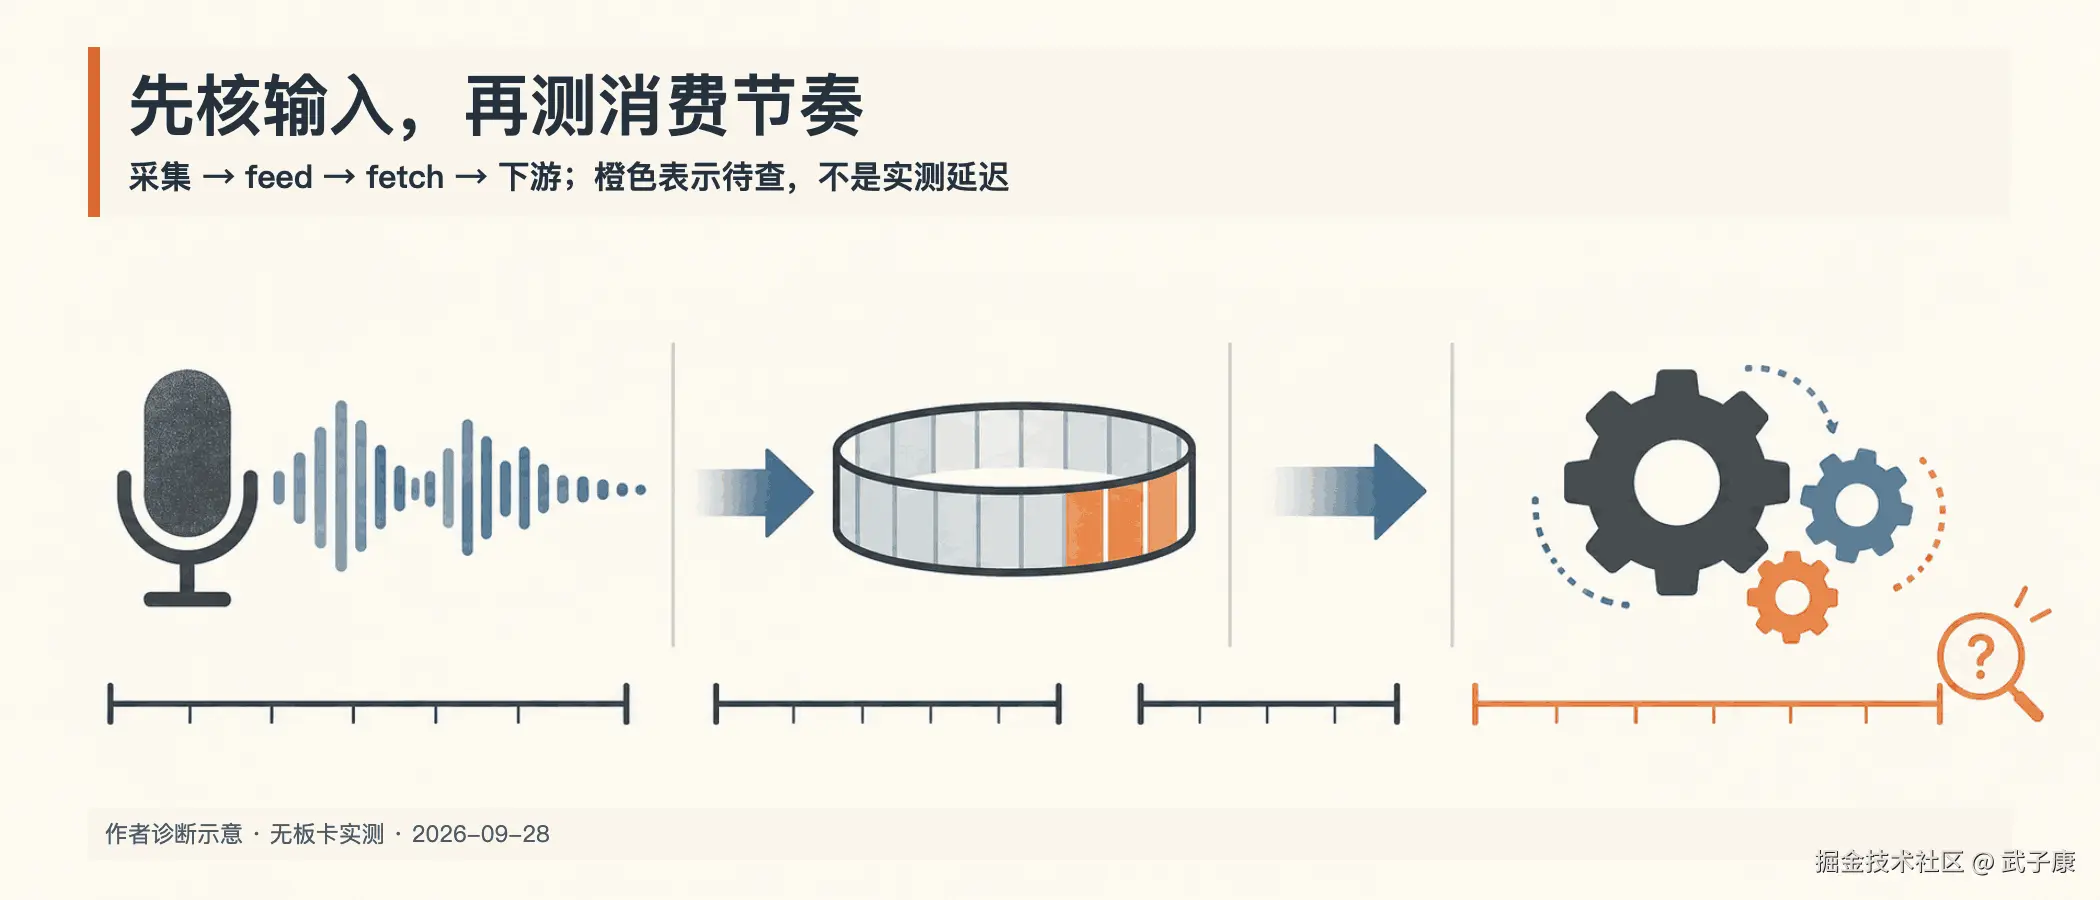
issue 的 detect_Task 循环先 fetch(),唤醒后同步调用 multinet->detect(),还输出状态或结果。它提供一处待测线索 :如果本轮下游处理太久,下次 fetch() 就会推迟;即使两个任务位于不同核心,也不意味着结果一定及时取走。页面没有逐段耗时,不能把 MultiNet 或日志打印定为原因。
乐鑫 ADF 开发说明建议检查任务绑定的核心与运行统计,并提醒长时间占据核心可能触发 Task WDT。文中的默认分核专指 ADF AFE manager ,不能套成所有原生 ESP-SR 工程的默认值。ESP-SR 配置头把 afe_ringbuf_size 定义为环形缓冲区的帧数;增大它可能吸收短暂抖动,但若长期输入快于消费,积压仍会继续。
| 边界 | 本次最少记录 | 用来判断 |
|---|---|---|
I2S → feed |
实读字节、通道排列、帧长、调用起止和返回值 | 输入合同与到达节奏是否成立 |
feed → AFE |
累计输入音频时长、告警时刻、afe_ringbuf_size |
告警前输入是否持续领先 |
AFE → fetch |
进入和返回时间、错误、输出样本数 | 消费是否阻塞或停顿 |
fetch → 下游 |
detect 等同步工作的起止、任务核心与运行统计 |
下次 fetch 是否被本轮处理推迟 |
两端帧长可能不同,因此不要只数调用次数;把样本数换成累计音频时长再比较。先用轻量计数或采样日志收集基线,避免详细打印本身改变时序。若 fetch 很快返回却久久不再进入,查同一循环中的同步工作;若返回前就长时间阻塞,查 AFE 与任务调度。每次只改一个因素,比较相同输入条件下的告警与输出连续性。
这份表是待板卡执行的诊断设计。官方文档、配置头与 issue 于 2026 年 10 月 13 日再次核实;使用时仍须锁定项目 ESP-SR 组件版本。下面运行的是本地算术与队列模型,不能替代这张表的目标板卡数据。
复制运行:先检查字节,再构造消费停顿
下面给出一个标准库最小例,把"长度或单位错误"与"消费赶不上输入"拆开验证。它不链接 ESP-SR、不模拟声学算法,也没有访问 I2S。第一部分按输入样本数、通道数和 16 bit 算出字节数;第二部分用带编号的帧放入有限队列,按给定时间表消费。程序没有墙钟等待,所有时间都由整数循环推进,因此输出是可重复的模型结果,不是性能基准。
保存为 afe_contract_queue.py,用 Python 3.8 或以上运行,无需安装依赖。自检依赖 assert,不要加 -O。
bash
python3 afe_contract_queue.py
python
"""PCM contract arithmetic and bounded queue model; no ESP-SR execution."""
from collections import deque
import struct


def check_frame(data, samples_per_channel, channels, sample_rate=16000):
    if (samples_per_channel <= 0 or channels <= 0 or sample_rate != 16000
            or type(samples_per_channel) is not int or type(channels) is not int):
        raise ValueError("invalid PCM contract")
    expected = samples_per_channel * channels * 2
    if len(data) != expected:
        raise ValueError(f"expected {expected} bytes, got {len(data)}")
    return expected, samples_per_channel * 1000 / sample_rate


def simulate(capacity, consume_ms, pause=None):
    if capacity <= 0 or consume_ms <= 0:
        raise ValueError("invalid queue parameters")
    queue = deque()
    accepted = consumed = rejected = peak = 0
    # Producer: 50 frames at t=0..1568ms. Consumer is scheduled before producer.
    for time_ms in range(1601):
        blocked = pause is not None and pause[0] <= time_ms < pause[1]
        if time_ms % consume_ms == 0 and not blocked and queue:
            queue.popleft()
            consumed += 1
        if time_ms < 1600 and time_ms % 32 == 0:
            if len(queue) == capacity:
                rejected += 1  # This model rejects new frames; it does not overwrite.
            else:
                queue.append(time_ms // 32)
                accepted += 1
                peak = max(peak, len(queue))
    assert accepted + rejected == 50
    assert accepted == consumed + len(queue)
    return accepted, consumed, rejected, peak, len(queue)


def main():
    expected, duration = check_frame(bytes(512 * 2 * 2), 512, 2)
    assert (expected, duration) == (2048, 32.0)
    print("two channels: bytes=2048 audio_ms=32.0")
    wrong_duration = 512 * 2 * 1000 / 16000
    assert wrong_duration == 64.0 and wrong_duration != duration
    print("wrong total-sample duration: 64.0ms (correct=32.0ms)")
    for label, data in (("mono allocation", bytes(1024)), ("partial read", bytes(2046))):
        try:
            check_frame(data, 512, 2)
        except ValueError as error:
            print(f"{label}: REJECT {error}")
        else:
            raise AssertionError("short frame accepted")
    mic = [100, 101, 102, 103]
    reference = [1000, 1001, 1002, 1003]
    interleaved = [v for pair in zip(mic, reference) for v in pair]
    planar = mic + reference
    good = struct.pack("<8h", *interleaved)
    bad = struct.pack("<8h", *planar)
    assert check_frame(good, 4, 2) == check_frame(bad, 4, 2)
    assert struct.unpack("<8h", good) == tuple(interleaved)
    assert struct.unpack("<8h", bad) != tuple(interleaved)
    print("equal byte count/wrong layout: expected=(100,1000,101,1001) got=(100,101,102,103)")
    for label, capacity, consume_ms, pause in (
            ("steady", 4, 32, None),
            ("temporary pause/small", 4, 16, (320, 480)),
            ("temporary pause/larger", 8, 16, (320, 480)),
            ("sustained slow/small", 4, 64, None),
            ("sustained slow/larger", 8, 64, None)):
        result = simulate(capacity, consume_ms, pause)
        accepted, consumed, rejected, peak, remaining = result
        if label == "steady":
            assert result == (50, 50, 0, 1, 0)
        elif label == "temporary pause/small":
            assert rejected > 0 and remaining == 0
        elif label == "temporary pause/larger":
            assert rejected == 0 and remaining == 0
        else:
            assert rejected > 0 and remaining > 0
        print(f"{label}: accepted={accepted} consumed={consumed} "
              f"rejected={rejected} peak={peak} remaining={remaining}")
    print("PASS: length, layout and queue conservation assertions")


if __name__ == "__main__":
    main()
2026 年 10 月 13 日本地实际运行,退出码 0,标准输出为:
text
two channels: bytes=2048 audio_ms=32.0
wrong total-sample duration: 64.0ms (correct=32.0ms)
mono allocation: REJECT expected 2048 bytes, got 1024
partial read: REJECT expected 2048 bytes, got 2046
equal byte count/wrong layout: expected=(100,1000,101,1001) got=(100,101,102,103)
steady: accepted=50 consumed=50 rejected=0 peak=1 remaining=0
temporary pause/small: accepted=49 consumed=49 rejected=1 peak=4 remaining=0
temporary pause/larger: accepted=50 consumed=50 rejected=0 peak=5 remaining=0
sustained slow/small: accepted=28 consumed=25 rejected=22 peak=4 remaining=3
sustained slow/larger: accepted=32 consumed=25 rejected=18 peak=8 remaining=7
PASS: length, layout and queue conservation assertions
第一行给出示例帧:每通道 512 个样本、两通道、每样本 2 字节,完整输入是 2048 字节,但音频跨度仍是 32 ms。把两通道总样本数除以采样率会得到 64 ms,这是程序专门保留的错误反例。交错通道表示同一时间点的不同信号,不是前后两段音频;如果用 64 ms 衡量送入速度,就会把实际压力算低一半。这里的 512 沿用算术示例,不替代运行时接口返回值。
单通道容量和少读两个字节分别被拒绝。少读情况很容易漏掉:申请了 2048 字节不代表读取返回了 2048 字节。程序以有效数据长度检查合同,而不是仅看对象容量。现场应把采集返回的有效字节数带到交接处,决定补齐、暂缓还是丢弃;不要无条件把整个分配区交给 feed,也不要让旧尾部内容伪装成新的完整帧。
两个长度完全相同的四样本帧则展示另一种错误。正确排列以麦克风、参考、麦克风、参考交错;错误排列先放完整麦克风段,再放参考段。字节检查对两者都通过,但样本标记断言能看出顺序不同。因此 check_frame 是长度检查器,不能宣称它识别了真实录音的通道语义。测试用 100、1000 这类已知标记,目的是检查打包代码;接入时再用各通道可辨识的测试输入确认布局。
相同输入,换消费时间表后发生什么
队列部分固定产生 50 帧,时间为 0 到 1568 ms,每隔 32 ms 一帧;检查到 1600 ms。它规定同一时刻先消费、再送入,满时拒绝新帧,不覆盖旧帧。先写明这些约定,峰值、拒绝数与剩余数才有可解释的含义。若改成生产先执行或满时覆盖旧帧,边界结果可能不同;本文不把这些约定说成 AFE 内部实现。
稳定组每 32 ms 消费一次,50 帧都被取走,峰值为 1。这里峰值来自事件顺序:时刻 0 消费时队列还空,随后第一帧进入;下一次才取走它。结果没有拒绝,不证明芯片能处理每帧音频,只证明给定生产消费表与容量在这个模型中相容。
短暂停顿组用每 16 ms 的较快消费者,在 320 到 480 ms 之间暂停。容量 4 的组拒绝 1 帧,容量 8 的组拒绝 0 帧,两组最后都清空。因为恢复后的消费速度快于输入,积压有机会回落;扩大容量只是给这段暂停更多余量。这个例子补出了"能恢复到基线"条件,不能只见偶发峰值就判断缓冲增加一定有效。
持续慢组则每 64 ms 才消费一帧。容量从 4 增至 8,拒绝从 22 降为 18,但终点仍剩 3 或 7 帧。输入总量都相同、消费者都只取走 25 帧;更大容量留下了更多积压,却没有改变消费者速度。这是有限窗口内的反例,不需要无限运行也能看出容量不是吞吐修复。它既不等于实测掉帧率,也不能推出真实 AFE 的最大延迟。
所有组都有两个守恒断言:尝试送入数等于接受加拒绝,接受数等于消费加剩余。计数通过说明模型没有凭空吞掉帧;真实采集流程也应保存类似的范围证据。不过 AFE 可能改变帧长、保留算法历史或做缓存,不能把本例一进一出的计数公式直接套到 feed/fetch 调用次数。对目标版本仍应将样本转成音频时间,并保留算法边界。
把模型结果转成现场的下一次测量
如果本地打包自检先失败,优先处理输入合同,暂不据队列结果调核或调缓冲。如果字节数正确但已知通道标记错位,检查交错打包与来源映射;只扩大数组不能修复信号位置。两项都成立后,再把模型中的生产、消费时间表换成现场实际观测,用轻量记录判断暂停是否回落、是否持续不足。
这个程序没有重现 issue #157,没有运行 MultiNet,也没有测得 ESP32-S3 的吞吐或掉帧。其拒绝策略只用于让计数可见;当前 AFE 满时究竟等待、覆盖还是报告错误,应核对具体版本实现与返回行为。若想把 detect 移出 fetch 循环,仍要定义新队列上限、音频所有权和退出路径,否则只会把阻塞搬到下一段。
一条满缓冲告警,需要放回此前的时间轴
告警发生的那一刻只是容量触及边界,真正的停顿可能早已出现。应在告警前后同时保留 feed、fetch 和下游处理的进度。假设唤醒后 detect 循环多了一段同步业务调用,fetch 返回本身仍很快,但下一次进入 fetch 的间隔变长,那么处理后的等待才是值得隔离的分支。若 fetch 进入后迟迟没有返回,则要看前端是否有输出以及任务是否获得运行机会。
短暂抖动与持续消费不足要分开验证
短暂抖动的假设是:某个阶段偶尔暂停,之后能比输入更快地处理一段时间,积压最终回到基线。持续不足的假设是:消费者长期速度跟不上,即使没有明显长暂停,积压也持续上升。前者可能通过合理余量吸收,后者需要减少工作或调整管线。判断它们要看一段完整进度,而非只看一次峰值。
容量以帧数表示时,估算内存和可吸收时间还必须知道对应版本缓冲保存什么数据、每帧大小以及消费路径。本文只引用字段的帧数定义,不从一个配置值推出固定字节数或等待时长。真实配置评估应以版本实现和测量为准。若增大容量后告警出现得更晚,而最终仍发生,这只是延后边界的证据,不是稳定运行的证明。
还要观察输出是否连续。告警消失可能因为应用少喂数据、丢弃更多帧或关闭某个处理分支。只有记录实际输入和输出范围,才能判断消失是吞吐改善还是任务被绕开。输入合同正确、告警没有出现、预期输出连续,三项应分别有证据;不能用"串口很安静"替代它们。
测量本身也会占用消费者的时间
逐帧串口打印可能改变原来要观察的节奏。可以先用轻量计数保存调用次数、样本数和少量时间点,故障时输出摘要;必要时再局部增加采样记录。记录方式应前后一致,否则"加日志后才出现"与"改代码后消失"的比较可能混入测量负担。本文不指定日志实现,只要求报告说明使用何种方式以及是否发现测量影响。
任务核心、优先级和运行统计适合帮助解释竞争,但平均 CPU 占用不足以排除短暂停顿。一段消费者被长操作卡住,平均占用仍可能不高。要把统计与告警附近的时间序列一起看,避免根据整体 CPU 余量就宣称调度没有问题。若设备同时播放、联网或刷新屏幕,就逐项安排启用与禁用的对照,而不是把所有业务都关闭之后称整机已经修复。
一套能区分假设的最小复测次序
第一组只核对并修正输入长度与排列,保持模型和任务设置。若告警仍在,第二组保留下游流程但加入起止计时,观察停顿边界。第三组才对已定位的同步工作做隔离对照,比如保留识别而暂缓业务动作,以判断动作是否推迟消费。临时隔离的结果只服务定位,不能成为最终设备能力证明,因为它改变了实际产品负载。
若定位到日志负担,就在固定输入下比较精简记录与原记录;若定位到回放过快,就按实际输入节奏重跑;若定位到持续消费不足,就评估处理工作是否必须每帧执行。每次改变一处,并在报告里标明改变的范围。这个方法不承诺某一步一定消除告警,而是确保无论结果好坏,都能减少一个具体的不确定性。
最终交付应解释告警与识别的关系
Ringbuffer full 与命令识别异常在同一轮出现,说明它们值得联合调查,但同时发生不足以证明前者造成后者。要建立关系,仍需要输入与输出连续性、异常发生顺序以及受控复测。若输入错误修正后两者都改善,可以报告该配置下观察到的对照;若告警改善而识别仍异常,就应继续沿模型输入和词表边界排查。
现场还应区分启动期与稳定期。初始化、模型加载或首次唤醒可能带来一次性工作,长期连续运行则用于观察能否持续消费。若只在启动期间出现告警,要对齐采集开始与消费者就绪的时刻;若稳定运行一段时间后才出现,要查看期间是否有新增业务或周期任务。两种情况可能需要不同的交接处理,不能用整段平均速度覆盖它们。
取消与重新开始也是必要反例。消费者退出之后,采集是否仍持续 feed?若停止检测但未停止送入,缓冲很可能触及容量边界,但这属于应用启停设计待核查,并非芯片性能结论。重新开始时旧音频是否仍留在队列,亦要通过采样范围辨认。将完整生命周期加进记录,才不会把停机阶段的告警错归为正常运行的吞吐不足。
如果某次输入读入失败,保留错误及对应时刻,明确是否仍调用 feed。错误后使用什么内容取决于应用合同,应从代码确认,不能靠猜测补零或发送旧帧。异常输入会使后续时序难以解释,所以错误路径与成功路径应同时受到最小审计。