1.二叉排序树BST
@toc
1.1定义
二叉排序树 (Binary Sort Tree),又称二叉查找树(Binary Search Tree),二叉搜索树,排序二叉树。
它或者是一棵空二叉树,或者具有以下性质:
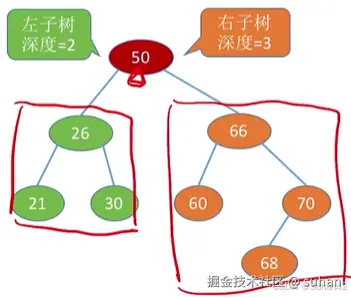
1/2.左子树 < 根节点 < 右子树
- 左子树上所有结点的关键字均小于根结点的关键字;
- 右子树上的所有结点的关键字均大于根结点的关键字;
- 左子树和右子树又各是一棵二叉排序树。
- 默认不允许有两个结点的关键字(data)相同。
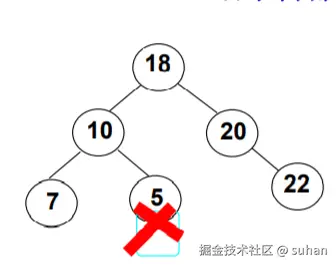
下图值为10的结点的右子树为5,比10小,不满足条件2,所以这棵树不是二叉搜索树。
可以进行中序遍历 ,得到一个递增的序列。
适用于需要快速查找、插入和删除数据的场景。
插入和删除操作的时间复杂度为 O(log n),其中 n 是树中节点的个数。
查找操作的时间复杂度也为 O(log n) 在平均情况下,但在最坏情况下可能为 O(n)。
1.2存储结构
c
// 二叉树的二叉链表结点结构定义
typedef int ElemType;

typedef struct BSTNode
{
	ElemType data;	//结点数据
	struct BSTNode *lchild, *rchild;	//左右孩子指针
} BSTNode, *BSTree;
1.3查找
查找操作的时间复杂度也为 O(log n) 在平均情况下,但在最坏情况下可能为 O(n)。
步骤:
- 查找从根结点开始,如果树为空,返回NULL。
- 若搜索树非空,则根结点关键字和 X 进行比较,并进行不同处理:
- 若 X 小于 根结点的键值,在左子树中继续搜索;
- 若 X 大于根结点的键值,在右子树中进行继续搜索;
- 若两者比较结果是相等,搜索完成,返回指向此结点的指针。
c
// 递归查找二叉排序树T中是否存在X
*BSTNode Find(BSTree BST, ElemType X){
    if(!BST) return NULL; //查找失败

    if(X > BST->data)
        return Find(X, BST->rchild); //在右子树中继续查找
    else if(X < BST->Data)
        return Find(X, BST->lchild); //在左子树中继续查找
    else //X == BST->Data
		return BST; //查找成功,返回结点的找到结点的地址
}使用递归 会导致效率不高。恰巧这段代码又是尾递归的方式(尾递归就是程序分支的最后,也就是最后要返回的时候才出现递归),从编译的角度来讲,尾递归都可以用循环的方式去实现。
由于非递归函数的执行效率高,可将"尾递归"函数改为迭代函数。
递归的时间复杂度:O(h)。
迭代的时间复杂度:O(1)。
c
*BSTNode IterFind(BSTree BST, ElemType X){
    while(BST) {
        if(X > BST->data)
            BST = BST->rchild; //向右子树中移动,继续查找
        else if(X < BST->data)
            BST = BST->lchild; //向左子树中移动,继续查找
        else // X == BST->Data
            return BST; //查找成功,返回结点的找到结点的地址
    }
	 return NULL; //查找失败
}
或者写为:
c
*BSTNode IterFind(BSTree BST, ElemType X){
    while(BST!=NULL && X!=BST->data) {
        if(X > BST->data)
            BST = BST->rchild; //向右子树中移动,继续查找
        else if(X < BST->data)
            BST = BST->lchild; //向左子树中移动,继续查找
    }
    //最后在叶子结点还是没有找到,那么就会继续向下使得BST=NULL
	 return BST;
}
1.3.1查找最大和最小元素
①最大 元素一定是在树的最右 分枝的端结点上。 ②最小 元素一定是在树的最左分枝的端结点上。
根据上述两点,我们可以很轻松的把代码(两种方式)写出来:
c
//方法1:递归
*BiTNode FindMin(BinTree BST){
	 if(!BST) return NULL; //空的二叉搜索树,返回NULL
	 else if(!BST->lchild)
	 	return BST; //找到最左叶结点并返回
	 else
	 	return FindMin(BST->lchild); //沿左分支继续查找
}
*BiTNode FindMax(BinTree BST){
	 if(!BST) return NULL;
	 else if(!BST->rchild)
	 	return BST;
	 else
	 	return FindMin(BST->rchild);
}


//方法2:迭代函数
*BiTNode FindMin(BinTree BST){
	 if(BST)
	 	while(BST->lchild)  //沿右分支继续查找,直到最右叶结点
	 		BST = BST->lchild;
	 return BST;
}
*BiTNode FindMax(BinTree BST){
	 if(BST)
	 	while(BST->rchild)  //沿右分支继续查找,直到最右叶结点
	 		BST = BST->rchild;
	 return BST;
}
1.4插入
有了二叉排序树的查找函数,那么所谓的二叉排序树的插入,其实也就是将关键字放到树中的合适位置而已。
时间复杂度为 O(log n),其中 n 是树中节点的个数。
c
BiTree Insert(BiTree &BST, ElemType X){
    if(!BST){ //若原树为空,生成并返回一个结点的二叉搜索树
        BST = (BiTree)malloc(sizeof(struct BiTNode));
        BST->data = X;
        BST->lchild = BST->rchild = NULL;
    }
    else { //开始找要插入元素的位置
        if(X < BST->data)
            BST->lchild = Insert(BST->lchild, X);//递归插入左子树
        else if(X > BST->Data)
            BST->rchild = Insert(BST->rchild, X);//递归插入右子树
        //else X已经存在,什么都不做
    }
    return BST;
}
1.4.1插入构造二叉排序树
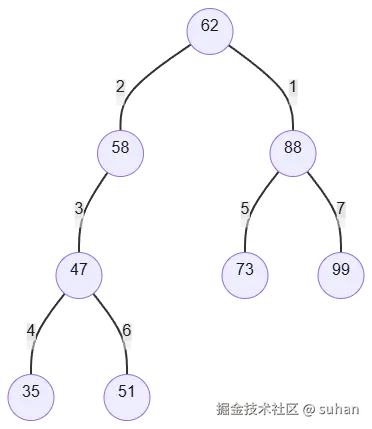
有了二叉排序树的插入代码,我们要实现二叉排序树的构建就非常容易了,几个例子:
c
int n=8;
int a[8] = {62, 88, 58, 47, 35, 73, 51, 99};
BSTree T;
CreateBST(T, a[], n);

//----------------------------------------
CreateBST(BSTree &T, int a[], int n){
    T=NULL;
    for(int i=0; i<10; i++){
        Insert(&T, a[i]);
}
上面的代码就可以创建一棵下图这样的树。
1.5删除
删除的结点有三种情况:
- 叶子结点 :
- 只需删除该结点不需要做其他操作。
- 仅有左或右子树的结点 :
- 删除后需让被删除结点的直接后继接替它的位置。
- 左右子树都有的结点 :
- 此时我们需要遍历得到被删除结点的直接前驱或者直接后继(一般是右子树的最小结点,即右子树的中序第一个子女),来接替它的位置,然后再删除那个最小的子女。
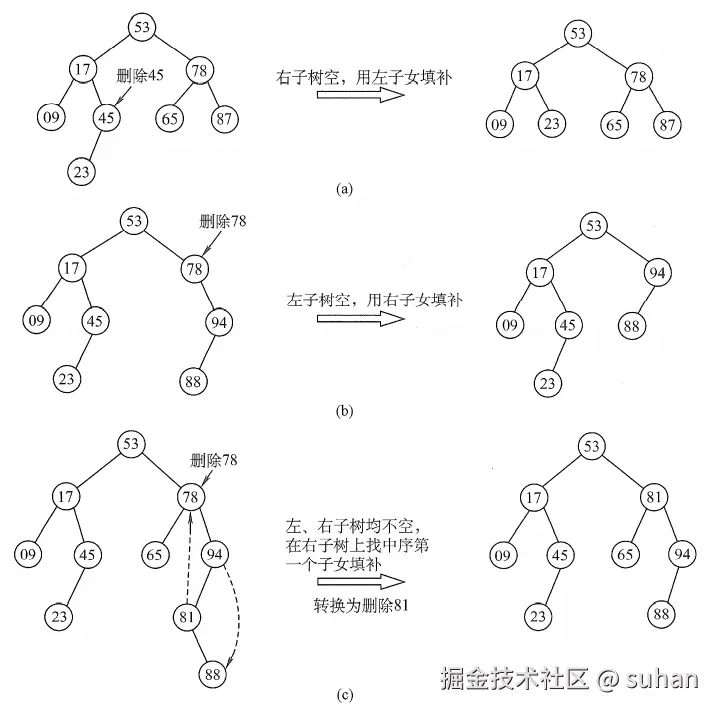
时间复杂度为 O(log n),其中 n 是树中节点的个数。
c
BiTree Delete(BiTree BST, ElemType X) {
    *BiTNode Tmp;
    if(!BST)
        printf("BST is NULL");
    else {
        if(X < BST->data)
            BST->lchild = Delete(BST->lchild, X);//从左子树递归删除
        else if(X > BST->data)
            BST->rchild = Delete(BST->rchild, X);//从右子树递归删除

        //BST就是要删除的结点
        else {
            //如果被删除结点有左右两个子结点
            if(BST->lchild && BST->rchild)
            {
                //从右子树中找最小的元素填充删除结点
                Tmp = FindMin(BST->rchild);
                BST->data = Tmp->data;
                //从右子树中删除最小元素
                BST->rchild = Delete(BST->rchild, BST->data);
            }
            //被删除结点有一个或无子结点
            else
            {
                Tmp = BST;
                if(!BST->lchild)    //只有右孩子或无子结点
                    BST = BST->rchild;
                else                //只有左孩子
                    BST = BST->lchild;
                free(Tmp);
            }
        }
    }
    return BST;
}
1.6性能分析
二叉排序树的优点明显,插入删除的时间性能比较好。而对于二叉排序树的查找,走的就是从根结点到要查找的结点的路径,其比较次数等于给定值的结点在二叉排序树的层数。
极端情况,最少为1次,即根结点就是要找的结点;最多也不会超过树的深度。也就是说,二叉排序树的查找性能取决于二叉排序树的形状(深度)。可问题就在于,二叉排序树的形状是不确定的。
例如 {62 , 88 , 58 , 47 , 35 , 73 , 51 , 99 , 37 , 93} 这样的数组,我们可以构建如下左图的二叉排序树。但如果数组元素的次序是从小到大有序,如{35,37,47,51,58,62,73,88,93,99},则二叉排序树就成了极端的右斜树,如下面右图的二叉排序树:
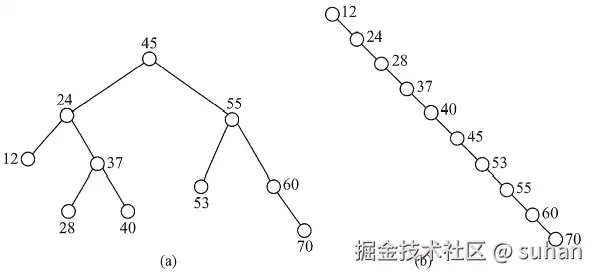
也就是说,我们希望**二叉排序树是比较平衡(左子树和左子树的高度之差不超过1)**的,即其深度与完全二叉树相同,那么查找的时间复杂也就为 O(log n),近似于折半查找。
不平衡的最坏情况就是像上面右图的斜树(高度为n),查找时间复杂度为 O(n),这等同于顺序查找。
因此,如果我们希望对一个集合按二叉排序树查找,最好是把它构建成一棵平衡的二叉排序树。