obra/superpowers,一个给 Claude Code 装技能的仓库,30 万 star。我第一次刷到这个数的时候以为是看错了,又去仓库页抓了一遍 stargazerCount:300,156。这是 2026 年 10 月 16 日的快照。
同一个下午我把头部仓库挨个过了一遍:anthropics/skills,官方的,181,447 star、21.5k fork;mattpocock/skills,293,200;affaan-m/ECC,280,632;multica-ai/andrej-karpathy-skills,220,151。往下还有 ui-ux-pro-max-skill 的 136,331、caveman 的 112,788。这数一个比一个离谱,但都是真的。
图:GitHub 为 anthropics/skills 官方仓库自动生成的品牌卡,白底,标注「Public repository for Agent Skills」及 181k stars / 21k forks / 407 issues / 98 discussions / 17 contributors(图源:GitHub 官方仓库 anthropics/skills(og:image 社交卡) opengraph.githubassets.com/e1fe05dfc11...
热度不是问题。问题是我的技能列表装到后来挂了四十多条 description,每次会话都背着,真正被触发过的不到五条。这篇就是我删完之后剩下的东西,哪些值得装、哪些千万别装,一次说清。
安装次数没有任何公开口径,star 数、awesome 榜单位次全是代理指标。下面所有数字都只说明「这一天它有多少 star」,不说明「有多少人真在用」。
机制不过一遍,取舍没得谈
Skill 的本体就是一个文件夹,里面必须有一个 SKILL.md,YAML frontmatter 起头,name 和 description 必填。按 agentskills.io 的规范:name 是 1 到 64 个字符,只允许小写字母、数字和连字符,不能拿连字符开头结尾;description 非空,上限 1024 字符;可选的 compatibility 描述环境要求,上限 500 字符;还有个 allowed-tools 用来预授权工具,目前标着 Experimental,我不指望它短期稳定。scripts/、references/、assets/ 三个子目录都是可选的。
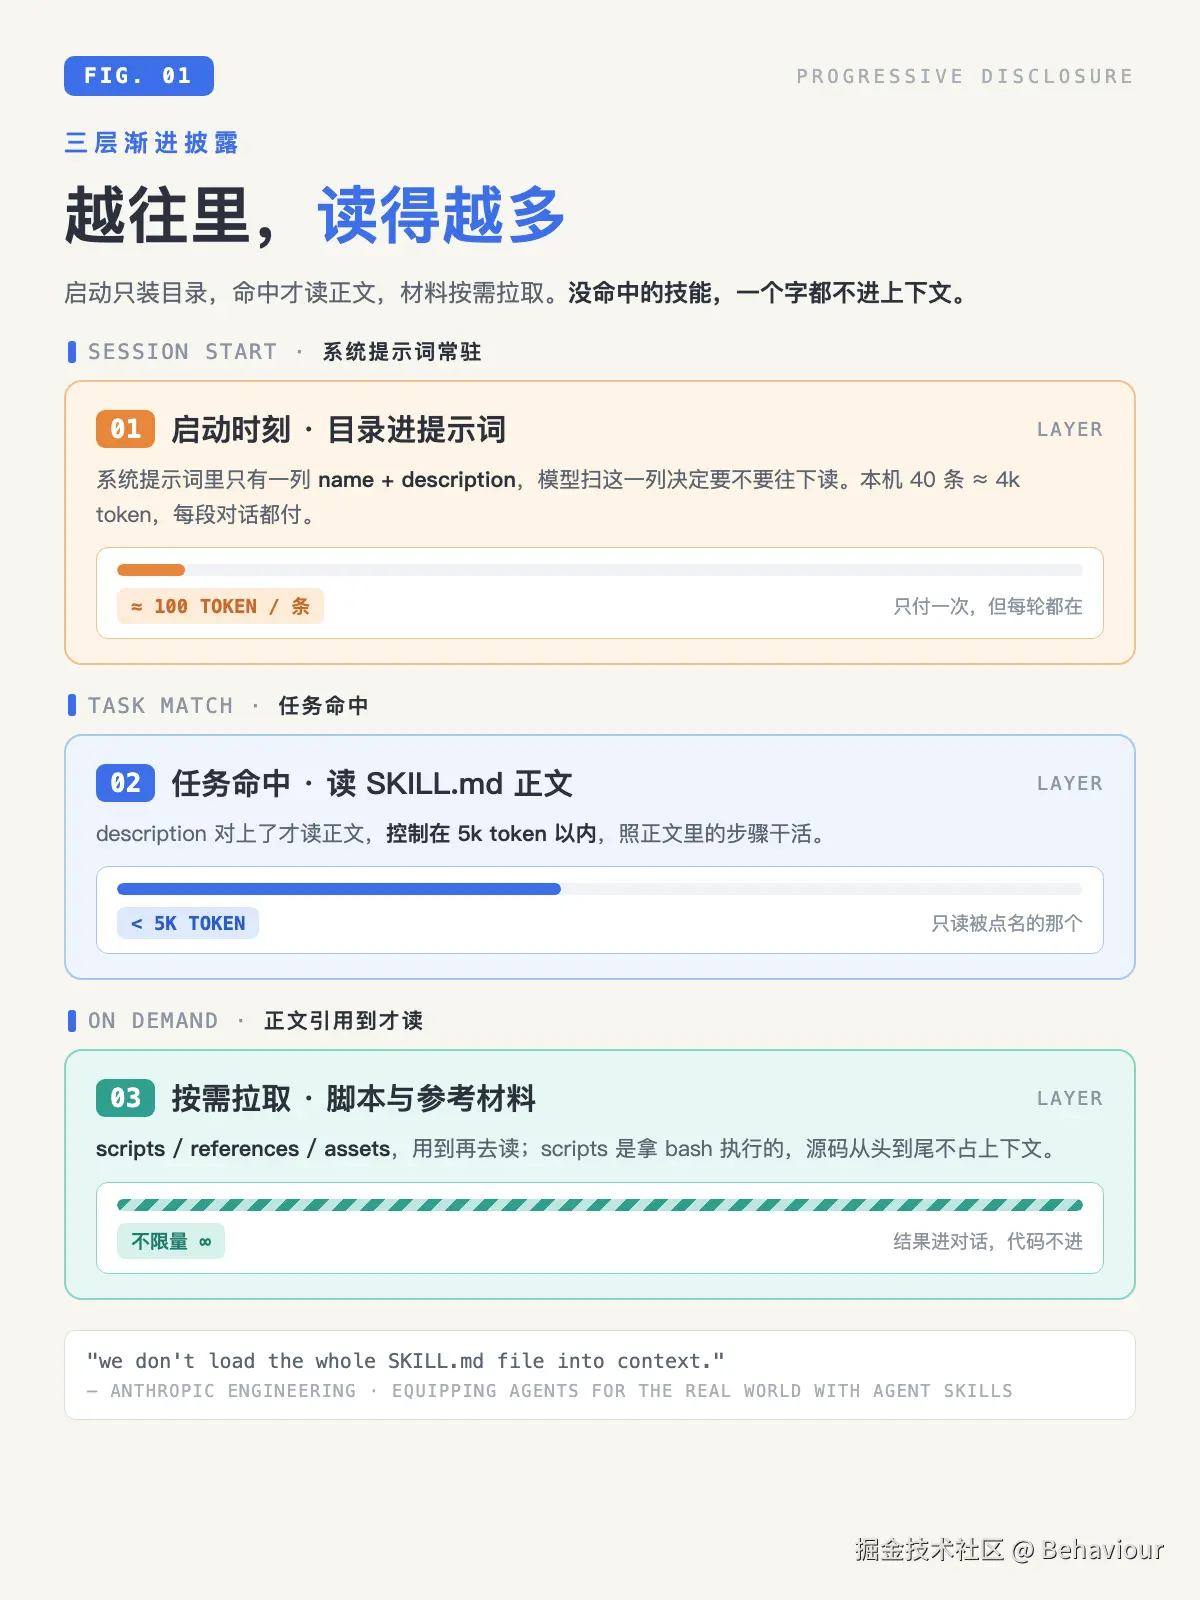
真有讲究的是加载方式。Anthropic 工程博客那篇讲得很直白,分三层:
第一层,启动时只把所有技能的 name 和 description 塞进系统提示词,一个大约 100 token;第二层,任务命中了才读 SKILL.md 正文,控制在 5k token 以内;第三层,正文里引用的脚本和参考材料,用到再去读,不限量。原话是 "we don't load the whole SKILL.md file into context";scripts 是拿 bash 执行的,内容根本不进上下文。
走一遍实际发生的顺序更直观。我对 Claude Code 说「把这篇 docx 转成 Obsidian 笔记」:它先扫系统提示词里那列 description,发现 docx-to-obsidian 对得上,于是去读这个技能的 SKILL.md 正文,照正文里的步骤干活;正文让它调 scripts/ 下的转换脚本,脚本跑完,输出直接进对话,脚本源码从头到尾没占过上下文。整个过程里,没命中的那几十个技能一个字都没被读过。
这笔账值得算一下。我机器上现在挂着四十多条技能描述:自己写的 12 个 SKILL.md,superpowers 插件全家桶十几个,再加官方 marketplace 的几个,常驻开销粗算 4k token 上下。4k 不致命,但它是每一段对话都要付的固定成本,跟你在干什么无关。装 100 个技能的人,光目录就吃掉 10k。这还只是 token 的账,更要命的是触发互相抢:两条 description 写得像的技能,模型挑哪个看运气。
skill、MCP、CLAUDE.md 这三条界限,新用户最容易糊。MCP 是给模型接能力,调 API、连数据库;skill 是给模型塞程序性知识,「遇到这类任务按这套步骤做」;CLAUDE.md 是常驻规则,每一轮都在场。我的分法很朴素:永远适用的规则写 CLAUDE.md,特定任务才用的才值得做成 skill。
装与写:命令都在这
官方仓库的安装就三行,README 原文照抄:
bash
/plugin marketplace add anthropics/skills
/plugin install document-skills@anthropic-agent-skills
# 或者装示例合集
/plugin install example-skills@anthropic-agent-skills
document-skills 是 docx、pdf、pptx、xlsx 四个文档技能(source-available),example-skills 是示例合集。装完不需要任何特殊指令,自然语言点名就行,README 给的例子是 "Use the PDF skill to extract the form fields from path/to/some-file.pdf",从提问到拿到表单字段列表就这一句话的事。不记得名字,去 /plugin 里走 Browse and install plugins 翻也行。
superpowers 已经进了 Claude 官方插件市场,一行搞定:
bash
/plugin install superpowers@claude-plugins-official我装的是 5.0.7,今年 4 月底装上一直在用。它的老社区源还保留着:/plugin marketplace add obra/superpowers-marketplace,再 /plugin install superpowers@superpowers-marketplace。
有意思的是它的 README 同时给了 Codex 官方插件市场入口、droid 的 plugin marketplace add、agy 的 plugin install 三种写法。这是「skill 跨智能体通用」最硬的证据:SKILL.md 就是个 Markdown 文件,规范站在 agentskills.io,Claude Code、Codex、OpenClaw 谁都能读同一份。
不走插件、直接建目录也行,我大部分自建技能都是这么放的:
bash
~/.claude/skills/kb-lookup/SKILL.md     # 用户级,所有项目可用
.claude/skills/toutiao-topic-essay/SKILL.md   # 项目级,只在这个仓库生效
插件和 skill 是什么关系?skill 是内容单位,插件是打包分发的方式。我装的 superpowers 就是个插件,拆开里面十几个技能(brainstorming、test-driven-development、systematic-debugging、writing-plans),在会话里都带 superpowers: 前缀。一个插件能不能只装其中一个技能,现在不行,只能整包进。
自己写一个最小的,十分钟的事:
bash
mkdir -p ~/.claude/skills/my-skill
cat > ~/.claude/skills/my-skill/SKILL.md <<'EOF'
---
name: my-skill
description: 把触发条件写清楚,模型靠这一行决定用不用你
---

# 怎么做

1. 第一步做什么
2. 第二步做什么
EOF
骨架也可以让 skill-creator 生成,官方仓库 skills/ 目录里就带。但有一句实话得说:description 才是一个 skill 的命。模型第一层只看得见 name 和 description,写得含糊,这技能就永远不会被触发;写得太宽,又会在不相干的任务里乱跳。
举个例子。「查项目历史决策」这种 description,看着清楚,实际废的------「历史」「决策」这些词太泛,模型判断不了。我自己 kb-lookup 的 description 是这么写的:vault 路径、调用哪个 MCP、BM25 加向量加 RRF 的检索方式,然后一串触发场景:项目历史决策、过往踩坑、设计依据、Code Review 结论、可复用代码片段,还特意写了「这些信息外网搜不到」。关键词是照着「用户嘴上会怎么说」去铺的,中英文都铺。写完别急着交付,换个说法问它两句,看触不触发、有没有跟别的技能抢。
几个踩过的坑。SKILL.md 正文别写太长,5k token 的第二层预算超了,渐进披露就白设计了。我知识库项目里那几个长的(article-covers 151 行、docx-to-obsidian 134 行、csdn-publish 123 行),后来都把细节挪去了 references/ 和 scripts/,正文只留流程,最短的 frontend-design 只有 42 行,照样好使。脚本一律放 scripts/,别把代码贴正文里,脚本执行不占上下文。name 别用大写和下划线,规范里写死了只收小写字母、数字、连字符。还有一条最不起眼:会产出文件的技能,给它划个固定的 workspace 目录,不然项目根目录早晚被塞满,我现在这个项目里就躺着一个 toutiao-topic-essay-workspace,那技能自己生成的。
我留下的,和我不装的
选型之前先看别人怎么选。翻各家推荐时有个细节我记得牢:最先被安利的往往是 simple-english、grill-with-mocks、unslop 这类小切口技能,一个技能只干一件事,名字就是说明书。这些我没都装,但这个取向我认。反过来,几万 star 的大而全仓库,装的时候很爽,用的时候想不起来。
必装只有一档:superpowers 这类方法论框架。brainstorming、test-driven-development、systematic-debugging、writing-plans,内容是方法论,不绑定任何具体 API,过时得慢。它跟 CLAUDE.md 有重叠,但粒度细得多------CLAUDE.md 只告诉你 TDD 好,它的 skill 告诉你先写哪个测试、红灯绿灯怎么走。
图:GitHub 仓库 obra/superpowers 品牌卡:An agentic skills framework & software development methodology that works,300k Stars / 27k Forks / 60 位贡献者(图源:GitHub github.com/obra/superp...)
场景必装,按需开:
- skill-creator:写 skill 的 skill,官方仓库 skills/ 目录里就带。生成骨架、跑 eval、调 description 的触发准确率都管。第一次写 skill 别对着规范干瞪眼,拿它起手快得多,本机就装着一份。
- grill-me:RobMitt/grill-me-skill(952 star)。动手之前不停拷问你,问到需求真正对齐为止。AI 编程最贵的浪费是揣着一堆错误假设闷头跑,这技能治的就是这个。star 不多,胜在小而准。
- OpenSpec:Fission-AI/OpenSpec(72,095),规格驱动开发(SDD),先落规格再让 AI 动手,改了什么有据可查。跟 superpowers 不冲突,一个管方法论,一个管需求到规格那段路。
- 官方 document-skills:要处理 docx/pdf/pptx/xlsx 就是刚需,来源是官方,安全审查这一步可以直接省。
- show-me:humanlayer/skills 里的,Matt Pocock 点名推荐过的那个,用伪代码、调用树、组件树、文件树、Mermaid 流程、时序图、Diff、HTML 八种小图解释技术概念。写架构文档的时候真好用。
- caveman(112,788):省 token 向的,涨得凶,当天的快照里记着它单日涨了 433 个 star。我没长期用,长上下文敏感的场景再考虑。
图:GitHub 仓库 Fission-AI/OpenSpec 品牌卡:Spec-driven development (SDD) for AI coding assistants,72k Stars(图源:GitHub github.com/Fission-AI/...)
图:GitHub 仓库 RobMitt/grill-me-skill 品牌卡:interview the user relentlessly until reaching shared understanding,952 Stars(图源:GitHub github.com/RobMitt/gri...)
观望不装的也说三条。
ECC,280,632 star。这个数说明它确实击中了什么,但我到现在说不清它替我做了哪些决定。一个说不清边界的重框架,出了问题你得排障排到 skill 里去,我不愿意付这个成本。
multica-ai/andrej-karpathy-skills,220,151。不是不好,是重复。它把 Karpathy 那套 AI Coding 原则(编码前思考、简洁优先、精准修改、目标驱动)做成了一个 skill。我项目 CLAUDE.md 里那四条规则跟它几乎一一对应,这种永远适用的原则,贴在 CLAUDE.md 里常驻比做成 skill 更合适,做成 skill 反而多一层「这次会不会被触发」的不确定。
图:GitHub 仓库 multica-ai/andrej-karpathy-skills 品牌卡:A single CLAUDE.md file to improve Claude Code behavior,220k Stars / 22k Forks / 8 位贡献者(图源:GitHub github.com/multica-ai/...)
网上一些流传的稿子还停在旧数据,写着它原来的 forrestchang 仓库和 66.7k star。仓库已经迁到 multica-ai 组织了,两个名字现在都是 220,151。搜 skill 资料时,旧数据比没数据更害人。
安全这道坎,别跳过去
整篇我就想让人记住一句话:把第三方 skill 当不信任的第三方代码。
Trend Micro Research 那篇《When Skills Become Liabilities: Prompt Injection in Claude Code》给了实战案例:藏在 SKILL.md 里的注入文本,进入上下文之后会被模型当可信指令,能静默覆盖正常行为,他们的演示是让 Claude Code 去读 .env 这类敏感文件并外传。更麻烦的一条:skill 里带 API 调用的 JS 可以绕过 allowed-tools 白名单,等于任意命令执行。
我的规矩就三条,也够用:装前把 SKILL.md 全文和 scripts/ 下每个脚本读一遍;只装可信来源:官方的、认识的人维护的、star 高且我读过代码的;读完觉得不对就不装,star 数救不了你。
圈子里流传很广的一条说法是,OpenClaw 生态装任何第三方 skill 前先装个叫 Skill Vetter 的安全技能。我去 GitHub 核了一下:搜 "skill-vetter",首个同名仓库是 app-incubator-xyz/skill-vetter,61 个 star,main 分支 README 还是 404。这个推荐我写不进清单。「装前先审查」的思路完全对,但我找不到一个配得上「必装」二字的实名仓库。现阶段,审查这活儿还得自己干。
还有个更社会性的争议,叫「同事.skill」:有人把老工程师的工作经验打包成 skill 分享,评论区吵翻了,经验被做成 skill 之后还算不算那个人的东西,被 AI 学走之后归谁。这个没有答案。它只提醒了一件事:你写进 SKILL.md 的每一句话,都得当成打算公开的来写。
收个尾
skill 生态现在像早期的 npm:规范刚定型,官方仓库当了样板,一夜之间冒出一堆十万 star 级的仓库。npm 后来靠 lockfile 和审计收拾了供应链问题,skill 这边连个像样的版本锁定都没有------上游改名、迁移、删库,你本地那份就永远是旧的四原则。
我留下的这几个,一个月后大概还会再删一两个。真正悬着的就一个问题:description 的常驻成本线性涨,触发又互相抢,这笔账现在没人替你算。四十条的时候还行,等哪天到一百条,第一层那 10k token 花得值不值,得有人给出比「装就完了」更认真的答案。
参考链接
- GitHub:anthropics/skills 仓库 README 与官方安装命令 github.com/anthropics/...
- GitHub:obra/superpowers 仓库 README,官方市场与 Codex/droid 安装方式 github.com/obra/superp...
- Anthropic 工程博客:用 Agent Skills 装备真实世界的智能体,三层渐进披露与 token 量级 www.anthropic.com/engineering...
- agentskills.io:Agent Skill 规范,name/description 硬参数与目录约定 agentskills.io/specificati...
- Claude Code 官方文档:Skills code.claude.com/docs/en/ski...
- Trend Micro Research:Claude Code 的 skill 提示注入实战案例 www.trendmicro.com/en_us/resea...
- GitHub:multica-ai/andrej-karpathy-skills,Karpathy 四原则与仓库迁移 github.com/multica-ai/...
- GitHub:ComposioHQ/awesome-claude-skills,收录 1000+ 条目的技能索引 github.com/ComposioHQ/...
- GitHub:Fission-AI/OpenSpec,规格驱动开发工具 github.com/Fission-AI/...
- GitHub:RobMitt/grill-me-skill,需求拷问技能 github.com/RobMitt/gri...