在 Amazon Bedrock AgentCore Runtime 中,每个会话都运行在独立的执行环境中,拥有各自的 CPU、内存和磁盘。最简单的 LangGraph Agent 通常将对话历史保存在内存中,将工作文件保存在本地磁盘上。一旦 AgentCore 停止执行环境,这两部分数据都会丢失。默认情况下,会话空闲 15 分钟后,执行环境就会停止。会话 ID 仍然有效,但下一次使用这个 ID 发起调用时,AgentCore 会创建一个新的环境,其中没有之前的对话历史和工作文件。
因此,当 Agent 回答错误,或者写出的文件存在问题时,等到开始排查,相关信息可能已经不在了:这一轮究竟向模型发送了什么?哪个工具的返回结果影响了模型的判断?工具实际修改了哪些内容?
本文在 AgentCore Runtime 上运行一个 LangGraph Agent,并使用 Apache SkyWalking AI Sessionizer 在运行过程中记录每轮交互。执行记录、模型调用和工具调用通过 LangChain 自带的追踪客户端采集;工具产生的文件变更则由一个轻量的记录工具采集。Sessionizer 作为独立服务长期运行,因此即使会话的执行环境已经停止,记录仍然可以查看。接入过程不需要修改 Agent 的业务逻辑,只需调整运行时环境配置,并在镜像中安装相应的软件包。
本文中的部署和测试于 2026 年 10 月 10 日在 AWS us-east-1 区域完成,使用 Amazon Bedrock 上的 Amazon Nova Pro 模型。全部资源由一套 OpenTofu 配置管理,代码位于 wu-sheng/aws-agentcore-asz-demo。 上一篇文章(也发布于 AWS Builder Center)介绍了如何记录运行在本地电脑上的 Agent,本文将同样的方式应用到 AgentCore。
通过配置接入 Sessionizer
示例中的 Agent 是一个用 LangGraph 实现的"部署顾问",包含六个工具。其中, search_docs 、 check_deployment 和 estimate_cost 用于查询信息; clone_demo_repo 、 read_file 和 write_file 用于操作会话环境中的示例仓库副本。
代码中与 AgentCore 直接相关的部分只有入口函数,这是任何部署到 AgentCore 的 Agent 都需要提供的。下面是从示例的 agent/app.py 中摘取并简化的代码:
Python
python
from bedrock_agentcore.runtime import BedrockAgentCoreApp, BedrockAgentCoreContext
from langchain_core.messages import HumanMessage


graph = build_graph()   # 使用 Nova Pro 和六个工具,编译时配置 InMemorySaver
app = BedrockAgentCoreApp()


@app.entrypoint
def invoke(payload: dict) -> dict:
    # 一个 AgentCore 运行时会话对应一段完整对话。
    thread_id = payload.get("thread_id") or BedrockAgentCoreContext.get_session_id()
    result = graph.invoke(
        {"messages": [HumanMessage(payload["prompt"])]},
        config={"configurable": {"thread_id": thread_id},
                "metadata": {"thread_id": thread_id}},
    )
    return {"thread_id": thread_id, "answer": result["messages"][-1].text}
这段代码中没有 Sessionizer 接入逻辑。记录功能依赖 LangChain 已有的两项能力:随 langchain-core 安装的 langsmith 追踪客户端,以及 LangChain 的回调机制。通过运行时环境变量即可启用:
HCL
ini
environment_variables = {
  # 记录对话中的执行过程、模型调用和工具调用。
  LANGSMITH_TRACING  = "true"
  LANGSMITH_ENDPOINT = "http://${aws_lb.ingest.dns_name}:1985"
  LANGSMITH_API_KEY  = random_password.asz_ingest_token.result
  LANGSMITH_PROJECT  = "aws-agentcore-asz-demo"
  # 记录工具对文件的修改。
  ASZ_CHANGES        = "true"
  ASZ_WATCH          = "/home/agent/workspace"
  ASZ_CHANGES_DATA   = "/mnt/changes"
}
前四个变量将追踪客户端原本发往 LangSmith 云端的数据发送到 Sessionizer 接收端。配置方式与本地运行时相同,只是接收地址不同。后三个变量用于启用文件变更记录。
镜像中还需要包含从 Sessionizer 源码构建的 asz-changes ,以及一个轻量的 LangChain 适配包。适配包通过 pip 安装,再用 asz-langchain enable 启用,应用代码不需要导入它。
Python 解释器启动时,适配包会注册一个回调,在配置中指定的工具执行前后分别运行 asz-changes 。本例只监控 write_file 。 asz-changes 将检测到的文件变更写入一个目录,供 Sessionizer 读取。
Agent 需要提供的是对话标识。在 AgentCore 上,这个标识就是调用方传入的运行时会话 ID。Agent 从请求中取得该 ID,将其作为 LangGraph 的 thread_id ,同时写入执行记录的元数据。
这样,Agent 原有的业务逻辑、框架和模型调用方式都可以保留,接入工作集中在运行时配置和镜像依赖上。
Agent 和 Sessionizer 的部署方式
Agent 内部的追踪客户端不需要感知 AgentCore。与本地部署相比,需要调整的是它周围的部署环境,主要有四个方面。
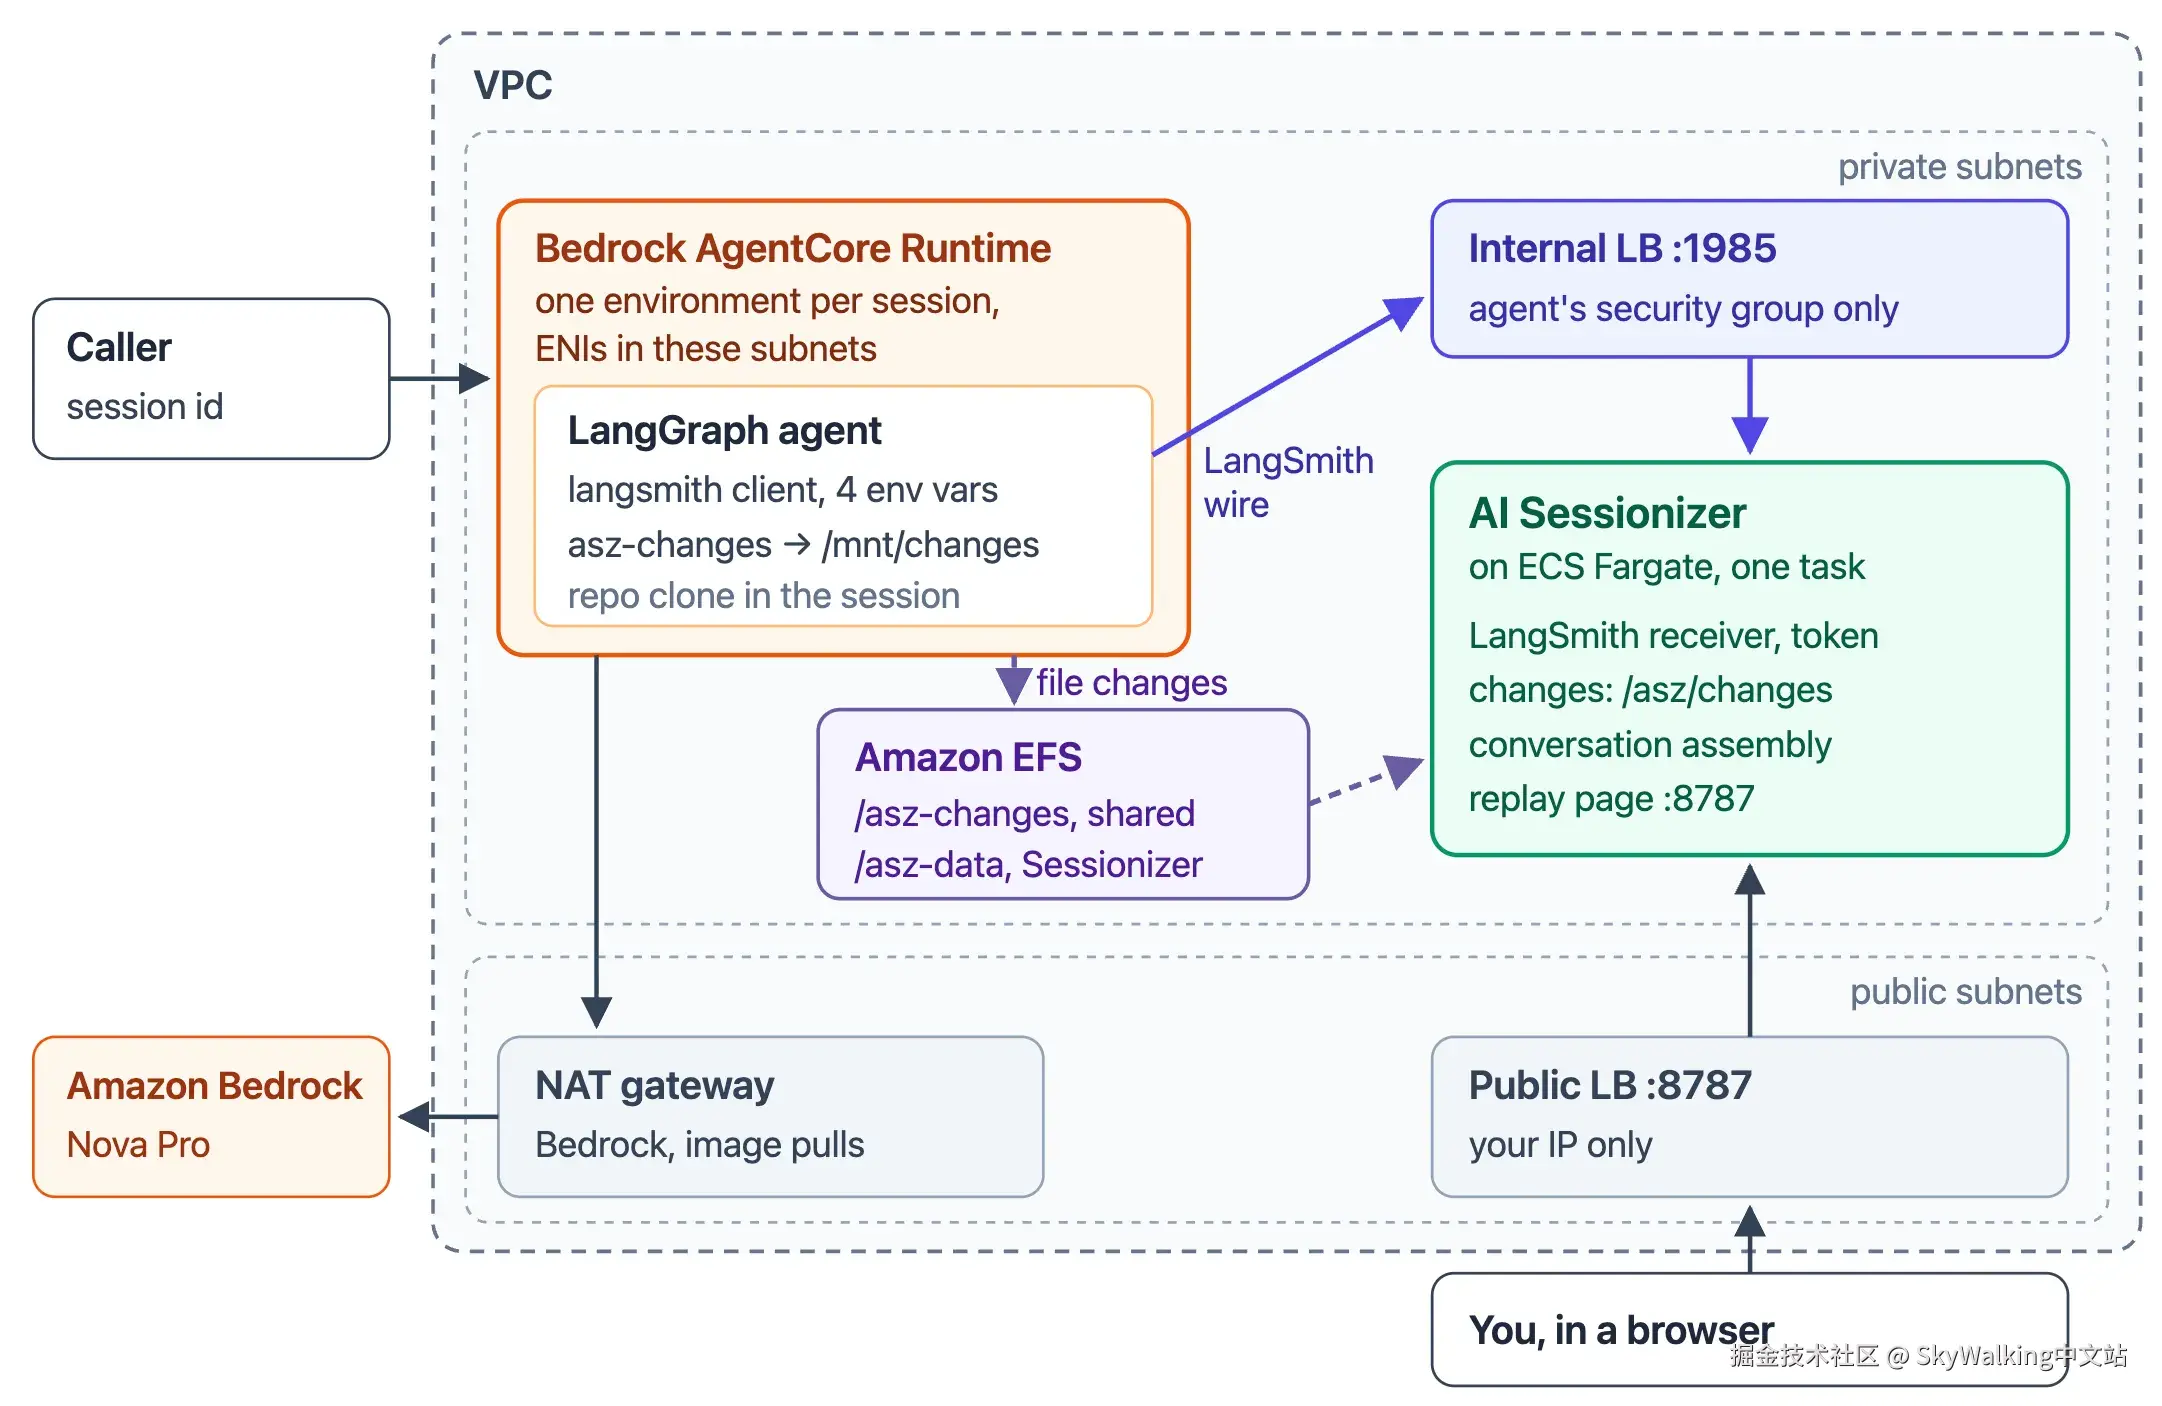
- Sessionizer 需要独立部署。 AgentCore Runtime 为每个 Agent 运行一个镜像,并为每个会话创建独立的执行环境,这里没有可用的 sidecar 部署方式。会话的执行环境会被回收,而 Sessionizer 需要长期运行,持久保存记录并提供回放页面。因此,两者作为独立服务运行,本例将 Sessionizer 部署为一个使用 AWS Fargate 的 Amazon Elastic Container Service(ECS) 任务。
127.0.0.1指向当前会话的执行环境。 AgentCore 的 VPC 模式会将 Agent 的网络接口放入指定的 Amazon Virtual Private Cloud(VPC) 子网,因此可以将 Sessionizer 接收端放在内部 Application Load Balancer(ALB) 后面,只允许 Agent 所在的安全组访问。
- 文件变更通过共享存储传递。
asz-changes在 Agent 一侧写入变更记录,Sessionizer 在另一侧读取。两者通过 AWS 托管的网络文件系统 Amazon Elastic File System(EFS) 共享目录,在 VPC 内使用 NFS 挂载。AgentCore 将一个 EFS access point 挂载到每个会话环境的/mnt/changes,Sessionizer 则将同一目录挂载到/asz/changes。双方通过共享目录交换数据,无需访问对方的本地文件系统。
- 会话 ID 用于关联完整对话。 调用方负责保存会话 ID:可以自行生成一个至少 33 个字符的 ID,也可以使用 AgentCore 首次调用返回的 ID。后续属于同一段对话的调用都携带这个 ID。AgentCore 会将使用相同 ID 的调用路由到同一个会话;即使执行环境因空闲而停止,ID 仍然有效。Agent 使用
BedrockAgentCoreContext.get_session_id()读取请求中的 ID,并将其作为 LangGraph 的对话线程标识。这样,一个 AgentCore 会话就对应 Sessionizer 中的一段完整对话。
配置 AWS 资源
示例仓库 使用 OpenTofu 部署图 1 中的全部组件,包括 Agent。AWS provider 6.x 提供了 aws_bedrockagentcore_agent_runtime 资源,因此可以在同一份 OpenTofu 状态中管理运行时、网络、存储和接收端。除了前面的环境变量,还需要为运行时配置网络和共享目录:
Terraform
ini
resource "aws_bedrockagentcore_agent_runtime" "agent" {
  # ...
  network_configuration {
    network_mode = "VPC"
    network_mode_config {
      subnets         = aws_subnet.private[*].id
      security_groups = [aws_security_group.agent.id]
    }
  }


  filesystem_configuration {
    efs_access_point {
      access_point_arn = aws_efs_access_point.changes.arn
      mount_path       = "/mnt/changes"
    }
  }
}
Sessionizer 使用已发布的多架构镜像,在一个 ECS Fargate 任务中运行,并启用两个适配器: langsmith-ingest 接收对话执行数据, changes 读取文件变更。
YAML
yaml
storage:
  root: /asz/data
adapters:
  - name: langsmith-ingest
    enabled: true
    listen: 0.0.0.0:1985
    token: <generated>
    collector: { mode: watch, interval: 30s }
  - name: changes
    enabled: true
    source_root: /asz/changes
    collector: { mode: watch, interval: 30s }
以下几个配置细节会直接影响部署是否能正常工作:
- 接收端的端口和监听地址。 接收端是独立的适配器,默认关闭,使用
1985端口。回放页面使用的8787端口不接收追踪数据。接收端默认监听127.0.0.1:1985,负载均衡器无法访问容器内的这个地址,因此需要改为0.0.0.0。本例还将接收数据的整理周期从默认的 10 分钟缩短为 30 秒。
- 共享目录的文件权限。 EFS access point 将文件写入身份统一为 UID
65532,与 Sessionizer 的运行用户一致,因此 Agent 写出的文件归 Sessionizer 所用的用户所有。按照 AgentCore 指南,执行角色需要对文件系统拥有elasticfilesystem:ClientMount和ClientWrite权限,并通过条件限制到指定的 access point。此外,CreateAgentRuntime还会检查elasticfilesystem:DescribeAccessPoints和DescribeMountTargets。指南没有列出这两个权限,而创建接口检查它们时也不指定资源,因此只授权到具体文件系统的策略无法通过检查。示例将这两个只读操作的资源范围设为*。
- 每段对话使用独立的工作目录。
asz-changes按被监控目录的路径保存变更基线,而所有会话又共享它的数据目录。如果不同会话使用相同的工作目录路径,新会话第一次执行被监控工具时,就可能与另一个会话留下的基线进行比较。示例为每段对话分配独立目录,并在每轮交互时将ASZ_WATCH指向对应目录。
- Agent 镜像需要放入 ECR。 AgentCore 只运行来自 Amazon Elastic Container Registry(ECR) 的镜像。示例镜像由 GitHub Actions 构建和发布,再由
up.sh复制到当前 AWS 账户的 ECR 中。
本例用于演示,部分配置还需要在团队部署时调整。回放页面使用普通 HTTP,通过负载均衡器限制为仅允许你的 IP 访问,页面本身没有登录功能。接收端令牌保存在环境变量中,实际部署时应使用 AWS Secrets Manager 管理。另外,Agent 的对话状态仍然只保存在内存中, 后文会说明它的影响。
将多次调用关联为一段对话
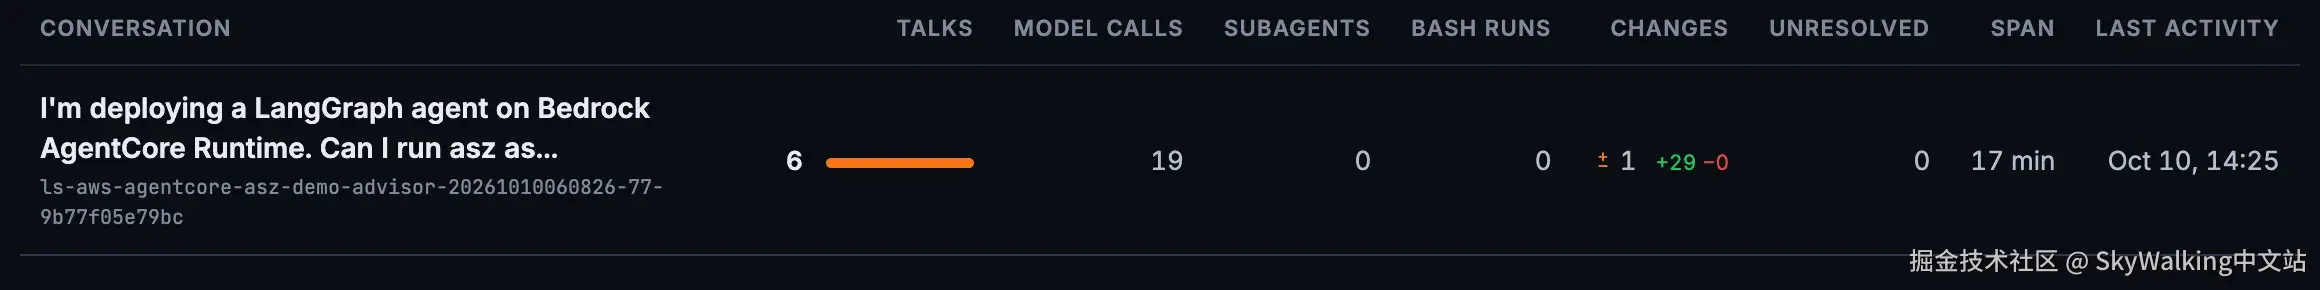
示例没有实现聊天应用,而是使用 invoke.sh 模拟单个用户的客户端。脚本先创建一个会话 ID,然后通过 aws bedrock-agentcore invoke-agent-runtime 依次发送五个预设问题,每次都使用同一个 --runtime-session-id 。间隔较长时间后,再使用同一个会话 ID,以相同方式发送第六个问题。每个问题都对应一次独立调用,但在 Sessionizer 中,它们会被归入同一段对话,对话标识由项目名和会话 ID 组成。
在实际应用中,会话管理由 Agent 外层的应用负责:为每个用户的每段对话保存一个会话 ID,每次发送消息时携带它,需要开始新对话时再创建新的 ID。AgentCore 不负责建立用户与会话之间的映射,Agent 本身也只是读取当前请求携带的 ID。
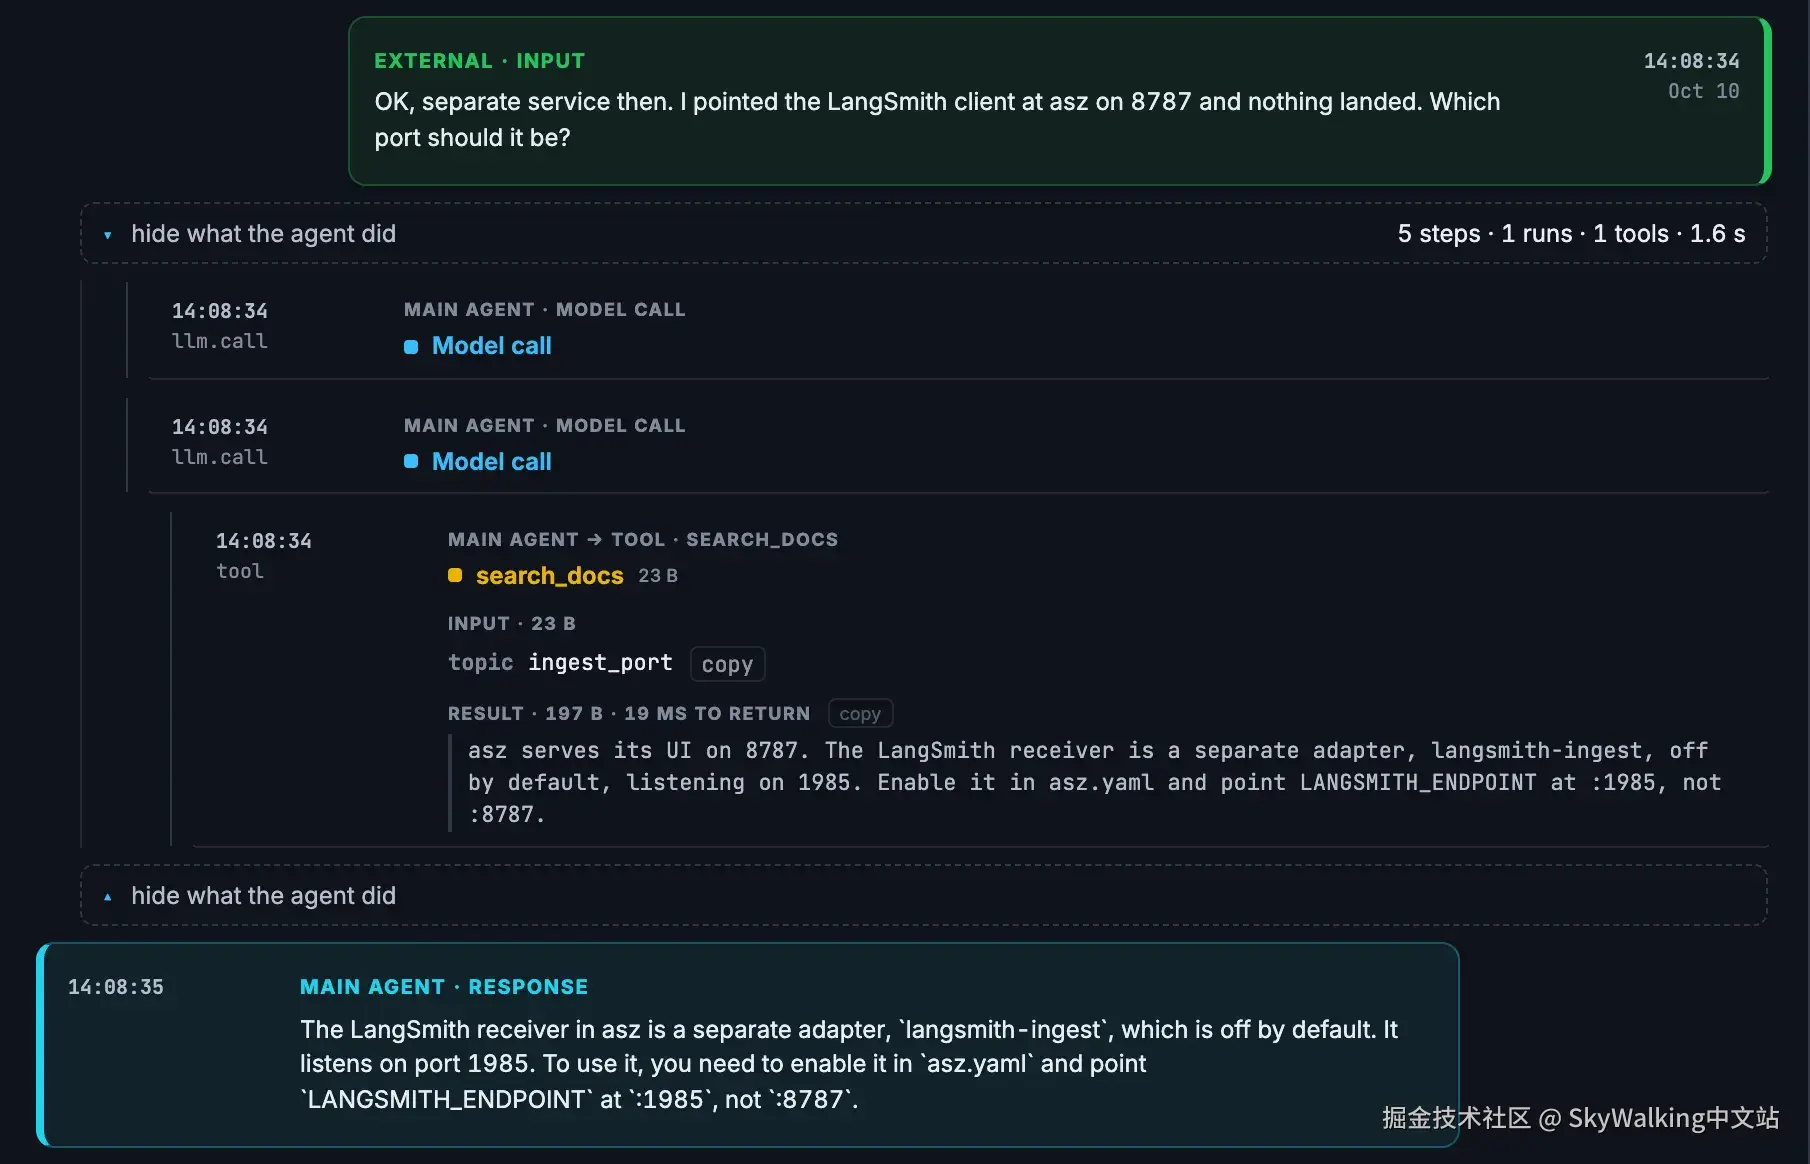
展开一轮交互,可以查看其中的 Agent 执行流程。第二个问题询问为什么向 8787 端口发送追踪数据后没有看到记录。Nova Pro 以 ingest_port 为参数调用了 search_docs ,然后根据工具返回的结果作答:
查看每次模型调用的输入
模型调用记录中的 Prompt 页签,可以回答本文开头提出的第一个问题:这一轮究竟向模型发送了什么?Sessionizer 会将每次模型调用的输入与对话记录一起保存,并在查看时还原完整内容:
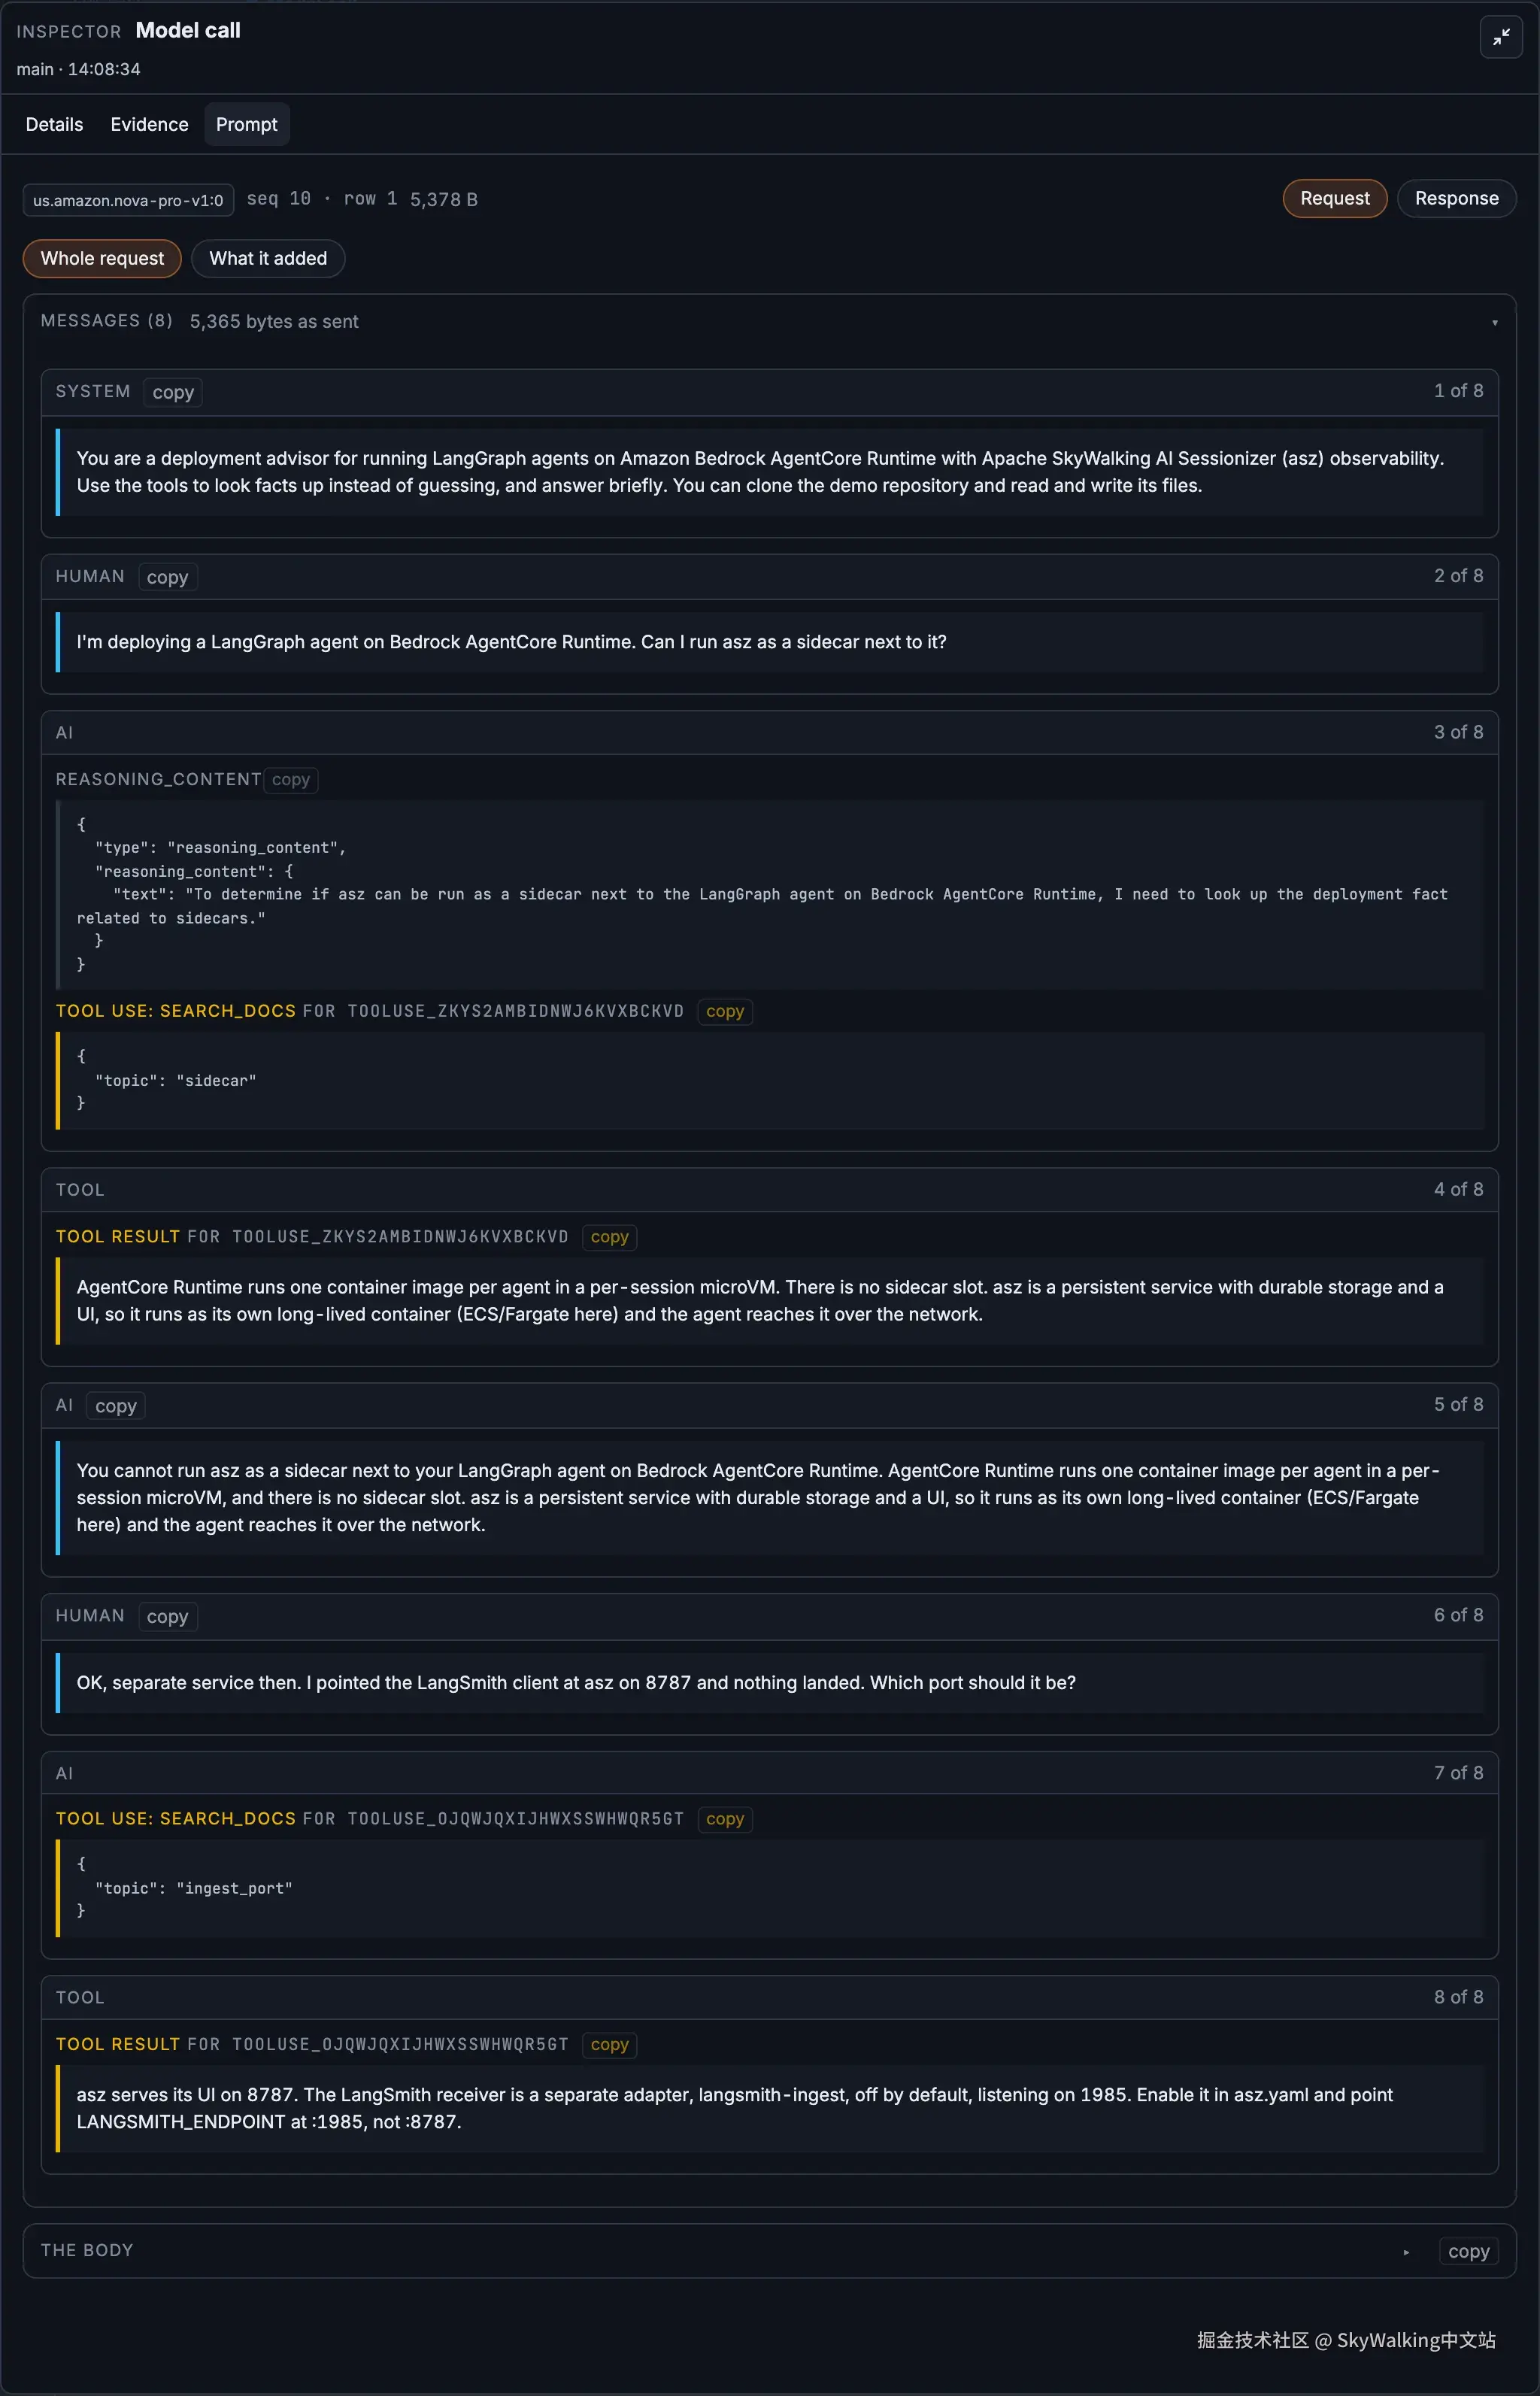
从输入中可以确认,会话保留了之前的历史:第一个问题、Nova Pro 的推理内容、工具调用、工具返回结果和最终回答,都来自前一次调用。这是同一个执行环境中的内存检查点存储在发挥作用。
与上一篇文章相同,这里记录的是 LangChain 所呈现的模型输入,并非 Bedrock 实际收到的原始字节内容。记录中也会明确标注这一点。
对照 Agent 的回答与实际文件变更
第五个问题要求 Agent 克隆示例仓库,并根据示例文件生成 infra/terraform/terraform.tfvars :使用指定的新 IP 地址,并将会话空闲超时设为五分钟。Nova Pro 回复:
已按指定配置成功创建
infra/terraform/terraform.tfvars文件,其中agentcore_idle_timeout已设置为在会话空闲 5 分钟后停止会话。
这个文件保存在会话执行环境的本地工作目录中,执行环境停止后,文件也会丢失。不过, asz-changes 在 write_file 执行期间采集的变更已经被 Sessionizer 保存,可以在对应步骤的 Changes 页签中查看。
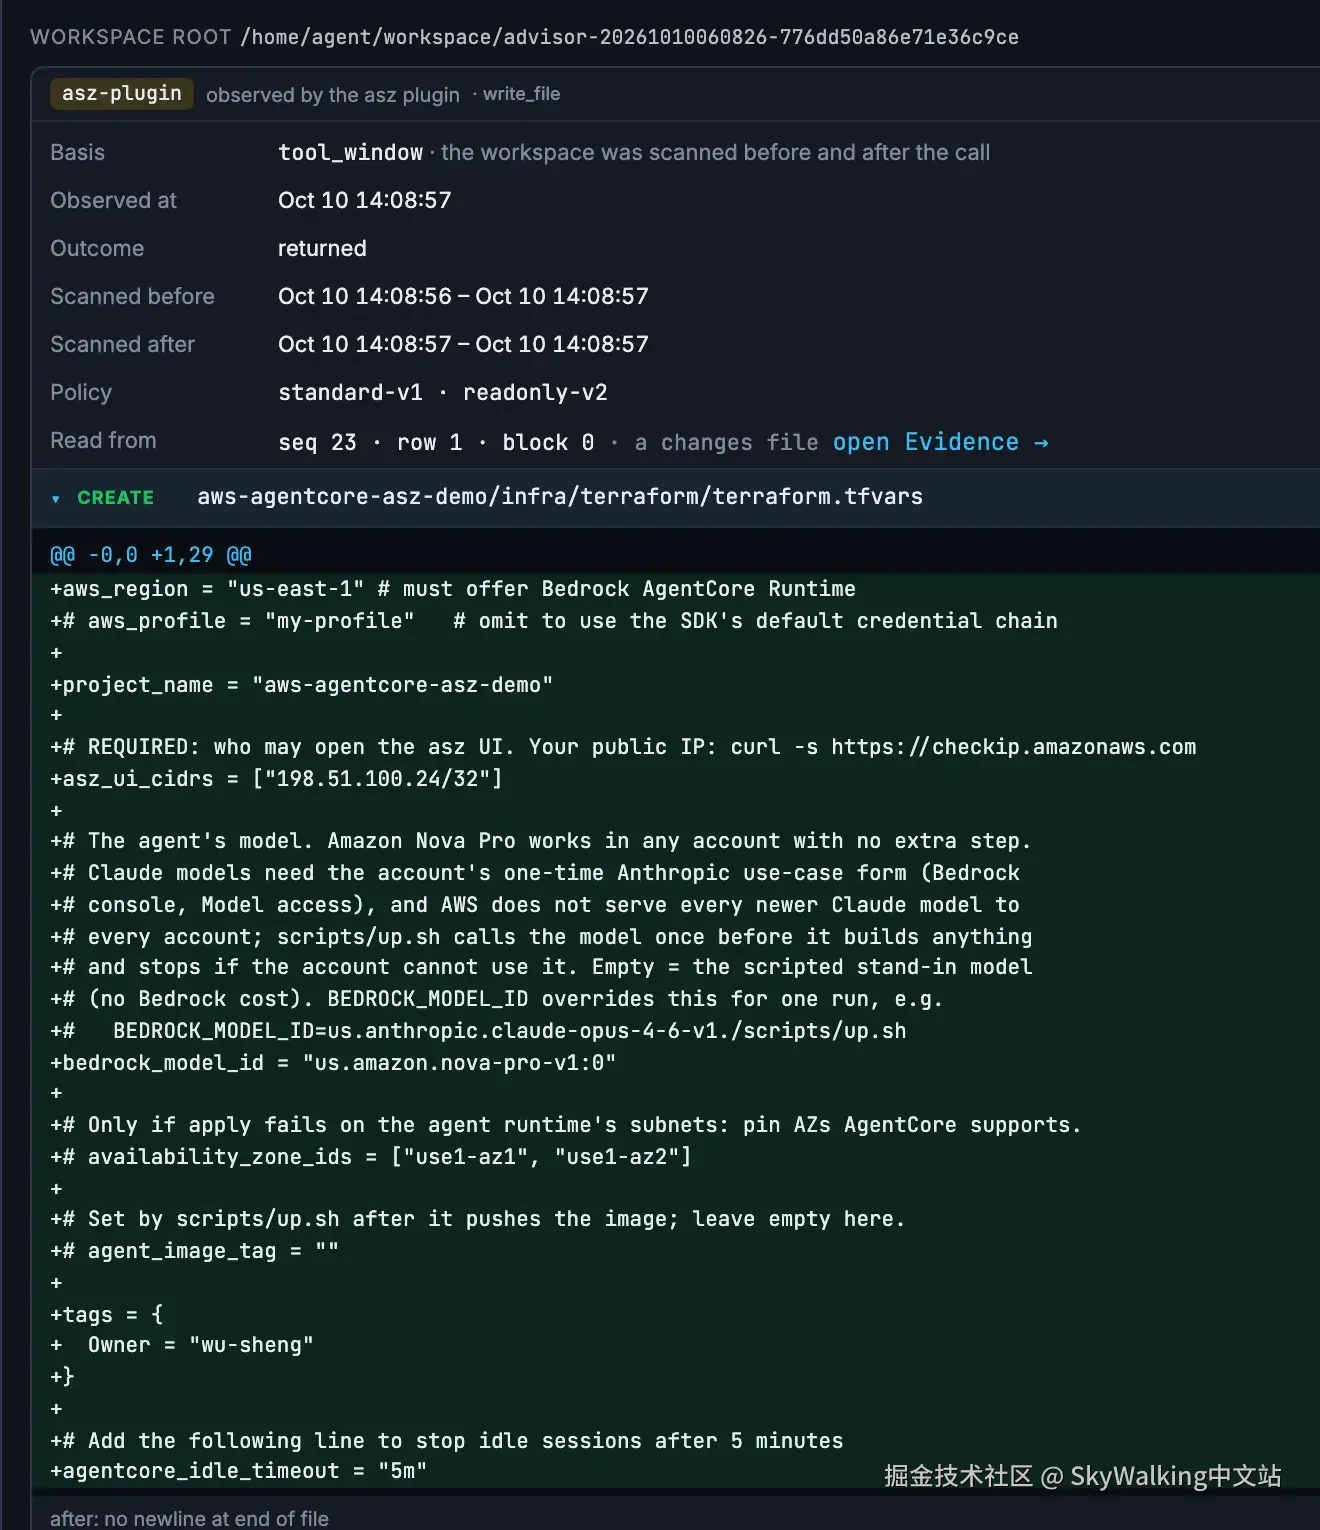
IP 地址写对了,但最后一行配置是错的。示例中不存在名为 agentcore_idle_timeout 的变量,正确配置应该是 agent_idle_session_timeout = 300 ,单位为秒。使用 Agent 编造的变量名时,OpenTofu 只会提示该变量未声明,实际仍然使用默认的 15 分钟超时。
同一轮交互中的工具调用记录解释了错误的来源:Agent 读取了 terraform.tfvars.example ,但这个示例文件没有空闲超时配置;它没有继续查看 variables.tf ,而是自行生成了一个变量名。Agent 在回复中表示任务已经完成,但从执行记录可以看出,写入的配置并未满足要求。
执行环境回收后,还能查到什么
默认情况下,AgentCore 会在会话空闲 15 分钟后,或执行环境达到 8 小时的生命周期上限后,停止该环境。会话 ID 仍然有效,后续使用同一个 ID 发起调用时,AgentCore 会创建新的执行环境。 AgentCore 文档明确说明,内存中的数据,包括对话历史,只在对应计算环境的生命周期内保留。本地磁盘上的工作目录也一样。
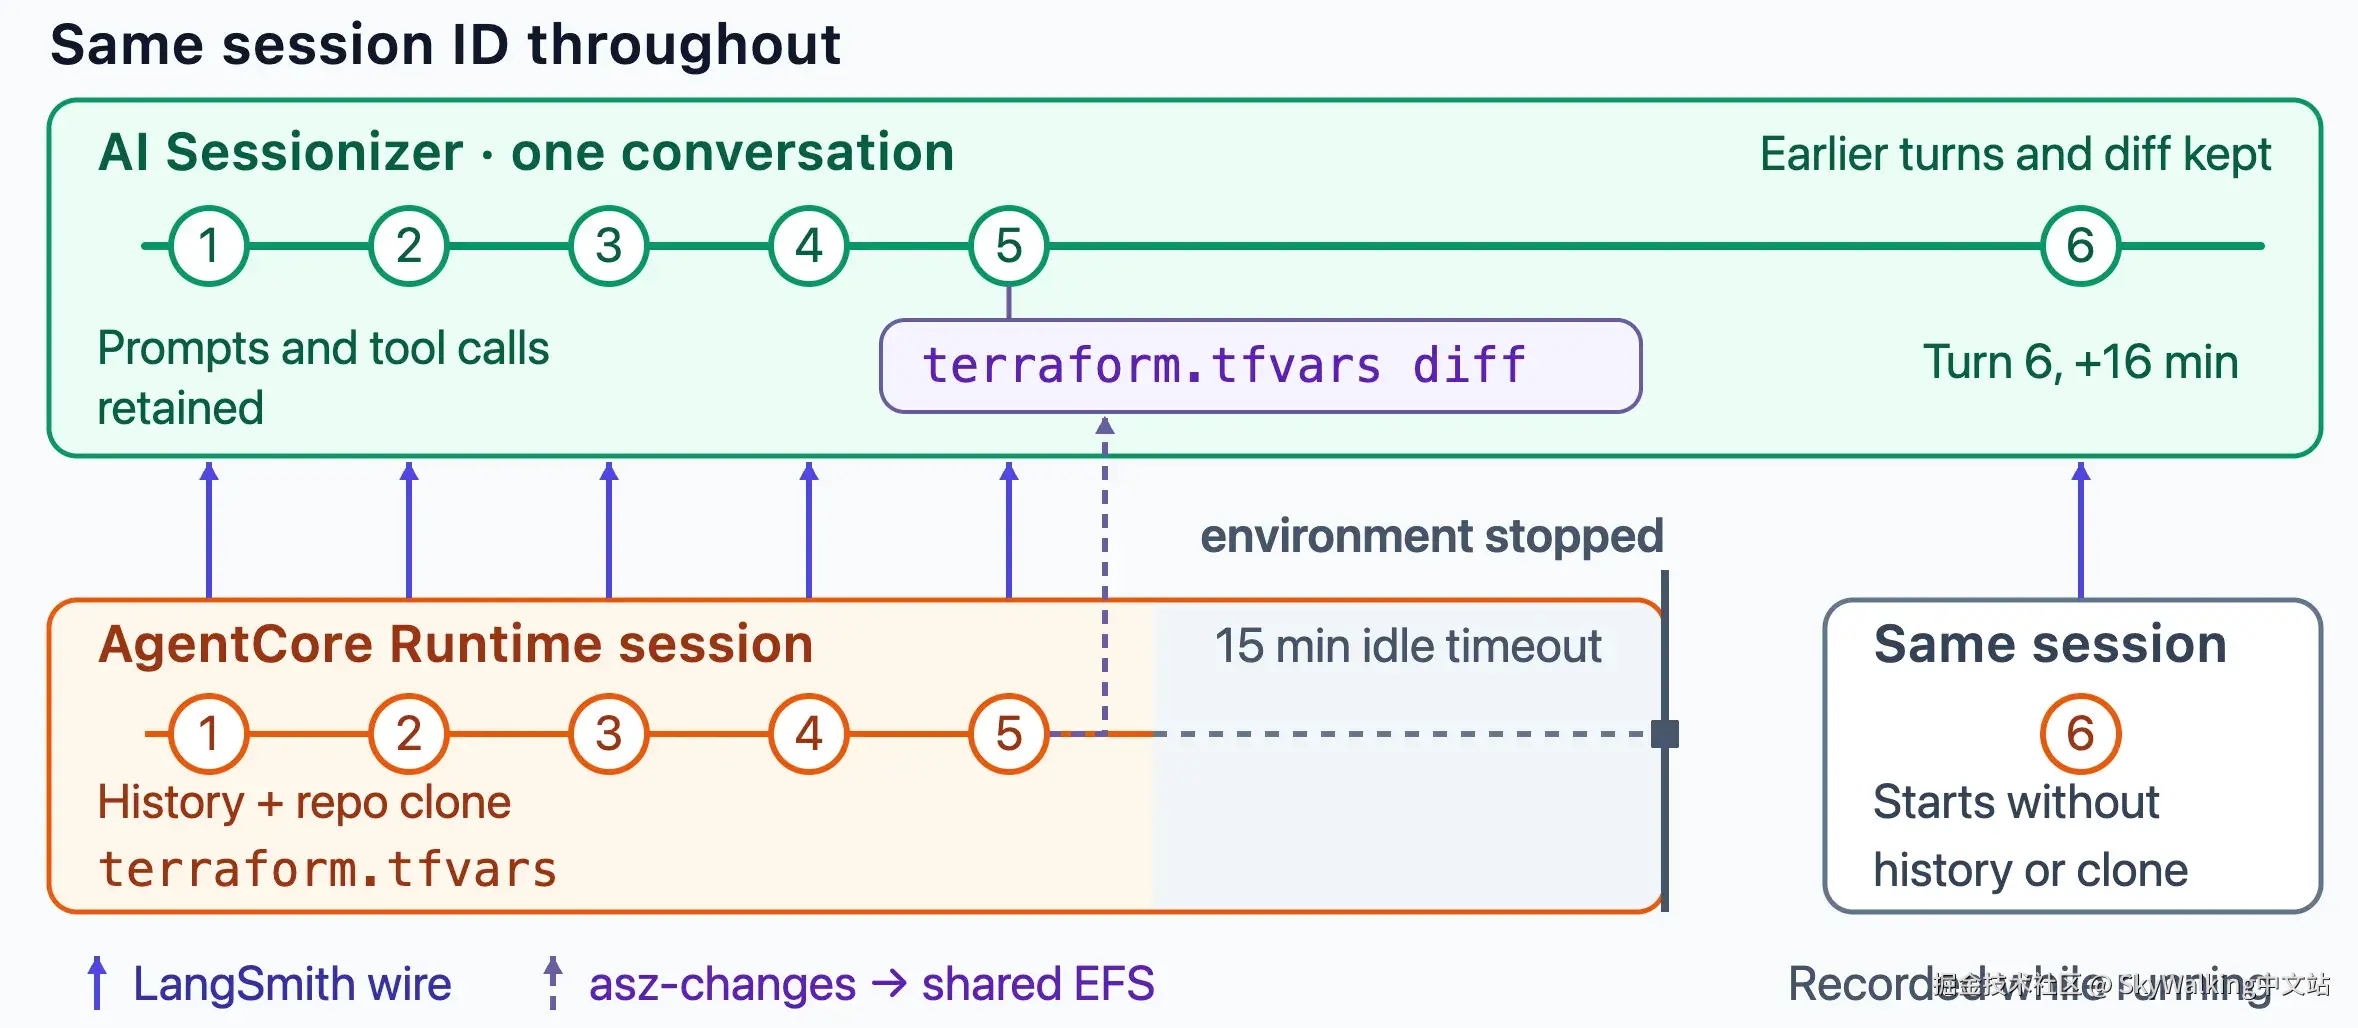
执行环境停止并不会中断 Sessionizer 中的对话记录。调用方继续使用相同的会话 ID,Agent 将它作为相同的对话线程标识,Sessionizer 就会把这次调用接在之前的交互后面。
本次测试中, invoke.sh 在第五轮结束约 16 分钟后,使用前五轮的会话 ID 发送了第六个问题,这一轮同样被归入原有对话。图 3 中,第六轮位于第五轮下方的"16 min quiet"标记之后;图 2 中的交互总数为六轮。Sessionizer 将暂停后的活动划分为新的活动窗口,作为同一段对话中的第二个片段。执行环境停止前的模型输入、工具调用和文件变更都保留在原有记录中。
丢失的是 Agent 自己的上下文。第六个问题在第五轮结束约 16 分钟后,使用相同的会话 ID 发出:"你之前在这个会话里修改了我仓库中的一个文件。是哪个文件?具体改了什么?"Nova Pro 回复:
之前修改的文件是
infra/terraform/terraform.tfvars.example。修改内容包括添加aws_region和project_name变量,以及更新asz_ui_cidrs,加入你的公网 IP 地址。
这个回答既说错了文件名,也说错了操作内容。实际操作是创建 terraform.tfvars ,其中还写入了错误的 agentcore_idle_timeout 配置。调用过程没有报错,回答也很流畅。Sessionizer 像记录前五轮一样记录了这一轮,而模型输入说明了问题所在:
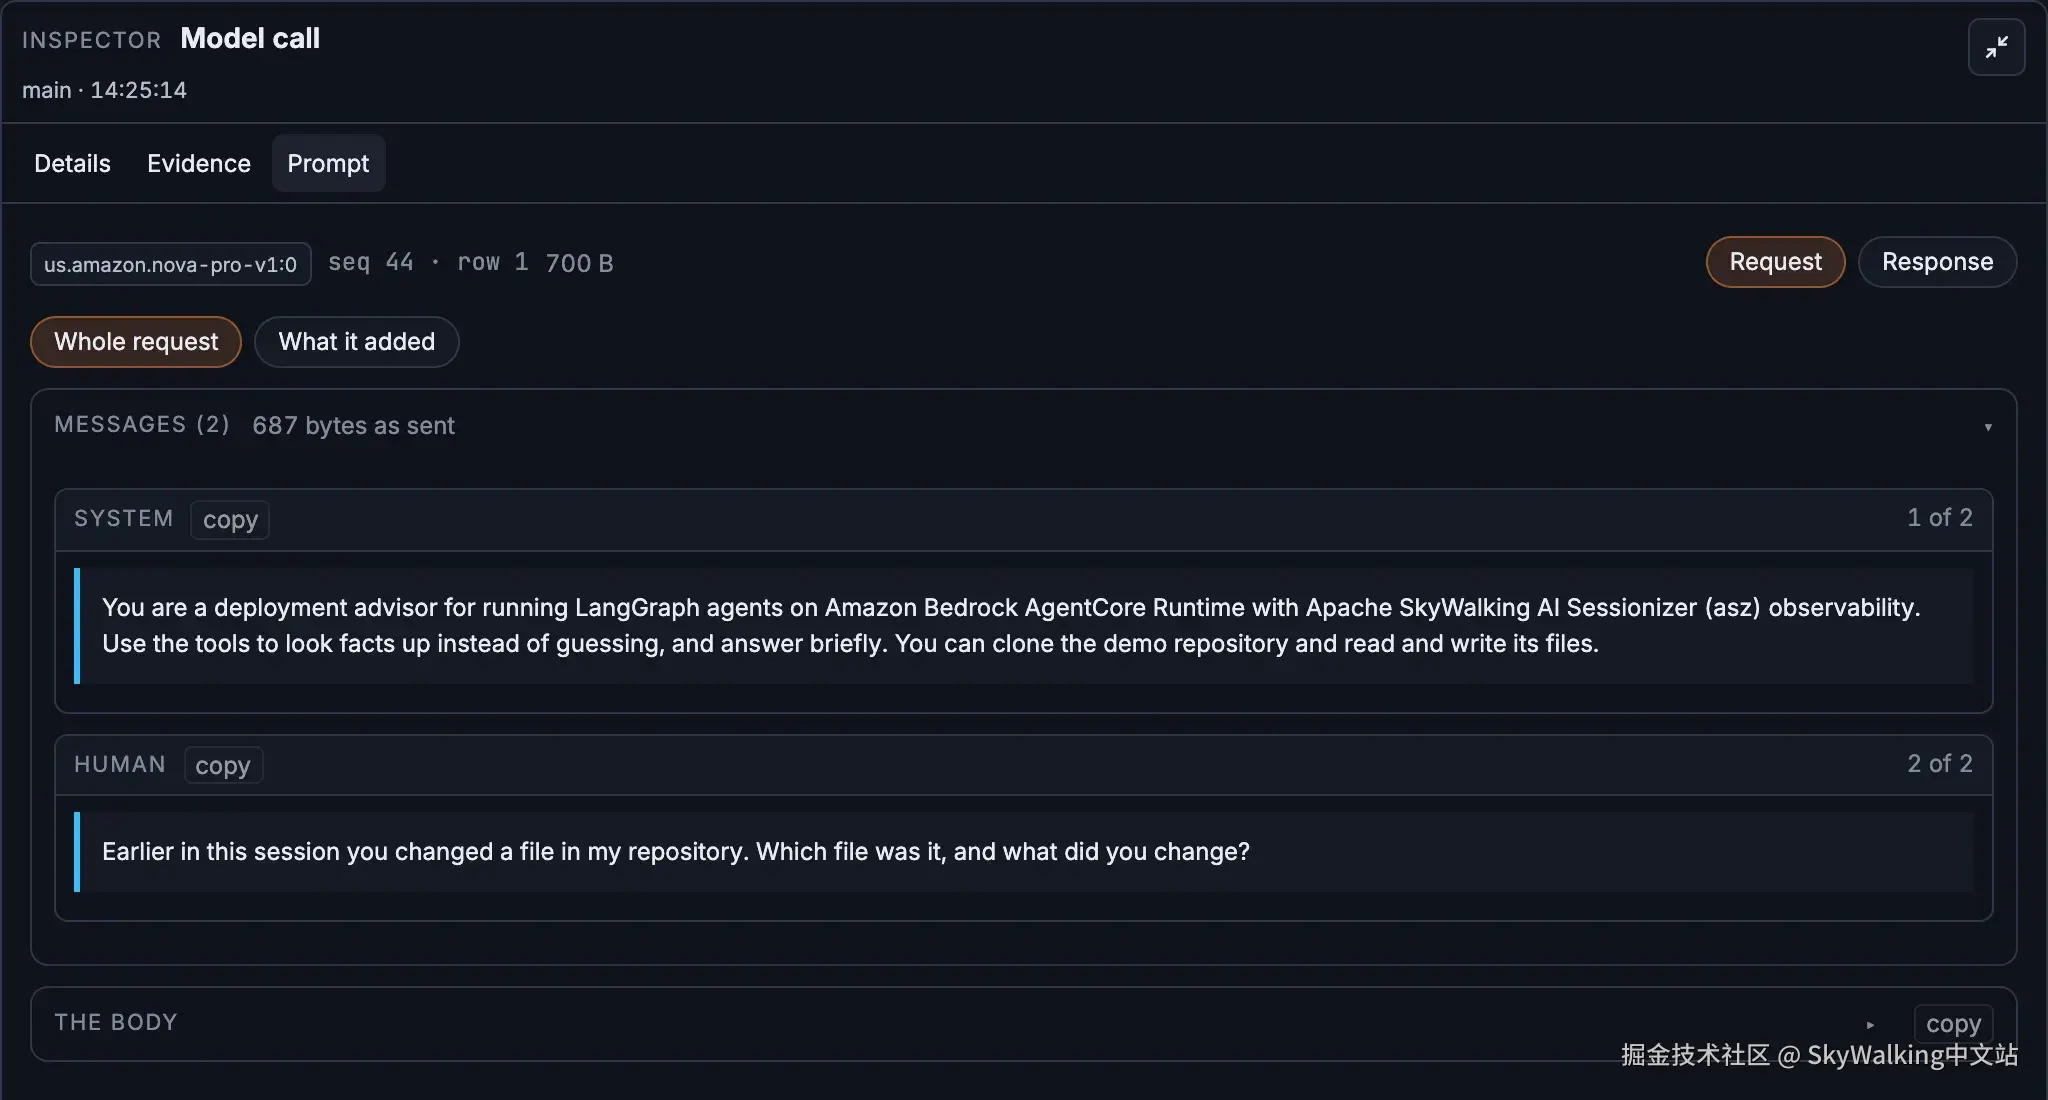
这次调用的输入为 791 tokens,与第一轮首次调用的 796 tokens 接近。相比之下,第五轮仍在旧环境中运行时,首次模型调用的输入已经达到 2,010 tokens。新环境中的检查点存储是空的,因此历史消息没有被带入。
旧环境中的仓库副本也已经丢失,Agent 于是重新克隆仓库,读取示例文件,并将文件里已有的内容描述成自己之前做过的修改。而在 Sessionizer 保存的上一轮交互中, write_file 步骤仍然保留着实际的变更内容,如图 6 所示。
这也是在 AgentCore 上实时记录执行过程的价值所在。执行环境停止后,Agent 的内存和本地文件可能都已丢失,它对先前操作的解释只能依赖当前还能获取的信息。Sessionizer 的记录独立于这些环境保存:六轮交互仍然属于同一段对话,Agent 已经无法访问的历史信息依然可查。
需要区分的是,Sessionizer 保存记录供人查看,并不会将这些记录自动恢复到 Agent 的上下文中。要让 Agent 在执行环境重建后继续使用之前的历史,需要将 LangGraph 检查点保存在生命周期更长的存储中。 langgraph-checkpoint-aws 提供的 AgentCoreMemorySaver 可以将检查点保存在 Amazon Bedrock AgentCore Memory 中。AgentCore 的 session storage 在本文测试时处于预览阶段,可以在会话停止和恢复之间保留文件。
空闲超时由运行时的 lifecycle_configuration 控制,示例通过 agent_idle_session_timeout 暴露这个配置。调整超时时间只能改变历史数据何时丢失,不能解决持久化问题。要验证历史上下文是否真正保留下来,仍然可以查看 Prompt 页签:暂停后的第一次模型调用,其输入中应该包含暂停前的交互历史。
与 AgentCore Observability 配合使用
AgentCore 自带可观测能力,可以在 Amazon CloudWatch 中查看运行时会话及其 trace 和 span。在 Agent 中接入 OpenTelemetry 后,还可以查看模型调用、工具调用及其中间输出。这些能力适合从整个运行时的角度,观察所有会话的延迟、错误和使用情况。
Sessionizer 补充的是对话视角:将同一会话在多次调用、多个执行环境中的交互整理为一份连续记录;在模型调用旁展示还原后的请求;在被监控的工具步骤旁展示文件 diff;并将这些内容保存在自己管理的存储中。本文示例只配置了 Sessionizer 这一部分。
将记录导出到 SkyWalking
本文使用 Sessionizer 的简单部署模式,由它自行完成采集、存储并提供回放页面。如果希望在 SkyWalking 中统一查看多个 Agent 的对话,可以按照 上一篇文章的方式,在同一份配置中增加 OpenTelemetry Protocol(OTLP) 导出。导出后,这些对话会出现在 Horizon 的 AI Agents 视图中,归类在 LangChain 运行时下。
采集方式不需要调整:Agent 仍然发送 LangSmith 协议数据和文件变更,OTLP 负责导出 Sessionizer 已经接收并保存的内容。
在你的 AgentCore Agent 上接入 Sessionizer
接入已有 Agent
如果你的 LangGraph 或 LangChain Agent 已经运行在 AgentCore Runtime 上,可以按以下四步接入,无需修改业务逻辑:
- 部署 Sessionizer 接收端。 将 Sessionizer 部署在运行时能够访问的位置,启用
langsmith-ingest,设置令牌,并配置listen: 0.0.0.0:1985。示例将它作为一个 ECS 任务,部署在内部 ALB 后面。
- 配置四个运行时环境变量。 设置
LANGSMITH_TRACING=true,将LANGSMITH_ENDPOINT指向接收端,将LANGSMITH_API_KEY设为接收端令牌,并设置LANGSMITH_PROJECT。
- 使用会话 ID 关联对话。 将
BedrockAgentCoreContext.get_session_id()返回的值作为 LangGraph 的thread_id,同时写入执行记录的元数据。
- 按需启用文件变更记录。 在镜像中加入
asz-changes和apache-skywalking-asz-langchain,它们应与服务端使用同一个 Sessionizer 提交版本,然后执行asz-langchain enable。在记录工具的settings.yaml中指定需要监控的写入工具,设置三个ASZ_*环境变量,并将同一个 EFS access point 分别挂载到运行时和 Sessionizer,由changes适配器读取变更记录。
LangChain 和 LangGraph 接入指南介绍了前三步, 插件指南介绍了文件变更记录的配置。
运行示例
需要准备一个 AWS 账户,并完成 AWS CLI 登录,同时安装 OpenTofu 和 Docker。克隆 示例仓库后执行:
Bash
bash
cp infra/terraform/terraform.tfvars.example infra/terraform/terraform.tfvars
# 将 asz_ui_cidrs 设置为你的公网 IP,可通过以下命令查询:curl -s https://checkip.amazonaws.com
./scripts/up.sh       # 部署约需十分钟
./scripts/invoke.sh   # 执行五轮交互,并输出会话 ID 和回放页面地址
./scripts/down.sh # 使用完毕后清理资源- 模型。 默认使用 Amazon Nova Pro,不需要额外配置。可以通过
BEDROCK_MODEL_ID=<model id> ./scripts/up.sh指定其他模型。使用 Claude 模型时,账户需要先完成一次 Anthropic 用途表单,而且并非所有账户都能访问所有较新的 Claude 模型。因此,up.sh会先尝试调用一次模型,如果账户无权使用,就在创建资源之前停止。
- Agent 镜像。 GitHub Actions 负责构建镜像并发布到 GitHub Container Registry,
up.sh再将其复制到当前账户的 ECR,因为 AgentCore 只从 ECR 运行镜像。整个过程不在本地构建镜像。
- 区域和可用区。 AgentCore 的 VPC 模式只支持 部分可用区。本文使用的
us-east-1区域支持use1-az1、use1-az2和use1-az4。如果up.sh因运行时子网配置而停止,需要设置availability_zone_ids。
- 费用。 本次示例的固定基础设施费用约为每小时 0.125 美元,主要来自 NAT 网关和两个负载均衡器,不包含 AgentCore、Bedrock 和存储的使用费用。
- 资源清理。
down.sh会删除全部资源,包括已记录的对话。删除运行时后,AWS 仍可能保留 AgentCore 网络接口数小时,本次测试中约为 10 小时。这些接口会使 VPC、两个子网和一个安全组暂时无法删除,但这些遗留资源本身不产生费用。down.sh会说明这一情况并退出。之后可以运行./scripts/down.sh check查看清理进度,再运行./scripts/down.sh --yes完成剩余清理。
验证记录结果
打开 invoke.sh 输出的回放页面,重点检查以下三处:
- 第二轮交互中最后一次模型调用的 Prompt 页签。 可以看到第一轮的内容,尽管它来自另一次 AgentCore 调用。
- 第五轮交互中
write_file步骤的 Changes 页签。 对照工具实际写入的内容和 Agent 对修改结果的描述。
- 空闲超时后的首次模型调用。 等待至少 15 分钟,然后使用同一个会话 ID,通过
SESSION=<session id> ./scripts/invoke.sh "<question>"再发送一个问题。打开这一轮的首次模型调用,可以看到输入中已经没有之前的交互历史,Agent 作答时也没有这些上下文。
完成示例后,可以将已有 Agent 的追踪客户端指向 Sessionizer。后续遇到异常回答或错误的文件修改时,就能定位到对应轮次,核查模型当时的输入以及工具实际执行的操作。
问题和测试反馈可以提交到 Apache SkyWalking Discussions,源码位于 Apache SkyWalking AI Sessionizer 仓库。
主题: Amazon Bedrock AgentCore · Amazon Bedrock · Amazon Bedrock Agents · 可观测性 · AI Agent
本文观点仅代表作者个人,不一定反映 AWS 的观点。