做特征工程时很多人有一套固定动作:StandardScaler 然后 fit_transform。(也就是先标准化数据,再训练模型)
这在教科书数据集上没问题,但真实数据,比如订单金额、页面停留时长、接口耗时等,几乎天然右偏,还总混着几个离谱的值。
StandardScaler 拿均值和标准差当尺子,而这两个数本身会被极端值带偏。你以为做了标准化,其实是把正常样本的区分度压小了。
本文用一份订单金额数据,把三种常用的特征缩放器(MinMax vs Standard vs Robust)挨个跑一遍,看它们各自把数据变成了什么样,最后给一套能直接抄进项目的选型规则。
1. 缩放只做两件事
先说清楚一件事:缩放不改变分布形状,右偏还是右偏,长尾还是长尾。它只做平移(改位置)和拉伸(改尺度)。
那为什么还要缩放?因为模型看的是数字,不是单位。
一张表里同时放着订单金额(0~200)和下单件数(1~5),对 KNN、SVM、带正则项的线性模型、神经网络来说,金额这个特征天然"嗓门大"。
缩放就是让所有特征站到同一条起跑线上。
既然只是平移加拉伸,三种缩放器的全部差别就只剩一个问题:用哪两个数当尺子。
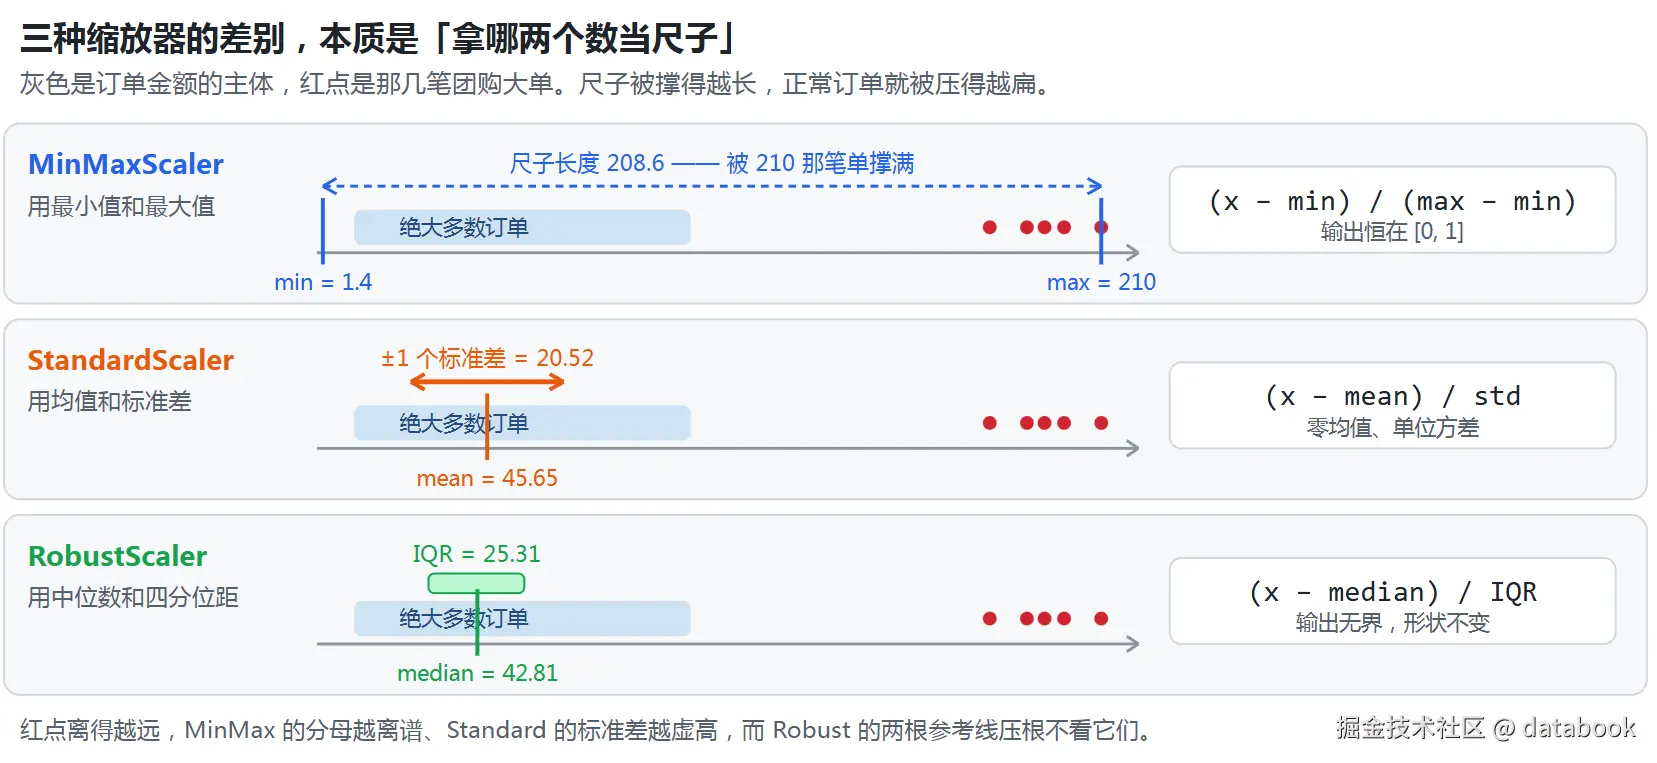
结论已经藏在图里了。
MinMax的两根参考线在数据的两端,多一笔大单它就得多挪一大截;Standard的均值和标准差是拿全部样本算的,极端值当然算在内;Robust的两根线取自中间那一半数据,右边发生什么都不影响它。
一句话:谁离极端值越近,谁越容易被带偏。
2. 实战:一份订单金额数据
用合成数据,参数可控、结果可复现。
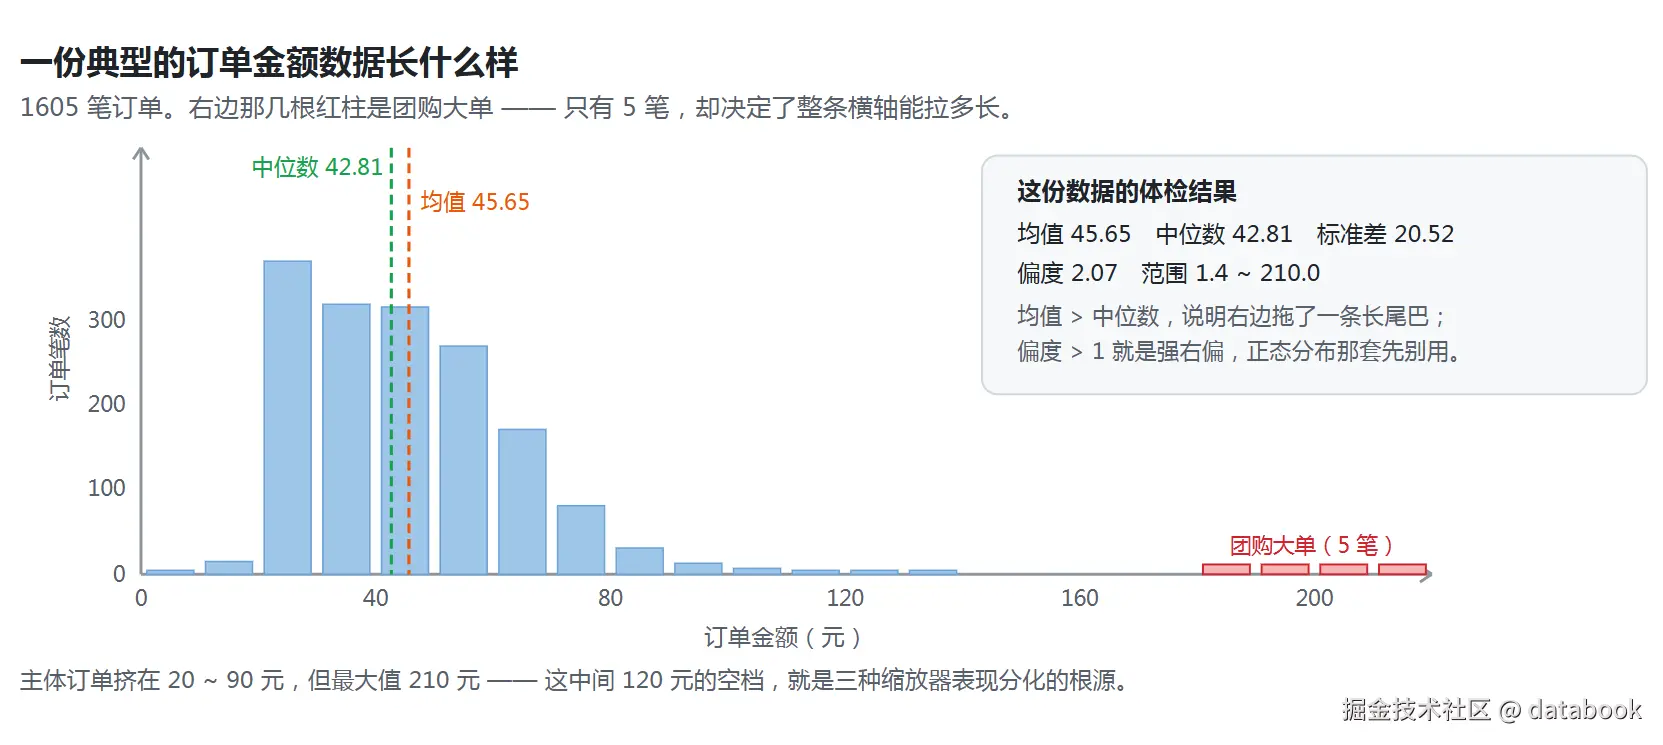
模拟一家店的订单金额:800 笔普通零售单(集中在 50 元附近)+ 800 笔小额长尾单(凑单、活动价,天然右偏)+ 5 笔 180~210 元的团购单------占比只有 0.3%,金额却是正常单的三四倍。
python
np.random.seed(42)
normal_orders = np.random.normal(50, 15, 800)          # 普通零售单
long_tail = np.random.exponential(2, 800) * 10 + 20    # 小额长尾单
amount = np.concatenate([normal_orders, long_tail, [200, 180, 190, 210, 195]])
缩放之前先体检,这一步不能省:
python
x = df["amount"]
print(f"均值 {x.mean():.2f} 中位数 {x.median():.2f} 标准差 {x.std():.2f}")
print(f"偏度 {stats.skew(x):.2f} 范围 {x.min():.1f} ~ {x.max():.1f}")
plain
均值 45.65 中位数 42.81 标准差 20.52
偏度 2.07 范围 1.4 ~ 210.0
这几个数要连起来读。
均值大于中位数,说明右边拖了条长尾巴;
偏度 2.07 把这件事量化了(远大于 1 就是强右偏);
范围里藏着第三个信息,即最大值 210 比绝大多数订单高出一个数量级,就是那 5 笔团购单。
3. StandardScaler
先跑最常用的那个。
办法很直接:把"含异常值"和"剔除异常值(<150 元)"各算一遍,看参考值漂了多少。
python
mean_all, std_all = df["amount"].mean(), df["amount"].std()
clean = df[df["amount"] < 150]["amount"]
print(f"含异常值 std={std_all:.2f} 剔除后 std={clean.std():.2f}")
print(f"50 元订单 z-score: {(50 - mean_all) / std_all:.2f} "
      f"vs {(50 - clean.mean()) / clean.std():.2f}")
plain
含异常值 std=20.52 剔除后 std=18.51
50 元订单 z-score: 0.21 vs 0.26
均值只动了 0.54,看不出什么;标准差从 18.51 涨到 20.52,涨了 10.86% ------这个才要紧,因为 z-score 的分母就是它。
分母变大,所有正常订单的 z-score 被整体压扁:一笔 50 元的典型订单,本来该落在 0.26 个标准差的位置,现在只剩 0.21。
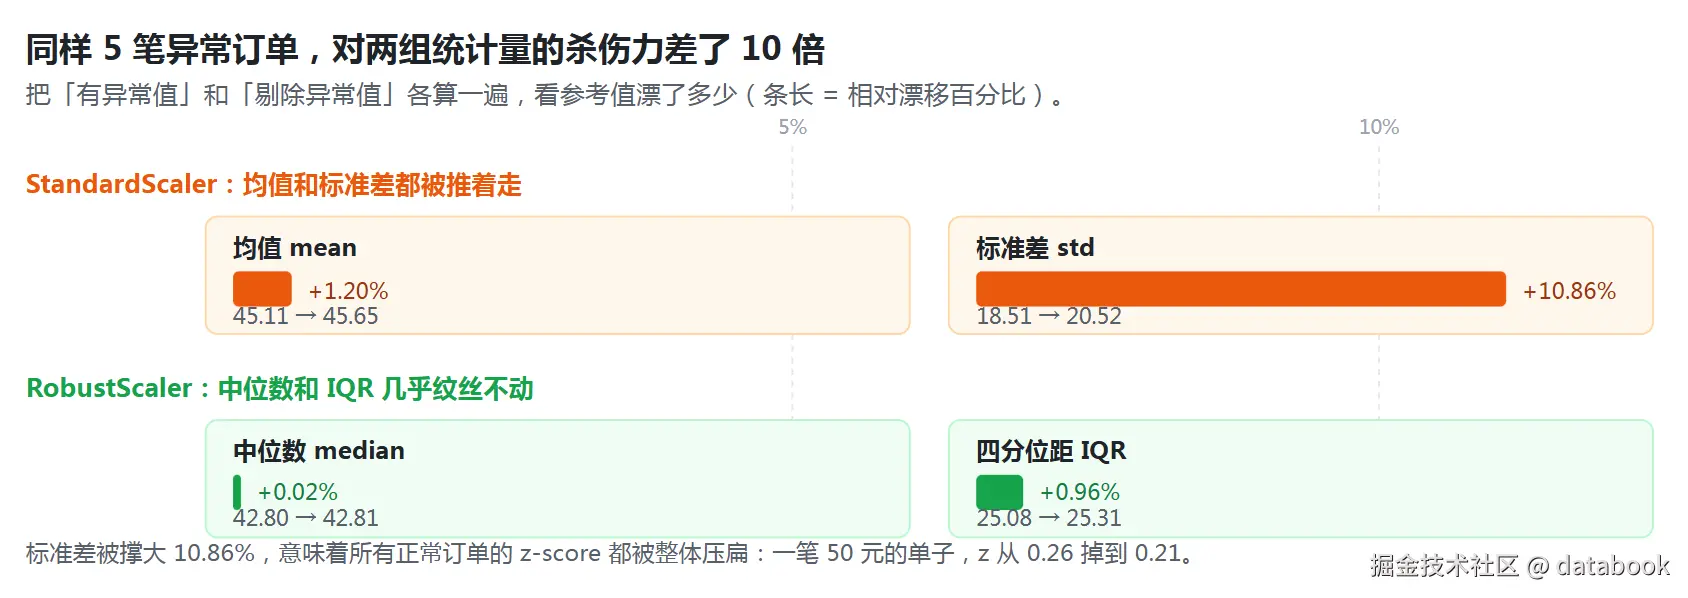
同一组异常值,对标准差(StandardScaler)的杀伤力是对 IQR(RobustScaler) 的十倍以上。
差别在于:标准差 的计算里每个样本都要跟均值做差再平方,一个离得特别远的点,贡献是平方级的;IQR 只问第 25 和 75 百分位在哪,极端值连投票权都没有。
说句公道话,它的问题只在"偏态 + 异常值"同时出现时才明显。
用距离或内积的算法------KNN、SVM-RBF、KMeans、PCA、带正则的线性模型、神经网络等等会受直接影响;树模型(XGBoost、LightGBM、随机森林)根本不看尺度,这一步可以整个跳过。
4. MinMaxScaler
MinMaxScaler 最好解释:最小值映射成 0,最大值映射成 1,中间线性铺开。
问题是这个"最大值"掌握在极端值手里。
python
df["minmax"] = MinMaxScaler().fit_transform(df[["amount"]]).ravel()
for p in [50, 75, 90, 95, 99]:
    print(f"{p}% 的订单落在 {df['minmax'].quantile(p / 100):.3f} 以下")
print(f"{(df['minmax'] < 0.5).mean() * 100:.1f}% 被塞进 0 ~ 0.5")
plain
50% 的订单落在 0.199 以下
75% 的订单落在 0.262 以下
90% 的订单落在 0.319 以下
95% 的订单落在 0.368 以下
99% 的订单落在 0.541 以下
98.6% 被塞进 0 ~ 0.5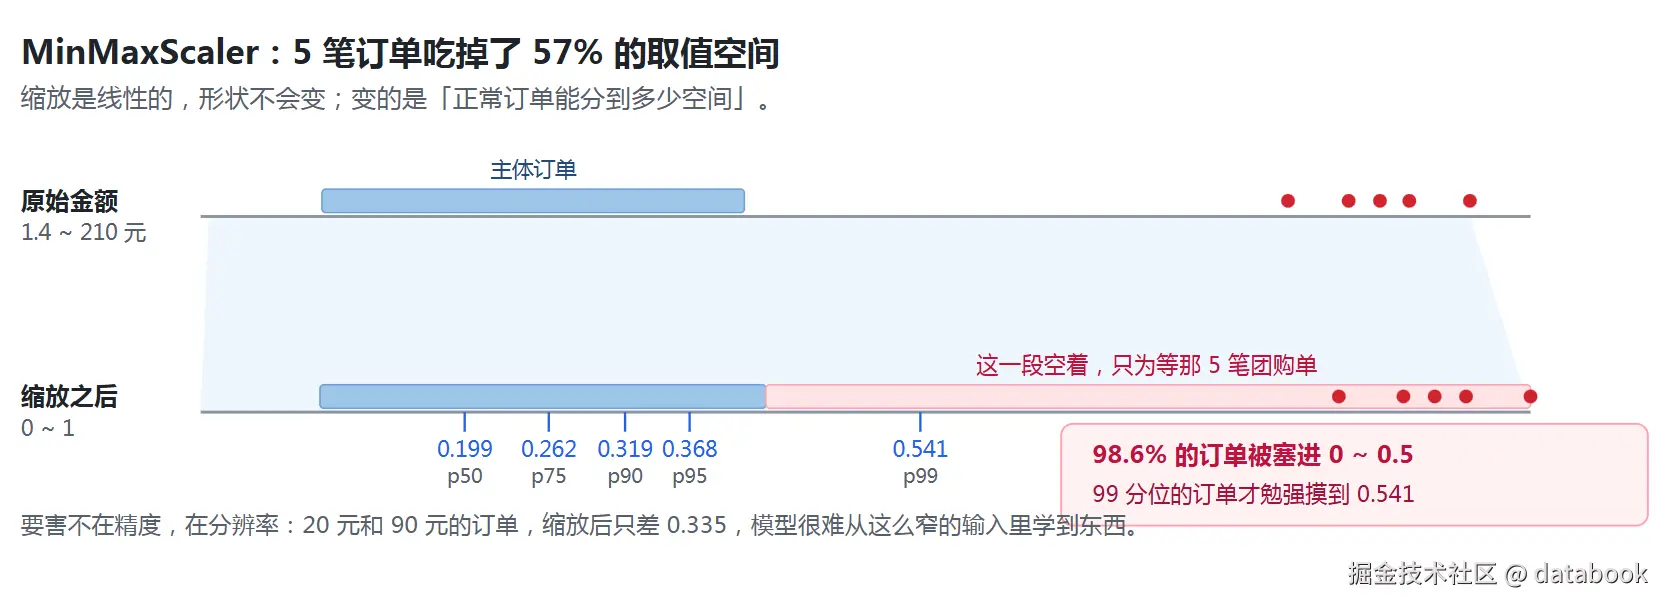
98.6% 的订单挤在 0~0.5,剩下 57% 的取值空间只服务那 5 笔团购单。
缩放是线性的,形状一点没变,变的是正常订单能分到多少空间。
要害不在精度,在分辨率:20 元和 90 元的订单差了四倍多,缩放后只差 0.335。
这个差距在神经网络第一层输入上尤其吃亏,KNN 这类靠距离说话的算法也会把绝大多数样本挤成一团。
所以它的适用条件很窄:字段有天然边界,且这个边界本身有意义 (评分 15、百分比、像素 0255),并且确认没有异常值。
5. RobustScaler
公式是 (x - median) / IQR。理解 IQR 最好的方式是看箱线图。
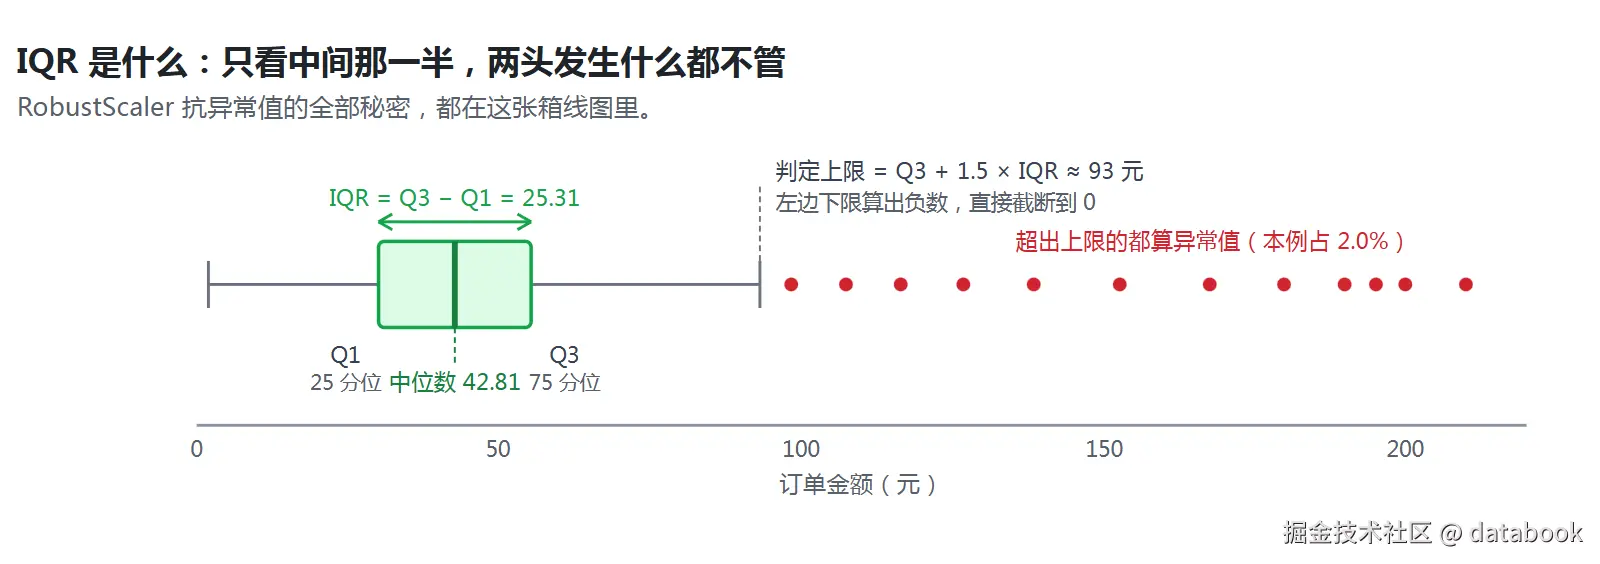
箱体里装的是中间 50% 的样本,中位数是箱体里那根粗线,IQR 就是箱体的宽度。
判定异常值的经典规则也出自这里:超过 Q3 + 1.5 × IQR 算异常。
本例上限约 93 元,超出它的订单占 2.0%。注意这个比例是按"位置"算的,跟具体有多极端无关,一笔 94 元和一笔 210 元权重一样。
这就是它稳的原因。
python
df["robust"] = RobustScaler().fit_transform(df[["amount"]]).ravel()
median_all = df["amount"].median()
iqr_all = df["amount"].quantile(0.75) - df["amount"].quantile(0.25)
clean = df[df["amount"] < 150]["amount"]
iqr_clean = clean.quantile(0.75) - clean.quantile(0.25)
print(f"含异常值 median={median_all:.2f} IQR={iqr_all:.2f}")
print(f"剔除后   median={clean.median():.2f} IQR={iqr_clean:.2f}")
print(f"50 元订单 robust score: {(50 - median_all) / iqr_all:.2f} "
      f"vs {(50 - clean.median()) / iqr_clean:.2f}")
plain
含异常值 median=42.81 IQR=25.31
剔除后   median=42.80 IQR=25.08
50 元订单 robust score: 0.28 vs 0.29
中位数漂移 0.02%,IQR 漂移 0.96%,同一笔订单缩放结果 0.28 对 0.29,基本没变。
RobustScaler 的代价也得说清楚:输出没有边界。
MinMax 死死卡在 0~1,Standard 大约落在 -2.16~8.01,Robust 大约落在 -1.64~6.61。
此外,它的下游要是需要有界输入,得在它后面再接一层。
可解释性也差一点,比如 "0.28 个 IQR"不如"0.28 个标准差"直觉。
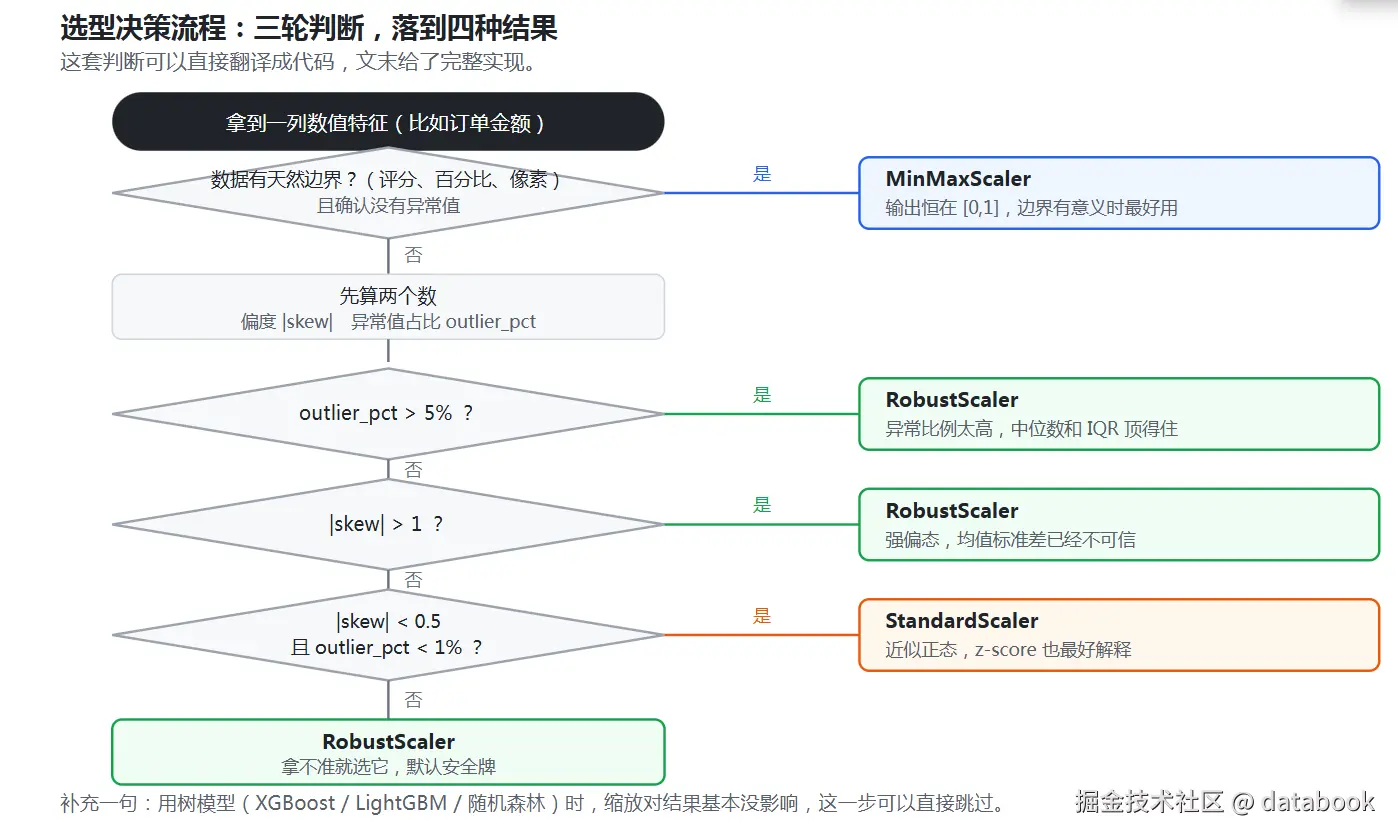
6. 选型:三轮判断
| 参考值 | 输出范围 | 怕什么 | 适用场景 | |
|---|---|---|---|---|
| MinMaxScaler | min / max | 固定在 0,1 | 极端值撑大分母 | 有天然边界、确认无异常值 |
| StandardScaler | mean / std | 无界 | 偏态 + 异常值 | 近似正态、需要可解释性 |
| RobustScaler | median / IQR | 无界 | 基本不怕 | 偏态、异常值不能删 |
python
def recommend_scaler(data):
    skewness = abs(stats.skew(data))
    q25, q75 = np.percentile(data, [25, 75])
    iqr = q75 - q25
    outlier_pct = ((data > q75 + 1.5 * iqr) | (data < q25 - 1.5 * iqr)).mean() * 100
    if outlier_pct > 5:
        return "RobustScaler - 异常值占比过高"
    if skewness > 1:
        return "RobustScaler - 强偏态分布"
    if skewness < 0.5 and outlier_pct < 1:
        return "StandardScaler - 近似正态分布"
    return "RobustScaler - 默认安全牌"
plain
偏度 2.07 异常值占比 2.0%
推荐结果: RobustScaler - 强偏态分布
三种特征缩放的使用要点:
- 优先级不能反:先看异常值占比,再看偏度,因为异常值的破坏更直接。
- 阈值是经验值:你的业务如果天然异常值多,可以把 5% 调大。
- 它是起点不是终点:最终还是拿验证集说话,把两三个候选都跑一遍对比,比任何启发式都靠谱。
另外,特征缩放也可以按列做------一张表里金额偏态、件数正态,各列用各自的缩放器。
7. 完整代码
完整可运行代码共享在:order_amount_scaler_demo.py: url11.ctfile.com/f/45455611-... (访问密码: 6872)
感兴趣的话最好自己手动跑一遍感受一下。
bash
python order_amount_scaler_demo.py最后在补充一句:缩放器本身没有高下之分,区别在于数据长什么样。
有天然边界且干净,MinMax 最好用也最好解释;
近似正态、需要跟人解释,Standard 更合适;
真实业务里那些又偏又脏、还混着几笔大单的字段,RobustScaler 是最省心的默认选择。