2025 年 MCP 火的时候,大家的玩法出奇一致:给 Agent 接一堆 MCP Server------GitHub 的、数据库的、Slack 的、文件系统的------仿佛接得越多,Agent 就越智能。
结果很多人接完发现不对劲:活没干漂亮,token 倒是烧得飞快,模型还经常对着几十个工具发呆、选错工具。到了 2025 年底 Agent Skills 又火了,于是新的灵魂拷问出现了:MCP 和 Skill 是不是一回事?是不是 Skill 出来了,MCP 就没用了?
都不是。这俩解决的根本不是同一层的问题。这篇我把 Tool、MCP、Skill 三者从下到上捋一遍,再说说 2026 年大家为什么开始反思 MCP------争取你看完之后,能清楚地知道自己该在哪一层下功夫。
先从最底层的 Tool 说起
要理解 MCP 和 Skill,得先回到最朴素的东西:工具(Tool)和函数调用(Function Calling)。
一个 tool,本质上就是一个有明确输入参数、有可预期输出的函数 。比如 get_customer_record(customer_id),功能就是按 ID 查客户。
但要注意一个关键事实:模型自己从来不执行函数。 当模型判断需要查客户时,它只是输出一段结构化的"调用意图"------类似"请调用 get_customer_record,参数 customer_id=12345"。真正去跑这个函数的是你的应用程序(Host),跑完把结果塞回给模型,模型再接着往下说。
这里有两个细节值得记住:
- 工具的
description比你想象的重要得多。模型完全靠这段描述判断要不要、什么时候调用这个工具,参数 schema 反而是次要的。描述写得含糊,模型就会漏调或误调。 - 一个工具只应该知道"怎么做好一件事",它不决定自己什么时候被调用。这个判断权在模型,或者在更上层的编排逻辑里。
打个比方,tool 是模型伸出去的手。没有手,模型只会动嘴,碰不到真实数据和系统;有了手,它才能查库、调 API、发消息。但光有一堆手,它未必知道遇到一件复杂的事,该先伸哪只手、后伸哪只手。
MCP:解决的是"怎么连",不是"怎么会"
那 MCP 解决什么?它解决的是一个非常朴素的工程问题:集成爆炸。
假设没有 MCP。市面上有 M 个 AI 应用(Claude、Cursor、自研 Agent......),每个应用都要连 N 个外部系统(GitHub、数据库、Slack......)。最笨的做法是每个应用为每个系统单独写一套对接,连同样的 GitHub,Claude 写一遍、Cursor 写一遍、你的 Agent 又写一遍,而且各家函数定义格式还不一样------这就是 M × N 的集成地狱。
MCP 是 Anthropic 在 2024 年 11 月推出的开放协议(基于 JSON-RPC 2.0),它在 AI 应用和外部系统之间加了一层统一标准:任何一个合规的 MCP Server,能被任何一个合规的 MCP 客户端调用。 于是 GitHub 集成只写一次,到处都能接,复杂度从 M × N 降到 M + N。
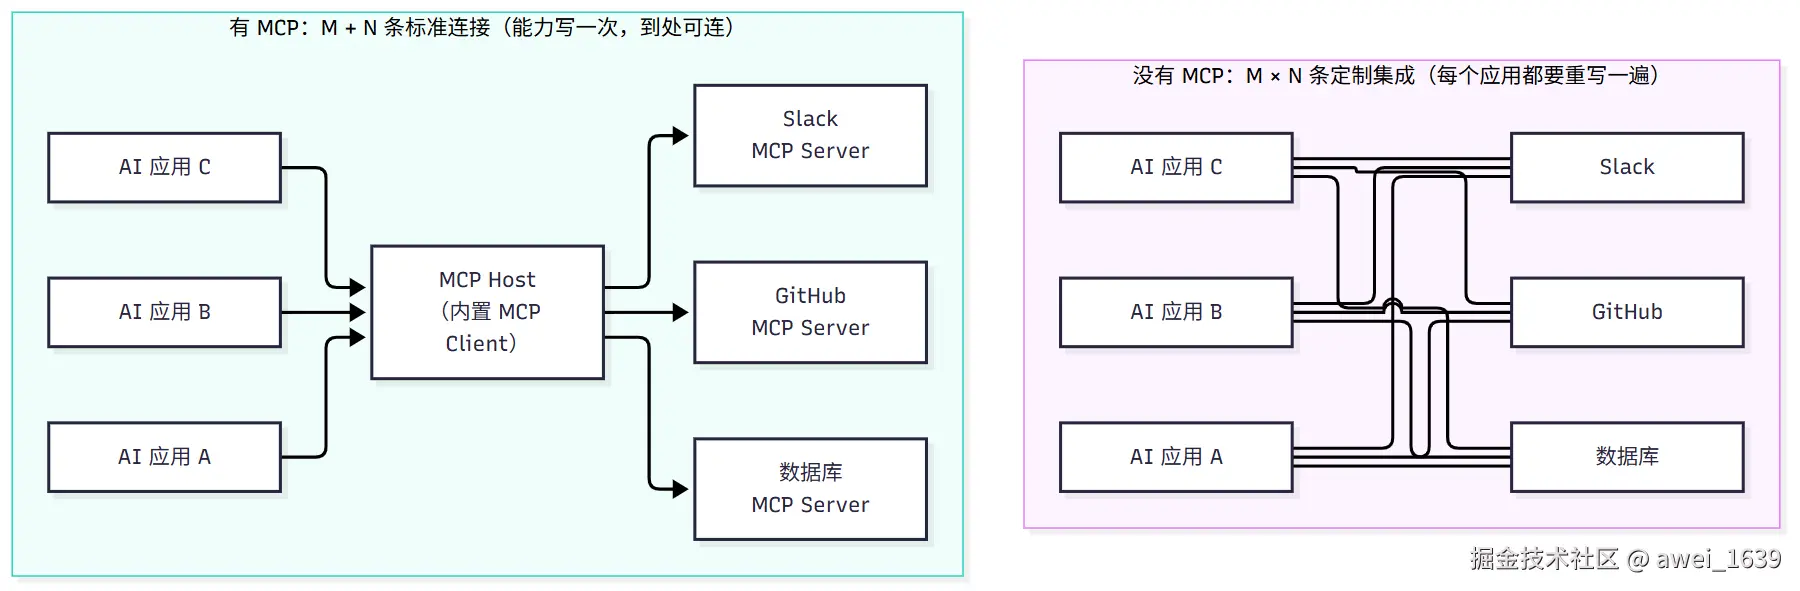 它采用 Host--Client--Server 三层结构:
- Host(宿主):AI 应用本身,负责用户授权、凭证管理、把上下文路由给模型;
- Client(客户端) :Host 内部为每个 Server 建一个连接,一对一、相互隔离;
- Server(服务端) :对外暴露能力,核心是三类原语------Tools (可执行的动作)、Resources (可读取的数据,类似 GET)、Prompts(预设好的交互模板)。
一次典型调用是这样的:客户端先 initialize 和 Server 握手、协商版本和能力,然后通过 tools/list 拿到这个 Server 有哪些工具,真正要调用时发 tools/call。传输层本地进程一般走 stdio(标准输入输出),远程服务走 HTTP------这块演进很快,早期用的是 SSE,2025 年用一个统一的 Streamable HTTP 端点取代了它,2026 年的规范还在继续往无状态、每请求自描述的方向走。
MCP 还带来一个常被忽略的好处:它是双向的。普通的 function calling 是"模型 → 函数"单向的;而 MCP Server 可以反过来请求客户端用模型生成内容(sampling),或者在需要时向用户反问补全信息(elicitation)。
所以 MCP 就是 AI 世界的 USB-C 接口:它不关心你插的是 U 盘还是显示器,只负责把"连接"这件事标准化、可移植。
但问题也恰恰在这------MCP 只保证了"连得上、调得动",完全没解决"模型会不会用这些工具把一件复杂的事做对"。
光有一堆手,不等于会干活
设想你要 Agent 处理一个退款请求。这件事至少包含:查客户记录 → 拉原始订单 → 按退货政策核验资格 → 符合条件就退款,不符合就转人工。
现在我用 MCP 把"查订单""查政策""发起退款"这些工具全接进来了,工具描述也写得清清楚楚。请问 Agent 就一定能正确处理退款了吗?
不一定。它可能:
- 跳过核验资格直接退款;
- 该转人工的时候硬着头皮操作;
- 漏掉"先查订单再判断"的顺序,或者拿到异常结果后不知道怎么兜底。
工具给的是单点能力 ,而"在什么场景下、按什么顺序、满足什么条件、出错怎么处理"是另一回事------这是过程性知识、是工作流、是 SOP。MCP 把标准化的手递到了模型面前,但没人教它做事的章法。
这就是 Skill 要填的那块。
Skill:把"怎么把一件事做好"打包成文件
Agent Skill(Anthropic 在 2025 年 10 月推出,同年 12 月作为开放标准开放,现在 Claude Code、Cursor 等都在采用)听名字很玄,落到地上非常朴素:它就是一个文件夹,里面有一个 SKILL.md,外加若干脚本和参考资料。
SKILL.md 开头必须有一段 YAML 元数据,最关键的是两个字段:name 和 description。注意,description 要同时写清楚"这个 skill 做什么"和"什么时候该用它",因为模型就是拿用户请求去匹配这段描述来决定要不要触发的。
Skill 最核心的设计思想叫渐进式披露(Progressive Disclosure),分三级,专门解决"知识很多但上下文有限"的矛盾:
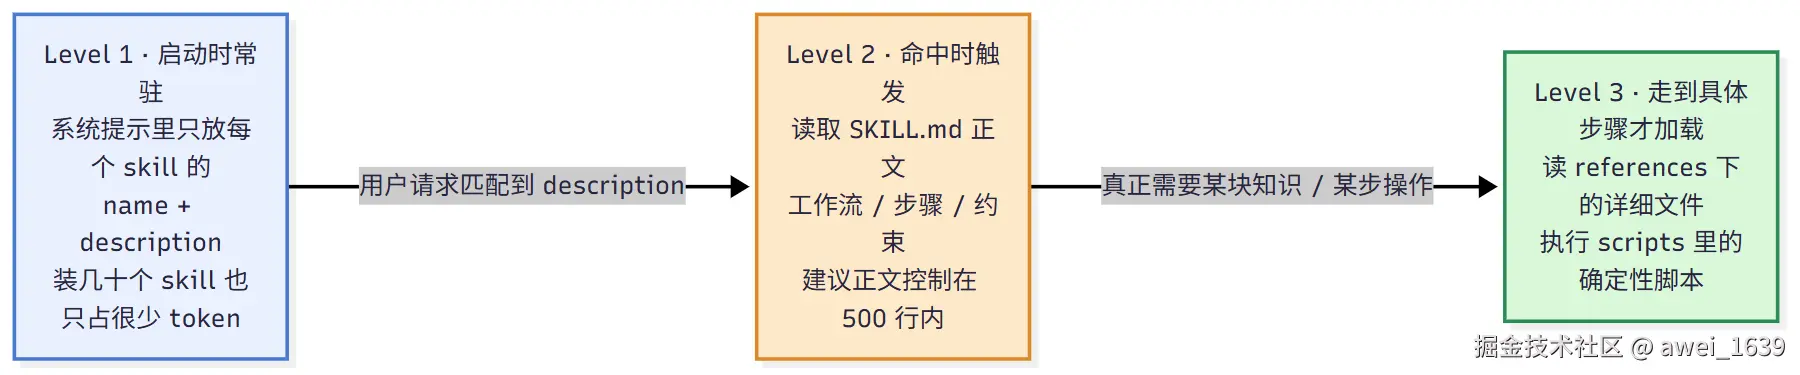
- Level 1,启动常驻:Agent 启动时,只把每个已安装 skill 的 name 和 description 放进系统提示。这点开销极小,所以你可以装几十上百个 skill,没触发时它们几乎不占上下文。
- Level 2,命中触发 :当模型判断当前任务匹配某个 skill,才把整个
SKILL.md正文读进来------这里面写的是工作流、步骤、约束、最佳实践。官方建议正文控制在 500 行以内。 - Level 3,按需深入 :
SKILL.md像个目录,它会指向references/下更详细的文件(比如"怎么填表单"单独放一个forms.md),以及scripts/里的脚本。模型走到具体步骤才去读对应的文件、跑对应的脚本。
这跟给新员工的入职手册是一个道理:先给你一份目录知道"遇到什么事去翻哪一章",而不是把所有手册第一天全塞进你脑子里。正因为按需加载,一个 skill 能打包的知识量几乎是无限的。
Skill 还可以捆绑确定性代码。比如排序、解析 PDF 表单这种事,用模型逐 token 生成又慢又不稳定,直接让它跑一个现成的 Python 脚本,结果确定、可复现,还不用把脚本和文件读进上下文。
这里有个重要的认知:Skill 不是新协议,也不是新运行时,它本质上是"一套打包约定 + 一种上下文管理方式"------把你脑子里的经验、团队的 SOP,沉淀成可复用、可 git 分发的文件。 它是文件,不是服务。
三者同框:手、总线、脑子
把 Tool、MCP、Skill 放在一张图上,分工就彻底清楚了:
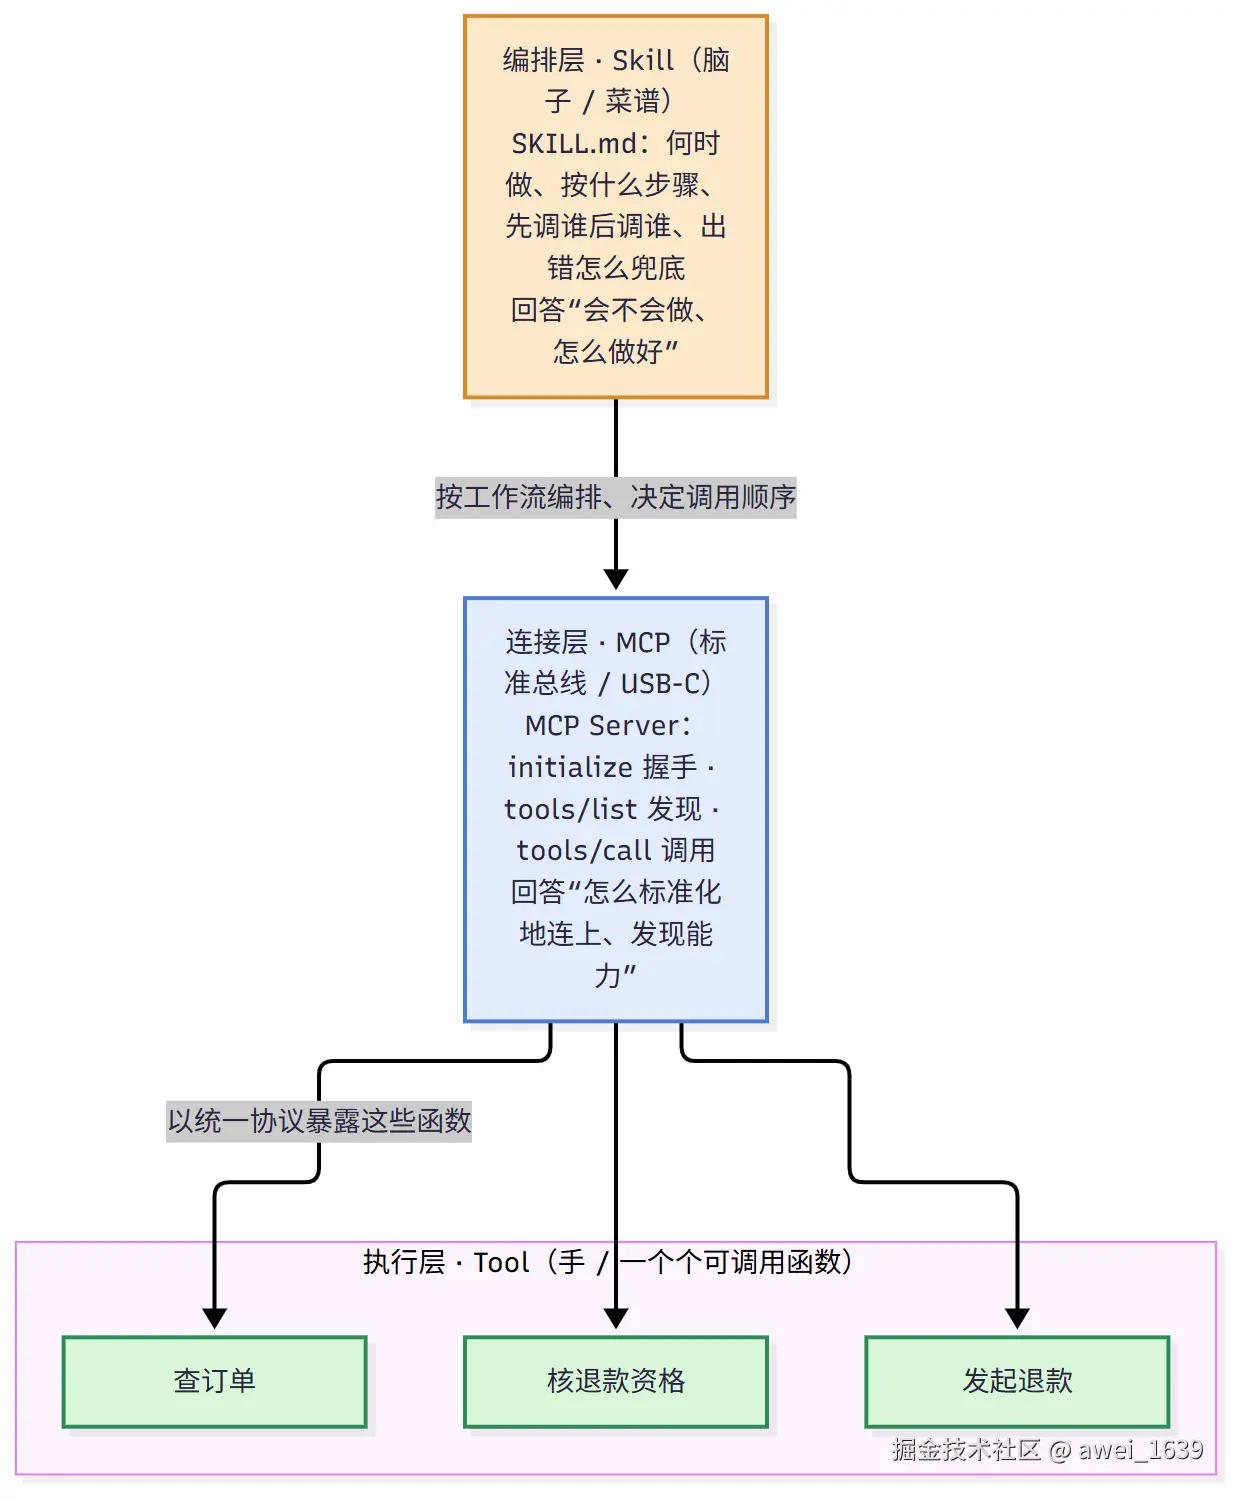
- Tool(执行层,手):一个个具体可调用的函数,知道"怎么做好一件事";
- MCP(连接层,总线 / USB-C):用统一协议把这些函数标准化地暴露、发现、调用,解决"怎么连、怎么复用";
- Skill(编排层,脑子 / 菜谱):写清楚"什么时候做、按什么步骤、先调谁后调谁、出错怎么兜底",解决"怎么把一件复杂的事做对"。
一句话总结:Skill 决定做什么、按什么顺序做,Tool 负责动手,MCP 是让这些手能被一致地接入的基础设施。三者不是替代关系,而是上下层关系。
它们还能天然配合。回到退款场景:你写一个 handle-refund skill,在 SKILL.md 里把"查订单→核资格→退款或转人工"的流程、判断条件、异常处理写清楚;流程里要调用的那些具体函数,由 MCP 接入的"订单 Server""支付 Server"提供。Skill 负责编排,MCP 负责连接,Tool 负责执行。甚至 Anthropic 官方在介绍 Skill 时就明确说,Skill 会和 MCP Server 互补------用 skill 教 Agent 编排涉及外部工具的复杂工作流。
顺带一提,它们的安全边界也分层:Tool 管的是函数级权限 (这个函数能不能调);MCP 管的是协议级的同意和能力协商 (这个 Server 授权了哪些能力);Skill 管的是行为护栏和决策边界(整个流程里允许做什么、什么情况必须停下转人工)。
泼盆冷水:MCP 不是银弹
讲到这里,如果你以为"那就全用 MCP",那得踩刹车了。2026 年业界对 MCP 的反思很值得听,因为它暴露出的是真实生产问题,不是纸上谈兵。
第一,上下文真的会被工具定义吃爆。 每个工具都要带一段 JSON Schema(名字、描述、参数类型、枚举、字段说明),单个工具的描述就要 550~1400 token。有团队实测:连上 3 个 MCP Server,光工具定义就占了约 143K token,在一个 200K 上下文的模型里,约 72% 的窗口在 Agent 还没读到用户消息前就被工具定义吃掉了。 而且上下文里无关内容越多,模型选对工具的准确率反而越低。Perplexity 的 CTO 公开转向 CLI 时,点名的就是这个问题,加上多 Server 认证带来的可靠性摩擦。
第二,成本可能高得离谱。 Scalekit 跑过 75 个基准测试(用 Claude Sonnet 4),报告里 MCP 方案的成本比直接用 CLI 最高高出 32 倍。这里头有协议标准化带来的冗余------全量的工具定义、参数描述、认证流程都要进上下文。
第三,安全面是新的。 OWASP 已经出了专门的 MCP Top 10,典型的有:工具描述投毒(tool poisoning,在工具描述里藏恶意指令)、rug pull(你授权后工具行为被偷偷改掉)、工具返回结果里夹带 prompt injection。MCPTox 基准里,o1-mini 对工具描述投毒的攻击成功率高达 72.8%,而且越强的模型有时反而越容易中招------因为它们更"听话"、更倾向于执行工具描述里的内容。
所以业界出现了"MCP 已死、CLI 复兴"的声音。这个说法有点标题党,但它的内核是对的:像 gh、kubectl、git 这类 CLI 本身就是几十年打磨出来的、可组合、自带 --help 的成熟接口,让 Agent 直接用 shell 调 CLI,往往比为每个系统都包一层 MCP Server 更轻、更省 token。
不过别急着把 MCP 一棍子打死。CLI 也不是万能的:它的输出是给人看的非结构化文本,跨平台、跨语言、授权、需要双向交互或订阅资源的场景,MCP 的结构化和标准化依然有价值。合理的工程姿势是:
- 单个 Server 暴露的工具数控制在 20 个以内,别做一个几百个工具的大杂烩;
- 按领域拆成多个专用 Server,按需启用,而不是全挂着;
- 推动工具 schema 懒加载(只在需要时才拉某类工具的完整定义);
- 对第三方 Server 像对待依赖一样做审计,最小权限授权。
标准自己也在进化:Streamable HTTP 取代 SSE、无状态化、schema 压缩,都是在补这些洞。
Skill 同样不是银弹
Skill 这边也有它自己的坑,别神化:
- 成败全在 description。 它写得不准,模型要么该触发时不触发、要么不该触发时乱触发。这是 Skill 最高频的翻车点,得对着真实调用日志反复打磨。
- Skill 之间会打架。 装了一堆 skill,描述重叠、职责不清时,模型会在几个 skill 之间纠结。
- 正文别膨胀。 一旦 SKILL.md 写得又长又乱,渐进式加载省下的好处就被你自己吃光了,该拆文件就拆。
- 恶意 skill 风险。 它能携带脚本、能指挥模型外联,装来源不明的 skill 和装来源不明的软件一样危险,装之前先看它的依赖和外联行为。
那到底该怎么选?
给你一个简单的决策顺序:
- 只需要一两个工具、就一个应用用 → 直接 function calling,没必要上 MCP,别为了"显得先进"增加一层;
- 能力要在多个客户端/团队之间复用,需要标准化对接、权限协商、远程或双向交互 → 上 MCP;
- 系统本身已经有成熟的 CLI,而且只是一次性、命令式的操作 → 直接让 Agent 调 CLI 往往更轻;
- 你要解决的是"某类任务有固定流程、有团队 SOP、有踩坑经验,需要 Agent 稳定地按章法做" → 写 Skill,不管它底层调的是 MCP 工具还是 CLI。
一句话收尾:MCP 让 Agent 能用上整个世界的工具,Skill 让 Agent 知道什么时候、用什么姿势去用这些工具。 前者解决"连得广、连得标准",后者解决"做得对、做得稳"。把它们当成同一套体系的不同层,而不是二选一的替代品,你才不会在各种新名词里反复横跳。
你们团队在接 MCP 或写 Skill 时,有没有踩过工具爆炸、token 失控或者 skill 死活不触发的坑?评论区聊聊你是怎么解决的。