一、预先准备
作为一个有4年多的前端攻城师,对AI秉承着打不过就加入的原则。想开发一款基于 FastAPI + LangChain 的智能客服系统 ,属于自己的一个智能对话服务系统【我称为:"小鸟" 】。
于是乎,在ai的指导下,look了相关的项目资料,以菜鸟的身份重新入门,给自己添一些新技能(刚好够用)。
在原有前端的基础上,加配以下技能和使用:
新学编程语言: Python3、FastAPI、SQLAlchemy 2.0;
AI/LLM: Propmt工程、Agent、RAG、LangChain。
对于Python3的学习先look一遍 Python3教程文档 一些demo示例都敲一遍,再到B站大学将 Python3教程视频 过一遍视频后,熟练程度还是要在实际项目打磨。
依法炮制: FastAPI 官方文档 、 MySQL文档 (每条指令在终端都挨个玩一遍)
而重中之重的AI Agent,作为资深的B站学员,也是找浏览度最高的课程学习- AI Agent开发零基础教程
就这样吭哧吭哧地学完以上技能,再找一些优秀的帖子,无形地与前辈们探讨:
- 初识:RAG
- 一文读懂:大模型RAG(检索增强生成)含高级方法
- LangChain指南:打造LLM的垂域AI框架
- 小白入门AI:LangChain
- RAG召回率从61%到89%:chunk重切、embedding换型与rerank排序的工程实践
- RAG 向量数据库设计指南:从入门到生产
- AI Agent 全面解析:架构范式、核心组件与工程落地实践
- 这几道高频RAG面试题你都会了吗
- RAG夺命10连问,你能抗住第几问?
学习以上的视频教程和官方文档,再加上专心看完码友分享,体会心得。早已摇摇欲试,再消化并借鉴githua上相关项目。
先来看看效果:


二、小鸟项目方案设计
基于 FastAPI + LangChain 的智能客服系统------小鸟(可以是:售前、售后使用、知识库等),采用微服务架构,集成 RAG 检索增强生成、ReAct Agent 工具调用与 SSE 流式对话,支持多轮会话持久化与用户认证。

项目目录:
langchain-rag-fastapi-service-vue3/
├── backend/ # ① Agent + RAG 后端(FastAPI,端口 8001)
│ ├── agent/ # Agent 层
│ │ ├── react_agent.py
│ │ └── tools/
│ │ ├── agent_tools.py
│ │ └── middleware.py
│ ├── api/ # API 入口 + 路由
│ │ ├── init .py
│ │ ├── main.py
│ │ ├── routes/
│ │ │ ├── init .py
│ │ │ ├── chat.py
│ │ │ ├── history.py
│ │ │ └── users.py
│ │ └── services/
│ │ ├── init .py
│ │ └── history_client.py
│ │
│ ├── config/ # YAML 配置
│ │ ├── agent.yml
│ │ ├── chroma.yml
│ │ ├── prompts.yml
│ │ └── rag.yml
│ │
│ ├── core/ # 限流 + 缓存
│ │ ├── init .py
│ │ ├── rate_limit.py
│ │ ├── redis_cache.py
│ │ └── redis_config.py
│ ├── model/ # 模型工厂
│ │ └── factory.py
│ ├── rag/ # RAG 核心
│ │ ├── rag_service.py
│ │ ├── reranker_service.py
│ │ └── vector_store.py
│ ├── prompts/ # 提示词模板
│ ├── mysql/init/
│ │ └── 01-create-databases.sql
│ ├── utils/ # 工具函数
│ └── logs/
│
├── FastAPI_UserService_HistoryService/ # ② 用户/会话服务(FastAPI,端口 8000)
│ ├── main.py
│ ├── API.md
│ ├── Dockerfile
│ ├── .dockerignore
│ ├── .env
│ ├── requirements.txt
│ ├── config/
│ ├── crud/
│ ├── models/ # SQLAlchemy 模型
│ ├── routers/
│ ├── schemas/ # Pydantic 模型
│ └── utils/
│
├── front/ # ③ Vue3 前端(Vite)
│ ├── index.html
│ ├── package.json
│ ├── vite.config.js
│ ├── Dockerfile
│ ├── nginx.conf
│ ├── .dockerignore / .gitignore
│ ├── public/
│ │
│ └── src/
│ ├── App.vue
│ ├── main.js
│ ├── api/
│ ├── assets/
│ ├── components/
│ ├── router/
│ ├── stores/
│ │ ├── session.js
│ │ └── user.js
│ └── views/
├── docs/
└── images/
| 目录 | 技术栈 | 职责 |
|---|---|---|
| backend/ | FastAPI + LangChain/LangGraph + ChromaDB + Redis | Agent 对话、RAG 检索/重排/总结、SSE 流式输出 |
| FastAPI_UserService_HistoryService/ | FastAPI + SQLAlchemy(MySQL) + Redis + bcrypt | 用户认证、会话/消息存储 |
| front/ | Vue3 + Vite + Pinia + Vue Router | 聊天界面、用户/会话管理 UI |
2.1 前后端技术栈
选用技术栈,就是自己所能掌握或有一定认知的,也要覆盖到自己所写到。
后端技术栈:
语言/框架: Python 3.12、FastAPI、SQLAlchemy 2.0(异步 / aiomysql)
AI/LLM: LangChain(ReAct Agent、SemanticChunker)、通义千问 Qwen3(DashScope API)
RAG 检索: ChromaDB 向量库、混合检索(向量 + BM25 + RRF 融合)、HyDE 查询增强、Qwen3-Reranker-0.6B 本地 Cross Encoder 重排序(Transformers / PyTorch)
存储/缓存: MySQL(关系数据)、Redis(限流 + 缓存,双逻辑库)
通信: SSE(Server-Sent Events)流式输出、httpx 服务间调用
其他: bcrypt 密码加密、LangSmith 链路追踪、Docker Compose、JWT/Token 鉴权,balabala~
前端技术栈: Vue 3+Composition API+Vite+ElementPlus+Pinia+Axios+原生 fetch + SSE 流式解析+Markdown 渲染。
2.2 前后端功能点
后端功能点
设计并实现 RAG 检索增强链路: HyDE 假设性文档 → 混合检索(向量 + BM25 + RRF 融合)→ Cross Encoder 重排序 → LLM 总结,显著提升召回精度;
基于 LangChain 实现 ReAct Agent ,挂载 7 个工具(知识检索、天气、用户位置、外部数据拉取等),通过中间件实现工具调用监控与报告场景动态提示词切换
实现 SSE 流式对话接口,逐 token 推送回复,前端打字机式渲染,优化首字响应体验;
搭建 微服务架构: Agent 服务(:8001)与用户/历史服务(:8000)分离,通过 HTTP 代理解耦,用户/会话/消息数据统一由后者持久化;
实现用户认证与会话管理: 注册/登录、Token 签发校验(bcrypt 加密)、会话/消息 CRUD、关键词搜索、头像上传安全校验;
引入 Redis 双层限流(接口级 + 全局 IP 级)与 RAG 结果缓存(MD5 去重键、30 分钟 TTL),并做 Redis 故障降级;
建立统一响应格式 ({code, message, data})、全局异常处理、结构化日志与 /health 健康检查,接入 LangSmith 做全链路追踪;
使用 SemanticChunker 语义分块 (余弦相似度)替换固定长度分块,保证文档切片语义完整。
前端功能点
1. 实现 流式对话界面: SSE 逐字接收、打字机动画、Markdown 实时渲染
2. 实现会话管理: 会话列表(分页/搜索)、新建/切换/删除会话、历史消息回溯
3. 实现用户模块: 登录/注册、个人资料编辑、修改密码、头像上传
4. 封装 Axios 拦截器:自动注入 Token、统一中文错误提示、401 自动跳转登录;配置全局路由守卫实现未登录拦截
2.3 Agent设计【重点】
这里以实际工程讲解为主,详细理论可以look 初识ai Agent
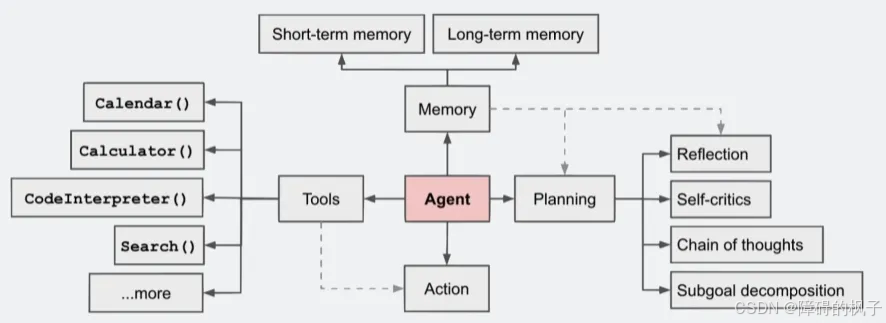
- Agent(代理)
python
from langchain.agents import create_agent
from model.factory import chat_model

class ReactAgent:
    def __init__(self):
        self.agent = create_agent(
            model=chat_model,
            system_prompt=load_system_prompt(),
            tools=[rag_summarize, get_weather, get_user_location, get_user_id,
                   get_current_month, fetch_external_data, fill_context_for_report],
            middleware=[monitor_tool, log_before_model, report_prompt_switch],
        )
        ......
用create_agent创建Agent,绑定Model、Prompt、Tools和Middleware。
- Model(大模型)
LLM是使用qwen3.5-flash, 向量化应用阿里百炼的text-embedding-v4,【阿里百炼的其他方案】
python
from abc import ABC, abstractmethod
from typing import Optional
from langchain_core.embeddings import Embeddings
from langchain_core.language_models.chat_models import BaseChatModel
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_community.embeddings import DashScopeEmbeddings

class BaseModelFactory(ABC):
    @abstractmethod
    def generator(self) -> Optional[Embeddings | BaseChatModel]:
        pass

 #聊天模型工厂
class ChatModelFactory(BaseModelFactory):
    def generator(self) -> Optional[BaseChatModel]:
        return ChatTongyi(model=rag_conf["chat_model_name"]) #qwen3.5-flash

#嵌入模型工厂
class EmbeddingFactory(BaseModelFactory):
    def generator(self) -> Optional[Embeddings]:
        return DashScopeEmbeddings(model=rag_conf["embedding_model_name"]) # text-embedding-v4

chat_model = ChatModelFactory().generator()
embed_model = EmbeddingFactory().generator()- Prompt工程加载
将Prompts目录下的Prompt定义加载,再交给Agent去代理:systen_prompt = system_prompt()
python
def load_system_prompt():
    try:
        system_prompt_path = get_abs_path(prompts_conf["main_prompt_path"])
    except Exception as e:
        logger.error(f"[load_system_prompt]在yaml配置项中没有main_prompt_path配置项")
        raise e

    try:
        return open(system_prompt_path, "r", encoding="utf-8").read()
    except Exception as e:
        logger.error(f"[load_system_prompt]读取系统提示词文件出错:{e}")
        raise e
# 以此类推,加载其它prompt
def load_rag_summarize_prompt():
......
def load_report_prompt():
......
def .....- Tools(工具)
Tools一般都多多益善,技多不压身:rag_summarize(RAG的会在后面重点阐述), get_weather, get_user_location, get_user_id,get_current_month, fetch_external_data...
python
from langchain_core.tools import tool

@tool(description="从向量存储中检索参考资料")
def rag_summarize(query: str) -> str:
    return rag.rag_summarize(query)

@tool(description="获取指定城市的天气,以消息字符串的形式返回")
def get_weather(city: str) -> str:
    return f"城市{city}天气为晴天,气温26摄氏度,空气湿度50%,南风1级,AQI21,最近6小时降雨概率极低"

@tool(description="获取用户所在城市的名称,以纯字符串形式返回")
def get_user_location() -> str:
    return random.choice(["深圳", "合肥", "杭州"])
......- Action(行动)
@wrap_tool_call monitor_tool ------ 包在每次工具实际执行外面,做调用日志 + 执行 + 给 runtime 上下文打标记(fill_context_for_report 触发后把 context"report"=True)
再由create_agent(..., tools=..., middleware=...) 把这些工具注册进 Agent
「选哪个动作」这一步是模型自己通过 function/tool calling 决定的,不是代码里 if/else 写的。
python
from typing import Callable
from utils.prompt_loader import load_system_prompt, load_report_prompt
from langchain.agents import AgentState
from langchain.agents.middleware import wrap_tool_call, before_model, dynamic_prompt, ModelRequest
from langchain.tools.tool_node import ToolCallRequest
from langchain_core.messages import ToolMessage
from langgraph.runtime import Runtime
from langgraph.types import Command
from utils.logger_handler import logger


@wrap_tool_call
def monitor_tool(
        # 请求的数据封装
        request: ToolCallRequest,
        # 执行的函数本身
        handler: Callable[[ToolCallRequest], ToolMessage | Command],
) -> ToolMessage | Command:             # 工具执行的监控
    logger.info(f"[tool monitor]执行工具:{request.tool_call['name']}")
    logger.info(f"[tool monitor]传入参数:{request.tool_call['args']}")

    try:
        result = handler(request)
        logger.info(f"[tool monitor]工具{request.tool_call['name']}调用成功")

        if request.tool_call['name'] == "fill_context_for_report":
            request.runtime.context["report"] = True

        return result
    except Exception as e:
        logger.error(f"工具{request.tool_call['name']}调用失败,原因:{str(e)}")
        raise e


@before_model
def log_before_model(
        state: AgentState,          # 整个Agent智能体中的状态记录
        runtime: Runtime,           # 记录了整个执行过程中的上下文信息
):         # 在模型执行前输出日志
    logger.info(f"[log_before_model]即将调用模型,带有{len(state['messages'])}条消息。")

    logger.debug(f"[log_before_model]{type(state['messages'][-1]).__name__} | {state['messages'][-1].content.strip()}")

    return None


@dynamic_prompt                 # 每一次在生成提示词之前,调用此函数
def report_prompt_switch(request: ModelRequest):     # 动态切换提示词
    is_report = request.runtime.context.get("report", False)
    if is_report:               # 是报告生成场景,返回报告生成提示词内容
        return load_report_prompt()

return load_system_prompt()- Memory(记忆)
可分为短期记忆和长期记忆。
短期记忆(Short-term)= LangGraph 的 AgentState"messages"
_history_to_langchain_messages() 把历史消息转成 HumanMessage/AIMessage/SystemMessage,拼上当前提问,作为 input_dict = {"messages": lc_messages} 传入,中间件里的 state'messages' 就是这个状态
python
@before_model
def log_before_model(
        state: AgentState,          # 整个Agent智能体中的状态记录
        runtime: Runtime,           # 记录了整个执行过程中的上下文信息
):         # 在模型执行前输出日志
    logger.info(f"[log_before_model]即将调用模型,带有{len(state['messages'])}条消息。")

    logger.debug(f"[log_before_model]{type(state['messages'][-1]).__name__} | {state['messages'][-1].content.strip()}")

    return None
python
def _history_to_langchain_messages(messages: Optional[list[dict]]):
    """
    将 HistoryService 返回的消息列表转换为 LangChain 消息格式
    :param messages: [{"role": "user|assistant|system", "content": "..."}, ...]
    :return: LangChain 消息对象列表
    """
    if not messages:
        return []
    lc_messages = []
    for m in messages:
        role = m.get("role", "")
        content = m.get("content", "")
        if role == "user":
            lc_messages.append(HumanMessage(content=content))
        elif role == "assistant":
            lc_messages.append(AIMessage(content=content))
        elif role == "system":
            lc_messages.append(SystemMessage(content=content))
    return lc_messages
python
def execute_stream(self, query: str, history_messages: Optional[list[dict]] = None):
        """
        流式执行 Agent
        :param query: 用户当前提问
        :param history_messages: 历史消息列表 [{"role": "...", "content": "..."}, ...]
        :yield: 文本片段
        """
        # 组装消息:历史消息 + 当前提问
        lc_messages = _history_to_langchain_messages(history_messages)
        lc_messages.append(HumanMessage(content=query))

        input_dict = {"messages": lc_messages}

        for chunk in self.agent.stream(input_dict, stream_mode="values", context={"report": False}):
            latest_message = chunk["messages"][-1]
            # 只输出 AI 消息,过滤掉 HumanMessage 等非 AI 消息,避免重复输出用户问题
            if isinstance(latest_message, AIMessage) and latest_message.content:
                yield latest_message.content.strip() + "\n"
长期记忆(Long-term)= HistoryService 的 MySQL
有两个表:ConversationSession(会话)+ ConversationMessage(消息,含 sources/meta_data 两个 JSON 字段)
python
from datetime import datetime
from typing import Optional

from sqlalchemy import Integer, String, DateTime, ForeignKey, Index, Text, Enum as SAEnum, JSON
from sqlalchemy.orm import Mapped, mapped_column, relationship

from .users import User, Base


class ConversationSession(Base):
    """
    会话表 - 存储每次对话会话的元信息
    用于 LangChain + RAG 集成时管理会话上下文
    """
    __tablename__ = 'conversation_session'

    __table_args__ = (
        Index('fk_session_user_idx', 'user_id'),
        Index('idx_session_updated', 'updated_at'),
    )

    id: Mapped[int] = mapped_column(Integer, primary_key=True, autoincrement=True, comment="会话ID")
    user_id: Mapped[int] = mapped_column(Integer, ForeignKey(User.id), nullable=False, comment="用户ID")
    title: Mapped[Optional[str]] = mapped_column(String(200), nullable=True, comment="会话标题(可由首条消息自动生成)")
    created_at: Mapped[datetime] = mapped_column(DateTime, default=datetime.now, nullable=False, comment="创建时间")
    updated_at: Mapped[datetime] = mapped_column(DateTime, default=datetime.now, onupdate=datetime.now,
                                                 nullable=False, comment="最后更新时间")

    # 关联消息
    messages: Mapped[list["ConversationMessage"]] = relationship(
        "ConversationMessage", back_populates="session", lazy="selectin",
        order_by="ConversationMessage.created_at"
    )

    def __repr__(self):
        return f"<ConversationSession(id={self.id}, user_id={self.user_id}, title='{self.title}')>"


class ConversationMessage(Base):
    """
    会话消息表 - 存储每条对话消息
    role: user(用户) / assistant(AI) / system(系统提示)
    sources: JSON字段,存储 RAG 检索到的来源文档信息
    metadata: JSON字段,存储 LangChain 所需的额外元数据(如token用量、模型名等)
    """
    __tablename__ = 'conversation_message'

    __table_args__ = (
        Index('fk_message_session_idx', 'session_id'),
        Index('idx_message_created', 'created_at'),
    )

    id: Mapped[int] = mapped_column(Integer, primary_key=True, autoincrement=True, comment="消息ID")
    session_id: Mapped[int] = mapped_column(Integer, ForeignKey(ConversationSession.id), nullable=False, comment="所属会话ID")
    role: Mapped[str] = mapped_column(
        SAEnum('user', 'assistant', 'system', name='message_role_enum'),
        nullable=False, comment="消息角色:user/assistant/system"
    )
    content: Mapped[str] = mapped_column(Text, nullable=False, comment="消息内容")
    sources: Mapped[Optional[dict]] = mapped_column(JSON, nullable=True, comment="RAG检索来源文档(JSON格式)")
    meta_data: Mapped[Optional[dict]] = mapped_column(JSON, nullable=True, comment="额外元数据(token用量、模型等)")
    created_at: Mapped[datetime] = mapped_column(DateTime, default=datetime.now, nullable=False, comment="消息创建时间")

    # 关联会话
    session: Mapped["ConversationSession"] = relationship("ConversationSession", back_populates="messages")

    def __repr__(self):
        return f"<ConversationMessage(id={self.id}, session_id={self.session_id}, role='{self.role}')>"
每轮对话开始时从库里拉全量历史,用户提问后,再喂回 Agent
python
async def _load_history(token: str, session_id: int) -> list[dict]:
    """从 HistoryService 加载会话历史消息"""
    try:
        return await history_client.get_all_messages(token, session_id)
    except Exception as e:
        logger.warning(f"[load history]加载历史消息失败: {e}")
        return []
友情提示: 这里没有向量化的记忆检索------长期记忆是「整段拉取历史消息」,不是 embedding + 相似度召回。Redis 在这个项目里只做 RAG 结果缓存和限流,不承担 Agent 记忆。
- Planning(规划)
create_agent 内置的 ReAct 循环(LangGraph 底层),即 思考 → 选工具 → 执行 → 观察 → 再思考 → ... → 给出最终答案。
这里,我只写了两个中间件:
- @before_model log_before_model ------ 每次调模型前的钩子
- @dynamic_prompt report_prompt_switch ------ 根据 runtime 上下文动态切换系统提示词:普通场景用 main_prompt.txt,报告场景(context"report"=True)切换到 report_prompt.txt。
2.3 RAG设计【重点】

一句话总结整条 RAG 主线:TXT/PDF 解析 → SemanticChunker 语义切分 → DashScope 向量化入 ChromaDB → HyDE 查询增强 → 向量+BM25 混合检索 + RRF 融合 → Qwen3-Reranker Cross Encoder 精排 → 通义千问 LCEL 总结生成 → Redis 缓存,外层再套一层 LangChain/LangGraph 的 Agent 工具调用,最终通过 FastAPI SSE 流式推给 Vue3 前端。【以下是详细拆解到代码级的】
(1)索引阶段(Indexing)------离线建库
【文档加载】(TXT/PDF ──加载 ──文档对象) ──▶【语义切分】(语义切分── 文本块)──▶ 向量化──▶ ChromaDB ──MD5去重入库
- 【文档加载】
python
import os,hashlib	# 从文件夹读取资料等使用,以下不做多阐述
from langchain_core.documents import Document
from langchain_community.document_loaders import  TextLoader, PyPDFLoader

def pdf_loader(filepath: str,password: str = None)->list[Document]:
    return PyPDFLoader(filepath,password=password).load()

def txt_loader(filepath: str)->list[Document]:
return TextLoader(filepath, encoding='utf-8').load()- 【语义切分】
python
self.spliter = SemanticChunker(
    embeddings=embed_model,            # 复用 text-embedding-v4
    breakpoint_threshold_type="percentile",   # 阈值计算方式
    breakpoint_threshold_amount=95,            # 百分位 95
)
工作流程:
1.先把文档按句子拆开,对每个句子算一次 embedding(向量);
2.计算相邻两个句子向量之间的余弦距离(1 - cosine_similarity),得到一串「语义距离」序列;
3.语义距离越大 = 这两个句子之间越像「话题切换点 / 语义断层」;
4.用 percentile=95 确定断点阈值:把所有相邻距离排序,取 第 95 百分位 作为阈值;
5.凡是语义距离 超过阈值 的地方就切断 → 形成文本块。
为什么用 percentile=95?
答:因为 95 分位意味着只有「语义差距最大」的前 5% 位置才切断,所以切得少、块大、语义完整。这也是值越大切的块越少(语义越完整)的原因。
它对比 RecursiveCharacterTextSplitter(按固定长度切)的优势:在语义边界处切,不会把一句话从中间截断,也不会把两个不同话题硬拼进同一块。
另外两种可选模式(breakpoint_threshold_type):standard_deviation(均值 + k·标准差)、interquartile(中位数 + k·IQR)。我是用 percentile。
- 向量化
在上面的Agent时,已经注册了embed_model:
python#嵌入模型工厂 class EmbeddingFactory(BaseModelFactory): def generator(self) -> Optional[Embeddings]: return DashScopeEmbeddings(model=rag_conf["embedding_model_name"]) # text-> embedding-v4 embed_model = EmbeddingFactory().generator()
向量化不是一段独立的「embed 再存」代码,而是交给 ChromaDB 自动完成的。Chroma 初始化时绑定了这个嵌入函数(vector_store.py:16-20):
python
self.vector_store = Chroma(
    collection_name=chroma_conf["collection_name"],
    embedding_function=embed_model,          # ← 绑定 text-embedding-v4
    persist_directory=chroma_conf["persist_directory"],
)
之后调用 add_documents() 时,Chroma 内部自动调用 embed_model.embed_documents() 把每个文本块算成向量再落盘。
python
def load_document(self):
        """
        从数据文件夹内读取数据文件,转为向量存入向量库
        要计算文件的MD5做去重

        :return:None
        """


        def check_md5_hex(md5_for_check: str):
            if not os.path.exists(get_abs_path(chroma_conf["md5_hex_store"])):
                # 创建文件
                open(get_abs_path(chroma_conf["md5_hex_store"]), "w", encoding="utf-8").close()
                return False            #md5 没处理过

            with open(get_abs_path(chroma_conf["md5_hex_store"]), "r", encoding="utf-8") as f:
                for line in f.readlines():
                    line = line.strip()
                    if line == md5_for_check:
                        return True     #md5 处理过
            return False        #md5 不存在

        def save_md5_hex(md5_str: str):
            """将传入的md5字符串,记录到文件中保存"""

            with open(get_abs_path(chroma_conf["md5_hex_store"]), "a", encoding="utf-8") as f:
                f.write(md5_str + "\n")

        def get_file_document(read_path:str):
            if read_path.endswith("txt"):
                return txt_loader(read_path)

            if read_path.endswith("pdf"):
                return pdf_loader(read_path)

            return  []

        allowed_file_path:list[str] = listdir_with_allowed_type(
            get_abs_path(chroma_conf["data_path"]),
            tuple(chroma_conf["allowed_knowledge_file_type"]),
        )

        for path in allowed_file_path:
            # 获取文件的MD5
            md5_hex = get_file_md5_hex(path)

            if check_md5_hex(md5_hex):
                logger.info(f"加载知识库{path}内容已经存在知识库内,跳过")
                continue

            try:
                from langchain_core.documents import Document
                documents:list[Document] = get_file_document(path)

                if not documents:
                    logger.warning(f"加载知识库文件{path}内容为空,跳过")
                    continue

                split_documents = self.spliter.split_documents(documents)

                if not split_documents:
                    logger.warning(f"加载知识库文件{path}分片后没有有效文本内容,跳过")
                    continue

                # 将分片后的内容添加到向量库
                self.vector_store.add_documents(split_documents)

                # 记录这个已经处理好的文件的md5,避免下次重复加载
                save_md5_hex(md5_hex)

                logger.info(f"[加载知识库{path} 内容加载成功]")
            except Exception as e:
                # exc_info=True 表示会记录详细的报错堆栈,如果为False则记录错误信息本身
                logger.error(f"加载知识库{path}加载失败:{str(e)},",exc_info=True)

        # 文档加载完毕后,重建 BM25 检索器
        self._build_bm25_retriever()
python
def _build_bm25_retriever(self):
        """构建 BM25 关键词检索器"""
        all_docs = self._get_all_documents()
        if all_docs:
            self._bm25_retriever = BM25Retriever.from_documents(
                documents=all_docs,
                k=chroma_conf["k"],
            )
            logger.info(f"【混合检索】BM25 检索器构建成功,共 {len(all_docs)} 个文档片段")
        else:
            self._bm25_retriever = None
            logger.warning("【混合检索】向量库无文档,BM25 检索器未构建")
以上重点代码流程:
python
for path in allowed_file_path:                       # 遍历 data/ 目录下 txt/pdf
    md5_hex = get_file_md5_hex(path)                 # ① 算 MD5
    if check_md5_hex(md5_hex):                       # ② 已处理过?
        logger.info("...已存在知识库内,跳过")
        continue

    documents = get_file_document(path)              # 加载 txt/pdf
    split_documents = self.spliter.split_documents(documents)   # 语义切分
    self.vector_store.add_documents(split_documents) # ③ 向量化+入库
    save_md5_hex(md5_hex)                            # ④ 记录 MD5,下次跳过
(2)检索生成阶段(Retrieval + Generation)
用户提问 ──▶ Redis缓存? ──▶ HyDE假设文档 ──▶ 混合检索(向量+BM25+RRF)
──▶ Cross Encoder重排 ──▶ 拼上下文 ──▶ LLM总结生成 ──▶ 写缓存 ──▶ 返回
rag_summarize当作是Agent的Tool来被使用,主流程代码如下:
python
@traceable
    def rag_summarize(self, query: str, use_hyde: bool = True) -> str:
        """
        RAG 摘要:检索 + 重排序 + 总结
        完整流程: Redis缓存 → HyDE → 混合检索 → Cross Encoder 精排 → LLM 总结 → 写入缓存
        :param query: 用户提问
        :param use_hyde: 是否启用 HyDE 查询增强
        """

        # ===== Redis 缓存查询:相同问题直接返回 =====
        cached = self._get_cache(query)
        if cached is not None:
            logger.info(f"【RAG】命中 Redis 缓存,直接返回(query={query[:30]}...)")
            return cached

        # HyDE:用假设性文档替代原始查询进行检索
        retrieve_query = query
        if use_hyde:
            try:
                retrieve_query = self.generate_hypothetical_document(query)
            except Exception as e:
                logger.warning(f"【HyDE】降级为原始查询检索: {e}")

        context_docs = self.retriever_docs(retrieve_query)

        # Cross Encoder 重排序:用原始 query 精排召回结果
        if self.use_reranker and context_docs:
            try:
                context_docs = self.rerank_docs(query, context_docs)
            except Exception as e:
                logger.warning(f"【Reranker】降级跳过重排: {e}")

        context = ""
        counter = 0
        for doc in context_docs:
            context += f"参考资料{counter}:参考资料:{doc.page_content}| 参考元数据:{doc.metadata}\n"
            counter += 1

        result = self.chain.invoke(
            {
                "input": query,
                "context": context
            }
        )

        # ===== 写入 Redis 缓存 =====
        self._set_cache(query, result)
        return result
① 缓存命中
相同问题 MD5 键直接返回
python
 # ==================== Redis 缓存辅助方法 ====================

    @staticmethod
    def _get_cache(query: str):
        """从 Redis 获取缓存(同步方法中调异步)"""
        try:
            loop = asyncio.get_event_loop()
            if loop.is_running():
                import concurrent.futures
                with concurrent.futures.ThreadPoolExecutor() as pool:
                    return pool.submit(asyncio.run, rag_cache.get(query)).result()
            else:
                return loop.run_until_complete(rag_cache.get(query))
        except Exception:
            return None
② HyDE 查询增强
让 LLM 先造假设性回答,用它去检索提升召回.
HyDE = Hypothetical Document Embeddings(假设性文档嵌入),解决的核心问题是「用户提问和文档的词汇/风格不匹配」:
- 用户提问往往很口语、很短(如「怎么充电?」)
- 知识库文档却是长句、术语化、书面语
- 直接用「提问向量」去检索,可能和文档向量距离很远,召回差
做法:先让 LLM 凭空编一个「假设性回答」,用这个回答去检索,因为这个假设回答是用和文档相似的语言风格写出来的,向量更接近真实相关文档。
python
    @traceable
    def generate_hypothetical_document(self, query: str) -> str:
        """
        HyDE 技术:让模型生成一个假设性回答,用假设性回答去检索,提高召回率
        """
        try:
            hyde_chain = self.hyde_prompt_template | self.model | StrOutputParser()
            hypothetical_doc = hyde_chain.invoke({"query": query})
            logger.info(f"【HyDE】生成假设性文档成功,长度={len(hypothetical_doc)}")
            return hypothetical_doc
        except Exception as e:
            logger.error(f"【HyDE】生成假设性文档失败: {e}")
            return query
③ 混合检索
向量相似度 + BM25,RRF 融合 + 动态权重
两条检索通路:
- 向量检索:similarity 相似度(语义匹配,能懂同义词/改写)
- BM25 检索:关键词匹配(能精确命中专有名词/编号)
两者召回结果打分尺度完全不同(余弦相似度 vs BM25 分数),不能直接相加,所以用 RRF(Reciprocal Rank Fusion,互惠排名融合) 按「排名」而非「分数」融合。
RRF 公式: score(doc) = Σ ( weight / (k + rank(doc) + 1) )
- k = 60(常数,平滑用,避免排名第一的文档权重过大)------见 vector_store.py:120
- rank:文档在各自结果列表里的名次(0 起)
- weight:该检索通路的权重(见下面动态权重)
代码实现:
python
# 向量通路累加
for rank, doc in enumerate(vector_docs):
    doc_scores[content_key] += vector_weight / (k + rank + 1)

# BM25 通路累加
for rank, doc in enumerate(bm25_docs):
    doc_scores[content_key] += bm25_weight / (k + rank + 1)
同一个文档出现在两条通路里,就把两边的 RRF 分加在一起,最后按总分降序取前 k 篇。
动态权重:
| 查询长度 | 向量权重 | BM25 权重 | 意图 |
|---|---|---|---|
| > 50 字 | 0.7 | 0.3 | 长句偏语义 |
| < 20 字 | 0.3 | 0.7 | 短句偏关键词 |
| 20~50 字 | 0.5 | 0.5 | 均衡 |
再叠加一个「词密度」微调:word_density = 词数/长度 > 0.1 时 BM25 再加 0.1(上限 0.7)、向量减 0.1(下限 0.3)。
python
@staticmethod
    def _get_dynamic_weights(query: str = None) -> list:
        """
        根据查询特征动态调整向量检索与 BM25 检索的权重
        长查询更偏向语义(向量),短查询更偏向关键词(BM25)
        :return: [向量权重, BM25权重]
        """
        default_vector_weight = 0.5
        default_bm25_weight = 0.5

        if not query:
            return [default_vector_weight, default_bm25_weight]

        query_length = len(query)

        if query_length > 50:
            vector_weight, bm25_weight = 0.7, 0.3
        elif query_length < 20:
            vector_weight, bm25_weight = 0.3, 0.7
        else:
            vector_weight, bm25_weight = default_vector_weight, default_bm25_weight

        query_words = len(query.split())
        if query_words > 0:
            word_density = query_words / query_length
            if word_density > 0.1:
                bm25_weight = min(bm25_weight + 0.1, 0.7)
                vector_weight = max(vector_weight - 0.1, 0.3)

        logger.info(f"【混合检索】查询长度={query_length}, 权重分配: 向量={vector_weight}, BM25={bm25_weight}")
        return [vector_weight, bm25_weight]
去重键: 用 page_content:200 前 200 字符做 key 去重,避免两条通路召回同一篇文档时重复计分。
降级策略: BM25 未构建或异常时,直接回退纯向量检索
python
def hybrid_search(self, query: str) -> list:
        """
        混合检索:向量 + BM25,基于互惠排名融合(RRF)合并结果
        :param query: 用户查询
        :return: 合并后的文档列表
        """
        if self._bm25_retriever is None:
            self._build_bm25_retriever()

        # 向量检索
        vector_retriever = self.vector_store.as_retriever(
            search_type="similarity",
            search_kwargs={"k": chroma_conf["k"]},
        )
        vector_docs = vector_retriever.invoke(query)

        # BM25 不可用时降级
        if self._bm25_retriever is None:
            logger.info("【混合检索】BM25 不可用,降级为纯向量检索")
            return vector_docs

        # BM25 检索
        bm25_docs = self._bm25_retriever.invoke(query)

        # 获取动态权重
        weights = self._get_dynamic_weights(query)
        vector_weight, bm25_weight = weights

        # 互惠排名融合(RRF)
        k = 60  # RRF 常数
        doc_scores = {}
        doc_contents = {}  # 用内容去重

        for rank, doc in enumerate(vector_docs):
            content_key = doc.page_content[:200]  # 用前200字符做去重键
            if content_key not in doc_contents:
                doc_scores[content_key] = 0.0
                doc_contents[content_key] = doc
            doc_scores[content_key] += vector_weight / (k + rank + 1)

        for rank, doc in enumerate(bm25_docs):
            content_key = doc.page_content[:200]
            if content_key not in doc_contents:
                doc_scores[content_key] = 0.0
                doc_contents[content_key] = doc
            doc_scores[content_key] += bm25_weight / (k + rank + 1)

        # 按融合分数排序
        sorted_keys = sorted(doc_scores.keys(), key=lambda x: doc_scores[x], reverse=True)
        result = [doc_contents[k] for k in sorted_keys[:chroma_conf["k"]]]

        logger.info(f"【混合检索】向量={len(vector_docs)}篇, BM25={len(bm25_docs)}篇, 合并={len(result)}篇")
        return result
④ 精排
Cross Encoder 重排,保留 top_k
python
@traceable
    def rerank_docs(self, query: str, docs: list[Document]) -> list[Document]:
        """
        Cross Encoder 重排序:对混合检索结果进行精排
        :param query: 原始用户查询
        :param docs:  混合检索返回的文档列表
        :return: 重排序后的文档列表(仅保留 top-k)
        """
        if not self.reranker or len(docs) <= 1:
            return docs

        try:
            # 提取文档内容用于重排序
            contents = [doc.page_content for doc in docs]
            ranked = self.reranker.rerank(query, contents)

            # 构建 内容 -> Document 映射,重排后保留原始 Document 对象
            content_to_doc = {doc.page_content: doc for doc in docs}
            reranked_docs = []
            for item in ranked:
                doc = content_to_doc.get(item["document"])
                if doc:
                    reranked_docs.append(doc)

            # 未匹配的文档追加到末尾
            for doc in docs:
                if doc not in reranked_docs:
                    reranked_docs.append(doc)

            logger.info(
                f"【Reranker】重排后保留 {len(reranked_docs)} 篇文档"
                f"(最高分={ranked[0]['score']:.4f})" if ranked else ""
            )
            return reranked_docs

        except Exception as e:
            logger.error(f"【Reranker】重排序失败,保留原顺序: {e}")
            return docs
⑤ 拼上下文
将重拍后的top_k参考资料 和元数据拼进模板
python
        context = ""
        counter = 0
        for doc in context_docs:
            context += f"参考资料{counter}:参考资料:{doc.page_content}| 参考元数据:{doc.metadata}\n"
            counter += 1
⑥ 生成
交给Model生成
⑦ 写缓存
将会话写入Redis
三:优化点
提取资料建库时,精度处理的不好,发现Githua有款很nice的工具 OpenDataLoader PDF 后续用这个试一下,加到项目去。
根据 初始RAG 的品胖标准再微调改改。
就到此为止,后续,等找到工作,有时间再优化改改,分享出来。