在之前的文章中我们介绍过,大模型的训练流程是先输入一段文本,转换成token列表,正向计算一遍输出预测下一个token的概率。然后与正确结果比较,通过反向传播更新参数值。那么大模型是如何得到输出概率的?如何判断大模型训练中的能力水平?参数具体是如何反向传播的?又是使用什么方法更新参数值的?这篇文章将会介绍从模型数据输出结果开始的参数训练原理,涉及很多主题。
前置数学基础
人工智能相关算法中,包含很多的数学知识,其中更是包含大量矩阵操作。虽然上学的时候学过,但已经忘了不少。因此这里再简单复习一下下文中会用到的一些数学知识。
矩阵乘法
一个M×N的矩阵 AM×N A_{M \times N} AM×N,一般表示M行N列。例如下面为三行两列的矩阵 A3×2 A_{3 \times 2} A3×2,每个元素 aij a_{ij} aij表示这个元素在第i行,第j列。 a11 a12 a21 a22 a31 a32 \begin{bmatrix} a_{11} & a_{12} \\ a_{21} & a_{22} \\ a_{31} & a_{32} \end{bmatrix} a11a21a31a12a22a32
矩阵和矩阵之间可以进行运算,其中矩阵加法就是要求矩阵行列相同每个元素相加,矩阵相乘则麻烦一点。两个矩阵相乘,要求左边矩阵的列数等于右边矩阵的行数,形如: AM×N ⋅ BN×K = CM×K A_{M \times N} \cdot B_{N \times K} = C_{M \times K} AM×N⋅BN×K=CM×K。矩阵相乘的结果是一个矩阵,行数和列数分别为左边矩阵的行数和右边矩阵的列数。其中的每个元素值为左边行与右边列中每个元素相乘再相加的结果。 设 A3×2 = a11 a12 a21 a22 a31 a32 , B2×4 = b11 b12 b13 b14 b21 b22 b23 b24 C3×4 = A3×2 ⋅ B2×4 = a11 a12 a21 a22 a31 a32 ⋅ b11 b12 b13 b14 b21 b22 b23 b24 = a11b11+a12b21 a11b12+a12b22 a11b13+a12b23 a11b14+a12b24 a21b11+a22b21 a21b12+a22b22 a21b13+a22b23 a21b14+a22b24 a31b11+a32b21 a31b12+a32b22 a31b13+a32b23 a31b14+a32b24 \begin{align*} 设 A_{3 \times 2} &= \begin{bmatrix} a_{11} & a_{12} \\ a_{21} & a_{22} \\ a_{31} & a_{32} \end{bmatrix} , \quad B_{2 \times 4} = \begin{bmatrix} b_{11} & b_{12} & b_{13} & b_{14} \\ b_{21} & b_{22} & b_{23} & b_{24} \end{bmatrix} \\10pt C_{3 \times 4} &= A_{3 \times 2} \cdot B_{2 \times 4} \\ & = \begin{bmatrix} a_{11} & a_{12} \\ a_{21} & a_{22} \\ a_{31} & a_{32} \end{bmatrix} \cdot \begin{bmatrix} b_{11} & b_{12} & b_{13} & b_{14} \\ b_{21} & b_{22} & b_{23} & b_{24} \end{bmatrix} \\ &= \begin{bmatrix} a_{11}b_{11}+a_{12}b_{21} & a_{11}b_{12}+a_{12}b_{22} & a_{11}b_{13}+a_{12}b_{23} & a_{11}b_{14}+a_{12}b_{24}\\ a_{21}b_{11}+a_{22}b_{21} & a_{21}b_{12}+a_{22}b_{22} & a_{21}b_{13}+a_{22}b_{23} & a_{21}b_{14}+a_{22}b_{24}\\ a_{31}b_{11}+a_{32}b_{21} & a_{31}b_{12}+a_{32}b_{22} & a_{31}b_{13}+a_{32}b_{23} & a_{31}b_{14}+a_{32}b_{24} \end{bmatrix} \end{align*} 设A3×2C3×4= a11a21a31a12a22a32 ,B2×4=b11b21b12b22b13b23b14b24 =A3×2⋅B2×4= a11a21a31a12a22a32 ⋅b11b21b12b22b13b23b14b24 = a11b11+a12b21a21b11+a22b21a31b11+a32b21a11b12+a12b22a21b12+a22b22a31b12+a32b22a11b13+a12b23a21b13+a22b23a31b13+a32b23a11b14+a12b24a21b14+a22b24a31b14+a32b24
因此,矩阵相乘不满足交换律,因为交换之后中间的行列数可能不相等,即使相等,计算结果也不同;但满足结合律,即计算括号可以重新组合。 交换律: AM×N ⋅ BN×K 合法 BN×K ⋅ AM×N 不合法 结合律: ( AM×N ⋅ BN×K )⋅ CK×J = AM×N ⋅( BN×K ⋅ CK×J ) \begin{align} & 交换律: \\ & A_{M \times N} \cdot B_{N \times K} 合法 \quad B_{N \times K} \cdot A_{M \times N} 不合法 \\ & 结合律: \\ & (A_{M \times N} \cdot B_{N \times K}) \cdot C_{K \times J} = A_{M \times N} \cdot (B_{N \times K} \cdot C_{K \times J}) \end{align} 交换律:AM×N⋅BN×K合法BN×K⋅AM×N不合法结合律:(AM×N⋅BN×K)⋅CK×J=AM×N⋅(BN×K⋅CK×J)
向量可以看作是一个特殊的矩阵,即行或者列为1。下面列举几种矩阵相乘的特殊场景。首先是矩阵乘向量,结果为另一个向量: C3×1 = A3×2 ⋅ B2×1 = a11 a12 a21 a22 a31 a32 ⋅ b11 b21 = a11b11+a12b21 a21b11+a22b21 a31b11+a32b21 \begin{align*} C_{3 \times 1} &= A_{3 \times 2} \cdot B_{2 \times 1} \\ &= \begin{bmatrix} a_{11} & a_{12} \\ a_{21} & a_{22} \\ a_{31} & a_{32} \end{bmatrix} \cdot \begin{bmatrix} b_{11} \\ b_{21} \end{bmatrix} = \begin{bmatrix} a_{11}b_{11}+a_{12}b_{21} \\ a_{21}b_{11}+a_{22}b_{21} \\ a_{31}b_{11}+a_{32}b_{21} \end{bmatrix} \end{align*} C3×1=A3×2⋅B2×1= a11a21a31a12a22a32 ⋅b11b21 = a11b11+a12b21a21b11+a22b21a31b11+a32b21
然后是向量乘向量,结果有两种,如果左边一行形式的向量乘右边一列形式的向量,则结果为一个数字。如果反过来,则是一个矩阵。 A1×3 ⋅ B3×1 = a11 a12 a13 ⋅ b11 b21 b31 =a11b11+a12b21+a13b31 A3×1 ⋅ B1×3 = a11 a21 a31 ⋅ b11 b12 b13 = a11b11 a11b12 a11b13 a21b11 a21b12 a21b13 a31b11 a31b12 a31b13 \begin{align*} A_{1 \times 3} \cdot B_{3 \times 1} &= \begin{bmatrix} a_{11} & a_{12} & a_{13} \end{bmatrix} \cdot \begin{bmatrix} b_{11} \\ b_{21} \\ b_{31} \end{bmatrix} = a_{11}b_{11}+a_{12}b_{21}+a_{13}b_{31} \\ A_{3 \times 1} \cdot B_{1 \times 3} &= \begin{bmatrix} a_{11} \\ a_{21} \\ a_{31} \end{bmatrix} \cdot \begin{bmatrix} b_{11} & b_{12} & b_{13} \end{bmatrix} = \begin{bmatrix} a_{11}b_{11} & a_{11}b_{12} & a_{11}b_{13} \\ a_{21}b_{11} & a_{21}b_{12} & a_{21}b_{13} \\ a_{31}b_{11} & a_{31}b_{12} & a_{31}b_{13} \end{bmatrix} \end{align*} A1×3⋅B3×1A3×1⋅B1×3=a11a12a13 ⋅ b11b21b31 =a11b11+a12b21+a13b31= a11a21a31 ⋅b11b12b13 = a11b11a21b11a31b11a11b12a21b12a31b12a11b13a21b13a31b13
对角矩阵指的是当矩阵的元素中行坐标和列坐标相等时才有元素值,其余都为0。这里展示一下普通矩阵乘对角矩阵的效果,可以看到相当于给列元素增加了一个系数。 C3×2 = A3×2 ⋅ B2×2 = a11 a12 a21 a22 a31 a32 ⋅ b11 0 0 b22 = a11b11 a12b22 a21b11 a22b22 a31b11 a32b22 \begin{align*} C_{3 \times 2} &= A_{3 \times 2} \cdot B_{2 \times 2} \\ &= \begin{bmatrix} a_{11} & a_{12} \\ a_{21} & a_{22} \\ a_{31} & a_{32} \end{bmatrix} \cdot \begin{bmatrix} b_{11} & 0 \\ 0 & b_{22} \end{bmatrix} = \begin{bmatrix} a_{11}b_{11} & a_{12}b_{22} \\ a_{21}b_{11} & a_{22}b_{22} \\ a_{31}b_{11} & a_{32}b_{22} \end{bmatrix} \end{align*} C3×2=A3×2⋅B2×2= a11a21a31a12a22a32 ⋅b1100b22 = a11b11a21b11a31b11a12b22a22b22a32b22
对数
首先看一下对数的概念。如果a的y次方为x,那么y就是以a为底的x的对数。其中a>0且a≠1。其中自然对数ln(x)是以e为底的对数。e是一个无理数,值为e=2.71828...。 ax=b⇔x = loga b ex=b⇔x =lnb \begin{align*} a^{x}=b \quad \Leftrightarrow \quad x &=\log_{a}{b} \\ e^{x}=b \quad \Leftrightarrow \quad x &=\ln{b} \\ \end{align*} ax=b⇔xex=b⇔x=logab=lnb
对数满足一些特殊的运算性质: loga M∗N = loga M+ loga N loga MN = loga M− loga N loga MN =N∗ loga M \begin{align*} \\ \log_{a}{M*N} &= \log_{a}{M} + \log_{a}{N} \\ \log_{a}{\frac{M}{N} } &= \log_{a}{M} - \log_{a}{N} \\ \log_{a}{M^{N}} &= N * \log_{a}{M} \end{align*} logaM∗NlogaNMlogaMN=logaM+logaN=logaM−logaN=N∗logaM
再简单提一下指数的运算性质: am⋅an=am+n aman=am−n (am)n=am⋅n \begin{align*} a^m \cdot a^n = a^{m+n} \\ \frac{a^m}{a^n} = a^{m-n} \\ (a^m)^n = a^{m\cdot n} \\ \end{align*} am⋅an=am+nanam=am−n(am)n=am⋅n
对数相关的求导公式: ( loga x) ′ = 1xlna (lnx)′ =1x \begin{align*} {(\log_{a}{x})}' &= \frac{1}{x\ln{a}} \\ {(\ln{x})}' &= \frac{1}{x} \end{align*} (logax)′(lnx)′=xlna1=x1
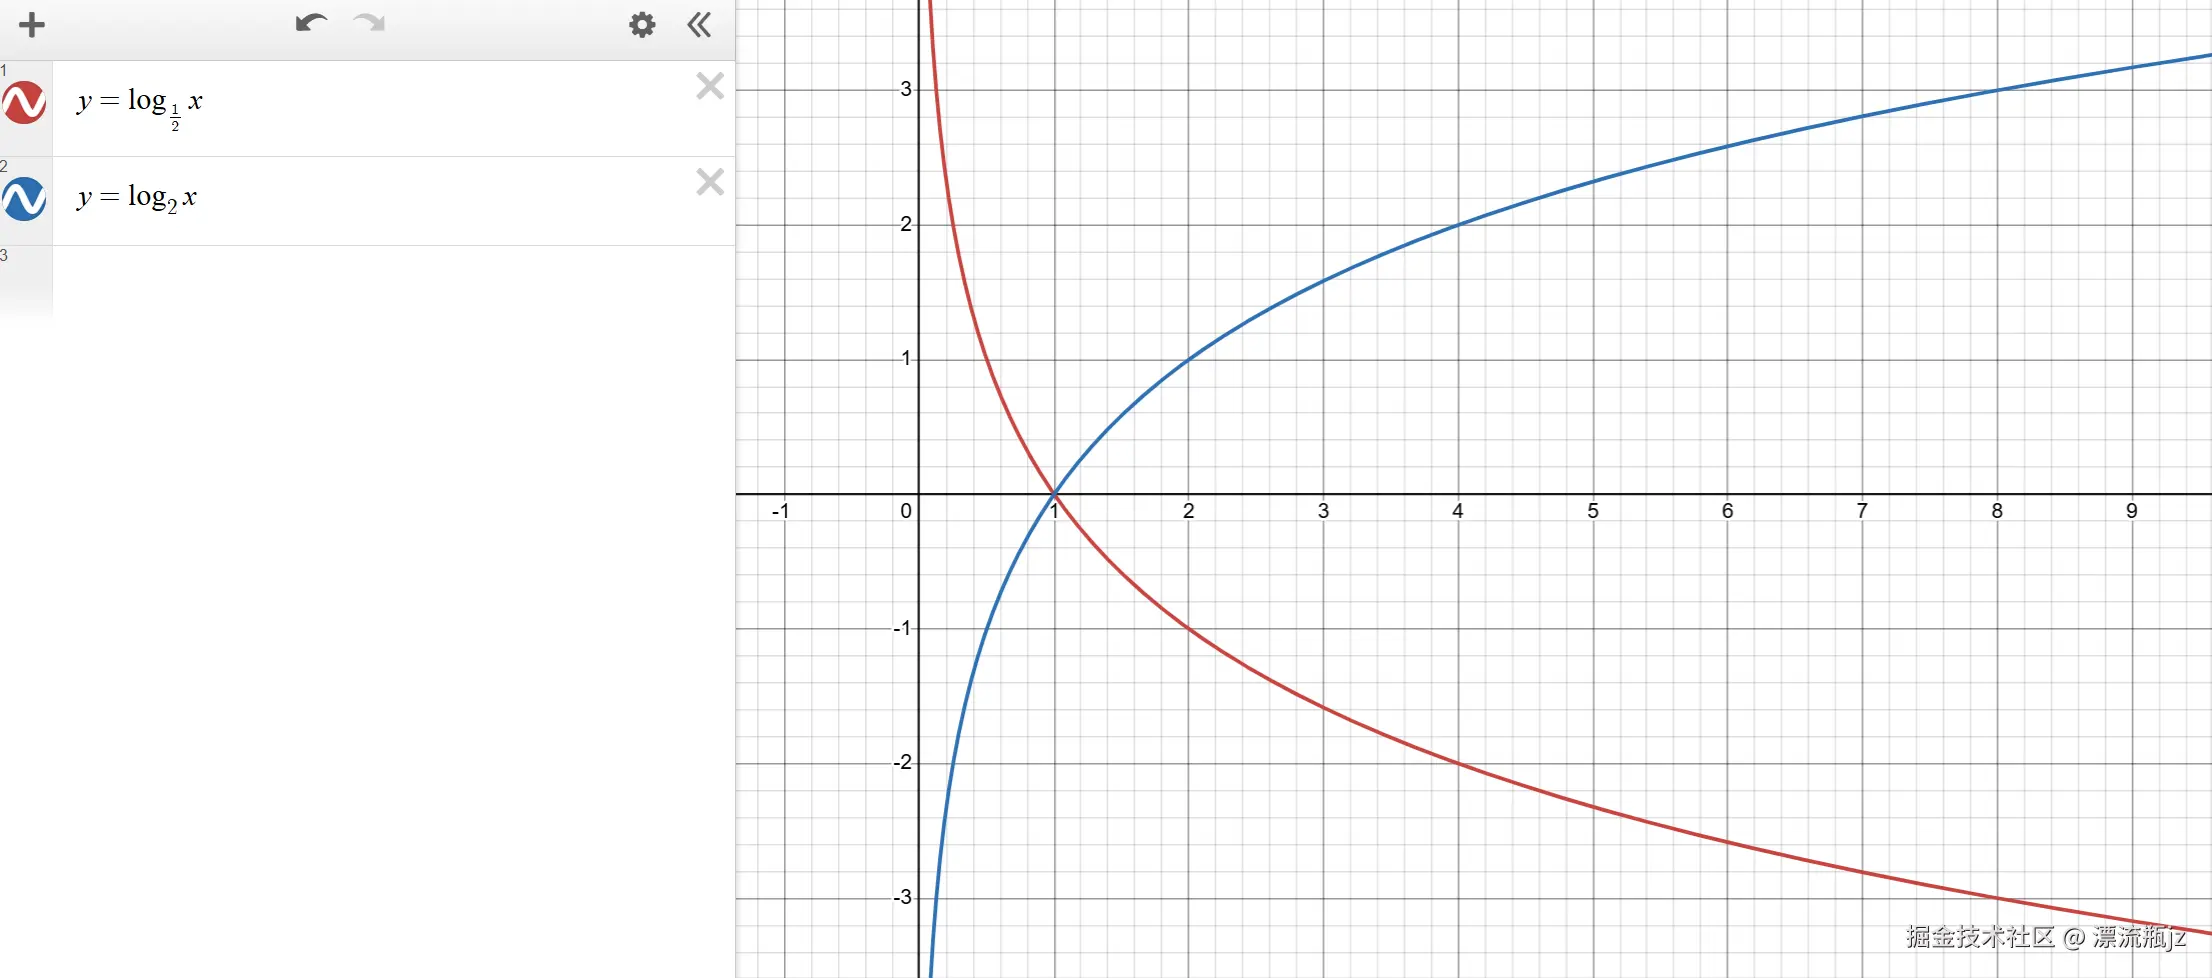
当a的范围在0到1之间时,与a>1时,对应 y= loga x y=\log_{a}{x} y=logax的函数图像不同,一个开口向下,一个开口向上。例如下图中,红线是底数为1/2时函数的曲线,蓝线是底数为2的曲线。不管底数的值如何,它们都经过(1, 0)这个点。
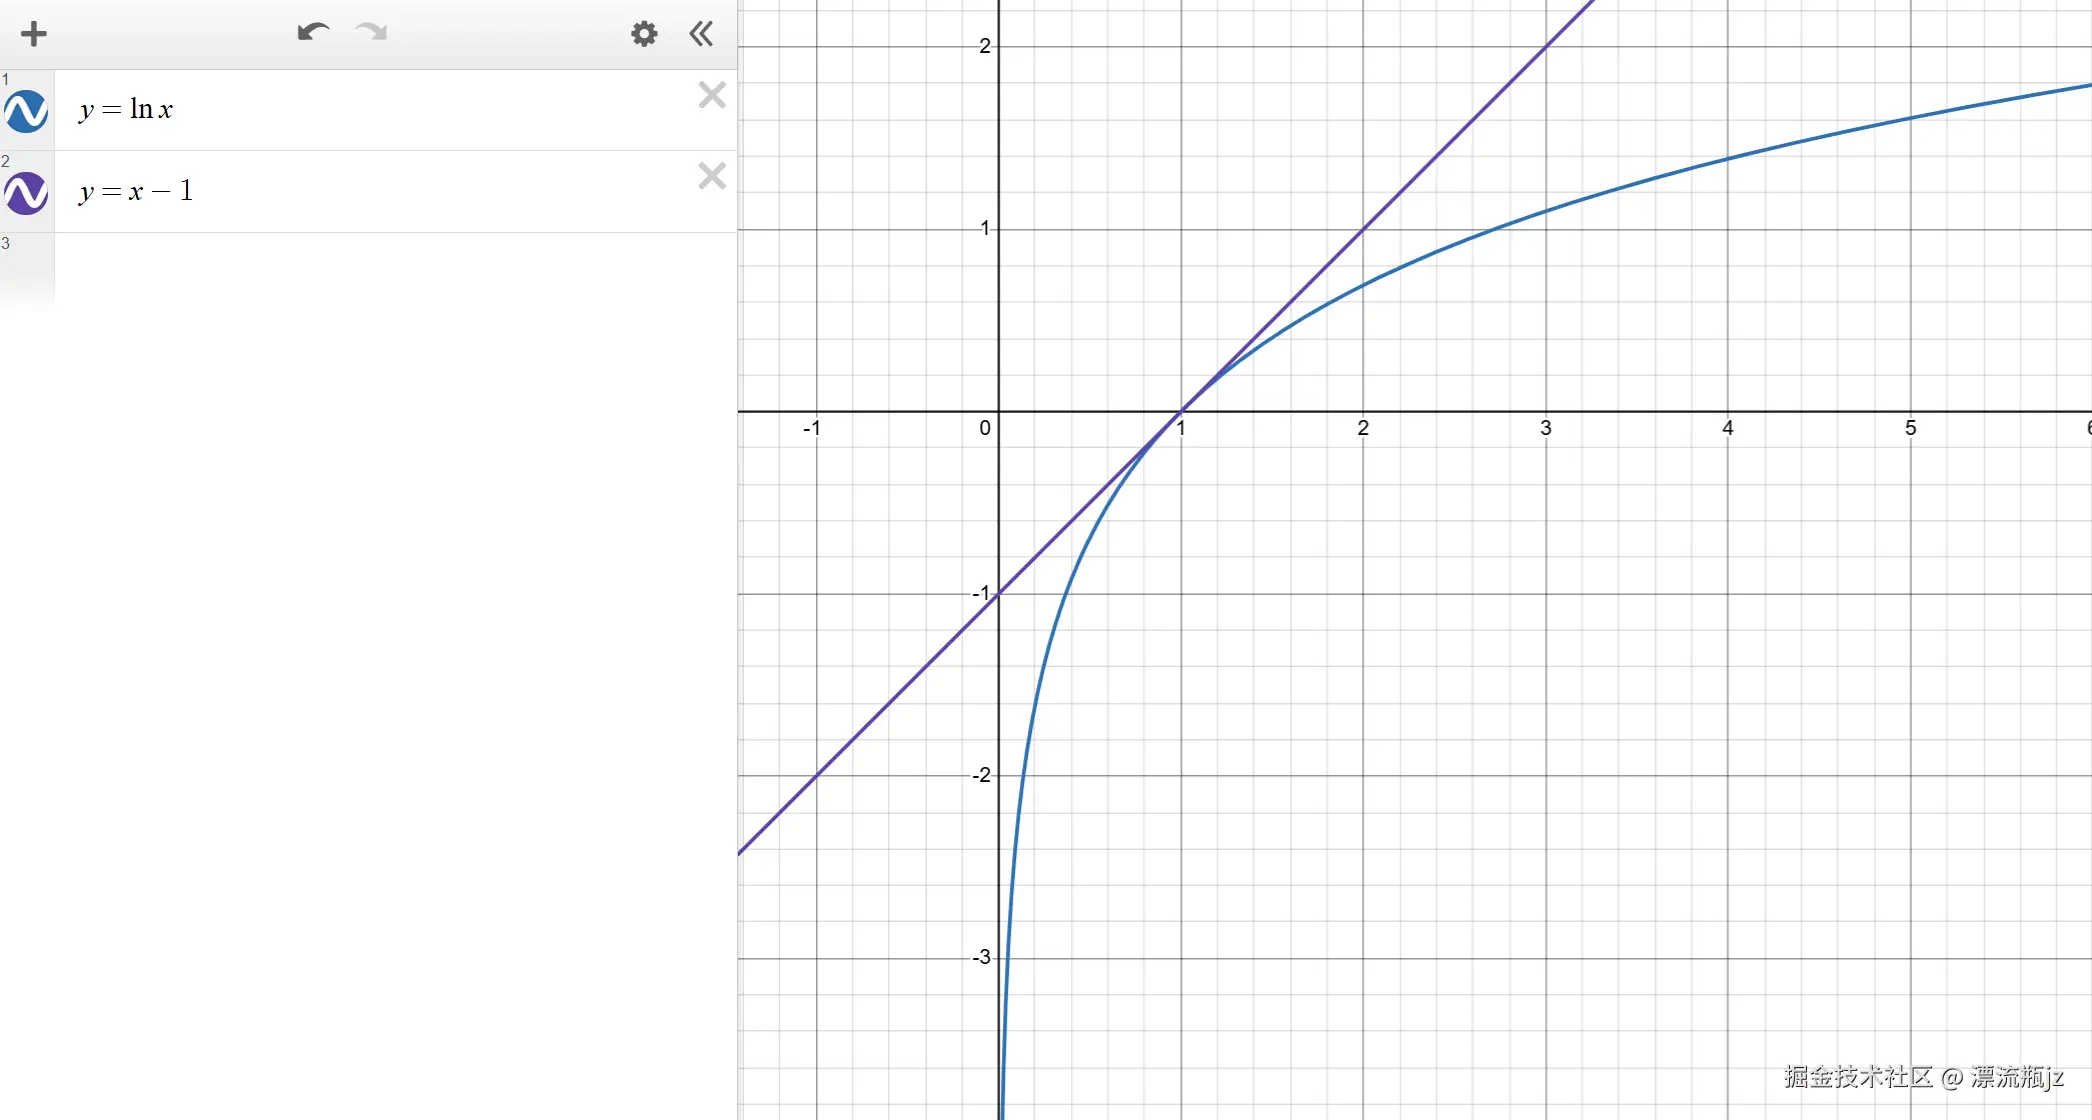
特别的, y=x−1y=x-1 y=x−1这个直线是 y=lnxy=\ln{x} y=lnx这个函数在(1, 0)这个点的切线,且 lnx≤x−1\ln{x}\le x-1 lnx≤x−1永远成立,且相等的位置只有(1, 0)这个点。通过图像可以直观感受到:
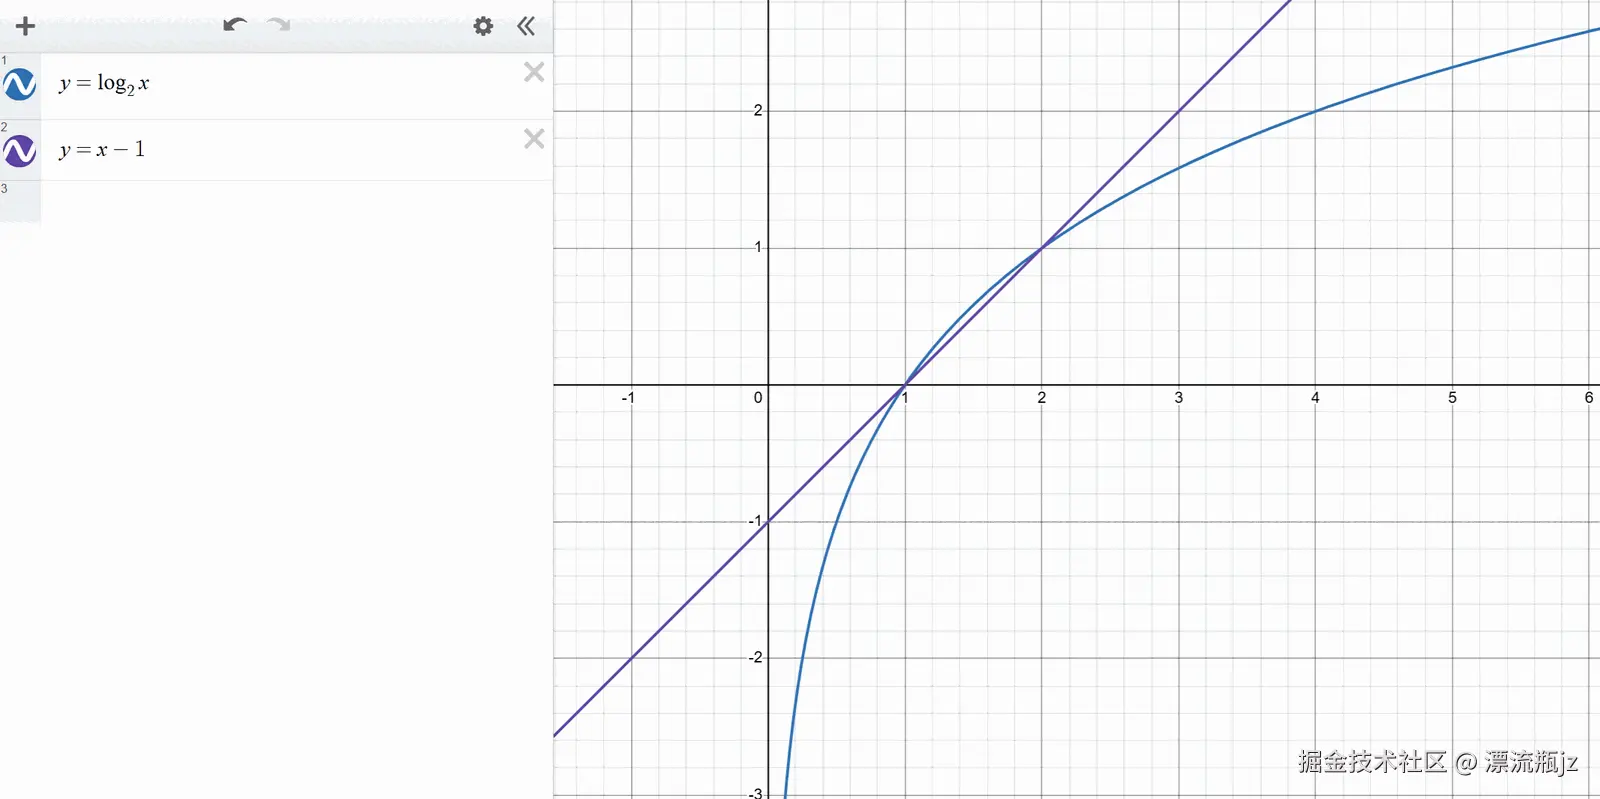
但是对于其它底数,这个不等式却不一定成立。例如 y= log2 x y=\log_{2}{x} y=log2x在(1, 0)这个点的切线斜率(也就是导数)是 1xln2 \frac{1}{x\ln{2}} xln21,和 y=x−1y=x-1 y=x−1的斜率不同,因此这条直线并不是切线,函数值也不一定都在这条直线下方,如图所示,x在1到2的区间内,函数值在直线上方。
偏导数
首先来复习一下导数的概念。函数的导数也是一个函数,指的是函数在某一点的变化率,也可以被称作斜率。用极限公式表示如下: 设△x为变量x在某一点的变化 y=f(x)的导数函数为: dydx =f′(x)= lim△x→0 f(x+△x)−f(x)△x \begin{align*} &设\bigtriangleup x 为变量x在某一点的变化 \\ &y = f(x)的导数函数为: \\ &\frac{\mathrm{d} y}{\mathrm{d} x} = {f}'(x) = \lim_{\bigtriangleup x \to 0} \frac{f(x+\bigtriangleup x) - f(x)}{\bigtriangleup x} \end{align*} 设△x为变量x在某一点的变化y=f(x)的导数函数为:dxdy=f′(x)=△x→0lim△xf(x+△x)−f(x)
当一个函数的变量有多个时,如果想求这个函数对其中一个变量的导数,那这就是偏导数。 设函数z=f(x,y) 函数对于x的偏导数表示为: ∂z∂x = ∂(f(x,y))∂x 函数对于y的偏导数表示为: ∂z∂y = ∂(f(x,y))∂y \begin{align*} &设函数 z = f(x, y)\\ &函数对于x的偏导数表示为:\frac{\partial z}{\partial x} = \frac{\partial (f(x, y))}{\partial x} \\ &函数对于y的偏导数表示为:\frac{\partial z}{\partial y} = \frac{\partial (f(x, y))}{\partial y} \\ \end{align*} 设函数z=f(x,y)函数对于x的偏导数表示为:∂x∂z=∂x∂(f(x,y))函数对于y的偏导数表示为:∂y∂z=∂y∂(f(x,y))
如何求偏导数的值呢?实际上和普通的求导方式一致,即把当前求导的变量看做变量,而把其它变量看作常数即可。这里举个简单的例子: 设函数z=x2+y2+xy ∂z∂x =2x+y(相当于 dzdx ) ∂z∂y =2y+x(相当于 dzdy ) \begin{align*} &设函数 z = x^2 + y^2 + xy\\ &\frac{\partial z}{\partial x} = 2x + y \quad (相当于 \frac{\mathrm{d} z}{\mathrm{d} x}) \\ &\frac{\partial z}{\partial y} = 2y + x \quad (相当于 \frac{\mathrm{d} z}{\mathrm{d} y}) \\ \end{align*} 设函数z=x2+y2+xy∂x∂z=2x+y(相当于dxdz)∂y∂z=2y+x(相当于dydz)
从几何意义上来说,假设z=f(x,y)是一个三维曲面,则对x求偏导相当于曲面沿x轴方向的变化率,对y求偏导相当于曲面沿y轴方向的变化率。还有一些其它下面可能涉及到的求导公式: (1u)′=−1u2 (uv)′=u′v+uv′ (uv)′= u′v−uv′v2 \begin{align*} \\ (\frac{1}{u})' = -\frac{1}{u^2} \\ (uv)' = u'v + uv' \\ (\frac{u}{v})' = \frac{u'v - uv'}{v^2} \\ \end{align*} (u1)′=−u21(uv)′=u′v+uv′(vu)′=v2u′v−uv′
然后再说一下求导的链式法则,即复合函数的导数等于内层函数导数乘外层函数导数。这个法则对于导数和偏导数都适用: 设z=g(y)y=f(x)则z=g(f(x)) 链式法则: dzdx = dzdy ⋅ dydx 设z=g(x,y)y=f(a)则z=g(x,f(a)) 链式法则: ∂z∂a = ∂z∂y ⋅ ∂y∂a \begin{align*} & 设z = g(y) \quad y = f(x) \quad 则 z = g(f(x)) \\ & 链式法则:\frac{\mathrm{d} z}{\mathrm{d} x} = \frac{\mathrm{d} z}{\mathrm{d} y} \cdot \frac{\mathrm{d} y}{\mathrm{d} x} \\ & 设z = g(x, y) \quad y = f(a) \quad 则 z = g(x, f(a)) \\ & 链式法则:\frac{\partial z}{\partial a} = \frac{\partial z}{\partial y} \cdot \frac{\partial y}{\partial a} \end{align*} 设z=g(y)y=f(x)则z=g(f(x))链式法则:dxdz=dydz⋅dxdy设z=g(x,y)y=f(a)则z=g(x,f(a))链式法则:∂a∂z=∂y∂z⋅∂a∂y
这个法则在平时计算导数时也是经常使用的,我们看个求导的简单例子: 设: z=ln(x2),求 dzdx 解: 令y=x2则z=ln(x2)⇒ { z=g(y)=ln(y) y=f(x)=x2 dzdx = dzdy ⋅ dydx =1y⋅2x= 2xx2 =2x \begin{align*} 设:& z = ln(x^2),求\frac{\mathrm{d} z}{\mathrm{d} x} \\ 解:& \\ & 令y = x^2 \quad 则 z = ln(x^2) \Rightarrow \begin{cases} z = g(y) = \ln(y) \\ y = f(x) = x^2 \end{cases} \\ & \frac{\mathrm{d} z}{\mathrm{d} x} = \frac{\mathrm{d} z}{\mathrm{d} y} \cdot \frac{\mathrm{d} y}{\mathrm{d} x} = \frac{1}{y}\cdot 2x = \frac{2x}{x^2} = \frac{2}{x} \end{align*} 设:解:z=ln(x2),求dxdz令y=x2则z=ln(x2)⇒{z=g(y)=ln(y)y=f(x)=x2dxdz=dydz⋅dxdy=y1⋅2x=x22x=x2
但注意如果是多个子函数中都出现同一个求导的自变量a,那么链式法则就要变化一下了,需要每个涉及到自变量的都进行链式求导,再相加。 设z=f1(x,y)y=f2(a)x=f3(a)则z=f1(f3(a),f2(a)) 链式法则: ∂z∂a = ∂z∂y ⋅ ∂y∂a + ∂z∂x ⋅ ∂x∂a \begin{align*} & 设z = f_1(x, y) \quad y = f_2(a) \quad x = f_3(a) \quad 则 z = f_1(f_3(a), f_2(a)) \\ & 链式法则:\frac{\partial z}{\partial a} = \frac{\partial z}{\partial y} \cdot \frac{\partial y}{\partial a} + \frac{\partial z}{\partial x} \cdot \frac{\partial x}{\partial a} \end{align*} 设z=f1(x,y)y=f2(a)x=f3(a)则z=f1(f3(a),f2(a))链式法则:∂a∂z=∂y∂z⋅∂a∂y+∂x∂z⋅∂a∂x
等比数列求和公式
等比数列的每项与前一项相除,都是一个固定的常数。定义如下: 等比数列的第i项为ai ai+1 ai =q,为一个常数 通项公式:ai=a1qi−1 前n项的和为Sn=a1+a2+...+an \begin{align*} &等比数列的第i项为a_i\\ &\frac{a_{i+1}}{a_i} = q,为一个常数 \\ &通项公式:a_i = a_1q^{i-1} \\ &前n项的和为 S_n = a_1+a_2+...+a_n \end{align*} 等比数列的第i项为aiaiai+1=q,为一个常数通项公式:ai=a1qi−1前n项的和为Sn=a1+a2+...+an
现在求解等比数列前n项和Sn的计算公式: Sn =a1+a2+...+an=a1+a1q+a1q2+...+a1qn−1 Sn−a1 =a1q+a1q2+...+a1qn−1 =q(a1+a1q+a1q2+...+a1qn−2) =q(a1+a2+a3+...+ an−1 )=q(Sn−a1qn−1) =>Sn−a1 =q(Sn−a1qn−1) =>Sn−qSn =a1−a1qn =>Sn = a1(1−qn) 1−q 当q≠1时 \begin{align*} S_n &= a_1+a_2+...+a_n = a_1+a_1q+a_1q^2+ ...+a_1q^{n-1} \\ S_n - a_1 &= a_1q+a_1q^2+ ...+a_1q^{n-1} \\ &= q(a_1+a_1q+a_1q^2+ ...+a_1q^{n-2}) \\ &=q(a_1+a_2+a_3+ ...+a_{n-1}) = q(S_n - a_1q^{n-1}) \\ => S_n - a_1 &= q(S_n - a_1q^{n-1}) \\ => S_n - qS_n &= a_1 - a_1q^n \\ => S_n &= \frac{a_1(1 - q^n)}{1-q} \quad 当q \ne 1时 \\ \end{align*} SnSn−a1=>Sn−a1=>Sn−qSn=>Sn=a1+a2+...+an=a1+a1q+a1q2+...+a1qn−1=a1q+a1q2+...+a1qn−1=q(a1+a1q+a1q2+...+a1qn−2)=q(a1+a2+a3+...+an−1)=q(Sn−a1qn−1)=q(Sn−a1qn−1)=a1−a1qn=1−qa1(1−qn)当q=1时
Softmax归一化函数
首先介绍的是Softmax归一化函数。通过大模型神经网络一层一层计算,最后得到的输出是一个向量,长度为词表长度,其中每个值为词表中每个token的对应值。这个值越大,表示预测为这个token的概率越高。但这个值可能是正数,也可能是负数,甚至可能向量中每个值都是负数。此时肯定不能将所有值简单相加算概率,否则就会出现负的概率值,而且可能某些token的概率超过1。这里举几个例子: 设pi为第i个元素的概率 例子1: A=3,−1,3 p2= −13−1+3 =−15 例子2: A=−3,1,3 p3= 3−3+1+3 =3 \begin{align*} &设p_i为第i个元素的概率 \\ \\ 例子1:&A = 3, -1, 3 \\ &p_2 = \frac{-1}{3-1+3} = -\frac{1}{5} \\ \\ 例子2:&A = -3, 1, 3 \\ &p_3 = \frac{3}{-3+1+3} = 3 \end{align*} 例子1:例子2:设pi为第i个元素的概率A=3,−1,3 p2=3−1+3−1=−51A=−3,1,3 p3=−3+1+33=3
这明显是不可行的。因此需要一个归一化函数,将这些值对应为每个token对应的概率值,同时保证不会出现负值,且所有概率值相加为1。Softmax就是一个指数归一化函数。这里列举函数的计算公式: 设A=a1,a2,...,an 为模型输出向量; n为向量长度,pi为第i个token的概率值 pi=softmax(ai)= eai ∑j=1n eaj \begin{align*} &设 A = a_1, a_2, ..., a_n 为模型输出向量; \\ &n为向量长度,p_i为第i个token的概率值 \\ \\ &p_i = softmax(a_i) = \frac{e^{a_i}}{\sum_{j=1}^{n}e^{a_j}} \\ \end{align*} 设A=a1,a2,...,an 为模型输出向量;n为向量长度,pi为第i个token的概率值pi=softmax(ai)=∑j=1neajeai
可以看到,公式其实比较简单,就是将前面我们直接将输出值相加,改成了先计算指数再加和计算概率。因为不管原值如何,经过指数运算之后都变成了正值,因此保证了所有概率值相加为1,且不会出现负值。Softmax仅仅是比较值之间的差,根据差值计算概率。对于值中的"相同部分"并不会影响概率值。这里举几个例子: 例子1: A=1,2,3 pi= eie1+e2+e3 例子2: A=101,102,103 pi= e100+ie101+e102+e103 = e100⋅eie100⋅e1+e100⋅e2+e100⋅e3 = eie1+e2+e3 \begin{align*} 例子1:&A = 1, 2, 3 \\ &p_i = \frac{e^{i}}{e^{1} + e^{2} + e^{3}} \\ \\ 例子2:&A = 101, 102, 103 \\ &p_i = \frac{e^{100+i}}{e^{101} + e^{102} + e^{103}} \\ &= \frac{e^{100} \cdot e^i}{e^{100} \cdot e^{1} + e^{100} \cdot e^{2} + e^{100} \cdot e^{3}} \\ &= \frac{e^i}{e^{1} + e^{2} + e^{3}} \\ \end{align*} 例子1:例子2:A=1,2,3 pi=e1+e2+e3eiA=101,102,103 pi=e101+e102+e103e100+i=e100⋅e1+e100⋅e2+e100⋅e3e100⋅ei=e1+e2+e3ei
通过上面的例子可以看到,虽然第一个例子是1,2,3;第二个例子是101,102,103;但我们利用指数运算性质,拆分出例子2中每个值的相同部分,然后被分子分母约掉,就只剩下每个数之间相差的部分了。因此Softmax做到了仅根据值之间的差来计算概率。
注意这是训练时计算概率值的方式。推理时也使用Softmax计算概率,但输出会多一些处理。这里是描述训练过程,因此不介绍推理的相关步骤。
损失函数和交叉熵
损失函数概念
前面我们通过Softmax函数,拿到大模型预测每个Token的概率值。在训练时,我们使用的是带答案的训练集数据,因此会有一个正确的输出token值。但只拿到这些还不够,大模型需要一个值来表示模型距离预测正确还有多远,即把大模型输出值和训练集"正确值"比较,看看模型预测的是正确还是错误,错误的量是多少。这样可以对模型当前预测结果给一个定量的评价,再根据这个评价调整参数值。这就是损失函数需要做的事情。
有人会说,这太简单了。如果模型预测token和训练集的正确token一致,那说明模型预测正确,如果不一致,就是模型预测错误。但这样只解决了正确性问题,没有定量的结果。试想模型输出的token值是一个概率,这个概率的大小不同,对于模型的评价应该是不一样的: 设P为模型输出的概率向量,pi为模型输出第i个token的概率 例子1:P=0.01,...0.01,pa=0.02,0.01,...0.01 且a为正确token,即预测正确 例子2:P=0.01,...0.01,pa=0.8,0.01,...0.01 且a为正确token,即预测正确 例子3:P=0.01,...0.01,pa=0.02,0.01,...0.01 且a为不正确token,即预测错误 例子4:P=0.01,...0.01,pa=0.8,0.01,...0.01 且a为不正确token,即预测错误 \begin{align*} \\ &设P为模型输出的概率向量,p_i为模型输出第i个token的概率 \\ &例子1:P = 0.01, ... 0.01, p_a = 0.02, 0.01, ... 0.01 \\ &且a为正确token,即预测正确 \\ &例子2:P = 0.01, ... 0.01, p_a = 0.8, 0.01, ... 0.01 \\ &且a为正确token,即预测正确 \\ &例子3:P = 0.01, ... 0.01, p_a = 0.02, 0.01, ... 0.01 \\ &且a为不正确token,即预测错误 \\ &例子4:P = 0.01, ... 0.01, p_a = 0.8, 0.01, ... 0.01 \\ &且a为不正确token,即预测错误 \\ \end{align*} 设P为模型输出的概率向量,pi为模型输出第i个token的概率例子1:P=0.01,...0.01,pa=0.02,0.01,...0.01 且a为正确token,即预测正确例子2:P=0.01,...0.01,pa=0.8,0.01,...0.01 且a为正确token,即预测正确例子3:P=0.01,...0.01,pa=0.02,0.01,...0.01 且a为不正确token,即预测错误例子4:P=0.01,...0.01,pa=0.8,0.01,...0.01 且a为不正确token,即预测错误
例子1和例子2都预测正确了,但是概率值相差巨大,对于模型的评价应该是一样的么?例子3和例子4都预测错误了,但概率值相差巨大,对于模型的评价应该是一样的么?想要回答这些问题,就要找一个合适的损失函数来评价大模型场景的输出。
大模型场景实际上是一种One-hot分类场景,即输出值是一个向量,向量中的每个数字是这个分类的概率,但是只有一个分类是正确的。适用于One-hot分类场景的损失函数就是交叉熵。如果是多分类场景,例如给图像打标签,但是允许一个图像有多个标签,这时候就不能用交叉熵,需要采用其他损失函数。
损失函数的英文名叫做loss function,其中的损失就是loss。损失函数的入参为模型的输出值和训练集给出的结果,出参为得到的损失值,即模型离"完全正确"有多远。因此损失函数的输出一般为非负数,0值表示完全正确,值越大说明损失越大,即离正确越远。
信息量
想要了解交叉熵,需要先了解信息量和熵的概念。信息量指的是一个事件发生时,提供给我们的信息有多少,或者说事件发生时我们的惊讶程度。例如一个概率为99%的事件发生时,信息量比较小,因为它几乎是必然发生的。但是当概率为1%的事件发生时,我们会非常惊讶,因为基本不可能发生的事情发生了。因此,信息量有如下的特点:
事件发生的概率越小,当这个事件真正发生时,信息量就越大。
概率为100%的事件发生时,信息量为0,概率为0的事件发生时,信息量为无穷大。
信息量为非负数。
如果两个事件独立,则两个事件同时发生时的信息量等于两个事件单独发生时的信息量相加。
因此,在满足这些条件的基础上,将信息量的公式定义如下: 设P(x)为x事件发生的概率,I(x)为x事件发生的信息量 I(x)=log( 1P(x) )=−log(P(x)) \begin{align*} &设P(x)为x事件发生的概率,I(x)为x事件发生的信息量 \\ &I(x) = log(\frac{1}{P(x)}) = -log(P(x)) \end{align*} 设P(x)为x事件发生的概率,I(x)为x事件发生的信息量I(x)=log(P(x)1)=−log(P(x))
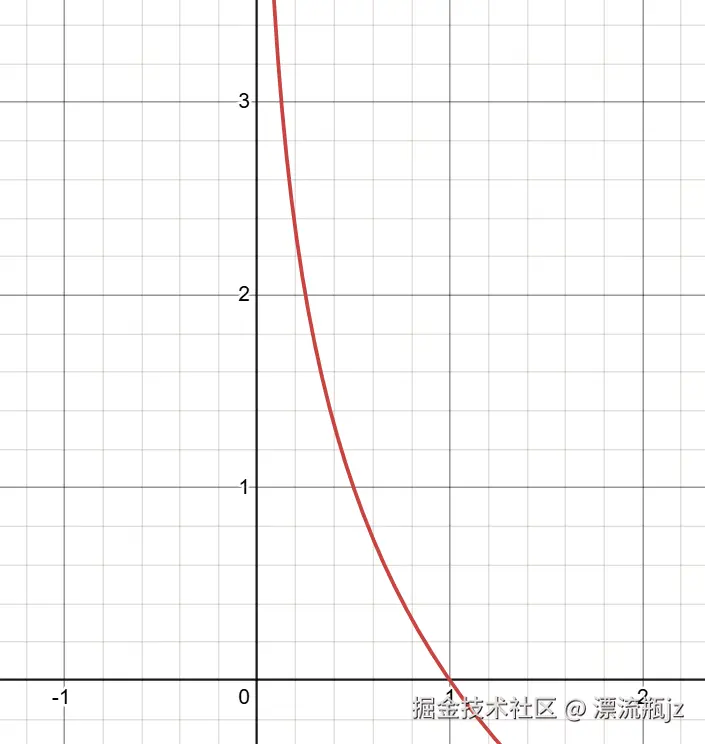
通过对应的公式曲线图,可以看到当横坐标(也就是概率值)处于0-1的范围内时,函数值从无穷开始逐渐下降,一直到0。这里再明确计算下上面说的性质: −log(0)=+∞ −log(1)=0 I(a)+I(b)=−log(P(a))−log(P(b))=−log(P(a)∗P(b)) =−log(P(ab))=I(ab) \begin{align*} &-log(0) = +\infty \\ &-log(1) = 0 \\ &I(a) + I(b) = -log(P(a)) -log(P(b)) = -log(P(a)*P(b)) \\ &= -log(P(ab)) = I(ab) \end{align*} −log(0)=+∞−log(1)=0I(a)+I(b)=−log(P(a))−log(P(b))=−log(P(a)∗P(b))=−log(P(ab))=I(ab)
前面的公式中我们只用了log,没有提到底数值,事实上不同场景使用的底数不同。当希望计算信息量对应的二进制位时,以2为底数计算;而在深度学习大模型中,为了计算方便使用e为底数。这里举例下以2为底时,直接求得的信息量值,就是需要的二进制位表示。 −log2(0.5)=−log2(12)=log2(2)=1bit −log2(0.25)=−log2(14)=log2(4)=2bit −log2(0.1)=−log2(110)=log2(10)≈3.32bit \begin{align*} -log_2(0.5) = -log_2(\frac{1}{2}) = log_2(2) = 1 \quad bit \\ -log_2(0.25) = -log_2(\frac{1}{4}) = log_2(4) = 2 \quad bit \\ -log_2(0.1) = -log_2(\frac{1}{10}) = log_2(10) \approx 3.32 \quad bit \\ \end{align*} −log2(0.5)=−log2(21)=log2(2)=1bit−log2(0.25)=−log2(41)=log2(4)=2bit−log2(0.1)=−log2(101)=log2(10)≈3.32bit
这里的二进制位是什么意思呢,可以看作是这个概率所需要的平均编码位数的最低值。这里举几个例子:
四个事件,每个概率1/4。每个信息量为2。分别编码为 00 01 10 11 编码长度一致
四个事件,每个概率为1/2, 1/4, 1/8, 1/8。对应信息量为1,2,3,3。对应哈夫曼编码为:0 10 110 111。编码长度一致。
三个事件,每个概率1/3。每个信息量约为1.58。对应哈夫曼编码为:0 10 11。 平均编码长度5/3 ≈ 1.67 > 信息量。
可以看到,当概率是2的-n次方时,使用哈夫曼编码的长度与信息量一致。但如果信息量计算结果非整数,那么哈夫曼编码的每个元素的长度必须是整数值,因此可能达不到最小值。
信息熵
前面描述的信息量,表示的是单个事件发生时的信息多少或者惊讶程度。那么对于一个完整的分布(即多个互斥事件的组合,加起来概率为1)它的平均信息量则用信息熵来表示,它是信息量的期望,也就是整个分布的平均惊讶程度。计算公式如下: 设X为整个分布,n为分布中事件个数 H(X)= ∑i=0n P(i)I(i)=− ∑i=0n P(i)log(P(i)) \begin{align*} \\ &设X为整个分布,n为分布中事件个数 \\ &H(X) = \sum_{i=0}^{n} P(i)I(i) = -\sum_{i=0}^{n} P(i)log(P(i)) \\ \end{align*} 设X为整个分布,n为分布中事件个数H(X)=i=0∑nP(i)I(i)=−i=0∑nP(i)log(P(i))
可以看到,实际上就是每个事件发生的信息量乘事件发生的概率。以通常意义来讲,如果这个分布确定性较高,那么信息熵比较小,如果分布得更随机,那么信息熵就更大。当事件个数固定,每个事件的概率相等时,分布最随机,此时信息熵最大。这里举个以2为底的例子:
两个事件,每个概率1/2。信息熵为1.
两个事件,概率分别为1/4,3/4。信息熵为1/2 + 3/4*0.415 ≈ 0.81
三个事件,每个概率1/3。信息熵约为1.58。
三个事件,概率分别为1/8,1/8,3/4。信息熵为3/8 + 3/8 + 3/4*0.415 ≈ 1.06
三个事件,概率分别为1,0,0 信息熵为0
这个现象背后的含义是,如果每个事件概率相等,则最终哪个事件发生是非常不确定的,难以预测的。但如果某个事件概率较高(对应其它事件概率较低),那么说明这个分布更容易发生这个事件,更容易预测,则信息熵更低。极端情况下,当某个事件概率为1,必然发生,则这个分布整体是没有不确定性的,此时信息熵为0。
交叉熵
前面描述的信息熵,表达了真实世界(或者说正确的)事件发生的概率分布所代表的平均信息量。对于模型来说,它不知道正确的概率分布是什么,它有一个自己的概率分布,通过学习来预测和逼近正确的概率分布,这就是大模型学习的意义。大模型预测的概率分布和正确的概率分布是有差别的,那么如何来描述这个差别呢,就要用交叉熵。 设P(x)为正确的概率分布,Q(x)为预测的概率分布 H(p,q)为交叉熵,n为事件个数 H(p,q)= ∑i=0n P(i)I(i)=− ∑i=0n P(i)log(Q(i)) \begin{align*} \\ &设P(x)为正确的概率分布,Q(x)为预测的概率分布 \\ &H(p,q)为交叉熵,n为事件个数 \\ &H(p,q) = \sum_{i=0}^{n} P(i)I(i) = -\sum_{i=0}^{n} P(i)log(Q(i)) \\ \end{align*} 设P(x)为正确的概率分布,Q(x)为预测的概率分布H(p,q)为交叉熵,n为事件个数H(p,q)=i=0∑nP(i)I(i)=−i=0∑nP(i)log(Q(i))
可以看到公式和信息熵非常相似,区别在于是以真实发生的概率乘模型预测概率的信息量,可以理解为真实事件发生时,我们心里想的是预测分布,以预测分布的角度对事件的平均惊讶程度。当我们预测的概率分布与真实分布完全一致时,交叉熵的公式就与信息熵完全一致了。
交叉熵减去信息熵的差值有个名称,叫做KL散度(Kullback-Leibler Divergence),用于表示两个分布之间的差异。KL散度的公式如下: DKL (p,q) =− ∑i=0n P(i)log(Q(i))−(− ∑i=0n P(i)log(P(i))) = ∑i=0n P(i)(log(P(i))−log(Q(i))) = ∑i=0n P(i)log( P(i)Q(i) ) \begin{align*} D_{KL}(p,q) &= -\sum_{i=0}^{n} P(i)log(Q(i)) -(-\sum_{i=0}^{n} P(i)log(P(i))) \\ &= \sum_{i=0}^{n} P(i)(log(P(i)) - log(Q(i))) \\ &= \sum_{i=0}^{n} P(i)log(\frac{P(i)}{Q(i)} ) \end{align*} DKL(p,q)=−i=0∑nP(i)log(Q(i))−(−i=0∑nP(i)log(P(i)))=i=0∑nP(i)(log(P(i))−log(Q(i)))=i=0∑nP(i)log(Q(i)P(i))
为什么叫做"散度"?这个词的直观可以理解为"散开的程度"。其实它也想叫做"距离",但是因为不完全满足距离的几个条件,因此被叫做散度。(下面的条件可以随便举个例子来证明不满足,这里证明就不列出了)
对称性 不满足 H(p,q) ≠ H(q,p)
非负性 满足
相同对象距离为0 满足
三角不等式,即三个对象两两连接,任意两条边距离的和大于第三条边的距离 不满足
交叉熵永远大于等于信息熵,且相等时表示预测分布与真实分布一致。也就是说KL散度永远大于等于0,这也就是吉布斯不等式的定义。这里给出证明: 设交叉熵的公式以a为底 DKL (p,q)= ∑i=0n P(i)loga( P(i)Q(i) ) = ∑i=0n P(i) ln( P(i)Q(i) ) lna = 1lna ∑i=0n P(i)ln( P(i)Q(i) ) = 1lna ∑i=0n P(i)ln( P(i)Q(i) )=− 1lna ∑i=0n P(i)ln( Q(i)P(i) ) (由于lnx≤x−1且x=1时等号成立那么−lnx≥1−x) ≥− 1lna ∑i=0n P(i)(1− Q(i)P(i) )=− 1lna ∑i=0n (P(i)−Q(i)) =− 1lna ( ∑i=0n P(i)− ∑i=0n Q(i))=− 1lna (1−1)=0 ∴ DKL (p,q)≥0且当 Q(i)P(i) =1时等号成立,即两个分布一致 \begin{align*} &设交叉熵的公式以a为底 \\ &D_{KL}(p,q) = \sum_{i=0}^{n} P(i)log_a(\frac{P(i)}{Q(i)} ) \\ &= \sum_{i=0}^{n} P(i)\frac{ln(\frac{P(i)}{Q(i)})}{lna} = \frac{1}{lna} \sum_{i=0}^{n} P(i)ln(\frac{P(i)}{Q(i)}) \\ &= \frac{1}{lna} \sum_{i=0}^{n} P(i)ln(\frac{P(i)}{Q(i)}) = -\frac{1}{lna} \sum_{i=0}^{n} P(i)ln(\frac{Q(i)}{P(i)}) \\ &(由于lnx \le x - 1 且x = 1时等号成立 \quad 那么-lnx \ge 1-x ) \\ &\ge -\frac{1}{lna} \sum_{i=0}^{n} P(i)(1 - \frac{Q(i)}{P(i)}) = -\frac{1}{lna} \sum_{i=0}^{n} (P(i) - Q(i)) \\ &= -\frac{1}{lna}(\sum_{i=0}^{n} P(i) - \sum_{i=0}^{n} Q(i)) = -\frac{1}{lna}(1 - 1) = 0 \\ \\ &\therefore \quad D_{KL}(p,q) \ge 0 且当\frac{Q(i)}{P(i)} = 1时等号成立,即两个分布一致 \\ \end{align*} 设交叉熵的公式以a为底DKL(p,q)=i=0∑nP(i)loga(Q(i)P(i))=i=0∑nP(i)lnaln(Q(i)P(i))=lna1i=0∑nP(i)ln(Q(i)P(i))=lna1i=0∑nP(i)ln(Q(i)P(i))=−lna1i=0∑nP(i)ln(P(i)Q(i))(由于lnx≤x−1且x=1时等号成立那么−lnx≥1−x)≥−lna1i=0∑nP(i)(1−P(i)Q(i))=−lna1i=0∑n(P(i)−Q(i))=−lna1(i=0∑nP(i)−i=0∑nQ(i))=−lna1(1−1)=0∴DKL(p,q)≥0且当P(i)Q(i)=1时等号成立,即两个分布一致
注意看,虽然前面对数的不等式只对自然对数成立,但我们利用换底公式把任意底数转换为了自然对数,同时提出一个公共常数。由于最后减号两侧互相抵消,因此常数部分不起作用。
在深度学习中,经常使用交叉熵作为概率分类的损失函数使用,交叉熵的值越小,即KL散度越小,则模型越逼近正确的概率分布,即模型的效果越好(当然也可能是过拟合了)。但是在大模型这种One-hot分类场景中,正确分布只有一个值,概率为1,因此交叉熵会在上述公式的基础上简化为非常简单的形式: 设x为正确分布中发生的事件 H(p,q)=− ∑i=0n P(i)ln(Q(i)) =−0⋅ln(Q(1))−0⋅ln(Q(2))...−1⋅ln(Q(x))...−0⋅ln(Q(n)) =−ln(Q(x)) \begin{align*} &设x为正确分布中发生的事件 \\ &H(p,q) = -\sum_{i=0}^{n} P(i)ln(Q(i)) \\ &= -0\cdot ln(Q(1)) -0\cdot ln(Q(2)) ... -1\cdot ln(Q(x)) ... -0\cdot ln(Q(n)) \\ &= -ln(Q(x)) \end{align*} 设x为正确分布中发生的事件H(p,q)=−i=0∑nP(i)ln(Q(i))=−0⋅ln(Q(1))−0⋅ln(Q(2))...−1⋅ln(Q(x))...−0⋅ln(Q(n))=−ln(Q(x))
反向传播和梯度
概念说明
大模型接收token列表,通过多层深度神经网络处理,最后输出一个词表长度的向量,这个向量的名字叫做logits。然后再使用前面介绍的Softmax归一化为概率向量,再通过交叉熵损失函数最后求得loss值。这个完整的过程叫做前向传播,除了计算loss之外,和推理过程是基本一致的。loss值可以评价模型离"正确输出"有多远,使用loss值作为基础,从后到前反向通过每一层神经网络,指导每个参数应该如何更新,即修改参数值。这就是反向传播的过程。
要知道大模型参数值非常巨大,如何根据loss值计算出每个参数应该更新多少呢?这就要通过梯度的方式。梯度实际上是每个参数对于loss的偏导数,即每个参数对于loss值的变化率。
试想我们计算loss的目的是通过loss来修改参数值,最终使得loss值变小。训练时需要经过大量数据,每个数据都会产生一个loss值,都会去更新每个参数值;那么每个数据对于参数值的影响,即每次修改的参数值范围是很小的。这里就和偏导数的直观含义类似:即参数有一个微小变化时,会对loss值产生一个微小的影响,这个微小影响就是参数在这个值的变化率,即偏导数。
因此,梯度就是偏导数。反向传播的概念就是通过loss值,一步一步从后向前计算出每个参数的偏导数。最后再将梯度输入优化器,通过优化器给参数一个微小改动,从而使得模型拥有学习和调整能力。注意优化器和修改参数值本身并不属于反向传播的过程。
我们可以把神经网络看作是一个超大的函数。前向传播时,函数的变量是token向量,网络中的参数值是常量。但反向传播时,我们把神经网络入参看作是不变的常量,将网络中的参数值看作是变量,通过这种方式来求偏导数。
logits梯度
前面介绍过,神经网络的输出在经过Softmax归一化之前的向量,叫做logits。梯度的计算起点就是logits,这里首先要计算logits中的每一个值对于loss的偏导数。将交叉熵损失函数和Softmax合并起来一起计算偏导,会更简单,因此先尝试合并计算的方式。首先是列出两个函数合并后的公式表示: 设: L为loss值;x为正确token对应的词表序号; H为交叉熵函数;P为模型预测概率向量,每个元素为pi; S为Softmax函数;A为logits向量,每个元素为ai; L= H(S(A))=−ln(S(ax))=−ln( eax ∑j=1n eaj ) = ln( ∑j=1n eaj eax )=ln( ∑j=1n eaj)−ln(eax) = ln( ∑j=1n eaj)−ax \begin{align*} \\ 设:&L为loss值;x为正确token对应的词表序号;\\ & H为交叉熵函数;P为模型预测概率向量,每个元素为p_i;\\ & S为Softmax函数;A为logits向量,每个元素为a_i;\\ L =& H(S(A)) = -ln(S(a_x)) = -ln(\frac{e^{a_x}}{\sum_{j=1}^{n}e^{a_j}} ) \\ =& ln(\frac{\sum_{j=1}^{n}e^{a_j}}{e^{a_x}} ) = ln(\sum_{j=1}^{n}e^{a_j}) - ln(e^{a_x}) \\ =& ln(\sum_{j=1}^{n}e^{a_j}) - a_x \end{align*} 设:L===L为loss值;x为正确token对应的词表序号;H为交叉熵函数;P为模型预测概率向量,每个元素为pi;S为Softmax函数;A为logits向量,每个元素为ai;H(S(A))=−ln(S(ax))=−ln(∑j=1neajeax)ln(eax∑j=1neaj)=ln(j=1∑neaj)−ln(eax)ln(j=1∑neaj)−ax
可以看到,这个公式和正确token对应的词表序号有关,因此求偏导时要分为两种场景,这里分别给出证明: 当i≠x时: ∂L ∂ai = eai ∑j=1n eaj =pi 当i=x时: ∂L ∂ax = eax ∑j=1n eaj −1=px−1 公式可以合并表示为: ∂L ∂ai =pi−yi(当i=x时,yi=1;否则yi=0) \begin{align*} &当i \ne x时:\\ &\frac{\partial L}{\partial a_i} = \frac{e^{a_i}}{\sum_{j=1}^{n}e^{a_j}} = p_i \\ &当i = x时:\\ &\frac{\partial L}{\partial a_x} = \frac{e^{a_x}}{\sum_{j=1}^{n}e^{a_j}} - 1 = p_x - 1 \\ &公式可以合并表示为:\\ &\frac{\partial L}{\partial a_i} = p_i - y_i \quad (当i = x时,y_i = 1;否则y_i= 0) \end{align*} 当i=x时:∂ai∂L=∑j=1neajeai=pi当i=x时:∂ax∂L=∑j=1neajeax−1=px−1公式可以合并表示为:∂ai∂L=pi−yi(当i=x时,yi=1;否则yi=0)
可以看到,经过合并和化简,使用很简单的方式就可以求出偏导数,结果也非常简洁。这就是logits向量中每个元素对于损失的梯度。
分开证明
前面介绍了合并计算的方式,但实际上单独对于交叉熵和Softmax求偏导计算梯度,也是可行的,就是麻烦一点(事实上也不是很麻烦,一开始我打算试一下看能求么,没想到直接就做出来了)。这里我们尝试将两个函数分开求偏导。首先求归一化后的向量对于loss的偏导数是非常简单的: 设Q=q1,...qn 为归一化后的输出向量 L为loss值;x为正确token。 ∂L ∂qi = ∂(−ln(qx)) ∂qi = { − 1qx 当i=x 0 当i≠x \begin{align*} \\ &设Q=q_1, ...q_n 为归一化后的输出向量\\ &L为loss值;x为正确token。\\ &\frac{\partial L}{\partial q_i} = \frac{\partial (-ln(q_x))}{\partial q_i}\\ &= \begin{cases} -\frac{1}{q_x} &当i=x \\ 0 &当i\ne x \end{cases} \\ \\ \end{align*} 设Q=q1,...qn 为归一化后的输出向量L为loss值;x为正确token。∂qi∂L=∂qi∂(−ln(qx))={−qx10当i=x当i=x
根据链式求导法则,如果想算loss对于logits的偏导数,可以分别求loss对于归一化向量的偏导数,乘以归一化向量对于logits的偏导数。第一个我们前面已经算出来了,第二个就是Softmax函数。 设:Q=q1,...qn 为归一化后的输出向量 A=a1,...an 为logits向量 ∂qi ∂ai = ∂( eai ∑j=1n eaj ) ∂ai = ∂(eai) ∂ai ⋅ ∑j=1n eaj−eai⋅ ∂( ∑j=1n eaj) ∂ai ( ∑j=1n eaj)2 = eai⋅ ∑j=1n eaj−eai⋅eai ( ∑j=1n eaj)2 = eai( ∑j=1n eaj−eai) ( ∑j=1n eaj)2 按照Softmax函数公式qi=softmax(ai)= eai ∑j=1n eaj 且q1+...+qn=1 原式=qi ∑j=1n eaj−eai ∑j=1n eaj =qi(1−qi) \begin{align*} &设:Q=q_1, ...q_n 为归一化后的输出向量\\ &A=a_1, ...a_n 为logits向量\\ \\ &\frac{\partial q_i}{\partial a_i} = \frac{\partial (\frac{e^{a_i}}{\sum_{j=1}^{n}e^{a_j}})}{\partial a_i}\\ &=\frac{ \frac{\partial (e^{a_i})}{\partial a_i} \cdot \sum_{j=1}^{n}e^{a_j} - e^{a_i} \cdot \frac{\partial (\sum_{j=1}^{n}e^{a_j})}{\partial a_i} }{ (\sum_{j=1}^{n}e^{a_j})^2 } \\ &= \frac{ e^{a_i} \cdot \sum_{j=1}^{n}e^{a_j} - e^{a_i} \cdot e^{a_i} }{ (\sum_{j=1}^{n}e^{a_j})^2 } = \frac{ e^{a_i} ( \sum_{j=1}^{n}e^{a_j} - e^{a_i}) }{ (\sum_{j=1}^{n}e^{a_j})^2 } \\ &按照Softmax函数公式 q_i = softmax(a_i) = \frac{e^{a_i}}{\sum_{j=1}^{n}e^{a_j}} \\ &且q_1 + ... + q_n = 1\\ &原式 = q_i\frac{\sum_{j=1}^{n}e^{a_j} - e^{a_i}}{\sum_{j=1}^{n}e^{a_j}} \\ &= q_i(1 - q_i) \end{align*} 设:Q=q1,...qn 为归一化后的输出向量A=a1,...an 为logits向量∂ai∂qi=∂ai∂(∑j=1neajeai)=(∑j=1neaj)2∂ai∂(eai)⋅∑j=1neaj−eai⋅∂ai∂(∑j=1neaj)=(∑j=1neaj)2eai⋅∑j=1neaj−eai⋅eai=(∑j=1neaj)2eai(∑j=1neaj−eai)按照Softmax函数公式qi=softmax(ai)=∑j=1neajeai且q1+...+qn=1原式=qi∑j=1neaj∑j=1neaj−eai=qi(1−qi)
再根据链式法则合起来计算Loss对于logits的偏导数。注意首先纠正一个错误的求法: 错误 ∂L ∂ai = ∂L ∂qi ⋅ ∂qi ∂ai 正确 ∂L ∂ai = ∑k=1n ∂L ∂qk ⋅ ∂qk ∂ai \begin{align*} \\ &错误 \quad \frac{\partial L}{\partial a_i} = \frac{\partial L}{\partial q_i} \cdot \frac{\partial q_i}{\partial a_i}\\ &正确 \quad \frac{\partial L}{\partial a_i} = \sum_{k=1}^{n} \frac{\partial L}{\partial q_k} \cdot \frac{\partial q_k}{\partial a_i}\\ \end{align*} 错误∂ai∂L=∂qi∂L⋅∂ai∂qi正确∂ai∂L=k=1∑n∂qk∂L⋅∂ai∂qk
L即loss是一个数字,但是Q即概率是一个向量,这个向量里面的每个值都是一个关于A向量中所有值的函数,因此L对ai的偏导数中实际上包含了Q的所有参数。因此需要这样计算: L=fQ(q1,...,qn );qi=fA(a1,...,an ); 因此按照偏导数的链式法则,应该这样计算: ∂L ∂ai = ∂L ∂q1 ∂q1 ∂ai + ∂L ∂q2 ∂q2 ∂ai ...+ ∂L ∂qn ∂qn ∂ai = ∑k=1n ∂L ∂qk ∂qk ∂ai \begin{align*} &L = f_Q(q_1,...,q_n ); \quad q_i = f_A(a_1,...,a_n ); \\ &因此按照偏导数的链式法则,应该这样计算:\\ &\frac{\partial L}{\partial a_i} = \frac{\partial L}{\partial q_1} \frac{\partial q_1}{\partial a_i} + \frac{\partial L}{\partial q_2} \frac{\partial q_2}{\partial a_i} ... + \frac{\partial L}{\partial q_n} \frac{\partial q_n}{\partial a_i} \\ &= \sum_{k=1}^{n} \frac{\partial L}{\partial q_k}\frac{\partial q_k}{\partial a_i} \end{align*} L=fQ(q1,...,qn );qi=fA(a1,...,an );因此按照偏导数的链式法则,应该这样计算:∂ai∂L=∂q1∂L∂ai∂q1+∂q2∂L∂ai∂q2...+∂qn∂L∂ai∂qn=k=1∑n∂qk∂L∂ai∂qk
由于我们前面只求了Q和A中下标相等的场景,这里再求一下不相等时候的偏导数。 ∂qx ∂ay = ∂( eax ∑j=1n eaj ) ∂ay 当x≠y时 =− eaxeay ( ∑j=1n eaj)2 =−( eax ∑j=1n eaj eay ∑j=1n eaj ) =−qxqy \begin{align*} \frac{\partial q_x}{\partial a_y} &= \frac{\partial (\frac{e^{a_x}}{\sum_{j=1}^{n}e^{a_j}})}{\partial a_y} \quad 当x \ne y时 \\ &= -\frac{e^{a_x}e^{a_y}}{(\sum_{j=1}^{n}e^{a_j})^2} \\ &= -(\frac{e^{a_x}}{\sum_{j=1}^{n}e^{a_j}} \frac{e^{a_y}}{\sum_{j=1}^{n}e^{a_j}}) \\ &= -q_xq_y \end{align*} ∂ay∂qx=∂ay∂(∑j=1neajeax)当x=y时=−(∑j=1neaj)2eaxeay=−(∑j=1neajeax∑j=1neajeay)=−qxqy
那么现在分开的偏导数已经全部求出来了,现在将它们拼合起来,求L对于A的偏导数: ∂L ∂ai = ∑k=1n ∂L ∂qk ∂qk ∂ai =0 ∂q1 ∂ai +...+0 ∂qn ∂ai + ∂L ∂qx ∂qx ∂ai =− 1qx ∂qx ∂ai = { − 1qi (qi(1−qi)) 当i=x − 1qx (−qxqi) 当i≠x = { qi−1 当i=x qi 当i≠x =qi−yi(当i=x时,yi=1;否则yi=0) \begin{align*} \\ \\ \frac{\partial L}{\partial a_i} &= \sum_{k=1}^{n} \frac{\partial L}{\partial q_k}\frac{\partial q_k}{\partial a_i} \\ &= 0\frac{\partial q_1}{\partial a_i} + ... + 0\frac{\partial q_n}{\partial a_i} + \frac{\partial L}{\partial q_x}\frac{\partial q_x}{\partial a_i} \\ &= -\frac{1}{q_x}\frac{\partial q_x}{\partial a_i} = \begin{cases} -\frac{1}{q_i}(q_i(1 - q_i)) & 当i=x\\ -\frac{1}{q_x}(-q_xq_i) &当i\ne x \end{cases} \\ &= \begin{cases} q_i-1 & 当i=x\\ q_i &当i\ne x \end{cases} \\ &= q_i-y_i \quad (当i = x时,y_i = 1;否则y_i = 0) \\ \\ \end{align*} ∂ai∂L=k=1∑n∂qk∂L∂ai∂qk=0∂ai∂q1+...+0∂ai∂qn+∂qx∂L∂ai∂qx=−qx1∂ai∂qx={−qi1(qi(1−qi))−qx1(−qxqi)当i=x当i=x={qi−1qi当i=x当i=x=qi−yi(当i=x时,yi=1;否则yi=0)
费了一番功夫,这样我们就得到了和前面合并计算一样的梯度计算结果。虽然计算过程并不难,但确实比合并计算要麻烦,在模型实际运算中,因为合并计算公式简洁简单,因此都不选择分开计算。
雅可比矩阵
向量如何对向量或者矩阵求梯度呢?这就需要介绍雅可比矩阵,它对于梯度的理解有重要的作用。我们先抛开大模型,重新假设X向量对Y向量求偏导数的场景。 设 Ym×1 =y1,...,ym , Xn×1 =x1,...,xn Ym×1 =f( Xn×1 )⟹ { y1=f1(x1,...,xn) y2=f2(x1,...,xn) ... ym=fm(x1,...,xn) 则 ∂yi ∂xj = ∂(fi(x1,...,xn)) ∂xj \begin{align*} &设 Y_{m\times 1} = y_1, ..., y_m ,X_{n\times 1} = x_1, ..., x_n \\ &Y_{m\times 1} = f(X_{n\times 1}) \Longrightarrow \begin{cases} y_1 = f_1(x_1, ..., x_n) \\ y_2 = f_2(x_1, ..., x_n) \\ ...\\ y_m = f_m(x_1, ..., x_n) \\ \end{cases} \\ &则\frac{\partial y_i}{\partial x_j} = \frac{\partial (f_i(x_1, ..., x_n))}{\partial x_j} \\ \end{align*} 设Ym×1=y1,...,ym ,Xn×1=x1,...,xn Ym×1=f(Xn×1)⟹⎩ ⎨ ⎧y1=f1(x1,...,xn)y2=f2(x1,...,xn)...ym=fm(x1,...,xn)则∂xj∂yi=∂xj∂(fi(x1,...,xn))
可以看到,当函数输出值是一个向量时,就相当于每个输出值有一个独立的函数,入参是X向量的全部参数。在向量xi对向量yj求偏导时,相当于挑出第j个函数来计算偏导数。因为i和j是独立的,因此向量对向量的偏导数实际是一个m×n的矩阵: ∂ Ym×1 ∂ Xn×1 = ∂y1 ∂x1 ∂y1 ∂x2 ⋯ ∂y1 ∂xn ∂y2 ∂x1 ∂y2 ∂x2 ⋯ ∂y2 ∂xn ⋮ ⋮ ⋱ ⋮ ∂ym ∂x1 ∂ym ∂x2 ⋯ ∂ym ∂xn \begin{align*} \frac{\partial Y_{m\times 1}}{\partial X_{n\times 1}} = \begin{bmatrix} \frac{\partial y_1}{\partial x_1}& \frac{\partial y_1}{\partial x_2}& \cdots & \frac{\partial y_1}{\partial x_n} \\ \frac{\partial y_2}{\partial x_1}& \frac{\partial y_2}{\partial x_2}& \cdots & \frac{\partial y_2}{\partial x_n} \\ \vdots & \vdots & \ddots & \vdots \\ \frac{\partial y_m}{\partial x_1}& \frac{\partial y_m}{\partial x_2}& \cdots & \frac{\partial y_m}{\partial x_n} \end{bmatrix} \end{align*} ∂Xn×1∂Ym×1= ∂x1∂y1∂x1∂y2⋮∂x1∂ym∂x2∂y1∂x2∂y2⋮∂x2∂ym⋯⋯⋱⋯∂xn∂y1∂xn∂y2⋮∂xn∂ym
这个矩阵就叫做雅可比矩阵。对应的我们前面计算过:单个数字对于向量求偏导,偏导数是向量;向量对于矩阵求偏导,结果是三维的雅可比张量;矩阵对矩阵求偏导,结果是四维雅可比张量。什么是张量?三维及以上维度的矩阵,就叫做张量。这也是深度学习相关工具(PyTorch,TensorFlow)中的数据表示形式。
线性层梯度计算和传播
我们求得logits向量的梯度,实际上只是反向传播的第一步。logits是大模型的"中间结果",并不是我们直接要调整的参数,因此我们还要继续从后向前传播,算出前面每个参数的梯度值。这里我们以一个线性层来举例梯度在神经网络中是如何计算的。对于非线性层,也是类似的计算和传播方式。
设向量维度为m,则一个线性层的矩阵计算公式可以这样举例。其中Y是输出向量,X是输入向量,A和B分别是模型中的参数。(为了公式简单一点,这里统一维度为相同数字,实际大模型中经常是不同的,但计算方式一样,只不过公式写起来没这么好看) Ym×1 = Am×m Xm×1 + Bm×1 Y_{m\times 1} = A_{m\times m}X_{m\times 1} + B_{m\times 1} Ym×1=Am×mXm×1+Bm×1
在前向传播中,我们以X作为自变量计算结果。但是在反向传播计算梯度时,计算哪个参数的梯度,哪个参数就要作为自变量,其余的参数则作为常量。为了方便理解,这里我们可以假设Y就是logits向量。假设要求loss对AB等参数的梯度,按照链式求导法则,我们已经求得了L对Y的偏导数,因此只需要求Y对A和B的偏导数即可。
在实际模型计算时,并不需要得到loss对AB等参数的真正梯度公式,只需要计算Y对于参数的梯度公式就好了。因此在上一步logits向量的梯度计算后,我们拿到的是logits向量的梯度实际值,不需要再合并公式了。且模型层数越长,这个公式恐怕非常难表示。我们从简单的开始,首先对B求梯度。 ∂Y∂B = ∂y1 ∂b1 ∂y1 ∂b2 ⋯ ∂y1 ∂bm ∂y2 ∂b1 ∂y2 ∂b2 ⋯ ∂y2 ∂bm ⋮ ⋮ ⋱ ⋮ ∂ym ∂b1 ∂ym ∂b2 ⋯ ∂ym ∂bm ∵ yj=AX+b当i≠j时,b=0 求偏导数时,AX为常数。因此i≠j时,偏导数为0 原式 = 1 0 ⋯ 0 0 1 ⋯ 0 ⋮ ⋮ ⋱ ⋮ 0 0 ⋯ 1 \begin{align*} \frac{\partial Y}{\partial B} &= \begin{bmatrix} \frac{\partial y_1}{\partial b_1}& \frac{\partial y_1}{\partial b_2}& \cdots & \frac{\partial y_1}{\partial b_m} \\ \frac{\partial y_2}{\partial b_1}& \frac{\partial y_2}{\partial b_2}& \cdots & \frac{\partial y_2}{\partial b_m} \\ \vdots & \vdots & \ddots & \vdots \\ \frac{\partial y_m}{\partial b_1}& \frac{\partial y_m}{\partial b_2}& \cdots & \frac{\partial y_m}{\partial b_m} \end{bmatrix} \\ \because & y_j = AX + b \quad 当i\ne j时,b = 0 \\ &求偏导数时,AX为常数。因此i\ne j时,偏导数为0 \\ 原式 &= \begin{bmatrix} 1& 0& \cdots & 0 \\ 0& 1& \cdots & 0 \\ \vdots & \vdots & \ddots & \vdots \\ 0& 0& \cdots & 1 \end{bmatrix} \end{align*} ∂B∂Y∵原式= ∂b1∂y1∂b1∂y2⋮∂b1∂ym∂b2∂y1∂b2∂y2⋮∂b2∂ym⋯⋯⋱⋯∂bm∂y1∂bm∂y2⋮∂bm∂ym yj=AX+b当i=j时,b=0求偏导数时,AX为常数。因此i=j时,偏导数为0= 10⋮001⋮0⋯⋯⋱⋯00⋮1
然后求Loss对于B的梯度。注意这里loss对Y的梯度是之前已经计算出的,这里直接套上实际的值来计算即可,没必要再合并公式了。且模型参数多,层数长,这个公式恐怕非常难表示。 ∂L∂B = ∂L∂Y ∂Y∂B = ∂L ∂y1 ∂L ∂y2 ... ∂L ∂ym 1 0 ⋯ 0 0 1 ⋯ 0 ⋮ ⋮ ⋱ ⋮ 0 0 ⋯ 1 = ∂L ∂y1 ∂L ∂y2 ... ∂L ∂ym \begin{align*} \\ &\frac{\partial L}{\partial B} = \frac{\partial L}{\partial Y}\frac{\partial Y}{\partial B} \\ &= \begin{bmatrix} \frac{\partial L}{\partial y_1} & \frac{\partial L}{\partial y_2} & ... & \frac{\partial L}{\partial y_m} \end{bmatrix} \begin{bmatrix} 1& 0& \cdots & 0 \\ 0& 1& \cdots & 0 \\ \vdots & \vdots & \ddots & \vdots \\ 0& 0& \cdots & 1 \end{bmatrix} =\begin{bmatrix} \frac{\partial L}{\partial y_1} \\ \frac{\partial L}{\partial y_2} \\ ... \\ \frac{\partial L}{\partial y_m} \end{bmatrix} \end{align*} ∂B∂L=∂Y∂L∂B∂Y=∂y1∂L∂y2∂L...∂ym∂L 10⋮001⋮0⋯⋯⋱⋯00⋮1 = ∂y1∂L∂y2∂L...∂ym∂L
然后再对A求梯度。因为A本身就是一个二维矩阵,因此雅可比张量是三维,这里就不列出张量了,我们直接写出矩阵中每个元素的偏导计算公式。(求对A偏导数时B直接变为0,因此这里就不列出了) ∂yk ∂ aij = ∂( ak1 ... akm x1 ... xm ) ∂ aij = ∂( ak1 x1+...+ akm xm) ∂ aij = { ∂( ai1 x1+...+ aim xm) ∂ aij 当k=i ∂( ak1 x1+...+ akm xm) ∂ aij 当k≠i = { ∂( aij xj) ∂ aij 当k=i 0 当k≠i = { xj 当k=i 0 当k≠i \begin{align*} \\ \frac{\partial y_k}{\partial a_{ij}} &= \frac{\partial ( \begin{bmatrix} a_{k1} & ... & a_{km} \end{bmatrix} \begin{bmatrix} x_1 \\ ... \\ x_m \end{bmatrix} )}{\partial a_{ij}} \\ &= \frac{\partial (a_{k1}x_1 + ... + a_{km}x_m)}{\partial a_{ij}} \\ &=\begin{cases} \frac{\partial (a_{i1}x_1 + ... + a_{im}x_m)}{\partial a_{ij}} & 当k=i \\ \frac{\partial (a_{k1}x_1 + ... + a_{km}x_m)}{\partial a_{ij}} & 当k\ne i \end{cases} \\ &=\begin{cases} \frac{\partial (a_{ij}x_j)}{\partial a_{ij}} & 当k=i \\ 0 & 当k\ne i \end{cases} \\ &= \begin{cases} x_j & 当k=i \\ 0 & 当k\ne i \end{cases} \end{align*} ∂aij∂yk=∂aij∂(ak1...akm x1...xm )=∂aij∂(ak1x1+...+akmxm)={∂aij∂(ai1x1+...+aimxm)∂aij∂(ak1x1+...+akmxm)当k=i当k=i={∂aij∂(aijxj)0当k=i当k=i={xj0当k=i当k=i
然后我们再将L对Y的偏导数相乘,注意链式法则对于中间变量的连加。 ∂L ∂ aij = ∑k=1m ∂L ∂yk ∂yk ∂ aij 注意k从1到m遍历,必然遇到一次k=i = ∂L ∂yi ∂yi ∂ aij =xj ∂L ∂yi \begin{align*} \frac{\partial L}{\partial a_{ij}} &= \sum_{k=1}^{m} \frac{\partial L}{\partial y_k}\frac{\partial y_k}{\partial a_{ij}} \\ &注意k从1到m遍历,必然遇到一次k = i \\ &= \frac{\partial L}{\partial y_i} \frac{\partial y_i}{\partial a_{ij}} = x_j\frac{\partial L}{\partial y_i} \end{align*} ∂aij∂L=k=1∑m∂yk∂L∂aij∂yk注意k从1到m遍历,必然遇到一次k=i=∂yi∂L∂aij∂yi=xj∂yi∂L
可以看到对A和B求的梯度都是非常简洁的。然后我们还需要对X求梯度。为什么?X并不是参数,我们不会根据梯度调整它的值,为什么要计算呢?这是因为在大模型中不止一层网络,一个公式,它是由好多线性或者非线性的公式一层一层向下计算的,上一个公式的输出Y,也就是下一个公式的输入X。因此我们计算了本公式X的梯度之后,这个梯度就是上一个公式中Y的梯度。然后再根据相同的计算方式向上继续求梯度即可,这对于线性层和非线性层都适用。因此,中间结果即使不用来调整参数,梯度还是照样计算的。 设第一个函数的输出实际上就是第二个函数的输入,即Y1=X2 Y1=A1X1+B1 Y2=A2X2+B2 则首先计算出 ∂L ∂X2 = ∂L ∂Y2 ∂Y2 ∂X2 = ∂L ∂Y1 则第一个公式就可以直接利用这个结果来计算梯度了: ∂L ∂A1 = ∂L ∂Y1 ∂Y1 ∂A1 ∂L ∂B1 = ∂L ∂Y1 ∂Y1 ∂B1 如果还需要向前传播,则需要计算出 ∂L ∂X1 = ∂L ∂Y1 ∂Y1 ∂X1 \begin{align*} &设第一个函数的输出实际上就是第二个函数的输入,即Y_1=X_2\\ &Y_1 = A_1X_1 + B_1 \\ &Y_2 = A_2X_2 + B_2 \\ &则首先计算出 \frac{\partial L}{\partial X_2} = \frac{\partial L}{\partial Y_2}\frac{\partial Y_2}{\partial X_2} = \frac{\partial L}{\partial Y_1} \\ &则第一个公式就可以直接利用这个结果来计算梯度了:\\ &\frac{\partial L}{\partial A_1} = \frac{\partial L}{\partial Y_1}\frac{\partial Y_1}{\partial A_1} \\ &\frac{\partial L}{\partial B_1} = \frac{\partial L}{\partial Y_1}\frac{\partial Y_1}{\partial B_1} \\ &如果还需要向前传播,则需要计算出 \frac{\partial L}{\partial X_1} = \frac{\partial L}{\partial Y_1}\frac{\partial Y_1}{\partial X_1} \\ \end{align*} 设第一个函数的输出实际上就是第二个函数的输入,即Y1=X2Y1=A1X1+B1Y2=A2X2+B2则首先计算出∂X2∂L=∂Y2∂L∂X2∂Y2=∂Y1∂L则第一个公式就可以直接利用这个结果来计算梯度了:∂A1∂L=∂Y1∂L∂A1∂Y1∂B1∂L=∂Y1∂L∂B1∂Y1如果还需要向前传播,则需要计算出∂X1∂L=∂Y1∂L∂X1∂Y1
我们再来真正的计算出X的梯度结果。 ∂yk ∂xi = ∂( ak1 ... akm x1 ... xm ) ∂xi = ∂( ak1 x1+...+ akm xm) ∂xi = ∂( aki xi) ∂xi = aki \begin{align*} \\ \frac{\partial y_k}{\partial x_i} &= \frac{\partial ( \begin{bmatrix} a_{k1} & ... & a_{km} \end{bmatrix} \begin{bmatrix} x_1 \\ ... \\ x_m \end{bmatrix} )}{\partial x_i} \\ &= \frac{\partial (a_{k1}x_1 + ... + a_{km}x_m)}{\partial x_i} \\ &= \frac{\partial (a_{ki}x_i)}{\partial x_i} = a_{ki} \end{align*} ∂xi∂yk=∂xi∂(ak1...akm x1...xm )=∂xi∂(ak1x1+...+akmxm)=∂xi∂(akixi)=aki
最后求出loss对X的梯度结果。 ∂L ∂xi = ∑k=1m ∂L ∂yk ∂yk ∂xi = ∑k=1m aki ∂L ∂yk \begin{align*} \frac{\partial L}{\partial x_i} &= \sum_{k=1}^{m} \frac{\partial L}{\partial y_k}\frac{\partial y_k}{\partial x_i} \\ &= \sum_{k=1}^{m} a_{ki}\frac{\partial L}{\partial y_k} \\ \end{align*} ∂xi∂L=k=1∑m∂yk∂L∂xi∂yk=k=1∑maki∂yk∂L
梯度下降与优化器
梯度下降法
通过反向传播拿到各个参数的梯度值之后,下一步就是更新参数值,以求获得更低的loss。最直观也是最简单的方式,就是类比导数的定义,将梯度值乘一个微小量得到一个数字,参数值减去这个数字,作为一个新的参数值: 设: θold 为当前参数值; θnew 为新参数值;η为学习率 θnew = θold − η ∂L∂θ ∣ θ= θold \begin{align*} \\ 设:&\theta_{old}为当前参数值;\theta_{new}为新参数值;\eta 为学习率\\ \theta_{new} &= \theta_{old} - \left.\eta\frac{\partial L}{\partial \theta}\right|{\theta=\theta {old}} \end{align*} 设:θnewθold为当前参数值;θnew为新参数值;η为学习率=θold−η∂θ∂L θ=θold
其中学习率,就是这里的微小量,可以取值为0.001,0.0001等。它可以作为训练的超参数,一旦设定后训练过程中就不再变化。也可以使用学习率调度器,在训练的不同阶段单独调整学习率(后面单独介绍)。这里为什么是减去梯度而不是加上梯度?试想导数的定义时当x增加微小量时,y变化的差值。如果y增大那么导数就是正的;y减小导数就是负值。上面公式如果是加梯度,那么就变成了增大Loss了。但我们目标是减小Loss值,因此要减去梯度。
梯度下降法(Gradient Descent)就是直接使用前面的公式来更新参数值的方法。根据平均值情况的不同,分为以下三个方法:
SGD 随机梯度下降 Stochastic Gradient Descent
MBGD 小批量梯度下降 Mini-Batch Gradient Descent
多个样本组合为一个batch,一个batch完成后计算一次梯度值
BGD 批量梯度下降 Batch Gradient Descent
例如我们训练集有10000个样本,SGD表示跑一个样本就更新一次;MBGD是跑batch个数据就更新一次(例如32 64 128等);BGD表示跑完所有10000样本再更新一次参数。MBGD和BGD的公式可以用这样的形式表示,只不过数量n的大小不同: θnew = θold −η1n ∑i=1n ∂Li ∂θ ∣ θ= θold \theta_{new} = \theta_{old} - \eta\frac{1}{n} \sum_{i=1}^{n} \left.\frac{\partial L_i}{\partial \theta}\right|{\theta=\theta {old}} θnew=θold−ηn1i=1∑n∂θ∂Li θ=θold
实际上就是对n个样本计算的梯度求一个平均数,以这个平均数作为梯度来更新参数。由于大模型训练时样本数量比较大,整个训练完是需要花很长时间的,而且模型学习率一般比较小,需要修改很多次才能对参数值有明显改动,如果使用BGD方法更新,那么首先训练时间就太长了,难以接受。
而SGD要求一次只能跑一个样本;但是为了加快训练时间,利用GPU并行计算能力,训练时一般都会将多个样本拼接起来组成一个batch,一起放入大模型中并行计算。这时候如果使用SGD,必须训练一个样本更新一次,就不能使用并行计算多个样本的能力了。因此,大模型训练中使用最多的还是MBGD。
注意,虽然我们是多个样本一起更新参数值,但是每个样本的梯度是单独计算的。因为在前面梯度计算的公式中可以看到,偏导数的值依赖于模型输入,正确值,以及模型计算的过程和中间结果,这些数据合起来叫做计算图。因此即使参数值相同时,模型对于不同输入的梯度值是不同的,因此训练时会把计算图暂存起来,对每个样本进行自己的反向传播计算梯度,最后再求平均,但实际计算时反向传播也是利用GPU并行计算能力,一次计算整个batch的梯度。
事实上,由于大模型跑一次只能输出一个token,因此一个样本内部也是并行多个位置的token,同时反向传播的。关于这个我们会在后面的参数训练流程部分中提到。
梯度下降类比
前面关于梯度下降和偏导数的相关说明,相信很多同学是理解为什么要这么做的。但是网上很多同学也会拿下山这件事情来类比,这里我们也举例说明一下。
梯度下降法类似于:
你想以最快的速度从山顶下到最低点 -> 对应希望求最小的Loss值
但是你的眼睛被蒙住,看不到应该如何下山最快 -> 对应不知道全局最优解,也不知道函数应该表示为什么样子
因此只能一步一步尝试 -> 对应模型只能一批样本更新一次参数,训练很多次才能调整好参数
每次从最陡的方向下山一步 -> 对应每个参数的负梯度值,就是最陡的方向
每一步的大小 -> 学习率
当前所处的位置 -> 当前的参数值
因此,梯度下降法,确实很像蒙眼下山的场景。我们注意到其中一点:为什么参数的负梯度值,即减去梯度值,就是最陡的方向?换成数学的话来说,一个多元函数(即多参数函数),每个参数可以看作是一个维度;每个参数的偏导数作为这个方向的分量,将所有的参数的偏导数组合为一个向量,这个向量的方向就是函数当前上升最快的方向。对应大模型这里,这个向量的反方向就是函数当前下降最快的方向。
下面来证明这个结论。首先需要了解全增量和全微分的概念。 设:X为n个参数组成的向量,展开表示为x1,...,xn △X为向量增加一个微小量,展开表示为△x1,...,△xn z为函数值,在大模型场景中即为loss; △z为函数值在△X下的变化量 公式表示为:z=f(X) 全增量:△z=f(X+△X)−f(X) 全微分:dz= ∑i=1n ∂z ∂xi △xi = ∂z ∂x1 △x1+...+ ∂z ∂xn △xn △z≈dz 当△X⟶0时,△z−dz=二阶及以上的无穷小量 \begin{align*} &设:X为n个参数组成的向量,展开表示为x_1, ..., x_n \\ &\bigtriangleup X为向量增加一个微小量,展开表示为\\bigtriangleup x_1, ..., \\bigtriangleup x_n \\ &z为函数值,在大模型场景中即为loss;\\ &\bigtriangleup z为函数值在\bigtriangleup X下的变化量\\ &公式表示为:z = f(X) \\ \\ &全增量: \bigtriangleup z = f(X + \bigtriangleup X) - f(X) \\ &全微分: dz = \sum_{i=1}^{n}\frac{\partial z}{\partial x_i}\bigtriangleup x_i \\ &= \frac{\partial z}{\partial x_1}\bigtriangleup x_1 + ... + \frac{\partial z}{\partial x_n}\bigtriangleup x_n \\ \\ &\bigtriangleup z \approx dz \\ &当 \bigtriangleup X \longrightarrow 0时,\bigtriangleup z - dz = 二阶及以上的无穷小量 \\ \end{align*} 设:X为n个参数组成的向量,展开表示为x1,...,xn △X为向量增加一个微小量,展开表示为△x1,...,△xn z为函数值,在大模型场景中即为loss;△z为函数值在△X下的变化量公式表示为:z=f(X)全增量:△z=f(X+△X)−f(X)全微分:dz=i=1∑n∂xi∂z△xi=∂x1∂z△x1+...+∂xn∂z△xn△z≈dz当△X⟶0时,△z−dz=二阶及以上的无穷小量
可以看到,全增量就是函数在入参遇到微小变化时,实际的函数值变化。全微分则是这个微小变化用每个参数的微分*变化值来线性的近似全增量的值。它们的差值是这个微小变化的二阶无穷小,基本可以忽略不计。代入梯度下降法场景,全增量是我们实际参数调整后模型的结果,全微分是我们希望参数调整后的模型的结果,它们是近似的。再用蒙眼下山场景类比,全增量是我们实际踏出的一步走的海拔变化,全微分是我们走之前预估走的海拔变化。 设:∇f(x)或∇f为X的偏导数组成的向量,展开表示为 ∂z ∂x1 ,..., ∂z ∂xn dz= ∂z ∂x1 △x1+...+ ∂z ∂xn △xn = ∂z ∂x1 ... ∂z ∂xn ⋅ △x1 ... △xn =∇f⋅△X \begin{align*} &设:\nabla f(x) 或 \nabla f 为X的偏导数组成的向量, 展开表示为\\frac{\\partial z}{\\partial x_1}, ..., \\frac{\\partial z}{\\partial x_n} \\ &dz = \frac{\partial z}{\partial x_1}\bigtriangleup x_1 + ... + \frac{\partial z}{\partial x_n}\bigtriangleup x_n \\ &= \begin{bmatrix} \frac{\partial z}{\partial x_1} & ... & \frac{\partial z}{\partial x_n} \end{bmatrix} \cdot \begin{bmatrix} \bigtriangleup x_1 \\ ... \\ \bigtriangleup x_n \end{bmatrix} = \nabla f \cdot \bigtriangleup X \end{align*} 设:∇f(x)或∇f为X的偏导数组成的向量,展开表示为∂x1∂z,...,∂xn∂z dz=∂x1∂z△x1+...+∂xn∂z△xn=∂x1∂z...∂xn∂z ⋅ △x1...△xn =∇f⋅△X
可以看到,全微分可以表示为两个向量相乘,我们的目标是让向量相乘之后的值最大(加负号之后就变为了值最小)。在几何的维度下,两个向量相乘可以表示为两个向量的长度乘以cos夹角值: 设:θ为两个向量夹角 ∇f⋅△X=∣∇f∣∣△X∣cosθ \begin{align*} \\ &设:\theta 为两个向量夹角 \\ &\nabla f \cdot \bigtriangleup X = |\nabla f| |\bigtriangleup X| \cos \theta \\ \end{align*} 设:θ为两个向量夹角∇f⋅△X=∣∇f∣∣△X∣cosθ
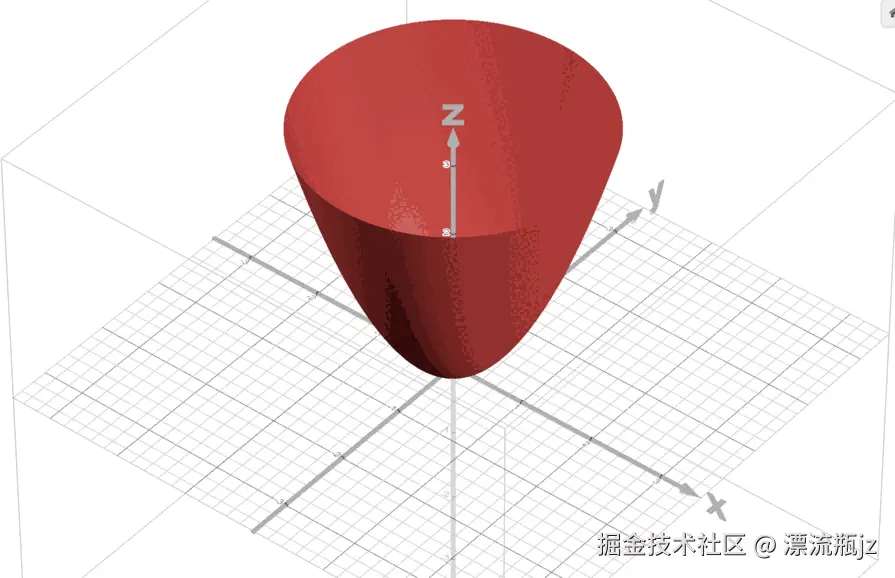
那什么时候乘积的值最大和最小呢,就是cosθ = 1和-1的时候。即两个向量的夹角为0度和180度,那也就是说X向量增加一个微小量ΔX的方向,即每个参数增长的比例,和梯度的方向一致时,值的增长最大;方向相反时,值的减小最大。因此按照负梯度值的方向下山,是最陡的方向,也是Loss值下降最快的方向。最后我们拿一个二元函数来举例: z=x2+y2 ∂z∂x =2x ∂z∂y =2y \begin{align*} z = x^2+y^2 \\ \frac{\partial z}{\partial x} = 2x \\ \frac{\partial z}{\partial y} = 2y \end{align*} z=x2+y2∂x∂z=2x∂y∂z=2y
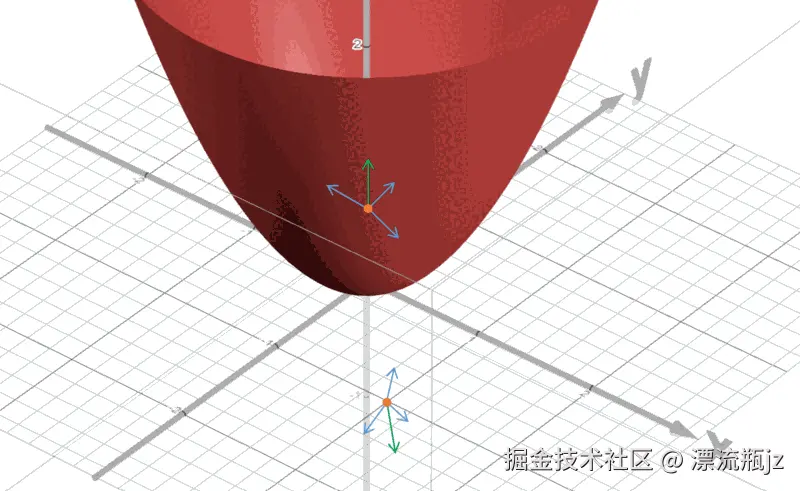
这个函数的三维图像如上,是一个类似于锅的形状,最低点为(0,0),越往外围值越大。此时我们求三个点的值和梯度: (1,1) z=2 ∂z∂x =2 ∂z∂y =2 梯度向量 (2,2) (1,−1) z=2 ∂z∂x =2 ∂z∂y =−2 梯度向量 (2,−2) (−1,−1) z=2 ∂z∂x =−2 ∂z∂y =−2 梯度向量 (−2,−2) \begin{align*} &(1, 1) &\quad z = 2 \quad \frac{\partial z}{\partial x} &= 2 \quad &\frac{\partial z}{\partial y} &= 2 \\ & &梯度向量&(2, 2)\\ &(1, -1) &\quad z = 2 \quad \frac{\partial z}{\partial x} &= 2 \quad &\frac{\partial z}{\partial y} &= -2 \\ & &梯度向量&(2, -2)\\ &(-1, -1) &\quad z = 2 \quad \frac{\partial z}{\partial x} &= -2 \quad &\frac{\partial z}{\partial y} &= -2 \\ & &梯度向量&(-2, -2)\\ \end{align*} (1,1)(1,−1)(−1,−1)z=2∂x∂z梯度向量z=2∂x∂z梯度向量z=2∂x∂z梯度向量=2(2,2)=2(2,−2)=−2(−2,−2)∂y∂z∂y∂z∂y∂z=2=−2=−2
这里的梯度向量,实际上就是在坐标轴上的方向,注意这里只是表示方向,不表示位置,因此梯度值为(2,2)和(1,1)是没有方向的区别的。但是梯度向量值的大小会影响走多大的步。对应在图上,就是(1, 1)的点往x轴正向45度,y轴正向45度时,z值增长最大;(1, -1)的点时,x轴正向45度,y轴负向45度时,z值增长最大。
对应到图上,就是xy平面上有很多方向,x和y值往哪个方向走,z值增长最快。可以看到绿色箭头对应的在曲面上的投影是z值增加最快的方向,其它蓝色箭头的投影低一些,有的还会让z值减小。
梯度下降缺陷
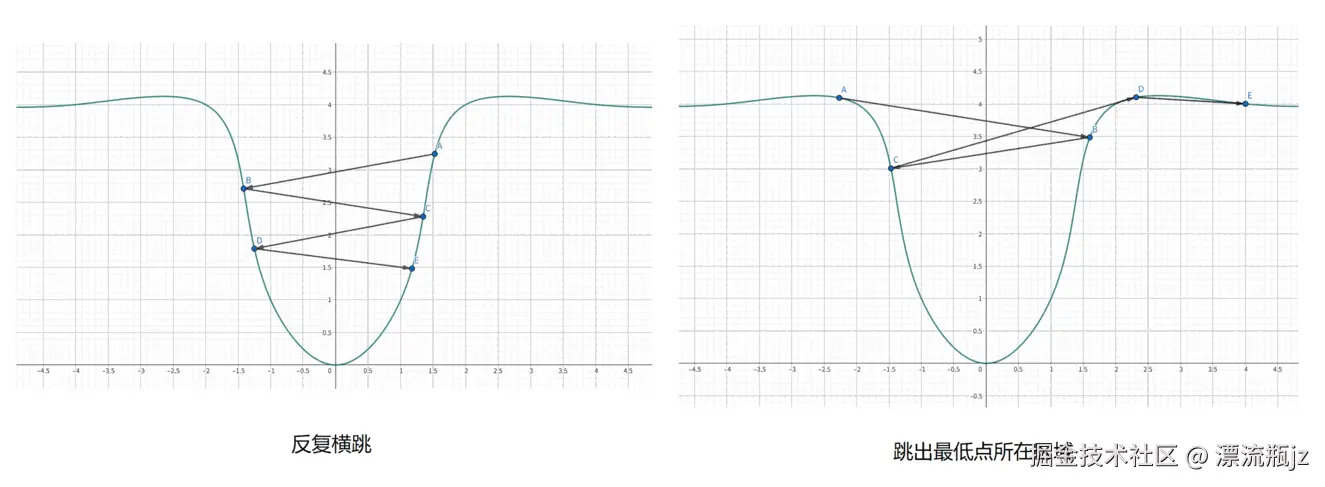
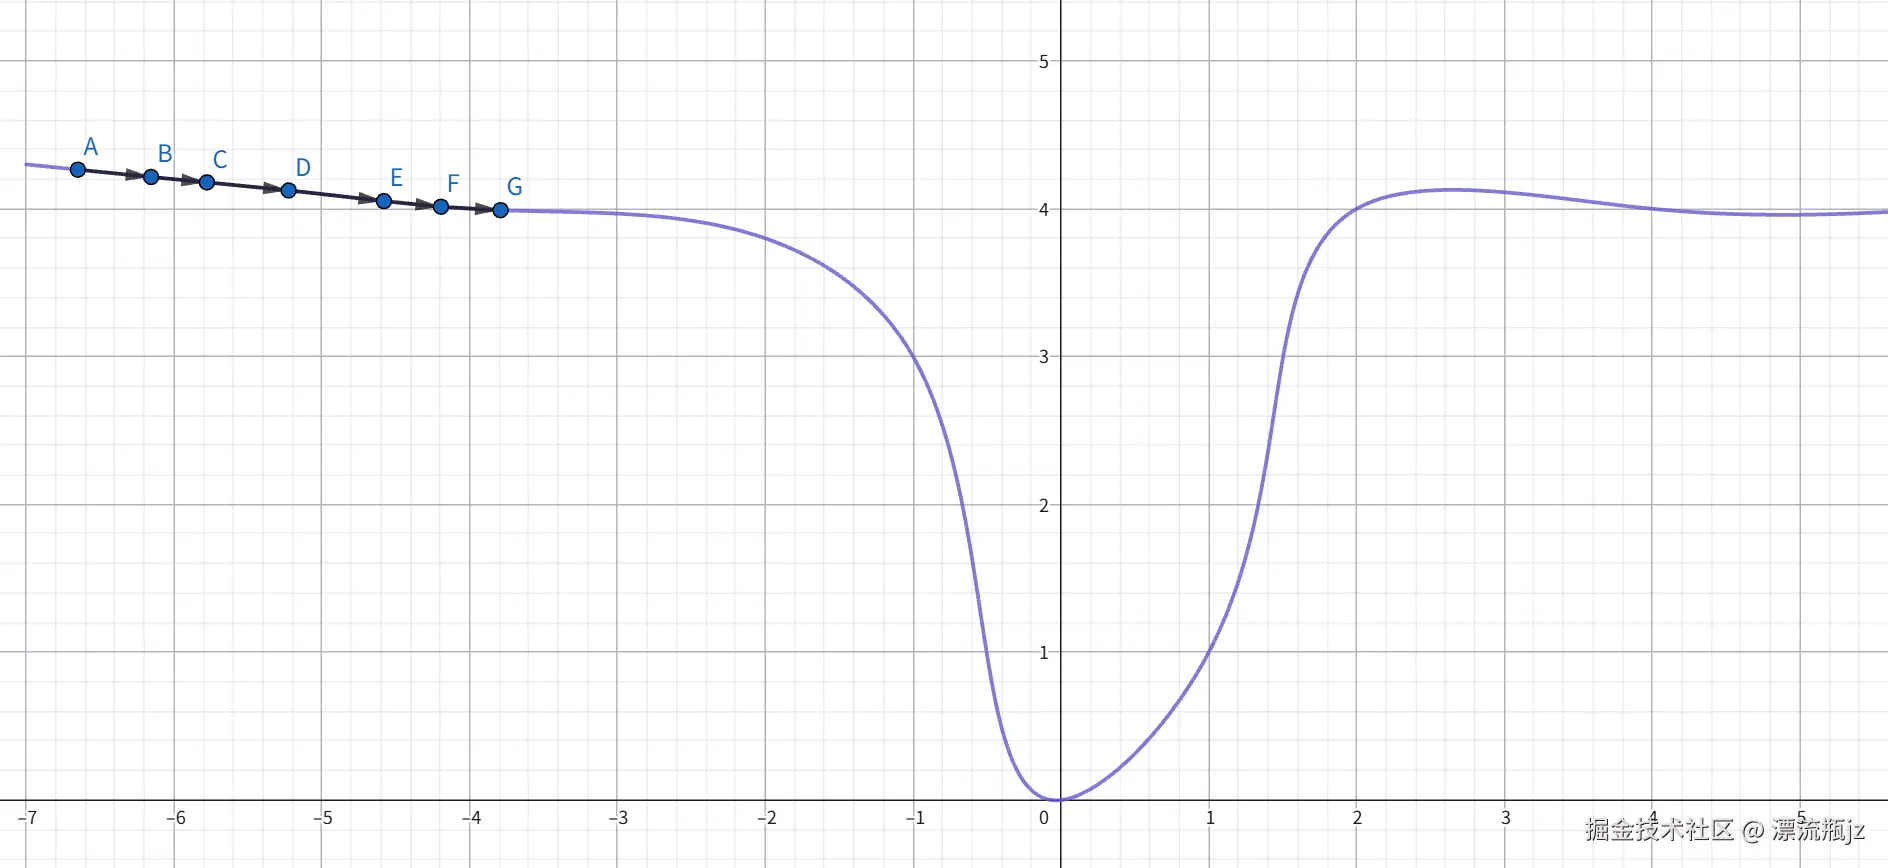
使用梯度下降法来更新参数,看似简洁又好用,但是也存在一些问题,这里列举几个。一是震荡问题:在面临一个两边都是下坡的最低点时,由于学习率是固定的,且模型梯度值也比较高,导致模型每一步会走的很大,直接从下坡的一侧穿过最低点到了另一侧。导致模型可以左右横跳震荡,很长时间才能走到最低点。甚至可能步子迈大了,彻底跳出这个区域。
顺便说一下这里的曲线图是通过GeoGebra在线制作的,我先通过离散点定义曲线的形状,再通过函数排序,实际连成曲线。不同例子中离散点的数据不一样。具体公式如下:
L = {(0,0),(1,1),(-1,1),(2,4),(-2,4),(4,4),(-4,4),(6,4),(-6,4)}
Ls = Sort(L, x(L))
Spline(Ls)
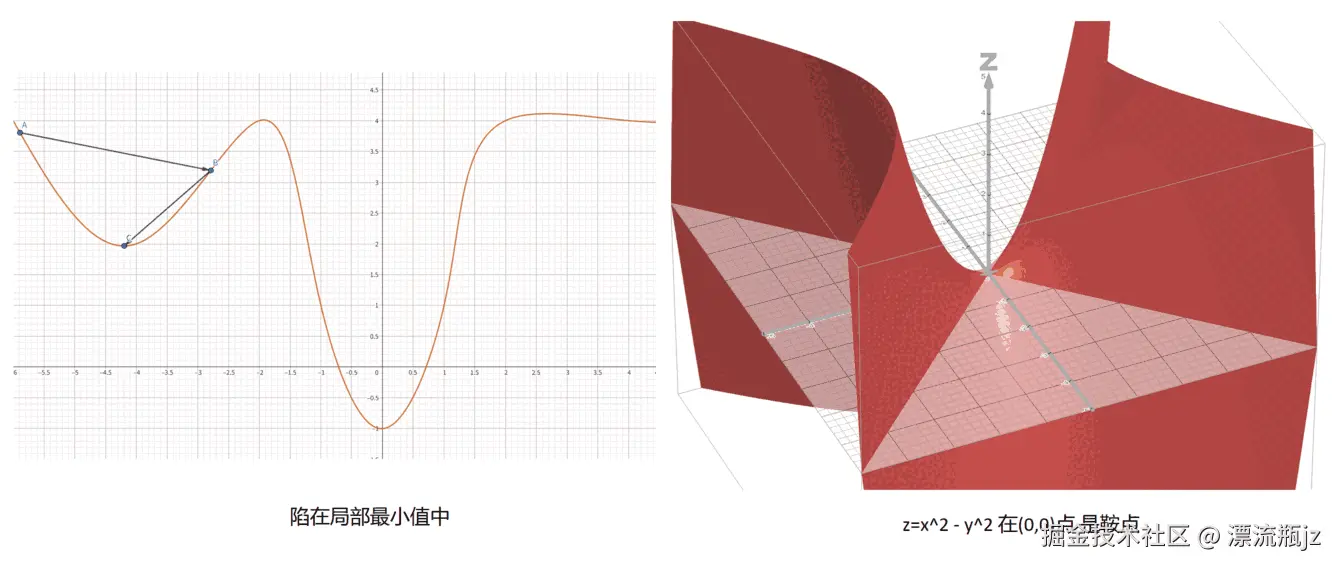
上图中列举了这两种场景的示意。这两个场景是可以通过调小学习率来解决,但是调小学习率之后会造成训练时间增加,而且可能更容易陷在局部最小值中出不来,这就是第二个问题。模型可能在局部最小点,驻点,鞍点等位置停住,模型无法继续前进。这些点的特性是梯度为0,函数"曲线"处在一个类似"平面"的位置上,代入梯度下降法的公式可以看到,此时参数的变化值为0,无法更新了,但实际上模型还没有走到全局最优点。这里依然用图片举例:
还有一种场景是模型遇到一个很长,而且下降幅度很低的缓坡,由于梯度值很小,因此模型经过缓坡时走一步的距离很小,导致模型需要很长的时间才能经过这个缓坡,非常影响训练效率。这个问题可以通过调大学习率来解决,但是调大之后前面的问题又更容易出现了。
BGD因为是直接用所有数据计算,没有随机因素,所以更容易发生这些问题。SGD和MBGD因为每次模型输入的数据不一样,带来了一些随机性,因此可以缓解部分现象,但问题依旧存在。为了尝试解决这些问题,又涌现出了其它梯度下降的方法,一般被叫做"优化器"。
动量法
动量英文名是Momentum,实际上类似于物理学中的惯性。即运动中的物体在不受到外力作用时,保持它之前的运动状态;如果受到外力作用时,则新的运动状态是之前的运动状态和外力作用的叠加效果。代入大模型场景,即参数每次的移动不仅看这次梯度的变化,还要参考历史的移动。这里列出动量法的公式: 设: θold 为当前参数值; θnew 为新参数值;η为学习率 vold 为当前"速度", vnew 为新速度 μ为动量系数,g为参数梯度,即 ∂L∂θ ∣ θ= θold 的简写 vnew =μ vold +g θnew = θold −η vnew \begin{align*} 设:&\theta_{old}为当前参数值;\theta_{new}为新参数值;\eta 为学习率 \\ &v_{old}为当前"速度",v_{new}为新速度 \\ &\mu 为动量系数,g为参数梯度,即\left.\frac{\partial L}{\partial \theta}\right|{\theta=\theta {old}}的简写 \\ &v_{new} = \mu v_{old} + g \\ &\theta_{new} = \theta_{old} - \eta v_{new} \end{align*} 设:θold为当前参数值;θnew为新参数值;η为学习率vold为当前"速度",vnew为新速度μ为动量系数,g为参数梯度,即∂θ∂L θ=θold的简写vnew=μvold+gθnew=θold−ηvnew
其中μ是预先设定好的超参数,一般设置为0.9。通过公式可以看到动量法引入了"速度"的概念,当前速度不仅看当前的梯度,还要参考之前的速度。这并不是完全套用惯性,但和惯性的特点类似,如果当前梯度为0,速度依然是上一步速度的90%。虽然这仅仅是对梯度下降公式的一个小的调整,但是可以缓解前面提到的缺陷。
首先是缓坡问题。假设在较长一段距离内,梯度值都为0.1,我们对比梯度下降法和动量法两者每步走的距离: 设:η学习率为0.001;μ动量系数为0.9;g参数梯度固定为0.1 v1=0+0.1=0.1θ1=0−0.001×0.1=−0.0001 v2=0.1×0.9+0.1=0.19θ2=−0.0001−0.001×0.19=−0.00029 v3=0.19×0.9+0.1=0.271θ3=−0.00029−0.001×0.271=−0.000561 v4=0.3439θ4=−0.0009049 ... \begin{align*} &设:\eta 学习率为0.001;\mu 动量系数为0.9;g参数梯度固定为0.1\\ &v_1 = 0 + 0.1 = 0.1 \quad \theta_1 = 0 - 0.001\times 0.1 = -0.0001 \\ &v_2 = 0.1\times 0.9 + 0.1 = 0.19 \quad \theta_2 = -0.0001 - 0.001\times 0.19 = -0.00029 \\ &v_3 = 0.19\times 0.9 + 0.1 = 0.271 \quad \theta_3 = -0.00029 - 0.001\times 0.271 = -0.000561 \\ &v_4 = 0.3439 \quad \theta_4 = -0.0009049 \\ &... \end{align*} 设:η学习率为0.001;μ动量系数为0.9;g参数梯度固定为0.1v1=0+0.1=0.1θ1=0−0.001×0.1=−0.0001v2=0.1×0.9+0.1=0.19θ2=−0.0001−0.001×0.19=−0.00029v3=0.19×0.9+0.1=0.271θ3=−0.00029−0.001×0.271=−0.000561v4=0.3439θ4=−0.0009049...
通过每步的计算可以看到,走的越长,速度越快,通过这种方式穿过缓坡的速度会比梯度下降要快很多。那么当梯度不变时,这个速度最大值是多少呢? vt+1 =0.9vt+g 当步数趋近于无穷时,假设存在一个稳定值 vmax vmax =0.9 vmax +g vmax = g1−0.9 =10g \begin{align*} &v_{t+1} = 0.9v_{t} + g \\ &当步数趋近于无穷时,假设存在一个稳定值v_{max} \\ &v_{max} = 0.9v_{max} + g \\ &v_{max} = \frac{g}{1-0.9} = 10g \\ \end{align*} vt+1=0.9vt+g当步数趋近于无穷时,假设存在一个稳定值vmaxvmax=0.9vmax+gvmax=1−0.9g=10g
通过推导可以得到,当步数趋近于无穷时,最大速度为1/(1-动量系数),当动量系数为0.9时,最大速度正好为10倍的梯度。因此动量法在穿过长缓坡时,最高速度可以达到梯度下降的10倍。
对于左右横跳震荡问题,因为两次的梯度方向相反,下一次的速度会被当前的速度抵消一些,因此可以解决部分震荡问题。通过下面例子可以看到,对比原始梯度的左右横跳,动量法在一边尝试下坡。 设:η学习率为0.001;μ动量系数为0.9;g参数梯度为10,−8,6,−4等 v1=0.9×0+10=10θ1=0−0.001×10=−0.01 v2=0.9×10−8=1θ2=−0.01−0.001×1=−0.011 v3=0.9×1+6=6.9θ3=−0.011−0.001×6.9=−0.0179 v4=2.21θ4=−0.02011 ... 对比原始梯度下降法: θ1=0−0.001×10=−0.01 θ2=−0.01−0.001×(−8)=−0.002 θ3=−0.002−0.001×6=−0.008 θ4=−0.008−0.001×(−4)=−0.004 ... \begin{align*} &设:\eta 学习率为0.001;\mu 动量系数为0.9;g参数梯度为10,-8,6,-4等\\ &v_1 = 0.9\times 0 + 10 = 10 \quad \theta_1 = 0 - 0.001\times 10 = -0.01 \\ &v_2 = 0.9\times 10 - 8 = 1 \quad \theta_2 = -0.01 - 0.001\times 1 = -0.011 \\ &v_3 = 0.9\times 1 + 6 = 6.9 \quad \theta_3 = -0.011 - 0.001\times 6.9 = -0.0179 \\ &v_4 = 2.21 \quad \theta_4 = -0.02011 \\ &...\\ &对比原始梯度下降法:\\ &\theta_1 = 0 - 0.001\times 10 = -0.01 \\ &\theta_2 = -0.01 - 0.001\times (-8) = -0.002 \\ &\theta_3 = -0.002 - 0.001\times 6 = -0.008 \\ &\theta_4 = -0.008 - 0.001\times (-4) = -0.004 \\ &...\\ \end{align*} 设:η学习率为0.001;μ动量系数为0.9;g参数梯度为10,−8,6,−4等v1=0.9×0+10=10θ1=0−0.001×10=−0.01v2=0.9×10−8=1θ2=−0.01−0.001×1=−0.011v3=0.9×1+6=6.9θ3=−0.011−0.001×6.9=−0.0179v4=2.21θ4=−0.02011...对比原始梯度下降法:θ1=0−0.001×10=−0.01θ2=−0.01−0.001×(−8)=−0.002θ3=−0.002−0.001×6=−0.008θ4=−0.008−0.001×(−4)=−0.004...
而且由于动量法具有惯性,在遇到局部最低点时,虽然梯度为0,但是模型还保留有速度,可能会通过惯性跳出局部最低点,避免陷进去。但也仅仅是部分场景可以,如果局部最低点又深又大,模型还是无法逃脱。
AdaGrad和RMSProp
在前面介绍的方法中,不管在训练的任何阶段和参数,学习率都是固定的超参数。但不同参数的调整速度不一定一致,有些参数需要慢速调整,有些参数则需要大步向前走,甚至有些参数早早的就找到了最优点,不再需要调整了。AdaGrad方法的英文全称叫做Adaptive Gradient Algorithm,即自适应梯度算法,可以根据参数历史的梯度值,对每个参数设置不同的学习率。下面是AdaGrad方法的计算公式: 设:θt为第t步的参数值,每个参数分别计算;η为学习率 Gt为历史梯度值的平方相加,g为参数梯度 ϵ为防止除数为0的超参数,一般为10−8 Gt+1 =Gt+g2 θt+1 =θt− η Gt+1 +ϵ g \begin{align*} &设:\theta_{t}为第t步的参数值,每个参数分别计算;\eta 为学习率 \\ &G_t为历史梯度值的平方相加,g为参数梯度 \\ &\epsilon 为防止除数为0的超参数,一般为 10^{-8}\\ \\ &G_{t+1} = G_{t} + g^2 \\ &\theta_{t+1} = \theta_t - \frac{\eta}{\sqrt{G_{t+1}} + \epsilon}g \end{align*} 设:θt为第t步的参数值,每个参数分别计算;η为学习率Gt为历史梯度值的平方相加,g为参数梯度ϵ为防止除数为0的超参数,一般为10−8Gt+1=Gt+g2θt+1=θt−Gt+1 +ϵηg
可以看到,公式就是在基础梯度下降法的基础上,对学习率进行了变化,至于梯度本身没有改动。这样改动后,当累计梯度大的参数值分母更大,学习率低,即参数变化更慢;累计梯度小的参数分母更小,学习率大,参数变化快。通过这种方式,每个参数就有了自己独立的学习率。
为什么不是让梯度累积大的参数有更大的学习率,变化更快呢?因为这样参数值变化太快,比较难收敛。另外由于先平方再开方的形式,忽略了梯度的正负号,且对于梯度更大的值更敏感。这里举个例子: g1=1G1=12=1 G1 =1 g2=10G2=1+102=101 G2 ≈10.05 g3=100G3=101+1002=10101 G3 ≈1005 \begin{align*} &g_1 = 1 \quad G_1 = 1^2 = 1 \quad \sqrt{G_1} = 1\\ &g_2 = 10 \quad G_2 = 1 + 10^2 = 101 \quad \sqrt{G_2} \approx 10.05 \\ &g_3 = 100 \quad G_3 = 101 + 100^2 = 10101 \quad \sqrt{G_3} \approx 1005 \\ \end{align*} g1=1G1=12=1G1 =1g2=10G2=1+102=101G2 ≈10.05g3=100G3=101+1002=10101G3 ≈1005
可以看到,对于同一个参数梯度累积来说,经过平方后,更大的梯度值对学习率的影响会放大。即使再经过开方,大梯度对学习率的影响还是被放大的。
AdaGrad的G是一直在增加,越来越大的。对应的学习率分母会越来越大,这样就造成学习率一开始很大,后续越来越低,低到一定程度后,参数值就基本不会变化,停止学习了。但可能此时参数值还没有到达最低点,没有训练完成。
这种学习率一直下降的场景并不符合实际情况,参数可能在某些时候需要高学习率,某些时候需要低学习率。因此在AdaGrad基础上进行改进,又出现了RMSProp方法。它的全称是Root Mean Square Propagation,即均方根传播方法。 设:θt为第t步的参数值,每个参数分别计算;η为学习率 Gt为历史梯度的平方加权平均;β为权重,一般为0.9或0.99 g为参数梯度,ϵ为防止除数为0的超参数,一般为10−8 Gt+1 =βGt+(1−β)g2 θt+1 =θt− η Gt+1 +ϵ g \begin{align*} &设:\theta_{t}为第t步的参数值,每个参数分别计算;\eta 为学习率 \\ &G_t为历史梯度的平方加权平均;\beta为权重,一般为0.9或0.99 \\ &g为参数梯度,\epsilon 为防止除数为0的超参数,一般为 10^{-8}\\ \\ &G_{t+1} = \beta G_{t} + (1-\beta)g^2 \\ &\theta_{t+1} = \theta_t - \frac{\eta}{\sqrt{G_{t+1}} + \epsilon}g \end{align*} 设:θt为第t步的参数值,每个参数分别计算;η为学习率Gt为历史梯度的平方加权平均;β为权重,一般为0.9或0.99g为参数梯度,ϵ为防止除数为0的超参数,一般为10−8Gt+1=βGt+(1−β)g2θt+1=θt−Gt+1 +ϵηg
RMSProp方法的计算公式和AdaGrad方法非常像,只是加了β这个权重系数,让历史的梯度累积影响逐渐衰减,但是看权重系数的取值一般比较大,因此衰减时间比较长。
通过这种方式,使得学习率具有AdaGrad的特性,又防止了梯度累积造成学习率过低,参数停止训练的问题。而且这种方式会使得参数在经过不同的位置时,出现不同的学习率,可以自适应的根据位置调整学习率。
移动加权指数平均和矩估计
在前面RMSProp方法的介绍中,使用权重系数β让历史梯度的影响逐渐衰减,同时让本次梯度的权重为1-β,使得权重总和为1。这种计算方式并不是RMSProp方法独创的,它是一个通用方法,名字叫做移动加权指数平均(Exponential Moving Average, EMA)。它的公式定义如下: 设:vt为第t步的结果值,xt为第t步的参数 β为权重系数,取值为0−1之间 vt+1 =βvt+(1−β) xt+1 \begin{align*} &设:v_t为第t步的结果值,x_t为第t步的参数\\ &\beta 为权重系数,取值为0-1之间\\ \\ &v_{t+1} = \beta v_t + (1-\beta)x_{t+1} \\ \end{align*} 设:vt为第t步的结果值,xt为第t步的参数β为权重系数,取值为0−1之间vt+1=βvt+(1−β)xt+1
公式非常简单,但是这样可以让权重的比例随时间缩小。我们将公式拆解开,第t步结果中每个参数的权重如下: vt =(1−β)xt+β vt−1 =(1−β)xt+β((1−β) xt−1 +β( vt−2 )) =(1−β)xt+β((1−β) xt−1 +β((1−β) xt−2 +β( vt−3 ))) =(1−β)xt+β(1−β) xt−1 +β2(1−β) xt−2 +β3 vt−3 (1−β)(xt+β xt−1 +β2 xt−2 +β3 xt−3 +...) \begin{align*} v_t &= (1-\beta)x_t + \beta v_{t-1}\\ &= (1-\beta)x_t + \beta((1-\beta)x_{t-1} + \beta(v_{t-2})) \\ &= (1-\beta)x_t + \beta((1-\beta)x_{t-1} + \beta((1-\beta)x_{t-2} + \beta(v_{t-3}))) \\ &= (1-\beta)x_t + \beta(1-\beta)x_{t-1} + \beta^2(1-\beta)x_{t-2} + \beta^3v_{t-3} \\ & (1-\beta)(x_t + \beta x_{t-1} + \beta^2 x_{t-2} + \beta^3 x_{t-3} + ...) \end{align*} vt=(1−β)xt+βvt−1=(1−β)xt+β((1−β)xt−1+β(vt−2))=(1−β)xt+β((1−β)xt−1+β((1−β)xt−2+β(vt−3)))=(1−β)xt+β(1−β)xt−1+β2(1−β)xt−2+β3vt−3(1−β)(xt+βxt−1+β2xt−2+β3xt−3+...)
由于β的值为0到1之间,因此β的乘方越高,对应参数权重越低,对应到公式中,第t步也就是最新的参数权重最高,时间越早的参数权重越低,但是每个参数对结果值依然有着贡献。使用这种方法,可以用来平滑数据,判断波动,提取特征等。它也是一种给参数根据时间变化求期望的方式。
矩是概率中的一个概念,是用来描述函数分布特征的一种指标,包含X阶矩,以及中心矩,原点矩等: 设X=x1,...,xi,...,xn 为第i个场景的值,pi为第i个场景的概率 k为矩的阶数,μ为期望 原点矩EXk = ∑i=1n pi(xi)k 中心矩E(X−μ)k = ∑i=1n pi(xi−μ)k \begin{align*} \\ &设X = x_1, ..., x_i, ..., x_n 为第i个场景的值,p_i为第i个场景的概率\\ &k为矩的阶数,\mu 为期望 \\ & 原点矩 \quad EX\^k = \sum_{i=1}^{n} p_i(x_i)^k \\ & 中心矩 \quad E(X-\\mu)\^k = \sum_{i=1}^{n} p_i(x_i-\mu)^k \\ \end{align*} 设X=x1,...,xi,...,xn 为第i个场景的值,pi为第i个场景的概率k为矩的阶数,μ为期望原点矩EXk =i=1∑npi(xi)k中心矩E(X−μ)k =i=1∑npi(xi−μ)k
在实际意义上,一阶原点矩就是分布的期望值,一阶中心矩是0,二阶中心矩则是方差。 一阶原点矩EX = ∑i=1n pixi 二阶中心矩E(X−μ)2 = ∑i=1n pi(xi−μ)2 \begin{align*} \\ &一阶原点矩 \quad EX = \sum_{i=1}^{n} p_ix_i \\ &二阶中心矩 \quad E(X-\\mu)\^2 = \sum_{i=1}^{n} p_i(x_i-\mu)^2 \\ \end{align*} 一阶原点矩EX =i=1∑npixi二阶中心矩E(X−μ)2 =i=1∑npi(xi−μ)2
矩估计则是一种参数估计方法,即我们使用样本计算出来矩的值,作为真实的矩的估计值,从而分析和尝试求解真实的分布。移动加权指数平均实际上就是对不同步骤的参数赋予一个权重概率,因此它也是一种矩估计方法。为什么要讲这些?因为在下面的Adam优化器中会用到。
Adam优化器
Adam优化器的全称为Adaptive Moment Estimation,直接翻译的名字就是"自适应矩估计"。它集合了前面讲过的方法:使用动量法给梯度增加惯性;使用RMSProp方法自适应学习率;同时将这两种方法融合到矩估计上面,使其有更好的解释性。Adam的计算公式如下: 设: θt为第t步的参数值,gt为第t步的梯度值 η为学习率,ϵ为防止除数为0的超参数 β1为动量系数,β2为自适应学习率权重 一阶矩 动量法部分 mt=β1 mt−1 +(1−β1)gt 二阶矩 RMSProp方法部分 vt=β2 vt−1 +(1−β2)(gt)2 偏差修正 m^t = mt 1−(β1)t v^t = vt 1−(β2)t 参数更新 θt= θt−1 − η v^t +ϵ m^t \begin{align*} 设:& \theta_t为第t步的参数值,g_t为第t步的梯度值 \\ &\eta 为学习率,\epsilon 为防止除数为0的超参数 \\ &\beta_1 为动量系数,\beta_2 为自适应学习率权重 \\ \\ 一阶矩& \quad 动量法部分\\ & m_t = \beta_1 m_{t-1} + (1-\beta_1)g_t \\ 二阶矩& \quad RMSProp方法部分\\ & v_t = \beta_2 v_{t-1} + (1-\beta_2)(g_t)^2\\ 偏差修正& \\ & \hat{m}_t = \frac{m_t}{1-(\beta_1)^t} \quad \hat{v}t = \frac{v_t}{1-(\beta_2)^t} \\ 参数更新& \\ & \theta_t = \theta {t-1} - \frac{\eta}{\sqrt{\hat{v}_t} + \epsilon}\hat{m}_t \end{align*} 设:一阶矩二阶矩偏差修正参数更新θt为第t步的参数值,gt为第t步的梯度值η为学习率,ϵ为防止除数为0的超参数β1为动量系数,β2为自适应学习率权重动量法部分mt=β1mt−1+(1−β1)gtRMSProp方法部分vt=β2vt−1+(1−β2)(gt)2m^t=1−(β1)tmtv^t=1−(β2)tvtθt=θt−1−v^t +ϵηm^t
可以看到,Adam并没有使用原始的动量法,而是做了一点改动,将当前梯度值也乘一个权重。最后的公式形式就是移动加权指数平均了。为什么要这么做?因为原始动量法是累加的,惯性会轻松超过速度本身,如果β1为0.9,最高可达梯度的10倍,但是RMSProp方法的却始终是梯度平方的一倍,这样就造成了量纲的不统一,直接结合会有问题,因此将动量法也改成了移动加权指数平均的形式。
动量法改造之后,两个部分都是移动加权指数平均,而且动量法是一阶矩,确定了参数的更新方向;RMSProp方法是二阶矩,确定了参数更新幅度;这给Adam方法注入了矩估计的理论基础。不过这两个部分都是原点矩而不是中心矩。虽然中心矩的实际意义和可解释性更好,但对于移动加权指数平均方法来说,还是原点矩更适用。
Adam还有一个改进是增加了偏差修正,即动量法和RMSProp算出的数字并不直接用来更新参数,而是经过偏差修正处理后再最终更新参数值。偏差修正的作用是什么?观察移动加权指数平均方法,由于开始时没有历史梯度累计值,因此启动非常慢,拿β1=0.9为例,最开始的m1仅仅为梯度的十分之一,v1也是类似的情况。而加入偏差修正后,会放大开始时计算的值,解决了启动慢的问题。我们看下例子: 设:每步的梯度值为一个常数g,β1动量系数为0.9 m1=0+0.1g=0.1g m2=0.9∗0.1g+0.1g=0.19g m3=0.9∗0.19g+0.1g=0.271g ... m^1 = 0.1g1−0.9 =g m^2 = 0.19g1−(0.9)2 =g m^3 = 0.271g1−(0.9)3 =g ... \begin{align*} & 设:每步的梯度值为一个常数g,\beta_1 动量系数为0.9 \\ & m_1 = 0 + 0.1g = 0.1g \\ & m_2 = 0.9*0.1g + 0.1g = 0.19g \\ & m_3 = 0.9*0.19g + 0.1g = 0.271g \\ & ... \\ &\hat{m}_1 = \frac{0.1g}{1-0.9} = g \\ &\hat{m}_2 = \frac{0.19g}{1-(0.9)^2} = g \\ &\hat{m}_3 = \frac{0.271g}{1-(0.9)^3} = g \\ & ... \\ \end{align*} 设:每步的梯度值为一个常数g,β1动量系数为0.9m1=0+0.1g=0.1gm2=0.9∗0.1g+0.1g=0.19gm3=0.9∗0.19g+0.1g=0.271g...m^1=1−0.90.1g=gm^2=1−(0.9)20.19g=gm^3=1−(0.9)30.271g=g...
可以看到当梯度值为一个常数时,偏差修正公式很神奇的使修正后的值与梯度值相同了!随着时间增长,mt越来越大,同时偏差修正公式中的分母越来越大,修正后的值始终和梯度值相同。事实上,通过偏差修正公式处理后,值为移动加权指数平均后梯度的期望值。而且不仅动量法适用,RMSProp也适用于这个偏差修正公式。下面通过求解得出这个公式,首先是动量法部分: mt =β1 mt−1 +(1−β1)gt =(1−β1)(gt+β1 gt−1 +β12 gt−2 +β13 gt−3 +...) =(1−β1) ∑i=1t gi β1t−i 对两边求期望,设gi的期望为一个常数g E(mt) =g(1−β1) ∑i=1t β1t−i =g(1−β1) ∑i=1t β1i−1 =g(1−β1) 1−β1t 1−β1 =g(1−β1t) ⇒g = E(mt) 1−β1t \begin{align*} m_t &= \beta_1 m_{t-1} + (1-\beta_1)g_t \\ &= (1-\beta_1)(g_t + \beta_1 g_{t-1} + \beta_1^2 g_{t-2} + \beta_1^3 g_{t-3} + ...) \\ &= (1-\beta_1)\sum_{i=1}^{t}g_i\beta_1^{t-i} \\ &对两边求期望,设g_i的期望为一个常数g\\ E(m_t) &= g(1-\beta_1)\sum_{i=1}^{t}\beta_1^{t-i} = g(1-\beta_1)\sum_{i=1}^{t}\beta_1^{i-1} \\ &= g(1-\beta_1)\frac{1-\beta_1^t}{1-\beta_1} = g(1-\beta_1^t) \\ \Rightarrow g &= \frac{E(m_t)}{1-\beta_1^t} \end{align*} mtE(mt)⇒g=β1mt−1+(1−β1)gt=(1−β1)(gt+β1gt−1+β12gt−2+β13gt−3+...)=(1−β1)i=1∑tgiβ1t−i对两边求期望,设gi的期望为一个常数g=g(1−β1)i=1∑tβ1t−i=g(1−β1)i=1∑tβ1i−1=g(1−β1)1−β11−β1t=g(1−β1t)=1−β1tE(mt)
因此,梯度的期望就是偏差修正公式处理后mt的期望。同样RMSProp也可以证明成立: vt =β2 vt−1 +(1−β2)gt2 =(1−β2)(gt2+β2 gt−12 +β22 gt−22 +β23 gt−32 +...) =(1−β2) ∑i=1t gi2 β2t−i 对两边求期望,设gi2的期望为一个常数g2 E(vt) =g2(1−β2) ∑i=1t β2t−i =g2(1−β2) ∑i=1t β2i−1 =g2(1−β2) 1−β2t 1−β2 =g2(1−β2t) ⇒g2 = E(vt) 1−β2t \begin{align*} v_t &= \beta_2 v_{t-1} + (1-\beta_2)g_t^2 \\ &= (1-\beta_2)(g_t^2 + \beta_2 g_{t-1}^2 + \beta_2^2 g_{t-2}^2 + \beta_2^3 g_{t-3}^2 + ...) \\ &= (1-\beta_2)\sum_{i=1}^{t}g_i^2\beta_2^{t-i} \\ &对两边求期望,设g_i^2的期望为一个常数g^2\\ E(v_t) &= g^2(1-\beta_2)\sum_{i=1}^{t}\beta_2^{t-i} = g^2(1-\beta_2)\sum_{i=1}^{t}\beta_2^{i-1} \\ &= g^2(1-\beta_2)\frac{1-\beta_2^t}{1-\beta_2} = g^2(1-\beta_2^t) \\ \Rightarrow g^2 &= \frac{E(v_t)}{1-\beta_2^t} \end{align*} vtE(vt)⇒g2=β2vt−1+(1−β2)gt2=(1−β2)(gt2+β2gt−12+β22gt−22+β23gt−32+...)=(1−β2)i=1∑tgi2β2t−i对两边求期望,设gi2的期望为一个常数g2=g2(1−β2)i=1∑tβ2t−i=g2(1−β2)i=1∑tβ2i−1=g2(1−β2)1−β21−β2t=g2(1−β2t)=1−β2tE(vt)
RMSProp求得的数据要经过开方,因此这里是梯度平方的期望。可以看到,这个偏差修正公式实际上是针对于移动加权指数平均。E(mt)和E(vt)这种属于梯度的有偏估计,通过修正可以变成无偏估计,即梯度(或平方)的期望。这就是偏差修正公式的意义,它可以消除移动加权指数平均带来的慢启动问题。
L2正则化和AdamW
AdamW方法是基于Adam改进得来的,但介绍AdamW之前,首先要了解L2正则化。前面提到的损失函数,反向传播和梯度下降优化器等方法,可以使得模型参数不断调整,学习到训练集中的知识和格式等,使得Loss下降。但是这样做也许会让模型参数过拟合,即在训练数据上表现非常好,但是在测试集和实际使用中却效果不好,即模型泛化能力差。
正则化方法可以解决这一问题。将前面的损失函数中另加入一项,表示参数的权重项即可。正则化有很多种方法,这里描述一下Lp正则化方法,即使用Lp范数作为参数权重项。Lp范数有L1范数,L2范数等,一直到无穷,表示不同意义下的距离函数: 设X=(x1,...,xn)为入参集合;Lp范数中的p表示幂次 Lp范数的表示形式为: ∥X∥p =( ∑i=1n ∣xi∣ p )1p L1范数: ∥X∥1 = ∑i=1n ∣xi∣ L2范数: ∥X∥2 = ∑i=1n xi2 L∞范数: ∥X∥∞ =max(∣X∣)即集合中绝对值最大的元素 \begin{align*} \\ &设X = (x_1, ..., x_n)为入参集合;Lp范数中的p表示幂次 \\ &Lp范数的表示形式为: \left \| X \right \|p = (\sum {i=1}^{n}\left | x_i \right |^p )^{\frac{1}{p} } \\ &L1范数: \left \| X \right \|1 = \sum {i=1}^{n}\left | x_i \right | \\ &L2范数: \left \| X \right \|2 = \sqrt{\sum {i=1}^{n}x_i^2} \\ &L\infty 范数: \left \| X \right \|_\infty = max(\left | X \right |) \quad 即集合中绝对值最大的元素 \\ \end{align*} 设X=(x1,...,xn)为入参集合;Lp范数中的p表示幂次Lp范数的表示形式为:∥X∥p=(i=1∑n∣xi∣p)p1L1范数:∥X∥1=i=1∑n∣xi∣L2范数:∥X∥2=i=1∑nxi2 L∞范数:∥X∥∞=max(∣X∣)即集合中绝对值最大的元素
可以看到,Lp范数的结果为一个距离值。L1范数为参数的绝对值相加;L2范数就是二维的欧几里得距离。因为幂次越高,绝对值更大的参数对于结果的影响更大,当幂次到无穷时,就只有最大的参数对结果产生影响,因此就只剩绝对值最大的元素了。
在大模型中,经常使用L2正则化作为避免过拟合的方式,即L2范数的平方,也就是去掉开方,因为这样求导方便。这里修改原有的损失函数,增加一项: 设:X=x1,...,xn 为所有参数的集合 Lold (X)为原有的损失函数, Lnew (X)为新的损失函数 λ为正则化系数 Lnew (X)= Lold (X)+λ12 ∥X∥22 = Lold (X)+λ12 ∑i=1n xi2 \begin{align*} &设:X = x_1, ..., x_n 为所有参数的集合\\ &L_{old}(X)为原有的损失函数,L_{new}(X)为新的损失函数\\ &\lambda 为正则化系数 \\ &L_{new}(X) = L_{old}(X) + \lambda \frac{1}{2} \left \| X \right \|2^2 \\ &= L {old}(X) + \lambda\frac{1}{2}\sum_{i=1}^{n} x_i^2 \end{align*} 设:X=x1,...,xn 为所有参数的集合Lold(X)为原有的损失函数,Lnew(X)为新的损失函数λ为正则化系数Lnew(X)=Lold(X)+λ21∥X∥22=Lold(X)+λ21i=1∑nxi2
前面加1/2的原因也是为了求导方便。正则化系数是一个0到1之间的数字,它控制L2正则化方法对于参数影响的大小,不同的模型或者优化器设置的并不相同,常见为0.1或者0.01等。这样模型中每个参数对于损失函数的偏导数,都会增加一个参数大小的项,而且非常容易计算: ∂ Lnew ∂xi = ∂ Lold ∂xi +λxi \frac{\partial L_{new}}{\partial x_i} = \frac{\partial L_{old}}{\partial x_i} + \lambda x_i ∂xi∂Lnew=∂xi∂Lold+λxi
L2正则化和梯度下降优化器是独立的,优化器将这个新的梯度值作为输入,经过处理后更新参数即可。但是在Adam方法中,这个新的梯度值会经过动量和自适应学习率处理再来更新,但L2正则化的部分不需要经过这些处理,处理后反而效果变差。
因此在Adam方法的基础上,出现了AdamW方法,其中W指的是Weight decay,即权重衰减。AdamW将L2正则化部分从损失函数和梯度值中拿出来,直接作为优化器公式的一部分,直接作用于参数更新,这也是权重衰减的意思。 Adam参数更新公式: θt= θt−1 − η v^t +ϵ m^t AdamW参数更新公式: θt= θt−1 − η v^t +ϵ m^t −ηλ θt−1 \begin{align*} \\ &Adam参数更新公式:\\ & \theta_t = \theta_{t-1} - \frac{\eta}{\sqrt{\hat{v}_t} + \epsilon}\hat{m}t \\ &AdamW参数更新公式:\\ & \theta_t = \theta {t-1} - \frac{\eta}{\sqrt{\hat{v}_t} + \epsilon}\hat{m}t - \eta \lambda \theta {t-1} \\ \\ \end{align*} Adam参数更新公式:θt=θt−1−v^t +ϵηm^tAdamW参数更新公式:θt=θt−1−v^t +ϵηm^t−ηλθt−1
注意依然要乘以学习率超参数。为什么?因为L2正则化项如果不乘学习率,可能会比Adam方法得到的值更大,大幅影响优化器本身的效果,甚至参数可能往反方向走。
通过AdamW方法,L2正则化并不需要修改原有的Loss损失函数,也不需要修改梯度值,仅仅在优化器中增加与L2正则求偏导值一样的一项即可,而且直接作用于参数更新,效果更好。Qwen3即采用了AdamW方法作为梯度下降的优化器。
学习率调度器
为什么需要学习率调度器
在前面梯度下降优化器的介绍中,我们了解RMSProp和Adam等方法,它们都包含了自适应学习率的功能,为什么还需要"学习率调度器"?自适应学习率实际上指的是在模型的同一次参数更新中,不同的参数使用不同的调整速度,适应不同参数梯度不一致的特点。但这时候优化器公式中依然有一个超参数学习率本身存在,且依然是控制参数整体更新幅度的重要工具。
例如在Adam方法中,经过偏差修正的一阶矩和二阶矩,它们的期望即是梯度和梯度值的平方。假设梯度值固定不变,他俩的值就等于梯度和梯度值的平方本身,我们代入Adam公式: 原公式:θt= θt−1 − η v^t +ϵ m^t 设: m^t =gt v^t =gt2 原公式⇒θt= θt−1 − η gt2 +ϵ gt = θt−1 − η ∣gt∣ +ϵ gt ≈ θt−1 −η⋅ { 1(gt>0) −1(gt<0) (省略极小的超参数ϵ) \begin{align*} \\ &原公式:\theta_t = \theta_{t-1} - \frac{\eta}{\sqrt{\hat{v}_t} + \epsilon}\hat{m}t \\ &设:\hat{m}t = g_t \quad \hat{v}t = g_t^2 \\ &原公式 \Rightarrow \theta_t = \theta {t-1} - \frac{\eta}{\sqrt{g_t^2} + \epsilon}g_t \\ &= \theta {t-1} - \frac{\eta}{\left | g_t \right | + \epsilon}g_t \\ &\approx \theta {t-1} - \eta \cdot \left\{\begin{matrix} 1 \quad (g_t > 0) \\ -1 \quad (g_t < 0) \end{matrix}\right. \quad (省略极小的超参数\epsilon) \\ \\ \end{align*} 原公式:θt=θt−1−v^t +ϵηm^t设:m^t=gtv^t=gt2原公式⇒θt=θt−1−gt2 +ϵηgt=θt−1−∣gt∣+ϵηgt≈θt−1−η⋅{1(gt>0)−1(gt<0)(省略极小的超参数ϵ)
可以看到,当梯度值不变时,参数的更新多少完全依赖于学习率的大小,不受梯度值本身大小的影响。因此,学习率本身确实是控制参数更新幅度的重要条件。而且在大模型训练中,学习率固定不变并不能适应不同阶段训练的要求:
训练前期需要大学习率,方便在大空间中快速探索,快速降低loss,同时避免陷入局部最小值
训练中期学习率需要稳定下降,让模型从探索转变为适当调整,防止模型横跳震荡
训练后期需要低学习率,让模型在最小值区域细致调整,找到更好的结果;同时避免学习率高导致模型跳出最小值
因此,学习率调度器的作用是将原有固定的学习率超参数变为动态参数,根据模型训练的不同时间阶段(或其它指标)来调整学习率,让模型达到更好效果的方法。
基础调度方法
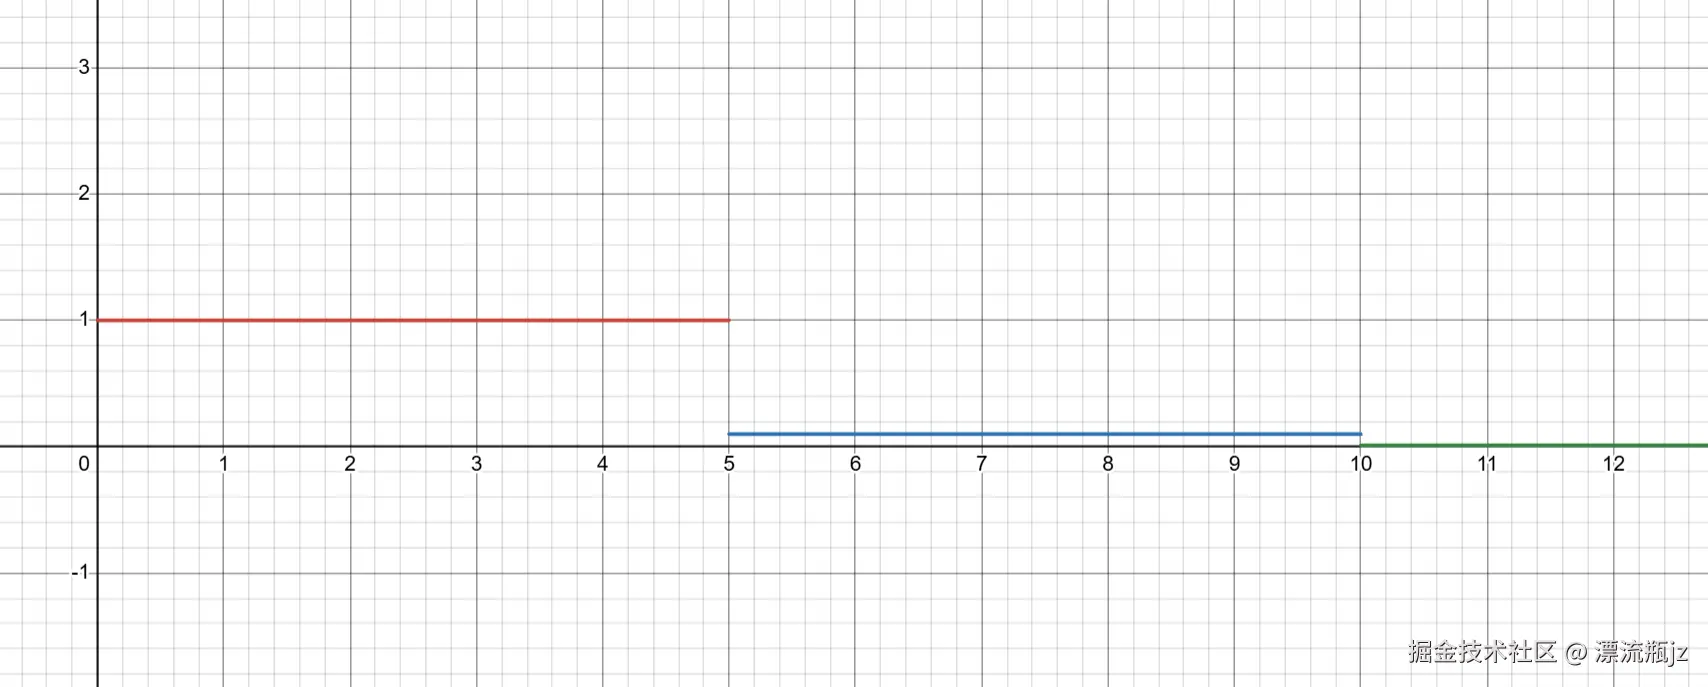
首先介绍几个简单的基础调度方法:StepLR, MultiStepLR, ExponentialLR。StepLR的英文全称为Step Learning Rate,即阶梯学习率,其中的LR即学习率的意思。这个方法每隔固定的步数,将当前学习率乘一个衰减因子。 设:当前已经训练过的步数为t,T是常数,表示T步后学习率变化 ηt表示当前步数的学习率,η0表示初始学习率 γ表示衰减因子,一般取值0.1 ηt=η0⋅γ ⌊tT⌋ \begin{align*} &设:当前已经训练过的步数为t,T是常数,表示T步后学习率变化\\ &\eta_t表示当前步数的学习率,\eta_0表示初始学习率 \\ &\gamma表示衰减因子,一般取值0.1 \\ \\ &\eta_t = \eta_0 \cdot \gamma^{\left \lfloor \frac{t}{T} \right \rfloor } \\ \end{align*} 设:当前已经训练过的步数为t,T是常数,表示T步后学习率变化ηt表示当前步数的学习率,η0表示初始学习率γ表示衰减因子,一般取值0.1ηt=η0⋅γ⌊Tt⌋
衰减因子上面的是向下取整。通过公式可以看到,初始时学习率为η0,每经过T步,学习率乘以一个衰减因子,即缩小为之前的十分之一。通过这种逐渐缩小的方式,符合了学习率逐渐下降的要求。至于这里的"步数",每一步可以表示为单条训练数据,也可以表示为整个训练集。由于大模型整个训练集数据非常大,不可能训练非常多轮次,因此一般采用单条训练数据为一步。当初始学习率为1,T取值为10时,StepLR的图像如下,类似于一个阶梯。
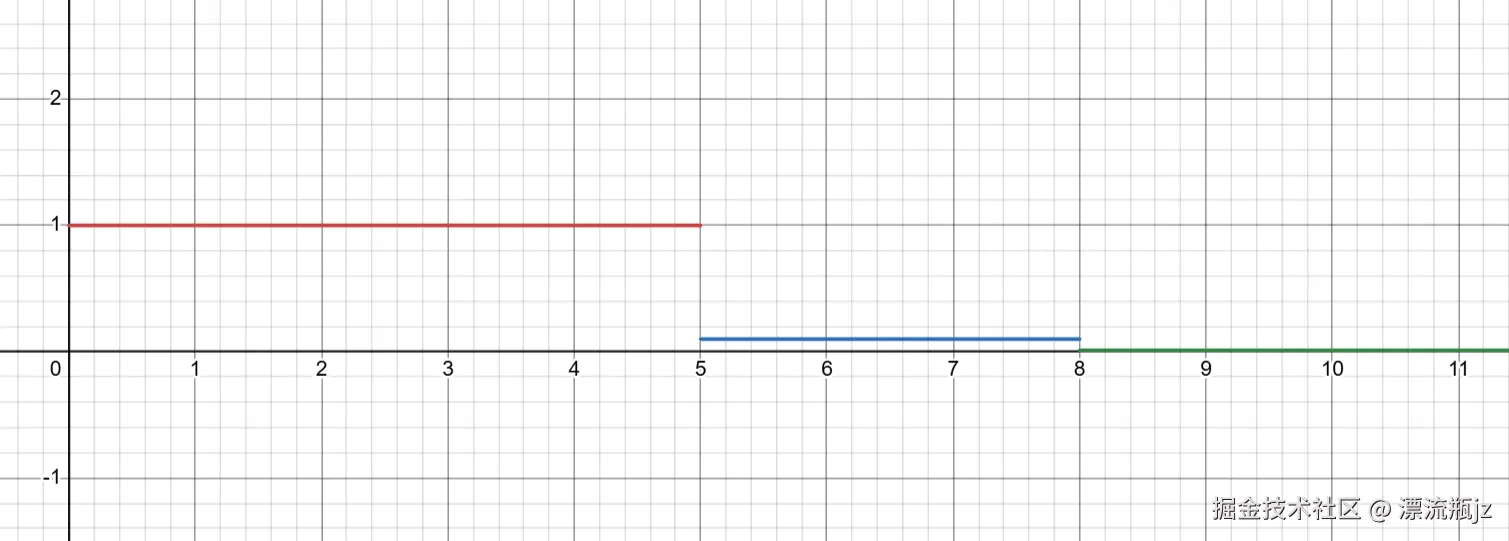
StepLR方法中,阶梯的长度是固定不变的,即每经过固定T步就变化。如果希望更细致的调整模型学习率变化,可以使用MultiStepLR方法。与StepLR相比,它可以自定义每个"阶梯"的长度。 设:当前已经训练过的步数为t ηt表示当前步数的学习率,η0表示初始学习率 γ表示衰减因子,一般取值0.1 M=m1,m2,... 为从小到大的步数值 当前步数每超过一个元素则f(t)的值+1 ηt=η0⋅γf(t) \begin{align*} &设:当前已经训练过的步数为t\\ &\eta_t表示当前步数的学习率,\eta_0表示初始学习率 \\ &\gamma表示衰减因子,一般取值0.1 \\ &M = m_1, m_2, ... 为从小到大的步数值\\ &当前步数每超过一个元素则f(t)的值 + 1\\ \\ &\eta_t = \eta_0 \cdot \gamma^{f(t)} \\ \end{align*} 设:当前已经训练过的步数为tηt表示当前步数的学习率,η0表示初始学习率γ表示衰减因子,一般取值0.1M=m1,m2,... 为从小到大的步数值当前步数每超过一个元素则f(t)的值+1ηt=η0⋅γf(t)
MultiStepLR的形式和StepLR基本一致,改动点就是多了M这个向量,通过它可以自己控制学习率在什么时间发生变化。当M = 5,3,8 时,图像如下:
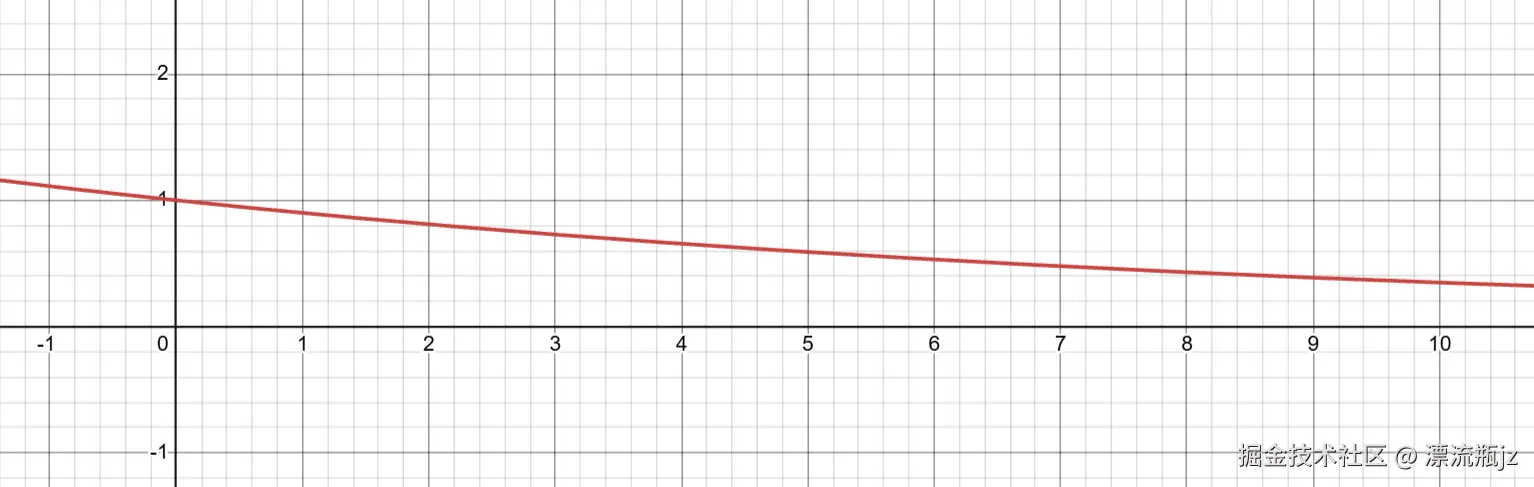
前面的两个方法都是阶梯状变化的,如果希望学习率调度器是平滑变化的,可以采用ExponentialLR方法,其中Exponential表示指数,即直接根据步数作为衰减因子的指数: 设:当前已经训练过的步数为t ηt表示当前步数的学习率,η0表示初始学习率 γ表示衰减因子,一般取值0.99 ηt=η0⋅γt \begin{align*} &设:当前已经训练过的步数为t\\ &\eta_t表示当前步数的学习率,\eta_0表示初始学习率 \\ &\gamma表示衰减因子,一般取值0.99 \\ \\ &\eta_t = \eta_0 \cdot \gamma^{t} \\ \end{align*} 设:当前已经训练过的步数为tηt表示当前步数的学习率,η0表示初始学习率γ表示衰减因子,一般取值0.99ηt=η0⋅γt
这样学习率调度器是关于步数的指数函数形式,曲线是平滑的,使模型训练过渡更稳定。但实际场景中StepLR等方法也不一定比ExponentialLR更差。衰减因子取值0.9时,图像如下:
余弦退火
余弦退火方法的英文名叫做CosineAnnealingLR,其中余弦表示学习率参考余弦公式下降;退火则是一个金属加工中的词,表示把金属材料加热到较高温度,然后缓慢冷却,让其中的金属原子重新排列,消除其中的应力。这里借用退火的概念,表示学习率随时间逐渐下降的含义。 设:当前已经训练过的步数为t,T是常数,表示训练总步数 ηt表示当前的学习率, ηmin 和 ηmax 表示最低和最高学习率 ηt= ηmin +12( ηmax − ηmin )(1+cos(tTπ)) \begin{align*} &设:当前已经训练过的步数为t,T是常数,表示训练总步数\\ &\eta_t表示当前的学习率,\eta_{min}和\eta_{max}表示最低和最高学习率\\ \\ &\eta_t = \eta_{min} + \frac{1}{2}(\eta_{max} - \eta_{min})(1 + \cos(\frac{t}{T}\pi)) \end{align*} 设:当前已经训练过的步数为t,T是常数,表示训练总步数ηt表示当前的学习率,ηmin和ηmax表示最低和最高学习率ηt=ηmin+21(ηmax−ηmin)(1+cos(Ttπ))
乍一看公式可能有点不理解,我把关键节点的计算结果列出: η0 = ηmin +12( ηmax − ηmin )(1+cos(0)) = ηmin +12( ηmax − ηmin )⋅2 = ηmax ηT2 = ηmin +12( ηmax − ηmin )(1+cos(π2)) = ηmin +12( ηmax − ηmin )⋅1 = ηmin + ηmax 2 ηT = ηmin +12( ηmax − ηmin )(1+cos(π)) = ηmin +12( ηmax − ηmin )⋅0 = ηmin \begin{align*} \eta_0 &= \eta_{min} + \frac{1}{2}(\eta_{max} - \eta_{min})(1 + \cos(0))\\ &= \eta_{min} + \frac{1}{2}(\eta_{max} - \eta_{min}) \cdot 2 \\ &= \eta_{max}\\ \eta_{\frac{T}{2}} &= \eta_{min} + \frac{1}{2}(\eta_{max} - \eta_{min})(1 + \cos(\frac{\pi}{2}))\\ &= \eta_{min} + \frac{1}{2}(\eta_{max} - \eta_{min})\cdot 1 \\ &= \frac{\eta_{min} + \eta_{max}}{2} \\ \eta_T &= \eta_{min} + \frac{1}{2}(\eta_{max} - \eta_{min})(1 + \cos(\pi))\\ &= \eta_{min} + \frac{1}{2}(\eta_{max} - \eta_{min})\cdot 0 \\ &= \eta_{min}\\ \end{align*} η0η2TηT=ηmin+21(ηmax−ηmin)(1+cos(0))=ηmin+21(ηmax−ηmin)⋅2=ηmax=ηmin+21(ηmax−ηmin)(1+cos(2π))=ηmin+21(ηmax−ηmin)⋅1=2ηmin+ηmax=ηmin+21(ηmax−ηmin)(1+cos(π))=ηmin+21(ηmax−ηmin)⋅0=ηmin
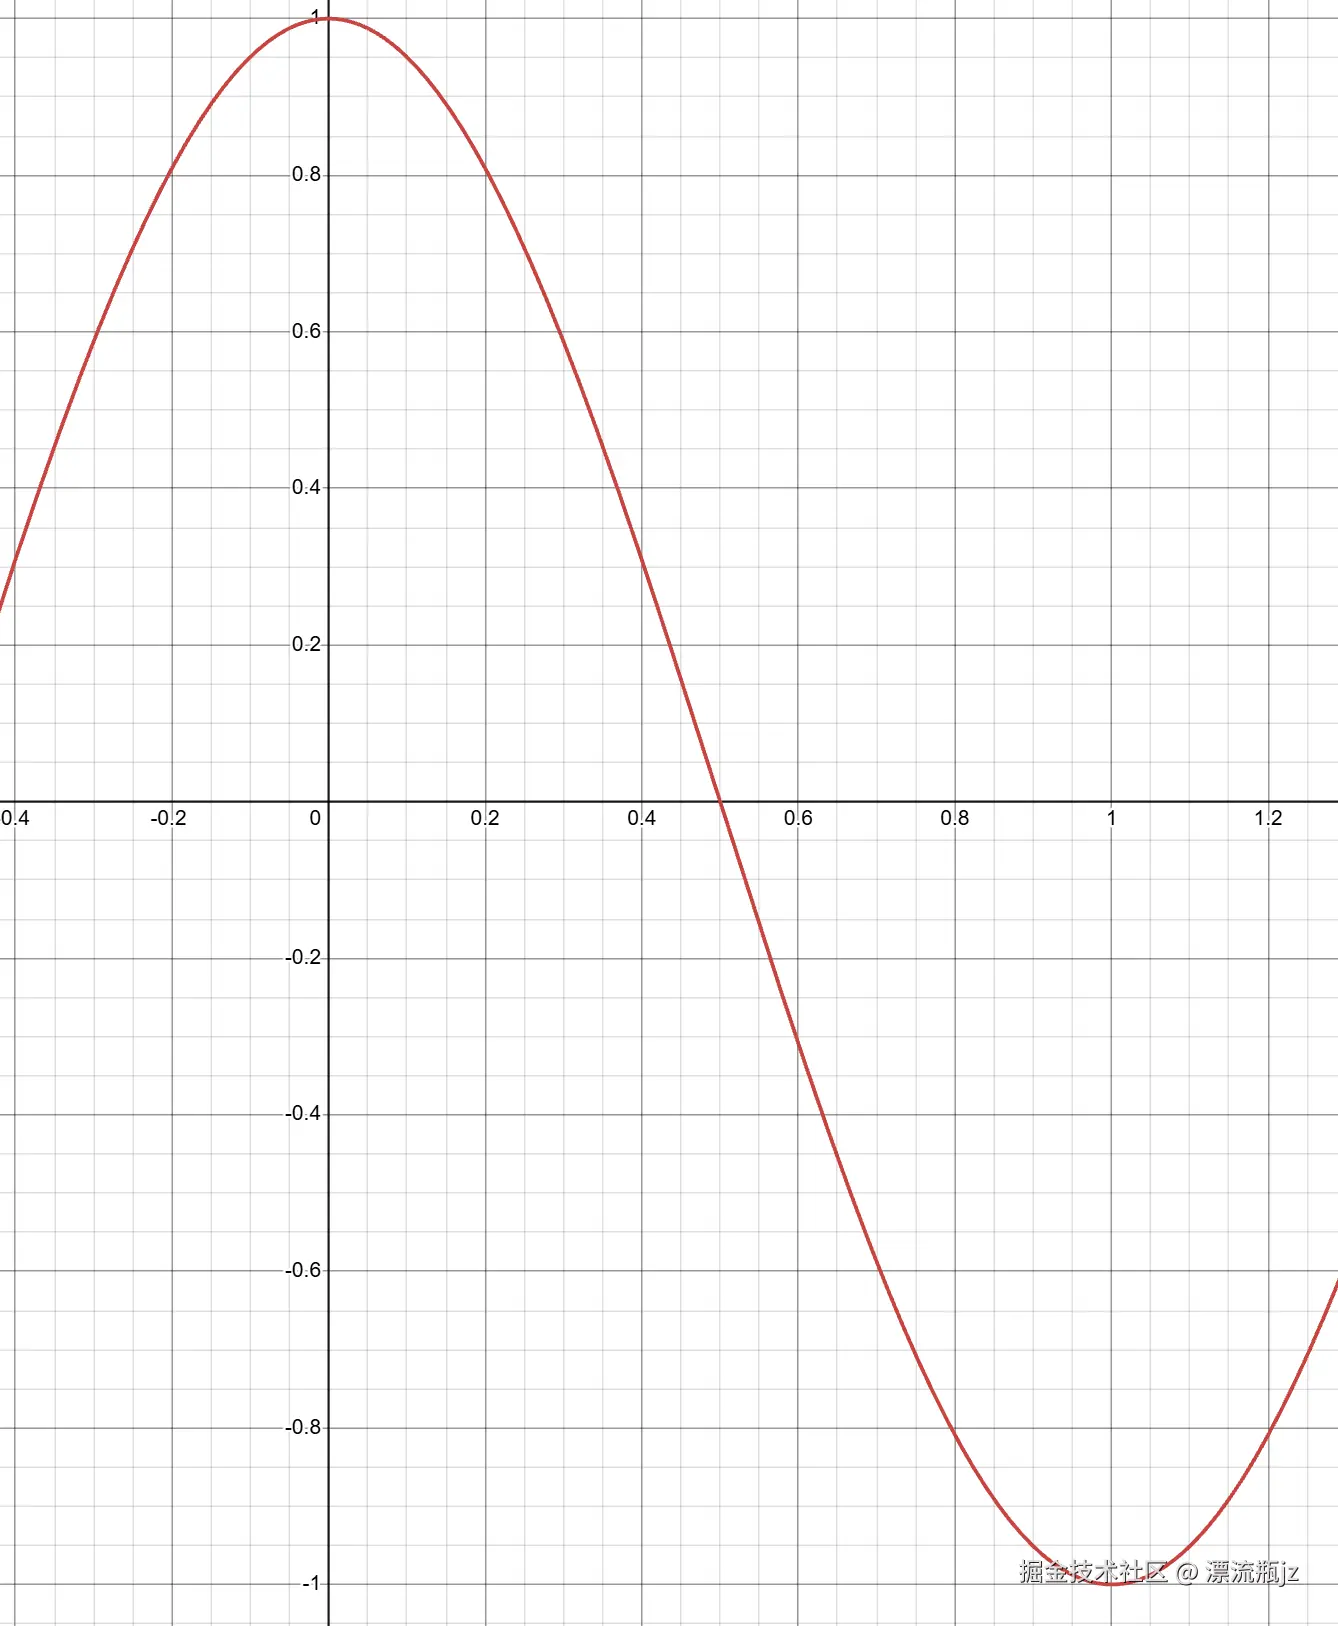
可以看到,当开始训练时,学习率最大;训练进行到一半时,学习率也正好是平均值;训练结束时,学习率最低。但它并不是线性下降的,cos函数前面的值都是常数,y=cos(xπ)本身的图像为:
可以看到,当x在0-1的区间内时,函数单调下降。但是下降的速度却不一样,靠近区间两端,即靠近0和1的位置,下降速度慢;靠近中间即0.5的位置,下降速度最快。这对应余弦退火方法的训练开始和结束时,学习率下降较慢;训练步数处于中间位置时,学习率下降较快。经过很多人的实验证明,使用余弦退火的方式比前面介绍的基础调度方法效果更好。但是这种方式需要提前预知训练总步数。
warmup
warmup表示预热,原意是运动前的热身活动,或者机器刚打开时候的预热。在大模型的场景下,表示模型训练开始时,不直接将学习率设为最大值,而是在训练初期逐步升高。warmup有很多种方法,最常用的是线性预热: 设:当前已经训练过的步数为t,T是常数,表示预热总步数 ηt表示当前的学习率, ηmax 表示最高学习率 ηt= ηmax tT当t≤T时 \begin{align*} &设:当前已经训练过的步数为t,T是常数,表示预热总步数\\ &\eta_t表示当前的学习率,\eta_{max}表示最高学习率\\ \\ &\eta_t = \eta_{max}\frac{t}{T} \quad 当t\le T时 \end{align*} 设:当前已经训练过的步数为t,T是常数,表示预热总步数ηt表示当前的学习率,ηmax表示最高学习率ηt=ηmaxTt当t≤T时
可以看到,公式非常简单,就是将学习率从0升至预设的值。预热总步数一般控制在总训练步数的0.1%到5%之间,也就是快速上升。这是因为训练刚开始时,参数值都是随机生成的,此时梯度和Adam等优化器的数值都不稳定,如果直接使用大学习率可能会将模型带偏,离最优值越来越远,甚至很难拉回来。
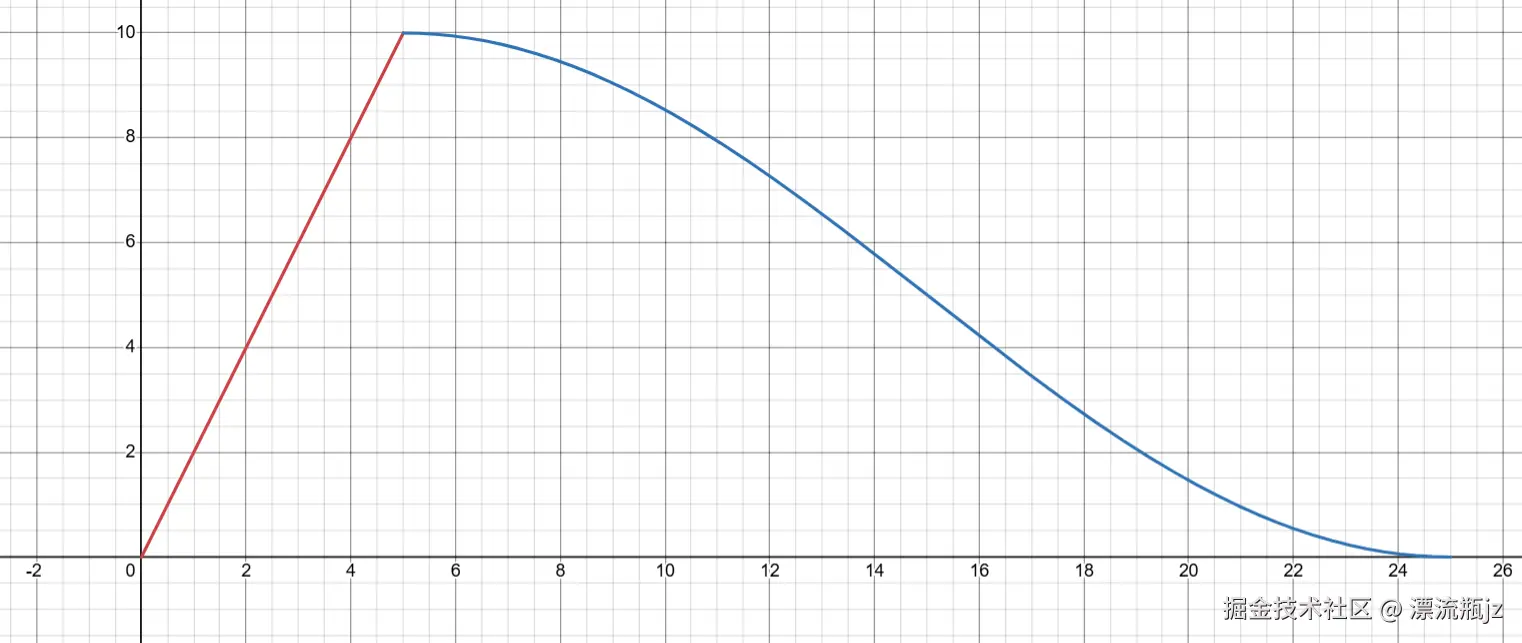
上升到预设学习率之后,后续训练不再采用warmup方法,而是选择正常的学习率下降方法。warmup与余弦退火方法是最常见的搭配,合起来叫做Warmup + Cosine Decay。结合使用的示意图如下,最开始使用warmup将学习率快速上升,然后搭配余弦方法慢慢下降。
训练数据
预训练和后训练
在之前的文章中我们提过,大模型训练主要分为预训练和后训练两个阶段,这两个阶段的训练数据和方法是不同的。预训练主要使用从网页,书籍,论文,代码,论坛,社媒等很多地方整理后的文本数据。预训练完成后,大模型理解和掌握了知识,但是只能续写文本,并不会回答问题。
后训练有很多种方法,这里只介绍最基础的SFT,全称为Supervised Fine-Tuning,即监督微调。它要求的数据格式为问答对,即问题/答案;问题/答案形式的数据。其中问题部分不计算loss和更新参数值,仅答案部分参与计算。通过SFT,模型可以掌握回答问题的能力,可以进行多轮对话,学会按照格式输出等。在SFT完成后,大模型还需要其它后训练方法,继续提升模型能力。
我们获取来的数据,需要先经过清洗处理,一般有正文抽取,去重,去掉错误数据,去广告,去掉隐私和非法数据;然后再统一格式,拆分打包,套入模板等处理,最后才给大模型训练使用。这里就不详细介绍了。
训练数据划分
模型训练时,数据一般被划分为三个集合。其中训练集的数据最多,具体比例需要根据任务类型和数据量分配。注意如果数据中有不同类别的数据,那么需要按照分层抽样的方式划分,即每个集合中对应类别的比例一致。
训练集: 用来学习和更新参数
验证集:用来监控和调整超参数,控制早停等
测试集:仅在训练完成后使用一次,评估模型能力
其中,训练集中的数据完整的走过前面所说的计算Loss和参数更新流程,它们是数据中数量最大也是最重要的部分,是知识和能力学习的来源,训练集中计算的Loss叫做Train Loss。
验证集中的数据是每隔一段时间跑一次,例如每隔1000步。验证集中计算的Loss叫做Val Loss。验证集虽然计算Loss,但这个Loss并不会指导更新模型参数,而是作为模型当前训练能力的评估和监控使用,即如果Val Loss异常升高,表示模型训练可能出问题了。
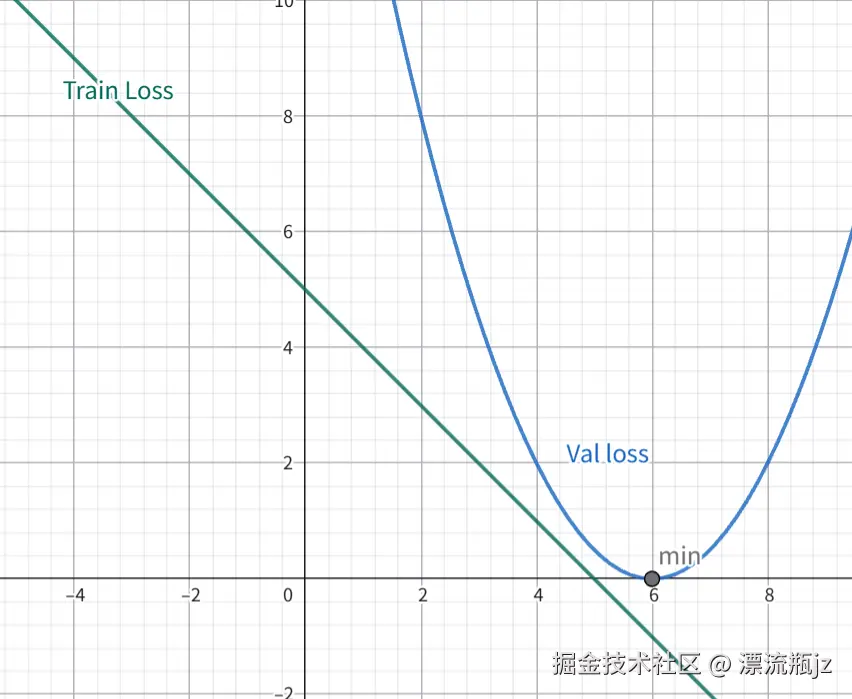
更常见的场景是Train Loss还在下降,但是Val Loss不再下降,反而向上升。这有可能是模型过度学习了训练数据,产生了过拟合,但是由于验证集没有用作参数更新,因此模型对验证集没有过拟合。此时应该停止学习,使用上升前的模型参数作为模型的训练结果。发现Val Loss上升时,提早停止训练,这叫做"早停"。模型训练时定时保存模型参数状态,这个状态叫做checkpoint。训练结束后使用Val Loss最低的状态作为训练结果,这叫做"选checkpoint"。例如下图:
早停一般在后训练中出现,预训练因为数据量非常大,且可能不会对同一批数据跑多个轮次,因此极少出现早停现象,一般都是完整训练结束。验证集一般也作为超参数选择使用,即选择不同的超参数训练,看看用哪个超参数值更好。这也是后训练主要使用,预训练消耗的时间和算力巨大,可能不会这么做。
验证集虽然不用来更新参数,但由于控制超参数和模型状态等,因此验证集也会对模型发挥训练作用。如果希望评估模型真正的能力,那么需要一次也没有在训练中使用过的数据,这就是测试集。注意测试集中的数据不能用来指导模型更新,否则它就变成验证集了,也失去了测试能力。除了使用训练数据本身提前切一块外,还可以使用外部的测试工具作为测试集来评估模型能力,这叫做"外部Benchmark"。
batch和epoch
这里介绍一下模型训练时,组织数据的一些名词:
单条数据:预训练时,指一段文本数据;后训练的SFT时,指一段连续的对话。
batch:包含多条训练数据,会传入大模型中同时处理
epoch:整个训练数据跑完一轮
其中单条训练数据很好理解,它是一段连续的文本,大模型会学习其中的知识,语义,注意力关系等。两条训练数据可以看作是独立的,没有任何关系。一条训练数据最长不能超过上下文长度,如果太长则需要切割。预训练的文本可能是书籍,论文,代码等,长度可能会特别长,因此可能会切割成很多条,每一条都是独立的训练数据。
大模型训练时具有并行处理能力,即它可以同时接收多条数据进入处理,互相之间独立计算。因此我们将多条训练数据组合为一个batch,一起放入模型中。一个batch中的训练数据格式如下:
[
  ['你好', ',', '我', '叫', 'jzplp'],
  ['今天', '天气', '如何', '?', ''],
  ['我', '喜欢', '使用', 'AI', '!'],
  // ...
]
可以看到,每一行都是一条训练数据,单条训练数据最长依然可以是上下文长度,因此一个batch中的总token数据经常是超过上下文长度的,具体多大要看硬件能力,即训练时的显存大小了。batch中的数据行数,叫做batch size。
SFT中的单条问答数据,相比于上下文长度可能太短,不够数据长度,这时候可以在最后填充特定的空字符,并且设置这些位置不求loss,不训练注意力关系(一般使用掩码技术处理,这里不展开讲了)。单条数据如果太短,作为一行训练是可行的,但这样会浪费机器的并行能力。因此可以将多条问答数据组合成一行,一起进入模型中训练。注意这时候需要对数据注意力关系做特殊处理,否则大模型会认为这是一条连续数据,影响训练效果。
整个训练数据跑完一轮,叫做一个epoch。预训练一般只跑一轮,因此大多不涉及过拟合问题。SFT后训练可能会跑多个epoch,这时候就可能出现过拟合问题了。
单条数据并行预测
在之前的文章中也介绍过,大模型每次只能根据已有的token序列,预测下一个token,但是我们训练时,提供给模型的是一段文本或者是问答数据,这些数据是完整且连续的,模型应该如何利用来训练呢?实际上,在单条数据内部,模型的训练也是并行预测各个位置,然后和数据本身进行比较。我们举个例子:
训练数据: ['你好', ',', '世界', '。', '我', '叫', 'jzplp', '。']
第1组:
已知: ['你好'] 预测:','
第2组:
已知: ['你好', ','] 预测:'世界'
第3组:
已知: ['你好', ',', '世界'] 预测:'。'
...
第7组:
已知: ['你好', ',', '世界', '。', '我', '叫', 'jzplp'] 预测:'。'
可以看到,我们对每个位置的数据都做一样的处理:把前面的数据都当作已知,预测下一个位置的token,然后和对应训练数据中的真实token比较。这在模型中是并行处理的。对应后训练SFT中的问答数据,也是一样的处理形式,只不过问题部分被忽略了:
训练数据: ['你好吗', '?', '我', '很好', '。', '今天', '天气', '如何', '?', '天气', '不错']
第1组:
已知: ['你好吗', '?',] 预测:'我'
第2组:
已知: ['你好吗', '?', '我',] 预测:'很好'
第3组:
已知: ['你好吗', '?', '我', '很好'] 预测:'。'
第4组:
已知: ['你好吗', '?', '我', '很好', '。', '今天', '天气', '如何', '?'] 预测:'天气'
第5组:
已知: ['你好吗', '?', '我', '很好', '。', '今天', '天气', '如何', '?', '天气'] 预测:'不错'
上面举了一个多轮对话的例子,注意问题部分永远作为已知,不会继续进行预测。后面的答案预测时,前面的问题和答案也同时作为已知。这里模型也是并行预测的。
平均Loss和梯度
大模型训练时,是并行预测n个位置的token,那么对应的Loss和参数的梯度值,理论上也会产生n个。大模型是如何使用这n个值更新参数呢?答案是求平均。即总Loss值等于n个Loss求平均值。对应的每个参数的梯度值,也是n个梯度值求平均值,最后用这个平均值放入梯度下降优化器中更新参数。注意,模型在不同预测位置的预测结果和中间结果都是不一样的,因此不同位置的梯度值数据也不一样。
但由于模型在反向传播求梯度值时,也是n个预测位置并行计算的,因此模型在计算时,直接让每个参数对总Loss值求梯度即可,并不需要分开计算再合并。公式如下: 设:N为模型预测位置总数;M为模型参数总数 L为平均Loss值,Lt为第t个预测位置的Loss值 xi为第i个参数, ∂Lt ∂xi 为第i个参数在第t个预测位置的梯度值 平均Loss:L=1N ∑t=1N Lt ∂L ∂Lt =1N 用来更新参数的平均梯度值: ∂L ∂xi = ∑t=1N ∂L ∂Lt ∂Lt ∂xi =1N ∑t=1N ∂Lt ∂xi \begin{align*} &设:N为模型预测位置总数;M为模型参数总数\\ &L为平均Loss值,L_t为第t个预测位置的Loss值\\ &x_i为第i个参数,\frac{\partial L_t}{\partial x_i} 为第i个参数在第t个预测位置的梯度值\\ \\ &平均Loss:L = \frac{1}{N} \sum_{t=1}^{N} L_t\\ &\frac{\partial L}{\partial L_t} = \frac{1}{N}\\ \\ &用来更新参数的平均梯度值:\\ &\frac{\partial L}{\partial x_i} = \sum_{t=1}^{N} \frac{\partial L}{\partial L_t} \frac{\partial L_t}{\partial x_i} = \frac{1}{N}\sum_{t=1}^{N}\frac{\partial L_t}{\partial x_i}\\ \end{align*} 设:N为模型预测位置总数;M为模型参数总数L为平均Loss值,Lt为第t个预测位置的Loss值xi为第i个参数,∂xi∂Lt为第i个参数在第t个预测位置的梯度值平均Loss:L=N1t=1∑NLt∂Lt∂L=N1用来更新参数的平均梯度值:∂xi∂L=t=1∑N∂Lt∂L∂xi∂Lt=N1t=1∑N∂xi∂Lt
可以看到,我们直接对总Loss求参数的梯度,实际上与对每个预测位置分别求梯度再求平均,最后的值是相同的。别看我们公式最后推导出了分别求的形式,但实际上大模型的内部是矩阵和张量运算,并不会计算出第i个参数在第t个预测位置的梯度值这种形式,而是直接给出了平均梯度值。
如果训练时一个batch中有多条训练数据,那么这多条数据的Loss和梯度会被一起求平均,最后再更新参数值。一个batch实际上只更新一次参数。
流程和总结
总体流程图
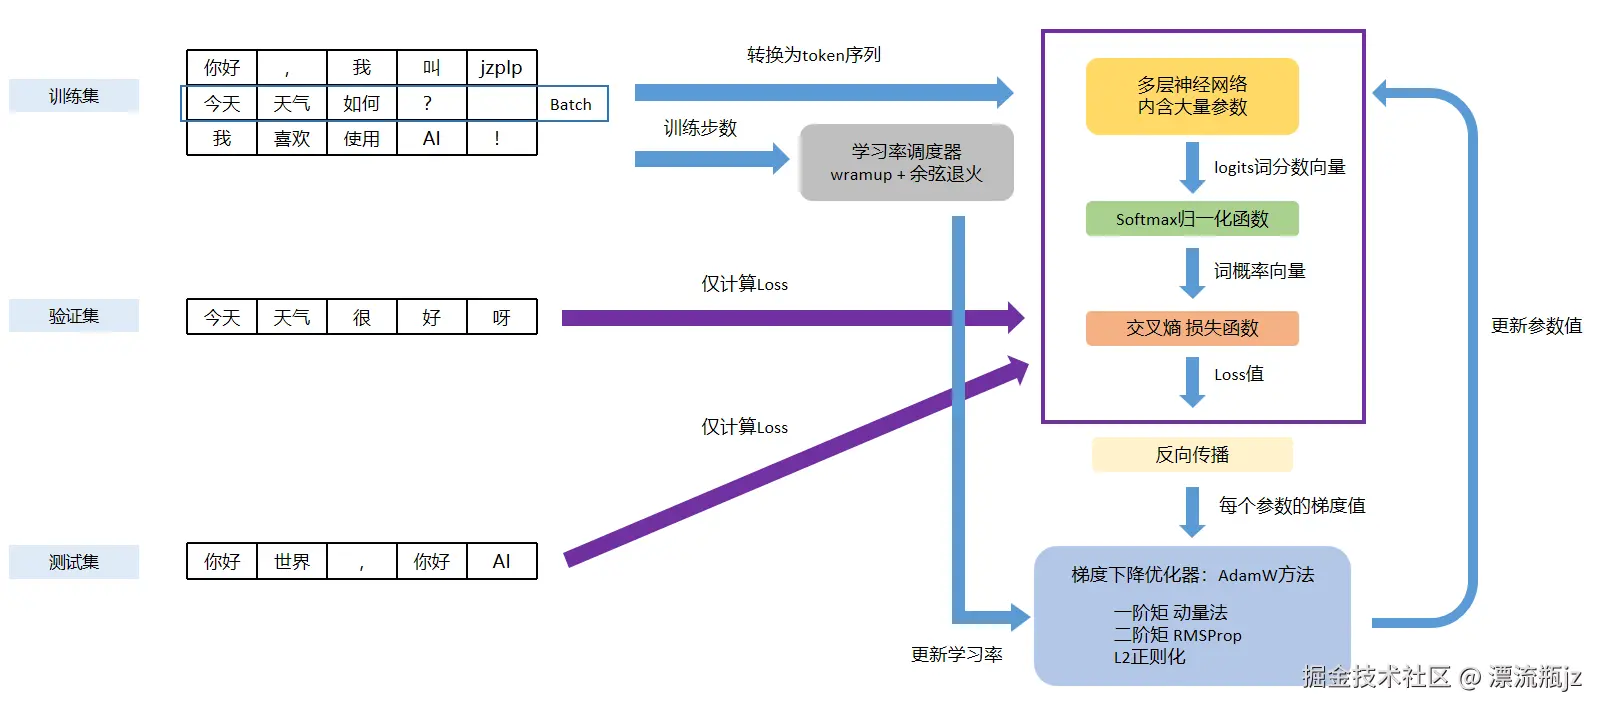
前面我们详细了解了大模型参数更新的步骤和其中的原理,为了方便理解,这里我们再对前面的流程进行梳理,汇总一个流程图:
数据集划分为:训练集,验证集,测试集。其中训练集用来更新参数,验证集测试集只计算Loss。
模型首先经过多层神经网络处理(本文并未探讨这一部分),输入为一个batch,输出为logits向量。
logits向量经过Softmax归一化为概率向量。
通过损失函数(这里使用交叉熵),得到Loss值。
通过反向传播,计算出参数对Loss值的偏导数,即梯度值。
通过梯度下降优化器(这里使用AdamW)更新参数值。
使用学习率调度器(这里使用warmup+余弦退火)随着时间更新学习率的值,影响优化器的计算结果。
重复上述训练过程,同时观察验证集的val loss,判断何时停止训练。
总结
本篇文章虽然只是描述了大模型中参数训练原理和流程,仅仅是大模型原理的一小部分,但实际上也是一个很大的主题。中间提到的损失函数,梯度,优化器,学习率调度器等,都只讲了一些基础和常用的某个方法,事实上这其中的每个主题都可以展开讲,都包含很多类型的方法,在不同的场景适用。
本篇文章也是我第一次接触大模型原理,之前听很多人说大模型是不可解释的,但看到文章中这些方法和流程,实际上全都是数学知识。不过虽然是数学,但也不怎么难,基本也就是大学高等数学的水平。当然可能部分比较难的公式和内容我忽略了没有讲,因为理解这些对于原理来说已经足够了,不能一开始希望把所有东西都搞懂,否则会遇到太多困难和挫折。要循序渐进的学习。
有很多人,包括我上学的时候,遇到题解中某些步骤是"略"或"显而易见",但我却推导不出来时,是很苦恼的。因此我倾向于把计算过程都展示出来(在不限制文章长度的情况下)。甚至有可能我自己现在懂,但是后面再看的时候,这些省略的内容我自己也推导不出来了。另外大模型或者深度学习是一个实验学科,即搞清楚原理是一回事,代码实现是一回事,能不能通过实验得到好结果是另一回事。
参考