本文是通俗实战版。保留全部工程精华、性能实测对比与跨框架(原生 JS / Vue 3 / React)开箱即用代码,8 分钟即可读完并直接落地到项目中。
一、为什么不能等 JSON 吐完再解析?
做普通 AI 聊天时,模型吐出的是纯文本或 Markdown,前端收到一个字就往屏幕上追加一个字(打字机效果)。
但现在越来越多的 AI 功能要求模型直接返回 JSON 结构化数据,让前端渲染成交互组件:
| 典型业务场景 | 模型输出的 JSON 结构 | 边收边渲染带来的体验提升 |
|---|---|---|
| 商品 / 知识卡片 | { title, summary, price, tags } |
标题先跳出来,摘要逐字填充,不用盯着空白卡片干等 |
| 流式数据表格 | { columns, rows: [...] } |
表格一行接一行"长"出来,长表格首屏等待时间缩短 80% |
| 智能表单填充 | { name, phone, address } |
表单项逐个自动回填,用户能实时看到 AI 正在填哪一格 |
| Agent 工具调用 | tool_calls[].function.arguments |
OpenAI 兼容接口的流式工具参数天生就是半截 JSON 碎片,边收边解析才能显示"正在搜索:xxx" |
模型生成一段完整的 JSON 往往需要几百个 Token、耗时 5~15 秒。如果傻等到最后一个 } 才调用 JSON.parse(),用户就得对着白屏干等十几秒------流式传输也就失去了意义。
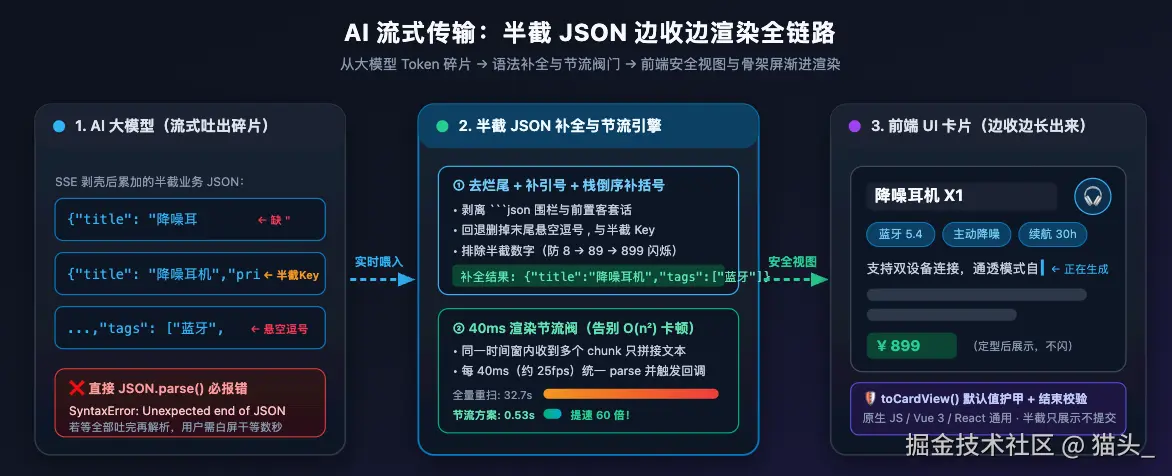
要在模型只吐出"半截 JSON"时就实时渲染 UI,全链路其实只需要闯过三关:
二、先避坑:流式接口里有"两层 JSON",别混为一谈
很多刚接触流式开发的同学会问:"我在写 SSE 流式接收时,不是已经用 buffer 处理过半截 JSON 了吗?"
其实在流式结构化输出里,存在外层信封 和内层业务数据两层完全不同的 JSON:
plain
外层(SSE 信封 JSON,一行一条,几毫秒就完整):
data: {"choices":[{"delta":{"content":"{\"title\":"}}]}
data: {"choices":[{"delta":{"content":"\"降噪耳"}}]}
data: {"choices":[{"delta":{"content":"机\"}"}}]}

内层(把所有 delta.content 拼起来的业务 JSON,要好几秒才完整):
第 1 刻:{"title":
第 2 刻:{"title":"降噪耳
第 3 刻:{"title":"降噪耳机"}
这两层的处理策略截然不同:
| 维度 | 外层:SSE 传输信封 | 内层:业务内容 JSON(本文主角) |
|---|---|---|
| 长什么样 | {"choices":[{"delta":{"content":"降噪"}}]} |
所有 content 累加拼出的 {"title":"降噪耳机",...} |
| 多久能凑齐 | 收到换行符 \n 就齐了(通常几毫秒) |
模型吐完最后一个 Token 才齐(几秒到几十秒) |
| 处理方式 | 用 buffer 按 \n 切行,凑齐一行再 JSON.parse |
不能干等:必须把半截字符串临时"补全"成合法 JSON |
浏览器原生的 JSON.parse 是个"全有或全无"的严格解析器------只要末尾少一个引号或括号,它立刻抛 SyntaxError,绝不会把前面已经解析好的字段还给你:
javascript
JSON.parse('{"title":"AI 周');             // ❌ SyntaxError: Unterminated string
JSON.parse('{"title":"AI 周报","items":['); // ❌ SyntaxError: Unexpected end of JSON input
JSON.parse('{"ok":tr');                    // ❌ SyntaxError: Unexpected end of JSON input
所以在整个生成过程中,除了最后一刻,直接调 JSON.parse 100% 会失败。我们需要一个**"尽力而为"的补全器**。
三、核心原理:半截 JSON 是怎么被"补"出来的?
生产环境里我们直接调用成熟小库(如 partial-json),但花 2 分钟看懂它的原理,你就能明白为什么有些字段会提前出现、有些字段会被暂时丢弃。
模型可能在任意字符处停下,补全器的工作其实就是**"去烂尾、补引号、补括号"**三步:
| 断在哪里 | 当前收到的半截文本 | 补全策略 | 补全后的合法 JSON |
|---|---|---|---|
| 字符串值中间 | {"title":"AI 周 |
补右引号 " + 补右括号 } |
{"title":"AI 周"}(文字可逐字展示) |
| 转义符中间 | {"text":"中\u4e |
削掉未完成的 \u4e,再补 "} |
{"text":"中"}(防非法转义报错) |
| 半截 Key | {"title":"周报","ite |
Key 没写完毫无意义,回退删掉 "ite,再补 } |
{"title":"周报"} |
| 有 Key 没 Value | {"title":"周报","items": |
回退删掉悬空的 "items":,再补 } |
{"title":"周报"} |
| 尾逗号 | [{"name":"A"}, |
删掉末尾悬空的 ,,再补 ] |
[{"name":"A"}] |
| 半截布尔 / null | {"ok":tr |
t 开头只可能是 true,顺手补全再补 } |
{"ok":true} |
计算机是怎么知道最后该补 ]} 还是 }]} 的?答案是一个简单的栈(Stack):
- 记引号状态 :从头扫描字符,遇到未转义的
"就切换"是否在字符串内"的状态; - 记括号栈 :在引号外部,每遇到
{就往栈里记一个},遇到[就记一个];遇到闭合的}或]就消掉栈顶那一个; - 截断并补齐 :需要渲染时,先把末尾悬空的逗号、冒号或半截 Key 削掉;如果停在字符串值中间就补一个
";最后把栈里剩下的括号倒序拼到末尾。
下面这 35 行极简代码就能跑通核心流程(帮你吃透原理的演示版):
javascript
function miniCompleteJson(partialStr) {
  let inString = false;
  let escaped = false;
  const closers = []; // 栈:记录还欠哪些闭合括号

  for (const ch of partialStr) {
    if (inString) {
      if (escaped) escaped = false;
      else if (ch === '\\') escaped = true;
      else if (ch === '"') inString = false;
      continue;
    }
    if (ch === '"') inString = true;
    else if (ch === '{') closers.push('}');
    else if (ch === '[') closers.push(']');
    else if (ch === '}' || ch === ']') closers.pop();
  }

  let fixed = partialStr;
  // 1. 如果停在字符串内部:先去掉末尾可能悬空的反斜杠,再补双引号
  if (inString) {
    if (escaped) fixed = fixed.slice(0, -1);
    fixed += '"';
  }
  // 2. 削掉末尾悬空的逗号、冒号或刚写了一半的 key(如 ,"pri 或 ,"price":)
  fixed = fixed.replace(/,\s*"[^"]*"?\s*:?\s*$/, '').replace(/[,:\s]+$/, '');
  // 3. 倒序补齐所有未闭合的括号
  return fixed + closers.reverse().join('');
}

// 实测效果:
console.log(miniCompleteJson('{"title":"降噪耳机","tags":["蓝牙",'));
// => '{"title":"降噪耳机","tags":["蓝牙"]}'
console.log(miniCompleteJson('{"title":"降噪耳机","pri'));
// => '{"title":"降噪耳机"}'
四、前端落地三板斧:不报错、不跳动、不卡顿
能解析出半截对象只是第一步。如果直接把半成品丢给页面渲染,往往会遇到组件白屏报错、数字疯狂闪烁、长 JSON 越滚越卡三大问题。
第一板斧:给半成品套一层"默认值视图函数"(防报错)
流式传输刚开始时,解析出来的可能是 {},下一秒是 { title: "降噪" },数组 specs 还是 undefined。如果在模板里直接写 data.specs.map(...),第一帧就会报错崩溃。
标准做法 :写一个纯函数 toCardView,把"任何字段都可能缺"的半成品,转换成结构固定的安全对象:
javascript
export function toCardView(partial) {
  return {
    title: typeof partial?.title === 'string' ? partial.title : '',
    summary: typeof partial?.summary === 'string' ? partial.summary : '',
    // ⚠️ 注意:价格还没生成出来时一定要给 null(显示骨架屏),别给 0(否则用户会以为商品免费!)
    price: typeof partial?.price === 'number' ? partial.price : null,
    tags: Array.isArray(partial?.tags)
      ? partial.tags.filter((t) => typeof t === 'string')
      : [],
    specs: Array.isArray(partial?.specs)
      ? partial.specs.map((s) => ({ label: s?.label ?? '', value: s?.value ?? '' }))
      : [],
  };
}
第二板斧:管住"不稳定"的数字与高度(防闪烁跳动)
流式卡片最影响观感的就是画面乱跳,记住这四条实战经验:
- 拒绝半截数字闪烁(
8→89→899) : 字符串逐字出现很自然,但价格如果从¥8变成¥89再变成¥899,看起来就像 Bug。用partial-json解析时,只要排除Allow.NUM(只允许字符串、对象、数组处于半截状态),解析器就会等数字后面的逗号或括号出现、数字彻底定型后才返回该字段! - 判断字段是否已写完(加打字光标) : 既然 JSON 是按顺序生成的,只要后面的字段已经出现(或者流已结束),前面的字段就一定写完了。我们可以据此给"正在生成的最后一个字段"加上闪烁光标样式。
- 固定高度 + 骨架屏占位 : 标题、价格区域提前用 CSS 占好最小高度,值为空或
null时显示灰色骨架条(Skeleton),避免文字填入瞬间把整张卡片撑高一截。 - Schema 字段顺序设计(先短后长) : 大模型会严格按照你在 Prompt 或 Structured Outputs Schema 中定义的字段顺序输出。把
title、price等短字段放在最前面,把长文本summary放在后面,卡片骨架 1 秒内就能立住。
在控制台观察一帧一帧的真实产出,数据是这样"长"出来的:
plain
帧  1: { title: "降噪耳",       summary: "",                 price: null, specs: [] }
帧  3: { title: "降噪耳机 X1",  summary: "主动降噪,续航 30", price: null, specs: [] }
帧  5: { title: "降噪耳机 X1",  summary: "主动降噪,续航 30 小时", price: 899, specs: [] }
帧  9: { title: "降噪耳机 X1",  summary: "...",              price: 899,  specs: [{ label: "重量", value: "250g" }] }
第三板斧:节流更新,别让解析退化成 O(n2)(防卡顿)
大模型吐 Token 极快,10 毫秒内可能连发四五个 chunk。如果每收到一个 chunk 就立刻全量补全 + JSON.parse + 刷新 UI,当 JSON 达到几十 KB(例如长表格)时,页面会越来越卡。
在一份 107 KB(1500 行表格,约 2.7 万个 chunk)的真实基准测试中,不同策略的耗时差距高达 60 倍:
| 解析与渲染策略 | 2.7 万个 chunk 总耗时 | 为什么差这么多? |
|---|---|---|
A. 每个 chunk 都重头扫描 + JSON.parse |
约 32.7 秒 | 每次都把前面攒下的几万字重扫一遍,工作量呈平方级( O(n2))爆炸 |
B. 增量扫描,但每个 chunk 都 JSON.parse |
约 8.3 秒 | 扫描快了,但 27000 次 JSON.parse 依然吃满 CPU |
| C. 按帧/定时节流(每 50 个 chunk 解析一次) | 约 0.53 秒 | 解析次数从 27000 次降到 500 多次,丝滑不掉帧 |
所以在前端落地上,千万不要在 reader.read() 循环里直接调 parse 和更新状态,而是加一道节流阀:
- 动画敏感型(普通卡片) :用
requestAnimationFrame对齐屏幕刷新率(60Hz 下约 16ms 最多解析渲染一次); - 重组件 / 虚拟DOM框架(React / Vue 大表格) :如果觉得每秒 60 次组件重渲染还是太频,可以直接用 50ms ~ 80ms 的定时器节流(每秒只更新 12~20 次),人眼看起来依然非常连贯,而框架重渲染开销直接再降 70%。
五、开箱即用:纯 JS 核心 + 原生 / Vue / React 接入
为了让代码在任何项目里都能直接复制使用,我们把逻辑拆成两层:
- 底层核心函数(纯 JavaScript,零框架依赖) :负责流读取、剥离代码围栏、节流解析与结束校验,通过
onUpdate回调吐出数据; - UI 接入层:无论你用原生 DOM、Vue 3 还是 React,都只需要不到 10 行代码就能接上。
5.1 核心流式解析函数(纯 JS,框架无关)
先安装轻量库:npm i partial-json
javascript
// partialStream.js ------ 纯 JS 实现,可在原生、Vue、React、小程序中通用
import { parse, Allow } from 'partial-json';
import { toCardView } from './cardView.js';

/**
 * 找到 JSON 正文起点:兼容模型在开头输出 "好的,结果如下:" 或 ```json 围栏
 */
function extractJsonBody(raw) {
  const fenceMatch = raw.match(/```(?:json)?\s*\n?([\s\S]*)/i);
  if (fenceMatch) {
    return fenceMatch[1].replace(/\s*```\s*$/, '');
  }
  const firstBracket = raw.search(/[{[]/);
  return firstBracket === -1 ? '' : raw.slice(firstBracket);
}

/**
 * 消费流式 JSON 文本,按指定间隔节流产出安全的视图对象
 * @param {ReadableStream} body - fetch 响应的 response.body
 * @param {(state: { data: any, done: boolean }) => void} onUpdate - 状态回调
 * @param {number} throttleMs - 节流间隔(默认 40ms,约 25fps,兼顾流畅度与框架性能)
 */
export async function consumePartialJson(body, onUpdate, throttleMs = 40) {
  const reader = body.pipeThrough(new TextDecoderStream()).getReader();
  let rawText = '';
  let timerId = null;

  const flush = () => {
    timerId = null;
    const jsonCandidate = extractJsonBody(rawText);
    if (!jsonCandidate.trim()) return;

    try {
      // 只允许字符串、对象、数组处于半截状态;排除 Allow.NUM 防止数字闪烁
      const partialObj = parse(jsonCandidate, Allow.STR | Allow.OBJ | Allow.ARR);
      onUpdate({ data: toCardView(partialObj), done: false });
    } catch {
      // 刚收到一两个字符尚无法解析时,静默跳过等下一拍
    }
  };

  while (true) {
    const { done, value } = await reader.read();
    if (done) break;

    rawText += value; // 若后端是标准 SSE,这里改为提取出的 delta.content 即可
    if (timerId === null) {
      timerId = setTimeout(flush, throttleMs);
    }
  }

  // 流结束:清理定时器,用原生 JSON.parse 做最终完整性校验
  if (timerId !== null) clearTimeout(timerId);
  const finalJson = extractJsonBody(rawText).replace(/}\s*[^}]*$/, '}');
  const finalObj = JSON.parse(finalJson); // 若中途断流不完整,这里会如实抛错进入上层 catch
  onUpdate({ data: toCardView(finalObj), done: true });
}
💡 为什么这里默认用了
setTimeout(..., 40)而不是固定死requestAnimationFrame? 在原生 DOM 里用rAF(约 16ms 一次)很轻快;但在 React / Vue 等框架中,16ms 触发一次响应式更新意味着每秒要走 60 次组件重渲染(Diff)。设为 40ms ~ 50ms 节流(每秒更新 20~25 次),肉眼看打字机依然丝滑,同时能把 React / Vue 的渲染负担降低 60% 以上。
5.2 三端接入示例(任选其一)
有了上面的 consumePartialJson,在任何技术栈里接入都只需要几行:
写法 A:原生 JS(直接操作 DOM)
javascript
const titleEl = document.querySelector('#card-title');
const summaryEl = document.querySelector('#card-summary');
const priceEl = document.querySelector('#card-price');

async function start() {
  const res = await fetch('/api/product-card', { method: 'POST' });
  await consumePartialJson(res.body, ({ data, done }) => {
    titleEl.textContent = data.title || '标题生成中...';
    summaryEl.textContent = data.summary;
    priceEl.textContent = data.price !== null ? `¥${data.price}` : '价格计算中...';
  });
}
写法 B:Vue 3(Composition API)
vue
<script setup>
import { ref } from 'vue';
import { consumePartialJson } from './partialStream';
import { toCardView } from './cardView';

const card = ref(toCardView({}));
const isDone = ref(false);

async function generate() {
  const res = await fetch('/api/product-card', { method: 'POST' });
  await consumePartialJson(res.body, ({ data, done }) => {
    card.value = data;
    isDone.value = done;
  });
}
</script>
写法 C:React(Hooks)
jsx
import { useState } from 'react';
import { consumePartialJson } from './partialStream';
import { toCardView } from './cardView';

export function ProductCard() {
  const [state, setState] = useState({ data: toCardView({}), done: false });

  async function generate() {
    const res = await fetch('/api/product-card', { method: 'POST' });
    await consumePartialJson(res.body, setState);
  }
  // 下面正常渲染 state.data 即可
}
六、工具怎么选?一张表对号入座
不用纠结重复造轮子,按你的项目情况直接选:
| 你的场景 | 推荐方案 | 特点与适用理由 |
|---|---|---|
| 常规前端项目(自建 SSE / Fetch 流) | partial-json |
零依赖、体积小,支持通过 Allow 位掩码关掉半截数字防闪烁。 |
| 模型不听话,爱输出单引号、注释、尾逗号 | jsonrepair |
容错能力极强,不仅能补全截断,还能把各种不规范的"坏 JSON"修成标准格式。 |
| Next.js / React 全栈项目(已用 AI SDK) | Vercel AI SDK (streamText + Output.object) |
前后端一体,配合客户端 useObject Hook 自动搞定补全、节流和 Schema 校验。 |
| 超大 JSON、几千行的流式列表 | @streamparser/json |
事件驱动的真正 O(n) 解析器,每当数组里有一个元素完整闭合就回调一次,完全不重扫前文(代价是拿不到半截字符串)。 |
七、上线前必看的 3 条生产安全底线
半截 JSON 补全出来的对象"长得很像完整数据",这在生产环境里最容易埋雷。上线前务必检查这三件事:
- 半截数据"只做展示,绝不提交" : 网络中断、用户点击"停止生成"、或者模型触发最大长度截断(
finish_reason: "length")时,补全器依然会给你一个合法的 JSON 对象,但里面少了一半字段。写数据库、提交表单、触发下一步业务接口,必须以done === true且通过原生JSON.parse(或zod.safeParse)完整校验为唯一标准。 - Agent 工具调用参数在完整前绝不执行 : 假设模型正在生成删除目录的工具调用,半截参数
{"path": "/data补全后是合法的{"path": "/data"},但模型原本要写的是/data/tmp/cache。流式阶段解析出的参数只能用于 UI 预览 (例如显示"正在准备清理目录:/data..."),真正执行工具必须等流结束并校验通过。 - 警惕结构化字段里的恶意链接与 XSS : 结构化不等于安全。如果卡片包含
link、avatar等 URL 字段,渲染到<a href={link}>前必须校验协议是否为https://,防止模型被诱导输出javascript:alert(1)伪协议;普通文本字段坚持走文本插值(如textContent、{{ title }}、{title}),不要直接塞进innerHTML/v-html。