📌 编者按 · 先看这段再往下划
一句话说清这篇文的价值:如果你正在用 MySQL 做知识库问答,或者 RAG 上线后效果拉胯,这篇能帮你少走至少半年的弯路。
两年前,我用 MySQL 给公司搭企业知识库,10 万条数据搜一次 800ms,准确率 42%------用户问"报销超期咋办",库里写的是"票据遗失补办流程",一个字都不重合,命中率直接归零。上线两周,废了。
后来换成向量数据库 + RAG 重做:同样的数据,检索从 800ms 干到毫秒级,准确率从 42% 拉到 96.5% 。这道题现在是大厂面试高频题 ,面试官想听的就四件事------原理理解、选型判断、工程深度、落地能力,本文全覆盖。
🎯 这篇文章你会拿走什么
🔥 4 个炸裂的真实数据
- MySQL 10 万条
LIKE:800ms / 42% → 专用向量库 10 亿条:38ms / 96.5%(差两个数量级,反而快 20 倍) - 纯向量召回的精确字符串查询(CVE 编号、错误码、订单号)直接失明 ,混合检索召回 +30%
- 加 Rerank 精排:答案准确率 62% → 84%
- 一次"召回饿死"事故:小租户请求 10 条,实际返回 0 条------根因是过滤写在了应用层
🛠️ 6 大生产级硬核模块(全带可跑 Java 代码)
- 选型决策树:有 PG 用 pgvector、没 PG 用 Qdrant、亿级才上 Milvus(附口诀和 TCO 对比)
- 分块成熟度 5 级阶梯 :
chunk_size=400 / overlap=50的实测基线,父子块、语义分块、Late Chunking 全拆解 - 入库流水线:批量+缓存+限流+归一化,MySQL 唯一事实源 + CDC 异步双写 + 增量更新
- 索引玄学破解 :HNSW/IVF/PQ 三个比喻讲透,
M=24 / efConstruction=256 / efSearch=128压测经验值 - 混合检索 :RRF 融合为什么不能比分数量纲(
k=60、排名从 1 开始这种坑都标了) - 多租户权限 :后过滤 / 前置过滤 / 迭代过滤三模式对比,过滤必须下推的铁律
💡 15 个生产难点速查表 + 8 条高频面试追问钩子 + 一页速记卡------建议直接收藏,架构评审和面试前翻一遍。
👥 这篇写给谁
- 正在做企业知识库 / 智能客服 / 文档问答的 Java 后端
- RAG 上线了但效果不行,被业务方追着问"为什么答不准"的同学
- 准备跳槽,想拿下大厂 AI 应用岗面试的工程师
- 手里只有 MySQL 和 PG、不想一上来就部署 Milvus 的务实派
不适合 :想找"三行代码跑通 RAG Demo"的------那种文章满大街都是,这篇讲的是能扛住生产流量的那条链路。
🎁 读到最后的两个理由
⏱️ 全文约 1.2 万字,建议先收藏再读。 核心结论我提炼成了文末「一页速记」,时间紧的直接滑到最后,但第九章那次召回饿死事故,劝你别跳过------那是拿线上故障换来的。
觉得有用,点赞 + 在看 + 收藏三连,就是对我最大的支持。关注我,下一篇《高并发下向量数据库的压测与调优》,HNSW 调参和 Milvus 运维细节全部展开。
👇 正文开始,系好安全带。
别再死磕 MySQL 了:向量数据库与 RAG 生产落地实录(Java 工程师专场)
两年前我接了个小项目:给公司做个企业知识库问答。图省事,第一版直接用 MySQL 存文档,LIKE 查询加全文索引,上线两周就废了------10 万条数据搜一次要 800ms,准确率只有 42%。用户问"报销超期了咋办",库里写的是"票据遗失补办流程",一个字都不重合,命中率为零。
后来换成向量数据库 + RAG 重做,同样的数据,检索降到毫秒级,准确率拉到 96.5%。这篇文章把中间完整的链路、踩过的坑、生产验证过的代码全部整理出来。这道题这两年大厂面试出现频率极高,面试官想听的无非四件事:原理理解、选型判断、工程深度、落地能力------本文全覆盖,适合想把 RAG 真正做进生产的 Java 工程师。
一、MySQL 这次为什么难受
先看一个真实场景
用户问:"手机充不进电怎么办?"
你的知识库里有一篇《充电接口接触不良排查》。LIKE '%充不进电%' 去查,一个关键词都不重合,直接返回空。这还不是最糟的,用户还会问"充不进电咋整""电池不耐用了""电源没反应"------你 LIKE 写得完吗?
根因一句话:MySQL 解决的是"精确匹配",知识问答要的是"语义相似",这是两种完全不同的检索范式。
| 维度 | MySQL(LIKE / 全文索引) | 向量数据库 |
|---|---|---|
| 匹配原理 | 字面 / 分词重合 | 语义距离(余弦 / 内积) |
| 同义改写、口语化 | 完全失效 | 天然支持 |
| 检索方式 | 精确匹配、范围查询 | 近似最近邻(ANN) |
| 100 万条性能 | 全表扫描,秒级~分钟级 | 毫秒级召回(p99 < 50ms) |
ORDER BY 相似度 LIMIT K |
只能全表扫描 | HNSW / IVF 索引加速 |
| 数据形态 | 结构化行数据 | 768 / 1024 / 1536 维浮点向量 |
| 定位 | OLTP 事务主库 | 语义检索专用引擎 |
B+ 树为什么救不了
MySQL 的 B+ 树靠"全序"吃饭:数字能比大小,字符串能按字典序排,索引才能加速。
但 1024 维向量是 [0.12, -0.87, 0.33, ...] 这样的浮点数组,你没法定义"谁比谁大";而且两个浮点向量完全相等的概率约等于 0,等值哈希也表达不了"相近"。这就是所谓的维度灾难------传统低维索引结构在高维空间里会逐渐失效。
算一笔账,你就懂了
暴力检索的复杂度是 O(N × d):
- 100 万条 × 1024 维,单次查询 ≈ 10 亿次乘加,约 20 亿次浮点运算;
- 1 亿条 × 128 维,光向量就要 51.2GB(128 × 4 字节 × 1 亿)。
数据只有几万条时,for 循环挨个算余弦相似度快得很,你会误以为架构已经完工;等知识库灌进几百万个 chunk,单次查询两三秒,并发一上来内存直接爆。
这就是向量数据库存在的意义:它解决的不是向量的"存",而是向量的"索引"。
MySQL 的三个硬伤
实际开发中我们经常遇到这三个问题,一个比一个致命:
硬伤一,存储别扭。 768 维 float 向量只能塞 BLOB 字段,单条 3KB,千万级数据光向量就占几十 GB,还没有原生压缩手段。
硬伤二,检索巨慢。 余弦相似度、欧氏距离这类计算,MySQL 只能全表扫描逐条算。百万级延迟破秒,千万级分钟起步,在线实时检索?不存在的。
硬伤三,混合查询直接崩。 真实业务经常要"按分类过滤 + 向量召回",先过滤再逐条算,或者全算完再过滤,无论哪种,性能都雪崩。
我们内部的压测数据更直观:10 万条 FAQ,MySQL
LIKE查询 800ms、精度 42%;ES + 分词 120ms、精度 71%(还得人工配同义词);专用向量库在 10 亿条规模下做到 38ms、精度 96.5%。数据量差两个数量级,速度反而快 20 倍------这就是专业工具的降维打击。
说句公道话:MySQL 也在追
MySQL 并非原地踏步。从 9.0 开始它原生支持 VECTOR 类型,官方还给了一条用 SQL 做 RAG 的路:
| 能力 | 起始版本 | 社区版可用 |
|---|---|---|
VECTOR 列(存取 / 格式转换) |
MySQL 9.0 | 可用 |
DISTANCE() 距离计算(余弦/点积/欧氏) |
随 VECTOR 引入 | 基本可用 |
库内嵌入 ML_EMBED_TABLE |
MySQL AI / HeatWave GenAI | 企业版 / 云 |
RAG 问答 ML_RAG |
同上 | 不可用 |
| 混合检索(语义 + 关键词) | HeatWave MySQL 9.5.0 起 | 不可用 |
但这里有个最大的坑:MySQL 的 VECTOR 列不能建向量索引 ,ORDER BY DISTANCE(...) LIMIT k 只能全表扫描。所以它的适用边界很清楚------几万到几十万行可以,上百万行就开始咬人。
再补一个必须说清的现状:MySQL 社区版(8.4 / 9.x)并没有可用的原生向量索引能力,真正的原生向量 + HNSW 检索目前只在 Oracle Cloud 的 HeatWave 上提供。所以"死磕 MySQL"在工程上约等于死磕一个不存在的能力。
正确姿势:分工,而不是替代
踩完坑,我的结论很稳:AI 时代不是 MySQL 被淘汰了,而是它退居二线。
| 能力 | MySQL | 向量数据库 |
|---|---|---|
| 事务一致性 | 强项 | 不是重点 |
| 精确查询 | 强项 | 一般 |
| 权限控制、审计 | 适合 | 依赖设计 |
| 业务主数据 | 适合 | 不适合 |
| 语义检索、相似召回 | 弱 | 强项 |
| 大规模 ANN | 不适合 | 适合 |
真实架构的分工一般是这样:
- MySQL:文档元数据、权限、版本、审计、业务关系
- 对象存储 OSS:原始文件归档
- 向量库:chunk 内容、embedding、检索元数据
- ES:关键词检索、混合检索
- Redis / Kafka:缓存限流、文档变更事件驱动异步索引
- LLM:总结、问答、改写、推理
送大家一句话,面试、架构评审都好用:
大模型是"嘴",向量库是"眼",MySQL 是"门禁"。MySQL 管"能不能看",向量库管"哪里有",大模型管"怎么说"。
分工想清楚了,下一个问题来了:向量库到底选哪个?别急,这一步最容易过度设计。
二、选型:别一上来就干 Milvus
先问自己五个问题
选型之前先把这五个问题想清楚,80% 的方向就定了:
- 数据量能全放内存吗?
- 标量过滤条件的比例有多高?
- 可接受的召回率底线是多少?
- P99 延迟要求是多少?
- Top-K 有多大?
两条技术路线
这是选型的第一性问题:
- 路线 A:专用向量数据库(Milvus / Qdrant / Weaviate / Chroma)。从零为向量检索设计,性能天花板高、向量特性齐全,代价是多维护一套数据库;
- 路线 B:通用数据库 + 向量扩展(pgvector / ES kNN / Redis Vector)。运维成本约等于零、事务一致性天然具备,代价是极限性能不如专用库。
决策树,白板就画这个
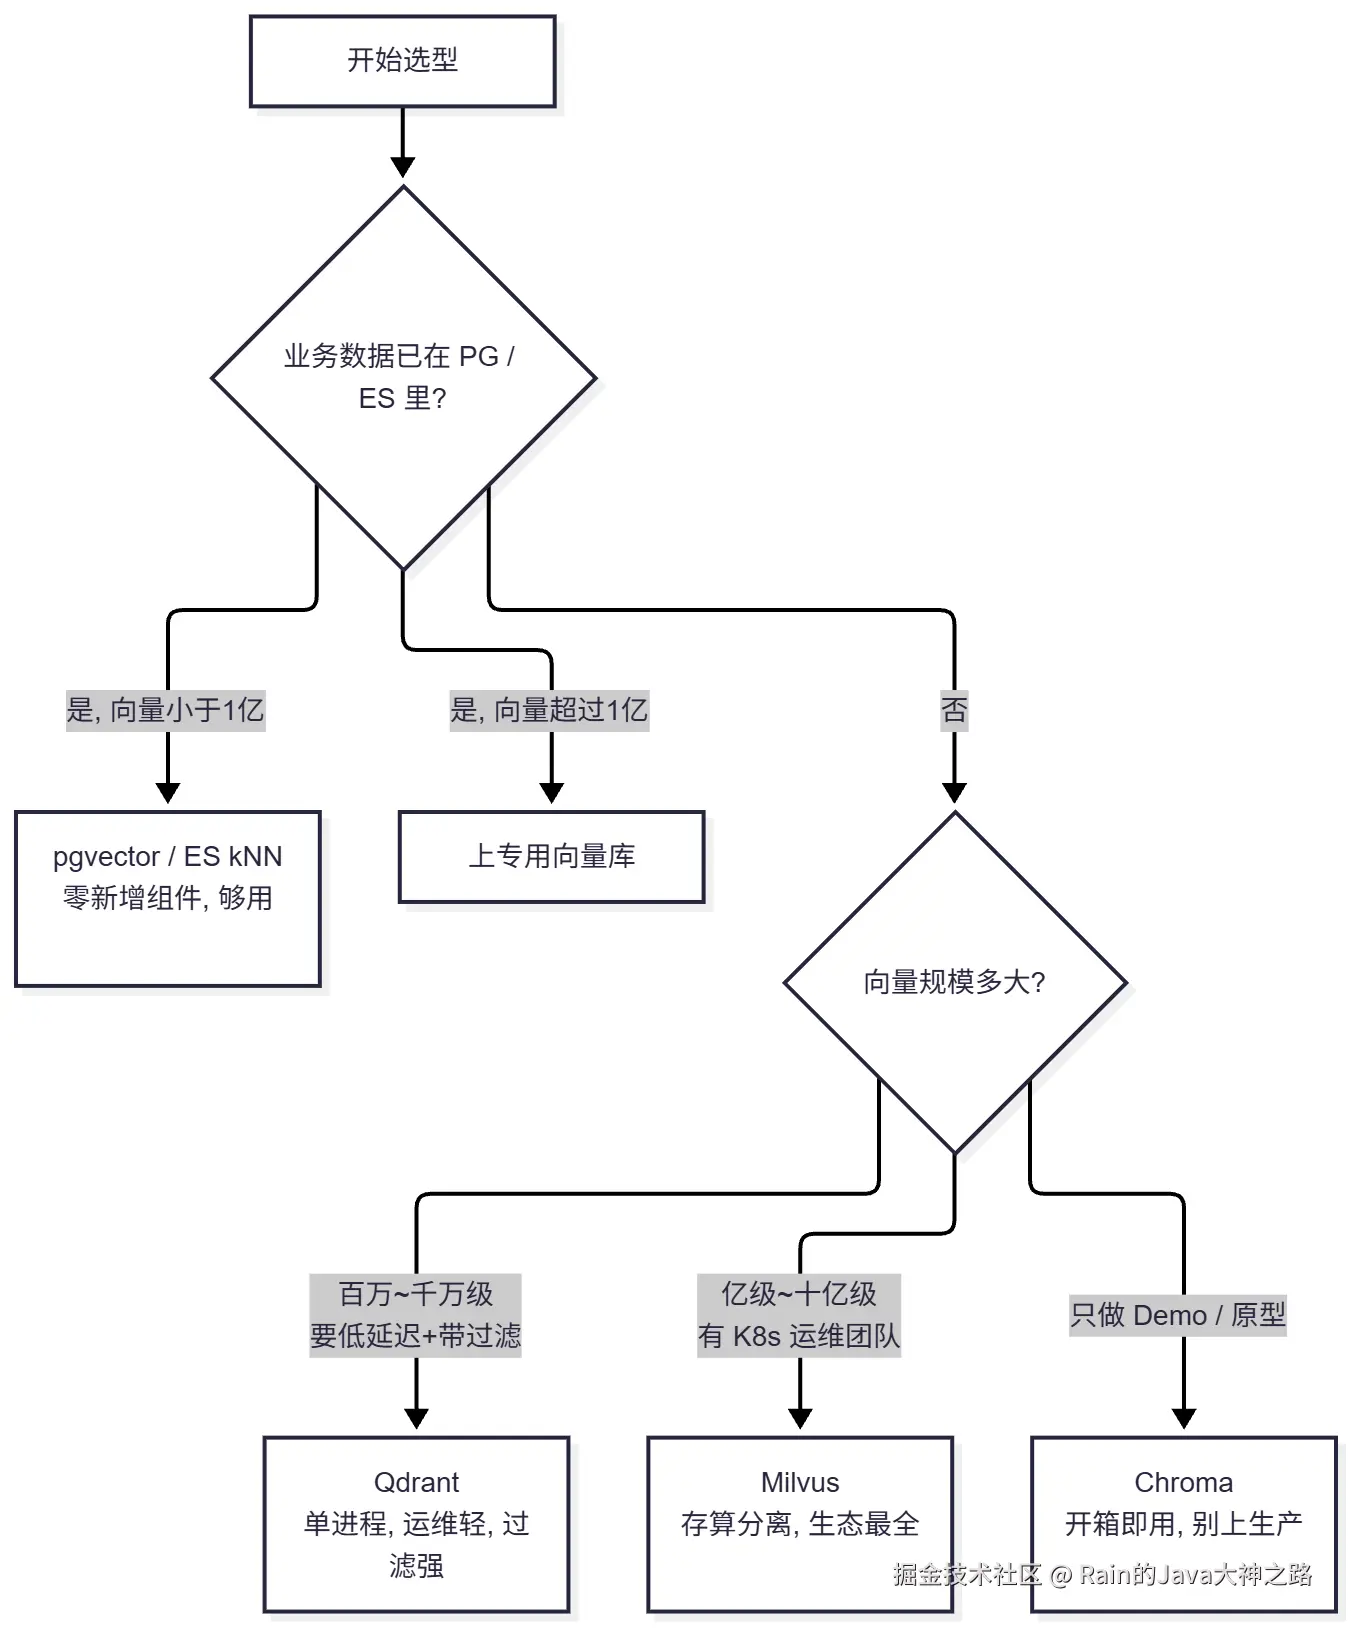
主流方案对比表
| 方案 | 规模上限 | 混合检索 | 运维复杂度 | 适配场景 |
|---|---|---|---|---|
| pgvector | 千万级 | SQL + 全文 | 极低,复用现有 PG 团队 | 已有 PG、想要事务和 JOIN |
| Qdrant | 千万~亿级 | 强 | 低,单二进制 + 内置 Raft | 自托管生产的稳妥默认值 |
| Milvus | 十亿级 | 外接 / 内置 | 中高,依赖 etcd + MinIO + K8s | 亿级向量、高 QPS、有专职运维 |
| ES / OpenSearch | 亿级(贵) | 原生强 | 中 | 已有搜索栈,BM25 + kNN 天然一体 |
| Redis Vector | 百万级 | 有限 | 低 | 内存友好、低延迟小规模 |
| Pinecone / 云厂商托管 | 无硬性上限 | 支持 | 零运维 | 不想碰运维、预算充足 |
两组公开数据供参考(报数据记得加"公开基准"限定词,生产以自己压测为准):
- 千万级、768 维场景:Qdrant P99 约 12
15ms,Weaviate 约 1622ms,Milvus 约 18ms;Milvus 在 2 亿向量下能扛 1.2 万 QPS,P99 85ms。 - 成本侧:百万~千万级场景,pgvector 的三年 TCO 通常比自建 Milvus 低 30%~45%。
我的选型口诀
有 PG 就用 pgvector,没有 PG 就用 Qdrant,真到亿级才上 Milvus。
Milvus 的运维复杂度是劝退级的------没有专职团队,它带来的不是性能,是告警。反过来,如果你的知识库只是几万条内部文档、团队只会 MySQL 和 PG,那 pgvector 就是性价比最高的起点,没必要为了"AI 时代"四个字硬上 Milvus。
再给一个反直觉的结论,建议刻在脑子里:
绝大多数团队在换向量库之前,应该先换 embedding 模型和检索策略。召回率的天花板由 embedding 质量决定,而不是由向量库决定。
这套选型决策树和对比表我整理成了一张速查图,在公众号后台回复"向量选型"就能拿,存起来早晚用得上。
库选好了,真正的硬菜才开始------RAG 的完整链路设计。
三、RAG 全链路:离线与在线两条流水线
先给定义。RAG(Retrieval-Augmented Generation,检索增强生成)不是让大模型凭空回答,而是先从知识库里检索相关资料,再把资料作为上下文交给 LLM 生成答案。
为什么值得做?五个核心价值:降低幻觉、答案可追溯、支持私有知识、不用频繁微调、成本远低于全量 Fine-tuning。
生产级 RAG 分离线和在线两条链路:
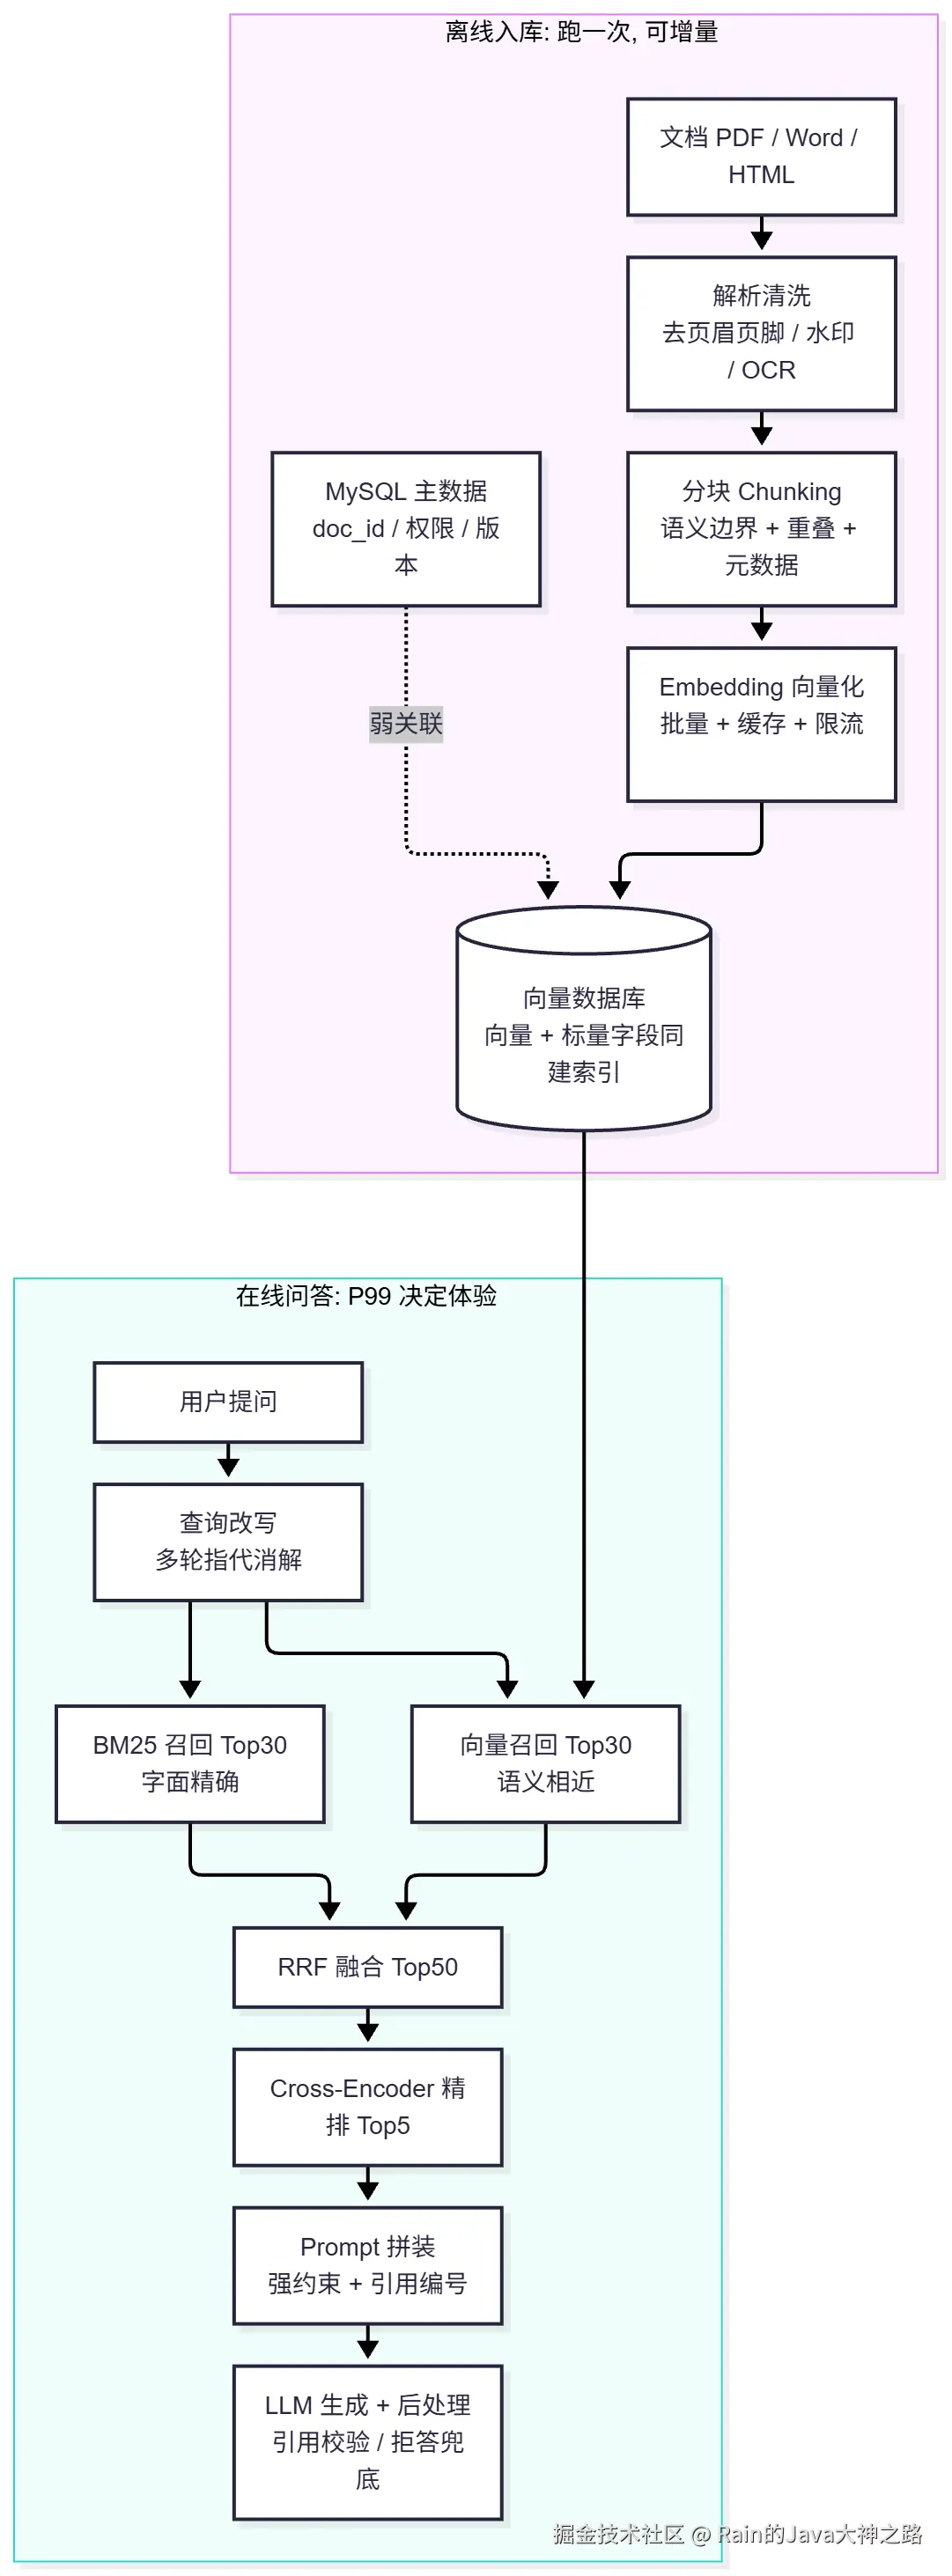
离线链路跑一次、可增量,四步:
- 解析清洗:PDF / Word / HTML 转结构化文本,去页眉页脚、水印、目录,扫描件走 OCR 甚至 VLM;
- 分块:按语义边界切,带 10%~20% 重叠,绑定元数据;
- Embedding:批量向量化,幂等、带缓存;
- 入库 :向量 + 标量字段一起写,标量字段一定要建索引。
在线链路每次提问都走一遍,六步:
- 查询改写:多轮对话指代消解,把"那第二条呢"改写成完整问句;
- 多路并行召回:向量 Top30 + BM25 Top30,并行别串行;
- RRF 融合:按排名融合,不比分数量纲;
- Cross-Encoder 精排:Top50 收敛到 Top5;
- Prompt 拼装:强约束 + 引用编号;
- 后处理:引用溯源校验 + 兜底话术,最终答案带出处。
这里先泼一盆冷水:
很多人以为 RAG 的瓶颈在 LLM,实际上线上七八成的问题出在检索侧------该召回的证据没召回来,LLM 再强也只能编。朴素实现的生产级 RAG,检索失败率能到 40%,模型会一本正经地基于错的文档生成答案。
只想先跑起来?Spring AI 三行版
Java 生态不用羡慕 Python,Spring AI 和 LangChain4j 早就把 RAG 用 Java 的方式封装好了。先看最小可用版:
java
// 只加一个 Advisor,检索增强就接上了
ChatClient chatClient = ChatClient.builder(chatModel)
        .defaultAdvisors(QuestionAnswerAdvisor.builder(vectorStore)
                .searchRequest(SearchRequest.builder()
                        .similarityThreshold(0.8d)   // 相似度门槛,滤掉噪声
                        .topK(6)                     // 召回条数
                        .build())
                .build())
        .build();

String answer = chatClient.prompt()
        .user("报销流程怎么走?")
        .call()
.content();但注意,上面这段代码有个生产隐患:它默认搜全库,多租户场景会串数据。必须加动态过滤表达式,而且过滤要下推到向量库执行,不是在应用层过滤:
java
// 场景:当前用户属于 corp_88,只能看自己的文档
String content = chatClient.prompt()
        .user("报销流程怎么走?")
        .advisors(a -> a.param(
                QuestionAnswerAdvisor.FILTER_EXPRESSION,
                "tenant_id == 'corp_88'"))   // 过滤下推到向量库
        .call()
        .content();
为什么强调"过滤必须下推"?这背后是一次血泪事故,后面多租户章节细讲,先把结论记住。
最小版跑通了,但离生产级还差八道工序。下面逐个环节拆开,先从最容易被低估的分块说起。
四、分块:最"脏"但收益最高的环节
分块是 RAG 里最不起眼的活,却决定了召回质量的上限。分块策略错了,后面所有环节都在加速错误。
分块成熟度阶梯,自查你在第几级
- Stage 0:固定 1000 字符一刀切,无重叠无元数据------教程默认值,也是"RAG 不好用"的万恶之源;
- Stage 1:递归切分 + 10%~20% 重叠 + 基础元数据------及格线;
- Stage 2 :结构感知:按
##标题切、代码按函数切、表格和列表不被切碎,记录完整标题路径; - Stage 3:语义分块(相邻句子余弦相似度骤降处切)+ golden set 评估门禁;
- Stage 4:Late Chunking / Contextual Retrieval(高价值语料)+ 新鲜度联动重切。
参数基线:从这里起步
学术上对分块有一些反直觉的结论,面试时说出来会加分:
| 策略 | 建议 | 依据 |
|---|---|---|
| 固定 token | 512 tokens 起步,overlap 10%~15% | Azure 官方起点 |
| 句子切分 | 优先选它 | 5k tokens 以内与语义切分效果持平,成本最低 |
| overlap | 别无脑加 | 系统性研究发现 overlap 无显著收益,反而增加索引成本 |
| 上下文长度 | 超过约 2.5k tokens 质量下降 | 出现 context cliff,别把整篇文档塞进去 |
我之前踩过这个坑:一开始按 1024 tokens + 20% overlap 切,索引膨胀了 30%,Recall 一点没涨;改成句子边界切分 + 10% overlap 后,索引降了,Recall 反而稳住了。
我们实测收敛的基线是 chunk_size=400 / overlap=50,供参考。大盘数据上,固定长度切分召回率约 70%~80%,递归 / 结构感知切分能到 85%~90%+。
为什么块大小这么讲究
- 切太大 :单块杂质多,稀释信号,学术上叫 context rot(上下文腐化);
- 切太小 :语义被割裂,"它增长了 40%"这种句子单独拿出来根本检索不到,这叫 context cliff(跨块断崖);
- 零重叠:跨边界的事实两边都丢,所以必须留 10%~20% 重叠。
千万别把"营收:"和"100 亿"切到两个块里,那真的是万恶之源。
父子块:小块检索,大块生成
生产上最常用的进阶招式:小块用于召回,命中后回捞它所属的父块用于生成。比如用 300 token 的小块入向量库保召回率,命中后取回 1000~1500 token 的父块喂给 LLM 保上下文完整。召回率和答案质量兼得,代价是架构复杂度上升。
常见分块策略对比
| 策略 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|
| 固定长度 | 通用文本 | 简单 | 容易切断语义 |
| 按段落 | 文章类 | 语义较完整 | 长度不均 |
| 按标题层级 | 帮助文档 | 结构清晰 | 实现复杂 |
| 滑动窗口重叠 | 长文本 | 保留上下文 | 数据量增加 |
| 父子块 | 高质量 RAG | 小块召回大块回答 | 架构复杂 |
| 语义分块 | 主题连贯性要求高 | 相似度骤降处切,语义完整 | 计算成本高 |
进阶招式,能说出来就赢一半
| 招式 | 做法 | 代价 / 收益 |
|---|---|---|
| 语义分块 | 按句子算 embedding,相似度骤降处切块 | 实践者数据显示准确率可提升至 ~71% |
| Late Chunking | 先用长上下文模型编码整篇文档,再对 token 表示切块池化 | BeIR 上 nDCG@10 提升约 2.7%~3.6%,无需额外 LLM 调用 |
| Contextual Retrieval | 每块前置一段 LLM 生成的上下文摘要 | 效果最好,但入库成本显著增加(每块一次 LLM 调用) |
| Pseudo-Instruction | 用文档级摘要指导切分 | 某评测 hits@5:58.4 vs 固定切分 54.5,省掉逐块 LLM 调用 |
代码:递归语义切分器
java
public class SmartTextSplitter {
    // 逐级尝试:段落 → 换行 → 句号 → 空格 → 字符
    private static final List<String> SEPARATORS =
            List.of("\n\n", "\n", "。", "!", "?", " ", "");

    private final int chunkSize;   // 目标块大小
    private final int overlap;     // 块间重叠

    public SmartTextSplitter(int chunkSize, int overlap) {
        this.chunkSize = chunkSize;
        this.overlap = overlap;
    }

    public List<String> split(String text) {
        List<String> chunks = new ArrayList<>();
        recursiveSplit(text, SEPARATORS, 0, chunks);
        return chunks;
    }

    private void recursiveSplit(String text, List<String> seps,
                                int depth, List<String> result) {
        if (text.length() <= chunkSize) {
            if (!text.isBlank()) result.add(text.trim());
            return;
        }
        String sep = seps.get(Math.min(depth, seps.size() - 1));
        String[] parts = text.split(Pattern.quote(sep));

        StringBuilder current = new StringBuilder();
        for (String part : parts) {
            if (current.length() + part.length() > chunkSize
                    && current.length() > 0) {
                result.add(current.toString().trim());
                // 保留 overlap 作为下一块开头,避免跨边界事实丢失
                current = new StringBuilder(current.substring(
                        Math.max(0, current.length() - overlap)));
            }
            current.append(part).append(sep);
        }
        if (current.length() > 0) result.add(current.toString().trim());
    }
}
用 Spring AI 的话更省事,new TokenTextSplitter(300, 60, 5, 10_000, true) 一行搞定,参数依次是块大小、重叠、最小块阈值、单块上限、是否保留分隔符。
结构感知的细节再补几句:按 Markdown ## 标题切、代码按函数切、表格和列表别切碎,每个块记录完整标题路径(比如"第三章 > 第 2 节 > 审批流程")------这些元数据在召回时是宝贝。
还有一个容易忘的点:给每个块带上 chunk_hash(内容 md5)。页眉、模板话术会在多篇文档里重复出现,去重之后既省 embedding 调用,又不污染索引。
块切好了,接下来是向量化和入库------这部分藏着好几个性能命门。
五、入库流水线:向量化、双写与增量更新
Embedding:批量、缓存、限流、归一化
java
@Service
public class EmbeddingService {

    // 本地缓存:同一段文本(页眉/模板)不必重复调 API
    private final Cache<String, float[]> cache = Caffeine.newBuilder()
            .maximumSize(100_000)
            .expireAfterWrite(Duration.ofHours(12))
            .build();

    private final EmbeddingModel embeddingModel;
    private final RateLimiter rateLimiter = RateLimiter.create(50); // 令牌桶,防打爆上游

    /** 分批并行向量化:批内并行,批间限流,失败可断点重跑 */
    public List<float[]> embedAll(List<String> texts) {
        List<List<String>> batches = Lists.partition(texts, 32); // 按 API 上限切批

        return batches.parallelStream().map(batch -> {
            rateLimiter.acquire();
            List<String> miss = batch.stream()
                    .filter(t -> cache.getIfPresent(t) == null).toList();

            if (!miss.isEmpty()) {
                List<float[]> vectors = embeddingModel.embed(miss);
                for (int i = 0; i < miss.size(); i++) {
                    cache.put(miss.get(i), normalize(vectors.get(i)));
                }
            }
            return batch.stream().map(cache::get).toList();
        }).flatMap(List::stream).toList();
    }

    // L2 归一化:归一化后 COSINE 等价于点积,计算更快
    private float[] normalize(float[] vec) {
        double norm = 0;
        for (float v : vec) norm += v * v;
        norm = Math.sqrt(norm);
        float[] result = new float[vec.length];
        for (int i = 0; i < vec.length; i++) {
            result[i] = (float) (vec[i] / norm);
        }
        return result;
    }
}这段代码的技术含量在四个词:批处理 (降 API 往返)、幂等 (可断点重跑)、限流 (保护上游)、缓存(重复文本不重复花钱)。
还有一个极易忽略的坑:度量方式必须和模型训练目标对齐。如果 embedding 模型是按 cosine 训练的,你却用裸 L2 且没归一化,召回质量会直接崩------哪怕索引参数调得再完美也没用。BGE 系列模型必须先 L2 归一化再用余弦相似度。
技术栈与依赖
我们的生产栈:Spring Boot 3.x + Spring AI 1.0(或 LangChain4j)+ Milvus 2.6 / pgvector,Embedding 用 bge-m3 或 bge-large-zh-v1.5(1024 维,中文效果好),OpenAI 的 text-embedding 是 1536 维。注意:维度必须与模型严格一致,写错直接报错。
三条路线的依赖任选其一:
xml
<!-- 路线一:Spring AI(Spring Boot 3.x 首选) -->
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-milvus-store</artifactId>
    <version>1.0.0</version>
</dependency>

<!-- 路线二:LangChain4j -->
<dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-milvus</artifactId>
    <version>0.32.0</version>
</dependency>

<!-- 路线三:Milvus 原生 SDK,控制力最强 -->
<dependency>
    <groupId>io.milvus</groupId>
    <artifactId>milvus-sdk-java</artifactId>
    <version>2.4.0</version>
</dependency>
用 pgvector 的话,一个 yaml 就够:
yaml
spring:
  ai:
    vectorstore:
      pgvector:                 # 千万级以内首选:零新增组件,过滤直接用 SQL
        initialize-schema: true
        index-type: HNSW
        distance-type: COSINE_DISTANCE
        dimensions: 1024        # 与 embedding 模型一致,如 bge-m3
接 Milvus 则是 properties 风格:
properties
spring.ai.vectorstore.milvus.collection-name=knowledge_base
spring.ai.vectorstore.milvus.embedding-dimension=1024
spring.ai.vectorstore.milvus.initialize-schema=true
spring.ai.vectorstore.milvus.index-type=HNSW
spring.ai.vectorstore.milvus.metric-type=COSINE
LangChain4j 的写法也很清爽,声明式配置,不用手写向量计算和 Milvus 原生 API:
java
MilvusVectorStore store = MilvusVectorStore.builder()
        .host("127.0.0.1").port(19530)
        .collectionName("rag_knowledge_base")
        .dimension(1536)                // 与 embedding 模型维度严格一致
        .indexType(IndexType.IVF_FLAT)  // 百万级数据的最优平衡方案
        .metricType(MetricType.COSINE)  // 文本场景用余弦相似度
        .nlist(1024)                    // 聚类中心数,百万级推荐 1024
        .build();

store.addAll(segments);  // 批量写入,自动完成向量化 + ID 生成
文档入库:主数据先落 MySQL
java
@Service
@RequiredArgsConstructor
public class KnowledgeIngestService {

    private final VectorStore vectorStore;
    private final DocMetaMapper docMetaMapper;   // MySQL
    // 父子块思路:小块入向量保召回,命中后回捞父块保上下文
    private final TokenTextSplitter splitter =
            new TokenTextSplitter(300, 60, 5, 10_000, true);

    @Transactional
    public void ingest(MultipartFile file, String tenantId) {
        // 1. 解析:Tika / PDFBox,扫描件走 OCR
        String raw = DocumentParser.parse(file);

        // 2. 分块
        List<Document> chunks = splitter.apply(
                List.of(new Document(raw, Map.of("tenantId", tenantId))));

        String docId = IdUtil.fastSnowflake();
        // 3. 主数据先落 MySQL(状态 = INDEXING),这是事实锚点
        docMetaMapper.insert(new DocMeta(docId, tenantId,
                file.getOriginalFilename(), "INDEXING"));

        // 4. 向量写入:元数据必须带 tenantId / permissions / version
        List<Document> withMeta = chunks.stream()
                .map(c -> Document.builder()
                        .id(docId + "#" + c.getId())
                        .text(c.getText())
                        .metadata("docId", docId)
                        .metadata("tenantId", tenantId)      // 租户隔离
                        .metadata("permissions", "internal") // 权限召回
                        .metadata("version", 1)              // 换模型时灰度用
                        .metadata("chunkHash", DigestUtils.md5Hex(c.getText()))
                        .build())
                .toList();
        vectorStore.add(withMeta);

        // 5. 状态流转为 READY,对外可检索
        docMetaMapper.updateStatus(docId, "READY");
    }
}
几个设计要点:原始文档另存 MySQL / OSS,向量库只存 chunk;删除时先软删主数据,再异步清向量,保证不出现"有向量没权限"的越权窗口。
用 Milvus 原生 SDK 建集合:partition key 是亮点
java
public static void createRagCollection(MilvusServiceClient client) {
    FieldType docId = FieldType.newBuilder()
            .withName("doc_id").withDataType(DataType.Int64)
            .withPrimaryKey(true).build();

    FieldType category = FieldType.newBuilder()
            .withName("category").withDataType(DataType.VarChar)
            .withMaxLength(64).build();

    // 亮点:高频过滤字段设为分区键,多租户数据物理隔离,过滤几乎零开销
    FieldType tenantId = FieldType.newBuilder()
            .withName("tenant_id").withDataType(DataType.VarChar)
            .withMaxLength(64).withPartitionKey(true).build();

    FieldType embedding = FieldType.newBuilder()
            .withName("embedding").withDataType(DataType.FloatVector)
            .withDimension(1024)   // 必须与模型维度一致
            .build();

    client.createCollection(CreateCollectionParam.newBuilder()
            .withCollectionName("rag_knowledge_base")
            .addFieldType(docId).addFieldType(category)
            .addFieldType(tenantId).addFieldType(embedding)
            .build());

    // HNSW 索引:M 控制邻居数,efConstruction 控制建图质量
    client.createIndex(CreateIndexParam.newBuilder()
            .withCollectionName("rag_knowledge_base")
            .withFieldName("embedding")
            .withIndexType(IndexType.HNSW)
            .withMetricType(MetricType.COSINE)
            .withExtraParam(JSON.toJSONString(
                    Map.of("M", 16, "efConstruction", 200)))
            .build());
}
双写一致性:MySQL 是唯一事实源
向量和元数据双写,不一致是常态,一致才是意外。生产上的组合拳:
- MySQL 作为权威数据源,通过 binlog / MQ 异步驱动向量增删,CDC 组件用 Canal 或 Debezium;
doc_id幂等删除,写入失败进重试队列兜底;- 异步对账任务定时校验补全。
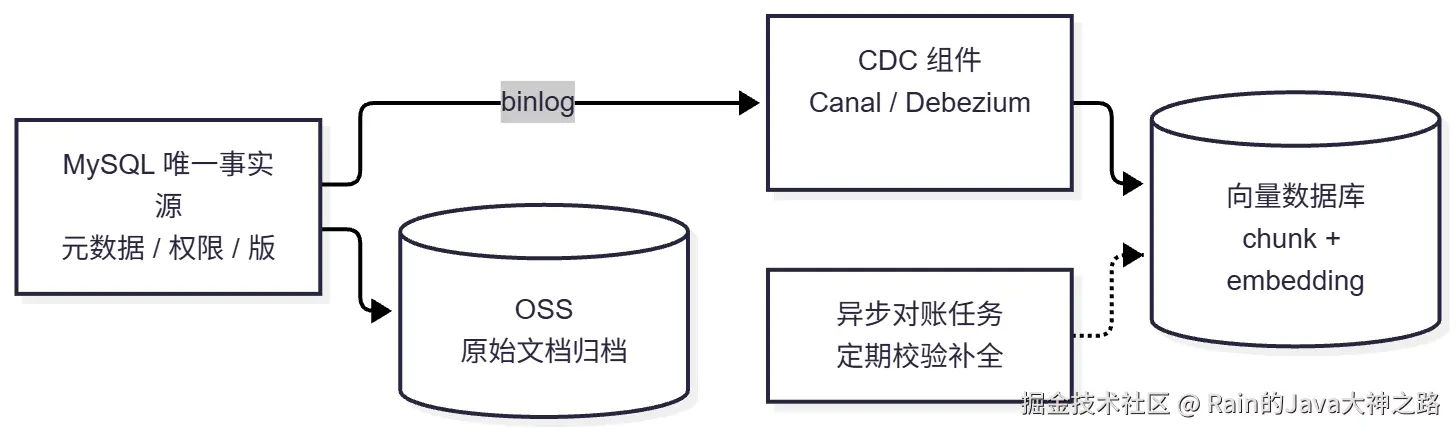
增量更新:别每次都全量重建
java
public void upsertDocument(String docId, String content, String tenantId) {
    String contentHash = DigestUtils.md5Hex(content);
    DocMeta old = docMetaMapper.selectByDocId(docId);

    // 内容没变,直接跳过,一次 embedding 都不浪费
    if (old != null && contentHash.equals(old.getContentHash())) {
        return;
    }
    // 1. 按 docId 删除旧 chunk
    vectorStore.delete("docId == '" + docId + "'");
    // 2. 写入新 chunk
    ingest(docId, content, tenantId);
    // 3. 更新 MySQL 的 hash
    docMetaMapper.updateHash(docId, contentHash);
}
三个关键点:用 docId 删旧向量,用 contentHash 判断要不要重新 embedding,权限变化时只更新元数据、不动向量。
换 Embedding 模型 = 全库重建,提前准备灰度
模型一换,旧向量全部失效,新旧向量的距离不可比。正确姿势:向量表预留 version / model_version 字段,新旧索引双写,按版本路由,后台分批重灌,评估达标后再切流量------整个流程预算留 2~4 周。这事别等换模型那天才想。
写入吞吐:千万级入库的三板斧
- Bulk Insert 批量导入,吞吐提升 10 倍以上;
- 延迟建索引:导入期关闭实时索引,离线构建后加载,速度提升 3~5 倍;
- MQ 削峰,写入异步化。
数据入库了,索引也建了,接下来聊聊索引背后的原理------这是面试最爱追问、也是调优最玄学的地方。
六、索引原理:HNSW、IVF、PQ 与那些玄学参数
三个比喻讲明白
HNSW = 多层高速公路网。 顶层只有几个入口(高速),底层连通所有节点(乡间小路),查询从顶层往下"跳",每层贪心靠近目标,代价从 O(N) 降到接近 O(logN)。它是用内存换速度,内存占用最高(向量 + 图边)。
IVF = 先分区域再细找。 用 K-means 把空间切成 nlist 个格子,查询只扫最近的 nprobe 个格子。内存中等,带过滤的查询有优势。
PQ = 把向量压缩了存。 把 1024 维切段,每段查码本,内存直接降 4~8 倍。代价是精度损失,靠"先粗筛再精排"补回来。
索引选型对照表
| 索引 | 相对内存 | 召回 / 延迟 | 查询旋钮 | 更新成本 | 最佳场景 |
|---|---|---|---|---|---|
| Flat(暴力) | 基准 | 完美召回,线性扫描 | 无 | 极低 | 小于 100 万,或做评测基线 |
| HNSW | 最高 | 内存方案里最好 | efSearch |
单条插入便宜,批量重建麻烦 | 低延迟 + 内存充足 |
| IVF-Flat | 中 | 同召回率下略低于 HNSW | nprobe |
需重训聚类中心 | 千万级、带过滤查询 |
| IVF-PQ | 最低(小 4~8 倍) | 较低,靠重排补救 | nprobe + 码长 |
需重训码本 | 亿级以上、内存受限 |
参数调优"人话表"
| 参数 | 作用 | 调参直觉 |
|---|---|---|
M |
每个节点的连接数 | 实时低延迟场景 8 |
ef_construction |
建图时候选邻居数 | 至少 2 倍 M,太低会永久损伤图质量 |
ef_search |
查询时的搜索宽度 | 聊天机器人 32~64;离线高召回可拉到 200+;经验值不小于 2 倍 K |
nlist(IVF) |
聚类中心数 | 百万级从 1024 起步 |
nprobe(IVF) |
查询扫描的簇数 | 设为 nlist 的 1/10,必须显式调,默认值会严重拉低召回 |
生产调参经验值(先压测再用):
- Milvus HNSW:
M=24, efConstruction=256, efSearch=128,线上按召回指标动态调; - pgvector HNSW:
m=16, ef_construction=64,SET hnsw.ef_search = 100;; - pgvector IVFFlat:
lists ≈ sqrt(行数),SET ivfflat.probes = 10;。
方法论 :
M、efConstruction压测后固定,线上只动efSearch/nprobe------这两个只影响查询,可以按 SLO 分档动态调。索引调参不是玄学,是你没找到那个能動的旋钮。
两个坑,都是架构级的
坑一:HNSW + 高过滤率 = 图碎片化。 真实案例:HNSW 无过滤时 Recall 98%、P99 50ms,看起来很美好;一旦加上"只搜本租户"的标量过滤、过滤率超过 90%,图结构瞬间碎片化,延迟飙到 2 秒,Recall 掉到 60% 以下。解法:高过滤率场景切 IVF 类索引,或者用 Milvus 的分区 / 分区键在物理层面隔离数据,别让 HNSW 硬扛。
坑二:度量方式不对齐。 前面说过了,模型按 cosine 训练、你用裸 L2,召回直接崩。参数调得再好也救不回来。
内存不够?IVF_PQ + Refiner
亿级向量全精度加载内存会爆。方案:IVF_PQ 乘积量化,内存最高可压缩 32 倍,再用 Refiner 把召回拉回来;或者 PQ / SQ 量化,内存降 70%+,召回率只略降。配合冷热分离------热数据常驻内存,冷数据落磁盘,闲置集合按需加载、动态释放。
索引讲完,单路召回已经能跑了。但我得提醒你:单路召回是瘸腿走路,真实的翻车案例都藏在下一章。
七、混合检索:向量 + BM25,少一路都是瘸的
两个真实翻车案例
案例一,纯向量对精确字符串天生不敏感。 用户问"CVE-2024-3094 影响哪些版本",模型召回一堆讲"漏洞影响范围"的文章,却偏偏漏掉标题里精确写着编号的公告。搜 E5021 错误码、X900-B 料号、ORD-2026-0001 订单号也一样------embedding 会把数字和型号"糊掉"。
案例二,纯 BM25 对口语化改述抓瞎。 用户问"服务突然挂了怎么排查",文档写的是"进程异常退出后的故障定位方法",零关键词重合。"报销"对"费用核销"、"请假"对"休假申请",全是这个结局。
向量管"意思像",BM25 管"字面像",两者互补,不是替代。混合检索在 2026 年已经不是加分项,是生产级 RAG 的标配。
为什么两路结果不能直接拼
新人最容易犯的错:把两路结果拼到一起,按分数排序。不行------两个分数的量纲根本不可比。余弦相似度在 0~1 之间,BM25 分数没有上界(可能是 3.2,也可能是 27.8),直接比大小等于拿"厘米"和"公斤"排序。
正解是 RRF(Reciprocal Rank Fusion,倒数排名融合)------不看分数,只看排名:
text
RRF_score(d) = Σ 1 / (k + rank_i(d)) k 通常取 60妙处有三:排名天然可比,第 1 名在哪一路都是"最好";两路都进前几名的文档融合分数明显更高,正是我们要的"交叉验证";k=60 是工业界默认的平滑常数,防止头部文档权重畸高,对分数分布不敏感,不同知识库可以做成配置项。
生产链路
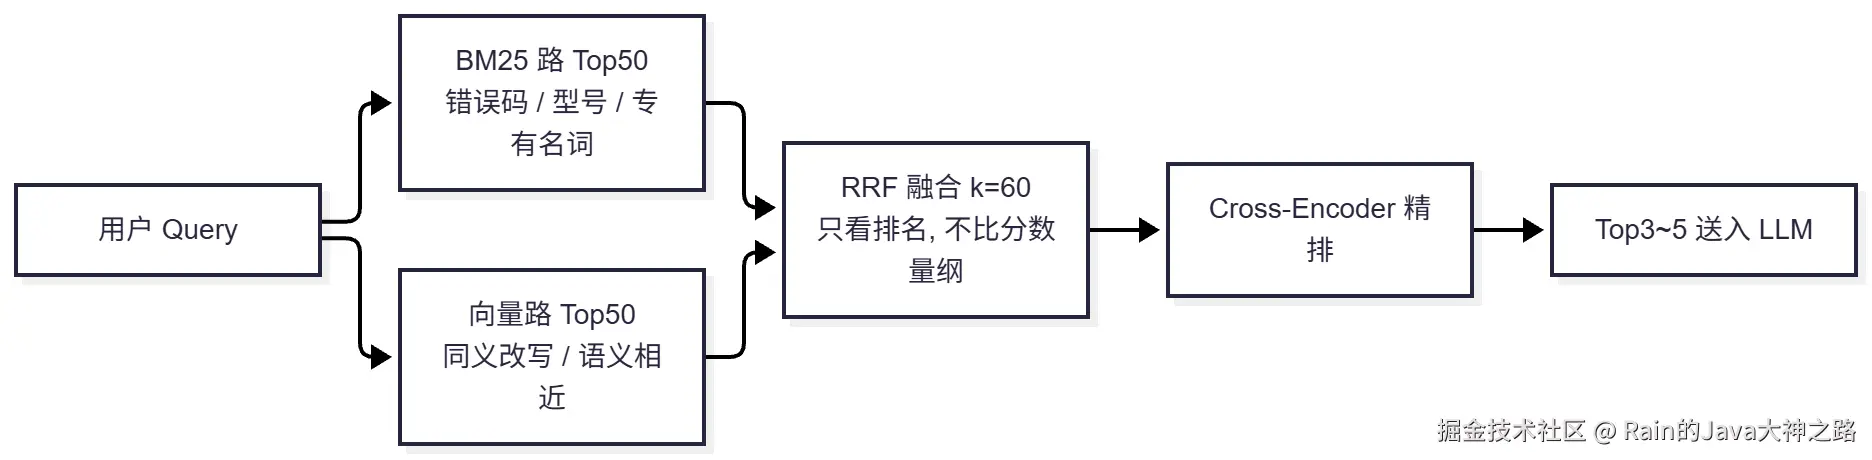
核心代码:并行召回 + RRF + 精排
java
@Service
@RequiredArgsConstructor
public class HybridRetriever {

    private static final int RRF_K = 60;
    private final VectorStore vectorStore;      // pgvector / Milvus / Qdrant
    private final Bm25Searcher bm25Searcher;    // ES / OpenSearch / 自建倒排
    private final Reranker reranker;            // Cross-Encoder 精排
    private final ExecutorService searchPool;   // 检索专用线程池

    public List<Candidate> search(String query, String tenantId, int topK) {
        var searchRequest = SearchRequest.builder()
                .query(query)
                .topK(50)                              // 宽召回,裁剪交给精排
                .similarityThreshold(0.65)             // 低分直接丢弃,防"硬答"
                .filterExpression("tenantId == '" + tenantId + "'") // 过滤下推
                .build();

        // 1. 双路并行召回,降低首字延迟
        var denseFuture = CompletableFuture.supplyAsync(() ->
                vectorStore.similaritySearch(searchRequest), searchPool);
        var sparseFuture = CompletableFuture.supplyAsync(() ->
                bm25Searcher.search(query, tenantId, 50), searchPool);

        try {
            CompletableFuture.allOf(denseFuture, sparseFuture)
                    .get(800, TimeUnit.MILLISECONDS);  // 硬超时,别让一路拖死整条链路

            // 2. RRF 融合:按"排名"融合,而不是按分数比较量纲
            List<Candidate> fused = rrfFuse(
                    List.of(denseFuture.get(), sparseFuture.get()));

            // 3. 同文档去重:防止相邻 chunk 占满前几位,保证证据多样性
            fused = dedupByDocId(fused);

            // 4. Cross-Encoder 精排,只取 topK 送 LLM,省 token 又提精度
            return reranker.rerank(query, fused, topK);
        } catch (Exception e) {
            // 5. 降级策略:混合检索挂了,退回单路向量召回
            log.warn("混合检索降级为单路向量召回, query={}", query, e);
            return vectorStore.similaritySearch(searchRequest).stream()
                    .map(Candidate::of).limit(topK).toList();
        }
    }

    /**
     * RRF: score(d) = Σ 1 / (k + rank)
     * 只用排名,天然规避 BM25 与余弦相似度"量纲不可比"的问题
     */
    private List<Candidate> rrfFuse(List<List<Candidate>> rankedLists) {
        Map<String, Double> scores = new HashMap<>();
        Map<String, Candidate> candidates = new HashMap<>();

        for (List<Candidate> ranked : rankedLists) {
            for (int i = 0; i < ranked.size(); i++) {
                Candidate c = ranked.get(i);
                int rank = i + 1;   // 易错点:排名从 1 开始!
                scores.merge(c.chunkId(), 1.0 / (RRF_K + rank), Double::sum);
                candidates.putIfAbsent(c.chunkId(), c);
            }
        }
        return scores.entrySet().stream()
                .sorted(Map.Entry.<String, Double>comparingByValue().reversed())
                .map(e -> candidates.get(e.getKey()).withScore(e.getValue()))
                .toList();
    }
}
两个注意事项:
CompletableFuture的线程池要独立配置 ,别和业务线程池共用,否则检索抖动会传导到整个应用。如果用 Java 21,可以换成虚拟线程 +StructuredTaskScope(scope.joinUntil()做硬超时),IO 密集场景吞吐提升明显,但注意下游连接池要配套扩容;- 排名从 1 开始 。如果从 0 开始,第一名会拿到
1/60,第 0 名和第 1 名的区分度被k抹平。这种细节,面试官一听就知道你有没有踩过坑。
中文场景还要补一课:分词
中文精确词失效是另一个重灾区,ILIKE '%向量数据库%' 返回 0 条的事太常见了。解法:jieba 分词或 N-gram(2-gram / 3-gram / 4-gram 组合),更重要的是自定义词典------让型号、错误码、内部项目名在分词时保持整体,不被切碎。
效果数据,用数字说话
双路召回 + RRF + 精排上线后,我们实测:top-5 召回率提升 18%~32%,top-1 准确率提升 25%~40%,错误码 / 型号这类精确查询召回提升约 30%,整体答案准确率提升约 40%。
召回够了,排序却可能还是错的------答案在 top10 里,LLM 只看到 top3,等于白搭。这就是下一章 Rerank 要解决的事。
八、Rerank 精排:性价比最高的质量提升器
Bi-Encoder vs Cross-Encoder
向量召回用的双塔(Bi-Encoder)像"两个人分别写作文,再比字数"------query 和 doc 各自压成向量,信息有损;Cross-Encoder 是"两人坐一起讨论后打分"------把 query 和 doc 拼在一起过模型,能看到两者的交互,精度远高于双塔,但慢(单条 5~30ms),所以只能精排少量候选。
标准打法是宽召回 + 窄精排三段式:
text
第 1 段 粗排(快):向量 + BM25 并行召回 Top50
第 2 段 融合:RRF 收敛到 Top30
第 3 段 精排(准):Cross-Encoder 逐条给 (query, chunk) 打分,只把 Top3~5 送进 LLM
三级降级:Rerank 挂了不能拖垮主流程
Rerank 是外部依赖,它挂了整个问答不能跟着瘫痪。生产上必须做降级:
java
public List<RerankedDoc> rerank(String query, List<Document> docs, int topN) {
    try {
        // 截断文档到 500 字符(API 长度限制)
        List<String> docTexts = docs.stream()
                .map(d -> truncate(d.getContent(), 500))
                .toList();
        // 调用 rerank 服务:bge-reranker-v2-m3 / qwen3-rerank / Cohere
        HttpResponse<String> resp = callRerankApi(query, docTexts, topN);
        if (resp.statusCode() != 200) {
            return fallback(docs, topN);   // 降级:API 失败,返回原始顺序
        }
        return parseResponse(resp.body(), docs, topN);
    } catch (Exception e) {
        log.error("Rerank 异常, 降级为原始顺序", e);
        return fallback(docs, topN);       // 最终降级:异常兜底
    }
}
任何外部依赖都不能是单点,必须有 fallback 路径。 这句话不止适用于 Rerank。
不想一开始就接模型服务的,可以先用规则打分冷启动,抽象一个 Reranker 接口,后续无缝替换:
java
private double score(String query, RagDocument doc) {
    double score = doc.similarityScore() * 0.6;   // 原始相似度打底
    if (doc.title() != null && doc.title().contains(query)) {
        score += 0.2;                              // 标题整句命中加权
    }
    // 分词后统计命中数(中文记得用 jieba 之类的分词器,
    // 别学我一开始用 String.split(""),那玩意儿切了个寂寞)
    long hitWords = tokenizer.segment(query).stream()
            .filter(doc.content()::contains)
            .count();
    score += Math.min(hitWords * 0.05, 0.2);
    return score;
}
一个零成本小技巧:最强片段放头尾
LLM 对上下文的开头和结尾注意力最强,中间容易"走神"------这就是 lost in the middle 现象,中间位置的召回率会下降 30% 以上。精排之后,把得分最高的片段放在头或尾,别埋在中间。一行代码的事,白捡的质量提升。
模型选型与效果
常用模型:bge-reranker-v2-m3(开源自托管首选)、qwen3-rerank、Cohere Rerank、Jina Rerank,已有 ES 的也可以玩 learning-to-rank。
效果有多顶?一个项目里加了 Rerank,答案准确率从 62% 干到 84%;另一个项目 Recall@5 从 0.695 提到 0.816。这就是我称它"性价比之王"的原因。
延迟敏感的场景(比如语音交互)再补几刀:候选截断(rerank 只处理 Top50)、微批调用、rerank 模型独立 GPU 部署、高峰期降级小模型,同时监控各阶段耗时定位瓶颈。
质量这块拿捏了,但还有个更要命的问题------权限。这一章你要是敢跳过,迟早出事故。
九、多租户与权限:一次"召回饿死"事故的复盘
事故现场
1000 万向量的多租户 SaaS 库,租户 corp_88 只占 1% 的数据。查询长这样:
sql
SEARCH(query_vec, limit=10, filter="tenant_id == 'corp_88'")我们当时图省事,在应用层做后过滤 :先在向量库取全局 Top-10,再按 tenant_id 过滤。结果:Top-10 里 99% 概率全是别的租户的向量,全被丢弃,返回 0 条。客户端明明要 10 条,实际拿到 0 条,小客户反馈"知识库搜不到东西",业务直接报障。
定位方式很简单:把"请求条数 / 实际返回条数 "做成监控面板,一眼就看到小租户的比值异常。修法:把过滤表达式下推到向量库执行,同时给 tenant_id 建标量索引。事后我把这条写进了代码规范:
向量检索的过滤条件,永远不允许写在应用层。
这是架构级问题,不是参数级问题------根因不是慢,是语义错了:先做全局 Top-K 再过滤,等于让 99% 的候选名额被其他租户占走。
三种过滤模式对比
| 过滤模式 | 执行顺序 | 能否保证满额召回 | 适用场景 |
|---|---|---|---|
| 后过滤 Post-filtering | 先向量 Top-K,再过滤标量 | 不能,小租户频繁归零 | 生产环境禁止使用 |
| 严格前置 Pre-filtering | 先倒排索引出 Bitmap,只在位图内搜 | 能,100% 保证 | 过滤能筛掉 90%+ 数据(如租户 ID) |
| 迭代 / 联合过滤 In-filtering | 图遍历时同步跳过不满足条件的节点 | 能,且通用 | 生产推荐,Qdrant / Milvus / Weaviate 均原生支持 |
过滤下推的原理
过滤表达式下推到向量库内核后,会在 Segment 级别用 bitset 剪枝------避免拉回全量向量再过滤,检索效率提升数倍。Milvus 原生 SDK 的写法:
java
// 标量过滤下推到存储层,Segment 级别 bitset 剪枝
String filterExpr = "tenant_id == '" + tenantId
        + "' and category == '" + bizCategory + "' and status == 1";

SearchParam searchParam = SearchParam.newBuilder()
        .withCollectionName("rag_knowledge_base")
        .withConsistencyLevel(ConsistencyLevelEnum.EVENTUALLY) // 检索用最终一致,延迟更低
        .withMetricType(MetricType.COSINE)
        .withTopK(topN)
        .withVectors(List.of(queryVector))
        .withVectorFieldName("embedding")
        .withExpr(filterExpr)          // 过滤下推
        .withSearchParams(JSON.toJSONString(Map.of("ef", 128)))
        .build();
权限模型应该长这样
每个 chunk 的 metadata 带上这些字段:
json
{
  "tenantId": "1001",
  "docId": "DOC_9527",
  "permissions": ["HR", "MANAGER"],
  "status": "PUBLISHED"
}
用户查询时,用当前用户的租户和权限列表做过滤:
java
SearchRequest request = SearchRequest.builder()
        .query(query)
        .topK(10)
        .similarityThreshold(0.60)
        .filterExpression(new FilterExpressionBuilder()
                .eq("tenantId", tenantId)
                .in("permissions", userPermissions)
                .build())   // 过滤下推到向量库,不是应用层
        .build();
很多初级实现只会写 vectorStore.similaritySearch(query),生产上这是绝对不够的------topK、similarityThreshold、filterExpression,一个都不能少。
组合拳兜底
- 物理 Partition 隔离:大租户单独分区,最优方案;
- 适当调高
efSearch,补偿过滤导致的图结构断裂; - 标量字段必须建索引,避免全 segment 扫描;
- 监控"请求 top-k / 实际返回数",比值波动大就说明过滤和索引没配合好;
- 业务层二次校验------检索层万一漏了,权限层还能拦住。
RAG 的安全不是只靠 Prompt 约束,而是在检索阶段就用 metadata filter 做硬隔离。
权限讲完,再来聊大家最担心的:幻觉。检索做好了,还得让 LLM 学会"闭嘴"。
十、幻觉治理:让大模型学会"闭嘴"
RAG 的幻觉有两层:检索没召回到 ,LLM 硬编;召回到了但 LLM 加戏,把"管理费 0.8%"说成"0.5%",这是 Faithfulness 问题。
治理必须是全链路的,"改 Prompt"只是其中一招:
板斧一:检索侧给干净上下文(治本)
混合检索 + 分块优化 + Rerank,保证喂给模型的上下文是准确、干净的。前面说过,七八成的幻觉锅其实在检索侧------这一步做不好,后面全是垃圾进垃圾出。
板斧二:Prompt 强约束(约束)
java
public Flux<String> ask(String question, List<Candidate> top5) {
    if (top5.isEmpty()) {
        // 拒答 > 幻觉:没有依据就老实说没有
        return Flux.just("知识库中未找到依据,我不确定,建议联系人工客服。");
    }
    String context = format(top5);   // 证据编号 [1][2][3]
    return chatClient.prompt()
            .system("""
                    你只能依据 <context> 回答,每个结论后用 [编号] 标注出处。
                    若 context 无依据,直接回答"未找到依据",禁止推测。
                    """)
            .advisors(a -> a.param(CONTEXT, context))
            .user(question)
            .stream().content();   // 流式输出,体验更好
}
要点:上下文和指令分离、强制标注引用编号、无依据时明确拒答。金融、医疗、法务这类场景,答案可溯源是硬要求。
板斧三:后处理校验(兜底)
两个动作:
Faithfulness 门禁。 用 NLI 蕴含判断或 RAGAS Faithfulness 对答案里的每个 claim 打分,低于 0.80 触发降级(经验阈值 0.7~0.8,与工作负载相关,不是硬标准),上下文覆盖不足时直接拒答,而不是硬答:
java
// 答案后置校验
double faithfulness = evaluator.score(answer, retrievedContexts);
if (faithfulness < 0.80) {
    return fallback("当前知识库暂无法确认该问题,建议转人工或补充文档");
}
引用溯源。 Prompt 里强制 LLM 标注 [doc_id],前端展示引用片段,用户可点开验证。这不仅是体验,也是线上幻觉的快速定位手段------答案基于哪份文档,一眼可见。程序还可以进一步校验引用编号是否真实存在于 context 中,校验失败就触发重生成。
不要追求"零幻觉",那是不可能的。目标是把幻觉控制在可观测、可降级、可追溯的范围内。
拒答也是门手艺:similarityThreshold(我们设 0.65)滤掉低分召回,Rerank 分数阈值(0.35)全低分就拒答。宁可转人工,不能一本正经地胡说。
质量和安全都拿捏了,最后两块工程拼图:性能与评估。
十一、性能与成本:别让 RAG 变成慢接口
先看一个典型 RAG 请求的耗时拆解:
| 阶段 | 典型耗时 |
|---|---|
| Query 改写 | 50~200ms |
| 向量检索 | 50~300ms |
| ES 关键词检索 | 50~300ms |
| Rerank 精排 | 100~500ms |
| LLM 生成 | 1s~10s |
LLM 生成占大头,所以流式输出必须安排上,首字出来体验就好一大截。其余优化方向逐个列:
1. 高频问题语义缓存。 key 设计成 question + tenantId + knowledgeVersion -> answer。三个注意:权限不同不能共享缓存;知识库版本变化要主动失效;热点问题还可以缓存向量检索结果,用 Redis 承接,key 提前设计好。
2. 粗排精排分离。 召回 50 条 → 精排 5 条 → LLM 只处理 5 条。别把 50 条直接塞给 LLM,又贵又慢。
3. 能并行就并行。 双路召回并行、向量化批处理、查询改写和历史加载并行。
4. Rerank 微批 + 高峰降级。 高峰期降级小模型,保 P99。
5. pgvector CPU 打满的解法。 HNSW 是 CPU 密集型,PG 单机几百 QPS 就打满了。对策:调 ef_search / m、读写分离、加语义缓存,超千万就上 Milvus 分片。
6. 内存成本。 PQ / SQ 量化让内存降 70%+,冷热分离,闲置集合按需加载。
7. 监控告警。 慢查询告警、各阶段耗时拆解(向量化 / 召回 / 融合 / 重排 / 生成),定位瓶颈再下手,别凭感觉优化。
十二、评估与可观测:没有评估的 RAG 是信仰
先建黄金测试集
"我感觉效果挺好"不是工程结论。准备一个标注集,200 条足够起步,覆盖四类问题 :错误码类、口语类、多条件类、无答案类------是的,"答不上来"的题也要考,专门看模型会不会硬编:
json
{
  "question": "请假审批被驳回怎么办?",
  "expectedDocIds": ["DOC_1001", "DOC_1002"],
  "expectedAnswerKeywords": ["重新提交", "联系审批人"]
}
每次改配置都在 CI 里跑回归:Recall@50 / MRR / NDCG@10 / P95,每轮只改一个变量。我的调优顺序供参考:先固定语料和分块 → 调 BM25 分词权重 → 比 embedding 与 topK → 选 RRF → 加 Rerank → 最后才做 Query 改写。
RAGAS 四指标
| 指标 | 测哪一端 | 回答的问题 | 需要真值 |
|---|---|---|---|
| Faithfulness(忠实度) | 生成 | 答案里每条陈述都被检索上下文支持吗 | 否 |
| Answer Relevancy(答案相关性) | 生成 | 答案真的回答了问题吗 | 否 |
| Context Precision(上下文精确率) | 检索 | 召回的块相关吗,相关的排前面了吗 | 否 |
| Context Recall(上下文召回率) | 检索 | 需要的信息都被召回了吗 | 是 |
没有标注数据?RAGAS 还能合成测试集------从文档里自动生成问题 + 参考答案,解决"没标注数据"这个最大瓶颈。
生产目标值参考
| 指标 | 含义 | 目标值 |
|---|---|---|
| Recall@K | Top-K 中含正确答案的比例 | 大于 0.85 |
| MRR | 平均倒数排名 | 大于 0.7 |
| Faithfulness | 回答忠于资料 | 大于 0.9 |
| Answer Relevancy | 回答切题 | 大于 0.8 |
| P95 Latency | 95 分位延迟 | 小于 2s |
可观测性:该记的日志都要记
每个请求记录:userId、tenantId、question、改写后的问题、召回文档列表、各阶段耗时(召回 / 重排 / LLM)、token 用量、答案、用户反馈(点赞 / 点踩)。
关键指标:召回耗时、命中率、Recall@K、MRR、拒答率、幻觉率、点赞点踩、单次问答 token 成本。
优化闭环这样转起来:用户问题 → 日志 → 标注 → 评测 → 分块 / 召回 / 重排优化 → 灰度上线。工具链:RAGAS(评估)+ LangSmith(全链路追踪)+ Spring Actuator 和 Micrometer(Java 侧指标)。
十三、生产难点速查表 + 一页速记
难点总表,建议收藏
| # | 难点 | 症状 | 解决方案 | 实测效果 |
|---|---|---|---|---|
| 1 | 分块语义割裂 | 答案被拦腰截断,召回高但不完整 | 结构感知 + 父子块 + 10%~20% 重叠 + 标题路径元数据 | 命中率 +15%,召回 70%→90% |
| 2 | 专有名词 / 错误码搜不到 | 纯向量对精确字符串失明 | BM25 + 向量双路 + RRF + 自定义词典 | 精确查询召回 +30% |
| 3 | 召回够但排序错 | 答案在 top10,LLM 只看 top3 | Cross-Encoder 精排 Top50→Top5 | 准确率 62%→84% |
| 4 | 过滤后召回归零 | 后过滤让小租户直接归零 | 过滤下推 / 分区隔离,禁止应用层后过滤 | 召回饿死清零 |
| 5 | 权限越权 | 看到别人的文档 | metadata 前置过滤 + 业务层二次校验 | 零越权 |
| 6 | 高过滤率延迟爆炸 | HNSW 图碎片化 | IVF 或分区键物理隔离 + 调高 efSearch + 标量索引 | P99 降 60% |
| 7 | 幻觉 | 没料也硬答 | 阈值拒答 + Prompt 强约束 + 引用编号后校验 | 幻觉大幅下降 |
| 8 | 入库慢 | 串行 embedding 跑到天荒地老 | 批量 + 并行 + 缓存 + 限流 + Bulk Insert + 延迟建索引 | 写入提速 3~10 倍 |
| 9 | 换 Embedding 模型 | 全库重灌、停服 | version 字段 + 双写灰度 + 后台分批重灌 | 平滑切换,预算 2~4 周 |
| 10 | 文档更新不一致 | 文档删了向量还在,答已废政策 | MySQL 唯一事实源 + CDC / binlog + 幂等删除 + 对账 | 最终一致可追溯 |
| 11 | 内存成本高 | 亿级向量 HNSW 吃满内存 | IVF_PQ 量化 + 冷热分离 + Refiner 拉回召回 | 内存 -70%+ |
| 12 | 亿级检索性能瓶颈 | 召回 RT 飙升超 200ms | 索引选型(HNSW / IVF_PQ)+ PCA / UMAP 降维 + 业务分片 | 召回率仍大于 95% |
| 13 | 多轮对话断层 | "那第二条呢"检索必失败 | 查询改写,指代消解成独立问句 | --- |
| 14 | 长文档超 token | 上下文塞不下 | MapReduce + 父子块 + 摘要压缩 + TopK 截断 | --- |
| 15 | 效果无法证明 | "我感觉挺好" | 黄金集 + RAGAS 进 CI,每轮只改一个变量 | 调优有据可依 |
高频追问速记
| 可能被追问 | 答题钩子 |
|---|---|
| 为什么不用 LIKE 做? | 语义鸿沟,精确匹配和语义近似是两种范式 |
| BM25 和向量结果怎么合并? | 分数量纲不可比,RRF 按排名融合,k=60 |
| 召回率怎么测? | Flat 暴力检索做真值基线算 recall@K,再加 RAGAS 的 Context Recall |
| 为什么加过滤后变慢了? | 过滤破坏 HNSW 连通性,分区隔离 / 调高 efSearch / 标量建索引 |
| 换 embedding 模型怎么办? | 全库需重嵌入,双写灰度 + 并行双索引,预算 2~4 周 |
| 为什么不把所有文档塞进上下文? | 窗口 + 成本 + lost in the middle,RAG 是先做减法再做加法 |
| 为什么不直接微调模型? | 微调解决语气解决不了知识时效,RAG 改库即生效且可溯源 |
| MySQL 真的一点用没有了? | 它是权限边界和事实锚点,用错工具不是工具不行 |
一页速记,存好
text
【一句话结论】不是 MySQL 不行,是检索范式从"精确匹配"变成了"语义近似"
【核心数字】暴力检索 O(N×d);100万×1024维 ≈ 20亿次浮点运算/次;1亿×128维 = 51.2GB
【选型口诀】有 PG 用 pgvector,没 PG 用 Qdrant,亿级才上 Milvus
【索引口诀】HNSW 内存换速度,IVF 分区域,PQ 压内存;线上只动 efSearch / nprobe
【必答组合】分块(语义+重叠) → 混合检索(BM25+向量) → RRF 融合 → Cross-Encoder 精排 → Top3~5
【头号大坑】后过滤导致"召回饿死",过滤必须下推到向量库
【幻觉三板斧】干净上下文 + Prompt 强约束 + 引用编号后校验
【评估四指标】Faithfulness / Answer Relevancy / Context Precision / Context Recall
【度量对齐】模型按 cosine 训练 → 向量必须归一化,别用裸 L2
写在最后
回到标题的问题:AI 时代,还要不要死磕 MySQL?
我的答案是:不是 MySQL 被淘汰了,而是 MySQL 负责"确定的事实",向量库负责"语义的相似" 。RAG 的工程本质,是把分块、召回、融合、重排、校验这五件事当成一条可观测的数据管道来运营,而不是把文档一股脑塞进向量库就完事。
常有人问:未来 MySQL 会不会把向量库吃掉?我的判断是部分会------中小规模 + 存量 MySQL 业务会走库内 AI(PolarDB 甚至能一条 SQL 完成向量化 + RAG 检索),但亿级 + 高并发仍然要专用向量库。真正的趋势不是谁取代谁,而是"向量检索"正在从一个独立组件,慢慢退化成数据库的一种索引能力。
三条落地建议送给你:
- 从小处起步:有 PG 就用 pgvector 开干,黄金集先建 200 条,别一上来就部署 Milvus;
- 过滤下推第一天就做:把"过滤不许写在应用层"写进代码规范,别重演我的召回饿死事故;
- 先评估再调优:没有黄金集就别谈优化,每轮只改一个变量。
我在项目里最深的体会是:检索侧每提升 1% 的 Recall,LLM 的幻觉就少一大截;而向量数据库选型和索引参数,决定了这个 1% 的天花板在哪里。
文章有点长,能看到这里的都是狠人。觉得有用的话,点赞、在看、收藏三连就是最大的支持。关注我,下一篇写《高并发场景下向量数据库的压测与调优》,HNSW 调参和 Milvus 运维的细节全部展开。
最后留个具体的小问题:你们生产环境的 chunk size 是多少?踩过什么"分块血泪"?或者你用的是 pgvector 还是 Milvus? 评论区聊聊,让我看看大家的答案。