第 1 篇我们说过一句话:坑不会消失,只会换一副面孔。 这一篇就是来填坑的。
上篇的 ActorSystem 让玩家模块的锁全部消失,但上线跑了一周,两个新问题浮出水面,而且都比想象中严重:
- 生命周期:玩家上下线频繁,actor 怎么创建、怎么销毁?粗暴处理的结果是------停机时数据没落库,回档了;重复创建,两个 actor 抢同一份玩家数据,race 换了件衣服回来了。
- 阻塞 IO :一个玩家在 actor 里同步查了一次 Redis,整个玩家的所有操作排队等了两秒。我们以为消灭了锁,结果造出了一个更隐蔽的"单点卡死"。
这篇讲清这两个问题的解法:生命周期三阶段停机,和全局协程池分流。代码可以直接抄,注释是踩坑后补的。
上篇回顾:我们留下的骨架
第 1 篇的 PlayerActor 核心只有三件事:mailbox 收消息、单 goroutine 串行消费、data 无锁独占。本篇所有代码基于这个骨架,不再重复全文:
go
type PlayerActor struct {
    data    *PlayerData // 只允许 loop goroutine 访问
    mailbox chan func()
    quit    chan struct{}
    wg      sync.WaitGroup
}
第一部分:玩家 Actor 的生命周期
1.1 上线:懒创建 + 双检
50 万注册玩家不可能常驻 50 万 goroutine。我们的策略:活跃玩家常驻,冷玩家上线时才创建 。注册表本身是共享的,这个 map 要加锁------注意,锁的是"索引",不是玩家数据,这是和上篇"消灭锁"不冲突的:
go
type ActorManager struct {
    mu     sync.RWMutex
    actors map[int64]*PlayerActor
}

// GetOrCreate:上线时按 pid 拿 actor,没有就创建
func (m *ActorManager) GetOrCreate(pid int64) *PlayerActor {
    m.mu.RLock()
    a, ok := m.actors[pid]
    m.mu.RUnlock()
    if ok {
        return a
    }
    // 双检:两个请求可能同时走到这里,只允许创建一个
    m.mu.Lock()
    defer m.mu.Unlock()
    if a, ok = m.actors[pid]; ok {
        return a
    }
    a = NewPlayerActor(loadPlayer(pid), 128)
    m.actors[pid] = a
    return a
}
这段代码是我们踩过坑的地方:第一版没有双检,高峰时同一个玩家并发登录,创建出两个 actor,各自处理一半请求------玩家数据裂成两半。race 检测器在 actor 内部抓不到,因为它发生在"两个 actor 之间",我们排查了整整两天。
1.2 下线:三阶段优雅停机
玩家下线、掉线、跨服迁移,都要把 actor 销毁。销毁最忌讳"一杀了之":mailbox 里还排着 50 条消息,里面可能有最后一步扣资源、写日志------直接杀掉 goroutine,这些操作全部丢失,回档就来了。
我们的停机是三阶段状态机:
sql
Running(正常服务)
   │  收到停机指令
   ▼
Draining(拒绝新消息,排空 mailbox 存量)
   │  存量消息全部处理完
   ▼
Stopped(落库 → goroutine 退出 → 从注册表摘除)
核心实现就两个函数,注意 loop 里 quit 分支的 drain 循环:
go
// Send:停机后拒绝新消息(返回 false),调用方自行决定降级
func (a *PlayerActor) Send(fn func()) bool {
    select {
    case a.mailbox <- fn:
        return true
    case <-a.quit: // quit 已关闭 → 进入停机流程
        return false
    }
}

func (a *PlayerActor) loop() {
    defer a.wg.Done()
    for {
        select {
        case fn := <-a.mailbox:
            fn()
        case <-a.quit:
            // 进入 Draining:把存量消息全部处理完再退出
            for {
                select {
                case fn := <-a.mailbox:
                    fn()
                default:
                    savePlayer(a.data) // 落库(停机路径允许一次性阻塞)
                    return             // Stopped
                }
            }
        }
    }
}

// BeginDrain:触发停机,之后 Send 一律返回 false
func (a *PlayerActor) BeginDrain() {
    close(a.quit)
}

// Wait:等待落库完成、goroutine 退出
func (a *PlayerActor) Wait() { a.wg.Wait() }
三个容易翻车的点,都是我们实际踩过的:
- drain 循环必须用非阻塞取消息 (
default分支退出),否则处理完存量后会在空 mailbox 上永久阻塞; - 落库必须在 drain 完成之后------如果一边处理消息一边落库,最后落下去的可能不是最终状态;
- 停机后要主动从注册表摘除 ,否则
GetOrCreate会拿到一个已死的 actor 引用,Send静默返回 false,玩家"上线失败但无报错",排查起来非常痛苦。
第二部分:actor 内禁止阻塞 IO
2.1 坑的现场:一次同步查 Redis,全玩家排队
生命周期解决后,我们迎来了第二个坑。某次版本上线,运营活动要读一个 Redis 配置,同事图省事直接在 actor 里同步查:
go
// 错误示范:在 actor goroutine 内直接阻塞
func (a *PlayerActor) OpenGiftBox() {
    a.Send(func() {
        cfg, err := redisClient.Get(ctx, "activity:gift:cfg").Result() // 阻塞 2 秒!
        if err != nil { /* ... */ }
        a.data.ApplyGift(cfg)
    })
}
Redis 抖动一下,这个玩家 actor 的 goroutine 卡在 Get 上 2 秒 。期间这个玩家点什么都无响应------升级、出征、聊天,全部排在 mailbox 里等着。单 actor 卡死 = 单玩家全功能不可用,比锁死锁更隐蔽,因为 CPU 不涨、连接不断,监控看不出任何异常,只有玩家骂。
更诱人的错误解法是"直接在 actor 里 go func":
go
// 更错误:在 actor 内开 goroutine 做阻塞任务
a.Send(func() {
    go func() { // 并发访问 a.data ------ 第 1 篇消灭的 race 回来了!
        cfg, _ := redisClient.Get(ctx, "...").Result()
        a.data.ApplyGift(cfg) // 和主循环同时写 data
    }()
})
actor 的串行性是"数据安全"的唯一来源,在 actor 里开 goroutine 等于亲手把第 1 篇的三个坑全部放回来。
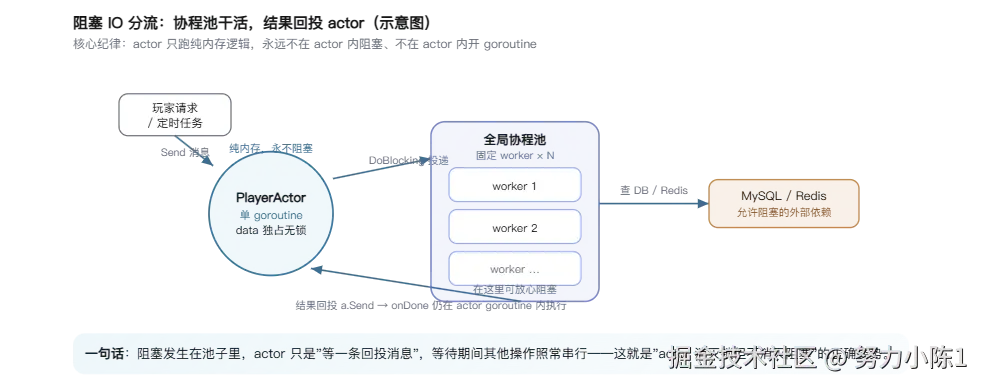
2.2 解法:全局协程池分流,结果回投
我们的方案分三句话:
- actor 只跑纯内存逻辑,凡是要阻塞 IO 的活,一律投给一个全局固定容量的协程池;
- 协程池里的 worker 可以放心阻塞(查 DB、调 Redis),池子是全局共享的,谁的任务都排队;
- 任务完成后,结果通过
Send回投给原 actor ------对data的访问仍然只发生在 actor goroutine 内,串行性一分没丢。
先看全局协程池(固定 worker 数,防止 goroutine 无限增长):
go
// Pool:全局固定容量协程池,专门承接阻塞任务
type Pool struct {
    jobs chan func()
    wg   sync.WaitGroup
}

func NewPool(workerCount, jobQueue int) *Pool {
    p := &Pool{jobs: make(chan func(), jobQueue)}
    for i := 0; i < workerCount; i++ {
        p.wg.Add(1)
        go func() {
            defer p.wg.Done()
            for fn := range p.jobs {
                fn() // 这里可以放心阻塞:查 DB、调 Redis
            }
        }()
    }
    return p
}

// Submit:非阻塞投递;池子满了返回 false
func (p *Pool) Submit(fn func()) bool {
    select {
    case p.jobs <- fn:
        return true
    default:
        return false // 满 → 调用方决定重试/降级
    }
}
再看 actor 侧的封装,这是全文最关键的一段:
go
var globalPool = NewPool(64, 1024) // 参数见文末占位

// DoBlocking:阻塞任务交给协程池,完成后回投到 actor goroutine 执行 onDone
func (a *PlayerActor) DoBlocking(task func() (any, error), onDone func(res any, err error)) {
    submit := func() {
        res, err := task()                    // 在池子 worker 里执行,可阻塞
        a.Send(func() { onDone(res, err) })   // 结果回投:onDone 仍只在 actor goroutine 内跑
    }
    if !globalPool.Submit(submit) {
        // 池满:不能原地执行 onDone(会破坏 actor 串行),同样回投一个失败回调
        a.Send(func() { onDone(nil, ErrPoolFull) })
    }
}
改造后的礼包领取:
go
func (a *PlayerActor) OpenGiftBox() {
    a.DoBlocking(
        func() (any, error) { // 阻塞部分:在协程池里
            return redisClient.Get(ctx, "activity:gift:cfg").Result()
        },
        func(res any, err error) { // 结果部分:回到 actor goroutine
            if err != nil {
                a.data.SetGiftError(err)
                return
            }
            a.data.ApplyGift(res.(string))
        },
    )
}
这个模式为什么对? 因为阻塞发生在池子里,玩家 actor 的 goroutine 永远不被卡住,它只是在"等一条回投消息"------等待期间其他操作照常串行执行。错误的地方只有一处:在 actor 内做阻塞;正确的地方也只需要一处:阻塞交给池子,结果回投。
2.3 方案对比
| 方案 | actor 串行性 | 阻塞影响 | 数据安全 | 复杂度 |
|---|---|---|---|---|
| actor 内直接阻塞 | 保持 | 单个 actor 全功能卡死 | 安全 | 最低 |
| actor 内开 goroutine | 破坏 | 无 | race 回来 | 低 |
| 协程池分流 + 回投 | 保持 | 仅池子打满时互相排队 | 安全 | 中 |
2.4 容量设计(经验,非银弹)
- worker 数:不是越大越好,建议按"业务高峰期阻塞任务并发量 × 1.5"压测得出【替换为你们的压测数据】;
- 队列长度 :worker 数 × 10 起步,池满后的策略要显式选择------拒绝并降级(返回错误提示"操作繁忙")比无限排队更可控;
- 超时 :
DoBlocking里给 task 加 context 超时,防止 Redis 挂了之后所有 worker 永久占住; - 监控:池子打满必须告警,这是"全局背压"的唯一信号。
总结:两条口诀
生命周期:上线懒创建(双检)、下线三阶段(拒绝新消息 → 排空存量 → 落库摘除)。
阻塞 IO :纯内存逻辑进 actor,阻塞 IO 进池子,结果回投 actor。永远不要在 actor 内阻塞,永远不要在 actor 内开 goroutine。
下一篇预告:《Actor 消息可靠性:背压、超时与重试》,聊 mailbox 塞满怎么办、消息丢没丢、以及跨节点 actor 的路由------这是把 actor 从"单机玩具"推向"生产可用"的最后一公里。