大家好,我是程序员天天困。
DeepSeek 又搞突袭。10 月 17 日,DeepSeek-V4.1-Flash-1017 直接上线,网页、App、API 一起换,连个预告都没有。
我看到消息的第一反应是:又来?再一看它说能从零建项目,行,那别测 Todo List 了,直接上 3D。
于是我花了半天,让它做了三个东西:一辆会飞的特斯拉、一个 3D 版《千里江山图》、一台会折叠的掌机;外加一个热身用的雨夜公交站。
四个都做出来了。可是没有一个满足我的预期。
不是它不会写代码。是它写完了,自己看不出哪儿不对。
一、先别急着看 77%:这版到底更新了什么
这次 DeepSeek 把 V4.1 Flash 升到了 V4.1-Flash-1017,网页、App、API 同步切换。API 的模型名没变,还是 deepseek-flash;旧名 deepseek-v4-flash 也还能调,只是背后换成了 1017。
发布前两天,DeepSeek 刚经历近 5 小时服务中断,官方按 API 用户 7 天内的 API 消耗金额全额返还赠金;而这次 1017 上线也几乎没有预热。
据 DigitalToday 转引彭博社的报道,官方在 X 上的说法很克制:这是对 9 月 V4.1 Flash 的一次小更新,基准更高、任务完成更快、回答更短。报道还把它放进了"中国开源权重模型 vs 美国闭源模型"的竞争叙事里。
这次更新最容易被记住的是三件事:跑分涨了、任务便宜了、官方开始讲"许愿式编程"。
许愿式编程(Wish-Driven Programming):用尽量少的需求描述,让模型自己完成规划、编码、运行和修改,直接交付一个能跑的项目。类比的话,以前你是在带一个需要逐行 review 的实习生,现在更像给外包发了一份一句话需求书。
先看官方给的数字。11 项基准全部上涨,其中和编程 Agent 最相关的几项是:
| 项目 | 9 月版 V4.1 Flash | V4.1-Flash-1017 | 变化 |
|---|---|---|---|
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| HLE(无工具) | 36.8 | 42.6/44.0* | +5.8 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 |
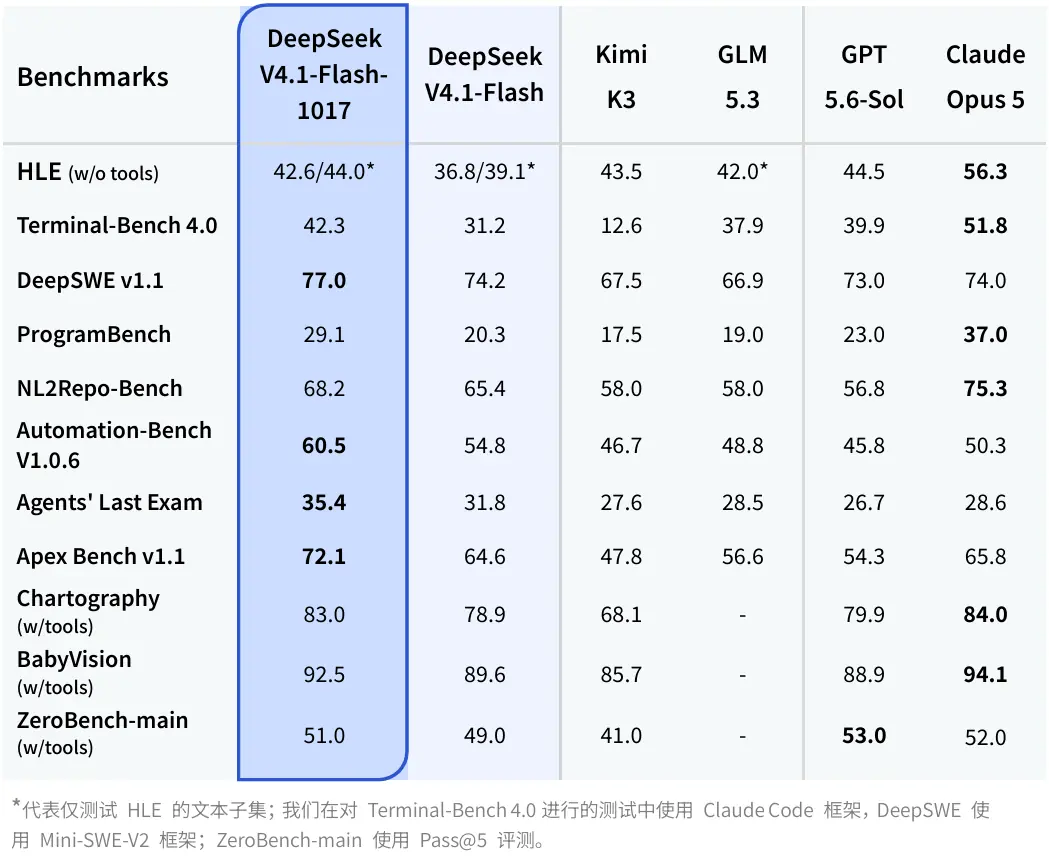
这张表有几个脚注很关键:Terminal-Bench 4.0 跑在 Claude Code 测试框架里,DeepSWE v1.1 跑在 Mini-SWE-V2 里,HLE 的 44.0* 只测了纯文本子集。换成别的框架、别的子集,数字不一定一模一样。
这些数字都是官方自报;1017 目前还没有 AA/Vals 的独立复测,第三方跑分要等几天。
所以 77% 的正确读法是"在这套框架、这套配置下,它拿到了 77%",不是"所有编程任务都能过 77%"。
再看对手。Claude Opus 5 在 HLE 上是 56.3,Terminal-Bench 4.0 是 51.8,这两项仍然明显领先;DeepSeek 赢在 DeepSWE 77.0 对 74.0、Automation-Bench 60.5 对 50.3、Apex Bench 72.1 对 65.8。不是全面碾压,是各有胜负------Claude 在 ProgramBench、NL2Repo、Chartography、BabyVision 上仍然领先。
这轮官方还放了一张性能-成本图:横轴看单任务成本,纵轴看 Pass@1。1017 的点在左上角:通过率最高,最高档单任务费用约 1.3 元;9 月版最高档约 3.3 元。
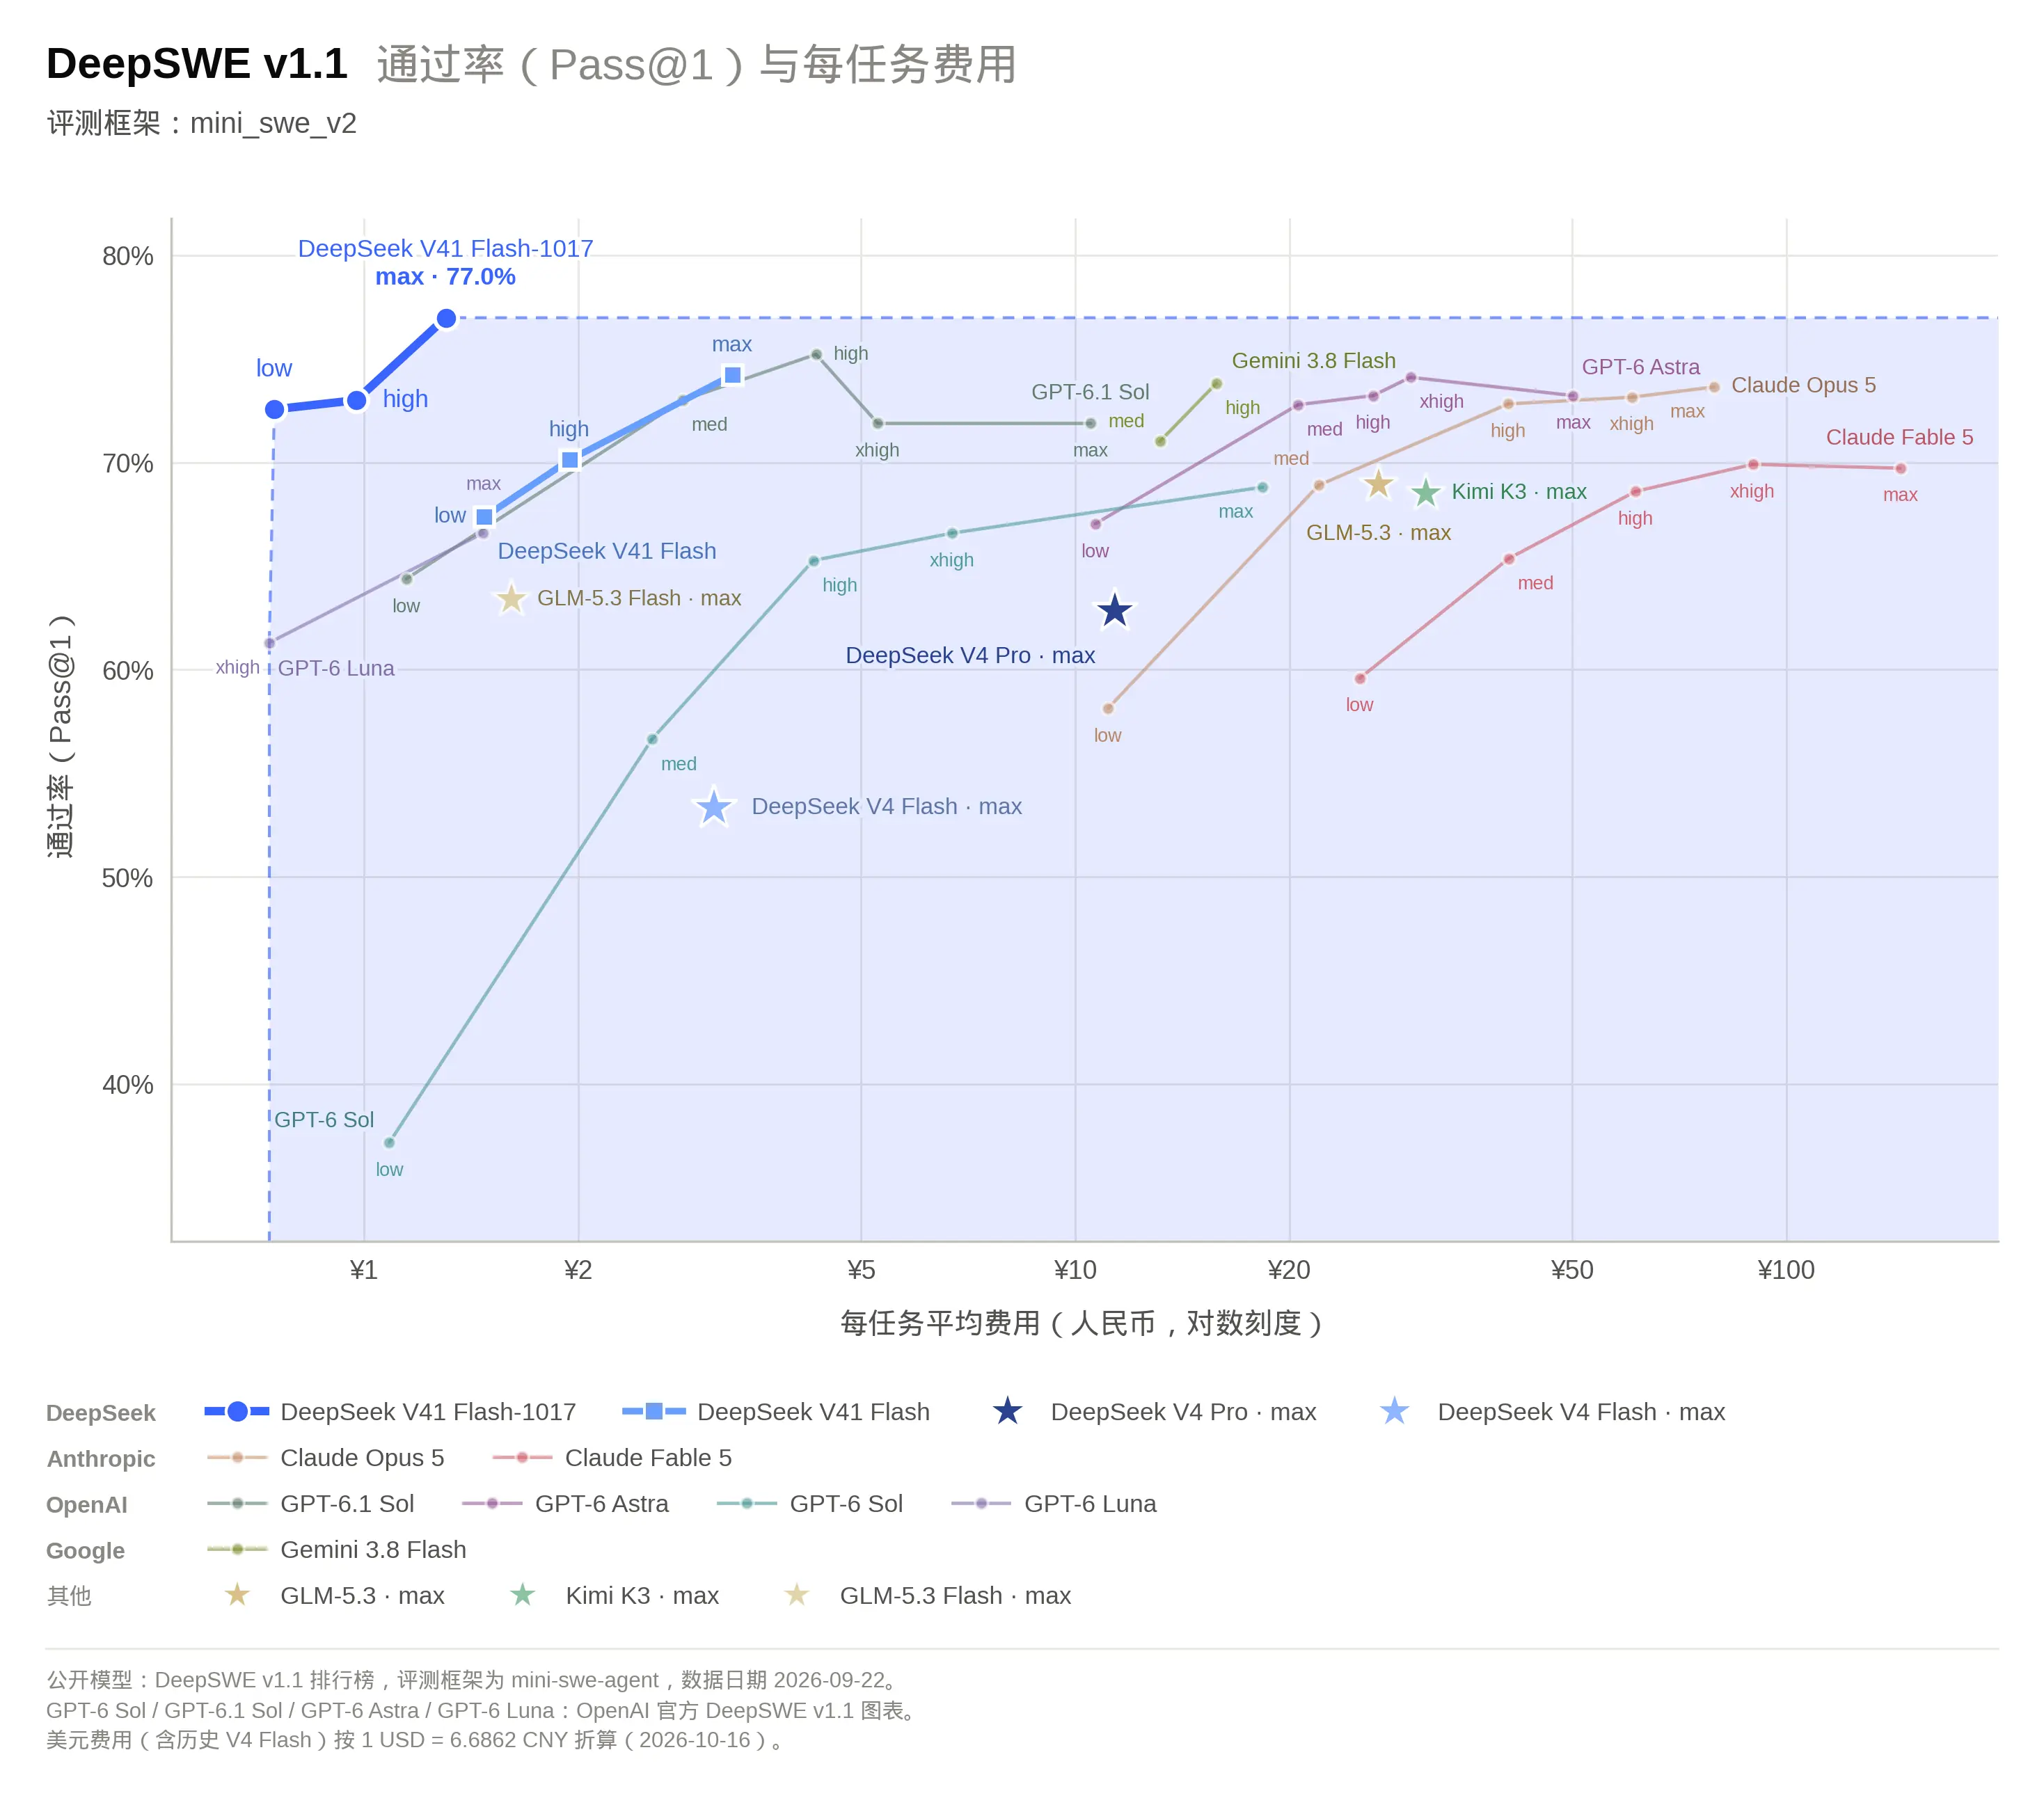
帕累托改进(Pareto Improvement):在不牺牲某一项指标的前提下,把另一项指标也变好。这里指的是通过率涨了、单任务成本反而降了;不是所有场景都成立,只在官方选的这组任务和框架里成立。
图好看归好看,我更关心另一件事:这玩意儿到底能不能直接拿来干活。官方演示里的故宫、赛车、传送门 2 和 Valley of Ages 确实惊艳;网上也有不少用户直出的飞车、蜜蜂、悬浮岛,效果同样能打。可这些大多是"开放题材"的胜利------考的是氛围、构图和脑洞。换成有明确现实参照、结构约束的题目,第一版就没那么稳了:比例、朝向、物理、相机,第二眼才露馅。
顺带说一句,这次还开放了自研搜索的 Search 和 Fetch 接口,都是 5 元 / 千次成功请求;在 DeepSeek Harness、Claude Code、Codex 里通过服务端工具调用目前不计费,2026 年 11 月 1 日 00:00(北京时间)开始收费。权重也开源了,Hugging Face 和 ModelScope 都能下;模型卡标注 MIT 许可。
对开发者来说,这比跑分实在:搜索、抓取、写代码、跑测试,开始收拢到同一套工具链里。
二、这次不测 Todo List:4 个项目,难度逐级加码
测试环境是 DeepSeek Harness 本机 Web 端,模型选 deepseek-flash(也就是 1017),默认思考模式,temperature 用默认值,未额外联网;三个 3D 项目都在 2026 年 10 月 18 日跑完,常规上下文,没有塞满 1M。每个任务第一轮只发一次提示词,首屏截图前不手动改代码;截图用本机 Chrome,1440×900。
这次我故意把难度拉高:
| 项目 | 考什么 | 难度 |
|---|---|---|
| 雨夜公交站 A/B | 提示词颗粒度、元素关系 | 热身 |
| 3D 飞行特斯拉 | 3D 产品、悬停/喷流/落地 | 中 |
| 3D《千里江山图》 | 大场景构图、层次、材质、动效 | 高 |
| 折叠掌机 | 产品结构、折叠机构、按键布局 | 高 |
说明一下:公交站和《千里江山图》在第一次截图后,我手动改了几行代码(CSS 和相机参数)。不是模型自己修的。我想看看"人来收尾"到底要动多少地方,所以把修复前后的图都留了下来。
三、热身:一句话 vs 四要素,雨夜公交站
A 版我故意只写一句话,连角色和验收标准都省了,只留了"单文件 HTML"这个输出约束:
text
做一个雨夜公交站的网页场景,要好看,单文件 HTML。出来的东西是这样:
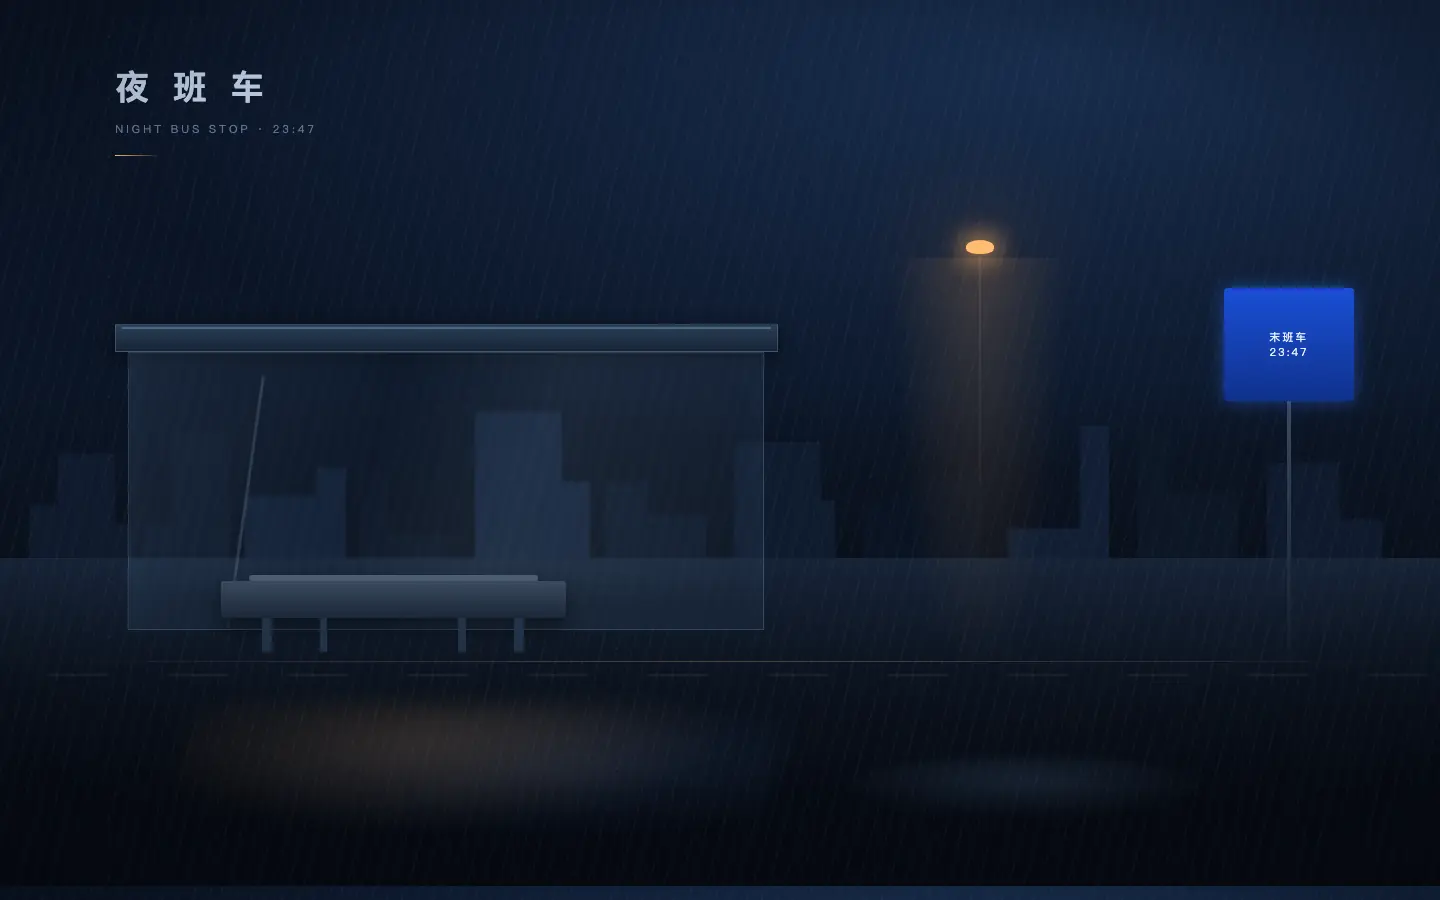
说实话,不难看。深夜蓝、钠灯、玻璃站台、湿地反光都有,雨丝也在动。但它像一张通用的"夜雨壁纸":站台是空的,没有等车的人,没有线路信息;除了一块"末班车 23:47"的牌子,几乎没有能让人记住的细节。
一句话的活儿,大概就是个 70 分的氛围:能看,但记不住。
B 版我把要求写成了四要素:
text
角色:你是一名擅长氛围叙事的前端创意开发者。
背景:我在做一期"城市夜归人"专题页,首屏要一张雨夜公交站的静态海报,最终会截成 16:9,1440×900 下必须成立。
任务:用单个 HTML 文件(内联 CSS/JS,不用外部图片、字体、库)实现场景,并同时满足 5 条约束:
1. 构图:站台在左三分之一,马路向右延伸,消失点在右 70%,站牌在右三分之一;
2. 必含元素:带雨痕的玻璃顶棚、长椅、三行可读的路线牌(夜1路/夜2路/机场专线)、一个撑伞等车的乘客剪影、地面积水倒影、一盏会轻微闪烁的钠灯;
3. 色彩:深夜蓝 #0B1220、钠灯暖橙 #FFB25E、站牌电光蓝 #2E6BFF、湿地 #141C2B,全画面不超过 6 个主色;
4. 动效:雨丝下落、钠灯每 4-6 秒闪一次、积水细微涟漪;prefers-reduced-motion 时全部静止;
5. 性能:不用 canvas,DOM 不超过 120 个节点,1440×900 不掉帧。
输出格式:
A. 完整可运行代码(一个代码块)
B. 自检清单:逐条对照 1-5,写"满足/不满足 + 证据"
C. 运行说明:一句话。
这次它把清单上的东西几乎都填了:三行路线牌、玻璃雨痕、钠灯、积水、长椅、站牌,连"夜1路/夜2路/机场专线"都写进去了。
然后乘客变成了这样:
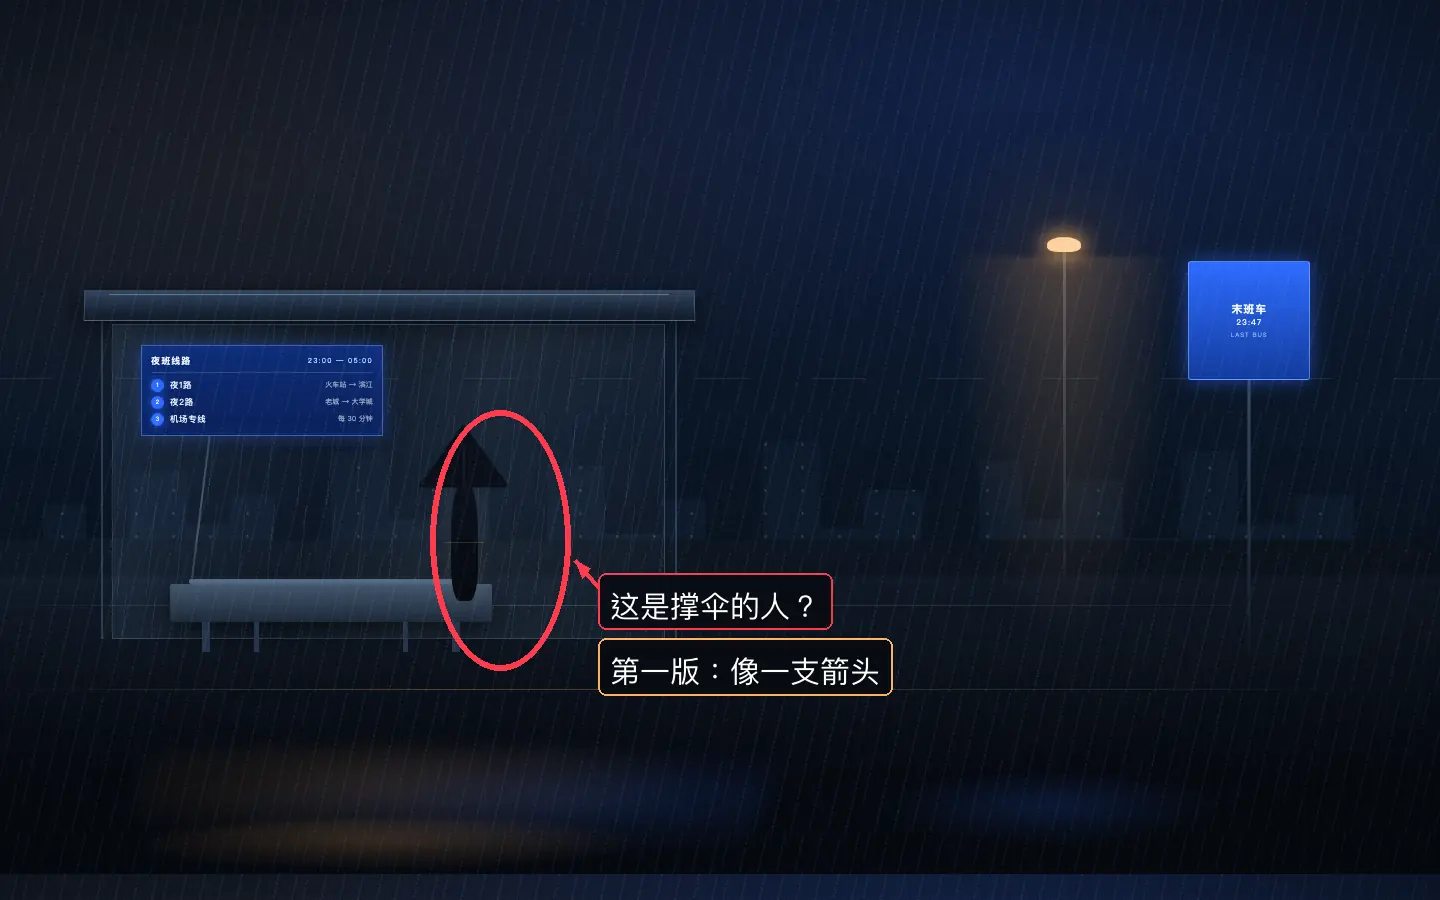
我盯着这张图看了半天,脑子里只有一句话:这也叫撑伞的人?
问题不在"它不会画人"。它画了伞面,也画了身体,代码里连伞柄都画了。问题是它把伞面写成了一个向上的三角形 clip-path,人体又叠在三角形下面,远看就是一支箭头。
毛病就出在这儿:清单上的东西它都填了,但填完不检查它们之间的关系。
提示词写的是"一个撑伞等车的乘客剪影",它理解成"一个三角形 + 一个竖条";至于这两块拼起来像不像人,它没有这个空间常识。
我没让它重跑,自己改了三处 CSS:伞面从三角形改成半圆,人体从长椅中间挪到站台边缘,补了腿、修了头。前后十几分钟。
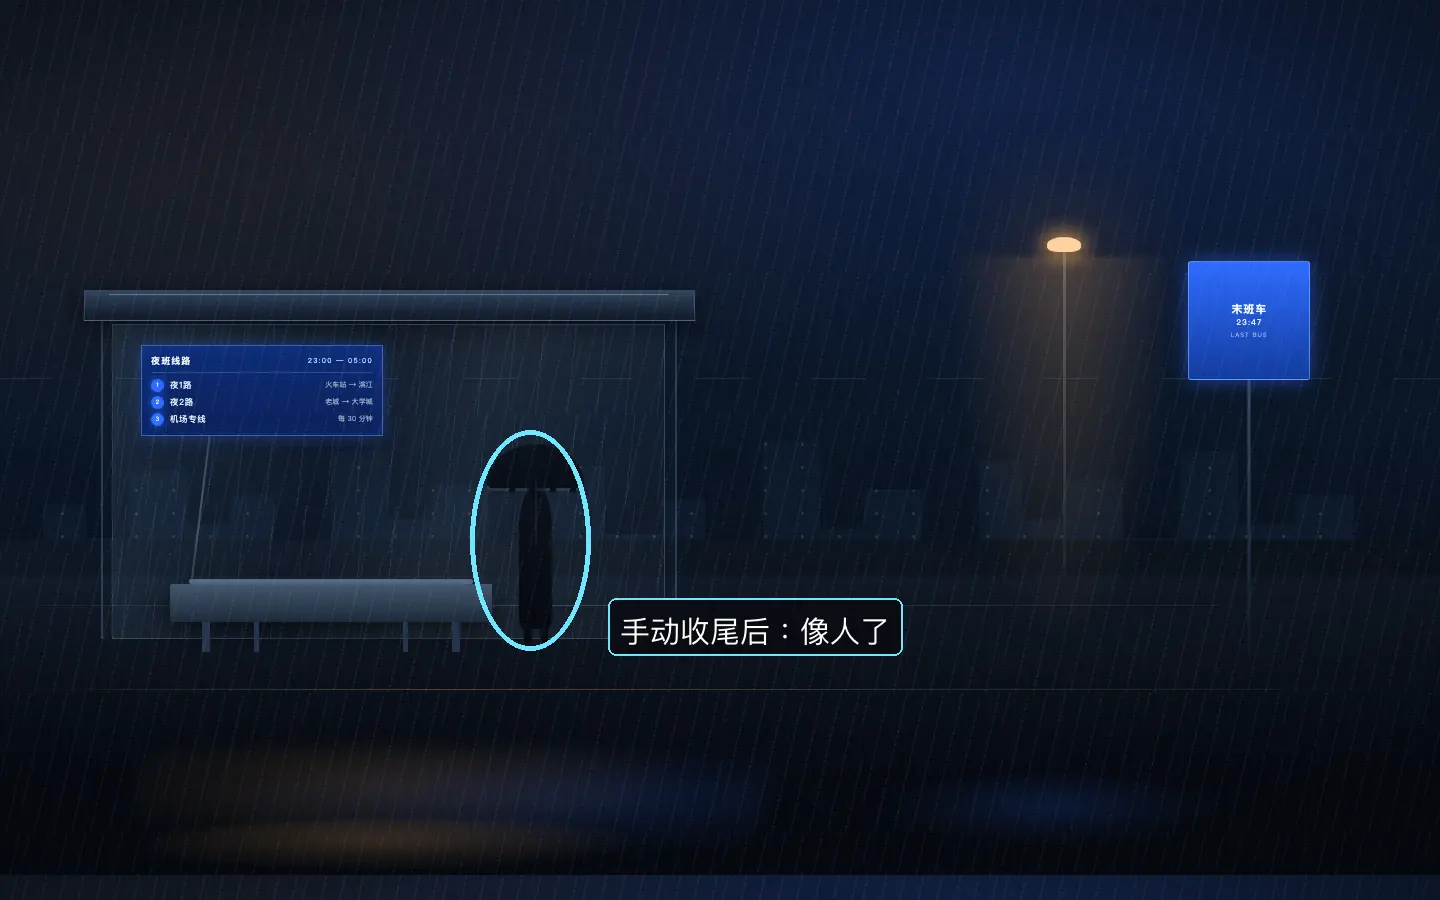
改完能看了,但它离"好看"还差得远:伞面的弧度有点硬,人物的比例也有点僵。这个差距不是提示词能解决的,得有人盯着画面调。
这一轮下来,我的感觉是:一句话能买到氛围,四要素能买到细节,但东西摆得对不对,还得人看。你要求写得越细,它越容易"每条都做到",但做到不等于做对。
四、3D 飞行特斯拉:喷流很唬人,车身像火箭卡丁车
10 月 15 日,特斯拉新一代 Roadster 的"飞行"演示刷屏:冷气推进器、悬停、跳过障碍、像火箭一样降落。演示前夜,特斯拉车辆工程副总裁 Lars Moravy 在 Hagerty 和 Top Gear 的专访里把底牌摊开了:SpaceX 冷气推进器,高压氮气,不燃烧;Rocket 版 600 升储气、约 5 秒推进、充满要 6-7 小时,而且是一次性的,用完得去专用氮气站补气;2028 年才计划投产。
这离"量产飞行汽车"还很远,更像一次工程验证。但画面太适合做 3D 测试了:产品、喷流、悬停、落地,一个都不少。
提示词:
text
角色:你是一名 3D 产品可视化/特效开发者。
背景:特斯拉新一代 Roadster 的"飞行"演示很火,我想做一个网页版 3D 概念图:一辆带冷气推进器的 Roadster 悬停在发射台上,可旋转查看。
任务:用单个 HTML 文件 + Three.js(本地 three.min.js)实现:
1. 一辆低多边形 Roadster:楔形车身、座舱、四个轮子、车尾四个冷气推进器;
2. 悬停动画:车身离地 2 米,四角推进器向下喷白色冷气,地面有反冲粒子;
3. 相机可拖拽旋转、滚轮缩放;空格切换"悬停/落地";
4. HUD:高度、推力、剩余氮气 5.0s;
5. 夜景发射台、冷白光、薄雾;1440×900 下 60fps,不用外部贴图。
输出格式:完整代码 + 自检清单(车身比例、推进器位置、喷流方向、落地姿态)+ 默认相机参数。
这里得先认个错:我的提示词第 1 条写"车尾四个",第 2 条又写"四角推进器",它放 6 个是在同时满足两条------"车头多了两个"有一半是我的锅。
它交出来的画面:
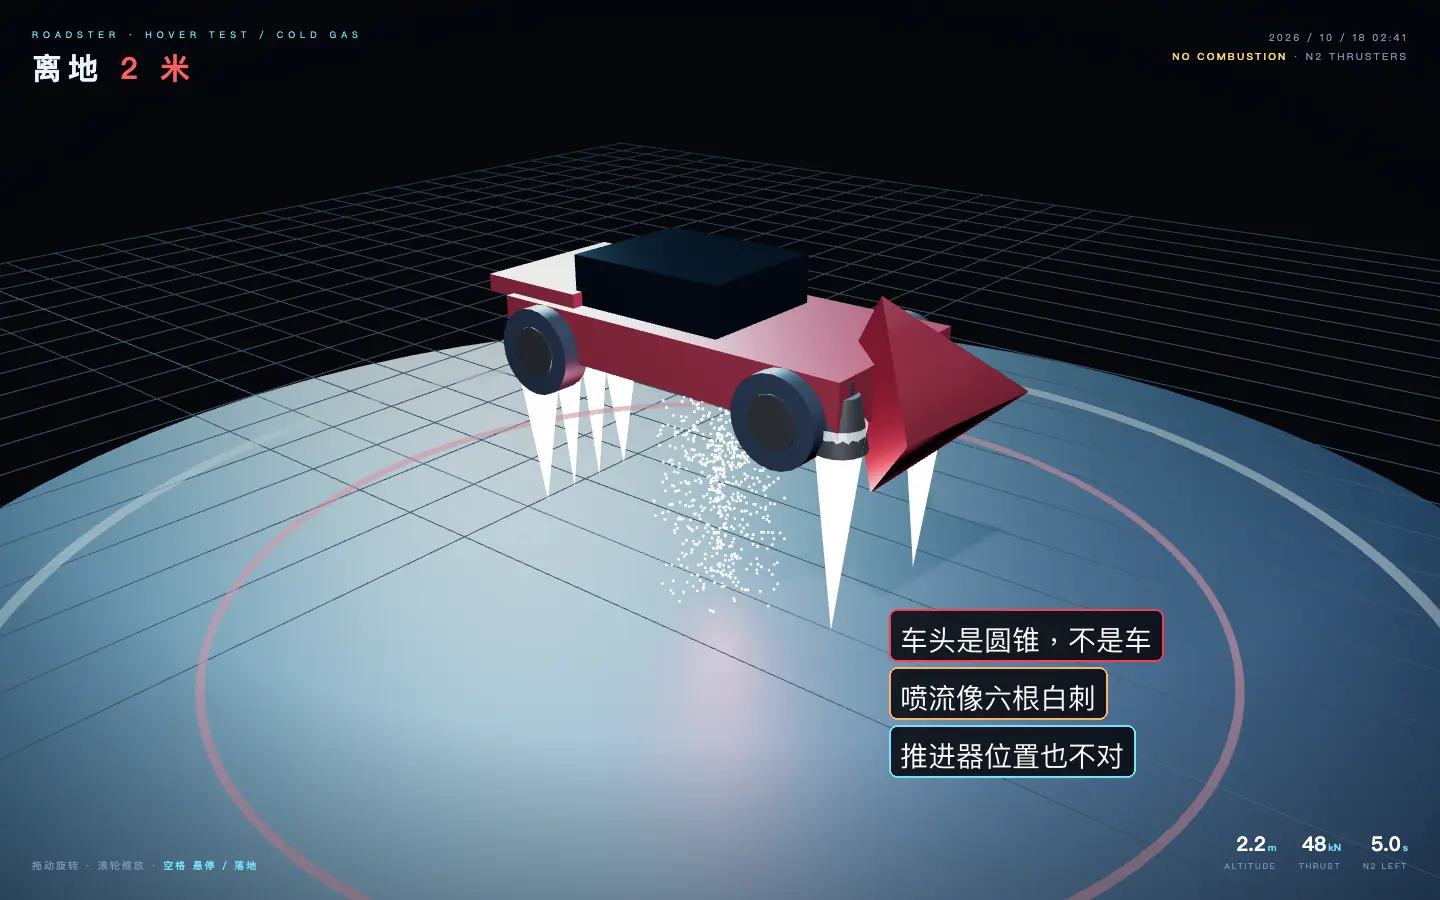
第一眼挺唬人:红色车身、发射台、HUD、六道白色喷流、粒子反冲,氛围是对的。
但细看,它不是 Roadster,是一辆"火箭卡丁车":
- 车头是一个巨大的红色圆锥,像把火箭头插在车头上;
- 座舱是一个黑色方块,没有挡风玻璃的坡度;
- 轮子像四个圆柱,直接挂在车身外面;
- 推进器一共六个,位置也不对:车尾四个挤在一起,车头又多了两个;
- 喷流是六根白色尖刺,不像冷气,像礼花;
- 车身比例是"箱货",不是"跑车"。
3D 这套它确实熟。悬停、喷流、粒子、HUD、发射台都做出来了,也按提示词做了白色冷气、没有加尾焰。可它没主动要参考图,也没核对 Roadster 的比例、推进器位置和喷流形态------这次我没给参考图,它只能凭训练记忆拼一个"跑车"。
还是公交站那个毛病:东西都摆上去了,但摆得不对。只不过 3D 产品的验收更狠------缩略图能骗人,比例骗不了。
五、3D《千里江山图》:相机一摆错,整幅画就散了
第二个硬项目是 3D 版《千里江山图》。选它,是因为它同时考构图、层次、材质和动效,不是堆几个模型就能糊弄过去的。
提示词:
text
角色:你是一名 Three.js 场景/数字艺术开发者。
背景:我在做"古画 3D 重构"系列,第一张是《千里江山图》,需要放在网页首屏,可拖拽旋转。
任务:用单个 HTML 文件 + Three.js(本地 three.min.js)做 3D 青绿山水:
1. 场景必含:层叠山体、开阔水面、石桥、亭台、渔船、树林、雾带、飞鸟;
2. 构图:默认视角要看到"山---水---桥---船"的层次,相机不能穿模;
3. 色彩:青绿山水,纸色天空,远山淡、近山浓;
4. 动效:水面微动、渔船缓慢移动、飞鸟掠过;拖拽旋转、滚轮缩放;
5. 1440×900 下 60fps,不用外部贴图。
输出格式:完整代码 + 自检清单(逐条写满足/不满足)+ 默认相机参数。
第一次直出,打开就是一座山怼脸:
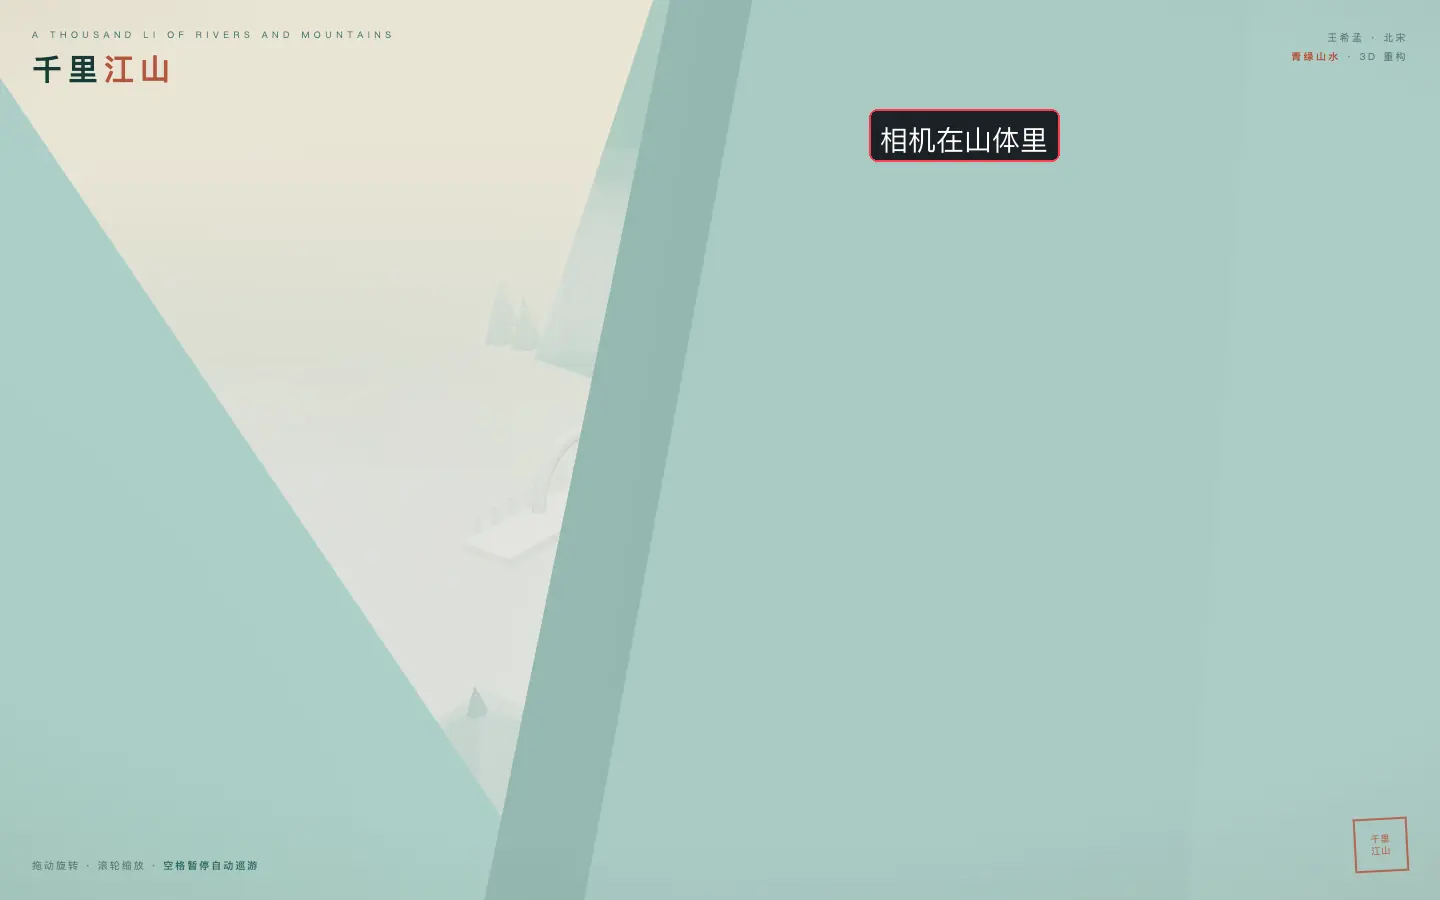
相机在山体里。不是"构图不好",是"相机穿模"这个最基础的问题,它自己没发现。
我把相机半径从 46 拉到 95,目标点往下压、往后挪,才看到全貌:
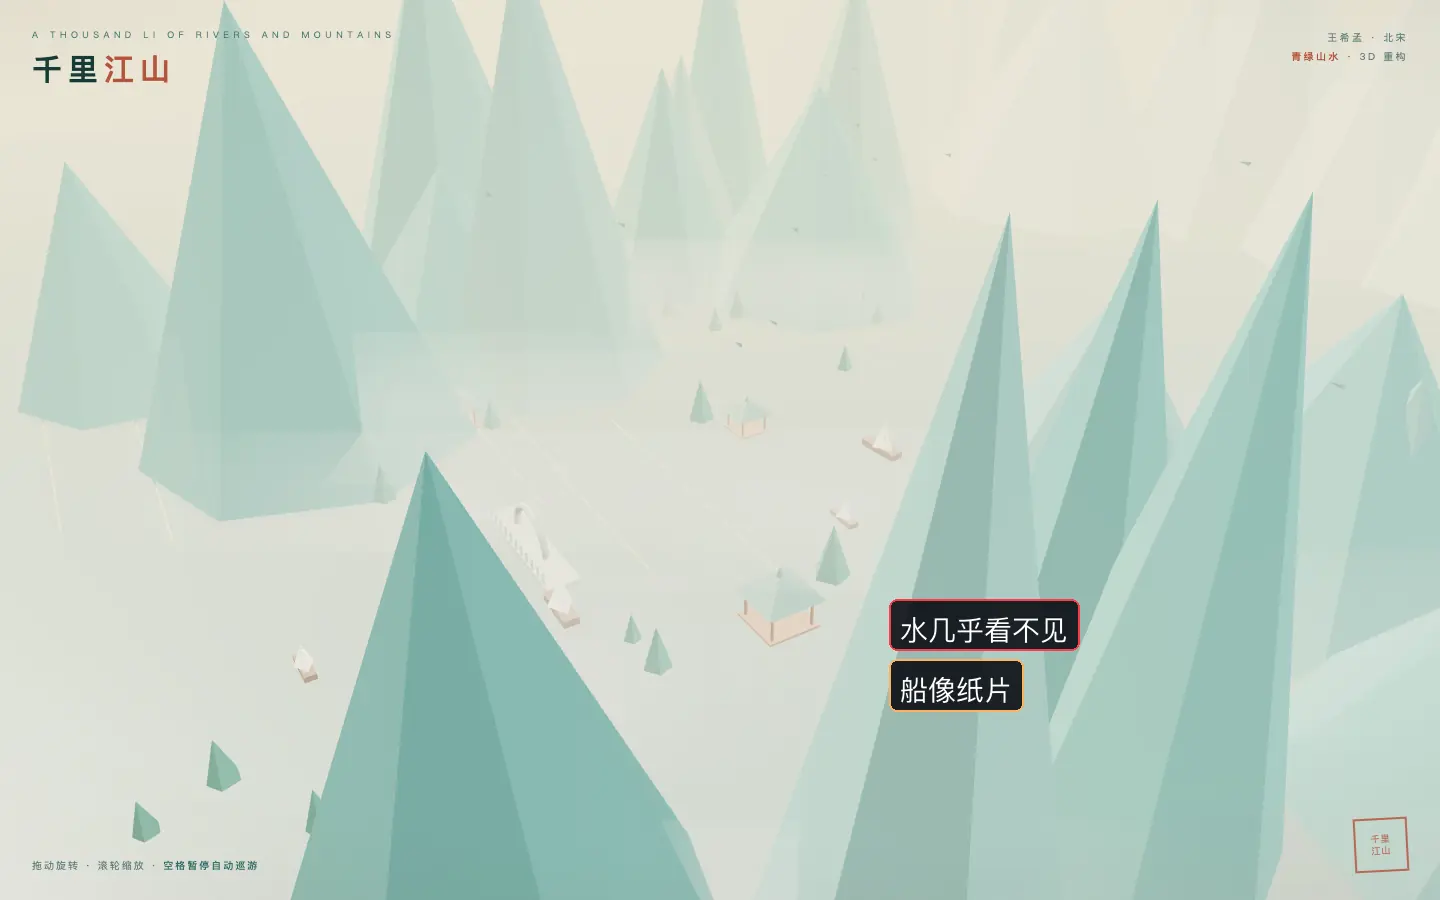
能看出是山水:有山、有船、有亭子、有桥。但也就是"能看出":
- 水面几乎看不见,河和天一个颜色;
- 船像纸片,亭子像积木,桥像一条白线;
- 山体全是同一种圆锥,远近只靠雾在撑,缺少主动的浓淡和留白;
- 雾带像贴上去的白色贴纸,不像空气。
网上刷到过一个 3D 清明上河图的案例,虹桥、街市、游船都能看清;我这版把桥做成了白线,船做成了纸片。不是我提示词写得差,是"堆出来"和"排好"之间,还隔着一个美术导演。
上百个物体、相机轨道、船在动、鸟在飞,它都做得到。可它分不清哪个该在前、哪个该虚、哪个该暗、哪个该留白。
说白了,还是那个问题:东西都堆出来了,但堆得不像一幅画。只不过 3D 的代价更高------2D 画错了还能糊成风格,3D 相机一摆错,整幅画就散了。
X 上有个对比测试也很说明问题:同一个"能抓、能拉、能扔的果冻小熊",Claude Opus 5.5 那组摆着不动时和 1017 差不多,手一碰就分出高下------1017 拉一下会变成薄片,眼睛会飘到脸外,捏动的手感也很糟。成本这边,1017 走非峰时价约 0.32 美元、54 分钟;对面约 7.8 美元、61 分钟。纯算 API 账,1017 便宜 20 多倍;但如果你手上已经有 Claude 订阅,账又是另一回事。
原图是 X 上的第三方测试,我没搬;原帖来自 @wquguru,这里只转述结论。
六、折叠掌机:它能做出产品图,但做不出能上手的产品
第三个硬项目是折叠掌机。选它,是因为它不只考"像不像",还考"结构对不对":铰链在哪、往哪折、按键该长在哪、屏幕该朝哪。
提示词:
text
角色:你是一名 3D 产品可视化开发者。
背景:我在做一个折叠掌机的概念发布页,需要一张能旋转的 3D 产品图,后面还要做折叠动画和爆炸图。
任务:用单个 HTML 文件 + Three.js(本地 three.min.js)做一台折叠掌机:
1. 左右两半机身、中间铰链、两块屏幕、D-pad、双摇杆、ABXY、肩键;
2. 空格切换折叠/展开,E 切换爆炸图;鼠标拖拽旋转、滚轮缩放;
3. 屏幕要有 UI(左屏游戏画面,右屏 HUD),按键位置要符合握持逻辑;
4. 材质:深灰机身、金属铰链、屏幕发光;展台 + 柔光;
5. 1440×900 下 60fps,不用外部贴图。
输出格式:完整代码 + 自检清单(重点检查折叠方向、按键位置、屏幕朝向)+ 默认相机参数。
展开图第一眼看着挺完整:
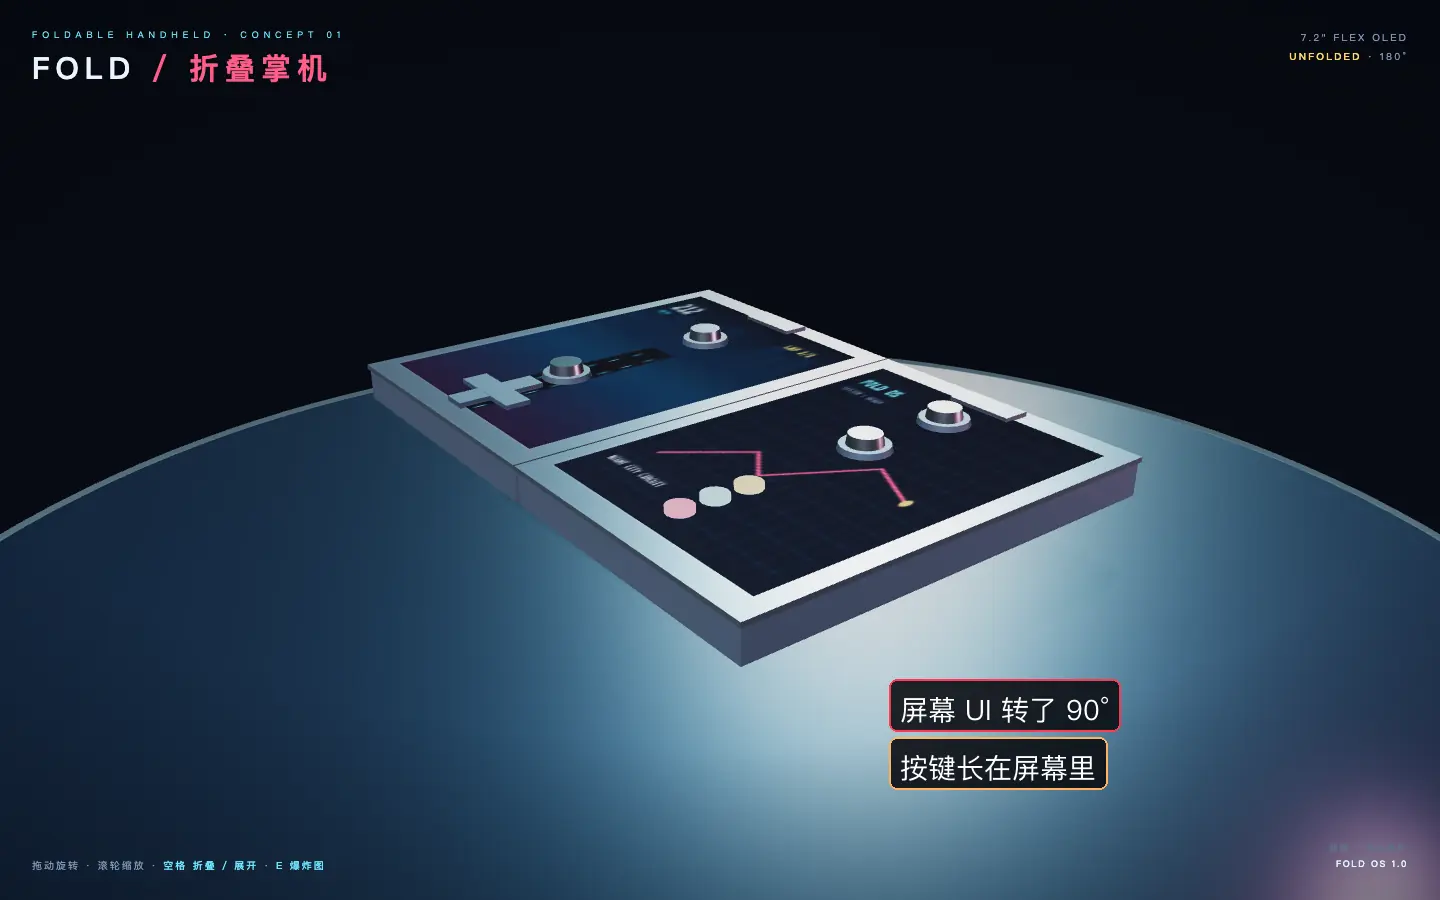
机身、屏幕、摇杆、铰链、展台、柔光都有,甚至有点产品发布图的味道。缩略图发出去,大概率能骗到几个赞。
但细看就露馅了:
- 屏幕 UI 是按 4:3 横屏画的,硬拉到竖屏上,比例全歪了------HUD 被拉成长条,游戏画面也变形;
- D-pad 和摇杆长在屏幕里,不是握持区;
- 白边过厚,像贴上去的;
- 铰链就是一根外露的金属棍;
- 掌机是平躺的,没有握把,拿不起来。
折叠之后更明显:
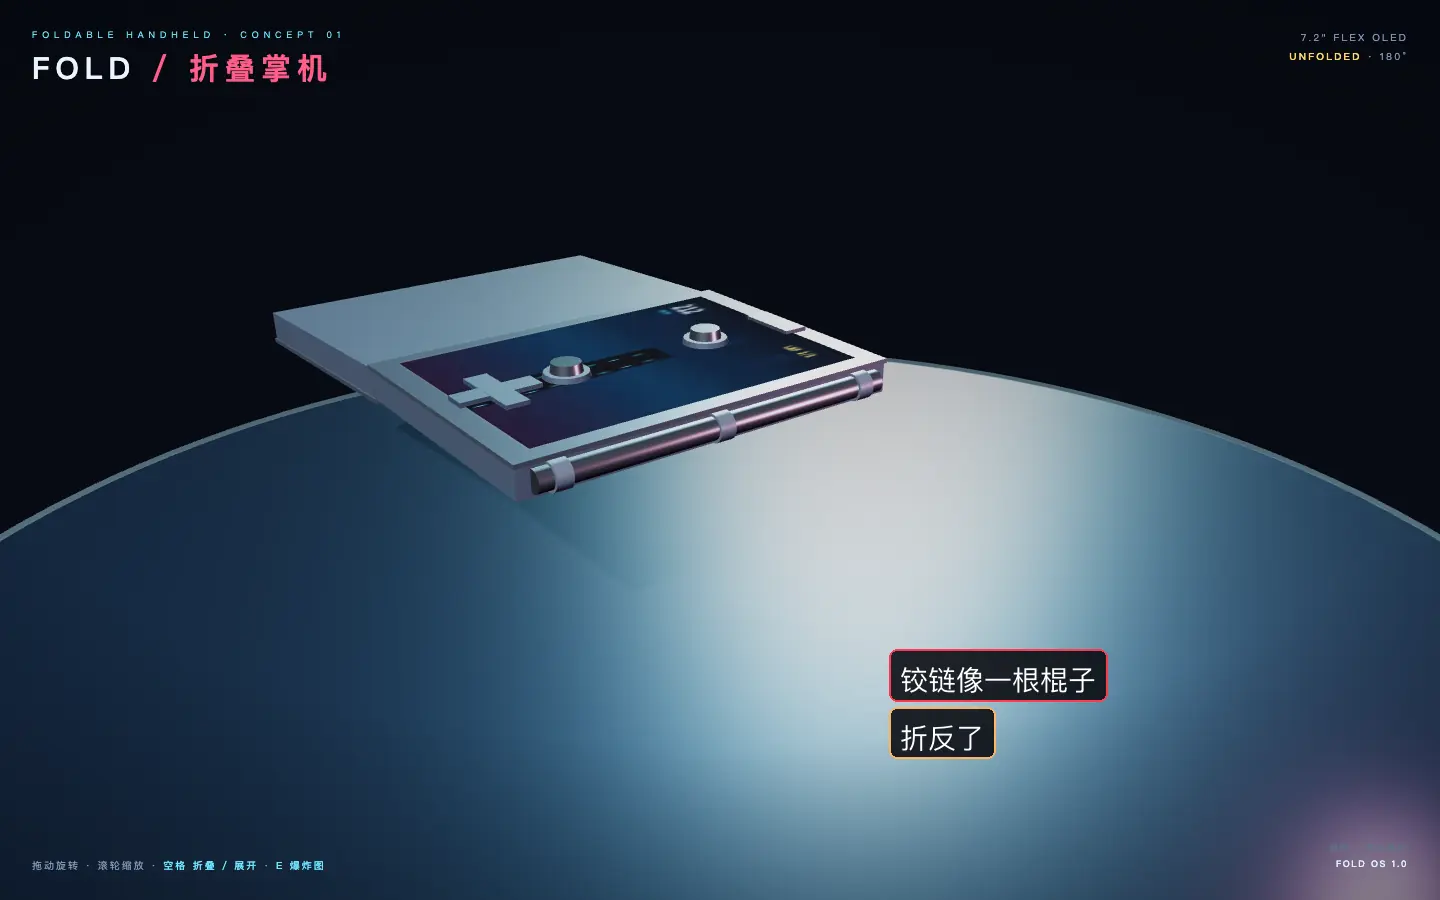
右半绕铰链翻了 180°,又被平移了一整个机身宽度,结果不是合上,而是翻面平摊到左边:背板朝上、屏幕朝下,铰链被甩到接缝外侧;左半的屏幕和按键还露在外面。它做出了"翻转",但没有"合上"这个状态,更没做出"折叠"这个结构。
网上刷到过一台 iPhone Duo 的 3D 案例,折叠、展开、拆解都做出来了;我这台掌机也能翻,但翻完是平摊的,不是合上的。同样的动作,结构对不对,一眼就能看出来。
折叠掌机这个实验最打脸:它能做出产品图,但做不出"能上手的产品"。不是图不够精致,是结构不对------翻完没合上、铰链甩在外面、按键长在屏幕里。
产品图不是看着像就行,得能上手用。屏幕朝向、按键位置、折叠方向、铰链位置,任何一个错了,图越精致,越容易误导。
七、跑分之外:便宜六成是怎么算出来的
"便宜六成"这句话,很容易被误读成 API 降价。不是。
官方价格页上,deepseek-flash 的单价没变:
| 计费项 | 空闲时段 | 高峰时段 |
|---|---|---|
| 输入(缓存命中)/ 百万 tokens | 0.02 元 | 0.04 元 |
| 输入(缓存未命中)/ 百万 tokens | 1 元 | 2 元 |
| 输出 / 百万 tokens | 4 元 | 8 元 |
便宜的是"完成一个任务的总成本"。TechWeb 的测算是:DeepSWE v1.1 上,1017 最高档单任务约 1.3 元,9 月版最高档约 3.3 元,降了约六成;最便宜档不到 1 元。
原因不神秘:输出更短、任务跑得更快。官方这次特意强调"缩短任务运行时间与输出长度",轮次和重试自然也会少一些。再加上空闲时段半价、空闲时段缓存命中输入只要 0.02 元/百万 tokens(高峰 0.04 元),重度 Agent 用户的账单会明显下来。
但别把"单任务 1.3 元"当成你的成本。你的任务如果输入 20 万 tokens、输出 2 万 tokens,高峰时段缓存未命中的账是:
- 输入:0.2M × 2 元 = 0.4 元
- 输出:0.02M × 8 元 = 0.16 元
- 合计:0.56 元
同样的量,空闲时段 0.28 元;如果输入全走缓存命中,输入费只要 0.008 元,合计 0.168 元。同一个任务,光时段和缓存就能差出三倍多------这和模型单价是两回事。
第三方这边,Artificial Analysis 给 9 月版 V4.1 Flash 的智能指数是 39,在 120 个模型里排第 9,智能指数单任务成本 0.49 美元(AA 页面当前口径),输出速度约 176 tokens/s(图里是 high 档;max 档约 227)。Vals AI 在 9 月发布时给它的成绩是 57.86%,56 个模型里第 15,单次测试约 0.30 美元;现在 Vals 页面是 51.32%(#26/49,$0.332/次),两个数别混着用。1017 目前还没有 Artificial Analysis 的独立排名;Vals 的 57.86% 也是 9 月版的成绩,不是 1017。网上流传的 AA 智能指数"45-46"只是猜测,不是实测。
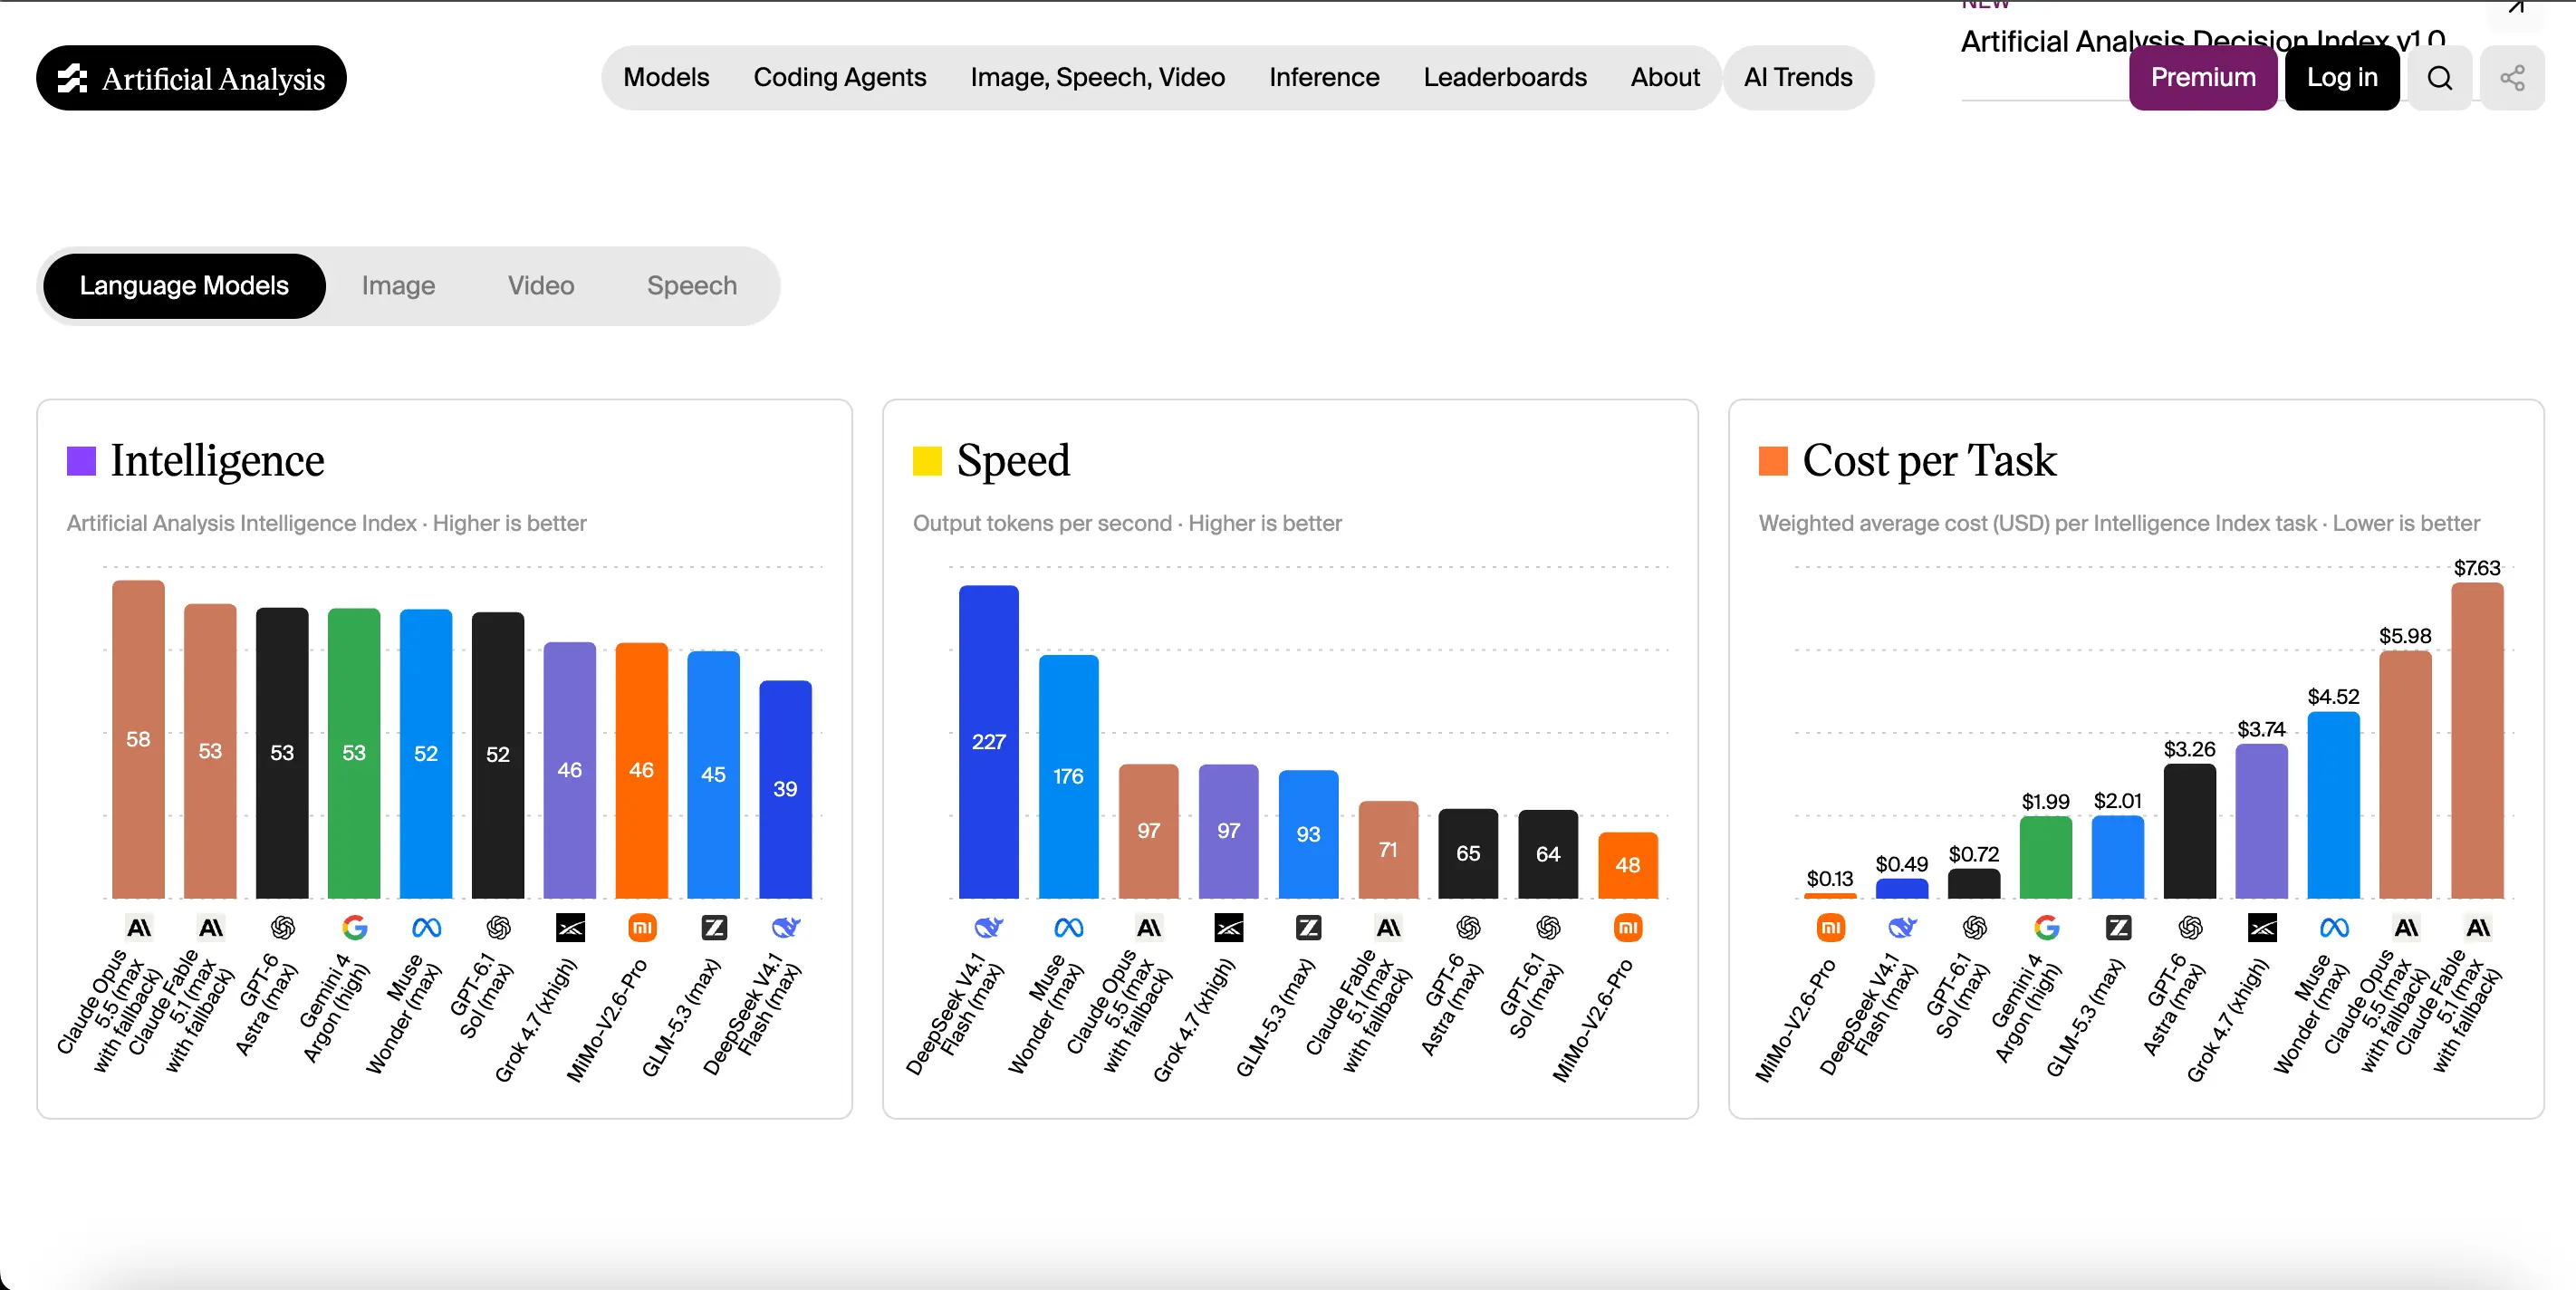
这里有个很容易被带偏的点:官方表和 AA 指数不是一套东西。AA 的智能指数由 10 项评测加权,和 DeepSeek 官方 11 行表里同版本、同口径的只有 Terminal-Bench 4.0;HLE 两边都有,但子集和跑法不同,不能直接对比。也就是说,官方表里的 77% 再漂亮,也不能直接换算成"综合第一"。
看跑分可以激动,做选型还是得看第三方复测。
八、谁该换,谁再等等
先说该换的。
如果你在做原型、独立开发、3D 展示页、产品概念图,或者需要一个便宜的长上下文 Agent 帮你读仓库、跑测试,1017 值得试。它的交付能力已经不是"补全几行代码",而是"给你一个能跑的初版"。
如果你已经在用 DeepSeek Harness,升级到 0.2.1-rc.1 以上,选带 1017 标记的模型就行。腾讯 CodeBuddy、WorkBuddy 也做了专项适配。
再说再等等的。
第一,强合规场景。金融、医疗、法务这类任务,错一次的代价远大于省下的 token 钱,而且更依赖可审计、可复现的流程,不是单看跑分。1017 在 HLE 上也仍然落后 Claude Opus 5 一大截,复杂知识和推理任务别只盯着 DeepSWE。
第二,没有测试的老项目重构。第三方反馈里有一条很扎眼:1017 在推理增强的同时,会出现"指令遵循的微调偏离",比如为了简化代码,擅自删掉某个它认为不重要的功能组件------社区里有人明确要求保留的骰子悬浮预览,就被整块删掉。有开发者形容它"更聪明但更难驾驭"。没有测试兜底,这种"聪明"很危险。
第三,产品级 3D、交互式 3D、像素级还原。静态图它能给你惊喜,动起来的手感、结构、相机,还是得人盯着调。
我自己的用法是把它当实习生:可以让它写初版、补测试、做 demo,但合并前必须过三件事------跑测试、看 diff、亲手玩一遍。
以 2026 年 10 月的版本为准,1017 适合当"能交付初版的实习生",不适合当"不用验收的外包"。
九、两个没法绕开的问题
你可能会问:1M 上下文是真的吗?
官方价格页写的是 1M 上下文、最大 384K 输出。我这次只跑了常规项目,没有把 1M 塞满,所以不给"1M 实测通过"的结论。想验证的话,丢一个接近 100 万 tokens 的仓库或文档进去,问一个只在中间偏后位置出现的问题(比如第 60 万字附近),看它能不能引用到正确段落、会不会漏掉中间部分。这比看宣传语有用。
你可能会问:那程序员是不是又要被替代了?
短期不会。它把"写"的成本降下来了,把"验收"的成本抬上去了。会写代码的人反而更容易用它,因为你能一眼看出哪里不对:伞面为什么像箭头、特斯拉为什么像火箭卡丁车、相机为什么在山里。这些判断,模型自己不会主动做。
我是程序员天天困,持续分享编程干货。觉得有用的话记得点赞收藏和关注~也欢迎在评论区聊聊:你觉得 DeepSeek-V4.1-Flash-1017 更适合接哪类项目,验收时你最怕它擅自改什么?