150毫秒和2400毫秒:同一 Agent 任务的两种延迟
编排器在入口接收任务后450毫秒收到第一个模型token,到2400毫秒才产生用户能采用的结果,3000毫秒才确认任务完成。若从发起模型调用计时,首token时间是150毫秒。这些数字可以同时正确。
这是一条为本文构造的时间线,不来自生产服务。它把问题压缩得很具体:150 毫秒从哪里开始,450 毫秒遗漏了什么,2400 毫秒和 3000 毫秒分别代表哪一种结果?先把端点说清楚,才能决定该展开哪段 trace。
下面的产物是一份可以直接运行的区间演算。它既能复算这条时间线,也会拒绝跨时钟域相减,并演示并行工具的 span 不能机械相加。它不测模型,不等待真实网络,也不据此推断服务容量。
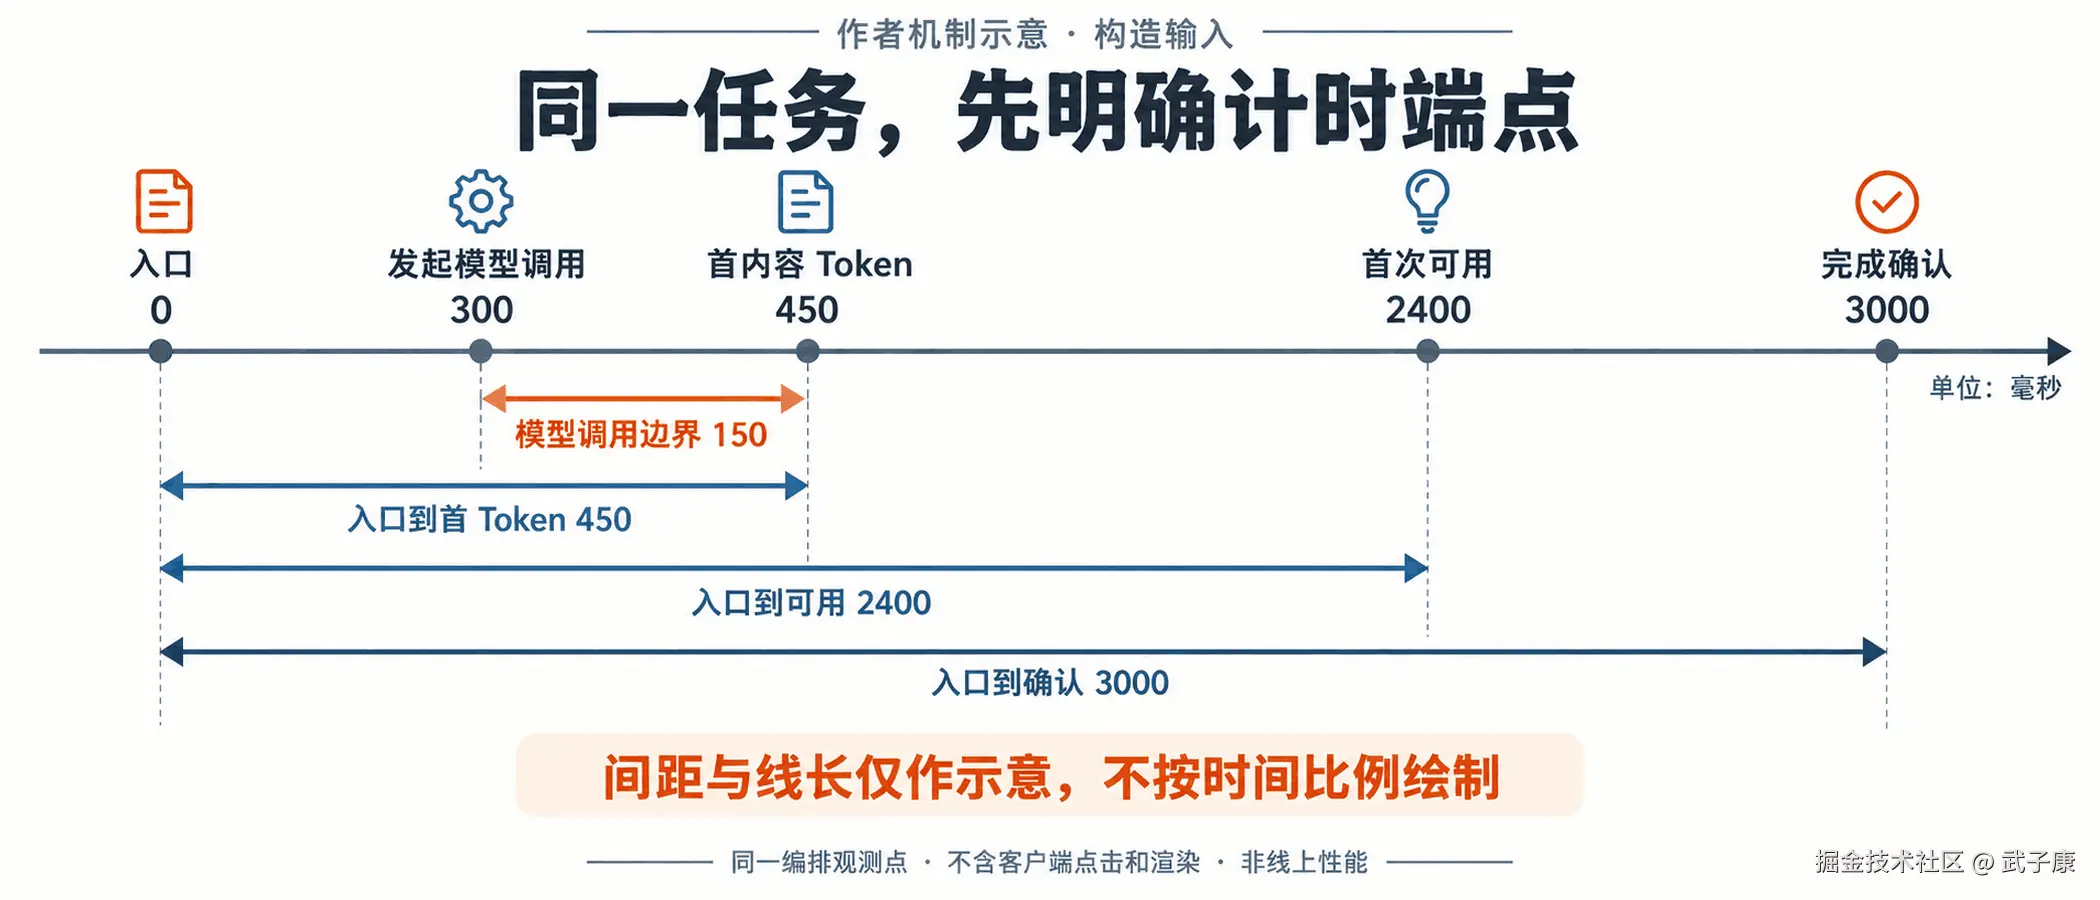
同一条记录,三个"快"的边界
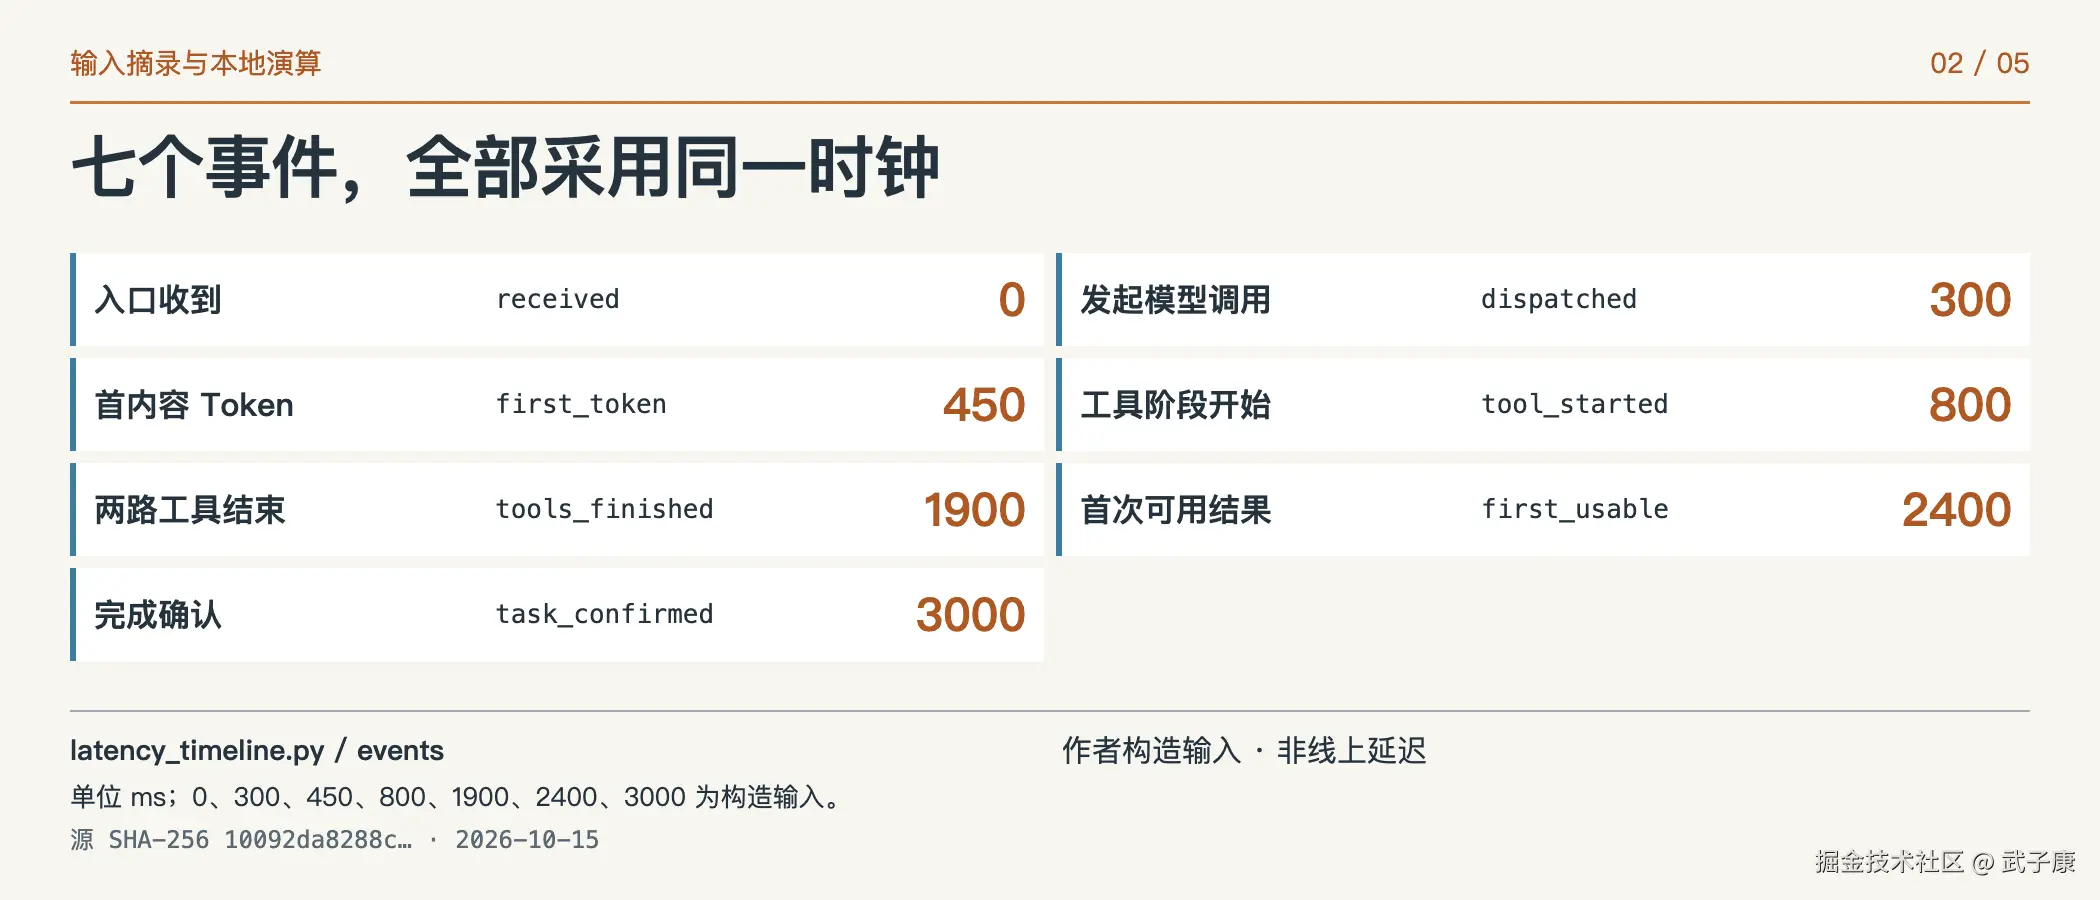
本例假定全部事件由同一个编排观测点记录,单位为毫秒,使用同一个单调时钟域。起点是编排入口接收请求,不是用户点击按钮;因此不包含点击到入口之间的客户端和网络时间。
| 事件 | 相对入口的毫秒数 | 本例中的精确定义 |
|---|---|---|
| T0 received | 0 | 编排入口收到这个任务 |
| T1 dispatched | 300 | 入口排队结束,编排器发起模型调用 |
| T2 first_token | 450 | 编排器收到第一个实际内容 token |
| T3 tool_started | 800 | 并行工具阶段开始 |
| T4 tools_finished | 1900 | 本次结果需要的两路工具均已返回 |
| T5 first_usable | 2400 | 编排器产生通过本例可用性规则的第一份结果 |
| T6 task_confirmed | 3000 | 编排器已取得本例规定的权威完成确认 |
七个事件是这个有限案例的记录方案,不是所有 Agent 必须遵守的事件顺序。纯问答可能没有工具,异步流程可能先报告受理状态,流式结果也可能在工具全部结束前已有一部分可用信息。换场景时必须重新定义端点,不能硬套 T0 到 T6。
在这条记录里,排队是 T1-T0=300,从模型调用发起到收到首个 token 是 T2-T1=150,从编排入口到首个 token 是 T2-T0=450。本文把前者明确命名为 model_boundary_ttft_ms,后者命名为 ingress_first_token_ms。
150 毫秒仍然包含编排器到模型服务的调用与回传边界,不能再分解成模型内部排队、prefill 或纯计算时间。供应商若从接收请求、发起 HTTP、首字节或首 chunk 等其他位置计时,得到的数不能直接放在同一列比较。接收到角色标记、心跳或占位 chunk,也不能在没有解析规则时当作实际内容 token。
"首次可用"需要另一项定义。本例设想用户查询预约改期结果:模型说"我来看看"不算可用结果,拿到资源查询结果并形成可采用的候选时间才算 T5;权威业务系统确认选定动作完成才算 T6。这只是用来解释两个端点的虚构任务语义,代码中的时间值已经人工给定,并没有运行这套业务服务,也没有自动评判文本。
若产品把"收到真实排队状态"定义为有效进展,可以另外记录首次有效进度事件。它有价值,却仍不能替代本例的首次可用结果。界面显示"已受理"与业务已经完成,回答的是两件事。
先确认这几个事件是不是同一份工作
在复制数字之前,还要看它们是否属于同一个任务与版本。若入口记录来自任务甲,首 token 来自重试后的任务乙,最终确认来自旧任务的迟到回调,时间顺序可能看上去合理,却没有形成一条可解释的用户旅程。示例里只有一份明确的七事件记录;真实采集至少需要把事件名、任务标识、尝试标识、观测点、时钟域和资源版本一起保留。
对"第一"也要固定判断规则。接收器第一次看到内容事件、前端第一次画出内容、用户第一次得到可采用结果,是三个位置。如果服务端在450毫秒记录收到 token,前端缓冲到700毫秒才显示,它们都不能被误标成同一个端点。本文所有数字来自编排观测点,没有采集浏览器渲染时间;要验证真实界面体验,必须增加客户端事件。
业务确认同样需要写出对象。本例的3000毫秒表示编排器已经拿到规定的权威确认,不表示所有通知消费者都处理完,更不能因为连接正常关闭就自动填这个值。若权威系统只给受理编号,事件应保持"已受理";没有查询到完成证据时,确认延迟应是未知或尚未结束,不能拿最后一段文案的时间补齐。
顺着相邻区间找缺口,不给它们乱贴阶段名
七个事件产生六个相邻区间:300、150、350、1100、500、600 毫秒,总和恰好是 3000。这是因为它们在同一时钟域内连续覆盖 T0 到 T6;不是因为排队、模型、工具、回传在真实系统中必然首尾相接。
其中 300 毫秒有明确的入口排队定义。若只在工作线程取到任务后开启根 span,仪表盘将从 T1 开始,用户实际经历的入口等待便没有进入这份执行耗时。修正方法是记录入队和出队事件,或让覆盖请求的观测区间包含等待。没有入队时间时,应报告"入口排队未知",不能把缺失补成零。
350 毫秒只是"首 token 到工具阶段开始"。它可能包含后续生成、参数解析、编排决策、调度和其他等待。500 毫秒只是"工具阶段结束到首次可用结果"。如果没有更细证据,就不应把前者全部归因于 decode,把后者全部归因于网络。
这个区别直接影响下一步行动。看到工具阶段 1100 毫秒,只能先展开工具相关观测;要决定扩容、改连接池还是改检索方式,还需要对应的排队、执行和依赖证据。同样,首 token 提前不说明 T4 到 T6 的等待已经缩短。
OpenTelemetry 的 Trace API 用带起止时间的 span 表达操作,并允许细分子操作或记录带时间戳的事件。这提供了记录手段;本例的"首次可用"和"完成确认"仍由产品与权威状态定义,并非遥测协议自动给出。OpenTelemetry Trace API
缺少一个端点,比多一张面板更值得先修
假设这条构造记录丢了T1。仍然能算入口到首 token 的450毫秒,也能算首次可用的2400毫秒;但300毫秒入口排队和150毫秒模型边界耗时就失去了各自的证据。把450全部登记为模型慢,会把排队问题错误分配给推理服务。正确处理是保留已知区间,同时明确细分未知,下一轮只补"出队并发起调用"的观测。
再假设丢的是T6。T5的2400毫秒仍有含义,但任务完成延迟不能报成2400。即使后来查到业务确实完成,也要说明查到的是"观察到完成"的时刻,还是业务系统提供的原始完成时刻。轮询间隔会让两者不同;只有具备时钟可比性和事件语义,才能把原始时间放回当前时间轴。
事件到达日志的顺序也不一定是发生顺序。批量导出、异步写入会延后接收,因此需要区分事件携带的发生时间和采集器收件时间。这个最小脚本没有接收异步日志,只验证已给定的有限记录;遇到丢失、重复或乱序的真实输入,先做关联和完整性判断,再计算,不能为了得到一行结果就偷偷排序所有事件或把负数截成零。
两路工具一共忙了 1700 毫秒,用户只等了 1100 毫秒
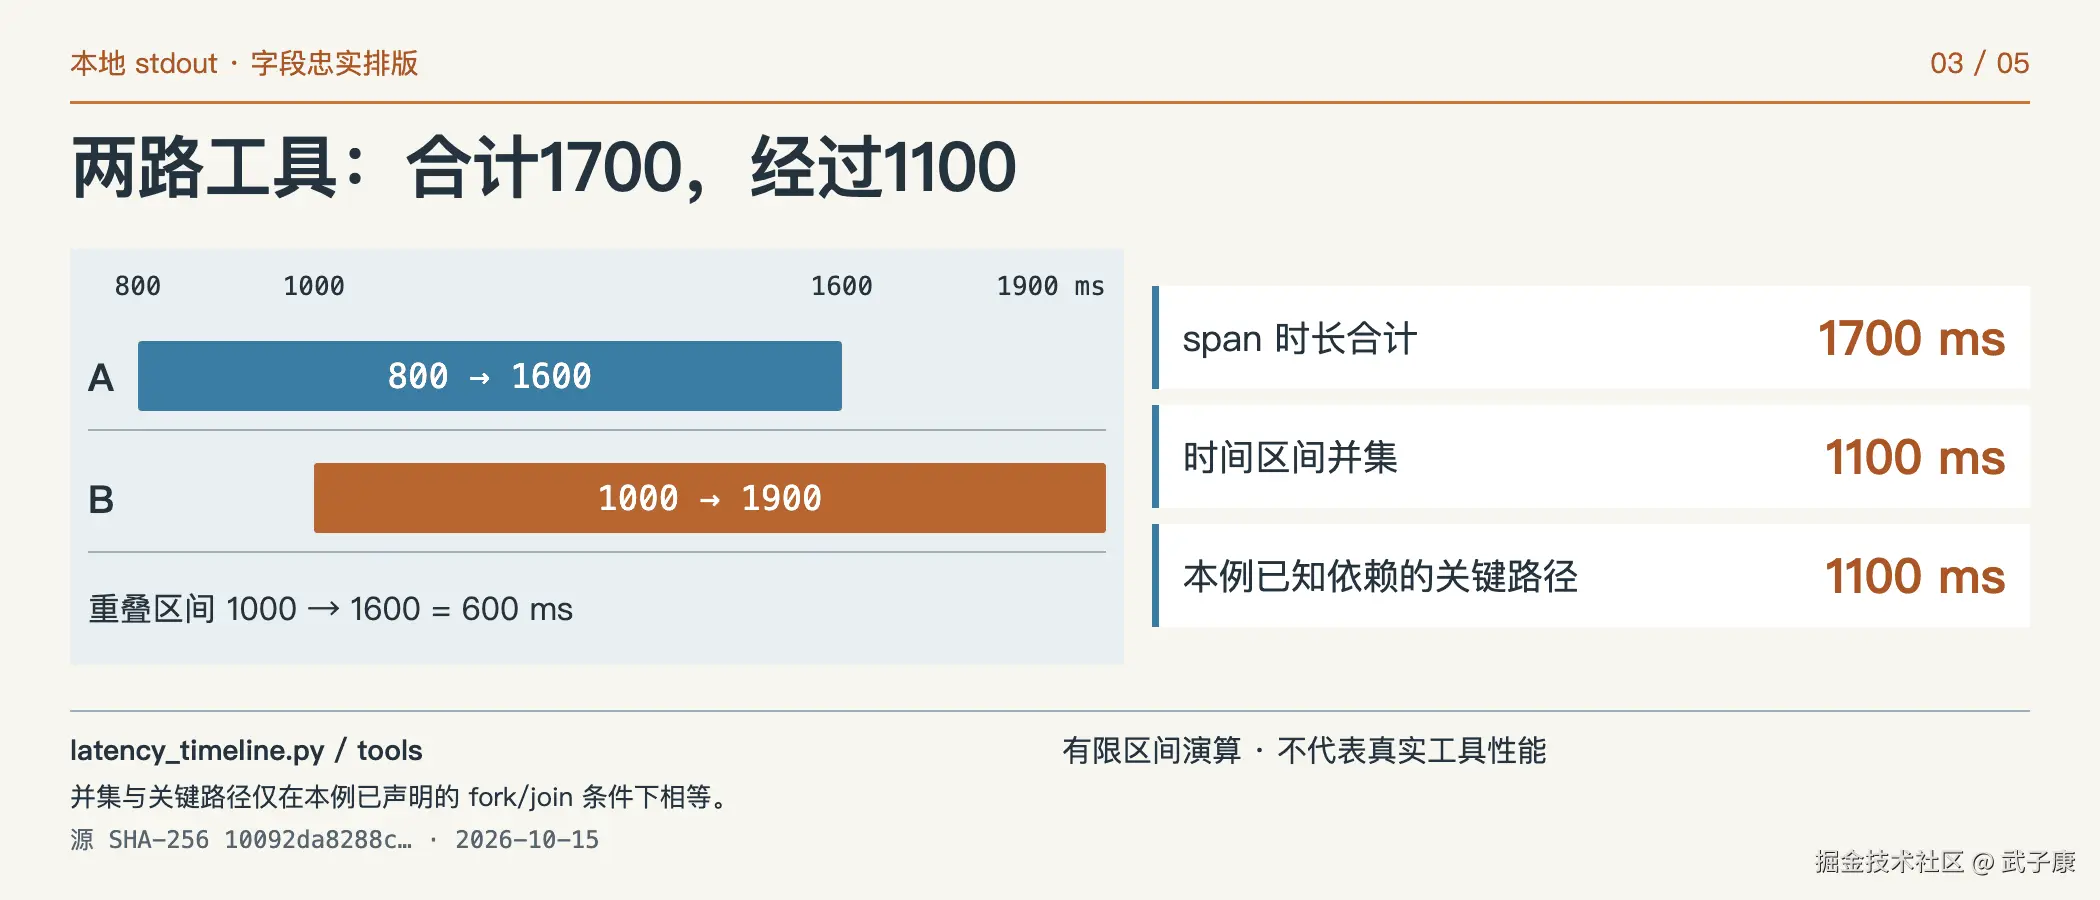
在 T3 到 T4 的阶段中,构造两路必需工具:
| 工具 | 开始 | 结束 | span 时长 |
|---|---|---|---|
| A | 800 | 1600 | 800 |
| B | 1000 | 1900 | 900 |
A、B 重叠了 600 毫秒。span 时长之和是 1700 毫秒,时间轴覆盖区间的并集是 1100 毫秒。前者可以用来描述两路操作耗时的合计,不能称为用户经过的墙钟等待,也不等于 CPU 实际工作量。
这个案例还明确了依赖关系:工具阶段在 800 毫秒 fork,B 等到 1000 才开始,两路结果都返回后才能 join;没有其他必需依赖。因此关键路径是 max(A 的 800, B 启动等待 200 + B 的 900)=1100。
并集与关键路径在本例恰好相等。一般情况下它们并不等价:并集只统计"至少一个已记录操作活跃"的时间,关键路径还取决于依赖、必要的等待、调度空隙和未插桩工作。两个工具之间如果隔着无人记录的等待,区间并集会漏掉它;若工具本来不阻塞用户结果,其 span 也不应该被自动计入完成关键路径。只有端点没有依赖图,不能声称算出了真实系统关键路径。
本例算并集,是为了暴露"子 span 相加会重复计时"的错误;不是提供一个通用分布式关键路径算法。
可以再做一个纯推导来检查自己的解释:若A仍在800到1600运行,B改成1700到1900,两个span并集只有1000毫秒,但从fork的800等到join的1900仍经过1100毫秒,中间有100毫秒没有任何已记录工具活跃。仅凭并集把这个阶段报成1000,就把间隙删掉了。这组变体不是脚本的新实测结果,只是依据区间定义作的算术反例。
还要避免同时累计父子span。覆盖800到1900的父阶段本身是1100毫秒,已经包含A、B;把父阶段再加上1700的子span总和,会得到2800,这不是工具阶段的墙钟时间。相反,把父阶段减去所有子span合计还会得到负数,也不能解释为"框架开销为负"。需要估算未被子操作覆盖的时间,应先求受约束子区间的并集,再考虑其余工作是否确实在父阶段内。
优化对象因此要依赖因果关系。本例A提前结束300毫秒,而B仍在1900结束,join可能完全不变;B在关键路径上的等待缩短才可能改变这次join。真实系统还可能因资源竞争改变别的区间,所以这是定位候选动作的理由,不是承诺某个优化一定带来同等端到端收益。
一段完整可运行的时间演算
把下面代码保存为 latency_timeline.py,用 Python 3 运行即可,无需安装库。边界断言覆盖同域区间、嵌套 span、空区间集合、负时长和跨时钟域输入。不要使用 python -O,否则 Python 的 assert 自检会被移除。
python
"""Constructed timestamps only; this is arithmetic, not a service benchmark."""


def elapsed(start, end):
    # Each event is (clock_domain, milliseconds).
    if start[0] != end[0]:
        raise ValueError("clock domains differ")
    if end[1] < start[1]:
        raise ValueError("time goes backwards")
    return end[1] - start[1]


def covered_ms(spans):
    if not spans:
        return 0
    clock = spans[0][0]
    for domain, start, end in spans:
        elapsed((domain, start), (domain, end))
        if domain != clock:
            raise ValueError("clock domains differ")
    merged = []
    for _, start, end in sorted(spans, key=lambda item: item[1]):
        if merged and start <= merged[-1][1]:
            merged[-1][1] = max(merged[-1][1], end)
        else:
            merged.append([start, end])
    return sum(end - start for start, end in merged)


def rejected(call, message):
    try:
        call()
    except ValueError as error:
        assert str(error) == message
    else:
        raise AssertionError("invalid timestamps were accepted")


def main():
    clock = "coordinator-A-monotonic"
    events = {
        "received": (clock, 0),
        "dispatched": (clock, 300),
        "first_token": (clock, 450),
        "tool_started": (clock, 800),
        "tools_finished": (clock, 1900),
        "first_usable": (clock, 2400),
        "task_confirmed": (clock, 3000),
    }
    names = list(events)
    adjacent = [elapsed(events[a], events[b])
                for a, b in zip(names, names[1:])]
    assert adjacent == [300, 150, 350, 1100, 500, 600]
    queue = elapsed(events["received"], events["dispatched"])
    model_ttft = elapsed(events["dispatched"], events["first_token"])
    first_token = elapsed(events["received"], events["first_token"])
    usable = elapsed(events["received"], events["first_usable"])
    complete = elapsed(events["received"], events["task_confirmed"])
    assert (queue, model_ttft, first_token, usable, complete) == (
        300, 150, 450, 2400, 3000)
    assert sum(adjacent) == complete
    print(f"queue_ms={queue}; model_boundary_ttft_ms={model_ttft}; "
          f"ingress_first_token_ms={first_token}")
    print(f"first_usable_ms={usable}; confirmed_task_ms={complete}")
    print("adjacent_ms=" + ",".join(map(str, adjacent)))

    tools = [(clock, 800, 1600), (clock, 1000, 1900)]
    work_sum = sum(end - start for _, start, end in tools)
    union = covered_ms(tools)
    # Only this fixture's fork/join has no hidden work or additional dependency.
    critical = max(1600 - 800, (1000 - 800) + (1900 - 1000))
    assert (work_sum, union, critical) == (1700, 1100, 1100)
    assert covered_ms([(clock, 0, 10), (clock, 2, 4)]) == 10
    assert covered_ms([]) == 0
    print(f"tool_span_sum_ms={work_sum}; tool_union_ms={union}; "
          f"fixture_critical_path_ms={critical}")

    # A separate task has two attempts; it is not the seven-event task above.
    attempts = [(0, 700, "failed"), (900, 3000, "succeeded")]
    durations = [end - start for start, end, _ in attempts]
    task_total = attempts[-1][1] - attempts[0][0]
    retry_gap = attempts[1][0] - attempts[0][1]
    assert durations == [700, 2100]
    assert task_total == sum(durations) + retry_gap == 3000
    print(f"separate_retry_task_ms={task_total}; attempt_ms=700,2100; "
          f"retry_gap_ms={retry_gap}")

    rejected(lambda: elapsed((clock, 10), ("worker-B-monotonic", 20)),
             "clock domains differ")
    rejected(lambda: elapsed((clock, 10), (clock, 9)),
             "time goes backwards")
    rejected(lambda: covered_ms([(clock, 0, 2), ("worker-B", 2, 3)]),
             "clock domains differ")
    print("boundaries=passed; fixture_only=true; live_service=false")


if __name__ == "__main__":
    main()
在附带示例的包目录执行下列命令;本次本地 Python 版本为 3.13.5,实际退出码为 0:
bash
python3 examples/latency_timeline.py实际标准输出:
text
queue_ms=300; model_boundary_ttft_ms=150; ingress_first_token_ms=450
first_usable_ms=2400; confirmed_task_ms=3000
adjacent_ms=300,150,350,1100,500,600
tool_span_sum_ms=1700; tool_union_ms=1100; fixture_critical_path_ms=1100
separate_retry_task_ms=3000; attempt_ms=700,2100; retry_gap_ms=200
boundaries=passed; fixture_only=true; live_service=false
这份输出验证的是算术和明确列出的错误边界。把数字换成另一组构造数据,输出就会变化;运行脚本很快,也不意味着目标系统达到了这些延迟。
重试属于同一个任务,但不是同一次尝试
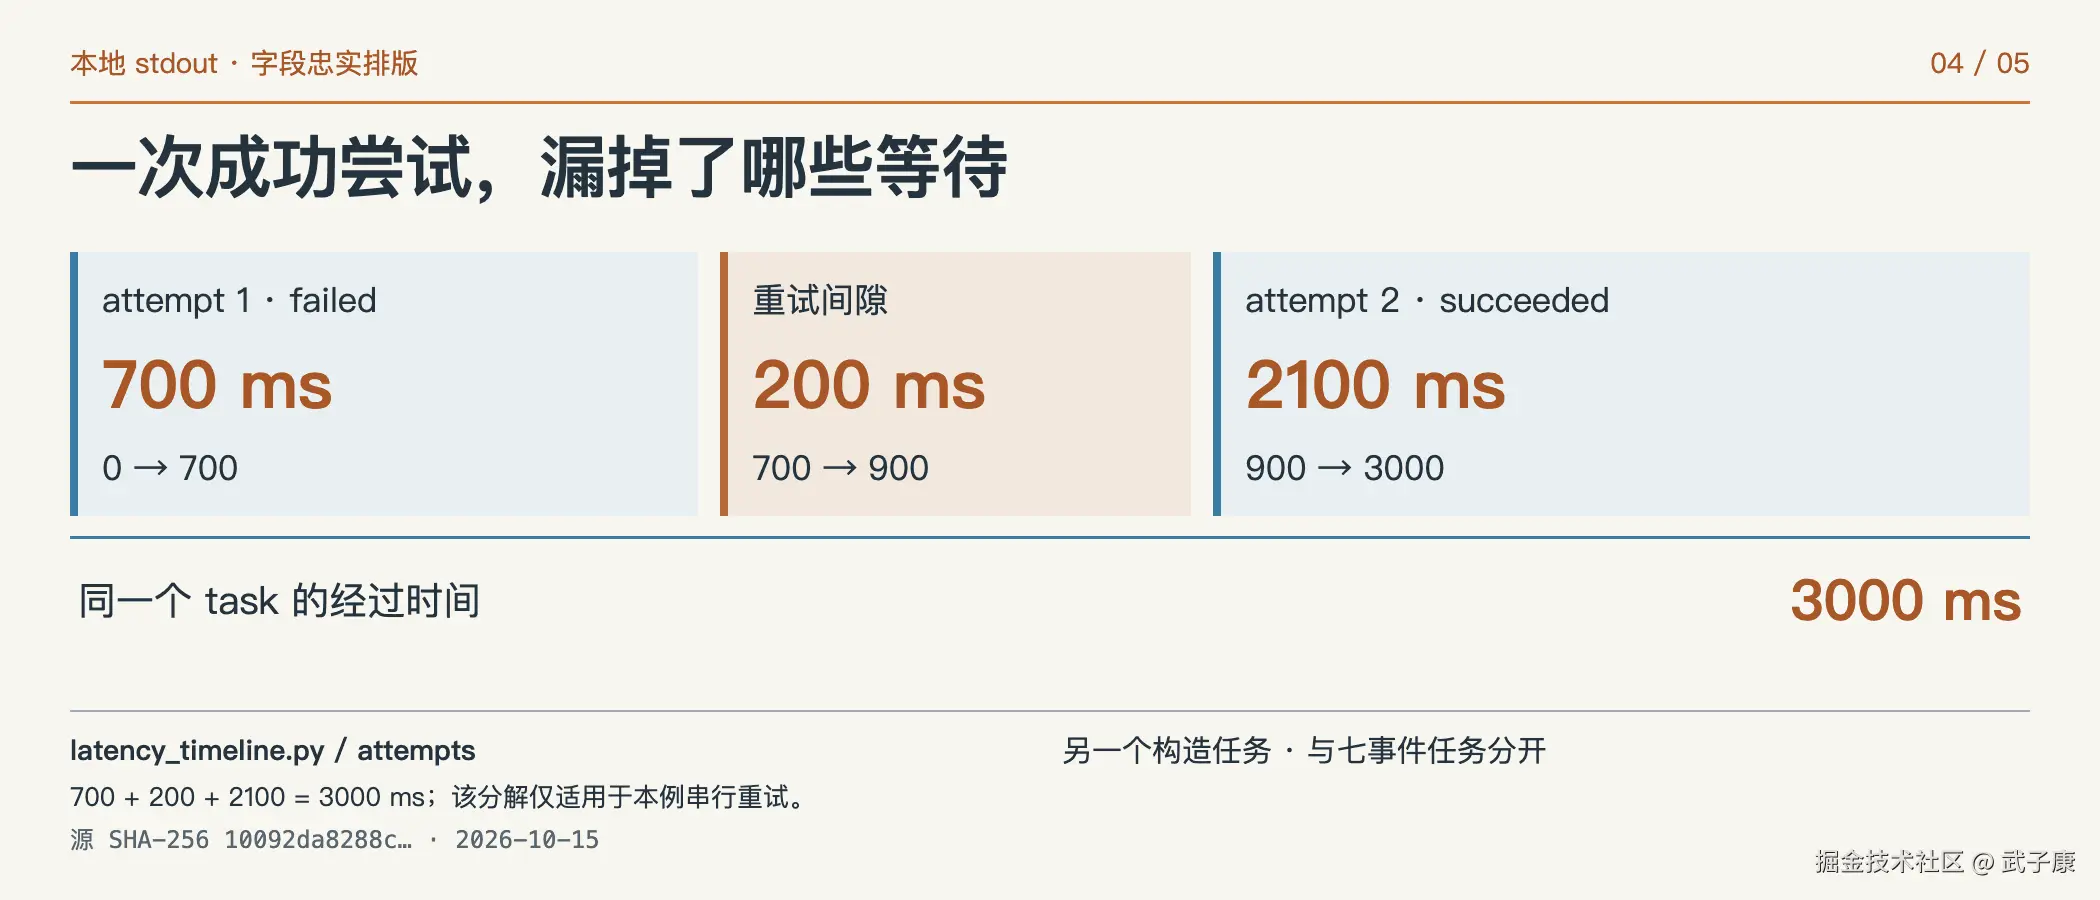
代码后半部分另外构造了一条重试任务,避免与前面的七事件案例混算。它的首次尝试在 0 到 700 毫秒间失败,第二次尝试在 900 到 3000 毫秒间成功,两次之间等待 200 毫秒。
成功尝试持续 2100 毫秒,用户任务从首次开始到最后成功持续 3000 毫秒。只保留成功尝试,会漏掉首次失败的 700 和重试间隙的 200;把两次尝试当作两个用户任务,又会改变任务级分母。
真实采集应给用户任务稳定的 task_id,给每次尝试独立的 attempt_id,保留尝试结果与最终任务结果。一个任务可以关联多个 trace,标识关联不能依赖"所有重试一定在同一条 trace 内"。排查工具失败时看尝试,报告用户等了多久时看任务,两种口径都保留。
例如按模型调用条数统计时,另一个重试任务贡献两次尝试;按被接受的用户任务统计时,它只贡献一个任务。两者的延迟分布不能拼接后统一叫"Agent响应时间"。即使最终业务成功,也应该保留失败尝试的状态和消耗;即使任务没能成功,已经发生的等待也不能从性能样本里悄悄删除。报告可分别说明尝试结果、任务终态和首次可用端点,避免只展示成功路径。
若一个任务并行触发多次尝试,连"尝试耗时相加再加重试间隙"的串行式也不适用。这里700、200、2100的分解成立,是因为构造数据明确串行、没有重叠;一般任务仍要回到实际时间轴和依赖关系。任务标识解决归属,尝试标识解决分支,二者都不会自动提供正确的聚合公式。
首次尝试的首 token 时间也不能冒充最终可用结果。它即使很早出现,后续仍可能失败;失败文本是否已经暴露给用户,需要客户端事件单独说明。本文没有模拟重试策略、取消协议和副作用幂等,只展示计时单位为何必须分开。
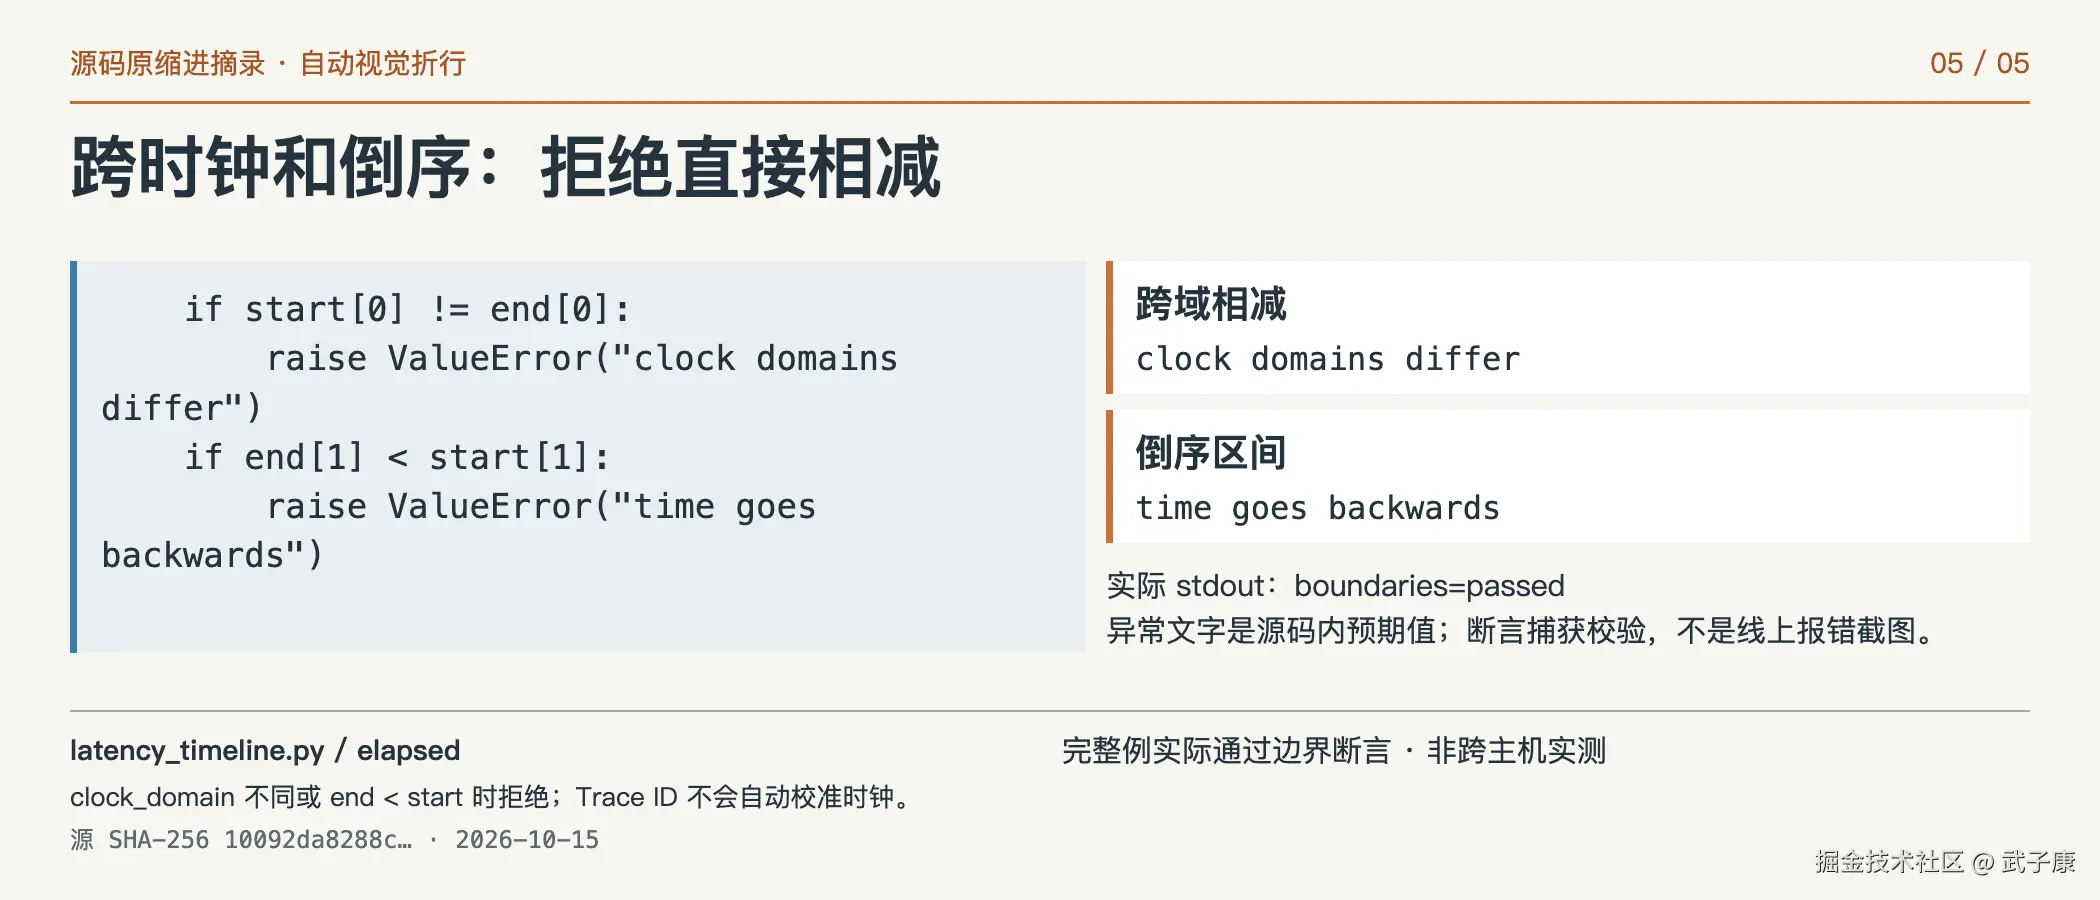
同一个 trace ID 不会把两台机器的时钟变成同一个时钟
代码让不同 clock_domain 的时间相减直接报错,这是一个保守的示例输入规则。它不是说跨进程永远不能比较时间,也不是要求每个进程都单独划域;域应对应实际可比较的时钟来源与基准。
单机的兼容单调时钟可以用于测量经过时间。Python 文档说明 monotonic 不受系统时钟设置跳变影响,参考原点未定义,应比较同一可兼容时钟下的差值。Python time.monotonic
两台独立机器即使都调用了单调时钟,也不能把各自原始读数直接相减。Trace ID 用来关联操作,并不携带一个自动消除时钟偏差的机制。实践中可以优先采用同一观测点的发送/接收区间和各节点本地持续时间,再结合因果关系;需要比较跨节点墙钟时间时,必须知道同步、偏差和精度边界。工具内部持续时间可以另报,却不能未经换算就塞进编排时间轴的绝对坐标。
这也解释了为何观测方案应先写口径再接面板:入口位置、事件语义、时钟域和任务/尝试单位缺一个,漂亮数字就可能回答错问题。
把这份演算换成自己的采集定义
拿一条用户确实在等的任务,先在同一观测边界里找到入口、首个内容、首次可用和最终确认。保留没有采到的区间,不用猜测补值;然后只展开占据等待、又与用户结果存在依赖的那一段。
本文可以直接带走的是七事件示例和区间检查代码。用于真实系统时,还要补客户端渲染事件、跨节点关联、缺失与乱序处理、样本覆盖和分布统计。一条构造 trace 算不出 P95,也不能证明某项优化改善了用户体验;比较版本时必须保持任务范围、端点与采集位置一致,并观察失败和重试是否改变。
落地时可以把本例的七行表改成一份端点说明,逐行填"由谁记录、在哪个位置、满足什么条件、缺失时如何显示"。先用一条已知任务核对原始事件、计算结果与界面事实,再扩大采样。本文留下的主要产物仍是这份时间区间演算;只有定义经得起真实事件回放,后续按任务类型比较分布才有共同基础。