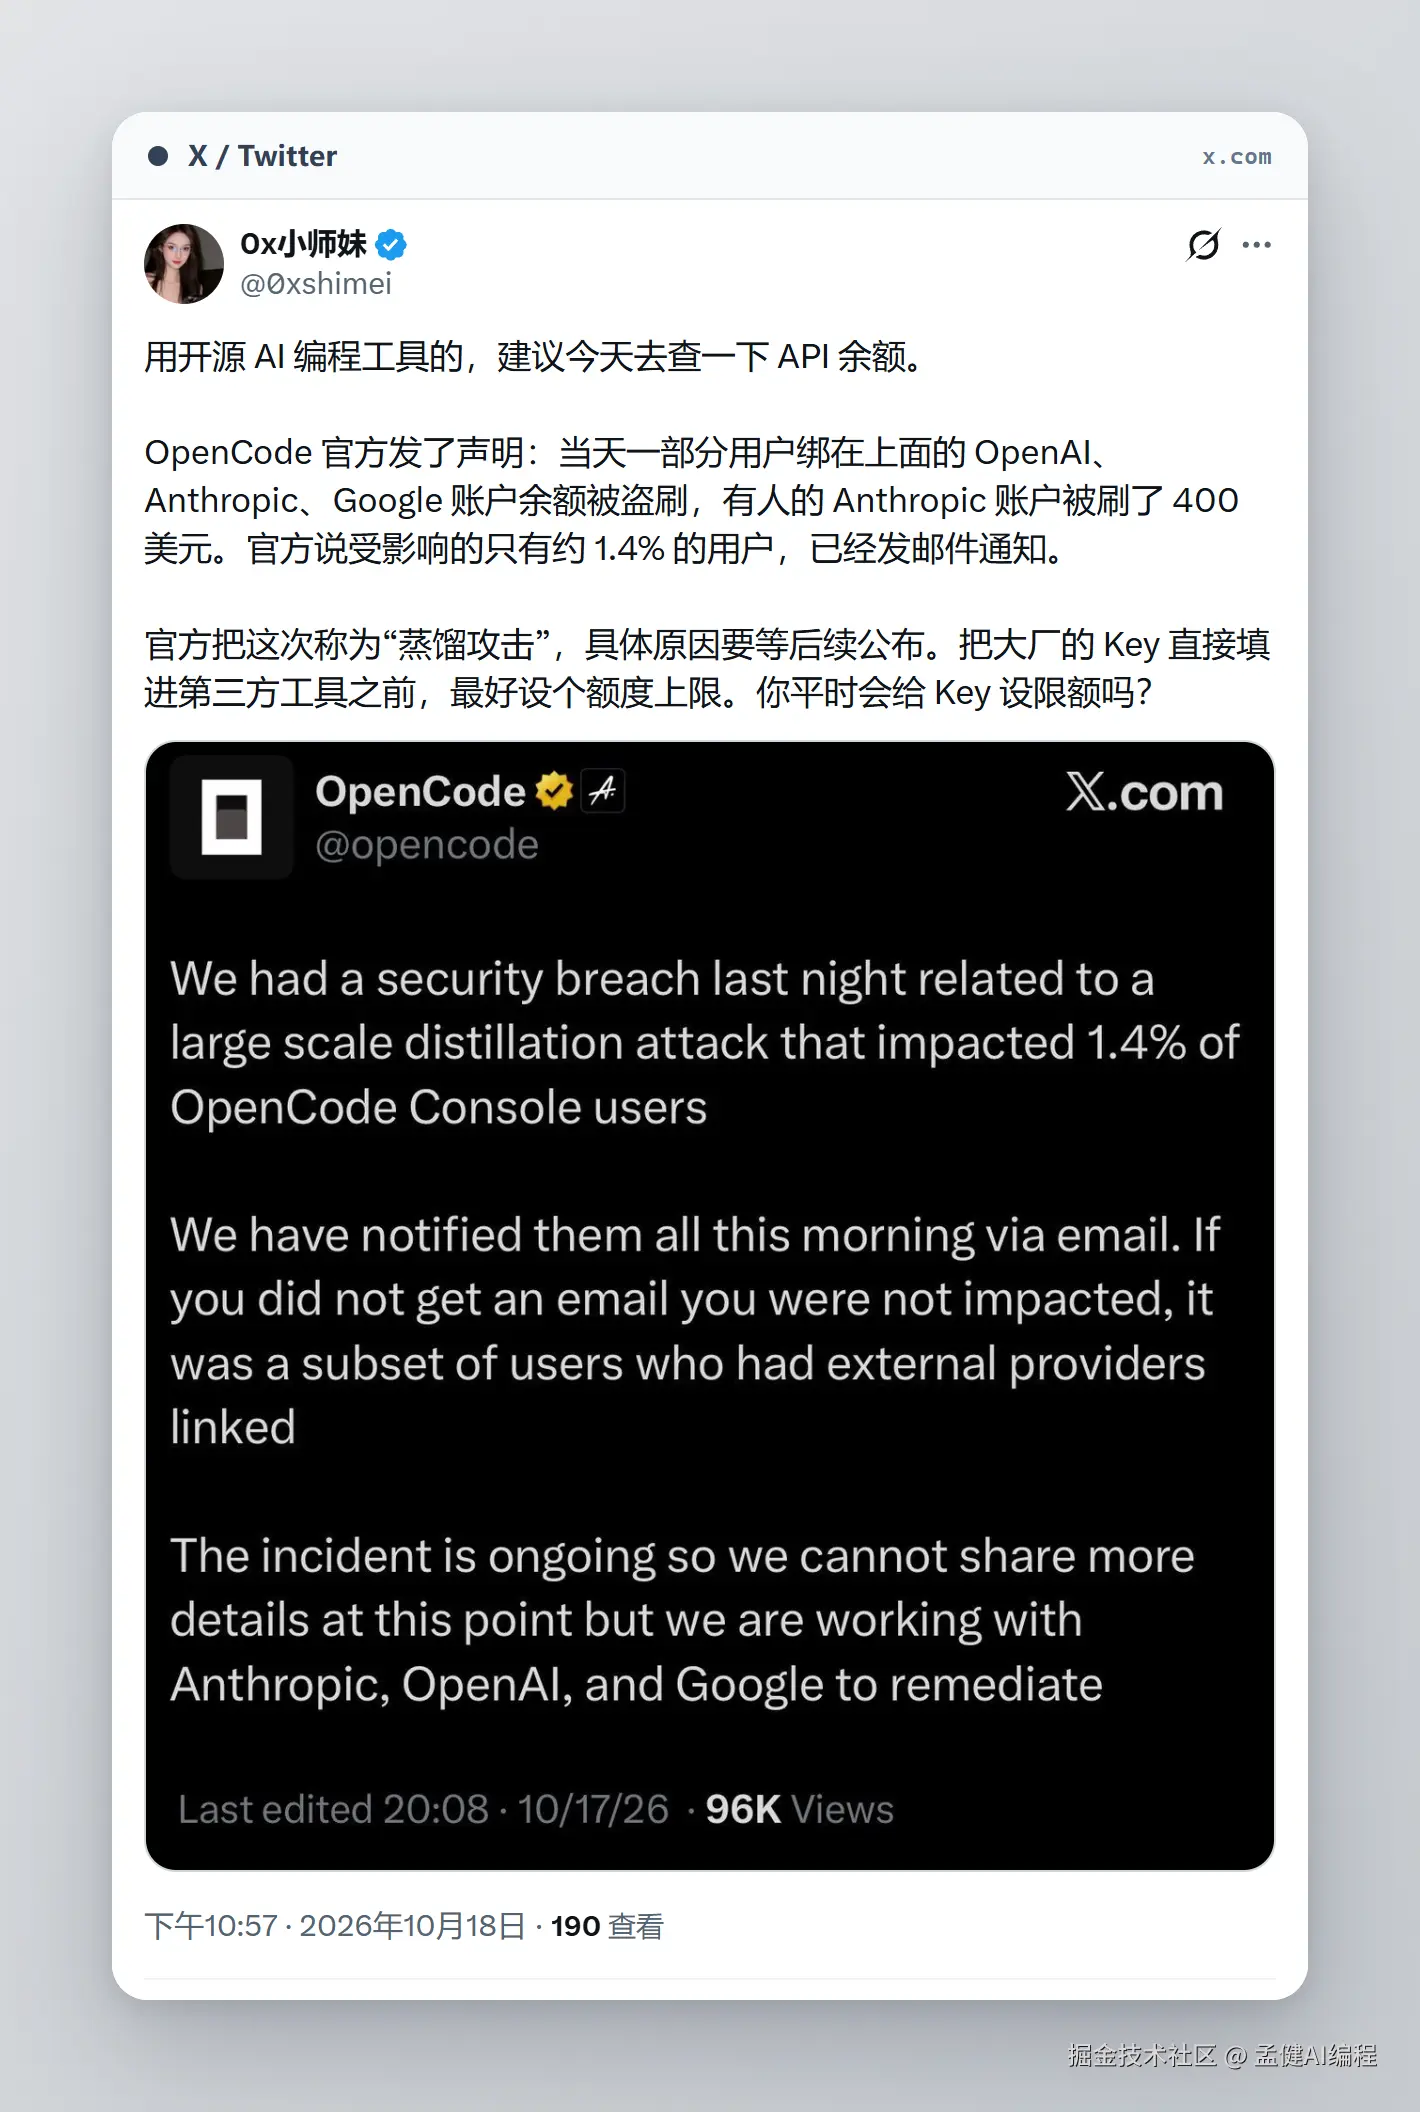
2026 年 10 月 18 日,开源 AI 编程工具 OpenCode 官方发布声明:约 1.4% 绑定了 OpenAI、Anthropic 与 Google 官方 API 凭据的用户遭遇"蒸馏攻击"盗刷,有开发者的 Anthropic 账户单日被刷走 400 美元。
该事件暴露了独立开发者与出海团队的技术盲区:将拥有扣费权限的官方主 Key 明文填入第三方客户端;或依赖二道贩子的中转站资金池。一旦客户端被渗透或中转商跑路,资产与业务连续性会清零。
本文面向需调用海外大模型、开发出海业务的工程师与独立开发者。我们将从支付链路切断对二道贩子的依赖,通过自建 LiteLLM 代理网关,落地包含"多模型容灾(Fallback Routing)、预算控制、敏感调用隔离"的架构。按文中步骤,可在 30 分钟内完成部署。
01、API 凭据泄漏与中转站依赖的真实代价
在生产环境中,API 密钥等同于无额度上限的支票。
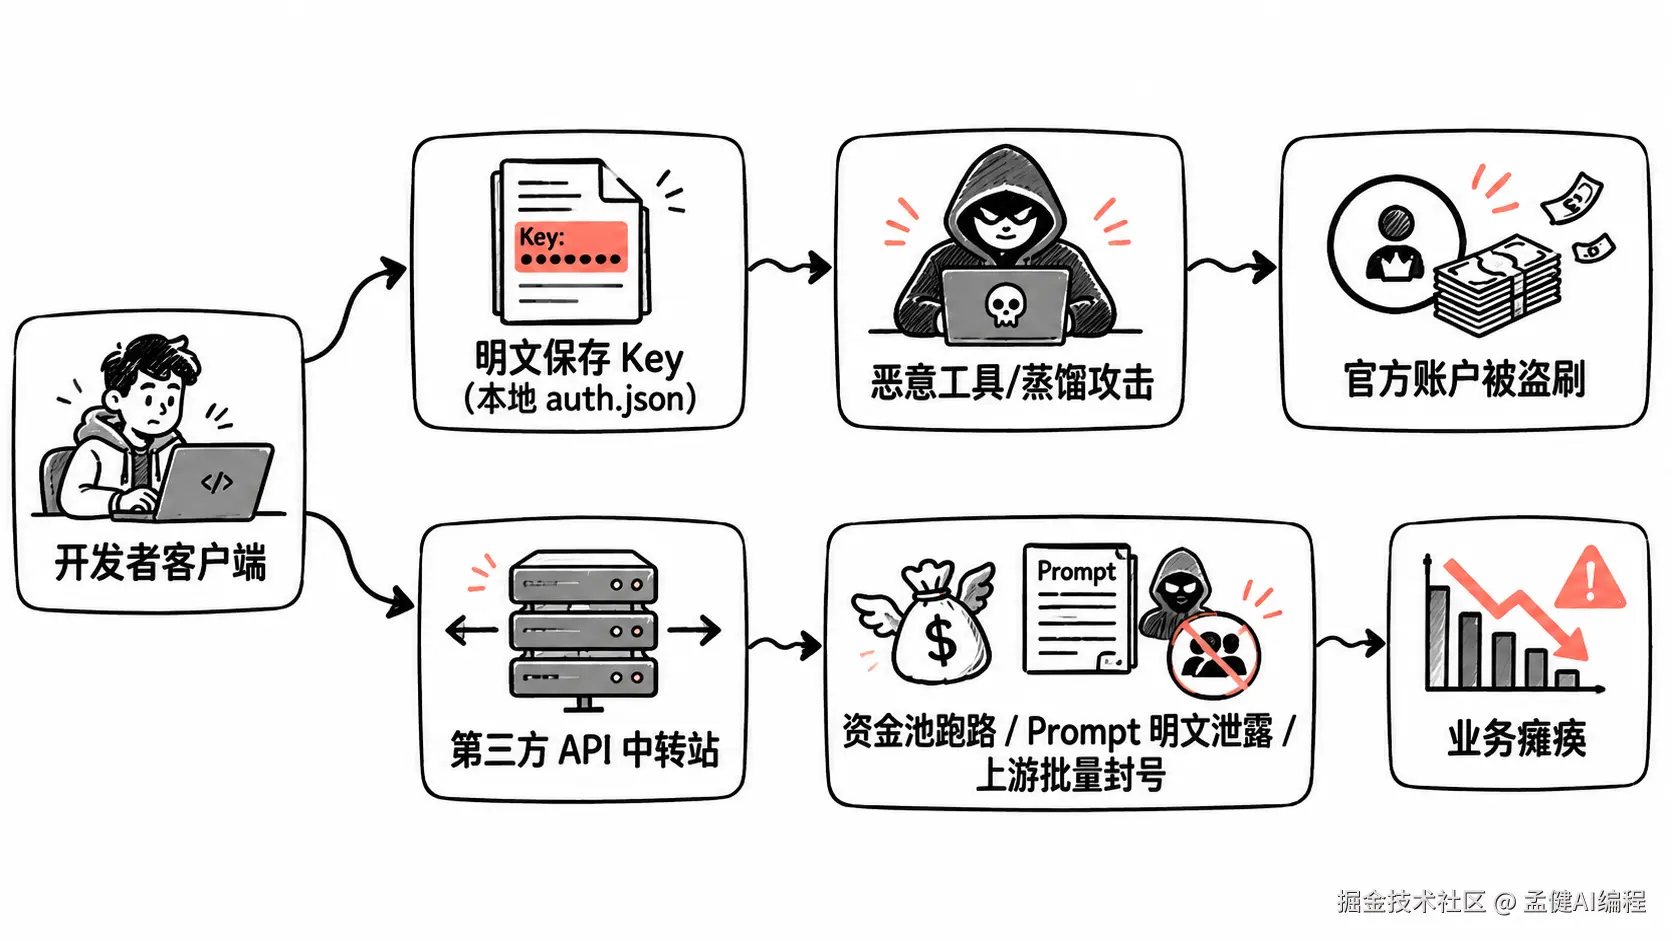
OpenCode 事件中,官方将漏洞归因为针对本地凭据存储机制的"蒸馏攻击"。OpenCode 支持超 75 家大模型提供商,用户执行 /connect 后,凭据以明文或弱加密形式保存在本地 ~/.local/share/opencode/auth.json 中。且许多开发者通过非官方逆向方式挂载 Claude Pro/Max 订阅凭据。攻击者利用恶意脚本抓取该目录或提取流量时,官方账户就变成了黑客训练小模型的"蒸馏算力池"。
选择第三方 API 中转站的开发者处境更脆弱。中转站本质是灰产资金池:服务商用黑卡或教育折扣账号接入大模型,通过反向代理按 token 折价售卖。这种模式存在三个硬伤:
- 资金随时归零:预充值后,平台跑路或上游封杀账号群,余额无法追索。
- 链路被注入与中间人风险:中转服务器可记录所有 Prompt 原文,商业逻辑与用户隐私在网关层裸奔。
- 服务不可靠且缺乏 SLA:上游风控收紧时全站接口报 502,线上业务直接瘫痪。
商业项目不能只看调用单价,更要看安全边际。把生产力押注在不可控的第三方节点,省下的 token 费用不够覆盖一次停机损失。
02、打通海外官方支付通道:Stripe 与 PayPal 的实操取舍
开发者选择中转站的核心障碍是无法为 OpenAI 或 Anthropic 绑卡充值。绕开二道贩子的第一步,是建立合规的海外直连支付通道。
根据出海收付款实操经验,海外支付工具差异如下:
Stripe 对开发者友好。其底层风控基于商户合规度与信用卡欺诈率,账单 API、订阅管理系统和开发者工具链成熟,调用官方 API 或开通企业控制台绑定主卡时,通过率高且极少无预警封停。在出海 SaaS 与模型调用中,Stripe 应作为第一顺位主支付渠道。
PayPal 支持更多地区的个人银行账户绑定,但风控算法严格且偶发不可控。实操中,PayPal 常因短期跨币种突增流水、异常地理位置登录或新账户资金变动,无预警触发长达 180 天的资金冻结(俗称"风控抽风")。接入 Anthropic 或 OpenAI 时,PayPal 适合作为兜底备份通道,不能作为唯一资金归集点。
账户安全管理需落实三项标准:
- 主账号与调用账号严格隔离:严禁在代码或第三方工具中使用 Organization Owner 级别的 API Key。
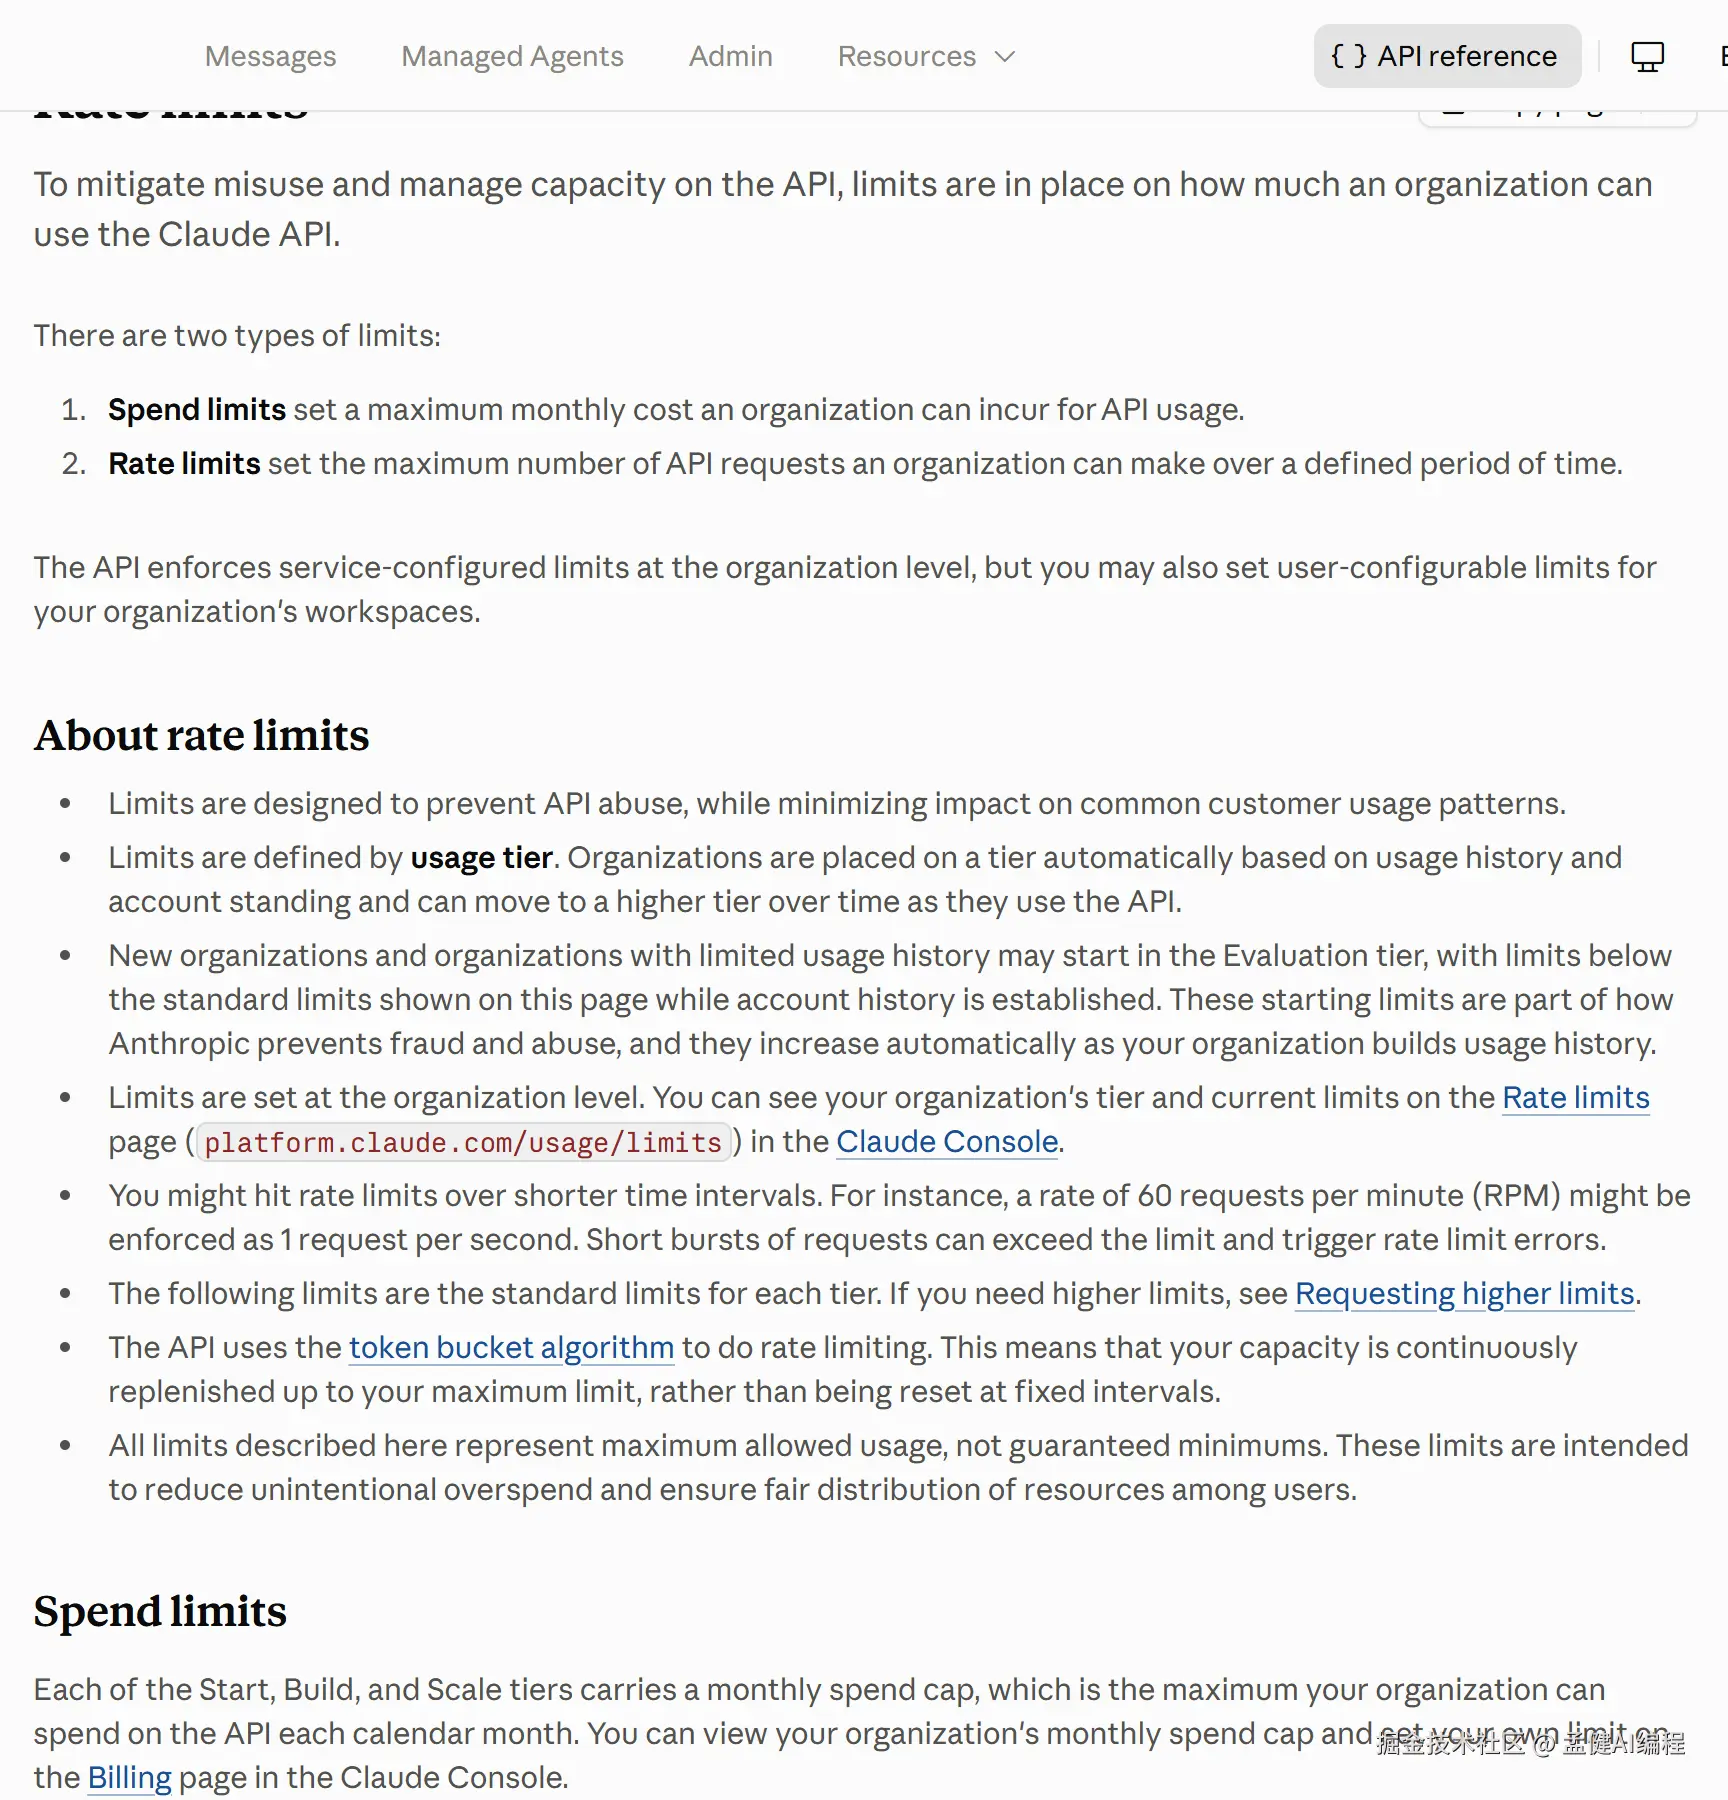
- 设置单月硬性支出上限(Hard Limit):在 Anthropic Console 或 OpenAI Billing 中,将单月预算上限锁死在预期消耗的 120% 以内,关闭自动无上限追加充值。
- 细分项目创建只读或受限 Key:为每个独立环境(本地调试、预发、线上生产)签发独立 Key,限制模型调用权限。
03、自建 LiteLLM 代理网关:解耦密钥与统一路由
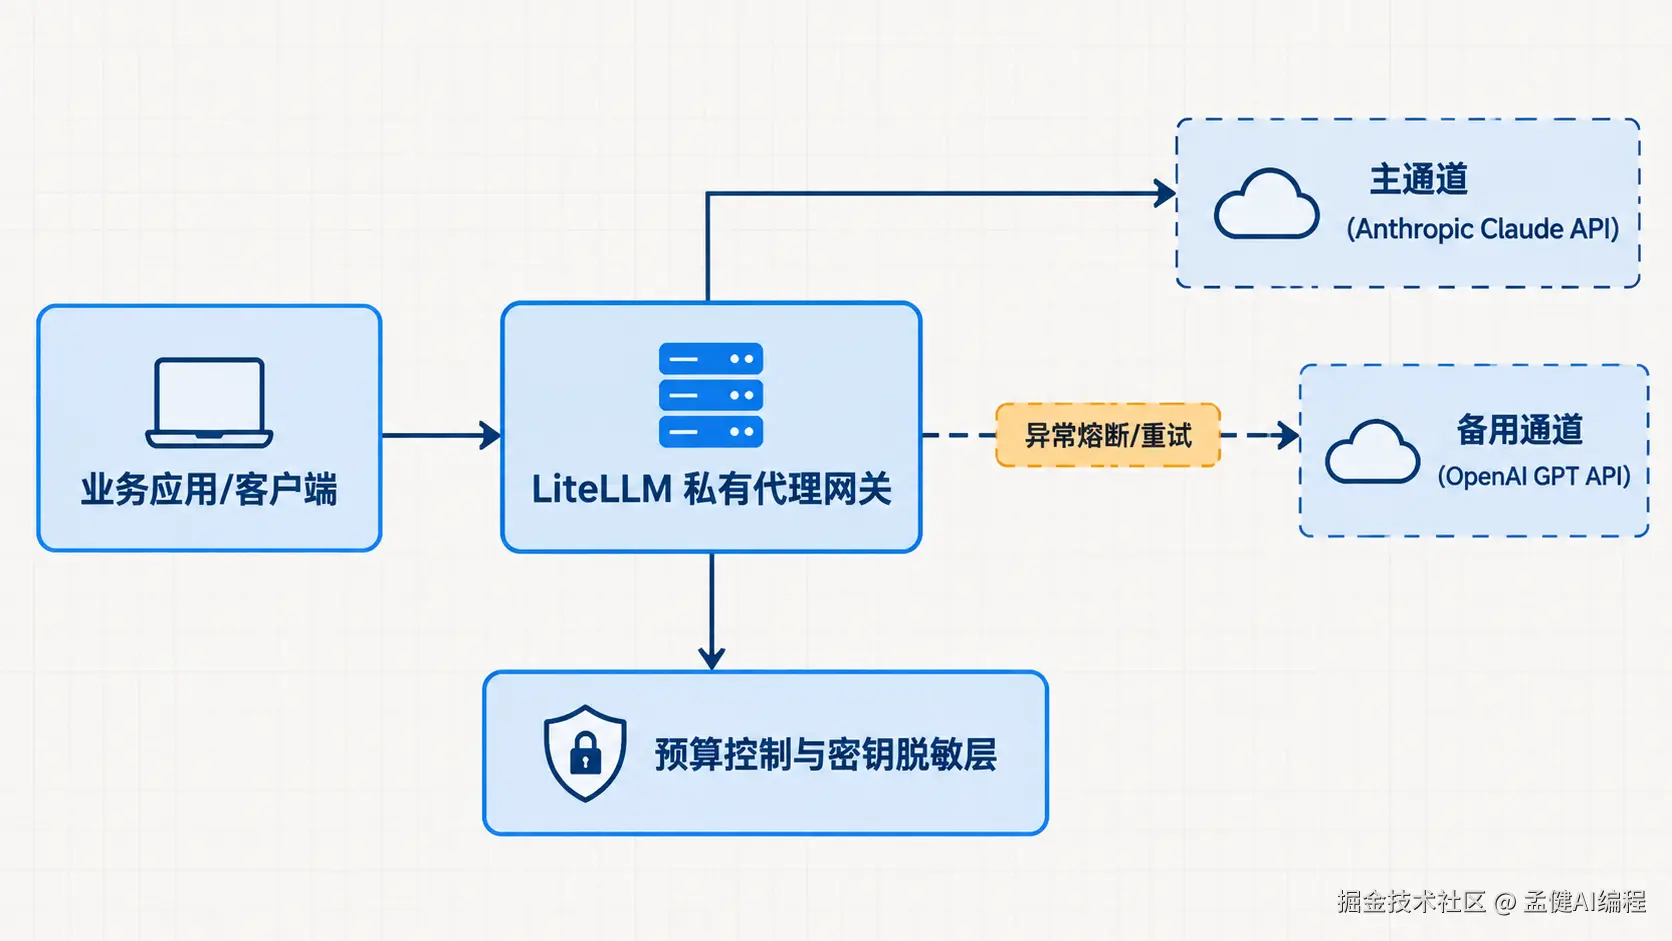
打通官方直连后,不要把官方 Key 分发给前端或外部客户端,应在服务器或本地边缘节点搭建 OpenAI 兼容的统一网关。
LiteLLM 支持超 100 家模型提供商,可做 API 协议转换,并提供密钥脱敏、负载均衡、预算控制与故障转移能力。通过 LiteLLM 代理,客户端只需调用内网网关暴露的虚拟 Key,官方主 Key 只存在于网关的环境变量中。
步骤一:编写容灾路由配置文件
创建 config.yaml。定义全局模型别名 production-model,指向 Anthropic Claude 3.5 Sonnet 作为主干模型;配置故障转移路由(fallback routing),当 Anthropic 接口报 429、500 或超时时,自动降级转发到 OpenAI GPT-4o 或 Google Gemini 1.5 Pro。
yaml
model_list:
  # 主通道:Anthropic Claude 3.5 Sonnet
  - model_name: production-model
    litellm_params:
      model: claude-3-5-sonnet-20241022
      api_key: "os.environ/ANTHROPIC_API_KEY"
      tpm: 40000
      rpm: 1000

  # 容灾备份通道 1:OpenAI GPT-4o
  - model_name: gpt-4o-backup
    litellm_params:
      model: gpt-4o
      api_key: "os.environ/OPENAI_API_KEY"

  # 容灾备份通道 2:Google Gemini 1.5 Pro
  - model_name: gemini-backup
    litellm_params:
      model: gemini/gemini-1.5-pro-latest
      api_key: "os.environ/GEMINI_API_KEY"

router_settings:
  fallbacks:
    - production-model: ["gpt-4o-backup", "gemini-backup"]
  context_window_fallbacks:
    - production-model: ["gemini-backup"]
  routing_strategy: latency-based-routing
  allowed_fails: 2
  cooldown_time: 30

general_settings:
  master_key: "sk-my-super-secret-admin-key"
  database_url: "sqlite:////data/litellm.db"
步骤二:容器化部署 LiteLLM Proxy
在 Linux 服务器上通过 Docker 启动网关服务,将主 Key 注入系统环境变量,避免配置文件泄露:
bash
# 写入环境配置文件 .env
cat <<EOF > .env
ANTHROPIC_API_KEY=sk-ant-api03-xxxxxx
OPENAI_API_KEY=sk-proj-xxxxxx
GEMINI_API_KEY=AIzaSyxxxxxx
LITELLM_MASTER_KEY=sk-proxy-admin-8899
EOF

# 启动 Docker 容器
docker run -d \
  --name litellm-proxy \
  --restart always \
  -p 4000:4000 \
  --env-file .env \
  -v $(pwd)/config.yaml:/app/config.yaml \
  ghcr.io/berriai/litellm:main-latest \
  --config /app/config.yaml --port 4000
启动后,LiteLLM 在 4000 端口暴露与 OpenAI 标准兼容的 /v1/chat/completions 接口。
步骤三:客户端接入与降级验证
在业务代码或开发工具(如 Cursor、OpenCode 或 Python 服务)中,将 Base URL 改为 http://<your-server-ip>:4000/v1,填入网关 Master Key 或子 Key,模型名指定为 production-model。
以下为模拟 Anthropic 故障时自动切换的 Python 测试脚本:
python
import openai

# 指向本地 LiteLLM 统一网关
client = openai.OpenAI(
    api_key="sk-proxy-admin-8899",
    base_url="http://127.0.0.1:4000/v1"
)

try:
    response = client.chat.completions.create(
        model="production-model",
        messages=[
            {"role": "system", "content": "You are a resilient assistant."},
            {"role": "user", "content": "Ping test for disaster recovery."}
        ],
        temperature=0.2
    )
    print("响应成功,实际提供者模型:", response.model)
    print("返回内容:", response.choices[0].message.content)
except Exception as e:
    print("调用链路异常:", str(e))
当 Anthropic 遭遇 500 报错或网络波动时,LiteLLM 路由器会在 30 秒冷却时间内将流量重定向至 gpt-4o-backup,对调用端透明,请求不中断。
04、工程落地的边界条件与注意事项
上线敏感业务前,需界定实测边界:
- 不要在强格式依赖工作流中静默降级:Claude 3.5 Sonnet 与 GPT-4o 均支持标准 Function Calling(工具调用),但在结构化 JSON Schema 输出严格度、系统提示词遵循度及极端上下文处理上存在差异。依赖 Prompt 格式约束的金融或代码生成任务,静默降级可能导致后置校验报错。应在响应头中回传实际处理模型标识,供业务端感知。
- 数据驻留与合规边界:Anthropic、OpenAI 与 Google 在各区域的数据留存政策(Zero Data Retention)不同。涉及海外 GDPR 合规的场景,备选模型提供商须拥有同等级隐私策略协议,不得跨区域无序降级。
- 网关鉴权分发原则 :生产环境严禁直接分发
master_key。应利用 LiteLLM 的/key/generate接口为不同业务模块派发带有独立max_budget(预算上限)和duration(有效周期)的临时虚拟令牌,实现子 Key 被盗用时在网关层秒级阻断。
对于独立开发者,控制好密钥访问权限与收付款生命线,系统才算拥有抗风险能力。
如果在配置 LiteLLM 路由或海外支付绑定过程中踩了其他坑,欢迎在评论区交流。觉得这套方案对你有帮助,不妨点赞收藏备用。
👋 我是孟健,前腾讯 T11、前字节技术 Leader,现在全职做 AI 编程。
🔥 更多 AI 编程实战:
- GitHub:@mengjian-github
- 专栏:AI编程实战
- 这期的完整清单:评论区回复「网关配置」,我把领取方式发你
觉得有用?点赞+收藏 就是最大支持 🙏
本文由作者借助 AI 辅助整理,内容经作者实测与审校。