2026-10-15·核心循环·核心循环
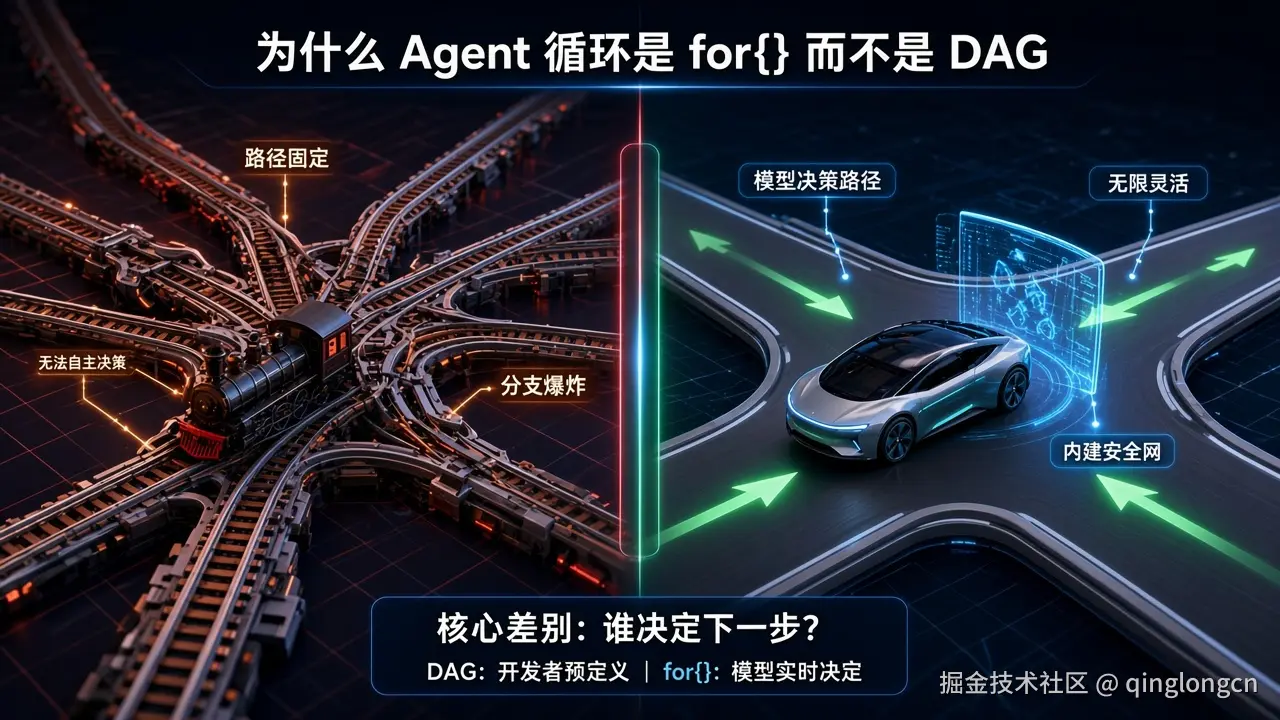
Agent 循环有五种可能的架构------for 循环、DAG、事件驱动、状态机、Actor 模型。截至本文写作时最成功的 Agent 产品全部选了最简单的那个。这不是巧合------Agent 的变化不在步骤顺序(那是 DAG 擅长的),在每步的输入输出(那是 for 循环擅长的)。
一个反直觉的现象
截至本文写作时,最成功的 Agent 产品------Claude Code、Cursor Agent Mode、Aider、Devin------全部用了最简单的循环结构:while / for 循环。
而早期强调 DAG 编排的产品(LangGraph 的 StateGraph、Dify 的 Workflow),要么增加了 Agent 模式(本质是回到了循环),要么把 DAG 定位为特定场景的工具(不再是"Agent 的唯一架构")。
行业用脚投票了。 但为什么?DAG 看起来更"工程化"------可视化、可追踪、可测试。for 循环看起来"太简单了"------没有图、没有状态转换、没有条件分支。
这个选择背后有深层原因。
五种架构范式
Agent 循环至少有五种可能的架构方式:
1. for 循环
bash
for {
    组装上下文 → 调 LLM → 执行工具 → 持久化 → 判断继续?
}
代表:Claude Code、Aider、Cursor Agent Mode。Claude Code 官方文档(code.claude.com)将其描述为"gather context → take action → verify results"三阶段循环,arXiv:2604.14228 确认"核心是简单的 while 循环调模型、跑工具、重复------但大部分代码在循环周围的系统里"。步骤固定,数据变化。
2. DAG(有向无环图)
代表:Dify Workflow、LangGraph StateGraph(早期)。节点和边预定义,路径编译期确定。
3. 事件驱动
代表:Microsoft AutoGen v0.4+(autogen-agentchat)。Agent 通过发布/订阅事件通信------一个 Agent 发出"我需要代码审查"事件,另一个订阅了这个事件的 Agent 接手。松耦合,每个处理器只关心自己订阅的事件。 AutoGen 的 GroupChat 就是事件驱动的多 Agent 协调------但调试时"消息从哪来、为什么到了这个 Agent"需要追踪整个事件链,这在复杂场景中非常痛苦(AutoGen GitHub Issues 中关于 GroupChat 调试的讨论超过 200 条)。
4. 状态机
代表:传统 BPM/Workflow 引擎的 Agent 适配(如 AWS Step Functions + Bedrock Agent、Temporal + LLM 调用)。状态和转换显式定义 ------Agent 从 GATHERING_INFO 转到 ANALYZING 再到 RESPONDING,每个状态有明确的入口条件和出口条件。优势是可审计(每个状态转换都有记录),但 Agent 的状态空间太大------"看了哪些文件""试了哪些方法""当前假设是什么"------这些组合起来是一个维度极高的连续空间,画不完状态图。
5. Actor 模型
代表:Erlang/Elixir 式 Agent(如 LiveKit Agents)、一些多 Agent 研究系统。独立实体通过消息通信,没有共享状态。 天然适合分布式------每个 Agent 可以在不同机器上运行。但 Agent 场景中"共享上下文"是核心需求(多个工具操作同一个代码库),无共享状态反而增加复杂度。Actor 模型更适合 Agent 之间的通信层 (如 Google A2A 协议),而非单个 Agent 的循环层。
for 循环赢在哪里
核心原因:Agent 的变化不在步骤顺序
DAG 和状态机的假设是:步骤顺序会变化------需要灵活的编排来描述不同路径。
但 Agent 的步骤顺序每一轮都一样:组装上下文 → 调 LLM → 执行工具 → 持久化 → 判断继续。你不会跳过"组装上下文"直接调 LLM,也不会先执行工具再调 LLM。
变化的是每步的输入和输出------LLM 这次可能说"读文件",下次可能说"改代码",再下次可能说"跑测试"。这种变化用 for 循环天然表达------循环体固定,每次迭代的数据不同。
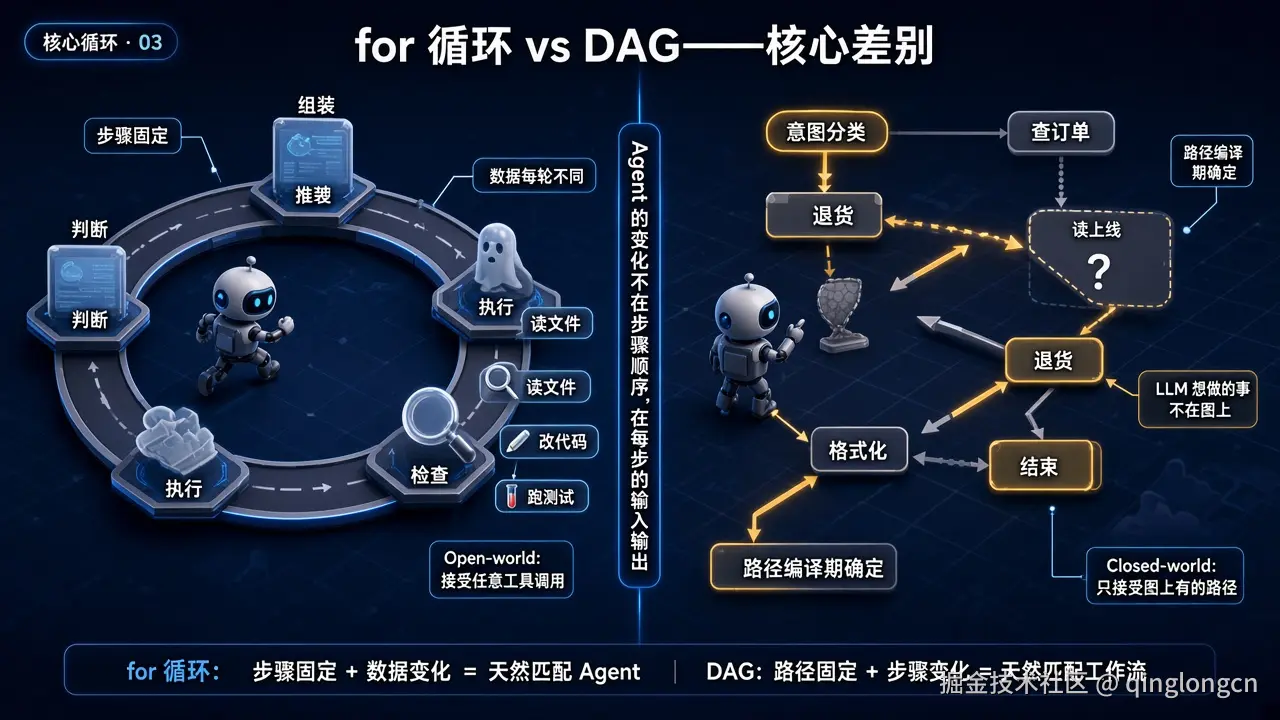
DAG 试图解决的问题(灵活的步骤编排)在 Agent 场景中不是真问题。 需要灵活的不是步骤顺序,而是步骤内的决策------那是 LLM 的事,不是编排框架的事。
LLM 在运行时决定路径------编译期的图是摆设
DAG 的核心价值是编译期 描述路径。但 Agent 的路径是 LLM 在运行时决定的------模型可能返回任何已注册工具的任何组合。你无法预定义一张 DAG 来覆盖所有可能。
如果你尝试这么做:
- DAG 会变得巨大(每种工具组合一条边------假设 20 个工具、每步可选任意一个,就是 20^N 条路径)
- 或者你会限制 LLM 的选择("只允许按图上的路径走"------退回了第一代编排驱动)
for 循环不限制 LLM 的选择------无论模型返回什么 tool_calls,循环体都能处理。这是一个根本性的契合:for 循环是 open-world 的(接受任意工具调用),DAG 是 closed-world 的(只接受图上有的路径)。Agent 的本质是 open-world 的------它需要根据运行时信息做出无法提前预测的决策。
LangGraph v1.0 的发布验证了这一点:官方博客明确建议"用 create_agent(本质是 ReAct 循环)起步,需要更多控制时降级到 StateGraph"------循环是默认,图是特例(langchain.com/blog/langchain-langgraph-1dot0)。
调试友好------栈追踪就是地图
for 循环在任意时刻的状态都在调用栈上------你在第几轮、在哪个阶段、在做什么。不需要日志考古。
事件驱动的 bug 追因链是 EventA → HandlerB → EventC → HandlerD → 状态不对------跨多个异步回调。DAG 的 bug 可能是"条件分支走错了路径"------需要检查图的路由条件。
嵌套透明------多 Agent 委派就是子循环
多 Agent 委派在 for 循环中极其自然------主 Agent 在循环体内启动子 Agent 的循环,结果回来后继续主循环。不需要 DAG 的"子图"概念。
Claude Code 的五种内置子代理(Explore / Plan / general-purpose 等,arXiv:2604.14228)就是嵌套循环的最佳实例------子代理有自己的权限模式、工具集和模型选择,但执行结构完全相同:while 循环。Hermes Agent 的 delegate_task 同理------支持同步等待和后台执行两种模式,但子 Agent 的内部结构还是 while 循环加工具调用。
错误恢复简单------重试就是下一轮
在 for 循环中,工具执行失败的恢复方式极其自然------把错误信息喂回 LLM,让它在下一轮决定怎么处理(重试、换策略、报告给用户)。不需要专门的"错误恢复图"或"异常处理状态"。
在 DAG 中,错误恢复意味着从某个节点跳回到另一个节点------这在图中需要回边,而"有向无环图"的定义不允许回边。于是你需要在 DAG 之外加一层重试逻辑,or 把错误处理也画进图------图迅速膨胀。
可观测性天然------每一轮都是一个完整的 trace
for 循环的每一轮迭代(组装 → 调 LLM → 检查 → 执行 → 持久化)天然构成一个可追踪的"Turn"------谁调了什么、参数是什么、结果是什么、花了多长时间。调用栈就是完整的追踪链,不需要额外的事件收集器。
事件驱动架构的可观测性需要分布式追踪------把跨多个异步回调的事件串起来形成因果链,这本身就是一个工程子系统(OpenTelemetry 级别的 context propagation)。
DAG 在什么场景下更好
这不是"DAG 不行"------是Agent 场景不适合 DAG。DAG 在以下场景仍然是正确选择:
| 场景 | 为什么 DAG 更好 | 例子 |
|---|---|---|
| 步骤可预测 | 路径有限,可以完整定义和测试 | FAQ 机器人、表单填写 |
| 需要可视化 | 非技术用户要看懂和修改流程 | Dify 给运营团队用 |
| 合规要求 | 审计员要求"按 exactly 这个流程执行" | 金融审批、医疗诊断 |
| 无 LLM 决策 | 节点是确定性操作(API 调用、数据变换),不需要 LLM 选路 | 数据 ETL 管线 |
判断标准 :如果你能提前画出所有可能的路径 ------用 DAG。如果你不知道下一步会是什么(取决于 LLM 的推理)------用 for 循环。
Dify 聪明地做了双模式------Workflow(DAG)模式和 Agent 模式(循环)并行存在。标准化流程用 Workflow,开放式任务用 Agent。这比强迫所有场景用同一种架构要务实。截至本文写作时,Dify 已服务超过 100 万应用(dify.ai),证明 DAG 在标准化场景中有持续的价值。
编程之外的证据。同样的"双模式"判断在其他行业也在发生:
- 企业 RPA + Agent:UiPath 2026 年推出 Agentic Automation(在传统 RPA 流程中嵌入 LLM 决策节点)------合同处理用固定流程(OCR → 提取 → 匹配 → 审批),但异常处理交给 Agent 循环。本质上就是 DAG 负责确定性部分,for 循环负责需要推理的部分
- 医疗诊断:Clinical Agent 在症状收集阶段用固定问卷(DAG),在诊断推理阶段切入 Agent 循环。FDA 的 AI/ML 监管框架要求"确定性路径必须可审计"------这正是 DAG 的强项
- 电商客服:退货/换货用 DAG(路径可枚举),投诉/咨询用 Agent 循环(需要理解用户意图并灵活回应)
一个真实教训:Plan 从 DAG 退回线性清单
这个教训发生在我们的引擎中------它完美地说明了为什么"Agent + DAG"会出问题。
曾经的设计
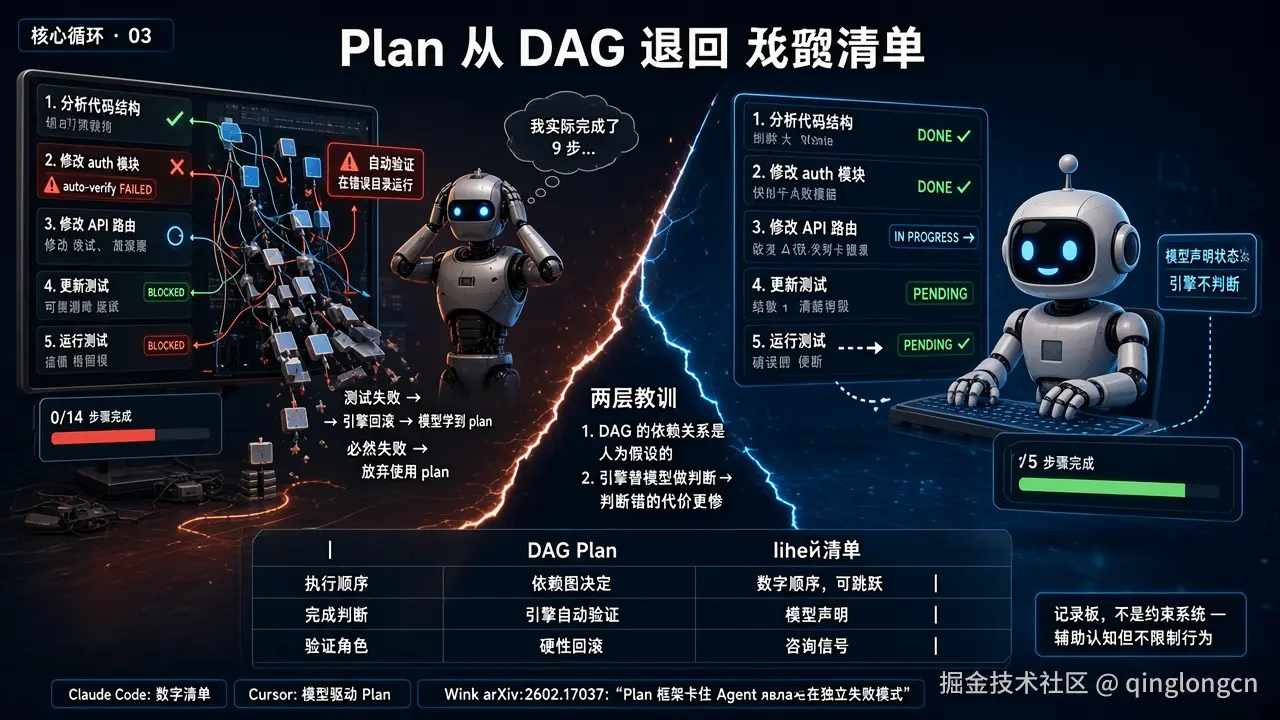
我们的 Plan(任务计划)系统支持步骤之间的依赖关系------本质上是一个 DAG:
bash
Step 1: 分析代码结构
Step 2: 修改 auth 模块     ← 依赖 Step 1
Step 3: 修改 API 路由      ← 依赖 Step 1
Step 4: 更新测试           ← 依赖 Step 2 和 Step 3
Step 5: 运行测试 ← 依赖 Step 4引擎还实现了自动验证------步骤完成后跑测试,通过就标完成,失败就回滚。看起来很工程化。
发生了什么
自动验证在错误的工作目录运行测试(在 monorepo 中,IDE 打开的根目录和项目根目录不一样)。结果:
- 测试系统性地全部失败
- 引擎忠实地回滚每个"完成"的步骤
- 模型经历几次"我说完成了 → 引擎说没完成"后,学到了 plan update 必然失败
- 模型放弃使用 plan 工具
- UI 显示 0/14 步完成------而模型实际完成了 9 步
两层教训
关于 DAG:步骤之间的依赖关系是人为假设的。实际执行中模型经常需要跳跃("先试 Step 4 发现不行再回来改 Step 2")。DAG 的刚性约束和 LLM 的灵活决策是矛盾的。
关于"引擎替模型做判断":自动验证本质上是引擎在做认知判断("这步完成了吗")。引擎做这个判断依赖的信息(正确的工作目录)它未必有------而判断错误的后果(模型放弃报告进度)比"不判断"更糟。
现在的做法
Plan 是线性清单 (数组,没有依赖关系)。模型通过 plan 工具声明步骤状态------引擎不替模型判断完成与否。自动验证降级为咨询信号("测试跑了,结果是这样"而非"测试失败了所以你没完成")。
这个改变的影响远比"删掉 depends_on 字段"大:
- 执行顺序变为数组顺序------模型可以按自己的判断跳跃("先试第 4 步发现不行再回来改第 2 步"),不被依赖约束卡住
- "完成"由模型声明------引擎记账(哪些步骤做过工作、哪些没做过),但不替模型盖"完成"的章
- Plan 终态有四种 (planning / active / completed / terminated),不再是 Completed + Interrupted 双布尔的错误抽象------双布尔有 4 种组合但其中一种(
Completed && Interrupted)是非法的,引擎曾在三个位置独立判断这个非法态,互相矛盾
行业中的类似经历
这不是我们独有的教训。Claude Code 的 Plan 也是线性清单(code.claude.com/docs),不支持步骤间依赖------Anthropic 显然也认为模型驱动的执行不需要 DAG。
更值得注意的是 Wink(arXiv:2602.17037)对编程 Agent 行为异常的分类学研究。他们分析了大量 Agent 失败案例后发现,"Agent 被自己的 Plan 框架卡住"是一类独立的失败模式------不是模型不行,是框架的刚性约束和模型的灵活决策产生了冲突。这和我们遇到的"模型放弃使用 plan 工具"是同一类现象。
核心教训 :引擎给 Agent 的工具应该是记录板 ("我打算做 A B C,做到 B 了"),不是约束系统("你必须按 A→B→C 顺序,B 完成了我才放你做 C")。记录板辅助认知但不限制行为,约束系统在 LLM 做决策的场景中注定要失败------因为 LLM 的"决策"不是沿着预定义的图走,是根据新信息随时改变方向。
总结:引擎的价值不在编排
把五种范式的适用性放在一起看:
| 范式 | 核心假设 | Agent 场景中的匹配度 |
|---|---|---|
| for 循环 | 步骤固定,数据变化 | ★★★★★ 完美匹配------每轮步骤相同,模型返回什么都能处理 |
| DAG | 路径可预定义 | ★★ 部分匹配------标准化流程可以,但 LLM 决策空间被图约束 |
| 事件驱动 | 关注点松耦合 | ★★ 通信层适合,但循环层调试困难、状态分散 |
| 状态机 | 状态可枚举 | ★ 状态空间太大------Agent 的"当前状态"是整个上下文的函数 |
| Actor | 无共享状态 | ★★ Agent 间通信适合,但单 Agent 需要共享上下文 |
Gartner 2026 年 9 月的指南也指向同一个方向------良好设计的 Agent 系统需要"解耦执行/控制"和"确定性与 Agent 混合执行"(gartner.com/en/documents/8408213)。翻译成架构语言:确定性部分用 DAG,Agent 部分用 for 循环,两者共存而不是二选一。
引擎的价值不在"更复杂的编排"------在于"更坚实的循环体"。 循环本身只有几十行代码(组装 → 调 LLM → 检查 → 执行 → 持久化 → 继续?),但每一步背后的工程------
- 上下文组装:七种信息竞争同一个 token 窗口,需要优先级和预算管理
- Provider 路由:多个 LLM 提供商之间的健康检测、故障切换、限速退避
- 安全治理:灾难命令拦截、路径边界检查、网络策略执行
- 持久化:每步的操作记录都要落盘,出了问题能追溯
- 异常检测:CycleDetector 判真循环,ErrorStreak 检伪进展------两阶段协议先自愈再问人
------这些才是从"20 行 Agent Demo"到"生产级引擎"的 2000 行代码去处。
引用来源
本文所有数据均可通过以下链接验证。
- LangGraph StateGraph + v1.0 演进 --- github.com/langchain-a...
- LangChain Blog, "LangChain and LangGraph Agent Frameworks Reach v1.0 Milestones" --- LangChain and LangGraph Agent Frameworks Reach v1.0 Milestones
- Dify Workflow DAG(双模式:Workflow + Agent)--- dify.ai
- Claude Code 官方文档 --- How Claude Code works - Claude Code Docs
- arXiv:2604.14228 "Dive into Claude Code" --- 循环 vs 图编排比较
- Wink (arXiv 2602.17037) --- 编程 Agent 行为异常分类学
- Cursor Agent Mode --- Cursor Docs --- Agent, Rules, MCP, Skills & CLI
- Microsoft AutoGen v0.4+ --- github.com/microsoft/a...
- AWS Step Functions + Bedrock Agent(状态机模式)--- Serverless Workflow Orchestration -- AWS Step Functions -- Amazon Web Services
- Google A2A 协议(Agent 间通信)--- github.com/google/A2A
- Gartner, "How to Design Agentic Systems" (Sep 2026):确定性与 Agent 混合执行 --- www.gartner.com/en/document...