报表重复开发:不只是效率问题,更是架构缺陷
在制造业等系统密集型场景中,'一张报表改8版'是典型内耗现象。业务需求微调------如按区域拆分、增加同比字段、下钻至客户层级、切换数据源或调整权限范围------常触发全链路重构:IT 团队反复修改 SQL、重写前端渲染逻辑、手动同步样式。根源不在开发能力,而在于传统 BI 工具的'模板'多为静态展示样本,仅含图表布局与示例数据,未封装数据加工链路、交互逻辑与权限策略。
结果是低价值重复劳动挤占高价值工作:数据治理滞后、指标口径漂移、报表数量激增但可信度下降,形成'人肉报表工厂'。
JVS 模板市场:不是模板库,而是可继承基线
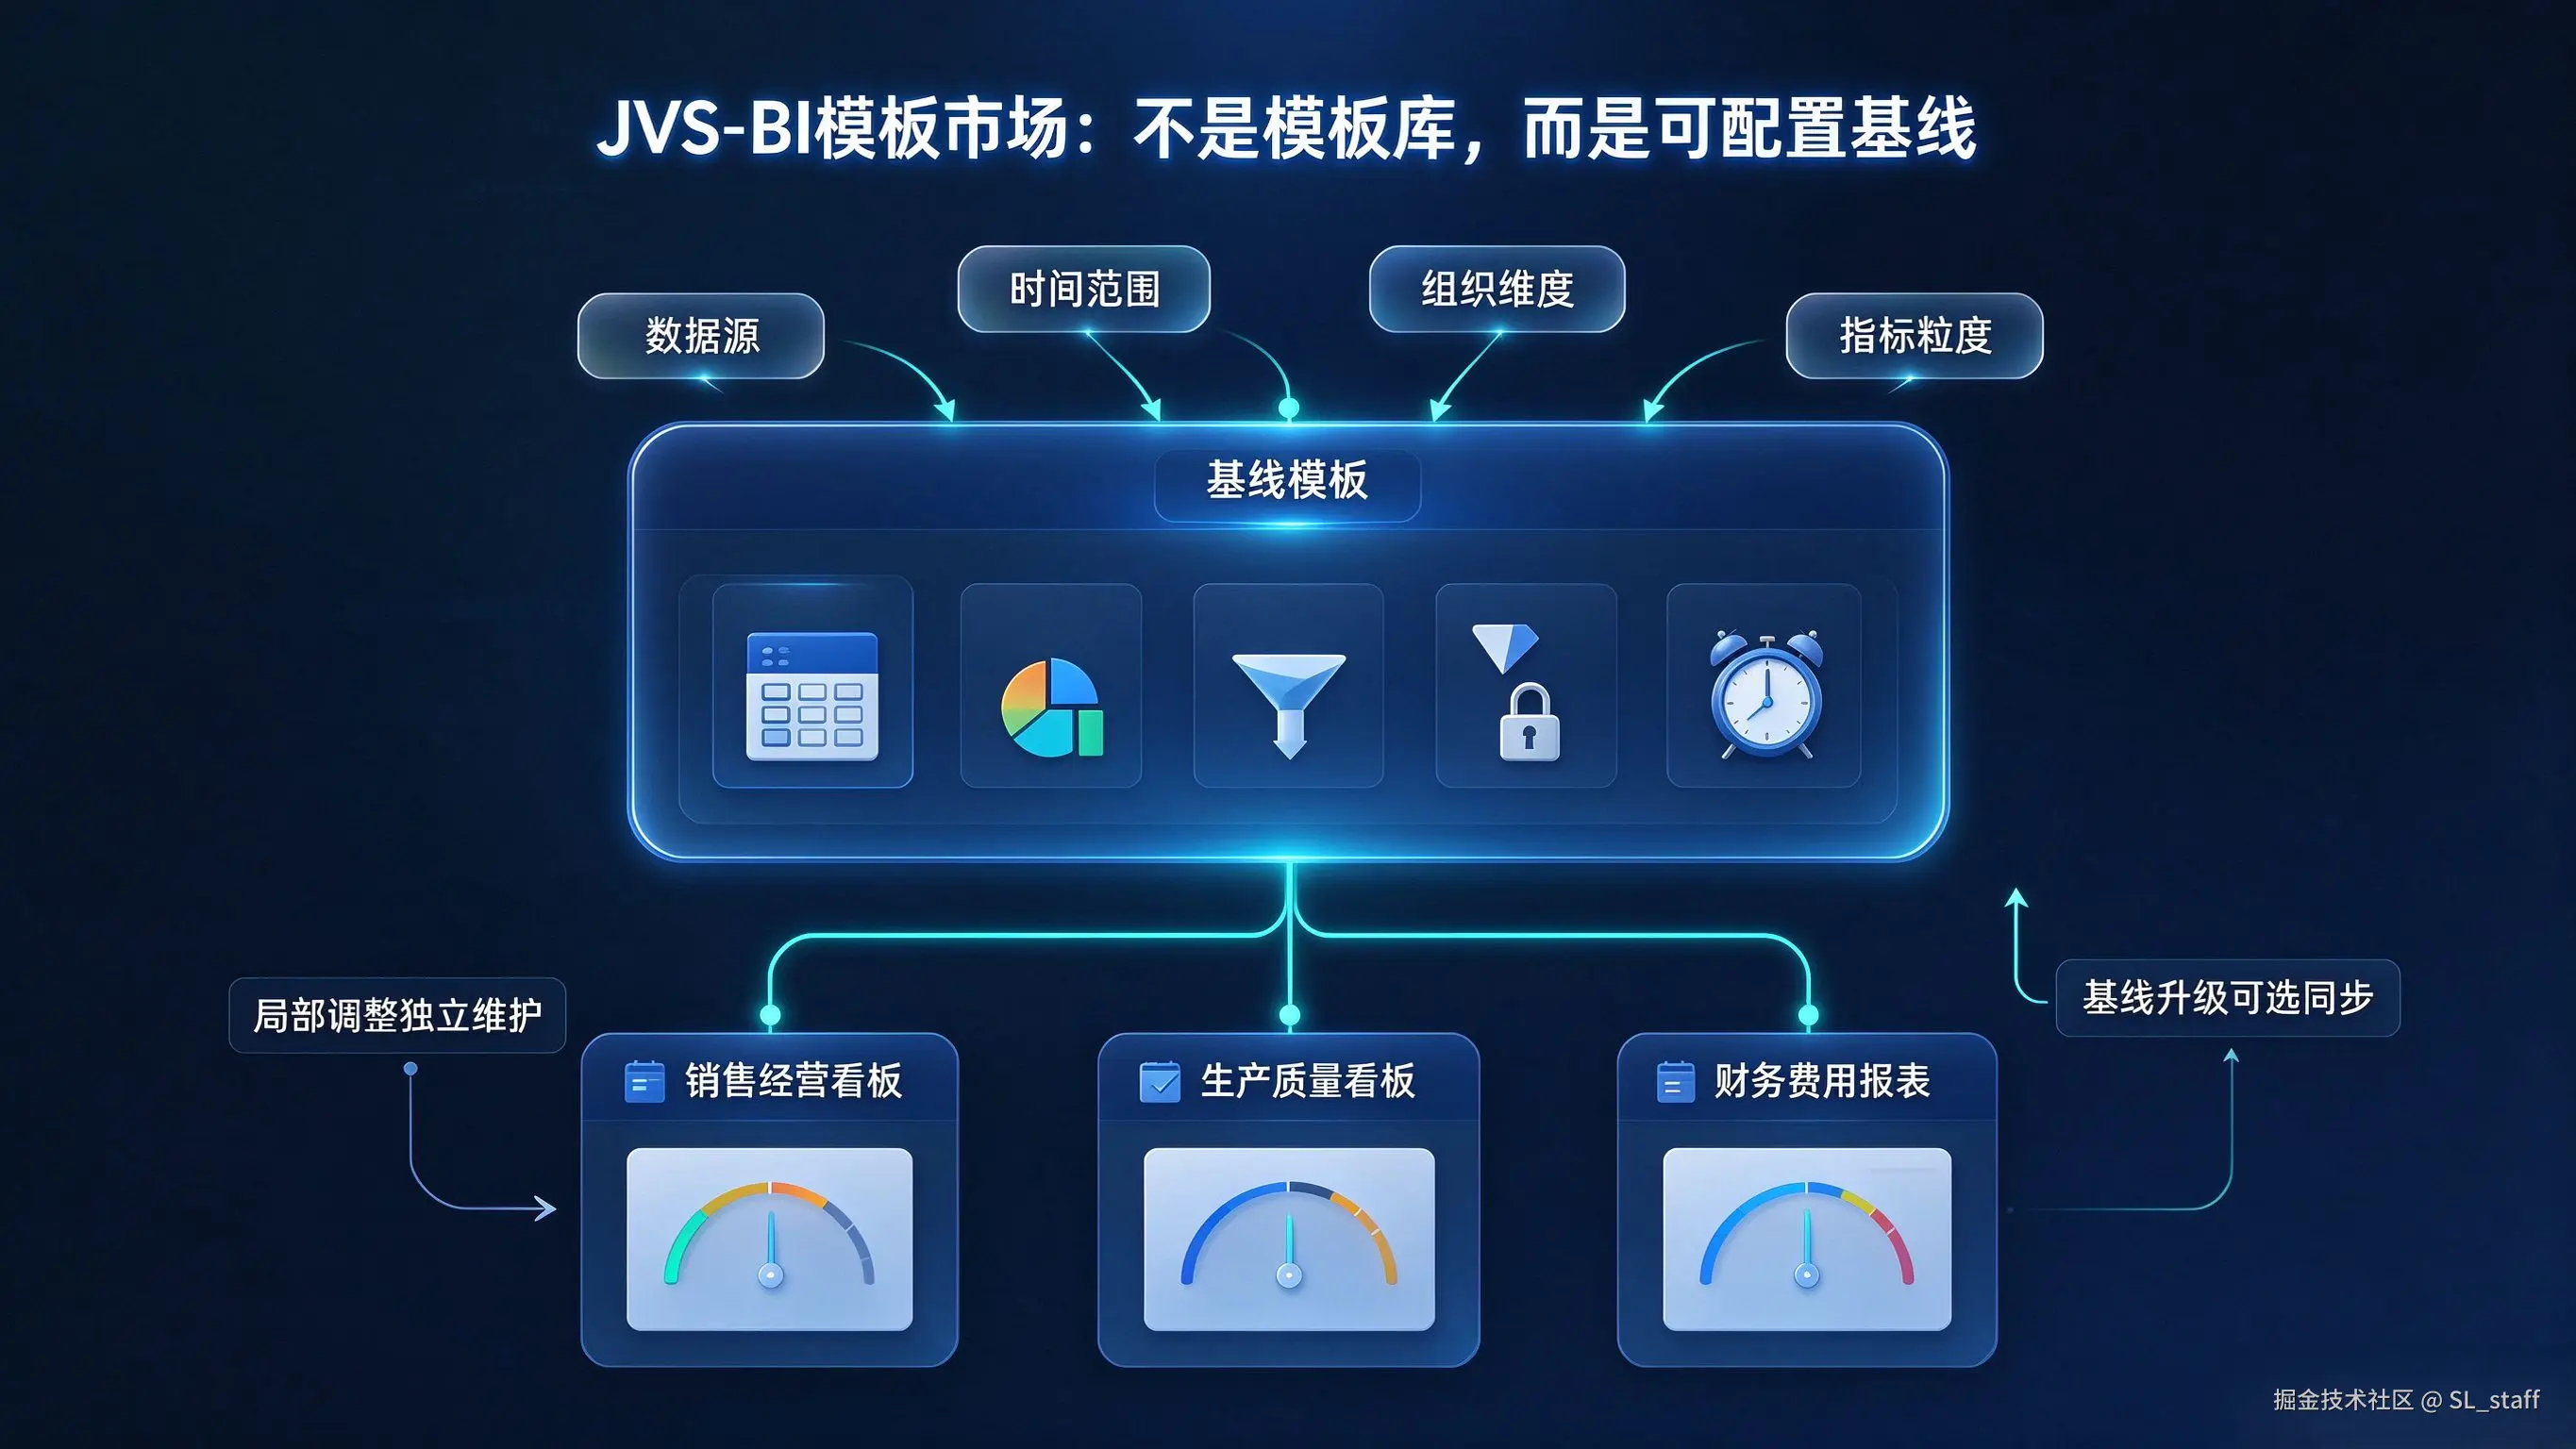
JVS-BI 模板市场并非静态资源集合,而是一套支持参数化继承的可配置基线体系。每个模板封装完整分析配置链路,包括:
-
已加工的标准数据集
-
预置图表与报表结构
-
字段筛选条件与钻取跳转路径
-
细粒度数据权限规则
-
调度更新策略
关键差异在于变量绑定机制:
-
所有动态要素(数据源连接、时间范围过滤器、组织架构维度、指标计算粒度)均以参数形式声明;
-
实例化时通过界面输入或系统上下文自动注入,无需触碰底层 SQL 或 JSON 配置;
-
继承保留完整血缘关系:子实例沿用父模板的数据加工逻辑与字段语义,规避因字段重命名或关联变更导致的 SQL 重写风险。
这种'模板 → 实例'派生模型,保障快速复用的同时,确保每次衍生具备独立可维护性------局部调整不影响基线,基线升级可选择性同步至下游实例。
字段热替换与样式全局联动:解耦配置与实现
字段热替换与样式全局联动,是降低二次开发耦合度的关键操作层能力:
-
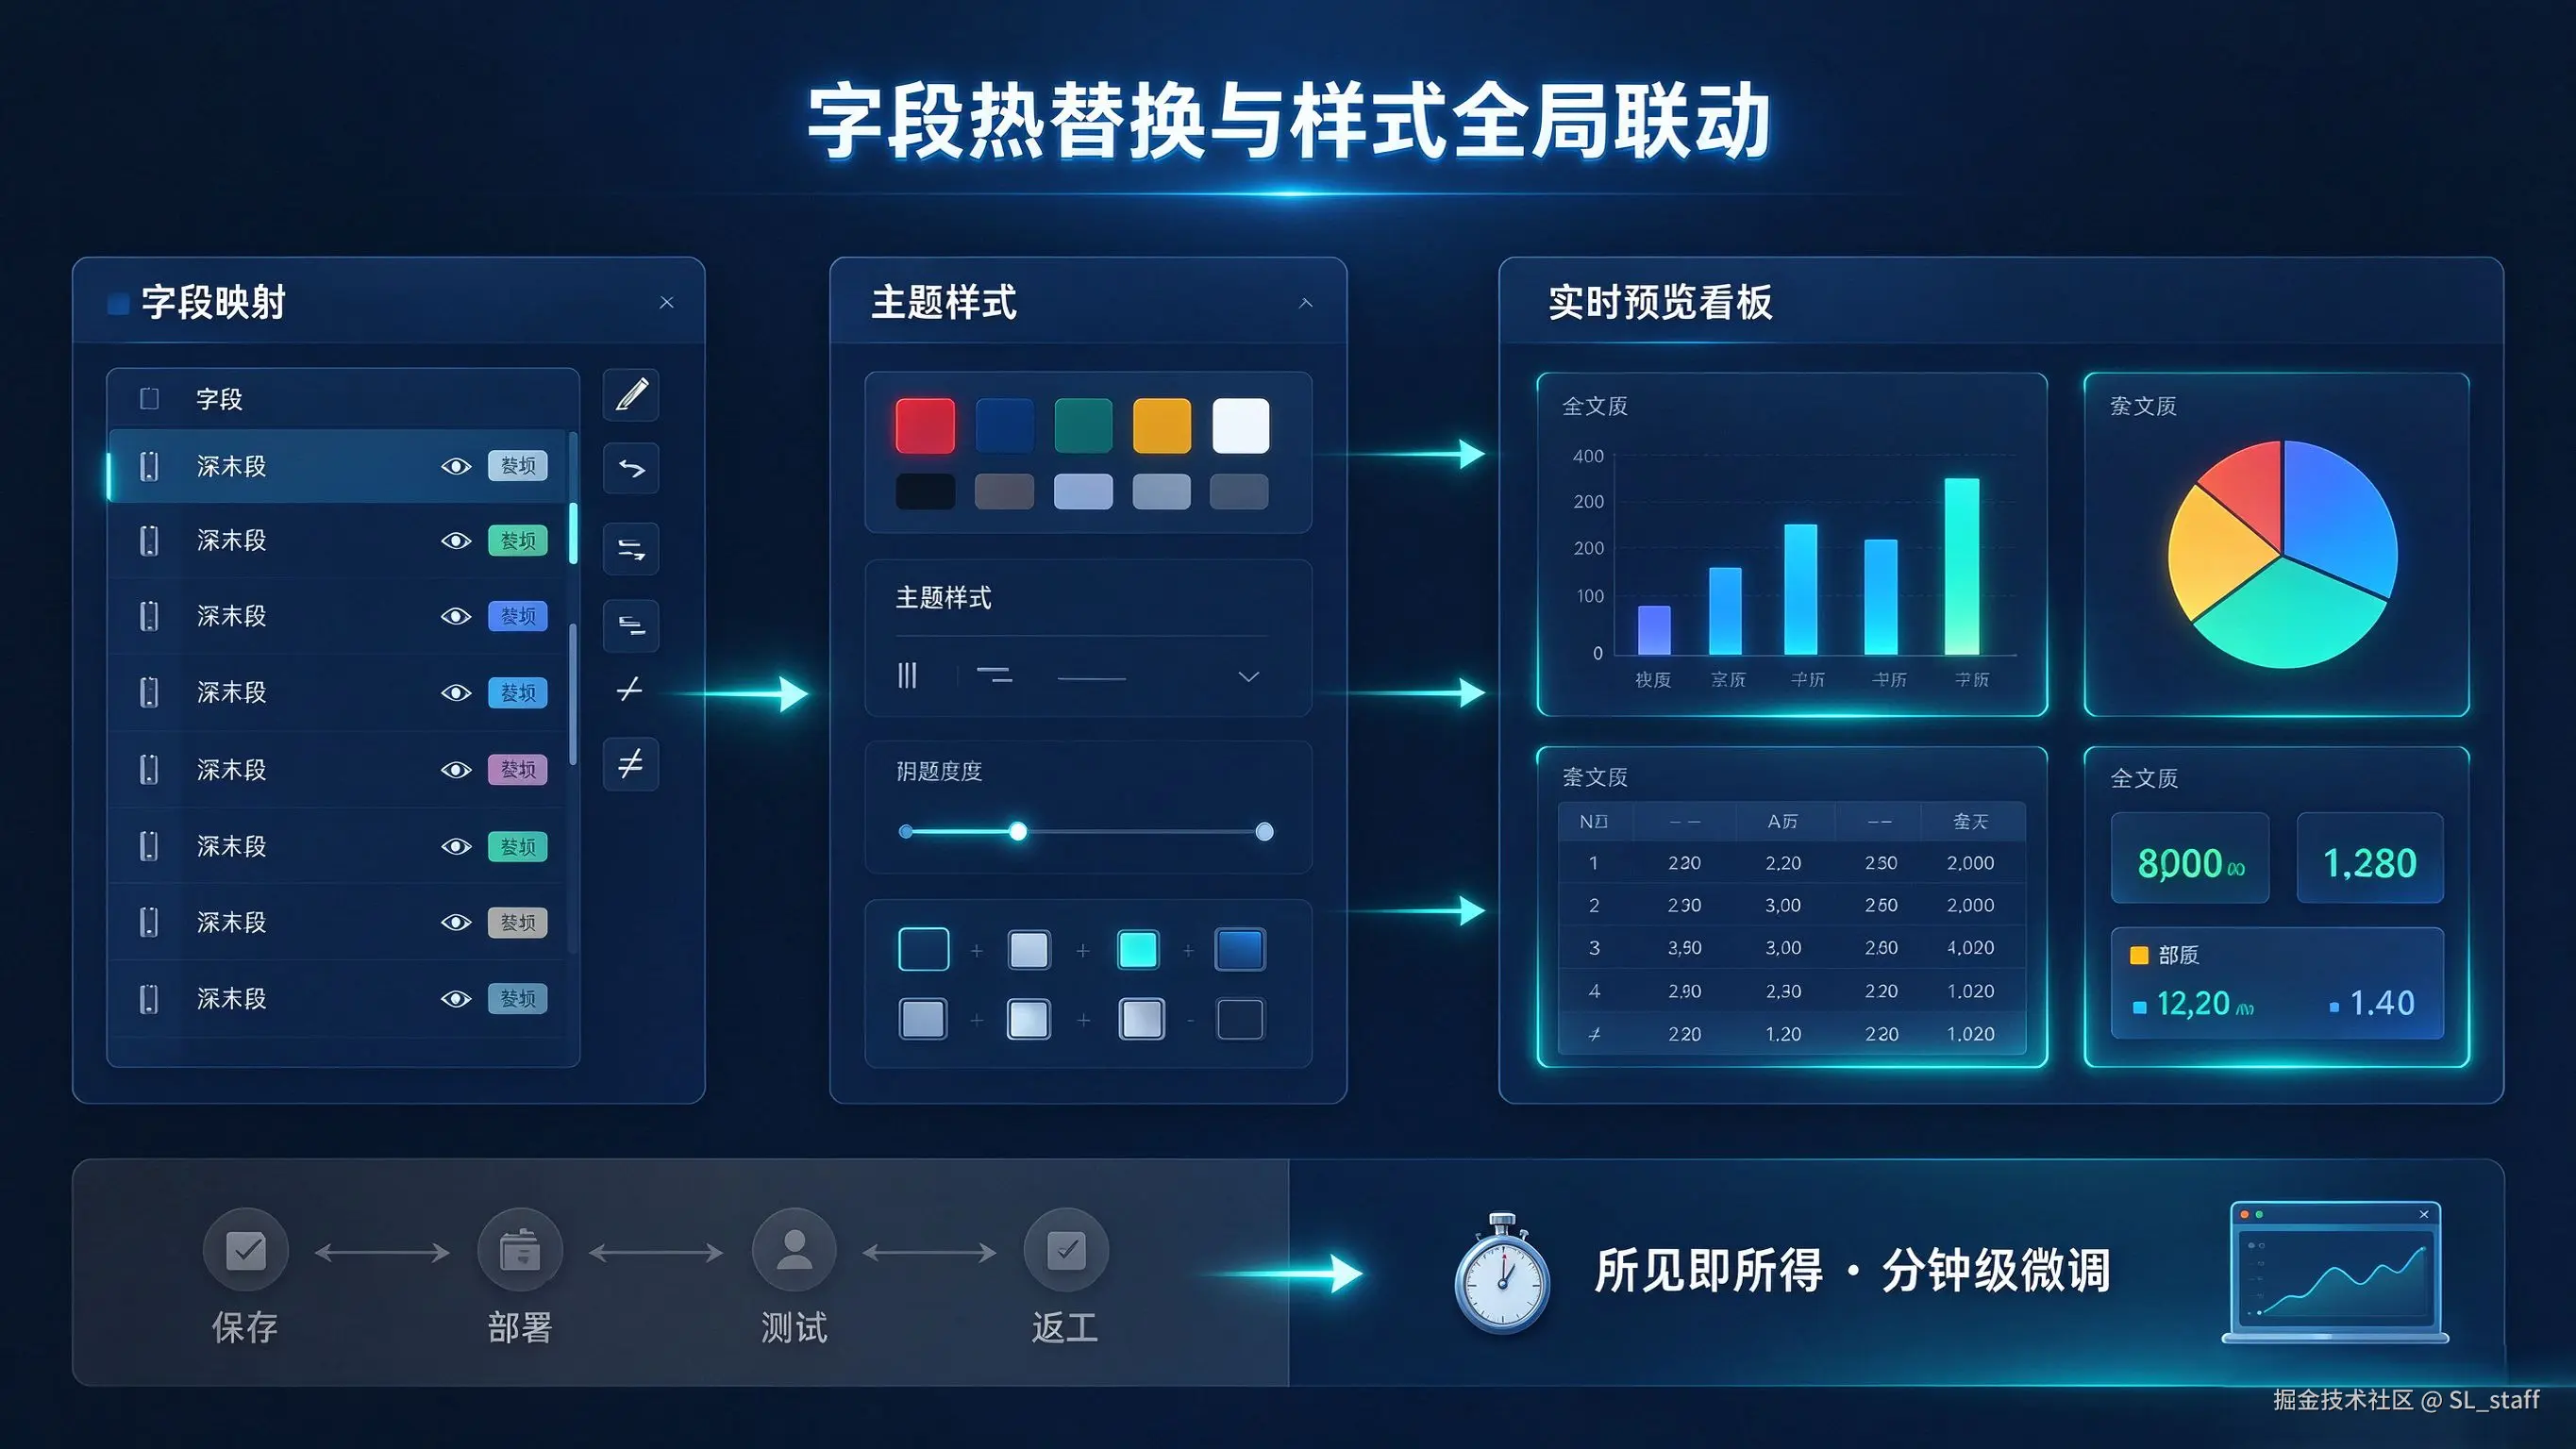
字段映射层:支持拖拽重命名、隐藏、排序字段;执行类型转换(字符串→数值)、空值替换等操作;所有变更实时作用于上层图表与报表,不修改原始数据集定义,也无需编写转换脚本;
-
样式配置层:主题色、字体族、间距、图例位置等抽离为独立配置项;页面级主题可一键应用至全部组件;单个组件支持覆盖式自定义;
-
交互逻辑层:下钻路径、跳转目标、联动触发条件随模板继承,并允许在实例中局部调整,无需重新配置底层事件绑定;
-
预览机制:所有配置变更支持所见即所得实时预览,跳过'保存---部署---测试---返工'闭环,高频微调压缩至分钟级。
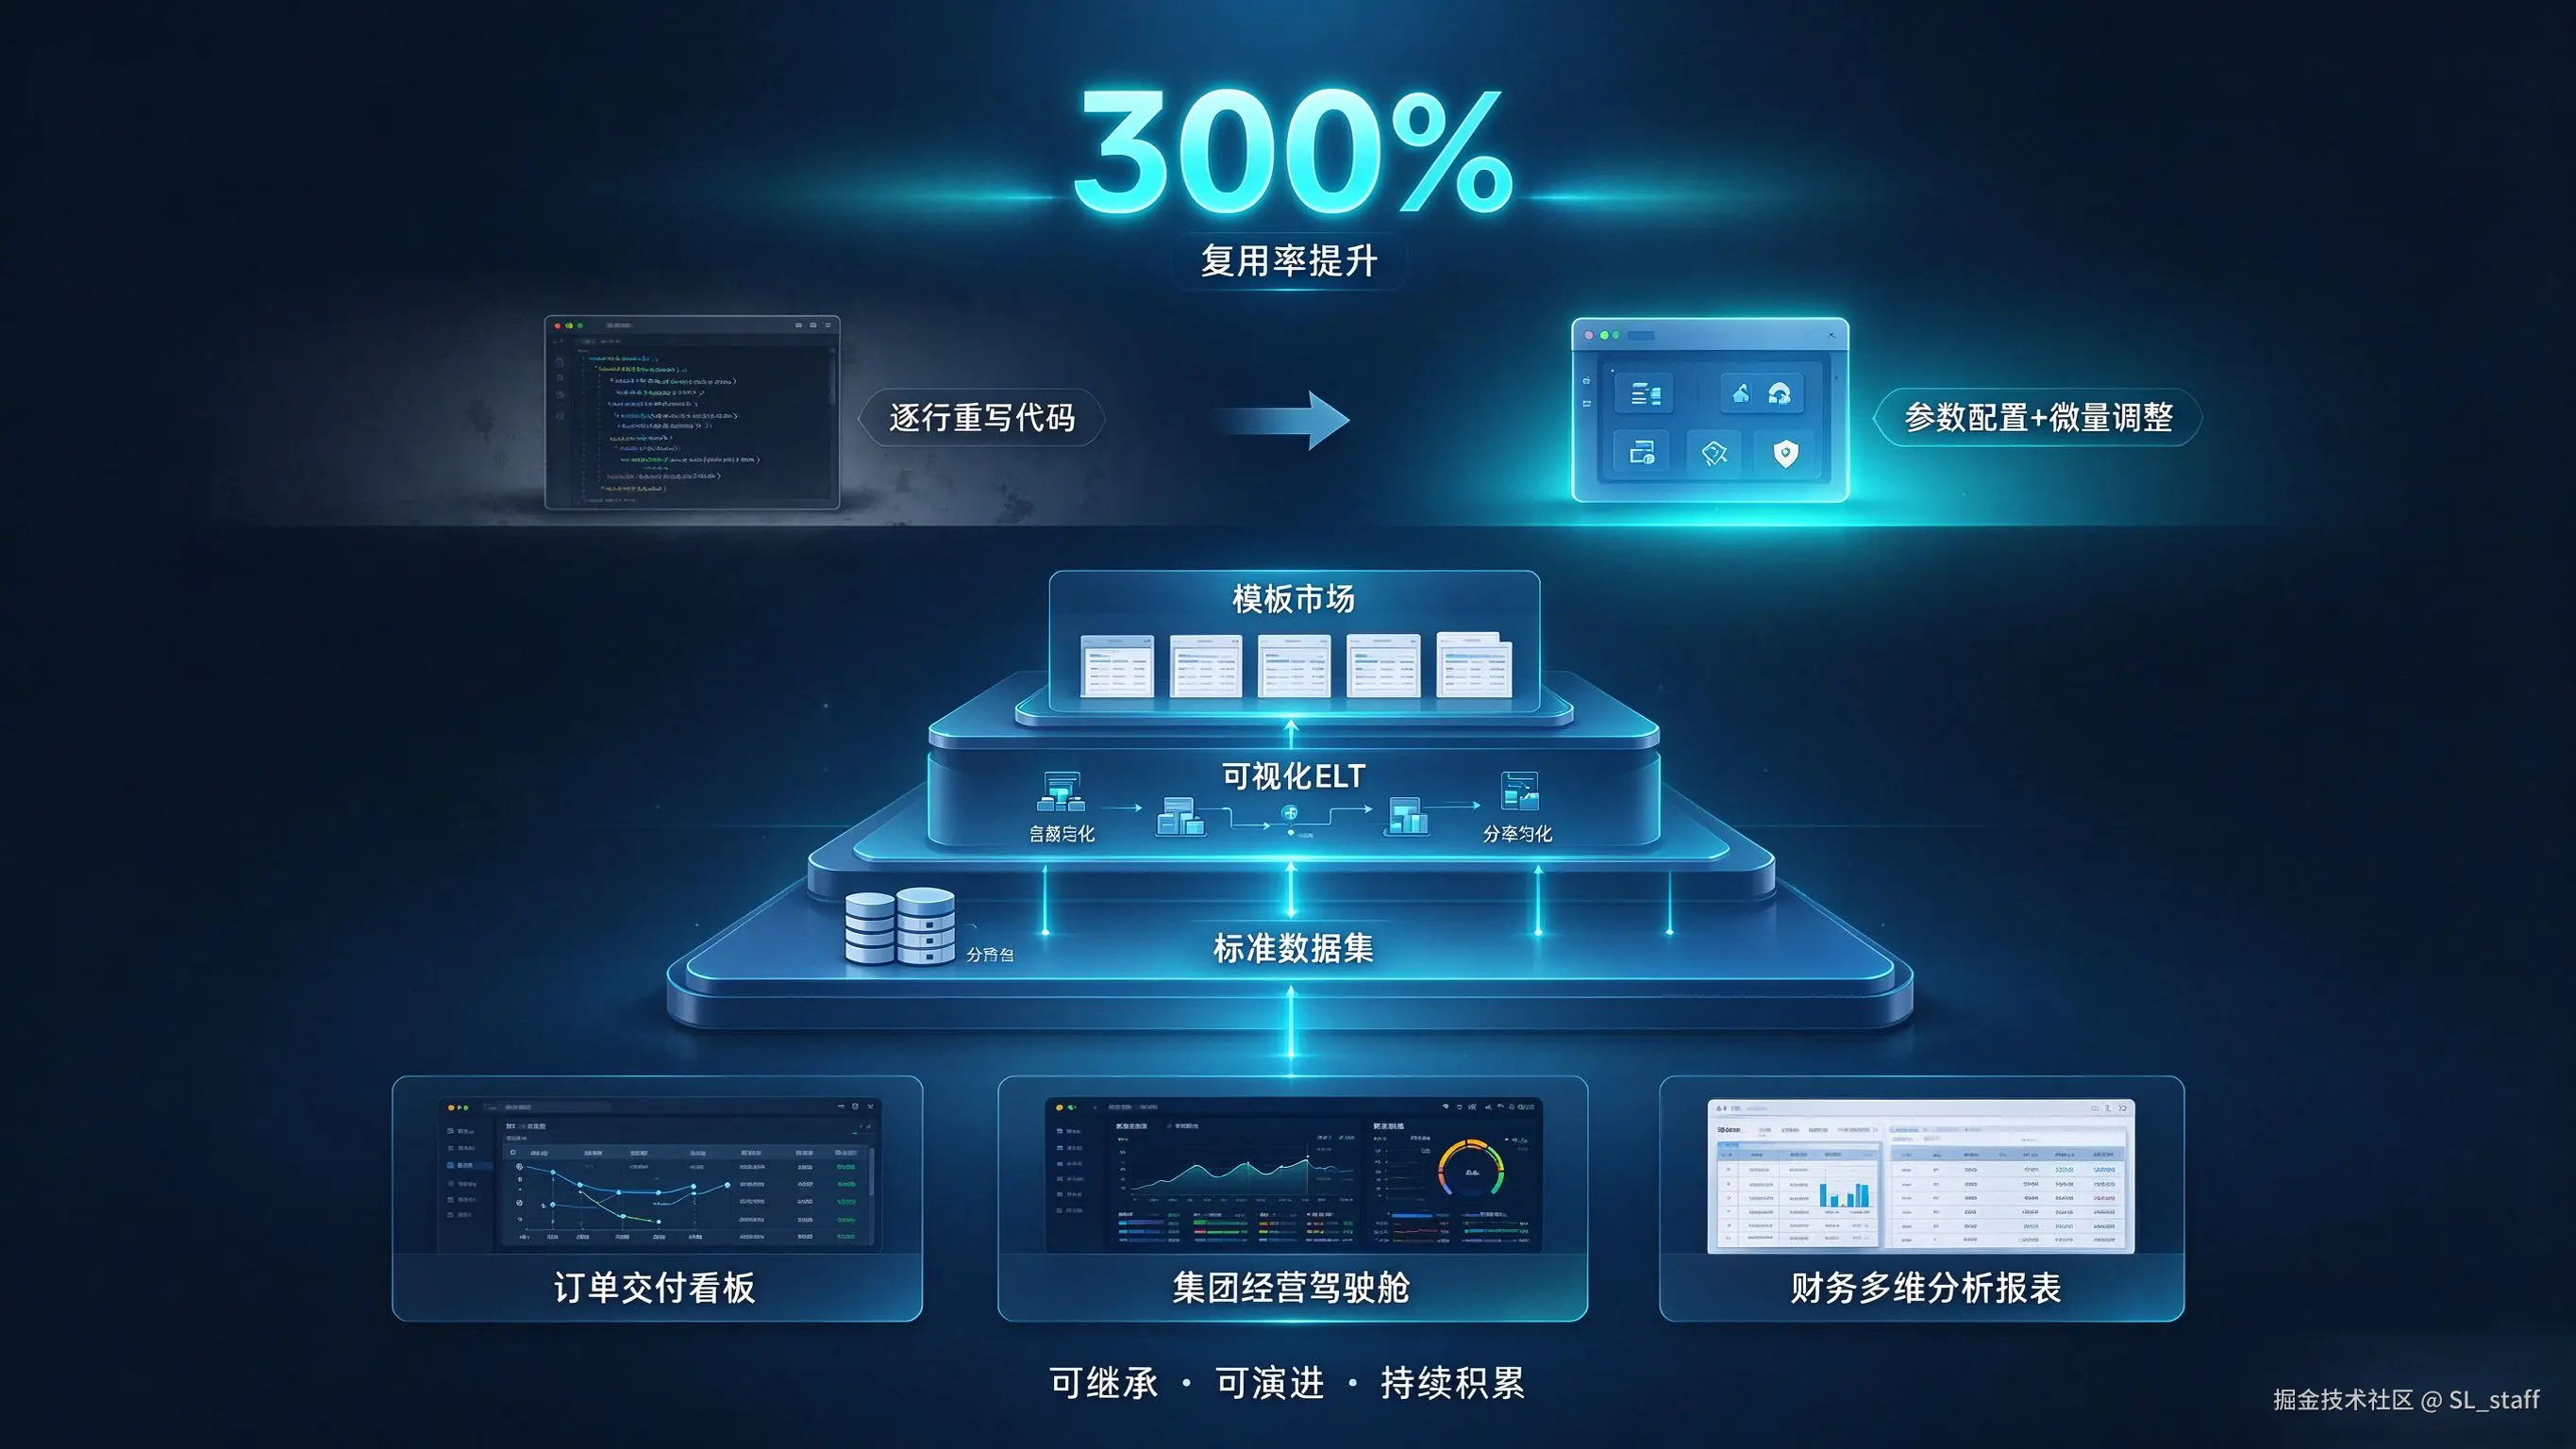
复用率提升 300%:背后是交付范式的转变
复用率提升 300%,反映的是报表交付范式从'逐行重写代码'转向'参数配置 + 微量调整'的本质变化。该能力成立依赖三者深度协同:
-
可视化 ELT 层统一输出语义清晰、口径一致的结果集;
-
标准数据集作为中间契约,确保下游消费一致性;
-
模板基于标准数据集构建,使复用内容在业务含义上始终对齐。
这种解耦显著降低对 SQL 编写与前端开发技能的强依赖,让 BI 开发重心回归业务逻辑表达本身:
-
选择维度
-
定义指标
-
配置交互
-
划定权限
长期看,该架构为行业模板沉淀与数据资产目录建设提供基础------制造企业的订单交付看板、集团经营驾驶舱、财务多维分析报表等,均可作为可继承、可演进的资产持续积累,而非一次性交付项目。