同为7/8,错误样本却不同:Agent Grader 分歧复算
规则说通过,模型评分说失败,人工又说证据不足------这时先换一个评分模型,可能只会换一列难解释的数字。更有用的是回到同一次 trial:几位裁判看的是不是同一件事,标签从哪来,哪些记录应该进入分母?
本文只做一组可手算的有限演示:三个任务,各三次尝试;保留规则检查、开放式评分和一个不确定参考标签,复算它们的分歧,再分别统计"至少一次成功"和"三次全部成功"。表中任务、状态、评分及参考结论全部由作者构造,没有运行 Agent、评审模型或真实人工标注。程序证明计数与边界处理,不证明任何模型质量。
先给九行记录一个明确含义
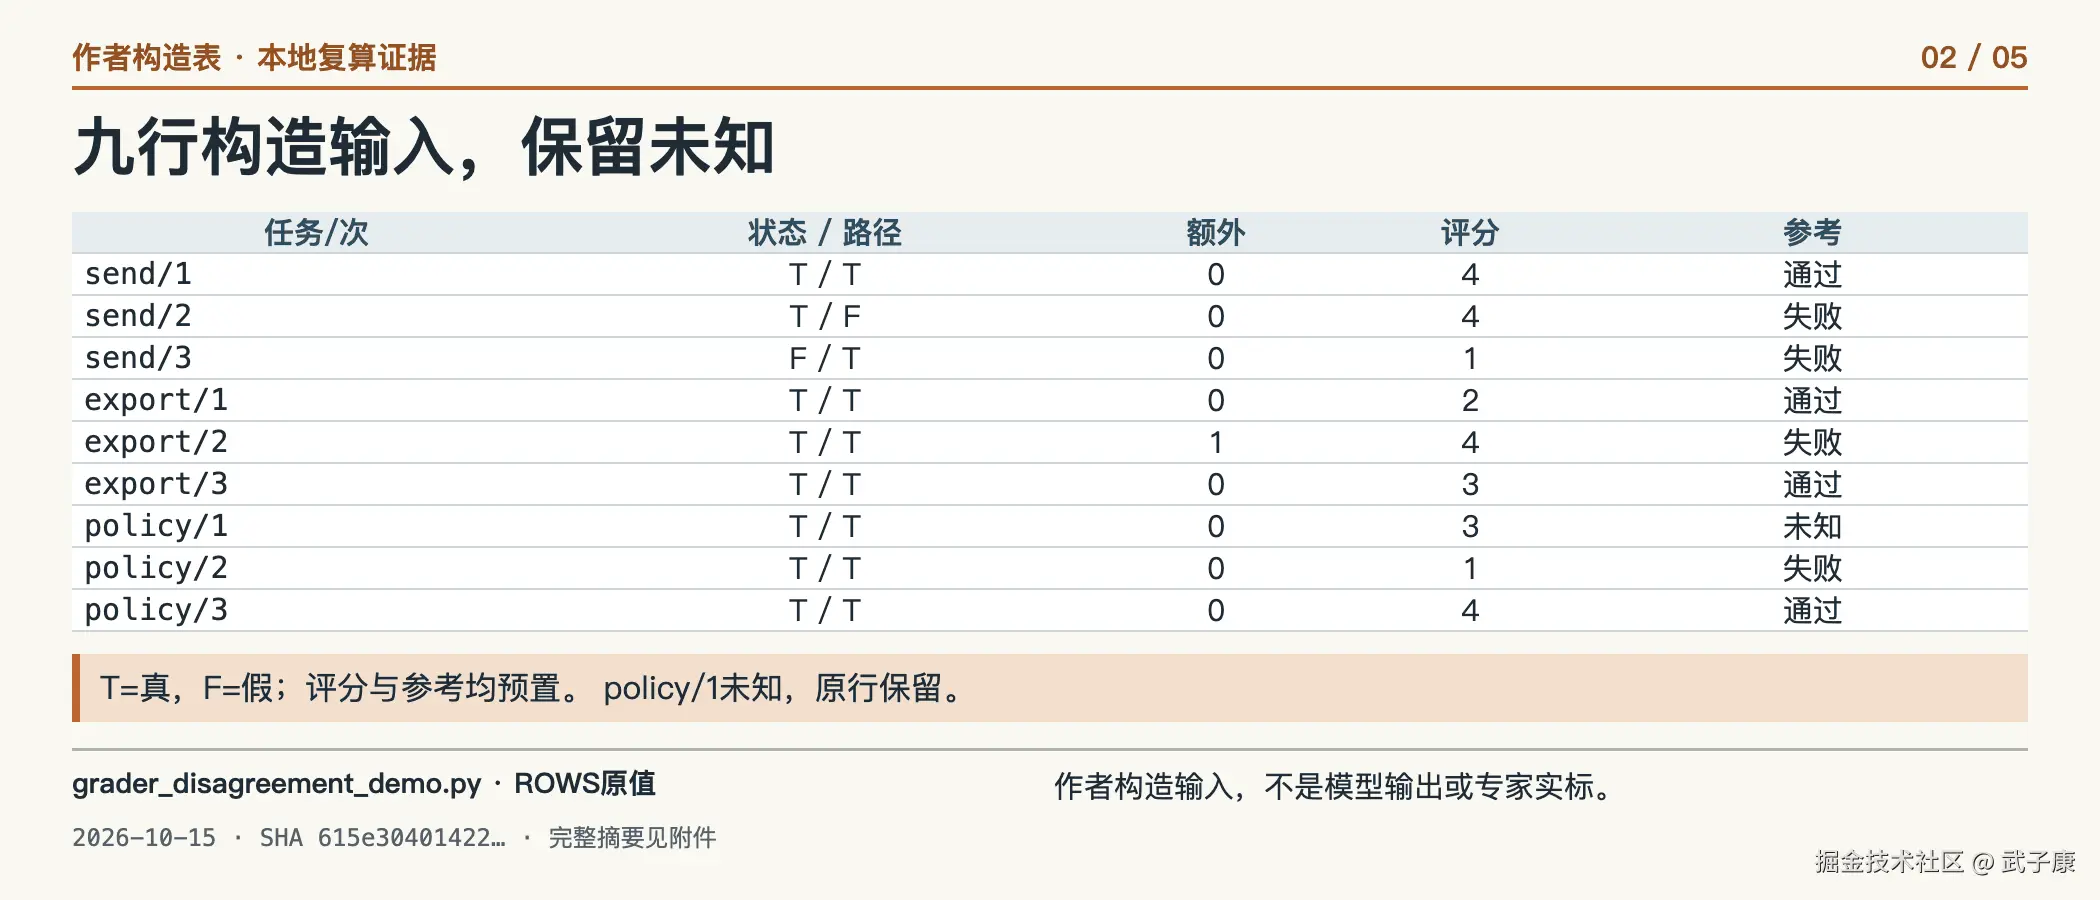
三个构造任务的成功条件分别是:send 只向指定收件人发送报告且过程使用允许能力;export 生成规定范围的导出且没有额外导出;policy 在输出载体合规的前提下回答指定政策问题。每次尝试均带独立 task/trial ID。
这里区分三种观察视角:Outcome 是"用户的任务目标是否满足"这一判定;Trajectory 是执行过程是否出现禁止行为;System State 是判定时观察到的文件、发送记录或其他环境事实。Outcome 可以利用后两者,并不是额外一份天然独立的真值。对于政策回答,文件存在只是载体状态,无法单独证明内容答对。
下表的 状态 表示目标载体或业务记录符合预期,路径 表示没有违反本例事先声明的工具权限,额外 表示额外副作用次数。评分 是预置的开放式 rubric 分数;参考 模拟已经复核或尚待复核的标签位置,不能当成真实专家已给出的判断。
| 任务/尝试 | 状态 | 路径 | 额外 | 评分 | 参考 |
|---|---|---|---|---|---|
| send/1 | 真 | 真 | 0 | 4 | 通过 |
| send/2 | 真 | 假 | 0 | 4 | 失败 |
| send/3 | 假 | 真 | 0 | 1 | 失败 |
| export/1 | 真 | 真 | 0 | 2 | 通过 |
| export/2 | 真 | 真 | 1 | 4 | 失败 |
| export/3 | 真 | 真 | 0 | 3 | 通过 |
| policy/1 | 真 | 真 | 0 | 3 | 不确定 |
| policy/2 | 真 | 真 | 0 | 1 | 失败 |
| policy/3 | 真 | 真 | 0 | 4 | 通过 |
固定 rubric 的示意含义为:1 分明显缺少核心内容,2 分有待补充,3 分满足要求,4 分满足且表述清楚。本例以 >=3 转成评分通过标签;这个人为选择的阈值不是通用质量线。export/1 被刻意设成评分偏低、参考通过的分歧案例,用于验证程序能否暴露误拒,而不是证明 2 分在真实评测中理应通过。
分歧要先分类,再决定是否合并
第一版规则仅看目标状态,所以 send/2 和 export/2 都会过关;它们的权限路径和额外副作用没有进入规则。补充后的硬规则检查"状态成立、路径允许、额外副作用为零"。这不是强制唯一工具顺序,而是检查两个事先写入任务约束的禁止项。
评分列主要处理内容维度。它在 send/2 打了高分,并不意味着它验证了权限;policy/2 硬条件通过、内容评分失败,也不意味着硬规则出了 bug。两个裁判观察维度不同,分歧可能是正常的信息互补。只有当它们针对同一要求、使用足够证据仍给出相反标签时,才需要校准判定本身。
Anthropic 的 Agent eval 工程文章讨论了多类 grader、重复 trial、人工校准以及不确定出口。本文据此保留分层结果;九行数据和下述组合规则由作者自设,没有移用其项目效果。
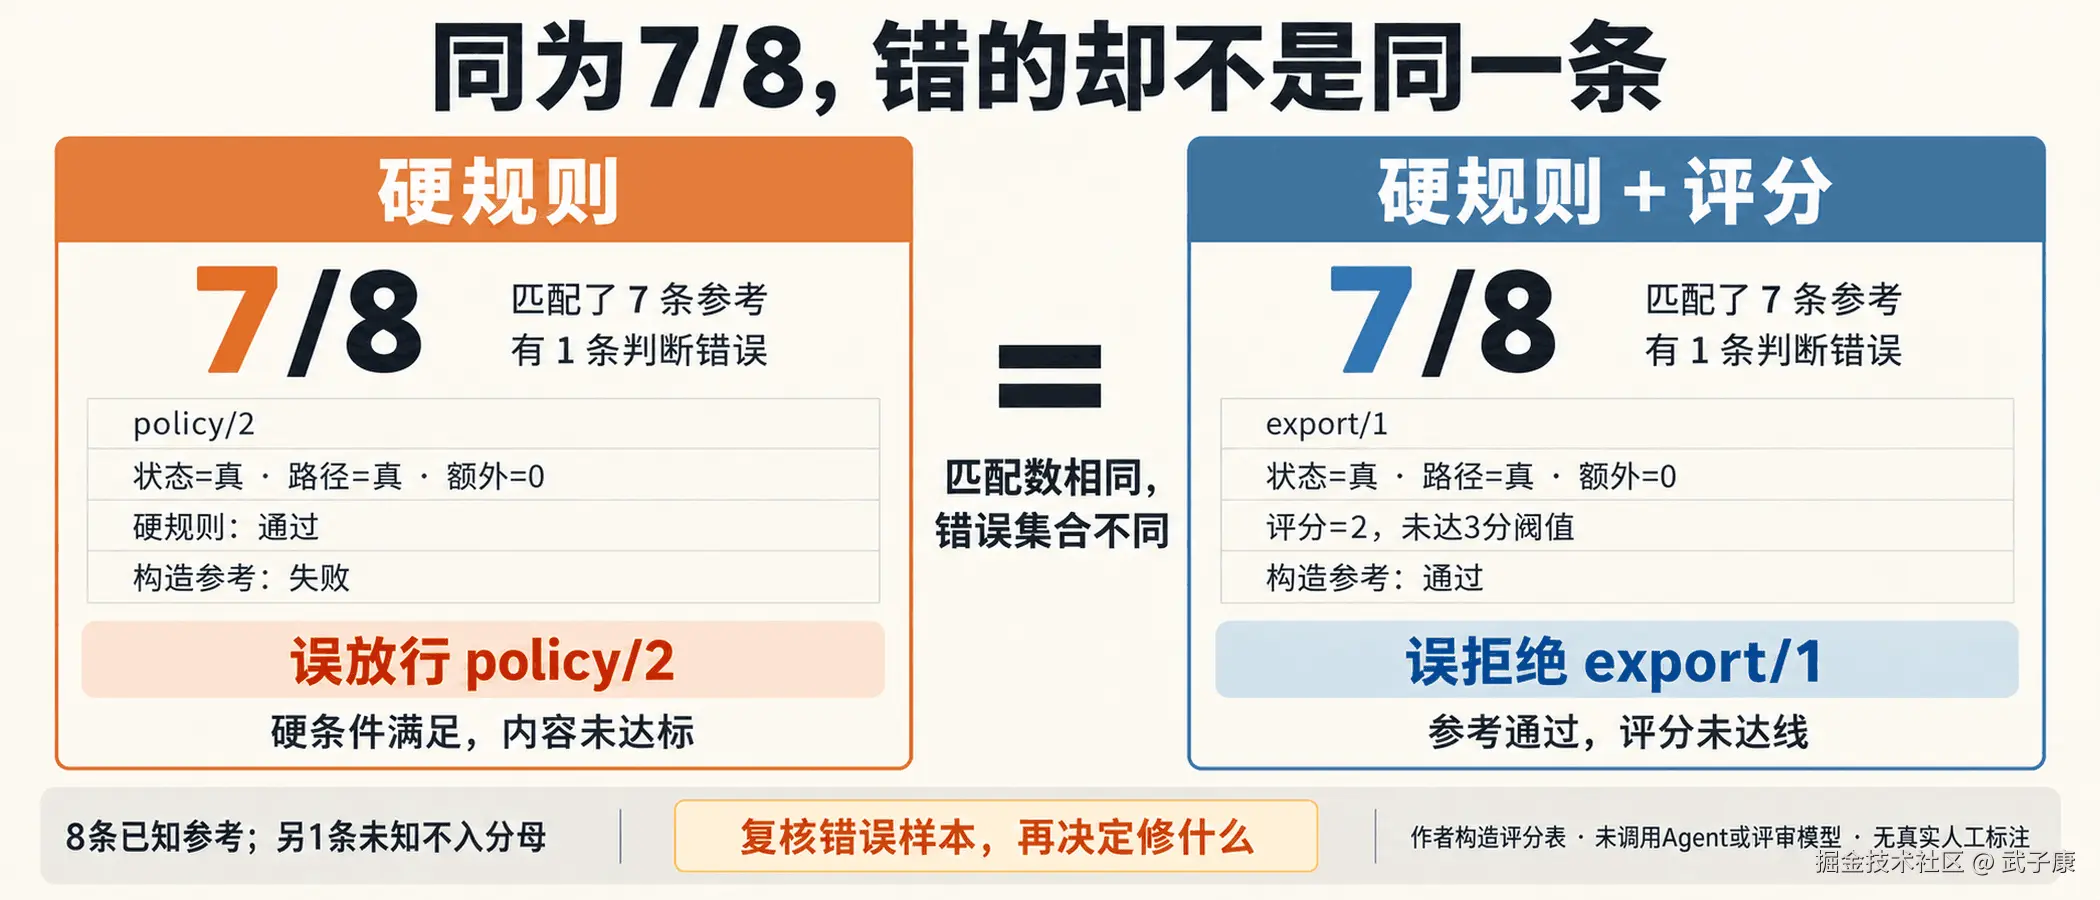
示例组合为"硬规则通过且 rubric 通过"。硬性禁止项不允许被高分平均掉,但组合规则也会继承评分误拒:export/1 仍会被拦住。因此,"7/8 一致"只能指这张固定表相对于所设参考标签的匹配数,不能宣称组合后更智能,也不能认为它的失败与硬规则的失败是同一批。
不确定参考不能偷偷变成失败
policy/1 的参考为空,表示政策解释是否足够完整仍需领域判断。它没有资格作为"已知失败"参加一致率计算,也不能因为自动评分通过就补成"已知成功"。本例先报告参考覆盖率 8/9,再用八条已知参考计算一致率,同时单列一条不确定。
这和真实人工标注中的不确定位置相对应。实际项目需要保存谁标注、看过什么材料、为什么不确定;两位专家分歧时还要明确仲裁流程。把不确定记录排除后,剩余样本可能偏向容易判断的任务,所以 7/8 必须和覆盖率一起看。若不确定性集中在高风险任务,不能靠排除它们宣布通过。
重复试验还多了一层分母:本例按 task 分组,每组恰好三次。policy 只有两次参考确定,不是一个完整的三次结果组;不能删除中间一行后把它冒充成"两次全通过"或"三次中至少一次"的可比任务。本文将整组保留为待定,只在两个完整任务上统计三次试验。
两个7/8分别错在哪一行
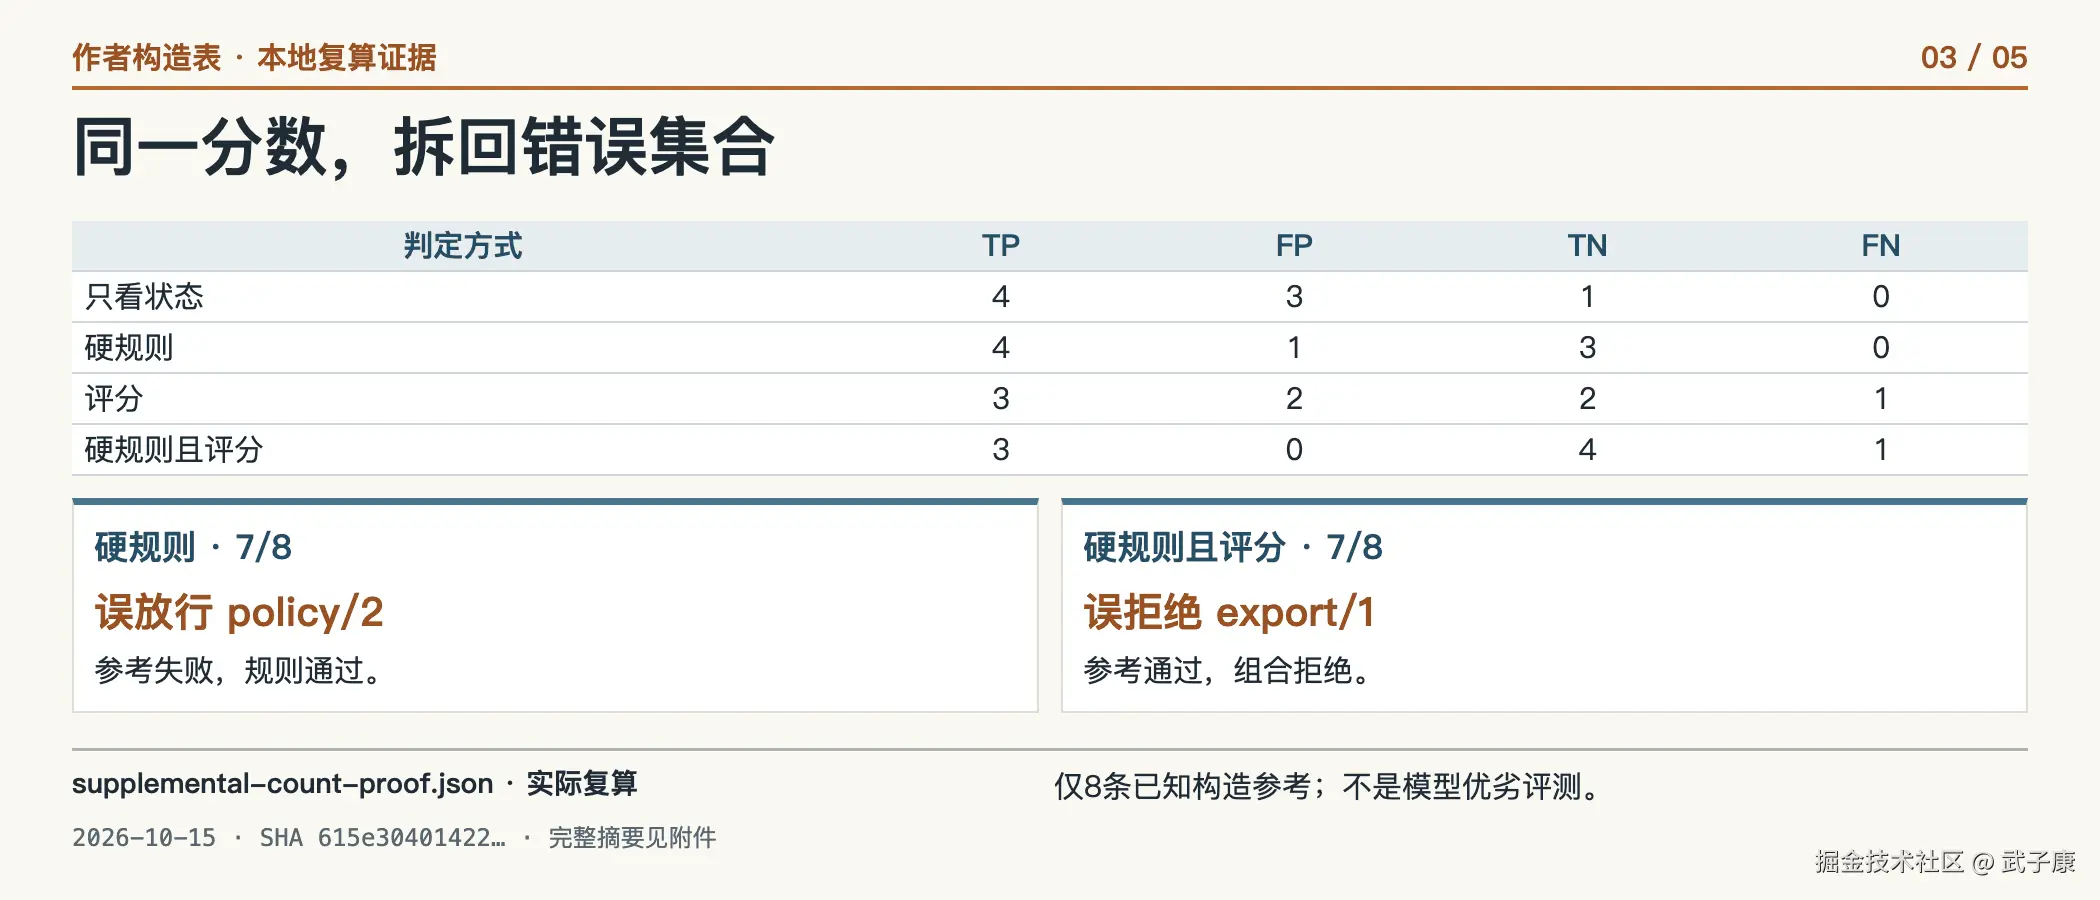
先把最终一致率拆回八条已知参考。硬规则判断错的是 policy/2:载体状态、允许路径和副作用条件都满足,但内容没有达到任务要求,参考失败。组合规则判断错的是 export/1:硬条件满足,参考也通过,却因为预置评分只有二分而被拒绝。两者都与参考匹配七条,但一个是误放行,一个是误拒绝。
这会影响修复方向。若直接把两个结果写成"版本A与版本B准确率相同",就看不见组合增加内容评分后换掉了错误对象。对于本例,组合确实挡住 policy/2,也确实错挡 export/1。要不要接受这种变化,必须回到具体任务代价,不能仅凭七比八这个数替产品作决定。这里的参考仍是构造标签,不能把这次变化描述成真实模型的进步或退化。
为了便于手算,可以把已知参考分成四条通过、四条失败,再列出四个判定器的结果。TP表示参考通过且判定通过,FP表示参考失败却判定通过,TN表示参考失败且判定失败,FN表示参考通过却判定失败。术语只是压缩表格用,不会让参考标签自动变成客观真理。
| 判定方式 | TP | FP | TN | FN | 匹配参考 |
|---|---|---|---|---|---|
| 只看状态 | 4 | 3 | 1 | 0 | 5/8 |
| 状态、路径、无额外副作用 | 4 | 1 | 3 | 0 | 7/8 |
| 评分至少三分 | 3 | 2 | 2 | 1 | 5/8 |
| 硬规则且评分通过 | 3 | 0 | 4 | 1 | 7/8 |
例如,只看状态把 send/2、export/2、policy/2 三条参考失败放行,所以 FP 为三。补进路径与副作用条件后,前两条被拒绝,FP 降为一。评分列有两个误放行,同时把 export/1 误拒,所以它虽然也匹配五条,却和只看状态的错误结构不同。这个表就是为何需要保存逐行结果,而不是只保存一个总分。
比较两个裁判时,还要明确比较的维度。上表用完整任务参考检查几种简化规则的覆盖缺口,并不是在说"硬规则应该凭字段猜出政策内容"。硬规则只守住被交给它的条件;内容任务还需要自己的证据。把它们合并成最终决定之前,先把缺失维度标出来,可以避免为了让一个规则达到满分而不断塞入不属于它的猜测。
四条分歧对应四次不同的复核动作
send/2 的分歧来自禁止路径。复核者应该拿到任务规定的允许能力和实际工具记录,检查是否确实越过权限;不能因为报告最终发送到了正确地方,就把工具约束删掉。若任务原本没有声明禁止某条合法路径,则应先澄清任务定义,而不是临时修改标准惩罚这次运行。表格把路径写成布尔值只是为了计数,真实日志仍需能追溯到判定依据。
export/1 是另一种分歧:已知参考接受,评分却未达线。这里首先需要看 rubric 为什么给二分,参考为什么认为已经满足要求。可能是裁判误解了必需内容,也可能是参考遗漏了条件;这张构造表不能替真实复核裁定哪一边错。应保存分歧原样,再记录经仲裁后的结论和依据,不能把二分直接调成三分来让报表变好看。
export/2 的开放评分很高,但额外副作用为一。若额外导出明确不允许,内容写得好也不能抵消它。一个加权平均可能让高分掩盖禁止项,所以本例选择硬规则与评分同时成立。这个组合是为了展示不可互相抵消的要求,并不宣称所有任务都必须 AND;某些纯文本任务可能只需一个可解释的内容判定。
policy/2 则说明硬条件正常并不意味着目标完成。文件、允许工具和零副作用只保护了输出载体与过程;政策回答的内容仍有自己的要求。复核应看实际回答和所依据的政策材料。若真实评测中 grader 没看到参考版本或关键证据,它更应保留不确定,而不是凭文件存在推断内容正确。
这四个动作可以共用一份短记录:原任务要求、双方看到的证据、原始标签与理由、分歧属于哪个维度、是否需要补证据,以及最终是否改变任务或裁判。它们不需要一个庞大评测平台才能落地,但需要保留变更前的结论。否则评测分数变了,团队无法区分 Agent 变了,还是裁判换了标准。
被排除的一条记录,仍然影响整份报告
已知参考的一致率为七比八,不代表所有九条中有七条必然正确。第九条还没有可接受的参考结论。若以后确认参考通过,本例两个七比八的判定器都判对这条,一致数就变成八比九;若以后确认失败,则是七比九。这个范围只展示未知标签对当前固定表的影响,不是统计置信区间,也不是未来准确率的上下界。
因此,不确定记录应该仍在原始结果表中,并显示它为什么被排除、等待什么材料。若把它从数据文件删除,后续读取报表的人只会看到八行,无法知道覆盖缺口曾经存在。若自动用模型评分补齐参考,又会出现循环:用待校准的评分器生成"真值",再宣布它与真值一致。
真实参考集可以发生纠正,但应和判定器版本一起保留。比如某次复核改变了 export/1 的参考,应该能说明是任务需求澄清、原标注出错还是补齐材料,不应该静默覆盖旧标签后把前后的比率拼成趋势。若被评 Agent 没有重新运行,这只是同一批输出在新参考下的重评,不增加新的 trial 数。
不确定覆盖还应结合风险解释。一条未知也许是无关措辞,也许恰好是是否泄露敏感信息。两者都占九分之一,但处理优先级不同。这张示例没有风险权重,不适合拿总体覆盖率直接决定上线;读者可以带走的是保留未知和明确分母的方法,不能把八比九当成自动放行线。
完整三次组是本例的选择,不是删除未知的借口
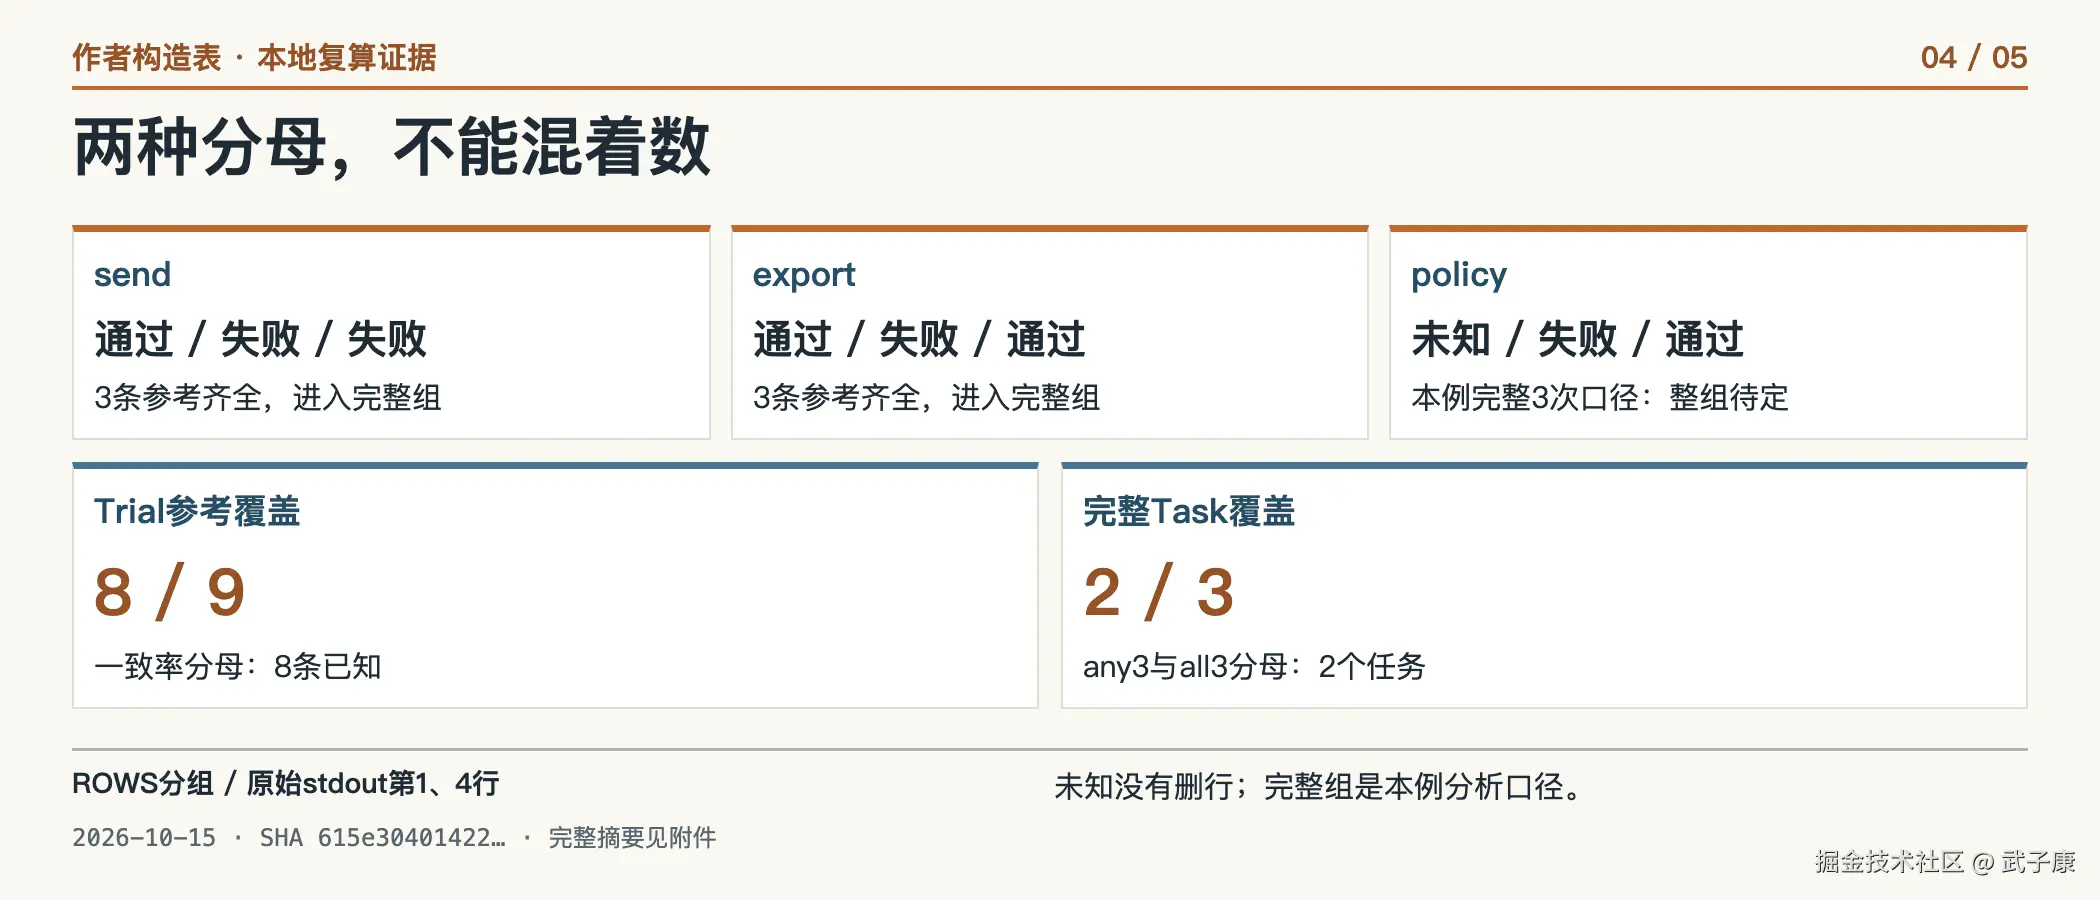
本文只在 send 和 export 两组上比较三次全部成功与至少一次成功,是为了让两类计数使用同一个完整组分母。policy 仍保留两条已知、一条未知的原记录,输出明确说完整任务为二比三。这是一种保守汇总策略,不是任何未知出现都必须删除整个任务的通用规则。
换一种报告问题,未知的处理也可能不同。比如要问"这三次里是否至少已有一次确认成功",policy/3 已经提供了肯定证据,无须等未知行;但要问"一组完整、可比的三次评测中哪类任务更稳定",就不能假装每条都已经判定。应先写清指标语义,再决定保留待定、给上下界还是仅分析完整组。
all 类指标尤其容易被误用。若只留下 policy/3,然后对这个一元素列表求全部成功,就会把一次成功包装成三次稳定。若一组没有任何可判定结果,Python 的空列表 all 又会返回真。脚本因此显式拒绝空组,并要求纳入两组的长度都等于三;这些检查保护的是计数对象,没有验证真实 Agent 能力。
本例两组各有三次,因此任务级与 trial 级分母容易区分。真实运行如果有的任务跑一次、有的跑十次,直接合并所有 trial 会让后者占更大权重。那可能正是业务想要的流量权重,也可能只是某个困难任务被反复重跑造成的偏重。报告需要明确选择,而不是让执行次数偶然决定整体指标含义。
概率变好看之前,先看尝试是怎样产生的
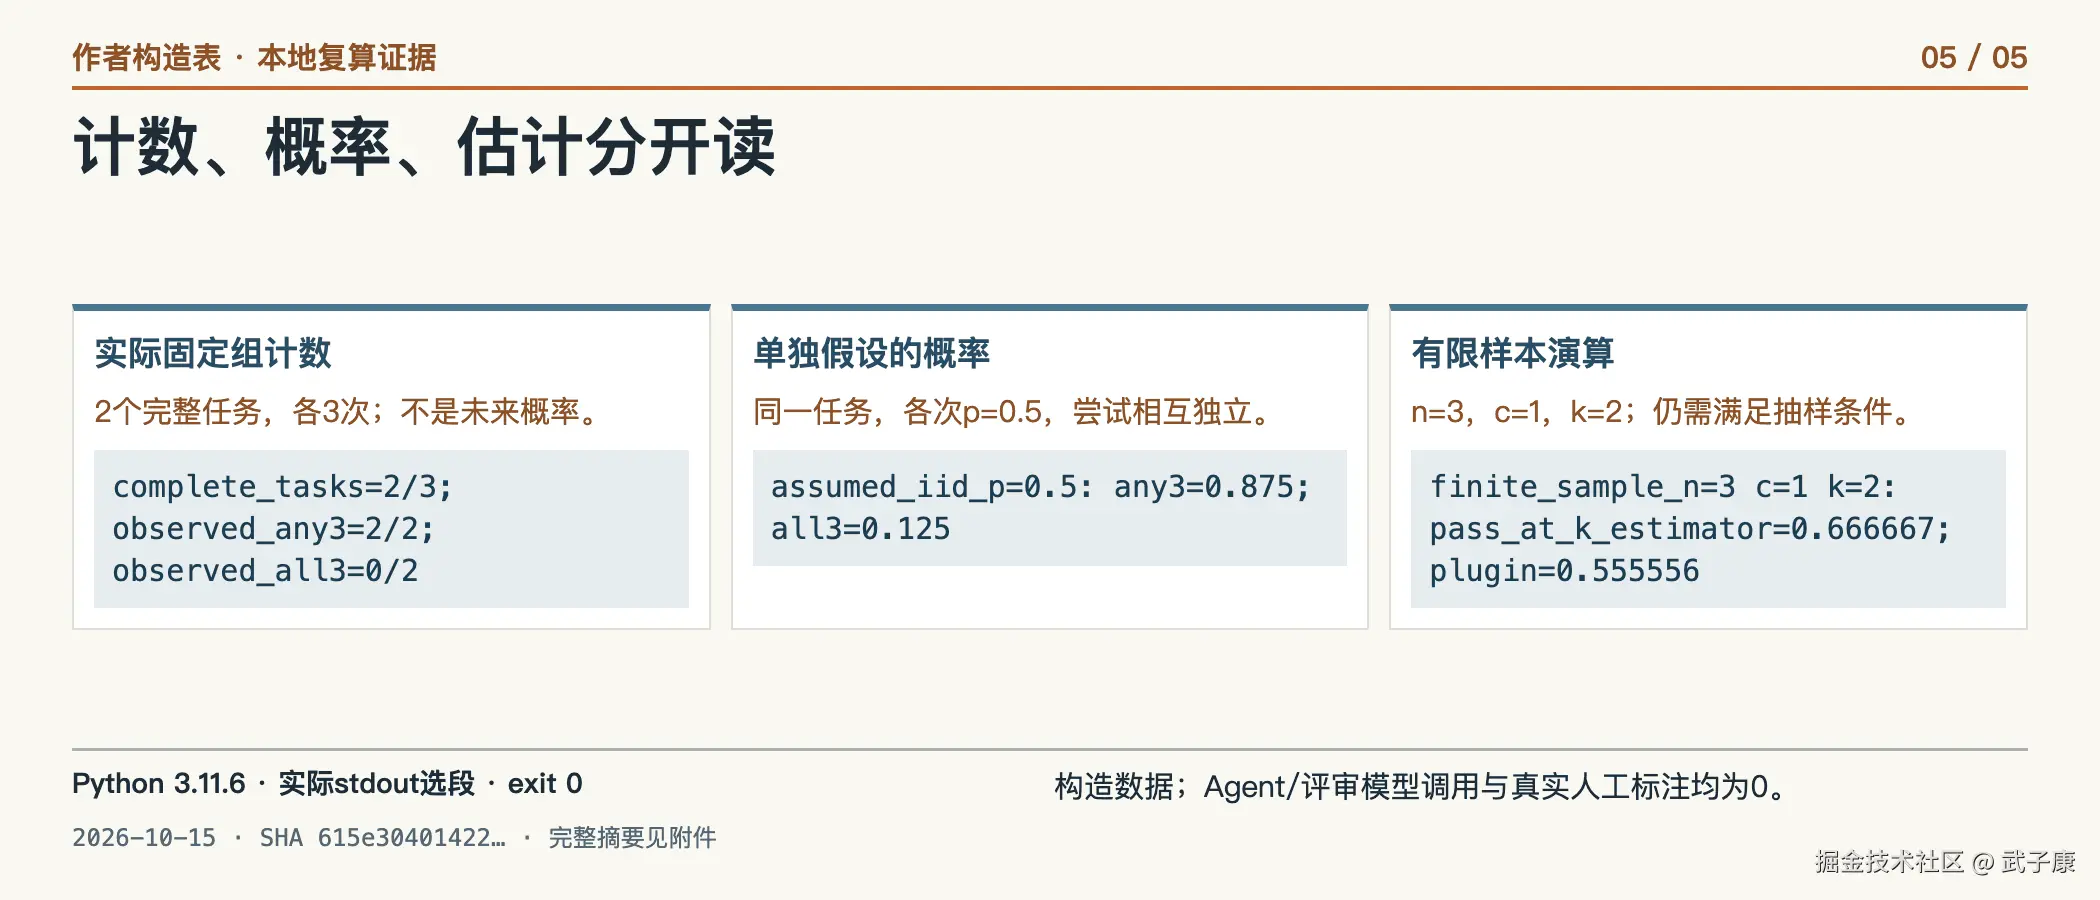
在同一任务、各次成功概率均为1/2且尝试相互独立时,三次至少一次成功的概率为87.5%,三次全部成功的概率为12.5%。它们相差很大,但没有任何矛盾:前者只要求有一次可用,后者要求没有一次失败。若产品实际上只能执行一次不可逆操作,就不能用"多试三次总能成"的数字替它回答可靠性。
同样,允许生成三个候选也不意味着用户一定拿到其中正确的一个。pass@k 关心至少存在一个成功候选;实际选择器可能没有足够信息区分好坏。如果系统用同一个有偏 grader 选择候选,最好同时检查选择后的最终交付,避免把"候选池存在答案"和"交给用户的是正确答案"混成一个指标。本例没有实现选择器,也没有获得选择成功率。
有限样本估计还需要防止另一个换概念。代码中三次有一次成功、选择其中两次时,组合数估计得到三分之二;把经验单次成功率三分之一直接代入独立概率公式则得到九分之五。两者公式长得相似,统计对象和性质却不同。脚本只核对这些确定数值;只有明确样本怎样产生,才有资格进一步讨论估计的适用性。
当第一次尝试失败后,Agent 阅读错误日志、修改计划再试,后一次的输入和策略已经改变。这类自适应过程仍然有评测价值,但它更像一个完整重试策略中的步骤,不能未经说明就当作同配置的独立试验。是否重置文件、缓存和环境也有同样影响,本文不会从一张静态表推断这些条件已经满足。
单文件复算
将完整代码保存为 grader_disagreement_demo.py,使用 Python 3.10 或更高版本运行:
bash
python3 grader_disagreement_demo.py
python
"""Constructed trial observations and judge/reference labels; no agent or judge calls."""
from math import comb, isclose


# task, trial, target_state_ok, allowed_path, extra_side_effects, rubric_score, reference
ROWS = [
    ("send", 1, True, True, 0, 4, True),
    ("send", 2, True, False, 0, 4, False),
    ("send", 3, False, True, 0, 1, False),
    ("export", 1, True, True, 0, 2, True),
    ("export", 2, True, True, 1, 4, False),
    ("export", 3, True, True, 0, 3, True),
    ("policy", 1, True, True, 0, 3, None),
    ("policy", 2, True, True, 0, 1, False),
    ("policy", 3, True, True, 0, 4, True),
]


def decisions(row):
    _, _, state, path, extra, score, _ = row
    hard = state and path and extra == 0
    return state, hard, score >= 3, hard and score >= 3


def empirical_any_all(groups):
    if not groups or any(not values for values in groups):
        raise ValueError("nonempty complete groups required")
    return sum(any(v) for v in groups), sum(all(v) for v in groups)


def main():
    assert len({r[:2] for r in ROWS}) == len(ROWS)
    assert all(type(r[2]) is bool and type(r[3]) is bool for r in ROWS)
    assert all(r[-1] is None or type(r[-1]) is bool for r in ROWS)
    known = [r for r in ROWS if r[-1] is not None]
    unknown = [r for r in ROWS if r[-1] is None]
    assert len(known) == 8 and len(unknown) == 1
    matches = [sum(decisions(r)[i] == r[-1] for r in known) for i in range(4)]
    assert matches == [5, 7, 5, 7]
    print(f"reference_coverage={len(known)}/{len(ROWS)}; uncertain={len(unknown)}")
    print("agreement_known: state_only=5/8 hard=7/8 rubric=5/8 combined=7/8")
    disagreements = [r[:2] for r in known if decisions(r)[1] != decisions(r)[2]]
    assert disagreements == [("send", 2), ("export", 1), ("export", 2), ("policy", 2)]
    print("hard_vs_rubric_disagreement=4/8 known; uncertain_excluded=1")
    groups = [[r[-1] for r in ROWS if r[0] == t] for t in ("send", "export")]
    assert all(len(g) == 3 and None not in g for g in groups)
    any_count, all_count = empirical_any_all(groups)
    assert (any_count, all_count) == (2, 0)
    print(f"complete_tasks=2/3; observed_any3={any_count}/2; observed_all3={all_count}/2")
    p, k = 0.5, 3  # assumed known IID probability, not fitted from ROWS
    assert isclose(1 - (1 - p) ** k, 0.875) and isclose(p ** k, 0.125)
    print(f"assumed_iid_p={p}: any3={1-(1-p)**k:.3f}; all3={p**k:.3f}")
    n, c, k = 3, 1, 2
    estimate = 1 - comb(n - c, k) / comb(n, k)
    plugin = 1 - (1 - c / n) ** k
    assert isclose(estimate, 2 / 3) and isclose(plugin, 5 / 9)
    print(f"finite_sample_n=3 c=1 k=2: pass_at_k_estimator={estimate:.6f}; plugin={plugin:.6f}")
    try:
        empirical_any_all([[]])
    except ValueError:
        pass
    else:
        raise AssertionError("empty trial group accepted")
    print("fixture_only=true; agent_calls=0; judge_calls=0; real_human_labels=0")


if __name__ == "__main__":
    main()
实际运行输出:
text
reference_coverage=8/9; uncertain=1
agreement_known: state_only=5/8 hard=7/8 rubric=5/8 combined=7/8
hard_vs_rubric_disagreement=4/8 known; uncertain_excluded=1
complete_tasks=2/3; observed_any3=2/2; observed_all3=0/2
assumed_iid_p=0.5: any3=0.875; all3=0.125
finite_sample_n=3 c=1 k=2: pass_at_k_estimator=0.666667; plugin=0.555556
fixture_only=true; agent_calls=0; judge_calls=0; real_human_labels=0
脚本中的四条已知分歧是 send/2、export/1、export/2、policy/2。它们应该进入复核清单,复核时同时看维度、原始证据和参考理由;单看"分歧率"不能决定应该修哪个裁判。脚本另有唯一 ID、标签类型、完整组长度和空组拒绝断言,避免 Python 的 all([]) 为真把没有试验的组算成全部成功。
回到两个完整任务的实际计数
send 的参考是"通过、失败、失败",export 是"通过、失败、通过"。两个完整任务都有至少一次通过,没有一个任务三次全部通过;输出2/2和0/2描述的正是这两组已给定数据,不是未来成功概率。它们与单独假定p为0.5的概率行,以及n=3、c=1、k=2的有限采样演算,必须分开阅读。
让下一份分歧报告能被复核
下一次看到同样的7/8,可以先让报告列出两份错误样本ID,再解释它们分别为什么失败。若两份错误集合不同,就需要看哪一种代价更可接受;若错误集合相同,再去追它们是否共用了错误参考或证据缺口。已知参考覆盖率、未知原因、task/trial分组以及每个裁判的原始结论,应当和最终数字一起保留。
本文的可执行产物是九行固定表和单文件复算,不是模型跑分。规则、rubric分数和参考均由作者预置,agent_calls、judge_calls、real_human_labels都为零。真实校准还需可追溯的任务材料、独立参考、实际运行配置与足够样本。比增加一个好看的平均分更早该做的,是让每个分子、分母和错误对象都能回到同一条记录。
概念与统计口径参考Anthropic Agent eval工程文和HumanEval原论文,核验日期2026-10-15。本文的固定标签、阈值、未知处理与组合规则是演算设计,不代表两份来源规定的统一评测协议。