大家好,我是数据库小学妹👋我踩过的坑,你别再踩。今天聊数据库运维。去年冬天,我跟着一个项目做割接。上线第一周,监控大屏全是绿的。CPU 不高,连接数正常,磁盘也没报警。可业务群里已经炸了。订单查询慢得离谱。
我上去看执行计划,才发现是统计信息太旧。优化器拿着老数据估行数,选错了连接方式。监控没骗人,它只是没看到这一层。那天之后,我对"数据库运维"有了新的理解。它不是把大屏点亮,是让系统在没人盯着时,也能稳稳地跑。
一、数据库运维到底管什么?先把六件事摆上桌
先把定义说清楚。数据库运维,是数据库上线后的一整套活动。它围绕稳定、性能、安全、可恢复和成本展开。它管的是一条完整生命周期。从部署、巡检、备份、监控,一路到变更和容灾。一句话判断标准:业务敢不敢把核心系统交给你。这就是数据库运维的上限。这六件事平时都在做,但做没做好,出事那一刻才见分晓。
| 数据库运维工作 | 平时做什么 | 出问题时的第一反应 | 做好的标志 |
|---|---|---|---|
| 安装部署与升级 | 装库、初始化、打补丁 | 回滚到上一版本 | 升级有回滚方案,验证有记录 |
| 备份与恢复 | 全量、增量、逻辑备份 | 找最近的备份 | 真恢复过,知道要多久 |
| 监控与告警 | 看指标、收告警 | 翻聊天记录找上次怎么处理 | 告警能分级,能指到人 |
| 性能与容量 | 慢 SQL、索引、连接数 | 加内存、加索引 | 有基线,能提前扩容 |
| 高可用与容灾 | 主备、读写分离、切换 | 手动切,边切边查文档 | 定期演练,切换有把握 |
| 变更与安全 | 工单、审计、权限 | 先改再说 | 变更前有检查,变更后可追溯 |
六件事里,容易被低估的是备份和变更。监控天天看,大家都熟。备份躺在那里,没人愿意真恢复一次。变更赶时间,检查项能省就省。事故往往就从这两处漏进来。
工具层面,金仓把这几件事拆成了几条线。KInstaller 管安装卸载。DBCA 管目录初始化和参数。DBUA 管版本升级和补丁。KEMCC 负责多实例的日常纳管。sys_rman 和 sys_dump 负责备份。先补哪块,得先知道差在哪。
二、数据库运维的五级成熟度,你在哪一级
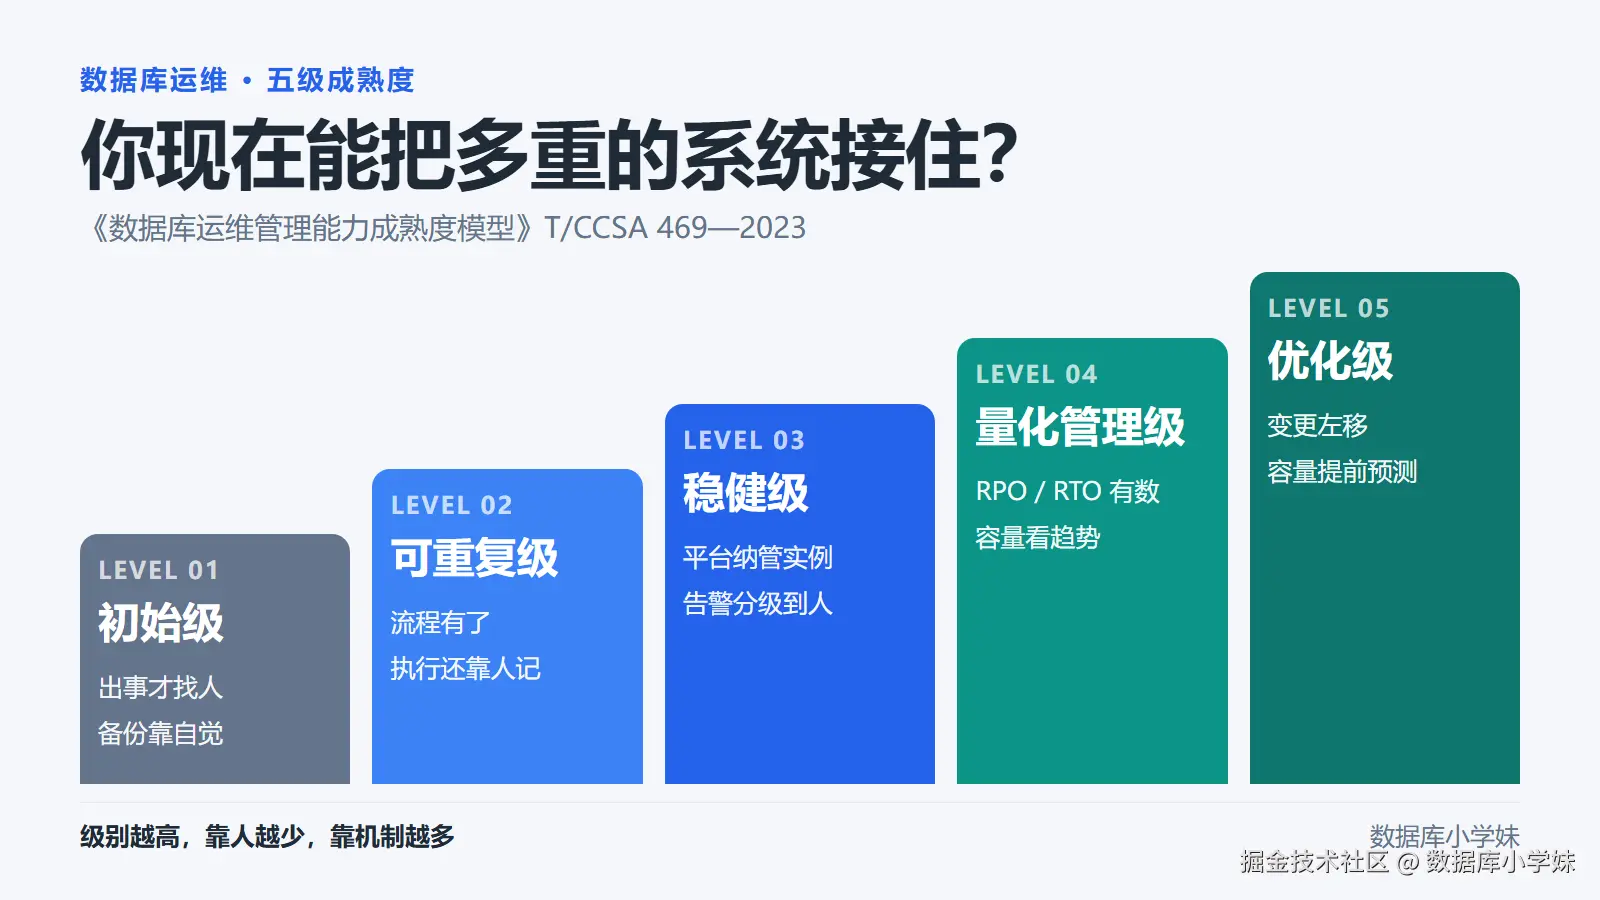
2023 年,中国通信标准化协会发布了一份标准。全称是《数据库运维管理能力成熟度模型》。编号 T/CCSA 469---2023。金仓是起草单位之一。标准把运维能力分成五级。依次是初始级、可重复级、稳健级、量化管理级、优化级。
别把它当考试评级。它更像一面镜子。它照出你现在的运维,到底靠什么在撑。级别越高,靠人越少,靠机制越多。
| 等级 | 典型状态 | 常见问题 | 先补什么 |
|---|---|---|---|
| 初始级 | 出事才找人,靠个人经验 | 没有固定巡检,备份靠自觉 | 备份验证 + 三条核心告警 |
| 可重复级 | 有流程,但靠人记 | 文档有,执行看心情 | 高频动作标准化、模板化 |
| 稳健级 | 平台接管重复动作 | 实例一多就顾不过来 | 统一纳管、告警分级、操作留痕 |
| 量化管理级 | 用数据说话 | 有指标,但指标不指向动作 | 恢复目标、切换演练、容量趋势 |
| 优化级 | 把故障挡在变更前 | 自动化跟业务脱节 | 变更左移、容量预测、成本治理 |
初始级:不是没干活,是活在救火里
这一级的典型画面,是用户先发现问题。运维再冲上去。监控装了没人看,备份做了没人验。变更流程写在脑子里,人一走就断。
先别急着买平台。把两件小事做成固定动作。每周验一次备份能不能恢复。每天盯三条告警:连接数、磁盘空间、主备延迟。工具再全,流程是空的,到头来还是一地鸡毛。
可重复级:流程有了,但还挂在人身上
巡检表有了,备份脚本也有了。可一到执行就变形。张三记得跑,李四忘了跑。交接靠嘴,人一休假就断档。
这一级要补的是"可重复"。巡检、备份、变更都做成模板和工单。每次变更留三样东西:改了什么、怎么回滚、怎么验证。我吃过亏。有次升级补丁,回滚脚本只写在聊天记录里。人一换,谁也找不到。
稳健级:平台开始接管重复动作
实例从几套涨到几十套。终端窗口开一排,告警响成一片。人还在,效率却到顶了。这时需要统一资源视图、统一告警、统一操作入口。金仓的 KEMCC 可以纳管 KES 及其他主流数据库。监控、巡检、备份恢复,都放在一个控制台。配置变更和告警分级,也在里面。
告警能按级别走短信、邮件、企业微信。重点不是功能多,是同一件事只在一个地方做。平台化的价值,是把重复判断变成规则。否则只是换了个界面。
量化管理级:指标要能指向动作
大屏指标很多。一问这套库能不能扛住下个月大促,没人答得上。能回答问题的指标,才算数。答不上来,指标就是摆设。
至少盯三类。恢复目标,也就是 RPO 和 RTO。可用性目标,一个月允许停多久。容量趋势,照现在的增速还能撑几周。每季度做一次恢复演练和切换演练,记录实际耗时。别写"应该能切",要写"上次切用了多久"。
备份工具只解决"备",解决不了"恢复"。金仓的 sys_rman 做物理备份。支持全量、增量、差异和块备份。sys_dump 做逻辑备份。备份时不阻塞读写。但备份文件躺在那里,不等于数据能回来。演练才是分水岭。
优化级:把故障挡在变更之前
故障少了,可每次大变更还是全员熬夜。容量总在业务爆发后才扩,问题总在上线后才暴露。救火像第一次。团队也开始疲了。
这一级拼的是左移。SQL 上线前审执行计划。变更前查依赖和容量。回滚方案先演练一遍。自动化也要挑顺序,从高频、低风险的动作开始。别一上来就做"一键切换"。
三、一次"监控全绿"的数据库运维复盘
回到开头那次事故。项目从 Oracle 迁到 KES。割接后第二周,早上八点四十,订单查询突然变慢。我先看会话和锁等待,没有明显阻塞。再看监控,CPU 四成,连接数正常,磁盘也正常。三个资源指标都健康,问题只能往数据层找。拿一条慢 SQL 跑执行计划。估算行数和实际行数对不上。
sql
-- 先确认估算和实际差多少
EXPLAIN (ANALYZE, BUFFERS)
SELECT o.id, o.amount
FROM orders o
JOIN order_items i ON i.order_id = o.id
WHERE o.created_at >= now() - interval '7 days';
看两个数就够了。优化器估的 rows,和实际返回的 actual rows。差一个数量级,先怀疑统计信息,别急着加索引。继续查,迁移后只做过一次全库分析。后面增量数据一直没触发更新。同一时间,备库回放延迟在涨。读写分离又把一部分查询压到备库,雪上加霜。
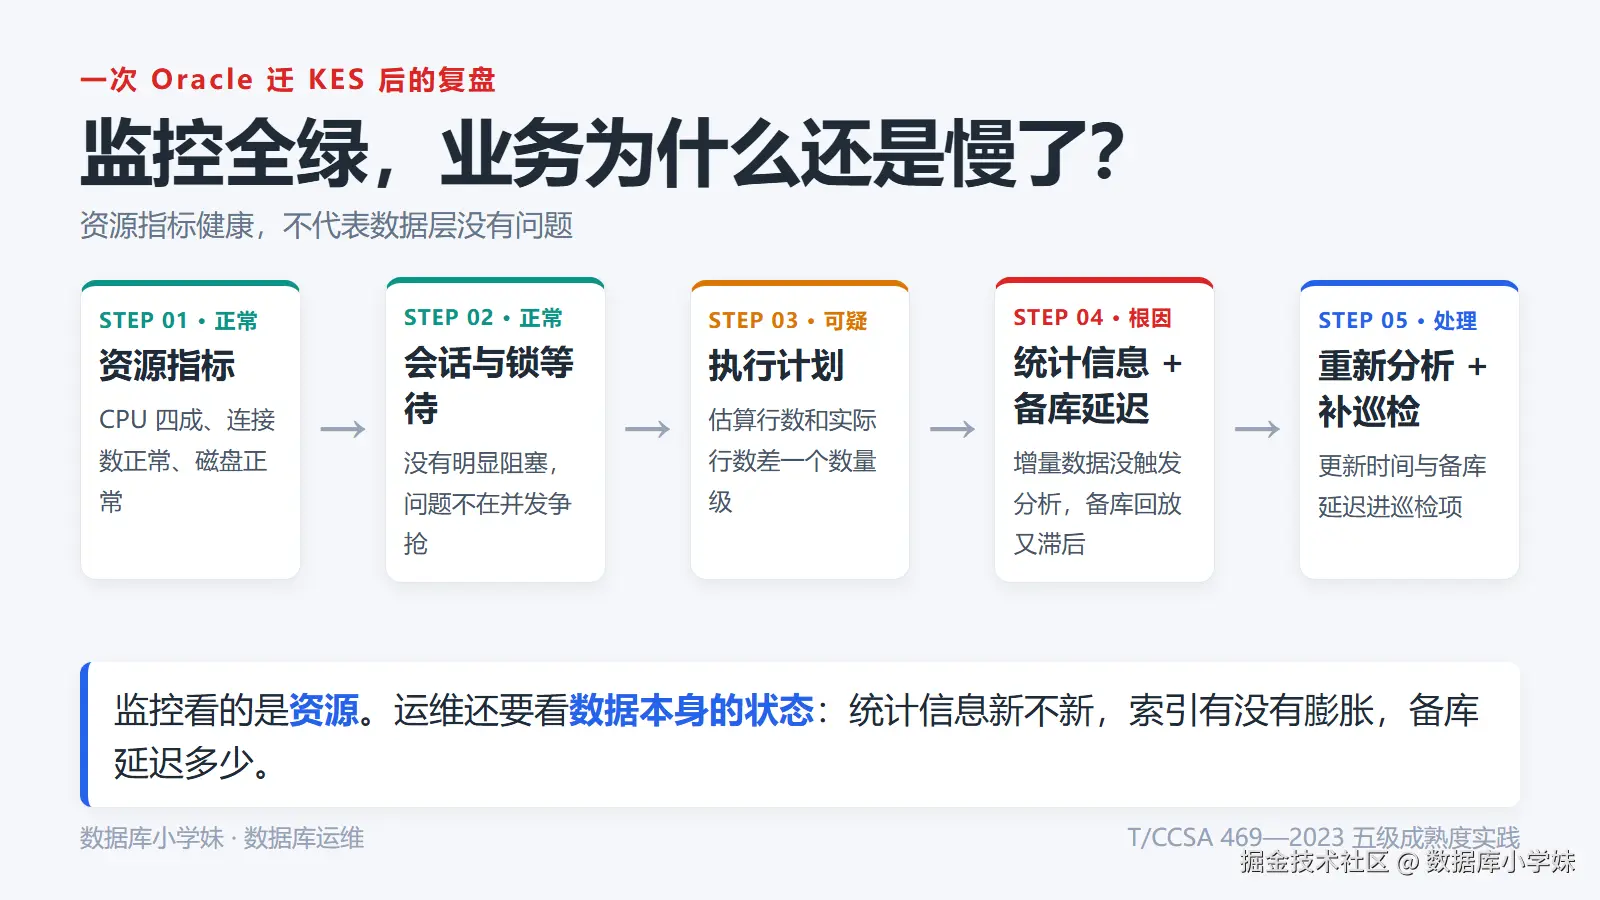
处理不复杂。对相关表重新分析,调整统计信息收集策略。再把"统计信息更新时间"和"备库延迟"加进巡检。真正花时间的是定位。那次没有停机,业务却慢了将近一个上午。
监控看的是资源。运维还要看数据本身的状态。统计信息新不新,索引有没有膨胀。备库延迟多少,归档空间还剩多少。这些不在默认大屏里,却常常是事故的起点。
四、数据库运维先补哪块?按症状对号入座
别一口气补全五级。先找真正拖后腿的那块,一次只解决一个。顺序错了,越补越乱。先止痛,再体检。
| 数据库运维症状 | 更可能的根因 | 先做的一件事 | 对应能力 |
|---|---|---|---|
| 故障总是用户先发现 | 告警没分级、没指到人 | 先收敛三条核心告警 | KEMCC 告警分级 |
| 备份有,但从没恢复过 | 只有备份,没有恢复验证 | 本季度做一次恢复演练 | sys_rman 备份集 |
| 实例多,终端开一排 | 缺统一视图 | 先纳管,再谈自动化 | KEMCC 多实例纳管 |
| 变更总在深夜 | 缺变更前检查 | 把统计信息、容量、依赖写进工单 | KStudio 执行计划 |
| 容量总在爆 | 没有趋势数据 | 先留 90 天监控指标 | KEMCC 监控 |
| 切换没底气 | 演练缺失 | 先做只读切换演练 | 读写分离集群 |
顺序很重要。先可恢复,再可观测,再自动化。跳步容易返工。没有恢复能力的自动化,只是把错误放大。
五、数据库运维避坑清单
先看监控大屏。它不是运维成果。指标要能回答"下一步做什么"。答不上来的指标,看多了只会麻木。告警也一样,全量推送等于没有推送。
再看备份。做完不等于能恢复。演练要记录时间、步骤和失败点。尽量换个人来恢复。自己备份、自己恢复,很容易把隐含步骤当成理所当然。
还有巡检项。不是越多越好。我曾把巡检表做到六十多项。后来发现,真正拦住故障的只有六项。备份、空间、延迟、锁等待、连接数、错误日志。剩下那一半,基本没人看。巡检没有反馈,就只是打卡。
六、收尾:运维的上限是信任
这五个等级,我平时拿来摸摸自己的底。它像一条线,标出你现在能把多重的系统接住。金仓这边有一条工具链。安装靠 KInstaller、DBCA、DBUA。日常纳管靠 KEMCC。备份和恢复主要靠 sys_rman。金仓也是 T/CCSA 469---2023 的起草单位之一。对正在做国产化替换的团队来说,运维习惯不用从零重建。但前提是,工具真的用进了流程。只装一个平台,不算数。
你现在这套库,卡在哪一级?是备份没验过,还是告警没人看?说说你遇到的情况。评论区聊聊。
我是数据库小学妹,帮你少走弯路少踩坑,咱们下篇见👋