别看现在 AI 发展得越来越快,好像很多选择,但我和身边的朋友都觉得,现在大家每个月花在 AI 编程上的钱越来越多,但踩的坑一点没少。
有人迷信顶配模型,在插件里挂着 Claude Opus 重构代码,结果一下午跑掉了 40 多美金;也有人还在拿老掉牙的 GPT-4o 改 Bug,改了五个来回,Bug没改掉就算了,原来的好代码全被它删没了。
为了搞清楚现在到底哪个模型真能干活、哪个纯粹是AI刺客,我去看了 LiveBench 2.0 (它的 Coding 单项评分很严格,直接在真实仓库上修复合并 PR 的 Bug,只要引入一处回归错误直接判 0 分)的最新数据,并把官方公布的每百万输出 Token 美元定价和账单整理成了一下,发现了真的不是模型越贵越好,也千万不要迷信国外的AI会写代码。
为什么大家骂归骂,写代码还是离不开 Claude?
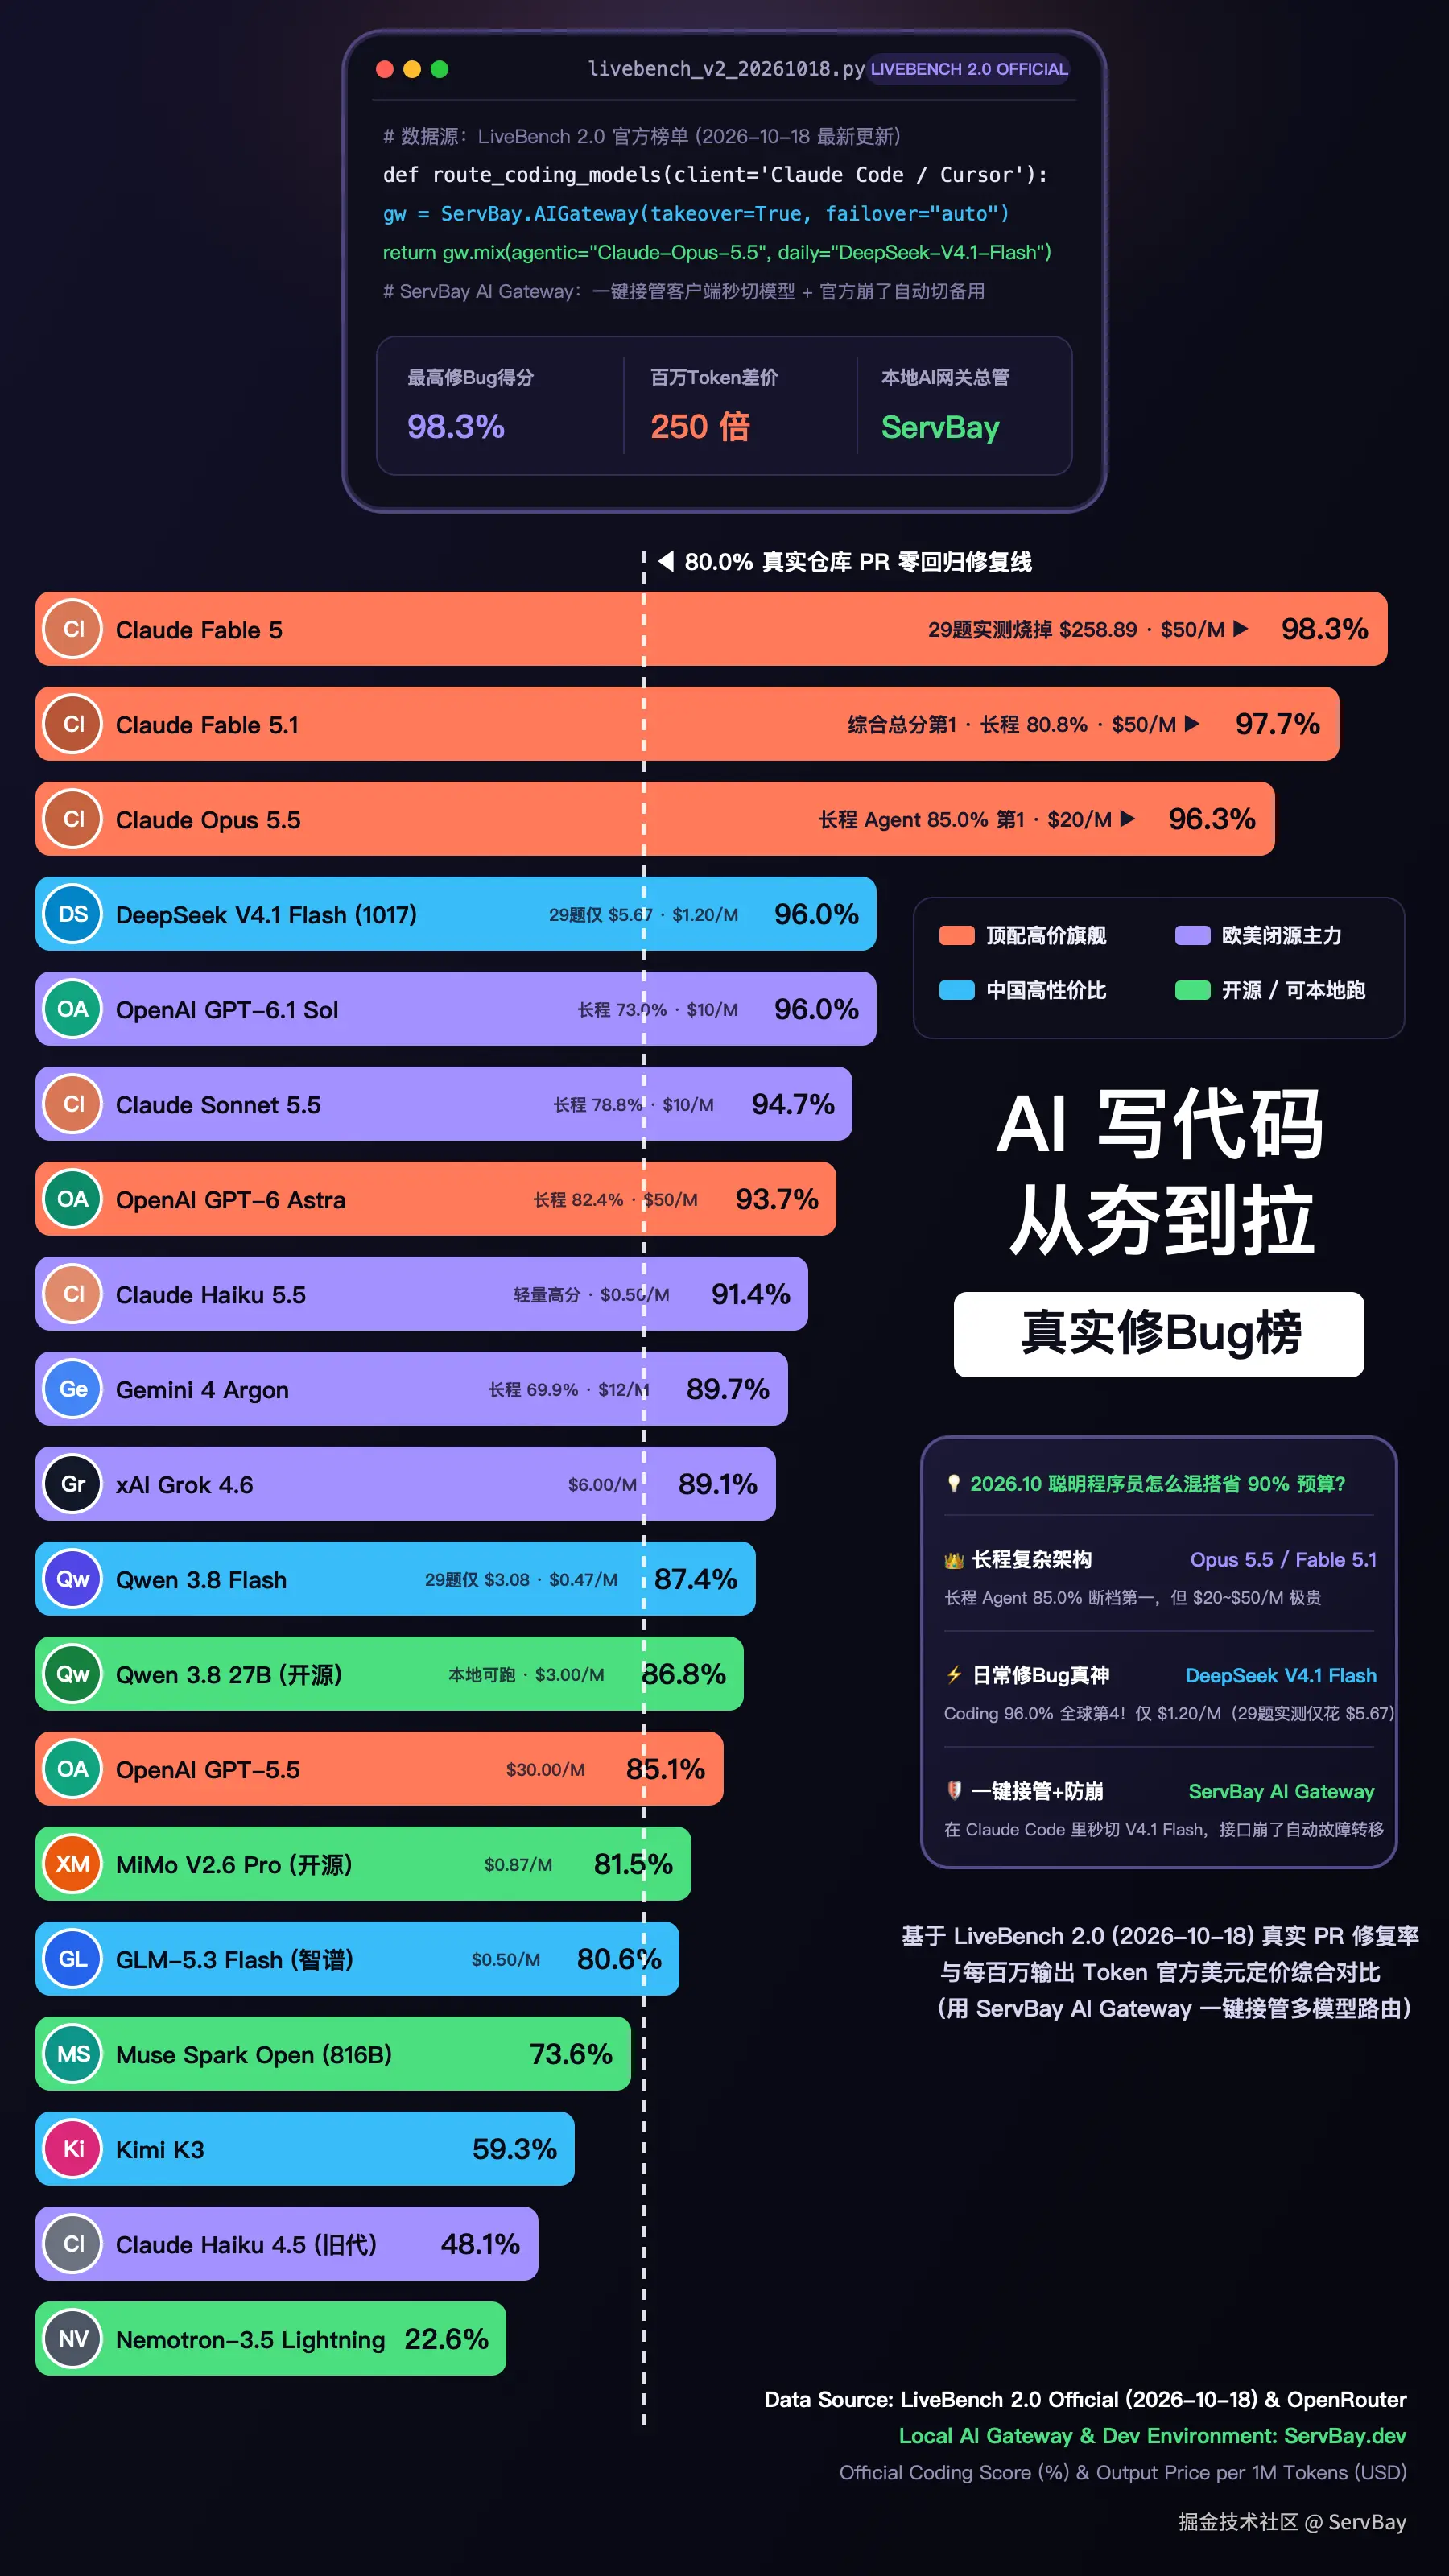
我们的国模之光,DeepSeek V4.1 Flash (1017),在国外模型的围剿中、在一篇腥风血雨中,杀进了前5。 它在真实 PR 修 Bug 单项上拿到了 96.0% 的高分,和 OpenAI 的 GPT-6.1 Sol(96.0%)并列全球第 4,甚至超过了 Claude Sonnet 5.5(94.7%)和 GPT-6 Astra(93.7%),距离第一名 Claude Fable 5(98.3%)只有 2.3 分的差距。
除了单题修 Bug(Coding),LiveBench 2.0 还有一项测试叫 长程 Agent(Long Agentic),专门测跨多轮需求变更的复杂业务工程。
在这项指标上,差距就出来了。
- Claude Opus 5.5 的长程 Agent 得分高达 85.0%(全球第 1);
- OpenAI GPT-6 Astra(82.4%)、Claude Fable 5.1(80.8%)、Claude Sonnet 5.5(78.8%) 紧随其后;
- 而单题修 Bug 拿到 96.0% 的 DeepSeek V4.1 Flash,长程 Agent 得分是 50.9% 。
很多程序员可能用国产模型都有点割裂感可能也是这个原因。
修一个明确的 Bug、写一个独立函数,DeepSeek V4.1 Flash 已经跟顶配平起平坐;但一旦要跨十几个文件重构整套项目架构,Claude Opus 5.5 / Sonnet 5.5 依然是不可替代的。
国产模型卷成白菜价
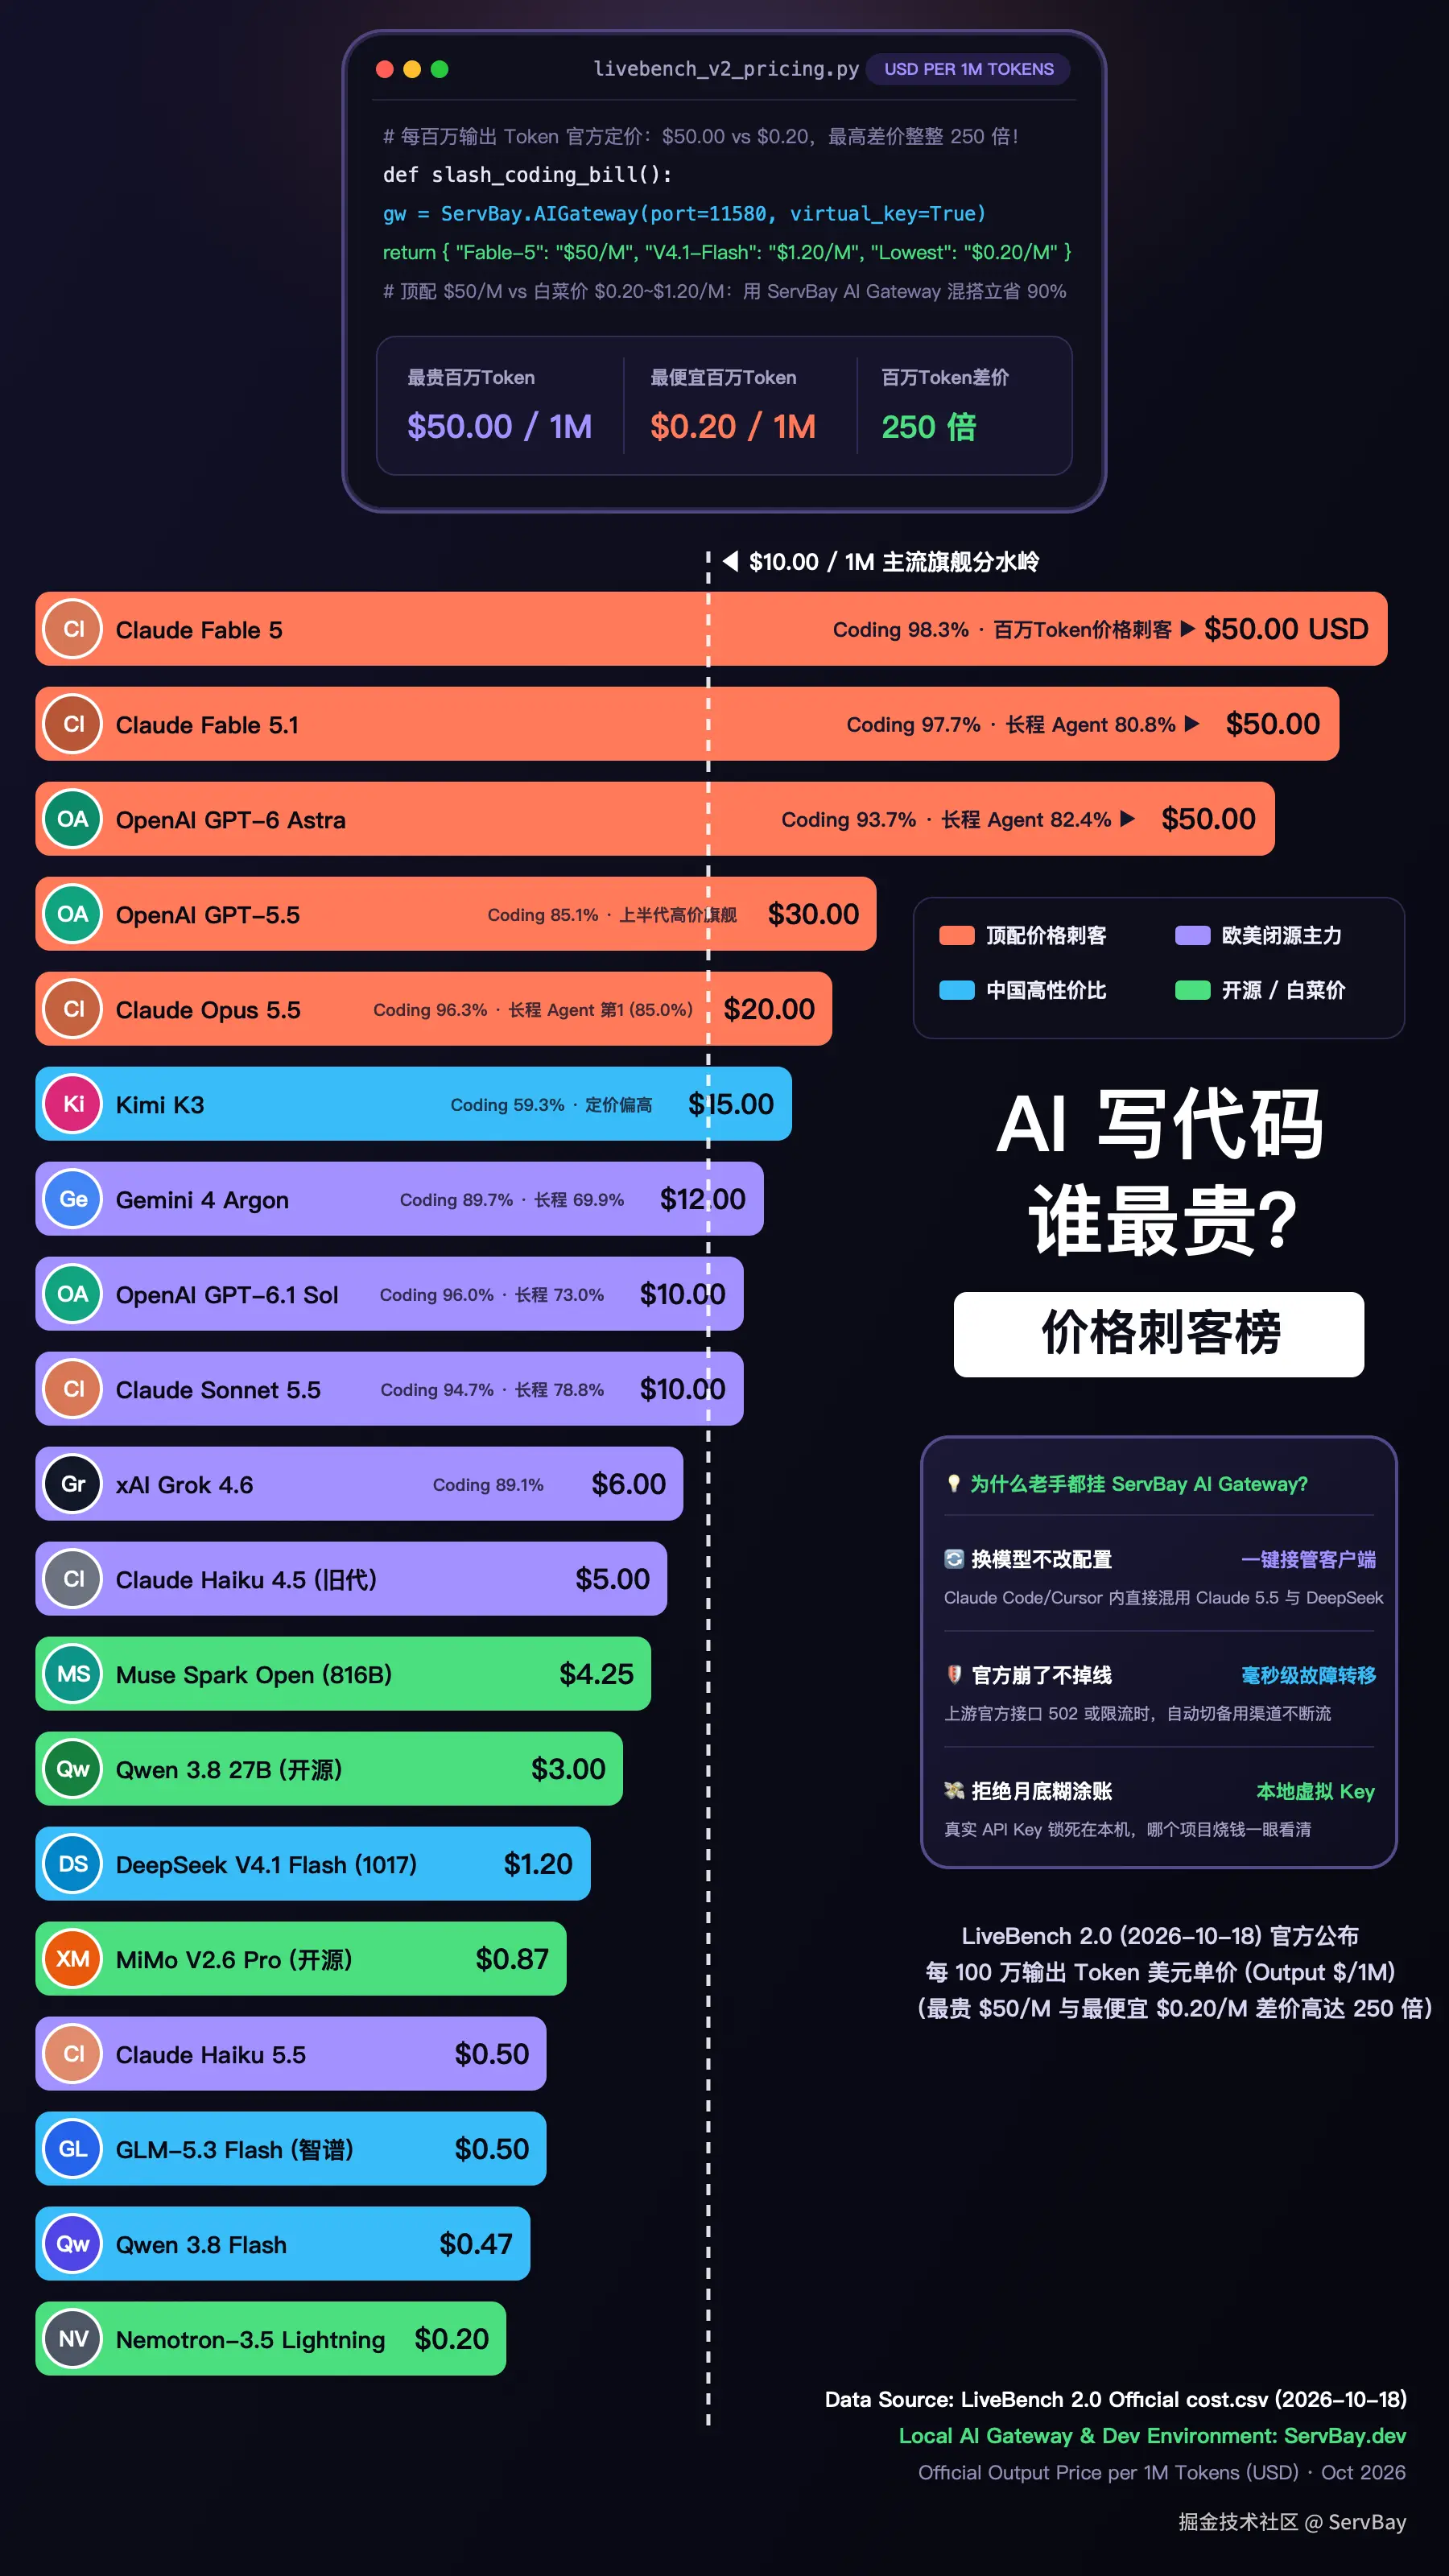
再看价格图,同样输出 100 万 Token,排在最上面的顶配模型 Claude 和 OpenAI 们高达 50.00/M,而排在最下面的模型只要0.20/M,最高单价差了整整 250 倍。
- Claude Fable 5 每百万输出 Token 高达 50.00,跑完官方这29道编程题实测烧掉了258.89;
- 而 DeepSeek V4.1 Flash (1017) 每百万输出 Token 只要 1.20,跑完一模一样的29道题,总账单只有5.67。
- 如果再往下看 Qwen 3.8 Flash(87.4%) 和 GLM-5.3 Flash(80.6%),百万 Token 单价更是压到了 0.47 0.50(不到 50顶配模型的1/100),跑完29道题只花了3.08。
也就是说,平时 80% 的单模块开发、修常规 Bug、写前端组件和单元测试,再用 20 50/M 的顶配模型纯属交智商税。不到6美元的价格,你还想要什么自行车,国产模型才是性价比之王。
现在的冤种模型是谁?
看如果你手里的工具还在默认调用上一代的 Claude Haiku 4.5,它还收着 5.00/M的价格(是新一代ClaudeHaiku5.50.50/M 的 10 倍),但修 Bug 得分只有可怜的 48.1%(新 Haiku 5.5 高达 91.4%)。同样,拿着 $15.00/M 的 Kimi K3(59.3%) 写代码,性价比也已经被同侪远远甩开。
怎么才能达到最高的性价比?
看懂了上面两张图,你就知道 2026 年写代码最聪明的策略绝对不是死磕某一家会员,而是分级混搭。 成年人了,当然是白菜价和聪明的AI两个都要。
- 20% 的长程复杂架构、跨模块重构 👉 交给 Claude Opus 5.5 / Sonnet 5.5;
- 80% 的日常修 Bug、写接口、补测试 👉 切给 DeepSeek V4.1 Flash 或 Qwen 3.8 Flash;
- 写私密项目或离线场景 👉 跑绿色柱子的开源模型(如 Qwen 3.8 27B、小米 MiMo V2.6 Pro)。
但道理很多朋友知道,但却不那么容易实现,原因有三个:
- 客户端协议锁死:比如大家最爱用的 Claude Code 原生只认 Anthropic 协议,想把 DeepSeek V4.1 Flash 或 Qwen 3.8 塞进去用,得自己折腾协议转换代理和一堆终端环境变量;
- 便宜模型官方容易崩:高性价比模型一旦火了,官方 API 经常因为高并发报 502 或限流(比如前阵子 DeepSeek 官方崩了近 5 个小时),一崩手里的活就得全停;
为了彻底解决这几个破事,我现在自己的电脑上是直接常驻一个 ServBay ,用它内置的 ServBay AI Gateway(本地 AI 网关) 就是朕最贴心的大内总管:
-
一键接管客户端,不用改一行配置:点一下开关就能直接接管本机的 Claude Code、Cursor、Codex、Gemini CLI,本地自动完成协议转换,我可以直接在 Claude Code 里用 Opus 5.5 定完架构,顺手切到 DeepSeek V4.1 Flash 写业务代码;
-
毫秒级自动故障转移(Failover) :给同一个模型配上官方和备用渠道(比如 OpenRouter 或硅基流动),哪天官方接口又 502 抽风了,网关会自动毫秒级切到备用线路,写代码的心流完全不会断;
-
一键跑本地模型:顺手点一下开关就能在本地 0 元跑开源大模型,1 秒拉起 PHP / Node.js / Python 和数据库环境直接验收 AI 写好的网页。
都是纯过日子人,建议把该省的 90% 冤枉钱省下来,规矩立住了,AI用起来才能不烧心。